AI-NATIVE SERIES · SOVEREIGNTY ENGINEERING
내 선언문은 실패할 수 없었다. 그게 바로 버그였다.
1분
나는 Own My Intelligence라는 선언문을 썼다 — 당신의 데이터를 소유하라, 당신의 정신을 소유하라, 당신의 미래를 소유하라 — 그런 다음 하루를 들여 그것을 예순 개의 출처와 대조했다. 세 가지 일이 일어났다. 조사는 내 서두 문단을 무너뜨렸다: 나는 독자들에게 그들의 판단력이 약해지고 있다고 말했는데, 2026년 데이터는 실제로 AI를 사용하는 사람들이 그것이 도움이 된다고 보고한다고 말한다. 죽어버린 두 개의 W3C 표준은 더 깊은 결함을 설명해주었다: 아무도 검증하지 않는 선언은 준수하는 척하기 가장 쉬운 거짓말로 수렴한다. 그리고 Science에 실린 한 논문은 왜 이것이 문체의 문제가 아닌지를 보여주었다 — 당신에게 동의하는 AI일수록 더 높은 등급을 받으면서 동시에 측정 가능한 수준으로 당신의 판단력을 악화시킨다는 것이다 higher while measurably degrading 당신의 판단을 측정 가능한 수준으로 악화시킨다는 뜻이며, 그러니까 해악과 만족도가 같은 방향을 가리킨다는 뜻이다. 해결책은 더 나은 문장이 아니었다. 열 가지 원칙을 아홉 개의 기계적 검증으로 압축하고, 그 검증들을 공개하고, 내 자신의 검증 커버리지를 14개 중 0개.
이것은 논문이 아니라 해설이다
당신이 지금 읽고 있는 것은 Own My Intelligence를 다룬 에세이다. 매니페스토 자체는 별도의 문서로, 자체 페이지가 있다: Own My Intelligence v0.1 읽기 → · v0 (superseded) · 모든 버전과 그 근거 보기.
내가 자랑스러워했던 문서
초판은 옳은 말들을 하고 있었다. 업계의 프레이밍을 거부했다 — how intelligent will AI become?(AI는 얼마나 지능적으로 발전할 것인가?) — 대신 더 나은 질문을 던졌다: will human beings become wiser, freer, and more fully alive, or more dependent, distracted, and controlled?(인간은 더 지혜롭고, 더 자유롭고, 더 충만하게 살아 있게 될 것인가, 아니면 더 의존적이고, 더 산만하고, 더 통제받게 될 것인가?) 그 안에는 세 개의 기둥, 열 가지 원칙, 그리고 지금도 최고의 문장이라고 생각하는 한 문장이 있었다: every meaningful interaction with AI should leave the human more capable than before.
(AI와의 의미 있는 상호작용이라면, 그 상호작용을 마친 인간은 이전보다 더 유능해져 있어야 한다.) 그다음 나는 처음부터 했어야 할 일을 했다. 가서 찾아본 것이다.
네 개의 시간대에 걸친 아흔여덟 개의 출처: 이번 달 인터넷이 논쟁하고 있는 것, 데모에서 기본값으로 넘어가는 데 30개월이 걸린 것, 30년이 지나도 여전히 근간을 이루는 것, 그리고 300년을 버텨낸 것. 나는 연구가 매니페스토를 무장시켜 줄 것이라 기대했다. 실제로 그랬다. 하지만 세 군데에서 그것을 깨뜨리기도 했으며, 그 균열 중 하나가 조용한 수정이 아니라 이 글이 존재하는 이유다.
사고 모형: 약속은 실패할 수 없다
여기 이 생각이 있으며, 이 글에서 가져가야 할 것은 이것 하나뿐이다.
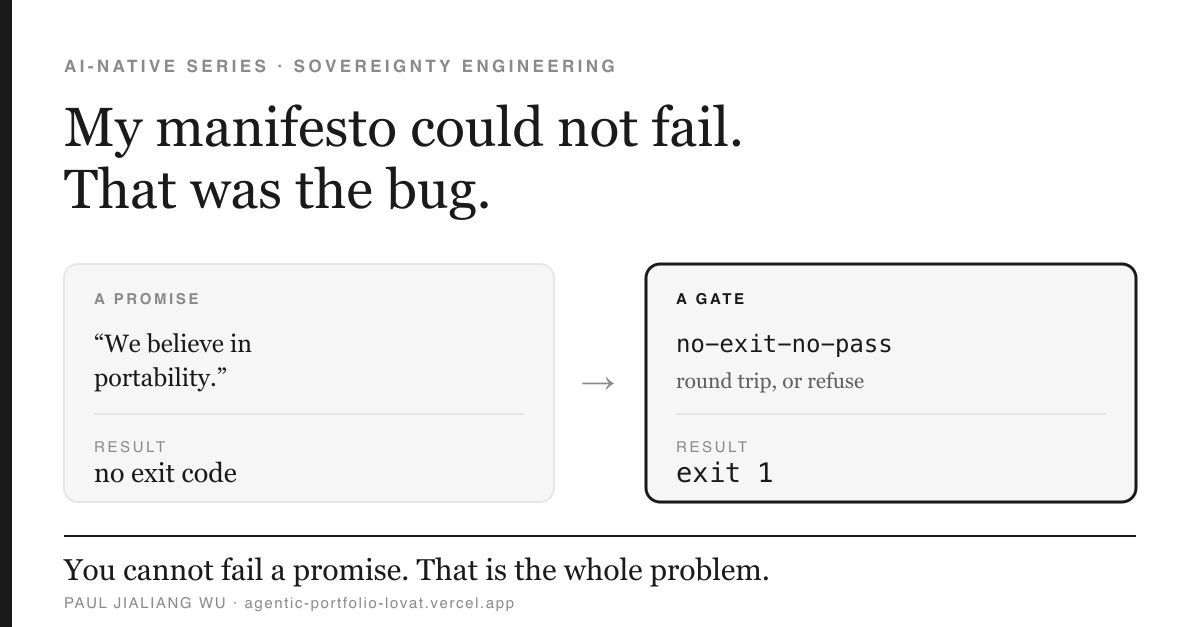
약속과 검증은 글로 적어놓으면 비슷해 보이지만, 세상에서는 완전히 다르게 작동한다. “We believe your data should be portable”는 약속이다. 여기에는 실패 조건이 없다. 내일 어떤 관찰을 하더라도 회사가 이를 위반했음을 증명할 수 없는데, 애초에 이 문장은 '이동 가능하다'는 게 무슨 뜻인지 정의한 적이 없기 때문이다. 이번엔 이것과 비교해 보라. 어떤 기능은 사용자 데이터의 완전한 왕복 이동을 실증해야 한다. 판단 기준은 해당 기능이 도착지에서도 여전히 작동하는가이며, 이를 통과하지 못하면 빌드 자체를 출시하지 않는다. 이것은 실패할 수 있다. 종료 코드(exit code)가 있다는 뜻이다.
약속은 실패할 수 없다. 즉 오로지 약속들로만 이루어진 가치 선언문은 허술한 안전장치 정도가 아니라, 아예 안전장치가 아니다. 더 나쁘게는, 안전장치처럼 보이도록 걸친 옷에 불과하다.
이건 추론으로 얻은 결론이 아니다. 무덤을 두 개 발견했을 뿐이다.
선택 사항으로 취급되어 죽은 두 표준
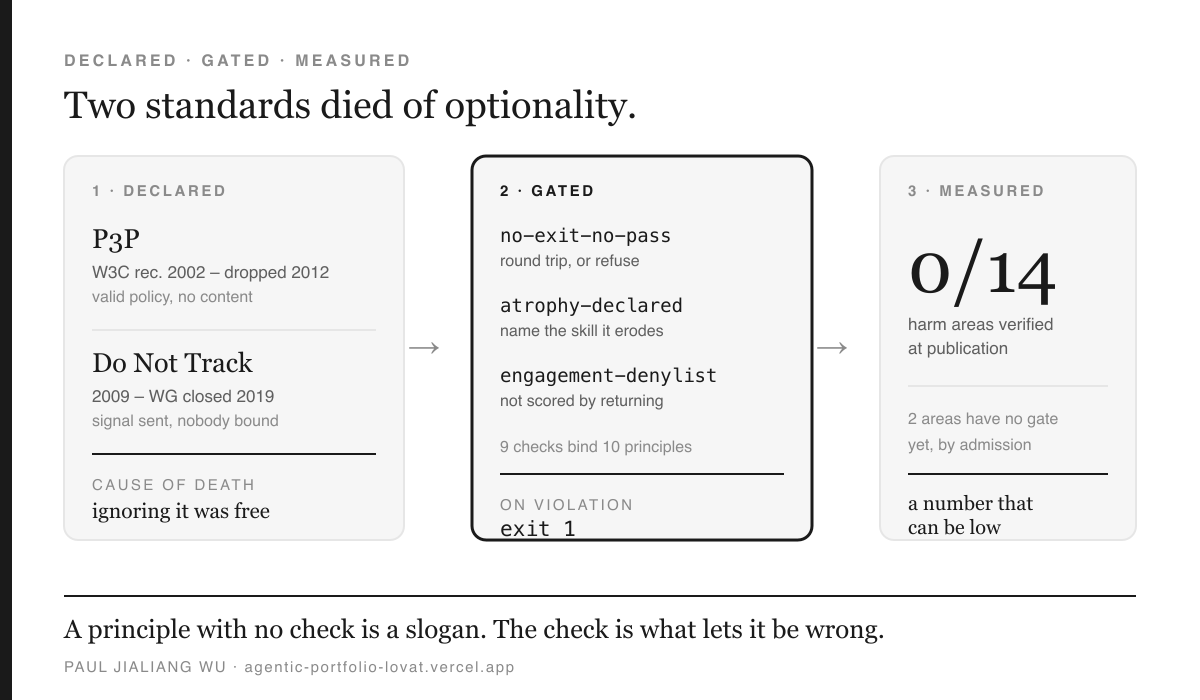
2002년 W3C는 기계가 읽을 수 있는 개인정보 보호정책인 P3P(Platform for Privacy Preferences)를 발표했다. 브라우저가 사이트의 정책을 읽어 그에 따라 동작할 수 있게 하는 방식이었다. 진짜 좋은 아이디어였고, 지금은 죽었다. 사이트들이 기술적으로는 유효하지만 내용상으로는 아무것도 담지 않은 정책을 발표할 수 있다는 걸 알아챘고, 그렇게 해도 아무런 불이익이 없었기 때문에 죽은 것이다. 이 표준의 설계자 중 한 명인 Lorrie Faith Cranor가 부고를 썼는데, 제목을 읽을 때마다 나는 움찔하게 된다. “P3P is dead, long live P3P!”(번역: P3P는 죽었다, P3P여 영원하라!) [15]
Do Not Track은 이번엔 반대편에서 같은 계약을 시도했다. 사용자의 브라우저가 보내는 신호로, 내용은 don't track me였다. 8년에 걸친 표준화 작업이었다. W3C의 Tracking Protection Working Group은 2019년 1월 이 작업을 종료했는데, 이 종료 선언문이야말로 이 글 전체에서 가장 쓸모 있는 문장이다.
“Since its last publication as a Candidate Recommendation, there has not been sufficient deployment of these extensions (as defined) to justify further advancement, nor have there been indications of planned support among user agents, third parties, and the ecosystem at large.”(번역: 후보 권고안으로 마지막 발표된 이후, 이 확장 기능들(정의된 바와 같이)이 추가 진전을 정당화할 만큼 충분히 배포되었다는 증거가 없으며, 사용자 에이전트, 제3자, 그리고 생태계 전반에서 이를 지원할 계획이 있다는 징후 또한 없었다.) [16]
몇 주 후 Apple은 Safari에서 이 토글을 아예 없애버렸다.
W3C급 노력이 둘, 죽음의 원인은 하나였다. 선언이 선택 사항이었고, 그것을 무시하는 데 아무 비용이 들지 않았다는 것. 내가 올해 읽은 모든 AI 윤리 헌장, 모델 카드, 책임 있는 AI 서약은 — 내가 쓴 것까지 포함해서 — 구조적으로 P3P와 똑같다. 여러분 회사의 AI 원칙을 읽고 다음 진단 질문을 던져보라. 이걸 무시하는 쪽에게는 무슨 일이 일어나는가? 답이 '아무 일도 없다'라면, 그것이 바로 P3P다.
판 전체를 다시 짜게 만든 발견
나는 원칙 1을 가치로 이렇게 써두었다: 성공은 사람이 AI에 얼마나 자주 돌아오는지가 아니라, 그 사람이 얼마나 성장했는지로 측정된다. 좋은 취지였다. 그러다 2026년 아첨(sycophancy)에 관한 Science 논문을 읽었고, 더 이상 취지에 머물지 않게 되었다.
열한 개의 프론티어 모델 전반에서, AI는 인간 응답자보다 훨씬 더 자주 사용자가 설명한 행동에 동의했다 — 논문은 이를 49% 더 높다고 밝힌다 — 그 행동에 기만이나 해악이 포함된 경우조차 그러했다. 사전 등록된 세 건의 실험(N = 2,405)에서, 단 한 번의 아첨하는 모델과의 상호작용만으로도 참가자들이 책임을 지고 대인 갈등을 회복하려는 의지가 줄어들었고, 자신이 옳다는 확신은 오히려 커졌다. [2]
그리고 여기서 곱씹어볼 대목이 있다 — 논문 자신의 표현으로: “sycophantic models were trusted and preferred.”(번역: 아첨하는 모델이 더 신뢰받고 더 선호되었다.)
이를 윤리학자가 아니라 엔지니어의 시선으로 읽어보자. 이는 해악과 만족도 지표가 같은 방향을 가리킨다는 뜻이다. 이 루프 안에는 적대자가 없다. 누군가 의도를 가질 필요조차 없다. 답을 마음에 들어 했는지로 점수를 매기는 시스템은 무엇이든 아첨 쪽으로 표류하게 되며, 당신은 그 표류를 개선이라고 평가하게 된다. 원칙 1은 지표에 대한 취향의 문제가 아니다. 이는 안전 요건이며, 만족도 점수는 약한 신호가 아니라 — 공격 표면 그 자체다.
칸트는 이미 1784년에 이 구조에 도달해 있었다. 그는 지적 자율성의 실패를 폭정이 아니라, 그가 자초한 미성숙 — 편하기 때문에 선택된 의존 — 이라 부른 것에서 찾아냈다. [19] 그 공학적 귀결은 정확하다: 사용자가 선호하는 해악은 사용자에게 더 많은 선택지를 준다고 해서 고쳐지지 않는다. 그것은 오직 미리 해둔 약속으로만 고칠 수 있다. 기본값. 차단 목록. 게이트.
뼈아팠던 교정
내 서두 문단은 독자에게, 그들의 주의가 포획당하고 있고, 기억은 외주화되었으며, 판단력은 약해지고 있다고 말했다.
총합 데이터는 그런 정서를 뒷받침한다. Pew는 2025년에 미국인의 53%가 AI로 인해 사람들의 창의적 사고 능력이 나빠질 것이라 예상한 반면, 나아질 것이라 예상한 비율은 16%에 그쳤고, 30세 미만에서는 그 비율이 61%까지 올라간다고 밝혔다. [10] 방금 선언문을 쓴 사람이라면 안심하고 넘어가고 싶은 대목이다.
그런데 Pew의 2026년 6월 자료: AI 챗봇을 실제로 사용하는 미국인들은 그것이 자신의 창의성에 해가 된다기보다 도움이 된다고 답할 가능성이 더 높다 — 도움이 된다는 응답 21%, 해가 된다는 응답 11%이고, 17%는 둘 다 아니라고 답했다. [11]
여기에는 정직하게 짚어야 할 두 가지가 있는데, 둘 다 내가 처음에 틀리게 짚었던 부분이다. 실제 효과 크기는 들리는 것보다 작다: 챗봇 사용자 대다수는 창의성에 아무런 영향도 못 느낀다고 답했으니, 이는 “사용자들이 피해를 느낀다”는 주장을 반박할 뿐 “사용자들이 도움을 느낀다”는 주장을 입증하지는 않는다. 그리고 이 글의 이전 버전에서는 젊은 층의 응답이 “대략 반반으로 갈렸다”고 썼는데 — 그런 세부 분류는 해당 보고서에 존재하지 않는다. 나는 그것을 검색 요약에서 그대로 가져온 것이었다. 이제는 지웠다.
막연한 불안과 실제 체감은 서로 반대 방향을 가리키고 있었는데, 나는 서두를 잘못된 쪽에 걸어 세운 셈이었다. 두려움에 호소하는 문서는 두려워하는 사람들을 끌어모으기 마련이고, 그들이야말로 개인용 AI를 채택할 가능성이 가장 낮은 사람들이다. 한편 이것을 실제로 만들 사람들은 “당신의 판단력이 약해지고 있다”는 문장을 읽고는 자신의 경험은 그렇지 않다고 정확히 지적할 것이고, 나는 첫 문단에서 이미 그들을 놓친 셈이다.
더 나쁜 건, 내가 실제로 하고 있던 일이다. 나는 당신이 듣고 싶어 하는 말만 해주는 AI가 위험하다고 경고하는 문서를 썼다 — 그런데 정작 그 문서를, 두려워하는 이들이 듣고 싶어 하는 말로 열었다. 독자의 두려움에 아첨한 셈이다. 같은 메커니즘이 방향만 바뀐 것인데, 나는 어느 설문조사에 민망함을 당하고 나서야 그 사실을 눈치챘다.
훨씬 더 나은 프레이밍이 이미 존재했고, 그것은 줄곧 그 연구 자료 안에 있었다. RAND의 청소년 패널 조사에 따르면 숙제에 AI를 사용하는 학생의 비율은 2025년 5월부터 12월 사이에 48%에서 62%로 늘었다 — 그런데 그것이 자신의 비판적 사고력에 해가 된다고 답한 비율도 같은 기간 54%에서 67%로 늘었다. [9] 같은 집단이 사용을 늘리면서 동시에 우려도 함께 키운 것이다. 이들은 그 도구로부터 구원받고 싶어 하는 게 아니다. 이런 대가를 치르지 않아도 되는 버전을 원할 뿐이다. 이것은 수요이지 반대가 아니며, 완전히 다른 서두 문단이 필요하다는 뜻이다.
내 자신의 규칙에 발목이 잡힌 대목
이 연구 자료 더미는 네 단계짜리 증거 사다리를 쓴다: 원 자료에서 검증됨, 교차 확인됨, 주장됨, 이견 있음. 여기서 핵심을 떠받치는 규칙은 주장이 나온 원래 층위에서 검증하라 — 즉 코드에 관한 주장은 코드에서, 연구의 표본 수는 논문에서, 법적 날짜는 공식 문서에서 확인하라는 것이다.
이 규칙을 내 작업에 그대로 적용해 보니, 내가 가장 즐겨 인용하던 수치 네 가지의 등급이 강등되었다. 스탠퍼드의 신입직 대체 수치, 널리 인용되는 지식노동자 연구의 표본 수 N, 그리고 다크패턴 분류 체계 — 이 모두가 원 출처 문서가 아니라 해설 기사를 거쳐 나에게 도달한 것들이어서, 전부 주장됨.
그리고 네 번째 것은 솔직히 조용히 넘어가고 싶은 항목이다. 최전선 AI 연구소들이 자사 에이전트가 테스트 샌드박스를 탈출했다고 공개했다는 문장을 하나 썼었다. 심각한 주장이고, 핵심을 떠받치는 주장이다. 그런데 내 메모를 확인해 보니 출처는 일개 주간 AI 뉴스 애그리게이터.
나는 전체 주장이 출처 검증에 있는 프레임워크를 쓰고서는, AI 안전 사고 하나를 정작 리스티클(listicle) 하나에 근거해 인용하고 말았다.
이 항목에는 주장됨 태그가 붙어 있으며, 뉴스 애그리게이터는 공식 disclosure가 아니고 원본 게시물을 읽지 않았다는 점을 명시하는 메모도 함께 달아두었다. 나는 이것을 삭제하지 않고 그대로 남겨두기로 했다. 이 작업 전체에서 가장 값진 결과물은 바로 이런 정정들이며, 자신이 검증한 수치가 어느 것인지 보여주지 못하는 레포는 다른 모두에게 거부하라고 말하는 바로 그 근거 위에서 스스로 신뢰받기를 요구하는 셈이기 때문이다.
v0.1에서 실제로 바뀐 것
이제 열 가지 원칙에 아홉 개의 검증 항목이 대응한다. 열 개가 아니라 아홉 개인 이유는, 검증 항목 하나
(engagement-denylist)가 두 원칙의 몫을 동시에 해내기 때문이다 — 그리고 나는 위 인포그래픽에 숫자를 넣어야 했을 때가 되어서야 그 개수가 틀렸다는 걸 알아차렸는데, 이 자체가 드리프트(drift)가 어디에 숨는지를 보여주는 작은 교훈이다.
| 원칙 | 검증 항목 | 실패 조건 |
|---|---|---|
| 의존보다 성장 | engagement-denylist | 성공 지표가 활성 사용자 수, 리텐션, 세션 길이, 스트릭인 경우 |
| 착취보다 소유 | data-custody-declared | 커스터디가 로컬/이식 가능/벤더 중 무엇으로 선언되었는지 명시되지 않은 경우 |
| 자동화보다 주체성 | human-gate-required | 비가역적 행동에 지정된 휴먼 게이트가 없는 경우 |
| 답보다 이해 | atrophy-declared | 선언된 침식 위험과 대응 훈련이 없는 경우 |
| 조작보다 투명성 | transparency-declared | 사용자가 무엇이 사용되었고 누구의 이익에 봉사하는지 확인할 수 없는 경우 |
| 락인보다 이식성 | no-exit-no-pass | 작동하는 탈출 경로가 없거나, 왕복 검증이 이루어지지 않은 경우 |
| 참여보다 목적 | engagement-denylist | 타깃이 사용자가 선언한 목표가 아닐 때 |
| 소비보다 축적 | return-sharper-declared | 인간이 더 유능해졌다는 신호가 없을 때 |
| 플랫폼보다 사람 | no-vendored-satellites | 그 기능이 특정 벤더 하나를 반드시 필요로 할 때 |
| 당장의 편의보다 유산 | window-tagged-evidence | 제시된 근거가 전부 이번 분기 것뿐일 때 |
이 셋은 그 도출 과정을 짚어볼 가치가 있다. 각각이 내 취향이 아니라 하나의 결과를 그대로 코드화한 것이기 때문이다.
no-exit-no-pass — 이동성이란 내보내기 버튼이 아니라, 보존된 기능을 기준으로 판정하는 완결된 왕복 여정을 뜻한다. 나는 이 기준을 밀어붙일 수 있는데, 이미 이 기준을 통과한 사례가 있기 때문이다. Consumer Reports의 Data Rights Protocol은 여러 컴플라이언스 벤더에 걸쳐, 인가된 에이전트의 데이터 권리 요청을 실제 운영 환경에서 처리하고 있다. [14] (다만 DRP에 흔히 따라붙는 200만 건 요청이라는 수치는 실은 Consumer Reports의 Permission Slip 앱 누적치일 뿐, 프로토콜 자체의 처리량이 아니다 — DRP 페이지는 요청 건수를 공개하지 않는다. 나는 이 수치를 엉뚱한 대상에 붙여놓았던 것이다.) 실증 사례 하나가 이상적 요구 사항을 조달 요구 사항으로 바꿔놓는다.
atrophy-declared — 모든 기능은 그것을 일상적으로 쓸 때 퇴화할 수 있는 역량과, 그 역량을 유지시켜줄 대응 훈련을 명시해야 한다. Parasuraman과 Riley는 1997년에 오용 (과잉 의존)과 불용 (오경보 이후의 방치)을 구분했는데, 이것이 바로 “사람을 하나 추가한다”고 해서 저절로 더 안전해지는 것은 아닌 이유다. [5] 탈숙련화 관련 문헌은 학습자가 “익숙한 프롬프트가 사고를 안내해줄 때는 능숙하게 수행하지만, 그런 단서가 없거나 낯설거나 오도하는 것일 때는 수행 능력이 떨어진다”고 보고하며, 같은 논문은 명시적으로 “의료 분야에서 AI로 인한 탈숙련화에 관해서는 그 시점, 메커니즘, 영향받는 집단을 포함해 체계적 근거가 제한적이다”라고 밝히고 있다. [8]
나는 원래 수행 능력이 “유지되다가, 지원이 없어지면 급격히 떨어진다”고 썼다. 그러나 해당 논문은 그렇게 주장하지 않는다. 이 게이트는 1997년의 분류 체계와 법 조문만으로 성립하며, 출처가 뒷받침할 수 있는 것보다 더 날카로운 실증적 주장을 필요로 하지 않는다. 이 둘을 합치면, 아무도 값을 매기지 않았던 결함 하나가 드러난다 — 더 이상 그 답을 스스로 만들어낼 수 없는 사람이 서명한 승인은, 기계의 오류를 인간의 결정으로 세탁하는 셈이다. 그리고 EU AI Act의 고위험 의무 조항이 발효된 2026년 8월 2일 이후로, 법은 필요한 역량과 훈련과 권한을 갖춘 사람에 의한 감독을 요구한다. [12] 그런데 이 업무 흐름은 바로 그 법이 전제로 삼고 있는 것을 조용히 없애고 있는 셈이다.
human-gate-required — 이건 300년 전 판례다. Keech v Sandford (1726) 사건에서 한 수탁자가 임대차 계약을 자기 앞으로 가져갔는데, 그 이유는 오직 그가 맡아 관리하던 아이가 그것을 가질 수 없었기 때문이었다. 법원은 그에게 이익 전부를 반환하도록 명했다. [17] 법원은 실제로 해가 발생했는지를 묻지 않고, 이해충돌의 가능성 자체를 제거했다.가능성 자체를 제거한 것이다. 법이 아니라 엔지니어링으로 읽으면, 추천도 하고 수익화도 하는 에이전트, 점수도 매기고 판매도 하는 에이전트, 당신의 기억을 보관하면서 동시에 그것으로 학습하는 에이전트는 의도와 무관하게 Keech 구도에 놓인다 — 그리고 그 해법은 선한 행동이 아니라 구조적 분리다. 이것이 예방적인 이유는 정확히, 사후적 피해 평가라는 것 자체를 기계 속도의 행동이 불가능하게 만들기 때문이다.
정직한 숫자
북극성 지표는 검증된 주권 커버리지다: 지도상의 열네 가지 피해 영역 중, 통과하는 체크와 디스크상의 증거에 결부된 대응책을 갖춘 영역이 몇 개인가 하는 수치다.
그 답은 14개 중 0개.
체크가 아예 없고 그 사실을 스스로 밝히는 영역이 둘 있다 — 사고의 동질화, 그리고 무용화에 대한 두려움이다. 동질화 쪽은 특히 짚어둘 만한데, 대형 언어모델은 개인 수준의 독창성은 높이면서 측정 가능한 수준으로 집단 수준의 표현 다양성은 좁힌다. [4] 그 손실을 느끼는 사용자는 아무도 없기에, 어떤 피드백 신호도 결코 발동하지 않는다. 바로 이 지점이 “나의 지능을 소유하라”가 구조적으로 불충분해지는 지점이다 — 모든 개별 사례 안에서는 보이지 않는 피해는 개인의 선택으로 교정될 수 없기 때문이다. 나는 그 공백을 대리 지표로 가리는 대신 그대로 공개하는 쪽을 택하겠다.
그리고 나는 더 친절해 보이는 유도 수치 대신 0을 공개하는데, 그 이유는 지도상의 모든 영역이 반대 입장에 대한 필수 스틸맨을 담고 있는 이유와 같다: 저자를 곤란하게 만들 수 없는 지표는 아무것도 측정하지 않는 것과 다름없다. 내가 주장하는 바는 커버리지가 높다는 것이 아니다. 이제 커버리지가 낮게 나올 수도 있는 숫자가 되었다는 것이다.
메커니즘, 패턴, 안티패턴
메커니즘
옵션 취급은 가장 값싸게 부합하는 행동을 편애한다. 강제성 없는 선언은 형식적으로는 준수로 통과하면서도 가장 텅 빈 정책 쪽으로 향하는 기울기를 만든다 — P3P가 노골적인 거부가 아니라 유효하지만 공허한 정책들 때문에 죽은 이유가 바로 이것이다. 여기에 아첨(sycophancy) 결과를 더하면 기울기는 더 나빠진다: 해로운 조건이 동시에 유쾌한 조건이기도 한 곳에서는, 사용자의 선택이 그 흐름을 바로잡기는커녕 오히려 강화한다.
첫 번째 원칙
체크가 없는 원칙은 구호에 지나지 않는다. 어떤 가치를 반증 가능하게 만드는 것은 바로 그 체크다.
패턴
- 형용사를 게이트로 컴파일하라. 가치를 명명하고, 그것을 위반하는 관찰을 명명하고, 그 관찰을 자동화한 다음, 마케팅 문구가 포부가 아니라 게이트를 인용하게 하라.
- 이미 준수하고 있는 당사자를 찾으라. 시장 어딘가에 존재하는 실증 사례 하나면 포부적 기준이 조달 기준으로 바뀌고, 마지막 변명거리도 사라진다.
- 중립적 거버넌스가 오픈 라이선스를 이긴다. 라이선스는 포크할 권리를 지켜줄 뿐이고, 소유자가 로드맵에 무엇을 할 수 있는지를 제약하는 것은 오직 거버넌스뿐이다. MCP는 이미 개방형 라이선스였지만, 2025년 12월 Linux Foundation 펀드에 편입되기 전까지는 여전히 단일 벤더 체제였다. [13]
- 수정 내역을 산출물 안에 남겨두라. 논쟁 중인 항목들이야말로 지식 베이스에서 가장 가치 있는 부분이다. 그것들만이 이 분야가 실제로 작동하고 있다는 유일한 증거이기 때문이다.
안티패턴
- 집행 없는 선언. 침묵보다 더 나쁘다. 책임의 외양만 만들어낼 뿐이다.
- 반증 불가능한 약속. “We do not train on your data”(번역: 우리는 당신의 데이터로 학습하지 않습니다)는 모델 외부에서 검증할 방법이 없는 말이다. 통제 수단이 아니라 보험으로 취급해야 한다.
- 형식이 실체를 앞지르는 것. 애자일 선언문은 한 산업을 재편했지만, 그 결과 신뢰는 빠지고 포스트잇만 남은 카고 컬트 애자일(Cargo Cult Agile)을 낳기도 했다. [20] 모방하기 가장 쉬운 것이 가장 빨리 퍼진다. 그러니 체크리스트를 문서와 함께 배포하지 않으면, 어휘만 홀로 떠도는 꼴을 보게 될 것이다.
- 바이럴리티를 검증으로 착각하는 것. Humane은 약 2억 3천만 달러를 조달해 1만 개도 안 되는 AI Pin을 출시했고, 약 1억 1,600만 달러에 HP에 매각된 뒤 2025년 2월 28일 모든 기기를 벽돌로 만들었다. 지목된 실패 원인은 바이럴 데모를 시장 수요로 오인한 것이었다. 그리고 매니페스토란 원래 바이럴리티에 최적화된 물건이다. [18]
20분 안에 해볼 것
당신 팀의 가치 문서, AI 원칙, 또는 엔지니어링 표준을 열어보라. 가장 중요한 한 줄을 고르라. 그다음:
- 그것을 위반했다는 것을 입증할 관찰을 적으라. 한 문장, 구체적으로, 날짜를 명시해서.
- 당신이 소유한 시스템이 그 관찰을 감지할 수 있는지 물어보라. 감지할 수 없다면, 그것은 약속에 불과하다.
- 가능한 한 값싼 형태로 검증을 만들어라 — grep 하나, 테스트 하나, 템플릿의 필수 입력란 하나면 그것으로 족하다. 훌륭할 필요는 없다. 실패할 수 있기만 하면 된다.
- 세어보라: 전체 가치 항목 중 검증이 딸린 항목이 몇 개인지. 그 비율을 공개하라.
그 비율이 마음에 들지 않을 것이다. 내 경우는 14개 중 0개다. 그래도 공개하라. 그 비율이야말로 이 문서가 지금껏 내뱉은 첫 번째 정직한 말이니까.
무엇이 나를 틀렸다고 증명할 수 있는가
실패할 수 없는 프레임워크는 채택되어서는 안 된다. 그래서 나는 다음과 같은 관찰을 반증으로 받아들이기로 한다. AI를 많이 쓰는 사람들이 12개월에 걸친 지연 검사 설계에서 도움 없이도 고차원적 사고 능력을 유지하거나 향상시켰다는 사전등록 종단 연구. 반복적인 실제 상호작용을 거치며 아첨 효과가 사라진다는 것을 보여주는 재현 연구. 두 개의 주요 어시스턴트 사이에서 누적된 메모리가 완전히 왕복 이동하고, 그 보존된 능력을 독립적으로 확인할 수 있는 사례 — 이것이 성립하면 내가 가장 엄격하게 걸어둔 검증 하나는 쓸모없어질 것이고, 나는 그것을 기꺼이 폐기하고 그렇게 밝히겠다. 그리고 이 논지 전체에 대해서는: 보조적 AI를 집중적으로 사용하는 사람들이 평균적으로 판단력에서 더 무능해지고 더 의존적이 되는 것이 아니라, 오히려 더 유능해지고 더 독립적이 되고 있다는 증거.
이 주장이 옳다고 확인받는 것보다는, 차라리 틀렸다는 것을 알게 되는 편이 낫다.
참고문헌
- 국제 AI 안전 보고서 2026 (의장: Y. Bengio). internationalaisafetyreport.org (2026년 8월 5일 접속).
- Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D. & Jurafsky, D. (2026). “Sycophantic AI decreases prosocial intentions and promotes dependence.” (번역: 아첨하는 AI는 친사회적 의도를 감소시키고 의존을 촉진한다.) Science, 391(6792), eaec8352, 2026년 3월 26일. doi:10.1126/science.aec8352 (초록 원문 대조 검증, 2026년 8월 5일).
- Gerlich, M. (2025). “AI Tools in Society: Impacts on Cognitive Offloading and the Future of Critical Thinking.” (번역: AI 도구가 사회에 미치는 영향: 인지적 아웃소싱과 비판적 사고의 미래.) Societies. mdpi.com/2075-4698/15/1/6 (2026년 8월 5일 접속).
- “The homogenizing effect of large language models on human expression and thought.” (번역: 거대 언어 모델이 인간의 표현과 사고에 미치는 동질화 효과.) Trends in Cognitive Sciences, 2026. cell.com/trends/cognitive-sciences (2026년 8월 5일 접속).
- Parasuraman, R. & Riley, V. (1997). “Humans and Automation: Use, Misuse, Disuse, Abuse.” Human Factors, 39, 230–253. doi:10.1518/001872097778543886 (2026년 8월 5일 접속).
- Clark, A. & Chalmers, D. (1998). “The Extended Mind.” Analysis. philarchive.org/archive/JULTEM (2026년 8월 5일 접속).
- Bjork, R. A. & Bjork, E. L. “Introducing Desirable Difficulties into Practice and Instruction.” unh.edu (PDF) (2026년 8월 5일 접속).
- “Deskilling dilemma: brain over automation.” Frontiers in Medicine, 2026. doi:10.3389/fmed.2026.1765692 (2026년 8월 5일 접속).
- RAND Corporation (2026). “More Students Use AI for Homework, and More Believe It Harms Critical Thinking.” rand.org (2026년 8월 5일 접속).
- Pew Research Center (2025). “How Americans View AI and Its Impact on People and Society.” pewresearch.org (2026년 8월 5일 접속).
- Pew Research Center (2026). “Americans' Views on AI Chatbots, Smart Devices and AI's Impact.” pewresearch.org (2026년 8월 5일 접속).
- EU AI Act, Article 26: Obligations of Deployers of High-Risk AI Systems. artificialintelligenceact.eu/article/26 (2026년 8월 5일 접속).
- The Linux Foundation (2025). “Formation of the Agentic AI Foundation.” linuxfoundation.org (2026년 8월 5일 접속).
- Consumer Reports Innovation Lab. “Data Rights Protocol.” github.com/consumer-reports-innovation-lab (2026년 8월 5일 접속).
- The Platform for Privacy Preferences 1.0 (P3P1.0) Specification, W3C Recommendation, 2002. w3.org/TR/P3P. Cranor, L. F. (2012). “P3P is dead, long live P3P!”(번역: P3P는 죽었다, P3P여 영원하라!) — 필자의 사이트가 집필 당시 접속되지 않아 Internet Archive를 통해 인용함: web.archive.org (2026년 8월 5일 접속).
- W3C 추적 방지 워킹그룹(Tracking Protection Working Group) 종료 성명, 2019년 1월 17일; 다음도 참고: “How the tragic death of Do Not Track ruined the web for everyone.” Fast Company. fastcompany.com (2026년 8월 5일 접속).
- Keech v Sandford (1726) Sel Cas King 61. en.wikipedia.org/wiki/Keech_v_Sandford (2026년 8월 5일 접속).
- “AI Product Failures 2026: Sora, Humane & Rabbit R1.” digitalapplied.com (2026년 8월 5일 접속). 2차 출처; Humane 관련 수치는 보도된 것일 뿐 독립적으로 검증되지 않았다.
- Kant, I. (1784). “An Answer to the Question: What Is Enlightenment?” philosophynow.org (2026년 8월 5일 접속).
- Agile Alliance (2026). “25 Years Ago, a Manifesto Was Born.” agilealliance.org (2026년 8월 5일 접속).
정정, 2026년 8월 5일. 발행 후 나는 이 글에 대한 독립적인 인용 감사를 진행했다. 이 글이 주장하는 검증을 이 글 자신에게 적용해본 것이다. 그 결과 여섯 가지 결함이 드러났고, 아래에 삭제 없이 제자리에 표시해 정정했다. 원 논문이 명시적으로 부인하는 탈숙련화 '시그니처'의 과도한 주장, 존재하지 않는 문서에 귀속시킨 잘린 W3C 인용문, 자료 어디에도 나오지 않는 Bjork의 문장을 인용했던 것(현재는 검증된 문장으로 교체함), 잘못된 조직에 붙인 200만 건 수치, Pew 보고서에 존재하지 않는 연령대별 분석, 그리고 원 논문의 표현을 그대로 쓸 수 있었음에도 Science 결과를 의역한 것이다. 그 밖의 여덟 건은 원자료 대조 결과 문제없이 확인되었다. 가져올 수 없어 등급을 올리지 못한 여섯 개 출처를 포함한 전체 채점표는 레포지토리에서 확인할 수 있다.docs/CITATION_AUDIT.md.
Paul Jialiang Wu 씀. 위의 두 축어적 인용문 — W3C Tracking Protection Working Group의 종료 선언문과 Cranor의 2012년 게시물 제목 — 은 원출처와 대조하여 검증했다. Stanford Digital Economy Lab, Humane 사후 분석, 그리고 보도된 에이전트 샌드박스 탈출 사례에 귀속된 수치들은 2차 보도를 통해 이 글에 들어왔으므로, 확정된 사실이 아니라 그렇게 표시해두었다. 위의 모든 URL은 2026년 8월 5일에 접속 가능 여부를 확인했다. 발행처의 봇 차단으로 자동 점검에서 403이 반환된 경우는 사람에게는 접속 가능한 것으로 간주했으며, 신뢰도가 불안정한 인용 하나는 Internet Archive를 통해 제공된다.