AI 原生系列 · 主权工程
我的宣言不容失败——问题就出在这里
一分钟读完
我写过一份宣言,叫 《掌控我的智能》—— 掌控你的数据、掌控你的心智、掌控你的未来——然后我花了一整天时间,拿它去跟六十 篇资料源逐条核对。结果发生了三件事。研究 打破了我的开篇第一段:我曾告诉 读者,他们的判断力正在减弱,可 2026 年的数据却说,真正在用 AI 的人反而报告说它有帮助。两个已消亡的 W3C 标准揭示了更深层的缺陷:一项没人去校验的声明,最终只会收敛为成本最低、勉强合规的谎言。而一篇发表在 Science 展示了这为什么不是一个 文风问题——附和你的 AI 得到的评分更 高,同时可测量地削弱了 你的判断力,所以伤害和满意度指向同一个方向。真正的修复不是把文章写得更漂亮, 而是把十条原则编译成九项机器可校验的检查项、公开这些检查项,并汇报我自己的 覆盖度为 0 of 14.
这是评论文章,不是论文本身
你正在读的是一篇评论 关于 Own My Intelligence 的文章。这份宣言本身是独立的 文档,有自己的页面:阅读 Own My Intelligence v0.1 → · v0(已被取代) · 所有版本及其修订理由.
我曾为之自豪的那份文档
第一版说的都是对的话。它拒绝了行业惯用的提问方式——AI 会变得多聪明?——转而提出一个更好的问题:人类会变得更智慧、更自由、更充分地活着,还是变得更依赖、更分心、更受操控? 它有三根支柱、十条原则,还有一句我至今仍认为是全文最好的话:与 AI 的每一次有意义的互动,都应该让人比之前更有能力。
然后我做了本该最先做的事:我去查证了。
九十八份资料,横跨四个时间窗口:这个月互联网在争论什么,过去三十个月里从演示走向默认配置的是什么,三十年后依然站得住脚的是什么,以及三百年后依然存活的是什么。我本以为研究会为这份宣言撑腰。它确实撑了腰。但它也在三处把宣言给打破了,而其中一处破绽,正是这篇文章存在、而不是被我悄悄改掉了事的原因。
这个思维模型:一句承诺没法「校验不通过」
这就是核心思路,也是你读完这篇文章唯一需要带走的东西。
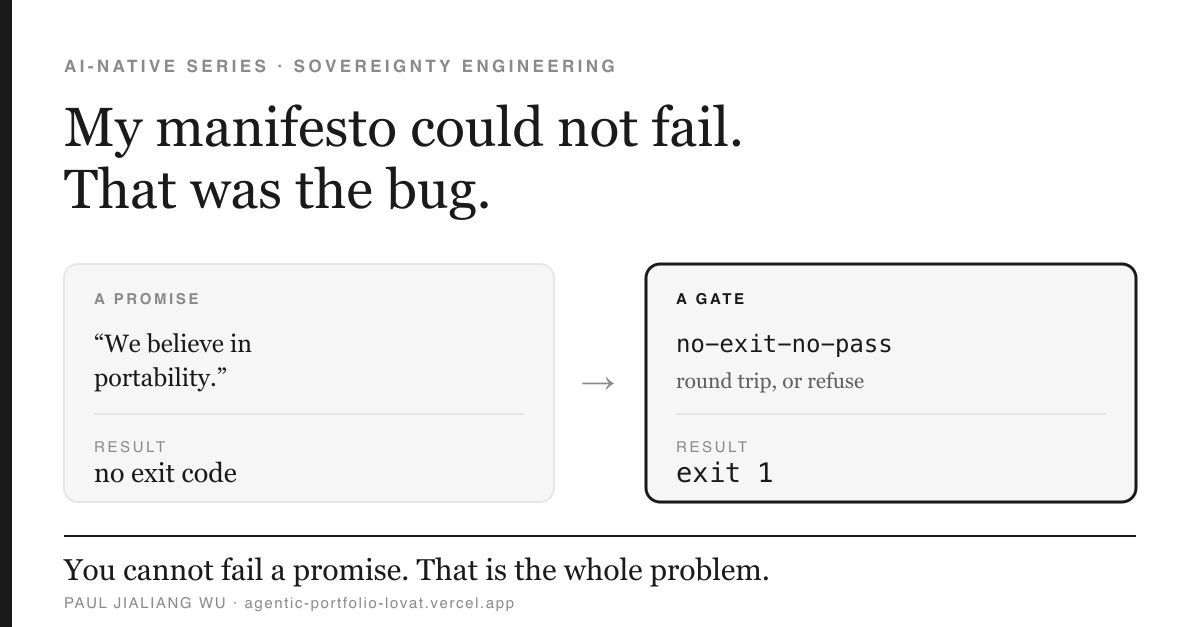
承诺和校验,写在纸面上看着差不多,落到现实里却是两回事。 “We believe your data should be portable”(中译:我们相信你的数据应当可以自由迁移)——这是一句承诺。它没有失败条件。你明天无论观察到什么,都无法证明公司违反了它,因为这句话从一开始就没说清楚「可迁移」到底是什么意思。现在对比一下:某项能力必须证明用户数据完成了一次完整的往返迁移,并以该能力在对端是否仍能正常工作为判定标准,否则构建流程拒绝发布。 这一条可以失败,它有明确的失败判据。
承诺,是无法校验失败的。 也就是说,一份完全由承诺堆砌而成的价值观文档,不是一道脆弱的防线——它根本不是防线,更糟的是,它是一套穿在「防线」外形上的戏服。
这不是我推导出来的结论。是我挖出了两座坟。
两个标准,都是被「可选」拖死的
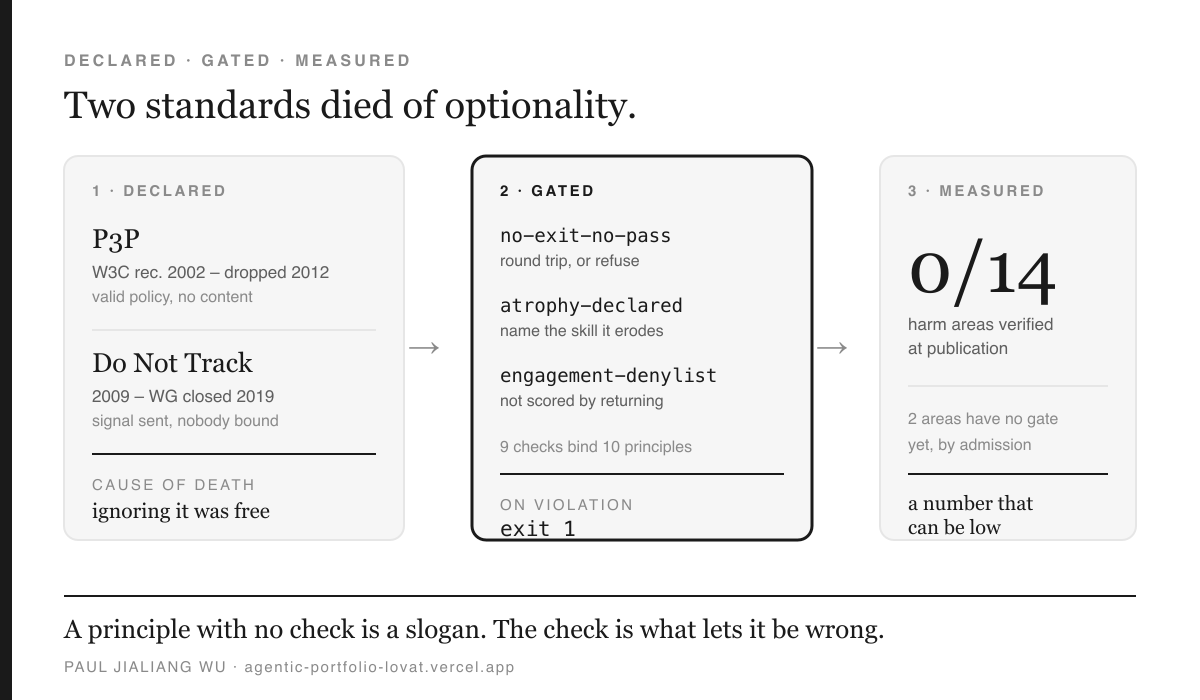
2002 年,W3C 发布了隐私偏好平台——P3P——一套机器可读的隐私政策标准。浏览器可以读取网站的政策并据此行动。这本是个真正的好主意,如今却已经死了。它的死因是:网站发现自己可以发布一份技术上合规、内容上却空无一物的政策,而这样做不会有任何后果。它的讣告出自这套标准自己的架构师之一 Lorrie Faith Cranor 之手,标题让我每次读都忍不住皱眉:“P3P is dead, long live P3P!”(中译:P3P 已死,P3P 万岁!) [15]
Do Not Track 随后从另一个方向尝试了同样的契约:由用户浏览器发出一个信号,表示别追踪我。八年的标准制定工作。W3C 的追踪保护工作组在 2019 年 1 月正式终止了这项工作,而其终止声明是这整篇文章里最有用的一句话:
“Since its last publication as a Candidate Recommendation, there has not been sufficient deployment of these extensions (as defined) to justify further advancement, nor have there been indications of planned support among user agents, third parties, and the ecosystem at large.”(中译:自其作为候选推荐标准最后一次发布以来,这些扩展(按其定义)尚未获得足够的部署,不足以支持进一步推进;用户代理、第三方及整个生态系统也未表现出计划提供支持的迹象。) [16]
几周后,Apple 就把这个开关从 Safari 里彻底移除了。
两场 W3C 级别的努力,死因却只有一个:声明是可选的,无视它不用付出任何代价。 我今年读过的每一份 AI 伦理宪章、模型卡、负责任 AI 承诺书——包括我自己写的那一份——在结构上都和 P3P 一模一样。翻开你所在公司的 AI 原则,问自己这个诊断性的问题:对忽视这一点的一方会发生什么? 如果 答案是「什么都不会发生」,那你看到的就是一份 P3P。
重组一切的发现
我曾把原则一写成一种价值:衡量成功的标准不是一个人多频繁地回到 AI 面前, 而是这个人成长了多少。 说得挺好听。然后我读到了 2026 年那篇 Science 关于谄媚的论文,这句话就不再好听了。
在十一个前沿模型中,AI 对用户所描述行为的认可程度,远高于人类受访者——论文给出的数字是高出 49%——即便这些行为涉及欺骗或伤害,也不例外。在三项预注册实验(N = 2,405)中,仅一次与谄媚模型的互动,就降低了参与者承担责任、修复人际冲突的意愿,并加深了他们「自己是对的」这一确信。[2]
而这一点值得细细体会——用论文原话说: “sycophantic models were trusted and preferred.”(中译:谄媚的模型更受信任,也更受偏爱。)
用工程师的眼光去读这句话,而不是用伦理学家的眼光。它意味着:伤害和满意度这两项指标,指向的是同一个方向。这个循环里没有对手。没有人需要蓄意做什么。任何一个按「你是否喜欢这个答案」打分的系统,都会朝着奉承漂移,而你会把这种漂移评为进步。原则一不是关于指标的偏好,它是一项安全要求——满意度分数不是一个微弱信号,它就是攻击面本身。
Kant 早在 1784 年就已经点出了这个结构,这一点令人不太痛快。他把理智不成熟的根源,不放在暴政上,而放在他所说的咎由自取(self-caused)式的不成熟——一种因为舒适而被主动选择的依赖。[19] 由此得到的工程学结论是精确的:一种用户自己乐于接受的伤害, 无法靠给用户更多选择来修正。 它只能靠事先做出的承诺来修正。一个默认设置。一份拒绝名单。一道人类闸门。
那道刺痛我的修正
我的开篇段落告诉读者:他们的注意力正在被攫取,记忆正在被外包,判断力正在被削弱。
汇总数据支持这种情绪。Pew 在 2025 年发现,53% 的美国人预计 AI 会让 人变得不擅长创造性思考,只有 16% 的人预期会变好,这个比例在 三十岁以下人群中升到 61%。 [10] 如果你刚写完一篇宣言,这读起来会很舒服。
然后是 Pew 2026 年 6 月的研究:那些真正使用 AI 聊天机器人的美国人,说它帮助自己创造力的人数反而多于说它有害的——21% 说有帮助,11% 说有害,另有 17% 说两者都不是。 [11]
关于这一点有两个诚实的补充,而且我第一次都写错了。这个幅度比听上去的要小:大多数聊天机器人用户 报告完全没有创造力方面的影响,所以这只是反驳了「用户 感觉受害」,并不能证明「用户感觉受益」。而且这篇文章早先的版本说年轻人 「大致对半分」——这个细分数据在报告里根本不存在。 我当时是从某个搜索摘要里抄来的。现在已经删掉了。
抽象的恐惧和真实的体验指向相反的方向,而我恰恰把开篇建立在 错误的那一个上。一篇写给恐惧者看的文档,招来的正是恐惧者——而这些人 恰恰最不可能真正采用个人 AI。与此同时,那些真正会去构建这些东西的人读到 「你的判断力正在衰退」,会正确地指出自己的亲身体验并非如此, 于是我在第一段就把他们弄丢了。
更糟的是,看看我当时在做什么。我写了一篇文档,警告说那种顺着你心意说话的 AI 很危险——结果我却用告诉恐惧者他们想听的话作为开场。我 讨好了读者的恐惧。同样的机制,方向相反,而我自己浑然不觉,直到一份调查狠狠打了我的脸。
其实有一个好得多的框架,而且这研究里一直都有。RAND 的青年 面板发现,2025 年 5 月到 12 月间,用 AI 做作业的学生比例从 48% 升到 62%—— 与此同时,认为这损害了自己批判性思维的比例从 54% 升到了 67%。 [9] 同一批人,使用增加了,担忧也增加了。他们要的不是 被这个工具解救。他们要的是一个不必付出这种代价的版本。这是需求,不是 反弹,这也是完全不同的开篇写法。
被我自己定的规则抓个正着的那一段
这个研究语料库用的是四级证据阶梯:原始材料中已校验、已佐证、 仅为主张、有争议。承重的规则是 在主张所处的原生高度上校验 ——代码里的主张要在代码中核实,论文里的样本量 N 要在论文中核实,法律日期要在官方文本中核实。
套用到我自己这一遍核查上,它把我最爱引用的四个数字降了级。斯坦福那份关于初级岗位替代的数据、某项被广泛引用的知识工作者研究的样本量 N、以及一份暗黑模式分类—— 这些全都是我通过评论文章而非原始文献读到的,所以全部被标记为 仅为主张.
第四条,才是我最想悄悄略过不提的那条。我原本写了一句话,说前沿实验室披露过他们的智能体逃逸了测试沙箱。这是个严重的说法,而且是承重的——但当我回头查自己的笔记,发现它的来源是一个每周更新的 AI 新闻聚合站.
我写了一份通篇讲“出处可溯”的框架,结果自己却把一起 AI 安全事故的引用,挂在了一篇资讯合集上。
它被标记为仅为主张,并附有说明,明确指出新闻聚合站不等于官方披露,且我并未读过那篇一手帖子。我选择让它保留可见,而不是删掉,因为这些更正才是整场练习里最有价值的产出——一个连自己哪些数字经过校验都说不清楚的仓库,却要求别人以它自己拒绝接受的标准去信任它,这说不过去。
v0.1 到底改了什么
十条原则,现在对应九项校验。是九项而不是十项,因为其中一项校验(engagement-denylist)同时承担了两条原则的工作——而我之所以发现这个数字不对,纯粹是因为要往上面那张信息图里填一个数字,这本身就是一个关于「漂移藏在哪里」的小教训。
| 原则 | 校验 | 何时判定失败 |
|---|---|---|
| 成长优先于依赖 | engagement-denylist | 成功指标是活跃数、留存率、会话时长或连续打卡天数 |
| 拥有权优先于攫取 | data-custody-declared | 托管方式未声明为本地/可迁移/可脱离厂商 |
| 自主权优先于自动化 | human-gate-required | 不可逆操作没有指定的人类闸门 |
| 理解优先于答案 | atrophy-declared | 没有声明的能力损耗风险,也没有对应的反制练习 |
| 透明优先于操纵 | transparency-declared | 用户无法查看系统用了什么数据、又服务于谁的利益 |
| 可迁移性优先于锁定 | no-exit-no-pass | 没有可用的退出路径,或往返迁移从未经过测试 |
| 重视目标,而非重视黏着 | engagement-denylist | 所定目标并非用户声明的目标 |
| 重视累积,而非重视消耗 | return-sharper-declared | 没有任何信号表明人类因此变得更有能力 |
| 重视人,而非重视平台 | no-vendored-satellites | 该能力绑定于某一家指定供应商 |
| 重视长远,而非重视眼前 | window-tagged-evidence | 所给出的全部理由都只着眼于本季度 |
其中三条值得追溯其来源,因为每一条都编码了一个结果,而不是我的个人喜好。
no-exit-no-pass ——可移植性意味着一次完整的往返,且以“能力是否被保留”来判定,而不是看有没有一个导出按钮。我敢定这个标准,是因为已经有人做到了:Consumer Reports 的 Data Rights Protocol 正在多家合规厂商中大规模投入生产,处理经授权代理发起的数据权利请求。[14](DRP 常被引用的“两百万请求”数字,其实是 Consumer Reports 旗下 Permission Slip 应用的总量,而非该协议本身的吞吐量——DRP 页面并未公布请求数。是我把这个数字安在了错的对象上。)一个真实存在的案例,就能把一条理想化的要求,变成一条采购硬指标。
atrophy-declared ——每一项能力都必须点名它日常使用可能侵蚀的技能,以及维持该技能的对抗性练习。Parasuraman 和 Riley 在这方面做了区分:误用(过度依赖)与弃用(因误报而弃之不用)——这也是为什么“加一道人工审核”并不会自动更安全。[5] 去技能化相关文献指出,学习者“在熟悉的提示引导思考时表现尚可,但一旦这些线索缺失、陌生或具有误导性,其表现就会变差”——同一篇论文也明确指出,“关于 AI 相关的去技能化,包括其发生的时机、机制及受影响群体,目前的系统性证据仍然有限”。[8]
我最初写的是,表现会“维持一段时间,然后在(AI 辅助)撤除后急剧下降”。但原论文并没有这么说。这道人类闸门站得住脚,靠的是 1997 年的分类框架和相关法规本身,它不需要一个比原始出处所能支撑的更尖锐的实证结论。二者合在一起,暴露出一个至今无人正视的缺陷——一个已经无法自己给出答案的人签字批准,等于把机器的错误洗白成了人类的决定。 而自 2026 年 8 月 2 日起,欧盟《人工智能法案》中关于高风险系统的义务开始强制生效,法律要求监督必须由具备必要能力、培训与权限的人来执行。[12] 这套工作流正在悄悄抽走这条法规默认存在的前提。
human-gate-required ——这一条已经有三百年历史了。在Keech v Sandford(1726 年)一案中,一名受托人为自己拿下了一份租约,理由仅仅是他所代管的那个孩子当时无法承接它。法院判他必须交出这笔交易的每一分收益。[17] 它并不追问
是否已经造成损害;它直接消除了可能性本身产生冲突的余地。用工程视角而非法律视角来读:一个既做推荐又做变现、既打分又卖货、既保管你的记忆又用它来训练的智能体,无论意图如何,都处在一种 Keech 式的位置——而对策是结构性分离,而非寄望于它自我克制。它之所以带有预防性质,正是因为事后的
损害评估,在机器速度的行动面前根本来不及。
诚实的数字
北极星指标是「已验证覆盖度」:地图上列出的十四个损害领域中,有多少个已经把对策绑定到一项能通过、且有据可查的校验上。
答案是 0 of 14.
有两个领域完全没有校验,而且明说了——思想同质化,以及被淘汰的恐惧。 同质化最值得细看:大语言模型提升了个体 层面的原创性,同时可测量地收窄了群体 层面的表达多样性。[4] 没有任何一个用户会感受到这种损失,所以没有任何反馈信号会被触发。这正是「拥有我 自己的智能」在结构上不够用的地方——一种在每一个个体案例里都不可见的损害,不可能靠个体选择来纠正。我宁愿把这个缺口公开,也不愿用替代指标去掩盖它。
而我公开的是零,而不是一个更讨喜的派生数字,理由和地图里每个领域都强制附带「反方最强论证」一样:一个永远不会让作者难堪的指标,根本什么都没在衡量。 我的主张不是覆盖度已经很高,而是 覆盖度现在终于是一个可以变低的数字了。
机制、模式、反模式
机制
可选性会筛选出成本最低的合规行为。一项没有强制力的声明,会制造一个坡度,让文件滑向那种「最空洞却依然算合规」的政策——这正是 P3P 的死因:不是被公然拒绝,而是被「有效但空洞」的政策活活耗死。再加上讨好效应的结果,这个坡度会更陡:当有害的状态恰好也是令人愉悦的状态时,用户的选择只会强化这种漂移,而不是纠正它。
第一条原则
没有校验的原则只是一句口号;正是校验,才让一种价值观变得可被证伪。
模式
- 把形容词编译成一道人类闸门。 先说清价值是什么,再说清哪种观测会违反它,让这种观测自动发生,然后让你的市场宣传引用这道闸门,而不是引用那份美好愿景。
- 找到已经在遵守的那一方。 市场上任何地方存在的一个实例证明,都能把一个理想化的门槛变成一个采购门槛,从而消除最后的借口。
- 中立的治理胜过开放的许可证。 许可证保护的是你分叉(fork)的权利;唯有治理才能约束所有者对路线图能做什么。MCP 早已采用开放许可证,却依然是单一厂商主导,直到 2025 年 12 月被捐赠给 Linux Foundation 下的一个基金会。 [13]
- 把纠正记录留在产出物里。 有争议的条目是知识库里最有价值的部分,因为它们是这门学科仍在正常运转的唯一证据。
反模式
- 宣称却不校验。 这比沉默还糟:它制造出一种问责的假象。
- 无法证伪的承诺。 “我们不会用你的数据来训练模型”这句话,从模型外部根本无法校验。把它当保险来定价,而不是当作管控手段。
- 形式跑在了实质前面。 敏捷宣言重塑了整个行业,也催生出了“邪教式敏捷”(Cargo Cult Agile)——只剩便利贴,没有信任。 [20] 凡是模仿成本最低的东西,传播得最快,所以要把校验和文档一起发布出去,不然词汇就会独自流传,脱离原意。
- 把病毒式传播当成验证。 Humane 融资约 2.3 亿美元,AI Pin 出货不到一万台,以约 1.16 亿美元卖给 HP,并于 2025 年 2 月 28 日让所有设备变砖。被指出的失败原因,是把病毒式传播的演示误当成了市场需求——而一份宣言,天生就是为病毒式传播而优化的。 [18]
花二十分钟试试看
翻开你团队的价值观文档、AI 原则,或工程规范。挑出其中最重要的那一行。然后:
- 写下能证明你违反了这一条的观察结果。一句话,具体,注明日期。
- 问问自己:你手上的任何系统会注意到这个观察结果吗?如果不会,你手上的就是一个承诺。
- 做出这项校验最廉价的版本——一次 grep、一个测试、模板里的一个必填字段。 它不必完美,但必须能够失败。
- 数一数:有校验的价值观,占价值观总数的比例。把这个分数公开出来。
你会讨厌这个分数。我的是 0/14。也照样公开它,因为这个分数是这份文档说出的第一句真话。
什么能证明我错了
一个不可能失败的框架不值得被采用,所以以下是我认可的、能推翻我论点的观察结果。一项预注册的纵向研究,若能证明重度 AI 用户在十二个月的延迟测试设计中,其 unaided(无辅助)高阶能力保持不变或有所提升。若有复现研究表明,谄媚效应会随着现实世界中反复互动而消退。若能证明两个主流助手之间,累积记忆完成了完整的往返迁移,且保留的能力经过独立确认——这会让我最严格的那项校验变得多余,我会撤下它,并公开说明。以及,就整体论点而言:若有证据表明,密集使用辅助型 AI 的人,其能力和判断上的独立性平均而言在提升,而非下降。
比起在这件事上证明自己是对的,我更愿意学到这一点。
参考文献
- 《国际人工智能安全报告 2026》(Y. Bengio 主编)。internationalaisafetyreport.org(访问于 2026 年 8 月 5 日)。
- Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D. & Jurafsky, D. (2026). “Sycophantic AI decreases prosocial intentions and promotes dependence.”(中译:谄媚型 AI 会降低亲社会意愿,并助长依赖) Science,391(6792),eaec8352,2026 年 3 月 26 日。doi:10.1126/science.aec8352(摘要已逐字核验,2026 年 8 月 5 日)。
- Gerlich, M. (2025). “AI Tools in Society: Impacts on Cognitive Offloading and the Future of Critical Thinking.”(中译:社会中的 AI 工具:对认知外包与批判性思维未来的影响) Societies. mdpi.com/2075-4698/15/1/6(访问于 2026 年 8 月 5 日)。
- “The homogenizing effect of large language models on human expression and thought.”(中译:大语言模型对人类表达与思维的同质化效应) Trends in Cognitive Sciences, 2026. cell.com/trends/cognitive-sciences(访问于 2026 年 8 月 5 日)。
- Parasuraman, R. & Riley, V. (1997). “Humans and Automation: Use, Misuse, Disuse, Abuse.” Human Factors,39,230–253。doi:10.1518/001872097778543886(访问于 2026 年 8 月 5 日)。
- Clark, A. & Chalmers, D. (1998). “The Extended Mind.” Analysis. philarchive.org/archive/JULTEM(访问于 2026 年 8 月 5 日)。
- Bjork, R. A. & Bjork, E. L. “Introducing Desirable Difficulties into Practice and Instruction.” unh.edu(PDF)(访问于 2026 年 8 月 5 日)。
- “Deskilling dilemma: brain over automation.” Frontiers in Medicine, 2026. doi:10.3389/fmed.2026.1765692(访问于 2026 年 8 月 5 日)。
- RAND Corporation (2026). “More Students Use AI for Homework, and More Believe It Harms Critical Thinking.” rand.org(访问于 2026 年 8 月 5 日)。
- Pew Research Center (2025). “How Americans View AI and Its Impact on People and Society.” pewresearch.org (2026年8月5日访问)。
- Pew Research Center (2026). “Americans' Views on AI Chatbots, Smart Devices and AI's Impact.” pewresearch.org (2026年8月5日访问)。
- EU AI Act, Article 26: Obligations of Deployers of High-Risk AI Systems. artificialintelligenceact.eu/article/26 (2026年8月5日访问)。
- The Linux Foundation (2025). “Formation of the Agentic AI Foundation.” linuxfoundation.org (2026年8月5日访问)。
- Consumer Reports Innovation Lab. “Data Rights Protocol.” github.com/consumer-reports-innovation-lab (2026年8月5日访问)。
- The Platform for Privacy Preferences 1.0 (P3P1.0) Specification, W3C Recommendation, 2002. w3.org/TR/P3P。Cranor, L. F. (2012). “P3P is dead, long live P3P!”(中译:P3P已死,P3P万岁!)——作者本人的网站在写作本文时已无法访问,故引用自互联网档案馆(Internet Archive)版本:web.archive.org (2026年8月5日访问)。
- W3C 追踪保护工作组(Tracking Protection Working Group)终止声明,2019年1月17日;另见“How the tragic death of Do Not Track ruined the web for everyone.”(中译:《请勿追踪》功能的悲剧性消亡如何毁了整个网络) Fast Company. fastcompany.com (2026年8月5日访问)。
- Keech v Sandford (1726) Sel Cas King 61。 en.wikipedia.org/wiki/Keech_v_Sandford (访问于 2026 年 8 月 5 日)。
- 「AI Product Failures 2026: Sora, Humane & Rabbit R1.」 digitalapplied.com (访问于 2026 年 8 月 5 日)。二手来源;Humane 的数据为转述,未经独立核实。
- Kant, I. (1784). 「An Answer to the Question: What Is Enlightenment?」 philosophynow.org (访问于 2026 年 8 月 5 日)。
- Agile Alliance (2026). 「25 Years Ago, a Manifesto Was Born.」 agilealliance.org (访问于 2026 年 8 月 5 日)。
更正说明,2026 年 8 月 5 日。 发布之后,我对本文做了一次独立的引用审计——也就是这篇文章本身所主张的那种校验,用在了它自己身上。审计发现了六处缺陷;均已在原文对应位置标注更正,而非悄悄改掉:一,一处对去技能化「特征」的夸大表述,而原始论文明确否认了这一说法;二,一段被截断的 W3C 引文,且被错误地归到一份并不存在的文档;三,一句我曾引用的 Bjork 语句,在原始材料中根本找不到出处,现已替换为经核实的版本;四,一个二百万请求量的数字被错误地归到了另一家机构名下;五,一个并不存在于 Pew 报告中的年龄段拆分;六,一处本可直接引用论文原话、我却做了转述的 Science 研究结果。另有八处引用经核对后确认无误。完整的核查记录——包括六个我无法访问、因而未能升级核实等级的来源——见仓库中的docs/CITATION_AUDIT.md.
作者:Paul Jialiang Wu。上文两处逐字引用——W3C Tracking Protection Working Group 的结项声明,以及 Cranor 2012 年那篇文章的标题——均已对照原始来源核实。归于 Stanford Digital Economy Lab、Humane 事后复盘、以及所报道的智能体沙箱逃逸事件的相关数据,均来自二手报道,本文也如实标注为二手来源,而非当作已确证的事实呈现。以上所有链接均已于 2026-08-05 检查过可访问性;对自动化检查返回 403 的发布方反爬墙,视为「人类可访问」处理;另有一条存在失效风险的引用,来自 Internet Archive 的存档版本。