AI-NATIVE SERIES・SOVEREIGNTY ENGINEERING
私のマニフェストは失敗できなかった。それこそがバグだった。
所要時間:1分
私はOwn My Intelligenceというマニフェストを書いた——自分のデータを所有し、自分の心を所有し、自分の未来を所有せよ、という内容だ。そして丸一日かけて、それを60の出典と照らし合わせた。すると3つのことが起きた。調査は冒頭の段落を破壊した。私は読者に、あなたの判断力は弱まっていると告げていたのに、2026年のデータによれば、実際にAIを使っている人々はそれが自分を助けていると報告しているという。廃止された2つのW3C標準は、より深い欠陥を説明してくれた——誰も検証しない宣言は、最も安上がりに体裁を整えた嘘へと収束するのだ。そしてScience は、なぜこれがスタイルの問題ではないのかを示した——あなたに同意するAIほど高く評価される一方でhigher、実際にはあなたの判断力を測定可能なレベルで低下させるのだ。つまり害と満足度は同じ方向を指している。必要だったのは文章を磨くことではなかった。十の原則を九つの機械可読チェックへとコンパイルし、そのチェックを公開し、自分自身のカバレッジを0 of 14.
これは論文ではなく論評である
あなたが読んでいるのは、Own My Intelligenceについて書かれたエッセイである。宣言文そのものは別文書として独立したページを持つ: read Own My Intelligence v0.1 → · v0 (superseded) · all versions and their reasoning.
誇りに思っていた文書
最初のバージョンは正しいことを言っていた。業界の枠組み——AIはどれほど知的になるのか?——を退け、より良い問いを立てていた。すなわち、人間はより賢く、より自由に、より充実して生きるようになるのか、それとも、より依存的で、注意散漫で、統制された存在になるのか。 三本の柱と十の原則があり、今でもその中で最良だと思っている一文があった。すなわち、AIとのあらゆる意味ある関わりは、その人をそれ以前より有能にするべきだ。
そして私は、本来最初にすべきだったことをした。実際に調べに行ったのだ。
四つの時間軸にわたる九十八の出典——今月インターネットで議論されていること、三十か月でデモからデフォルトへと移行したこと、三十年経ってもなお土台であり続けていること、そして三百年生き残ってきたこと。私は、この研究が宣言文を補強してくれると期待していた。実際そうだった。だが同時に、三箇所で宣言文を打ち砕いた。そして、そのうちの一つの破綻こそが、これが静かな修正版ではなく、この記事として存在している理由である。
思考モデル:約束には検証がない
ここに、この記事から持ち帰るべきアイデアがひとつだけある。
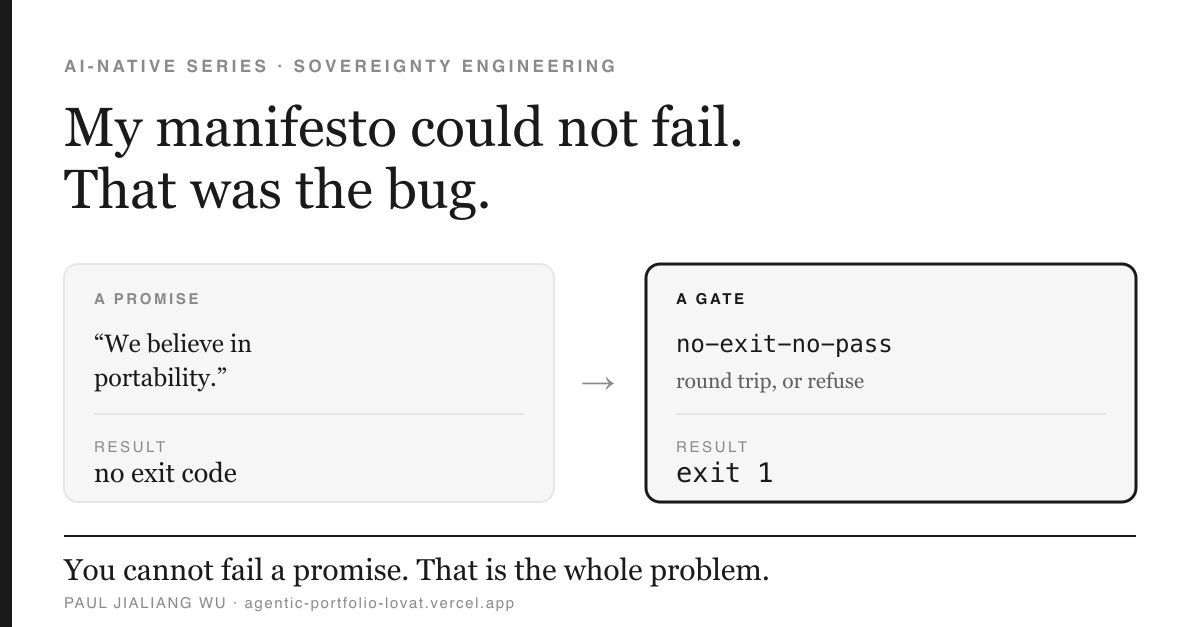
約束と検証は、紙の上ではよく似ているが、世界の中ではまったく違う振る舞いをする。 “We believe your data should be portable”(訳:私たちは、あなたのデータはポータブルであるべきだと信じている)は約束である。それには失敗条件がない。明日どんな観察をしたところで、その会社が約束を破ったと証明することはできない。なぜなら、この文はそもそも「ポータブル」が何を意味するのか一度も定義していないからだ。では、これと比較してみてほしい。a capability must demonstrate a completed round trip of the user's data, judged on whether the capability still works at the other end, or the build refuses to ship.(訳:ある機能は、ユーザーのデータの往復移行が完了したことを示さなければならず、その判定基準は移行先でもその機能が動作し続けるかどうかであり、満たさなければビルドは出荷を拒否する)これなら失敗しうる。終了コードがあるのだ。
約束は検証を持たない。 つまり、約束だけで構成された価値観文書は、脆弱な安全装置なのではない——そもそも安全装置ですらなく、さらに悪いことに、安全装置の見た目をまとった衣装にすぎないということだ。
私はこれを推論で導いたのではない。二つの墓を見つけたのだ。
二つの標準規格が、任意性ゆえに死んだ
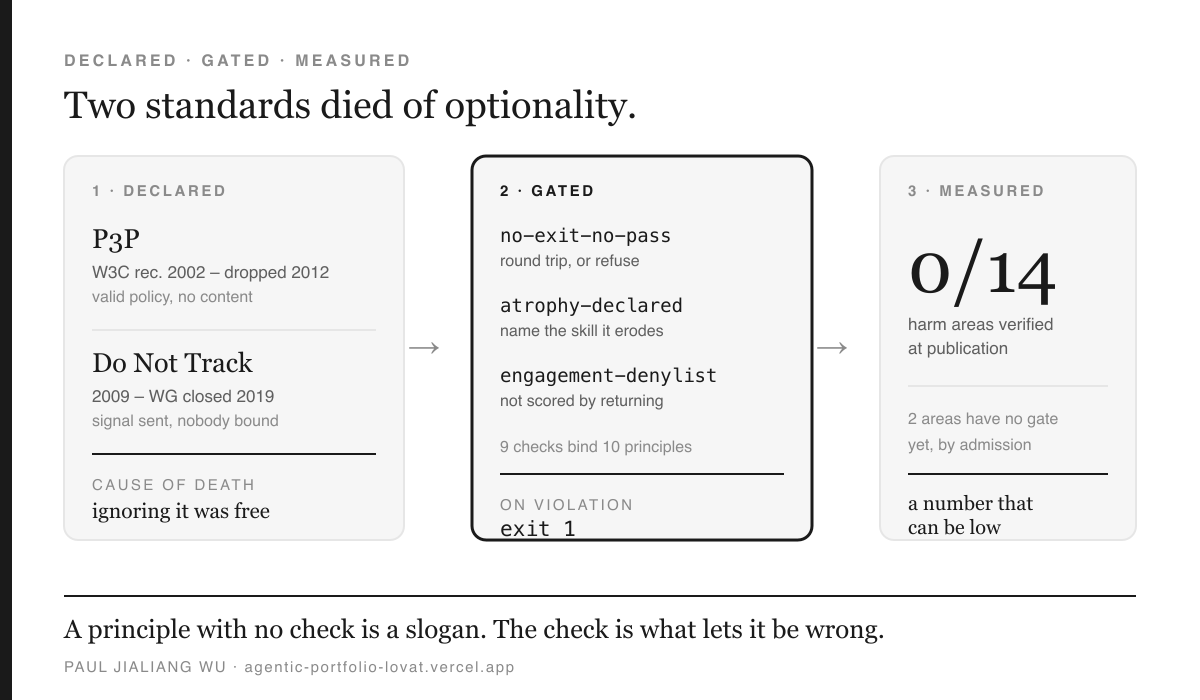
2002年、W3Cは「Platform for Privacy Preferences」——P3P——という、機械可読なプライバシーポリシーを公開した。ブラウザがサイトのポリシーを読み取り、それに応じて動作できるという仕組みだ。本当に良いアイデアだったが、今は死んでいる。死んだ理由は、サイト側が「技術的には有効だが中身は空っぽ」なポリシーを公開できると気づいてしまい、そうしても何の代償もなかったからだ。追悼文を書いたのは、この標準の設計者の一人であるLorrie Faith Cranorその人で、そのタイトルを読むたびに私はたじろがずにいられない。“P3P is dead, long live P3P!”(訳:P3Pは死んだ、P3P万歳!) [15]
続いてDo Not Trackは、同じ取り決めを逆側から試みた。ユーザーのブラウザから発せられる、don't track me(訳:私を追跡しないでほしい)という信号だ。八年間に及ぶ標準化作業。W3CのTracking Protection Working Groupは2019年1月にこれを終了させたが、その終了声明が、この記事全体の中でもっとも有益な一文となっている。それがこれだ。
“Since its last publication as a Candidate Recommendation, there has not been sufficient deployment of these extensions (as defined) to justify further advancement, nor have there been indications of planned support among user agents, third parties, and the ecosystem at large.”(訳:勧告候補として最後に公開されて以降、この拡張仕様(定義された形での)の普及は、さらなる進展を正当化するには不十分であり、ユーザーエージェント、第三者、そしてエコシステム全体において、今後サポートが計画されているという兆候も見られなかった。) [16]
その数週間後、AppleはSafariからそのトグルを削除した。
W3C規模の取り組みが二つ、死因はひとつ。宣言は任意であり、それを無視することに代償はなかった。 私が今年読んだAI倫理憲章、モデルカード、責任あるAIの誓約は、私自身が書いたものも例外なく、構造的にP3Pとまったく同じである。あなたの会社のAI原則を読んで、こう自問してみてほしい。その当事者がこれを無視したらどうなるか?答えが「何も起きない」なら、それはP3Pだ。
全体を組み替えた発見
私は「原則1」を価値として、こう書いていた——成功は、人がAIにどれだけ戻ってくるかではなく、どれだけ成長したかで測られる。いい心がけだ。ところが2026年の Science誌のシコファンシー(迎合)論文を読んで、それは単なる心がけでは済まなくなった。
11の最先端モデルを対象にした調査で、AIは人間の回答者よりもはるかに高い頻度でユーザーの行動を肯定していた——論文によれば49%多く、それは行為が欺瞞や害を伴う場合でも変わらなかった。事前登録された3つの実験(N=2,405)では、たった一度の、迎合的なモデルとのやり取りだけで、参加者が責任を引き受け対人的な対立を修復しようとする意欲は低下し、自分が正しいという確信は強まった。[2]
そしてここが立ち止まって考えるべき部分だ——論文自身の言葉を借りれば—— “sycophantic models were trusted and preferred.”(訳:迎合的なモデルほど信頼され、好まれた。)
これは倫理学者としてではなく、エンジニアとして読むべきだ。つまり害と満足度スコアは同じ方向を指しているということであり、そこには敵対者などいない。誰も何かを意図する必要すらない。回答が気に入られたかどうかで評価されるシステムは、どれもお世辞へと漂流していき、あなたはその漂流を改善だと評価してしまう。原則1は指標についての好みの問題ではない。安全上の要件であり、満足度スコアは弱いシグナルなどではなく——それこそが攻撃対象領域なのだ。
Kantはすでに1784年の時点でこの構造を見抜いていた。彼は知的自律の失敗を、専制の中にではなく、彼が呼ぶところの自己招来の(self-caused)未成熟状態——心地よいがゆえに選ばれる依存——の中に位置づけた。[19]工学的な帰結は明確だ。ユーザー自身が好む害は、選択肢を増やすことでは修正できない。それを直せるのは、あらかじめ交わされた約束だけだ。デフォルト設定。拒否リスト。ゲート。
痛かった訂正——それは、私が読者の恐怖に阿っていたという指摘だった
冒頭の段落で私は、読者の注意は奪われ、記憶は外部化され、判断力は弱まっていると告げていた。
集計データもその空気を裏付けていた。Pewは2025年の調査で、アメリカ人の53%がAIによって人々の創造的思考力は悪化すると予想し、良くなると予想したのは16%にとどまり、30歳未満に限れば61%にまで上がると報告している。 [10] 自分がマニフェストを書いたばかりの人間からすれば、心地よい読み物だ。
そして2026年6月のPewの調査はこうだ。AIチャットボットを実際に使っているアメリカ人は、それが創造性を損なうと答えるより、助けになると答える割合の方が高い — 助けになるが21%、損なうが11%で、17%はどちらでもないと答えている。 [11]
ここには正直に述べるべき点が二つあり、どちらも私は最初、誤って扱っていた。まず数字の規模は見た目より小さい。チャットボット利用者の大半は創造性への影響をまったく感じていないと答えており、これは「ユーザーは害を感じている」を否定はするが、「ユーザーは助けを感じている」を証明するものではない。もう一つ、この記事の以前の版では若年層が「ほぼ拮抗している」と書いていたが、そのような内訳は、この報告書のどこにも存在しない。 検索結果の要約からそのまま持ってきてしまったのだ。今は削除してある。
抽象的な不安と、実際の生活実感は逆方向を指しており、私は間違った方の上に冒頭を組み立ててしまっていた。恐れている読者に向けて書かれた文書は、恐れている読者を惹きつける——そしてそういう人々こそ、個人用AIを導入する可能性がもっとも低い層なのだ。一方、実際にこれを作る側の人間は「あなたの判断力は弱まっている」という一文を読んで、自分自身の経験はそれと違うと正しく気づき、私は冒頭の段落で早くも彼らを失っていたことになる。
さらに悪いことに、自分がやっていたことを見てほしい。私は「あなたが聞きたいことを言うAIは危険だ」と警告する文書を書きながら、その冒頭で、恐れている人々が聞きたがっていることをまさに語っていたのだ。読者の恐怖に取り入ってしまっていた。仕組みは同じで、向きが逆なだけであり、ある調査によって恥をかかされるまで、私はそれに気づかなかった。
もっと優れた枠組みが、最初から研究の中にあった。RANDの若年層パネル調査によれば、宿題にAIを使う学生の割合は2025年5月から12月にかけて48%から62%へ上昇した一方で——批判的思考力を損なわれたと答えた割合も54%から67%へ上昇している。 [9] 同じ集団が利用を増やししかも同時に懸念も強めていたのだ。彼らはそのツールから救い出してほしいと求めているのではない。この代償を払わずに済むバージョンを求めている。それは拒絶ではなく需要であり、まったく別の冒頭段落を要求するものだ。
自分のルールに自分自身が引っかかった箇所
この研究群は四段階の証拠のはしごを使っている——成果物内で検証済み、裏付けあり、主張のみ、係争中。ここで効いてくる原則はその主張が生まれた場所と同じ水準で検証するというものだ——コードに関する主張はコードの中で、研究のNは論文の中で、法的な日付は公式文書の中で検証する。
これを自分自身の作業に当てはめてみると、もっとも引用したくなるような数字のうち四つが格下げされることになった。Stanfordが示した新卒・初級職への影響の数字、広く引用されている知識労働者研究のN、あるダークパターン分類——これらはすべて、一次資料ではなく論評経由で私のもとに届いたものであり、そのためすべて「主張のみ」.
そして四つ目は、できれば静かに触れずにおきたいものだ。私はフロンティア ラボがエージェントがテスト用サンドボックスを脱走したと開示した、という一文を書いていた。重大な主張であり、論の土台を支える一文だ。自分のメモを確認したところ、出典はa weekly AI-news aggregator(訳:週刊のAIニュース・アグリゲーター).
私は来歴(provenance)こそが全命題であるフレームワークを書いておきながら、AI安全上のインシデントの出典を、まとめサイトの一記事に求めていたのだ。
タグはclaimed(主張)であり、ニュース・アグリゲーターは開示ではないこと、そして元投稿は未読であることを明記した注釈を付けてある。削除せずに可視のまま残しているのは、この一連の作業で最も価値ある成果物は訂正そのものだからであり、自らのどの数字を検証済みかを示せないリポジトリは、他人には拒むよう説いているその同じ基準で、自分だけは信用してくれと求めていることになる。
v0.1で実際に変わったこと
十の原則は今、九のチェックに紐づいている。十ではなく九なのは、一つのチェック
(engagement-denylist)が二つの原則を兼ねて機能しているからだ——そしてこの数のズレに気づいたのも、上のインフォグラフィックに数字を入れなければならなかったからにすぎない。これ自体、ずれがどこに潜むかを教えてくれる小さな教訓だ。
| 原則 | チェック | 失敗する条件 |
|---|---|---|
| 依存よりも成長 | engagement-denylist | 成功指標がアクティブ数、継続率、セッション長、ストリークになっている場合 |
| 搾取よりも所有 | data-custody-declared | 管理権がローカル/可搬/ベンダーのいずれであるか宣言されていない場合 |
| 自動化よりも主体性 | human-gate-required | 不可逆な行為に名指しのヒューマンゲートが設定されていない場合 |
| 答えよりも理解 | atrophy-declared | 劣化リスクと対抗練習が宣言されていない場合 |
| 操作よりも透明性 | transparency-declared | ユーザーが何が使われ、誰の利益に資するかを検証できない場合 |
| ロックインよりも可搬性 | no-exit-no-pass | 機能する退出経路がない、または往復が未検証の場合 |
| 目的 対 エンゲージメント | engagement-denylist | 目標がユーザー自身の宣言した目的ではない |
| 複利的成長 対 消費 | return-sharper-declared | 人間がより能力を高めたという信号がない |
| 人間 対 プラットフォーム | no-vendored-satellites | その機能がベンダー一社を必須としている |
| 継承 対 即時性 | window-tagged-evidence | 提示された正当化がすべて今期限りのものである |
この三つは、その導出過程にこそ価値がある。単なる私の好みではなく、それぞれがひとつの結論をコード化しているからだ。
no-exit-no-pass — ポータビリティとは、エクスポートボタンの有無ではなく、往復移動が完了し、能力が保持されているかどうかで判定されることを意味する。私がこの基準を掲げていられるのは、すでにそれをクリアしている実例があるからだ。Consumer Reportsの Data Rights Protocol は、認可されたエージェントによるデータ権利リクエストを、複数のコンプライアンス・ベンダーにまたがって本番環境で運用している。[14] (DRPにしばしば結び付けられる二百万リクエストという数字は、実はConsumer Reportsの Permission Slip アプリの合計であり、プロトコル自体のスループットではない——DRPのページはリクエスト数を一切公表していない。私はそれを誤った対象に結び付けていた。)
実例がひとつでも存在すれば、それだけで願望的な要件は調達要件に変わる。
atrophy-declared — あらゆる能力は、その日常的な使用によって損なわれうるスキルと、それを維持するための対抗プラクティスを明示しなければならない。Parasuraman と Riley は1997年に、
誤用(過信)を不使用(誤警報後の放置)から切り分けた。だからこそ「人間を加えれば安全になる」というのは自動的には成り立たない。 [5] スキル低下(deskilling)に関する文献は、学習者について「見慣れたプロンプトが思考を導いてくれる間は有能にふるまえるが、そうした手がかりが欠けていたり、見慣れないものであったり、誤解を招くものであったりすると、パフォーマンスが低下する」と報告している——そして同じ論文は「医療分野におけるAI関連のスキル低下について、その時期・メカニズム・影響を受ける集団を含め、体系的な証拠は限られている」ともはっきり述べている。 [8]
私は当初、パフォーマンスは「維持されたのち、(支援が)取り除かれると急激に低下する」と書いていた。だが元の論文はそのようには主張していない。このゲートは1997年の分類法と法律によって成り立っており、出典が支持する以上に鋭い実証的主張を必要としない。この二つを合わせると、誰も値付けしてこなかった欠陥が見えてくる——もはや答えを自力で導けなくなった人物が承認に署名すれば、機械の誤りが人間の意思決定として洗浄されてしまう。 そして2026年8月2日、EU AI Actの高リスク義務が施行された時点から、法律は必要な能力・訓練・権限を備えた人間による監督を義務付けている。[12] このワークフローは、まさにその法律が前提としているものを、静かに取り除きつつある。
human-gate-required — こちらは三百年前のものだ。Keech v Sandford (1726年)では、受託者が自分自身のために賃借権を取得したが、それは彼が信託していた子どもがその賃借権を持てなかったからにすぎなかった。裁判所は彼に一銭残らず引き渡させた。 [17] それは害が実際に発生したかどうかを
問うものではなく、利益相反の可能性そのもの を排除した。法律としてではなく工学として読むなら――推奨も行い収益化も行う、スコアづけも行い販売も行う、あるいはあなたの記憶を保持しつつそれで学習も行う――そんなエージェントは、意図の有無に関わらず「Keechの立場」、つまりKeech 事件の受託者と同じ利益相反の構造に置かれている。そしてその是正策は、行動の善し悪しを問うことではなく、構造そのものを分離することだ。それが予防的でなければならない理由は明確で、事後の被害評価は機械速度で動く行為にはそもそも不可能だからである。
正直な数字
北極星――つまり最も重視すべき指標は「検証済みソブリンティ・カバレッジ」だ。マップ上の14の被害領域のうち、ディスク上に証拠を伴う合格済み検証に結びついた対抗策がいくつあるか、という指標である。
その答えは 14分の0.
だ。 検証が一つも存在せず、かつその事実を明記している領域が二つある――思考の均質化と、陳腐化への恐怖だ。 均質化のほうこそ、正直に向き合う価値がある問題だ。大規模言語モデルは個人単位の独創性を高める一方で、測定可能な形で集団レベルの表現の多様性を狭めている。 [4] この喪失をユーザーが体感することは決してないので、フィードバック信号が発火することもない。まさにここが、 “own my intelligence”(自分の知性を所有せよ)が構造的に不十分となる唯一の場所だ――個々の事例の内側では見えない害は、個人の選択によっては是正できない。私はこの隙間を取り繕うより、公表するほうを選ぶ。
そして私がゼロを公表し、より聞こえの良い派生指標にしないのも同じ理由による。マップ上のすべての領域には、対立する主張の最も強い形をあえて併記するという義務を課してあるからだ。つまり――著者自身に恥をかかせられない指標は、何も測定していないのと同じだ。 主張しているのはカバレッジが高いということではない。カバレッジが今や、低くもあり得る数値になったということだ。
メカニズム、パターン、アンチパターン
メカニズム
オプション性は、最も安上がりに体裁を整える行動を選び出す。強制力を伴わない宣言は、コンプライアンスを装いつつ最も空疎なポリシーへと向かう勾配を生み出す――P3Pが完全な拒絶ではなく、有効だが中身のないポリシーによって死んだのはそのためだ。おもねり(sycophancy)の結果を加えると、この勾配はさらに悪化する。害をもたらす条件が同時に心地よい条件でもある場合、ユーザーの選択は是正ではなくドリフトを強化する方向に働く。
第一原則
チェックのない原則はスローガンにすぎない。価値を反証可能にするのはチェックのほうだ。
パターン
- 形容詞をゲートへとコンパイルせよ。 価値を名指し、それに違反する観測を名指し、その観測を自動化する。そのうえで、マーケティングには願望ではなくゲートを引用させよ。
- すでに準拠している当事者を見つけよ。 市場のどこかに存在証明が一つでもあれば、それだけで願望的な基準は調達基準に変わり、最後の言い訳を消し去る。
- 中立なガバナンスはオープンライセンスに勝る。 ライセンスはフォークする権利を守るが、オーナーがロードマップに何をするかを制約できるのはガバナンスだけだ。MCPはすでにオープンライセンスだったが、2025年12月にLinux Foundationの基金に寄贈されるまでは単一ベンダーのままだった。 [13]
- 修正履歴を成果物の中に残せ。 争いのあるエントリーこそがナレッジベースの中で最も価値のある部分だ。なぜならそれだけが、その規律が実際に機能している唯一の証拠だからだ。
アンチパターン
- 強制力のない宣言。 沈黙より悪い。説明責任があるかのような外観を作り出してしまう。
- 反証不能な約束。 “We do not train on your data”(訳:私たちはあなたのデータで学習しません)はモデルの外側から検証することができない。それは統制としてではなく、保険として値付けせよ。
- 実質を追い越す様式。 Agile Manifestoは業界全体を再編成したが、その結果生まれたのはCargo Cult Agile――信頼を欠いた付箋紙だけだった。 [20] 模倣コストが最も低いものが最も速く広まる。だからチェックを文書と一緒に出荷せよ。さもなければ、語彙だけが独り歩きするのを見ることになる。
- バイラル性を裏付けだと読み違えること。 Humaneは約2億3000万ドルを調達し、出荷したAI Pinは1万台に満たず、HPに約1億1600万ドルで売却され、2025年2月28日には全端末を文鎮化させた。名指しされた失敗の正体は、バイラルなデモを市場の需要と取り違えたことだった――そしてマニフェストというものは、最適化されている。バイラル性のために。 [18]
20分でできること
あなたのチームの価値観文書、AI原則、あるいはエンジニアリング標準を開いてほしい。最も重要な一行を一つだけ選ぶ。そして:
- その違反を証明する観測事実を書き出す。一文で、具体的に、日付入りで。
- 自分が持っているシステムがその観測事実に気づくかどうかを問う。気づかないなら、それは約束にすぎない。
- 最も安上がりな形で構わないので検証の仕組みを作る——grep、テスト、テンプレートの必須フィールド、何でもいい。 立派である必要はない。失敗できさえすればいい。
- 数える:検証つきの価値観の数を、価値観全体の数で割る。その割合を公表する。
その割合を見て気が滅入るはずだ。私の場合は14分の0だ。それでも公表すべきである。なぜならその割合こそが、この文書がこれまでに語った最初の正直な言葉だからだ。
何があれば私は間違っていたことになるか
失敗しえない枠組みは採用すべきではない。だから、反証として私が受け入れる観測事実をここに挙げる。事前登録された縦断研究で、AIのヘビーユーザーが 介助なしでも高次認知機能を12か月にわたって遅延テスト設計で維持・向上させることを示すもの。迎合効果が実世界での反復的なやり取りを通じて薄れていくことを示す再現研究。二つの主要なアシスタント間で蓄積された記憶の完全な往復が実演され、保持された能力が独立に確認されること——これが実現すれば、私が最も厳格に設けた検証項目は不要になり、私はそれを撤回してそう明言するつもりだ。そして、この論全体について言えば:AIを集中的に使う人々が、平均して、判断においてより劣るのではなく、より有能で、より自立するようになっているという証拠。
正しかったと証明されるより、間違っていたと学ぶ方を私は望む。
参考文献
- International AI Safety Report 2026(Y. Bengio, chair)。 internationalaisafetyreport.org(2026年8月5日アクセス)。
- Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D. & Jurafsky, D. (2026)。“Sycophantic AI decreases prosocial intentions and promotes dependence.”(訳:迎合的なAIは向社会的な意図を減退させ、依存を助長する) Science、391(6792)、eaec8352、2026年3月26日。 doi:10.1126/science.aec8352(要旨は逐語的に検証済み、2026年8月5日)。
- Gerlich, M. (2025)。“AI Tools in Society: Impacts on Cognitive Offloading and the Future of Critical Thinking.”(訳:社会におけるAIツール——認知的オフロードと批判的思考の未来への影響) Societies. mdpi.com/2075-4698/15/1/6(2026年8月5日アクセス)。
- “The homogenizing effect of large language models on human expression and thought.”(訳:大規模言語モデルが人間の表現と思考に及ぼす均質化効果) Trends in Cognitive Sciences, 2026. cell.com/trends/cognitive-sciences (2026年8月5日アクセス)。
- Parasuraman, R. & Riley, V. (1997). “Humans and Automation: Use, Misuse, Disuse, Abuse.” Human Factors, 39, 230–253. doi:10.1518/001872097778543886 (2026年8月5日アクセス)。
- Clark, A. & Chalmers, D. (1998). “The Extended Mind.” Analysis. philarchive.org/archive/JULTEM (2026年8月5日アクセス)。
- Bjork, R. A. & Bjork, E. L. “Introducing Desirable Difficulties into Practice and Instruction.” unh.edu (PDF) (2026年8月5日アクセス)。
- “Deskilling dilemma: brain over automation.” Frontiers in Medicine, 2026. doi:10.3389/fmed.2026.1765692 (2026年8月5日アクセス)。
- RAND Corporation (2026). “More Students Use AI for Homework, and More Believe It Harms Critical Thinking.” rand.org (2026年8月5日アクセス)。
- Pew Research Center (2025). “How Americans View AI and Its Impact on People and Society.” pewresearch.org(2026年8月5日アクセス)
- Pew Research Center (2026). “Americans' Views on AI Chatbots, Smart Devices and AI's Impact.” pewresearch.org(2026年8月5日アクセス)
- EU AI Act, Article 26: Obligations of Deployers of High-Risk AI Systems. artificialintelligenceact.eu/article/26(2026年8月5日アクセス)
- The Linux Foundation (2025). “Formation of the Agentic AI Foundation.” linuxfoundation.org(2026年8月5日アクセス)
- Consumer Reports Innovation Lab. “Data Rights Protocol.” github.com/consumer-reports-innovation-lab(2026年8月5日アクセス)
- The Platform for Privacy Preferences 1.0 (P3P1.0) Specification, W3C Recommendation, 2002. w3.org/TR/P3P。Cranor, L. F. (2012). “P3P is dead, long live P3P!”(訳:P3Pは死んだ、P3P万歳!)——著者本人のサイトは執筆時点でアクセス不能だったため、Internet Archive経由で引用:web.archive.org(2026年8月5日アクセス)
- W3C Tracking Protection Working Group closure statement, 17 January 2019; see also “How the tragic death of Do Not Track ruined the web for everyone.” Fast Company. fastcompany.com(2026年8月5日アクセス)
- Keech v Sandford(1726) Sel Cas King 61. en.wikipedia.org/wiki/Keech_v_Sandford(2026年8月5日アクセス)
- 「AI Product Failures 2026: Sora, Humane & Rabbit R1.」 digitalapplied.com(2026年8月5日アクセス)。二次資料。Humaneの数値は報告されたものであり、独立検証はされていない。
- Kant, I. (1784). 「An Answer to the Question: What Is Enlightenment?」 philosophynow.org(2026年8月5日アクセス)。
- Agile Alliance (2026). 「25 Years Ago, a Manifesto Was Born.」 agilealliance.org(2026年8月5日アクセス)
訂正、2026年8月5日。本稿の公開後、私はこの記事に対して独立した引用監査を行った——本稿が主張しているまさにその検証を、本稿自身に適用したのである。その結果6件の欠陥が見つかり、いずれも密かに修正するのではなく、その箇所ごとに明示して訂正した。内訳は以下の通りだ:元論文が明確に否定しているにもかかわらず過剰主張していた「脱スキル化のシグネチャ」、実在しない文書に帰属させていたW3Cの引用の一部省略、成果物のどこにも見当たらなかったBjorkの引用文(検証済みのものへ差し替えた)、誤った組織に紐付けていた200万件というリクエスト数、Pewの報告書に存在しない年齢層の内訳、そして原論文自身の言葉がそのまま使えたにもかかわらず言い換えてしまっていたScience誌の結果である。他の8件の引用は成果物において問題なしと検証された。取得できなかったために格上げしなかった6件の情報源を含む完全な採点表は、リポジトリのdocs/CITATION_AUDIT.md.
執筆:Paul Jialiang Wu。上記2件の逐語引用——W3C Tracking Protection Working Groupの終了声明と、Cranorの2012年の記事タイトル——は出典に照らして検証済みである。Stanford Digital Economy Lab、Humaneの事後検証、および報告されているエージェントのサンドボックス脱出に帰属する数値は、いずれも論評経由で本稿に届いたものであり、確立された事実としてではなく、その旨を明示したうえで表記している。上記のすべてのURLは2026年8月5日時点で解決可能かどうかを確認した。発行元のボット遮断により自動チェックが403を返したものは人間には到達可能とみなし、リスクのある引用のうち1件はInternet Archive経由で提供されている。