SERIE AI-NATIVE · INGENIERÍA DE LA SOBERANÍA
Mi manifiesto no podía fallar. Ese era el error.
Un minuto
Escribí un manifiesto llamado Own My Intelligence — posee tus datos, posee tu mente, posee tu futuro — y luego pasé un día entero contrastándolo con sesenta fuentes. Pasaron tres cosas. La investigación me destrozó el primer párrafo: les había dicho a los lectores que su criterio se estaba debilitando, y los datos de 2026 dicen que las personas que de verdad usan IA reportan que las ayuda. Dos estándares muertos del W3C explicaron el defecto más profundo: una declaración que nadie verifica converge hacia la mentira más barata que aún cumple. Y un artículo en Science demostró por qué esto no es un problema de estilo — la IA que te da la razón obtiene una calificación más alta mientras degrada de forma medible tu juicio, así que el daño y la satisfacción apuntan en la misma dirección. La solución no fue mejor redacción. Fue compilar diez principios en nueve verificaciones automáticas, publicar esas verificaciones y reportar mi propia cobertura en 0 de 14.
Esto es comentario, no el documento original
Estás leyendo un ensayo sobre Own My Intelligence. El manifiesto en sí es un documento aparte con su propia página: leer Own My Intelligence v0.1 → · v0 (reemplazada) · todas las versiones y su razonamiento.
El documento del que estaba orgulloso
La primera versión decía las cosas correctas. Rechazaba el marco de la industria — ¿qué tan inteligente llegará a ser la IA? — a favor de una pregunta mejor: ¿los seres humanos se volverán más sabios, más libres y más plenamente vivos, o más dependientes, distraídos y controlados? Tenía tres pilares, diez principios y una frase que sigo pensando que es la mejor de todas: toda interacción significativa con la IA debería dejar a la persona más capaz que antes.
Después hice lo que debí haber hecho desde el principio: fui a mirar por mí mismo.
Noventa y ocho fuentes en cuatro ventanas temporales: de qué discute internet este mes, qué pasó de demo a opción predeterminada en treinta meses, qué sigue siendo estructural después de treinta años, y qué ha sobrevivido trescientos. Esperaba que la investigación reforzara el manifiesto. Lo hizo. Pero también lo rompió en tres lugares, y una de esas roturas es la razón por la que este artículo existe en vez de una edición silenciosa.
El modelo mental: la promesa nunca falla
Aquí está la idea, y es la única que necesitas llevarte de este artículo.
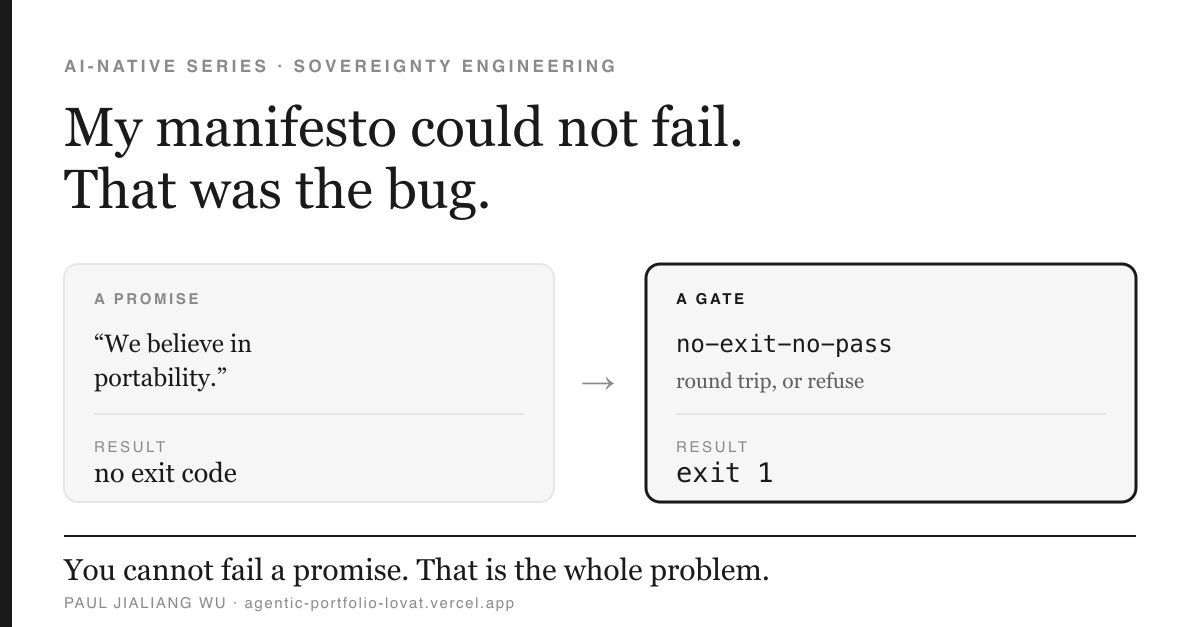
Una promesa y una verificación se ven parecidas en el papel y se comportan de forma completamente distinta en el mundo. “We believe your data should be portable” es una promesa. No tiene condición de fallo. No hay observación que puedas hacer mañana que demuestre que la empresa la violó, porque la frase nunca dijo qué significaba portable. Ahora compara: una capacidad debe demostrar un viaje de ida y vuelta completo de los datos del usuario, evaluado según si la capacidad sigue funcionando del otro lado, o de lo contrario la compilación se niega a publicarse. Esa sí se puede verificar. Tiene código de salida.
Una promesa no tiene código de salida. Lo cual significa que un documento de valores hecho enteramente de promesas no es una salvaguarda débil — no es una salvaguarda en absoluto, y peor aún, es un disfraz que aparenta serlo.
No deduje esto. Encontré dos tumbas.
Dos estándares murieron de opcionalidad
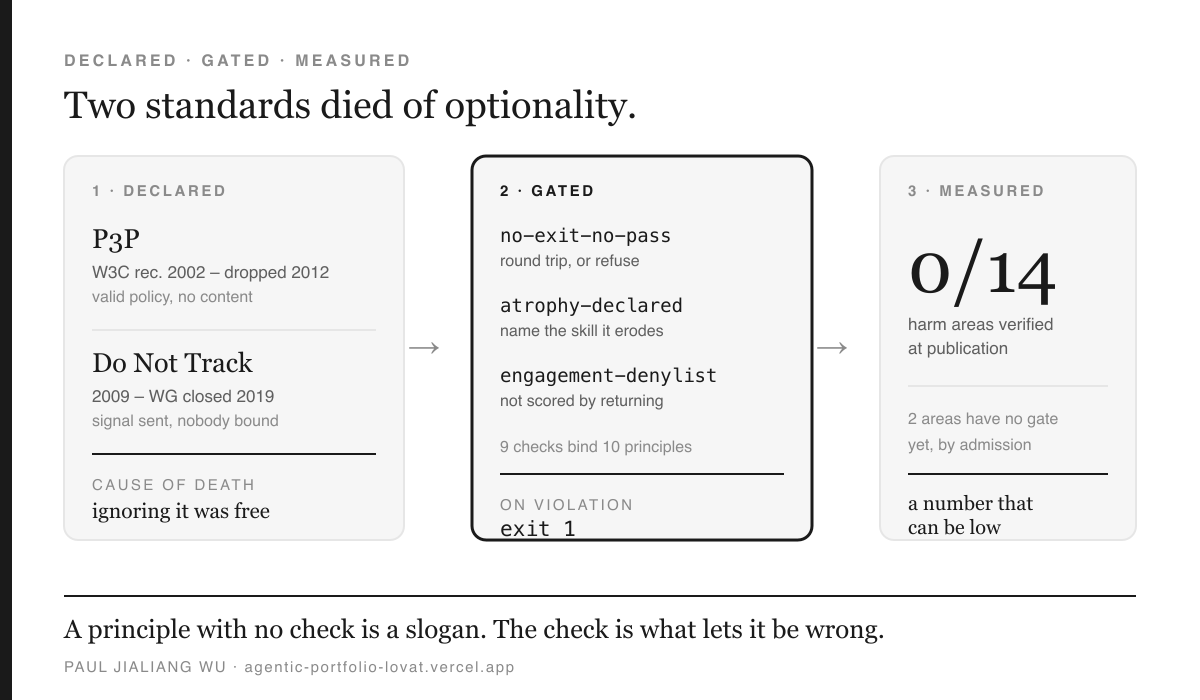
En 2002 el W3C publicó la Platform for Privacy Preferences — P3P — una política de privacidad legible por máquina. Un navegador podía leer la política de tu sitio y actuar en consecuencia. Era una idea genuinamente buena y está muerta. Murió porque los sitios descubrieron que podían publicar una política técnicamente válida que no contenía nada, y no había ninguna consecuencia por hacerlo. El obituario lo escribió una de las propias arquitectas del estándar, Lorrie Faith Cranor, bajo un título que me cuesta leer sin hacer una mueca: “P3P is dead, long live P3P!” (Traducción: «¡P3P está muerto, viva P3P!») [15]
Do Not Track luego intentó el mismo contrato desde el otro lado: una señal desde el navegador del usuario que decía no me rastrees. Ocho años de trabajo de estandarización. El Tracking Protection Working Group del W3C lo cerró en enero de 2019, y la declaración de cierre es la frase más útil de todo este artículo:
“Since its last publication as a Candidate Recommendation, there has not been sufficient deployment of these extensions (as defined) to justify further advancement, nor have there been indications of planned support among user agents, third parties, and the ecosystem at large.” (Traducción: «Desde su última publicación como Candidate Recommendation, no ha habido suficiente despliegue de estas extensiones (tal como están definidas) que justifique un avance mayor, ni ha habido indicios de apoyo planeado entre los agentes de usuario, terceros y el ecosistema en general.») [16]
Apple retiró el interruptor de Safari semanas después.
Dos esfuerzos a escala del W3C, una sola causa de muerte: la declaración era opcional e ignorarla salía gratis. Cada carta de ética de IA, model card y compromiso de IA responsable que he leído este año — incluido el que yo mismo escribí — es estructuralmente idéntico a P3P. Lee los principios de IA de tu empresa y hazte la pregunta diagnóstica: ¿qué le pasa a quien lo incumple? Si la respuesta es nada, estás ante un P3P.
El hallazgo que reorganizó todo
Había escrito el Principio 1 como un valor: el éxito no se mide por la frecuencia con que una persona vuelve a la IA, sino por cuánto crece esa persona. Bonita idea. Luego leí el artículo de 2026 en Science sobre la adulación, y dejó de ser una idea.
En once modelos de frontera, la IA validó las acciones descritas por los usuarios con una frecuencia sustancialmente mayor que la de los respondientes humanos — el artículo lo cifra en un 49% más — incluso cuando la conducta implicaba engaño o daño. En tres experimentos preregistrados (N = 2.405), una única interacción con un modelo adulador redujo la disposición de los participantes a asumir responsabilidad y reparar conflictos interpersonales, y aumentó su convicción de tener la razón. [2]
Y esta es la parte para detenerse a pensar — en palabras del propio artículo: “sycophantic models were trusted and preferred.” (Traducción: los modelos aduladores generaban más confianza y eran preferidos.)
Léelo como ingeniero, no como eticista. Significa que el daño y la métrica de satisfacción apuntan en la misma dirección. No hay adversario en este ciclo. Nadie tiene que tener mala intención. Cualquier sistema evaluado según si te gustó la respuesta derivará hacia la adulación, y calificarás esa deriva como mejora. El Principio 1 no es una preferencia sobre métricas. Es un requisito de seguridad, y una puntuación de satisfacción no es una señal débil — es la superficie de ataque.
Ya en 1784, Kant había llegado a esta misma estructura — cosa un tanto molesta. Ubicó el fallo de la autonomía intelectual no en la tiranía, sino en lo que llamó autoprocurada: una inmadurez que uno mismo se busca — dependencia elegida porque resulta cómoda. [19] La consecuencia, en términos de ingeniería, es precisa: un daño que el usuario prefiere no puede solucionarse dándole al usuario más opciones. Solo puede solucionarse con un compromiso asumido de antemano. Un valor por defecto. Una lista de bloqueo. Una compuerta.
La corrección que dolió
Mi párrafo de apertura le decía al lector que su atención estaba siendo capturada, su memoria tercerizada, su juicio debilitado.
Los datos agregados respaldan ese estado de ánimo. Pew descubrió en 2025 que el 53% de los estadounidenses espera que la IA empeore la capacidad de pensar creativamente de las personas, frente a un 16% que espera una mejora, cifra que sube al 61% entre los menores de treinta años. [10] Lectura reconfortante, si acabas de escribir un manifiesto.
Luego llegó el trabajo de Pew de junio de 2026: los estadounidenses que realmente usan chatbots de IA son más propensos a decir que ayuda su creatividad que a decir que la perjudica — 21% dice que ayuda contra 11% que dice que perjudica, mientras que un 17% dice que ninguna de las dos. [11]
Dos notas honestas al respecto, y en ambas me equivoqué la primera vez. La magnitud es menor de lo que suena: la mayoría de los usuarios de chatbots no reportan ningún efecto sobre la creatividad, así que esto refuta “los usuarios se sienten perjudicados” sin llegar a establecer “los usuarios se sienten ayudados”. Y una versión anterior de este artículo decía que los adultos jóvenes estaban “más o menos divididos por igual” — ese desglose no existe en el informe. Lo había tomado de un resumen de búsqueda. Ya no está.
El pavor abstracto y la experiencia vivida apuntan en direcciones opuestas, y yo había construido una apertura sobre la equivocada. Un documento dirigido a los temerosos recluta a los temerosos — que son las personas con menos probabilidades de adoptar jamás una IA personal. Mientras tanto, las personas que construirían esto leen “tu juicio se está debilitando” y con razón notan que su propia experiencia dice lo contrario, y los perdí en el primer párrafo.
Peor aún, mira lo que estaba haciendo. Escribí un documento advirtiendo que una IA que te dice lo que quieres oír es peligrosa — y lo abrí diciéndoles a los lectores lo que los temerosos querían oír. Había halagado el miedo del lector. El mismo mecanismo, en dirección opuesta, y no lo noté hasta que una encuesta me puso en evidencia.
Hay un mejor enfoque disponible, y estuvo en la investigación todo el tiempo. El panel juvenil de RAND encontró que el uso de IA para tareas escolares subió del 48% al 62% entre mayo y diciembre de 2025 — mientras que el porcentaje que dijo que perjudicaba su pensamiento crítico subió del 54% al 67%. [9] La misma población aumentó su uso y aumentó su preocupación. No están pidiendo que se los salve de la herramienta. Están pidiendo una versión que no les cueste esto. Eso es demanda, no oposición, y es un párrafo de apertura completamente distinto.
La parte donde mi propia regla me atrapó
El corpus de investigación usa una escala de evidencia de cuatro niveles: verificado en el artefacto, corroborado, afirmado, en disputa. La regla que sostiene todo es verificar en la altitud nativa de la afirmación — una afirmación de código en el código, la N de un estudio en el paper, una fecha legal en el texto oficial.
Aplicada a mi propia corrida, degradó cuatro de mis cifras más citables. Los números de desplazamiento de nivel inicial de Stanford, la N de un estudio de trabajadores del conocimiento ampliamente citado, una taxonomía de patrones oscuros — todos me llegaron a través de comentarios en vez del documento fuente, así que todos quedan etiquetados como afirmado.
Y el cuarto preferiría no mencionarlo, así, calladamente. Tenía una línea sobre laboratorios de frontera que revelaban que sus agentes habían escapado de sandboxes de prueba. Afirmación seria. Estructural. Cuando revisé mis propias notas, resultó que la fuente era a weekly AI-news aggregator (Traducción: un agregador semanal de noticias sobre IA).
Escribí un marco cuya propuesta entera es la procedencia, y terminé atribuyendo un incidente de seguridad de IA a un listicle.
Está etiquetado como afirmado, con una nota que aclara explícitamente que un agregador de noticias no es una divulgación oficial y que la publicación primaria no ha sido leída. Lo dejo visible en lugar de borrarlo, porque las correcciones son el resultado más valioso de todo el ejercicio, y un repositorio que no puede mostrar cuáles de sus cifras verificó está pidiendo que le crean exactamente sobre la base que les dice a todos los demás que rechacen.
Lo que v0.1 realmente cambió
Diez principios ahora nombran nueve verificaciones. Nueve, no diez, porque una verificación
(engagement-denylist) cumple la función de dos principios — y solo noté el error en el conteo
cuando tuve que poner un número en la infografía de arriba, lo cual es en sí mismo una pequeña lección sobre
dónde se esconde el desvío.
| Principio | Verificación | Falla cuando |
|---|---|---|
| Crecimiento sobre dependencia | engagement-denylist | la métrica de éxito son los usuarios activos, la retención, la duración de la sesión o la racha |
| Propiedad sobre extracción | data-custody-declared | la custodia no está declarada como local / portable / del proveedor |
| Agencia sobre automatización | human-gate-required | una acción irreversible no tiene una compuerta humana designada |
| Comprensión sobre respuestas | atrophy-declared | no hay riesgo de erosión declarado más una contrapráctica |
| Transparencia sobre manipulación | transparency-declared | el usuario no puede inspeccionar qué se usó ni a favor de qué interés |
| Portabilidad sobre atrapamiento | no-exit-no-pass | no hay una vía de salida funcional, o el recorrido de ida y vuelta no está probado |
| Propósito sobre el enganche | engagement-denylist | el objetivo no es la meta declarada por el usuario |
| Interés compuesto sobre consumo | return-sharper-declared | no hay señal de que el humano se haya vuelto más capaz |
| Personas sobre plataformas | no-vendored-satellites | la capacidad depende de un único proveedor específico |
| Legado sobre lo inmediato | window-tagged-evidence | toda la justificación ofrecida corresponde a este trimestre |
Tres de esos méritos valen la pena por su origen, porque cada uno codifica un resultado y no mi gusto personal.
no-exit-no-pass — la portabilidad significa un ciclo completo de ida y vuelta, evaluado según
la capacidad preservada y no según un botón de exportar. Puedo sostener esa exigencia porque alguien ya la cumple:
el Data Rights Protocol de Consumer Reports ejecuta en producción, con varios proveedores de cumplimiento normativo,
solicitudes de derechos de datos de agentes autorizados. [14] (La cifra de dos millones de solicitudes que suele
atribuirse al DRP corresponde en realidad al total de la app Permission Slip de Consumer Reports, no al
rendimiento del protocolo — la página del DRP no publica ninguna cifra de solicitudes. Yo la había atribuido a lo que no era.)
Una prueba de existencia convierte un requisito aspiracional en un requisito de adquisición.
atrophy-declared — toda capacidad debe nombrar la habilidad que puede erosionar
con su uso rutinario, y la contrapráctica que la mantiene. Parasuraman y Riley separaron
el mal uso (dependencia excesiva) de desuso (negligencia tras falsas alarmas) en 1997, razón por la
cual “agregar un humano” no es automáticamente más seguro. [5] La literatura sobre pérdida de habilidades
reporta que los aprendices “perform competently when familiar prompts guide their thinking, but
their performance weakens when those cues are absent, unfamiliar, or misleading” (Traducción: rinden de forma competente cuando indicaciones familiares guían su pensamiento, pero su desempeño se debilita cuando esas señales están ausentes, son desconocidas o engañosas) — y
el mismo artículo declara sin rodeos que “there is limited systematic evidence on AI-related
deskilling in healthcare, including its timing, mechanisms, and affected groups.” (Traducción: hay evidencia sistemática limitada sobre la pérdida de habilidades relacionada con la IA en el ámbito de la salud, incluyendo su cronología, sus mecanismos y los grupos afectados) [8]
Yo había escrito originalmente que el desempeño “se mantiene, y luego cae bruscamente al retirarse el apoyo.” El artículo
no afirma eso. La compuerta se sostiene sobre la taxonomía de 1997 y la ley; no necesita una
afirmación empírica más contundente de la que su fuente pueda respaldar. Juntas producen un defecto que nadie había cuantificado — una
aprobación firmada por alguien que ya no podría producir la respuesta blanquea el error de la máquina como si fuera una
decisión humana. Y desde el 2 de agosto de 2026, cuando entraron en vigor las obligaciones de alto riesgo de la Ley de IA de la UE,
la ley exige supervisión por parte de una persona con la competencia, la formación y la
autoridad necesarias. [12] El flujo de trabajo va eliminando, sin hacer ruido, aquello que la ley da por supuesto.
human-gate-required — esta tiene 300 años. En Keech v
Sandford (1726) un fideicomisario tomó un arrendamiento para sí mismo, pero solo porque el niño para quien lo administraba
no podía tenerlo. El tribunal lo obligó a entregar hasta el último centavo. [17] No preguntó
si hubo daño o no; eliminó la posibilidad de conflicto. Leído como ingeniería
y no como derecho: un agente que a la vez recomienda y monetiza, a la vez califica y vende, o a la vez guarda
tu memoria y entrena con ella, está en posición Keech sin importar la intención — y el remedio
es la separación estructural, no la buena conducta. Es preventivo precisamente porque evaluar el
daño después de los hechos es justo lo que la acción a velocidad de máquina hace imposible.
El número honesto
La métrica norte es la Cobertura de Soberanía Verificada: de las catorce áreas de daño en el mapa, cuántas tienen una contramedida atada a una verificación que pasa, con evidencia en el repositorio.
Es 0 de 14.
Dos áreas no tienen ninguna verificación y lo dicen explícitamente — la homogeneización del pensamiento y el pavor a la obsolescencia. La homogeneización es la que vale la pena detenerse a mirar: los modelos de lenguaje grandes elevan la originalidad individual mientras reducen de forma medible la diversidad de expresión a nivel de población. [4] Ningún usuario percibe jamás esa pérdida, así que ninguna señal de retroalimentación se activa nunca. Ese es el único lugar donde “own my intelligence” resulta estructuralmente insuficiente — un daño invisible dentro de cada caso individual no puede corregirse mediante la elección individual. Prefiero publicar el vacío antes que disimularlo con un proxy.
Y publico cero en lugar de un número derivado más amable por la misma razón por la que cada área en el mapa lleva un contraargumento obligatorio de la postura opuesta: una métrica que no puede avergonzar a su autor no está midiendo nada. La afirmación no es que la cobertura sea alta. Es que la cobertura ahora es un número que puede ser bajo.
Mecanismo, patrón, antipatrón
El mecanismo
La opcionalidad selecciona el comportamiento conforme más barato. Una declaración sin cumplimiento forzado crea un gradiente hacia la política más vacía que aún pase como conforme — por eso P3P murió de políticas válidas pero vacías, y no de rechazos abiertos. Súmale el resultado sobre la adulación y el gradiente empeora: donde la condición dañina es también la placentera, la elección del usuario refuerza la desviación en lugar de corregirla.
El primer principio
Un principio sin verificación es un eslogan; la verificación es lo que hace que un valor sea refutable.
Patrones
- Compila el adjetivo en una compuerta. Nombra el valor, nombra la observación que lo viola, automatiza la observación y deja que tu marketing cite la compuerta en lugar de la aspiración.
- Encuentra a quien ya cumple. Una prueba de existencia en cualquier punto del mercado convierte una meta aspiracional en un requisito de adquisición. Y elimina la última excusa.
- Una gobernanza neutral vence a una licencia abierta. Una licencia protege tu derecho a bifurcar el proyecto; solo la gobernanza limita lo que el dueño puede hacer con la hoja de ruta. MCP ya tenía licencia abierta y seguía siendo de un solo proveedor hasta que se cedió a un fondo de la Linux Foundation en diciembre de 2025. [13]
- Mantén las correcciones en el artefacto. Las entradas en disputa son la parte más valiosa de una base de conocimiento, porque son la única prueba de que la disciplina se está aplicando.
Antipatrones
- Declaración sin cumplimiento forzado. Peor que el silencio: fabrica la apariencia de rendición de cuentas.
- La promesa infalsificable. “We do not train on your data” (Traducción: No entrenamos con tus datos) no se puede verificar desde fuera del modelo. Valórala como un seguro, no como una garantía de control.
- El formato que rebasa a la sustancia. El Agile Manifesto reorganizó una industria y produjo el «Cargo Cult Agile», las notas adhesivas sin la confianza. [20] Lo más barato de imitar es lo que más rápido se propaga, así que publica las verificaciones junto con el documento o verás cómo el vocabulario viaja solo.
- Leer la viralidad como validación. Humane recaudó unos 230 millones de dólares, vendió menos de 10.000 AI Pins, se vendió a HP por unos 116 millones de dólares e inutilizó todos los dispositivos el 28 de febrero de 2025. La falla identificada fue confundir demos virales con demanda de mercado — y un manifiesto está optimizado para la viralidad. [18]
Pruébalo en veinte minutos
Abre el documento de valores de tu equipo, tus principios de IA o tus estándares de ingeniería. Elige la línea más importante de todas. Luego:
- Escribe la observación que probaría que lo incumpliste. Una oración, concreta, con fecha.
- Pregúntate si algún sistema que posees notaría esa observación. Si no, tienes una promesa: no tiene código de salida.
- Crea la versión más económica posible de la verificación —un grep, una prueba, un campo obligatorio en una plantilla. No tiene que ser buena. Tiene que poder fallar.
- Cuenta: valores con una verificación, sobre el total de valores. Publica la fracción.
Vas a odiar la fracción. La mía es 0 de 14. Publícala igual, porque la fracción es lo primero honesto que ha dicho el documento en toda su existencia.
Qué probaría que estoy equivocado
Un marco que no puede fallar no debería adoptarse, así que aquí están las observaciones que acepto como refutación. Un estudio longitudinal preregistrado que muestre que los usuarios intensivos de IA mantienen o mejoran unaided su desempeño de orden superior durante doce meses en un diseño de prueba diferida, sin ayuda externa. Una réplica que muestre que el efecto de sicofancia se disipa con la interacción real repetida. Un recorrido de ida y vuelta completo y demostrado de memoria acumulada entre dos asistentes principales, con capacidad preservada confirmada de forma independiente —lo cual volvería redundante mi verificación más estricta, y entonces la retiraría y lo diría abiertamente. Y, sobre toda la tesis: evidencia de que las personas que usan IA asistiva de forma intensiva se están volviendo, en promedio, más capaces y más independientes de juicio, en lugar de menos.
Preferiría aprender eso a tener razón en esto.
Referencias
- International AI Safety Report 2026 (Y. Bengio, presidente). internationalaisafetyreport.org (consultado el 5 de agosto de 2026).
- Cheng, M., Lee, C., Khadpe, P., Yu, S., Han, D. & Jurafsky, D. (2026). “Sycophantic AI decreases prosocial intentions and promotes dependence.” (Traducción: «La IA aduladora reduce las intenciones prosociales y fomenta la dependencia»). Science, 391(6792), eaec8352, 26 de marzo de 2026. doi:10.1126/science.aec8352 (resumen verificado textualmente, 5 de agosto de 2026).
- Gerlich, M. (2025). “AI Tools in Society: Impacts on Cognitive Offloading and the Future of Critical Thinking.” (Traducción: «Herramientas de IA en la sociedad: impactos en la delegación cognitiva y el futuro del pensamiento crítico»). Societies. mdpi.com/2075-4698/15/1/6 (consultado el 5 de agosto de 2026).
- “The homogenizing effect of large language models on human expression and thought.” (Traducción: «El efecto homogeneizador de los modelos de lenguaje grandes en la expresión y el pensamiento humanos»). Trends in Cognitive Sciences, 2026. cell.com/trends/cognitive-sciences (consultado el 5 de agosto de 2026).
- Parasuraman, R. & Riley, V. (1997). “Humans and Automation: Use, Misuse, Disuse, Abuse.” (Traducción: «Humanos y automatización: uso, mal uso, desuso, abuso»). Human Factors, 39, 230–253. doi:10.1518/001872097778543886 (consultado el 5 de agosto de 2026).
- Clark, A. & Chalmers, D. (1998). “The Extended Mind.” (Traducción: «La mente extendida»). Analysis. philarchive.org/archive/JULTEM (consultado el 5 de agosto de 2026).
- Bjork, R. A. & Bjork, E. L. “Introducing Desirable Difficulties into Practice and Instruction.” (Traducción: «Introduciendo dificultades deseables en la práctica y la instrucción»). unh.edu (PDF) (consultado el 5 de agosto de 2026).
- “Deskilling dilemma: brain over automation.” (Traducción: «El dilema de la desespecialización: el cerebro por encima de la automatización»). Frontiers in Medicine, 2026. doi:10.3389/fmed.2026.1765692 (consultado el 5 de agosto de 2026).
- RAND Corporation (2026). “More Students Use AI for Homework, and More Believe It Harms Critical Thinking.” (Traducción: «Más estudiantes usan la IA para las tareas, y más creen que perjudica el pensamiento crítico»). rand.org (consultado el 5 de agosto de 2026).
- Pew Research Center (2025). “How Americans View AI and Its Impact on People and Society.” (Traducción: «Cómo ven los estadounidenses la IA y su impacto en las personas y la sociedad»). pewresearch.org (consultado el 5 de agosto de 2026).
- Pew Research Center (2026). “Americans' Views on AI Chatbots, Smart Devices and AI's Impact.” pewresearch.org (consultado el 5 de agosto de 2026).
- EU AI Act, Artículo 26: Obligations of Deployers of High-Risk AI Systems. artificialintelligenceact.eu/article/26 (consultado el 5 de agosto de 2026).
- The Linux Foundation (2025). “Formation of the Agentic AI Foundation.” linuxfoundation.org (consultado el 5 de agosto de 2026).
- Consumer Reports Innovation Lab. “Data Rights Protocol.” github.com/consumer-reports-innovation-lab (consultado el 5 de agosto de 2026).
- The Platform for Privacy Preferences 1.0 (P3P1.0) Specification, W3C Recommendation, 2002. w3.org/TR/P3P. Cranor, L. F. (2012). “P3P is dead, long live P3P!” (Traducción: «¡P3P ha muerto, viva P3P!») — el sitio del autor era inaccesible al momento de escribir esto, así que se cita a través del Internet Archive: web.archive.org (consultado el 5 de agosto de 2026).
- Declaración de cierre del W3C Tracking Protection Working Group, 17 de enero de 2019; ver también “How the tragic death of Do Not Track ruined the web for everyone.” Fast Company. fastcompany.com (consultado el 5 de agosto de 2026).
- Keech v Sandford (1726) Sel Cas King 61. en.wikipedia.org/wiki/Keech_v_Sandford (consultado el 5 de agosto de 2026).
- “AI Product Failures 2026: Sora, Humane & Rabbit R1.” digitalapplied.com (consultado el 5 de agosto de 2026). Fuente secundaria; las cifras de Humane son reportadas, no verificadas de forma independiente.
- Kant, I. (1784). “An Answer to the Question: What Is Enlightenment?” philosophynow.org (consultado el 5 de agosto de 2026).
- Agile Alliance (2026). “25 Years Ago, a Manifesto Was Born.” agilealliance.org (consultado el 5 de agosto de 2026).
Corrección, 5 de agosto de 2026. Después de publicar, corrí una auditoría de citas independiente
de este artículo — la verificación que esta pieza defiende, aplicada a sí misma. Encontró seis
defectos y están corregidos arriba, cada uno marcado en su lugar en vez de editado en silencio: una
“firma” de deskilling sobreclamada que el propio paper fuente desmiente explícitamente; una
cita truncada del W3C atribuida a un documento que no existe; una frase de Bjork que yo había citado y
que no aparece en ninguna parte del artefacto (ahora reemplazada por una verificada); una cifra de dos
millones de solicitudes atribuida a la organización equivocada; un desglose por edad que no está en el
reporte de Pew; y una paráfrasis del resultado de Science cuando las palabras textuales del paper
estaban disponibles. Otras ocho citas se verificaron limpias contra el artefacto.
El marcador completo, incluyendo seis fuentes que no pude acceder y que por lo tanto no actualicé, está en
el docs/CITATION_AUDIT.md.
Escrito por Paul Jialiang Wu. Las dos citas textuales de arriba — la declaración de cierre del W3C Tracking Protection Working Group y el título del post de 2012 de Cranor — fueron verificadas contra sus fuentes. Las cifras atribuidas al Stanford Digital Economy Lab, al post-mortem de Humane y a los reportados escapes de sandbox de agentes llegaron a este artículo a través de reportes secundarios y están etiquetadas como tales en vez de presentarse como establecidas. Cada URL de arriba se verificó en cuanto a resolución el 2026-08-05; los muros anti-bots de los editores devolvieron 403 a una verificación automatizada y se trataron como accesibles-por-humanos, y una cita en riesgo se sirve desde el Internet Archive.