AI-NATIVEシリーズ・エージェントエンジニアリング・制御工学
アサンプションレジャー:安全保証は誰も見ていなかった一つの前提で決まる
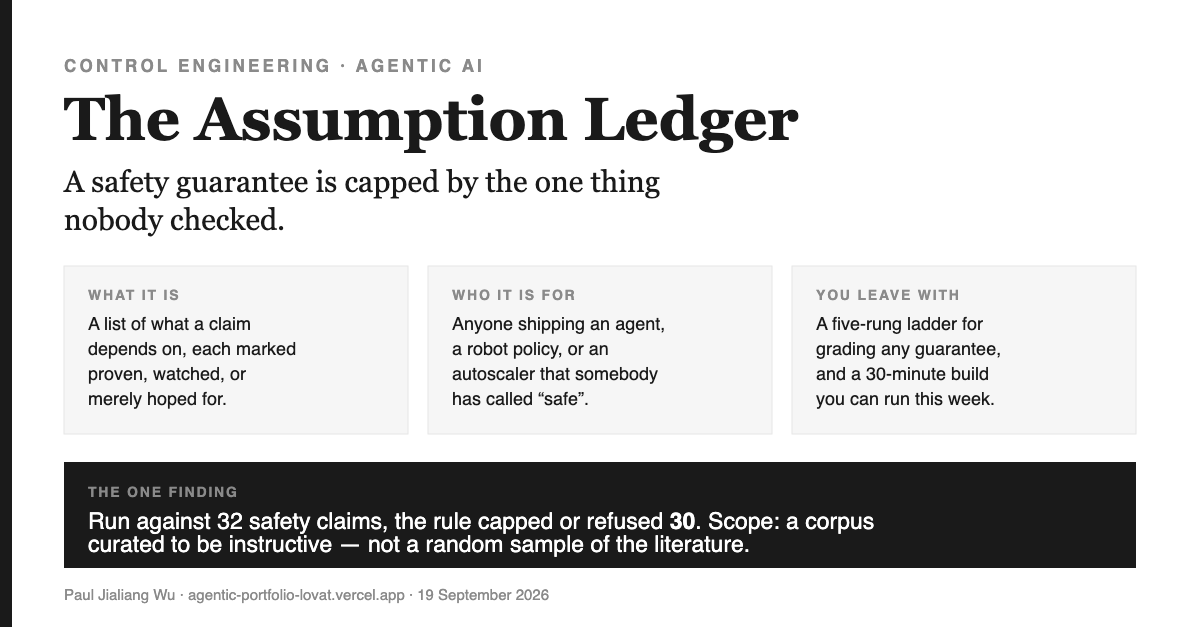
1分でわかる要点 ― 読み終えたときに手に入るもの
これは何か。 制御工学から持ち込まれた、シンプルな管理の工夫だ。アサンプションレジャーとは、assumption ledger とは、安全性主張が成立するために必要な条件を並べ、それぞれに「確認済み」「運用時に監視」「未検証・願望のみ」のいずれかを記す表である。検証済み, 実行時に監視されている、あるいはただ願われているだけ。このとき、その主張の保証は、最も弱い仮定が支えられる範囲までしか届かない。どれだけ他がしっかりしていても、未検証の項目がひとつでもあれば、それが全体の限界になる。
なぜこれが重要なのか。「モデル予測制御器を使った、だから安全だ」というのは応用制御で最もよくある主張の飛躍であり、そのソフトウェア版——「ガードレールを追加した、だからエージェントは安全だ」——も今や毎週のように世に出ている。安定性定理が語るのは、あくまでモデルそのものについてだ[8]。もし誰もモデルとロボットを照合しなければ、定理自体は成立しても、約束は成立しない。この種の失敗は、仕組み上、何の前触れもなく起こる。未検証の仮定は、それが崩れても何のシグナルも出さない——だからこそ、インシデントレポートで初めてその存在に気づくことになる。
この記事を読んだあとにできること。 どんな保証も五段階のラダー(G0逸話→G4認証)で評価し、その下にレジャーを書き、最も低いレベルを採用する。最後に30分で作れる実装例(入力、インバリアント、停止ルール、CI閾値)と、ここに出てくる全ての数値を生み出したオープンソース実装も紹介する。
アサンプションレジャーとは何か、そして誰のためのものか
アサンプションレジャーとは、主張の下に置かれる表のことだ。各行は、その主張が暗黙のうちに依存している要素を示し、それぞれにステータスが付く:(検証済み、または物理的に連動している)、discharged(実行時チェックが作動し、何かが起こる)、monitored(信じてはいるが未検証・未監視)、あるいはassumed(偽と分かっている)。これが仕組みのすべてだ。この記事の残りは、それを数値で扱うと何が見えてくるか、という話である。violated
これは、自分が手がけるシステムの挙動を他人が「安全」「安定」「アライン」「信頼できる」と呼ぶ人すべてに向けて書いている。ツールアクセスを持つエージェント、学習済みロボット方策、オートスケーラー、コンテンツフィルター、トレーディングガードなど。使うのに制御理論の知識は不要だ。読み終えるころには、安全性についての曖昧な主張を短く検証可能なものに言い換える術と、自分のシステムにそれを適用したときの居心地の悪さを味わうことになるだろう。
制御理論[9]は、「この仕組みが動き、世界が応答したとき、次にどうするか?」という問いを扱う、最も成熟した工学分野だ“this thing acts, the world answers back, now what?”(訳:「この仕組みが動き、世界が応答したとき、次にどうするか?」)——まさにエージェントが行動し、その結果を読み取るようになったとき、AIが直面した状況そのものだ。こうしたループがいつ安定し、いつ破綻するかについて100年分の知見があり、またその知見がどう誤用されてきたかという100年分の痛い経験もある。そしてレジャーは、その痛みの記録でもある。
この記事全体を貫くたとえがひとつある。唐突に持ち出すのではなく、最初にきちんと紹介しておきたい。
料理の階段──5つのキッチン、5通りの「約束」
自分のために料理するのと、全国規模の食品サプライチェーンを回すのとでは、何が違うのか。難易度の話ではない。約束の中身が、段階ごとにまったく別物になる。
自分のために料理する──自分で味見して納得すればそれで終わり。これは「もう食べ終えた一食」への約束だ。毎週家族に料理する──この5人、このキッチンでは毎回うまくいくとわかっている。レストランを回す──何人に出して何件クレームが出たかを数え、どれくらい安定しているかを語れる。ファストフードチェーンを展開する──レシピは500店舗、仕入れ先の変更、あなたを知らない料理人でも再現できなければならない。つまり、事前に洗い出したバリエーションすべてに耐えられる必要がある。全国規模の供給網を担う──誰かが監査し、その約束は署名付きの文書になる。
段が上がるごとに主張は強くなり、どれも「味見」だけでは済まされない。以下がその対応表だ:
| キッチン | 約束 | 制御分野での呼び方 |
|---|---|---|
| 自分のための料理 | “It tasted fine.”(訳:味は問題なかった) | G0・逸話レベル──一度だけ成功 |
| 家族のための料理 | “It works for us, every week.”(訳:毎週うちではうまくいく) | G1・経験則──測定済み、分布内 |
| レストランの運営 | “Ninety-five percent of covers, no complaint.”(訳:95%の提供でクレームなし) | G2・統計的──信頼水準付きの上限 |
| チェーンの運営 | 「リストに載っているすべての店舗とサプライヤーで成立する。」 | G3・ロバスト ― あらかじめ定めた不確実性の範囲すべてで成立 |
| サプライチェーン運営 | 「監査済み。これが証明書だ。」 | G4・認証済み ― 形式的なモデルで照合済み |
本当に重要なのは、G1からG2への段階を上がるところだ。G1以下では「実際に起きたこと」しか分からない。G2以上になると「これから起きること」について、しかも自分で明示した前提の範囲内でだけ、何かを言える。2026年時点のAI安全性主張のほとんどはG1にとどまり、G3のような文体で書かれている。
ここからがこのたとえ話の本題だ。レストランが潰れるのは、シェフが料理を失敗したからではない。ウォークイン冷蔵庫の温度が1週間ずっと2度高かったのに、誰も温度計を見ていなかったからだ。レシピ自体がリスクだったことはない。監査されていないサプライヤーこそがリスクだった――レジャーとは、サプライヤー一覧に「誰かが実際にチェックしているか」の欄を加えただけのものだ。
上限ルール
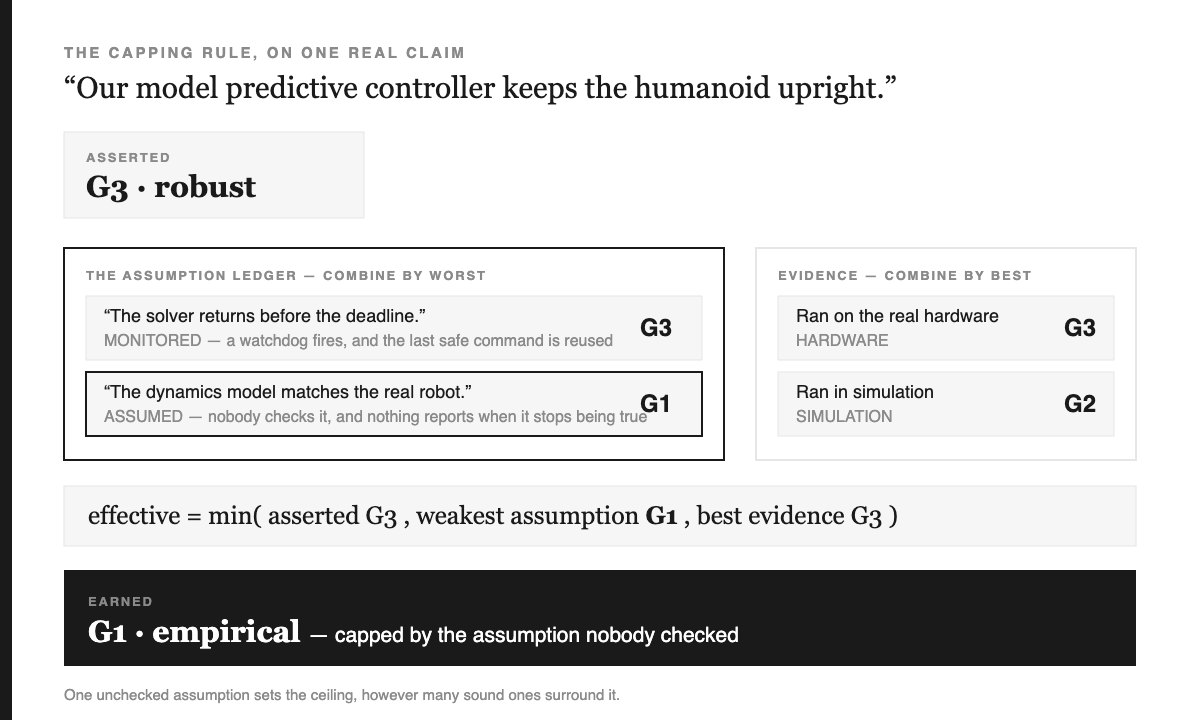
主張されたレベルを書く。レジャーを書く。そして一番低いものを採用する:
effective = min( asserted , weakest assumption , best evidence )本質的に効いているのは2つのポイントで、しかも互いに逆方向を向いている。
前提は一番弱いもので決まる。 チェーンは一番脆い輪で切れる。どれだけ他が堅牢でも、未検証の前提がひとつでもあれば、それが全体の保証の限界になる――なぜなら、失敗はその未検証の部分から、しかも予告なくやってくるからだ。
エビデンスは一番強いもので決まる。 エビデンスはチェーンではない。ハードウェアの結果の隣にゆるいアナロジーがあっても、ハードウェアの結果自体が弱まることはない。だから一番強い裏付けだけを採用すればいい。
各前提のステータスには上限があり、この表こそがこの仕組みで唯一の本質的な設計判断だ:
| ステータス | 上限 | その上限となる理由 |
|---|---|---|
discharged ― 証明済み、またはハードウェアで物理的に連動している | G4 | この場合、障害にはならない。 |
monitored ― チェックが作動し、フォールバックが動く | G3 | ここでは違反を検知しているだけで、排除しているわけではない。これで得られるのはロバスト性であり、認証とは異なる。 |
assumed ― 信じているが未検証・未監視 | G1 | 観測したことは報告できるが、前提が未確認のままでは将来の保証はできない。 |
violated ― 偽であると判明している | G0 | 却下。デモしか残らない。 |
注意深い読者が引っかかるのはこの行だmonitored。なぜランタイムチェックがロバスト止まりで、認証にはならないのか――検出器が正確でフォールバックも証明済みなら、何が足りないのか? 答えは毎回同じ三つだ。モニタは違反が起きてから初めて作動するので、保証は検知の遅延に縛られる。監視する信号も、誰かが選んだものだけなので、そのカバー範囲自体が新たな仮定になる。そしてフォールバックは、タイミングよく作動しなければならないが、それはモニタではなく現実世界についての主張だ。証明やハードウェア連動にはこうした制約がなく、そもそも危険な状態を排除する――検知と排除の違いがここにあり、だから上限がこの位置になる。
台帳の誠実さを保つルールがひとつある。そして多くの人が一番避けたがるのもこれだ:仮定にmonitoredまたはdischargedを付す場合は、チェックの名前を明記しなければならない。説明ではなく、具体的な名前を書く。どのモニタが、どの信号を、どの閾値で監視し、作動時に何が起きるのか。名前のないチェックはただの願望であり、願望だらけの台帳は台帳がないのと同じ扱いになる。
32件の主張で実際に試した結果
私はこの台帳を小さなオープンソースのエンジン [11]に組み込み、エンジンがカバーする12分野――とくにアラインメント、ロボティクス、物理AIが多いが、航空宇宙、サービング基盤、医療、マーケットも含む――について、各主張ごとに前提と証拠を書き出した。その結果、ゲートは32件中30件.
この数字は、その前提となる範囲とセットで見てほしい。範囲こそが意味の大半を占めている。 これは私が教材用に意図して集めた事例集であり、有名な過大な主張や反例も意図的に含めている。失敗例のない教材は何も教えないからだ。 これは文献から無作為に抽出したサンプルではなく、「30/32」という数字も分野全体の調査結果ではない。 率直にまとめるなら:既知の失敗例を含むよう選んだ主張セットに対し、このルールは既知の失敗例をきちんと見つけた——つまりルールが機能することは示したが、全体の発生率については何も語っていない。
主張通りのレベルで通ったものは2件あり、その2件は他の30件と同じくらい重要だ。すべてをはねつけるゲートは、何もはねつけないゲートと同じくらい無意味である。
通った2件と、その違い
Speculative decodingはG4で成立している なぜなら、その保証は 理論的に導かれた ものであり、単なる観測結果ではない。小型で高速なモデルが複数トークンを下書きし、大型モデルが一度にそれらを検証する。却下された下書きは、出力分布が変わらないよう厳密に選ばれたルールで再サンプリングされる。この手法の論文では、スピードアップが “without changing the distribution”(訳:分布を変えずに) および “without any changes to the outputs”(訳:出力に一切の変更を加えずに) [4] と報告されている。決定的なのは、両方の前提が discharged 実際に手順や仕組みとして明示されている点だ。受理ルールはCIで固定シードの分布同値テストにより検証され、語彙共有要件はモデルロード時に明示されるため、不一致ペアは静かに劣化するのではなく起動自体を拒否する。どちらも「約束」ではなく、失敗時には即座にエラーとして表に出るコードである。料理で言えば、現場で全皿を料理長のレシピと照合するテイスターがいて、リジェクト品を再調理する明文化ルールがあり、メニューは変わらない。「誰かが味見すべき」という方策ではない。
Tube model predictive controlはG3で成立している ——主張通りロバストだが、それ以上の段階ではない。これは、想定した有界集合内のすべての外乱に対して制約充足を保証する。[8] この最後の条件がすべてだ。保証は、実際の外乱が設計時の集合内に収まっていることを前提とし、誠実な運用ではその条件を 監視する :残差モニタが実際に観測された外乱を設計集合と比較し、逸脱があれば記録・警告する。監視はしているが、完全に排除しているわけではない——だからG3であり、G4ではない。これは、すべてのサプライヤーが仕様書通りで、誰かが実際に温度計を見ている間だけ成立する仕組みだ。非常に良い状態だが、“audited”(訳:監査済み)とは同じ意味にはならない。
両者に共通する特徴:主張が本当に成立するのは、その前提が「意図」ではなく、具体的な仕組みや手順として実装されている場合である。 どちらのチームも、より良いモデルではなく、「名前・閾値・結果」が明確なチェックを必要としていた。
パターンとその落とし穴
| よくある落とし穴 | それに置き換えるべき実践 |
|---|---|
| “We use technique X, therefore we are safe.”(訳:手法Xを使っているから安全だ) | Xの定理が本当に対象としているものを明確にし、それが自分の運用環境で実際に成り立っているかを確認する。 |
| 発動条件が書かれていないガードレール。 | どの信号を、どの閾値で、どのフォールバックが動くかまで名前を付けて明示したモニター。 |
| 生成側が自分で自分を評価する。 | 異なる壊れ方をする二つ目の視点を用意し、不一致が出たらエスカレーションする。 |
| 証明調で書かれた安全性ページ。 | すべての主張に、その主張が実際に得たグレード(段階)を明記した安全性ページ。 |
| 指標が動かなくなるまで最適化し続ける。 | 指標と本当に欲しかったものがまだ一致しているうちに止める。 |
| 誰も赤になったのを見たことがないゲート。 | 意図的に落とすテストが仕込まれているゲート。 |
見逃しやすい三つの罠
1. “It is optimal, therefore it has good safety margins.”(訳:最適化されているから安全マージンも十分だ)この分野では、標準的な最適コントローラについて長年そう信じられてきた。だが1978年、John Doyleが2ページの論文を発表した——タイトル:Guaranteed margins for LQG regulators;要旨は有名な一文で、要するに「マージンは存在しない」という内容だった——ゲインマージンがいくらでもゼロに近づく最適設計を示した[5]。「最適」と「安全」はまったく別の話だった。「最適化したからロバストだ」という主張は、現代風に着替えただけで本質はこの誤りそのものだ。
2. “The model critiques its own output, so quality improves.”(訳:モデルが自分の出力を批評するので、品質が向上する)これは「キャップ」ではなく「拒否」——なぜならクリティックと生成器が同じシステムであり、前提の一つが単なる未検証ではなく明確に偽だからだ。計測器の最初の鉄則は昔から変わらない:「自分自身の計器でループを閉じるな」。自己批評が本当に機能するのは、テストスイートやコンパイラ、外部環境など、システム外からの信号がループに入っている場合だけで、それがなければ必ず暴走する。解決策はより良いプロンプトではなく、異なる壊れ方をする二つ目の意見だ。
3. “Give the agent enough steps and it will finish the task.”(訳:エージェントに十分なステップを与えれば、必ずタスクを完了する) 却下した。なぜなら、この主張は「エラーが互いに独立している」という前提に立っているが、現実にはそうではないからだ。長期タスクの実行を直接測定したSinhaらの研究によれば、「models become more likely to make mistakes when the context contains their errors from prior turns」(訳:コンテキストに過去のターンで生じたエラーが含まれていると、モデルはよりミスをしやすくなる)という。[2]。これは単なるノイズの蓄積ではない。出力が次の入力となり、同じ方向に事態を加速させる「正のフィードバック」だ。こうした構造こそが、最初は小さな揺らぎから始まり、やがて大事故や崩壊につながる工学的失敗の典型的なメカニズムである。
この現象がエージェント型システムで特に深刻になる理由
ツールを使うエージェントを、あらゆるフィードバックループが持つ6つの要素に当てはめてみると、ある1行が明らかに抜けていることがわかる:
| 要素 | サーモスタットの場合 | ツールを使うエージェントの場合 |
|---|---|---|
| リファレンス(目標) | ダイヤルで設定した温度 | ユーザーの目標(最初に一度だけ設定され、その後は読み直されない) |
| コンパレータ(差分の検出) | 減算 | たいてい何もない [10] |
| コントローラ(意思決定) | サーモスタットのスイッチ | next-token policy |
| アクチュエータ(実際に動かすもの) | 暖房リレー | 発行されたツールコール |
| プラント(操作対象) | 部屋 | ファイルシステム、ネットワーク、ユーザー |
| センサー(フィードバックを返すもの) | 温度計 | ツールの返り値 |
そして、多くの人が見落としがちな3つの要素がある。実際のシステムが本当に破綻するのは、たいていここだ。レイテンシ: 1ステップごとに数秒、数十ステップ、実行回数に上限なし。権限: ツールの権限が許す限り——現代のコンピューティングで最も分析されていない権限制限であり、たいてい最も広い。フォールバック: たいてい何も用意されていない。
もしサーモスタットがこう設計されていたら——目標は一度だけ読み取り、エラー信号はなく、権限は無制限、フォールバックもなし——家は燃えてしまう。それも「すべて正常」と表示しながらだ。これは分野への皮肉ではない。自分でも何度かこの構成でシステムを世に出し、「エージェントフレームワーク」と呼んでいた。
朗報は、解決策は昔から知られているということだ。肝心な部分をいちいち信頼できるものに作り替える必要は、ほとんどない。未検証のコントローラをそのまま動かしつつ、安全性が証明されたベースラインを、いつでも切り替えられるモニターの後ろに控えさせておく。そして、必要なら人間がいつでも介入して止められるようにしておく。制御工学では、これをSimplexアーキテクチャと呼ぶ。実行時保証の設計手法のひとつだ。[6] バリア関数型セーフティフィルタもこの系譜に含まれる。[7] そのニューラル版は「not only provides safety assurances in the presence of a possibly unsafe neural controller, but can also improve the safety of such a controller in an online setting via retraining, without overly degrading its performance」(訳:安全でない可能性のあるニューラルコントローラが存在しても安全性を保証するだけでなく、オンラインで再学習することで、そのようなコントローラの安全性を大きな性能低下なしに高めることもできる)と明言している。[3] 保証は方策ではなく制約レイヤーに宿る。実際、旅客機もこの仕組みで動いているし、今日からあなたのエージェントにも使える。
30分で作れる
リポジトリは要らない。必要なのは表と、min().
入力。 ひとつの主張を一文で。著者が主張するレベル(G0〜G4)。仮定のリスト、それぞれにステータスと——monitored または discharged ——チェックの名前。証拠の種類(証明、ハードウェア、シミュレーション、ベンチマーク、アブレーション、アナロジー)のリスト。
出力。 実際のレベルと、それを制限したID。
不変条件。 ゲートは決して主張を“格上げ”しない。これは審判役であり、応援団ではない。どれだけ強力な証拠が揃っていても、控えめな主張は控えめなまま据え置かれる。
ストップルール。 A violated assumption が出た時点で即座に却下――その時点で判定は終了し、以降は読まない。
最小構成:
CEIL = {"discharged": 4, "monitored": 3, "assumed": 1, "violated": 0}
EVID = {"proof": 4, "hardware": 3, "simulation": 2,
        "benchmark": 1, "ablation": 1, "analogy": 0}

def judge(asserted, assumptions, evidence):
    if any(a.status == "violated" for a in assumptions):
        return 0, "refused"
    if asserted > 0 and not evidence:
        return 0, "unproven"          # no evidence means no
    if asserted >= 2 and not assumptions:
        return 1, "capped"            # a guarantee resting on nothing
    floor = min((CEIL[a.status] for a in assumptions), default=4)
    roof  = max((EVID[e] for e in evidence), default=0)
return min(asserted, floor, roof), "..."この2つのdefault= 引数は、単なる保険ではなく、実際に動くコードと、最初のレジャーで ValueError を投げるコードの分かれ目になる――つまり、G1の主張で仮定がまだ何も書かれていない場合。空のレジャーには上限がかからないため、「G2以上を主張しているのに仮定がひとつも書かれていない」場合のチェックが別に設けられている。
CIの基準。 ゲートが主張に制限をかけたり却下した件数を数え、それがゼロならビルドを失敗させる。決して動作しないゲートは単なる飾りであり、飾りのゲートは無いよりも有害だ。なぜなら、根拠なき安心感を生むからである――それは、誰も接続していないのに1年間ずっと4度を示し続けている冷蔵庫の温度計と同じだ。私のゲートは32件中12件でビルドを止める。
意図的に省いているもの。 上限に対する信頼区間は設けていない――この4つの数字は CEIL 判断であり、計測値ではない。これを“結果”と装うことこそ、このエッセイが批判しているまさにその過ちだ。自動の仮定抽出も行わない。システムの依存先をモデルが推測して作ったレジャーは、見た目は流暢でも中身は間違いであり、空のレジャーよりも悪質である。レジャーを自分で書くこと自体が本質的な作業であり、計算はその副産物にすぎない。
同じ構造、出口は5つ
| あなたは…… | 決めること | 今週やるべきこと |
|---|---|---|
| 学生 | 自分のプロジェクトの主張が実際にどの段階にあるか。 | 自分のシステムについて一文書き、その下にレジャーを書く。最初のレジャーはたいてい1行だけで、そこにはassumed. |
| エンジニア | 自分のガードレールがモニターなのか、ただの願望なのか。 | 出荷するすべての安全チェックについて、シグナル・閾値・発火時に何が動くかを明記する。名前を付けられないものはすべてassumed. |
| 創業者 | 自分のセーフティページに書いてよいこと。 | ページ内のすべての主張を一度棚卸ししよう。それぞれが実際に達したレベルより上のものは、他人に突っ込まれる前に自分で書き直しておくこと。 |
| 経営層 | 「ガードレールがあります」が本当に答えになるかどうか。 | 次のレビューで、たった一つだけ質問してみてほしい:どの前提が本当に要となっていて、それを誰が見張っているのか? 返事がなければ、それが答えだ。 |
| 投資家 | その技術的な優位性が本当に理論的裏付けなのか、単なるデモなのか。 | その主張が何を根拠にしていて、それぞれどうやってチェックされているのか尋ねてみよう。実運用中の学習システムでG4が出ることはほとんどなく、もし軽々しくG4だと主張しているのを聞いたら、それ自体が重要なシグナルだ。 |
私がここで主張していないこと
このラダーはあくまで判断の枠組みであって、定理ではない。 五段階のラダーと四つの上限は私の設計だ。筋は通っていて機械的だが、誰かが証明したものではない。一つの関数にまとまっているので議論の余地がある——それが私にできる正直な最大限だ。
32件中30件という数字は調査結果ではない。 これは上でも書いたが、繰り返す。なぜならこの数字だけが一人歩きしやすいからだ:このコーパスは、既知の失敗例をあえて含めて作ったものだ。
レジャー自体が何かを安全にするわけではない。 レジャーが正直にするのは主張だけだ。この二つはまったく別物であり、両者を混同することこそ、レジャーが本来あぶり出すべき典型的な誤りだ。
自分のコーパスの5分の1は未検証であり、ツールはそれを正直に出している。 エンジンが報告する unverified_rate は 0.22、つまり32件中7件だ。2026-09-24 追記:この記事の初出時の値は 0.53 だった。当時「検証済み」は私が手で書き込むフラグだった。手書きのフラグこそ、このゲートが捕まえるための「稼いでいない保証」そのものだ。そこで今は、主張が挙げるすべての出典を一次サービス(arXiv、doi.org、出版社)に実際に照会し、その応答を記録して初めて「検証済み」と数える。この作業でさらに10件の主張が確認でき、裏付けなしに「検証済み」と付けていた1件も見つかった。残る7件のうち6件は業界に流布する通説で、意図的に通説として記録したものなので、そもそも一次出典が存在しない。残る1件は、スクリプトでは開けない有料の認証規格に依拠している。都合のいい部分だけを見せるのではなく、この数字を公開する——「自分の主張が何に依拠しているかを明示せよ」という趣旨のプロジェクトが、自分の指標だけを加工するのは許されない。
参考文献
- Sinha, A., Arun, A., Goel, S., Staab, S., & Geiping, J. (2025). The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs. arXiv:2509.09677, 2025年9月11日投稿。arxiv.org/abs/2509.09677
- Phan, D. T., Grosu, R., Jansen, N., Paoletti, N., Smolka, S. A., & Stoller, S. D. (2019). Neural Simplex Architecture. arXiv:1908.00528, 2019年8月1日投稿。arxiv.org/abs/1908.00528
- Leviathan, Y., Kalman, M., & Matias, Y. (2022). Fast Inference from Transformers via Speculative Decoding. arXiv:2211.17192, 2022年11月30日投稿。arxiv.org/abs/2211.17192
- Doyle, J. C. (1978). Guaranteed margins for LQG regulators. IEEE Transactions on Automatic Control, 23(4), 756–757. doi.org/10.1109/TAC.1978.1101812 — 有料論文のため本文は未引用、要旨のみ記載。
- Hobbs, K. L. 他 (2021). Run Time Assurance for Safety-Critical Systems: An Introduction to Safety Filtering Approaches. arXiv:2110.03506. arxiv.org/abs/2110.03506
- Ames, A. D., Coogan, S., Egerstedt, M., Notomista, G., Sreenath, K., & Tabuada, P. (2019). Control Barrier Functions: Theory and Applications. arXiv:1903.11199. arxiv.org/abs/1903.11199
- Mayne, D. Q., Rawlings, J. B., Rao, C. V., & Scokaert, P. O. M. (2000). Constrained model predictive control: Stability and optimality.Automatica、36(6)、789–814。doi.org/10.1016/S0005-1098(99)00214-9
- Åström, K. J., & Murray, R. M.Feedback Systems: An Introduction for Scientists and Engineers。無料PDF:cds.caltech.edu — この記事で興味を持った人には、ここが本格的な学びの入り口になる。
- Anthropic (2024).Building effective agents. anthropic.com/engineering/building-effective-agents — evaluator-optimizerパターンは、制御工学の用語を取り除いたフィードバック制御そのものである。
- 実装と、本記事で使った全データセット:github.com/wjlgatech/control-anything — レジャーをビルドゲートとして動かすオープンソースエンジン。
make check本記事の数値 — 32件の主張のうち30件が制限または拒否され、unverified_rate0.22 — オフラインで動作し、APIキー不要。数値はすべて手で作成され、このサイトのリポジトリに保存されている(上記リポジトリではない)。
執筆:Paul Jialiang Wu ・ agentic-portfolio-lovat.vercel.app