SERIE AI-NATIVE · Ingeniería de agentes · Ingeniería de control
El registro de supuestos: la garantía de seguridad termina donde nadie miró
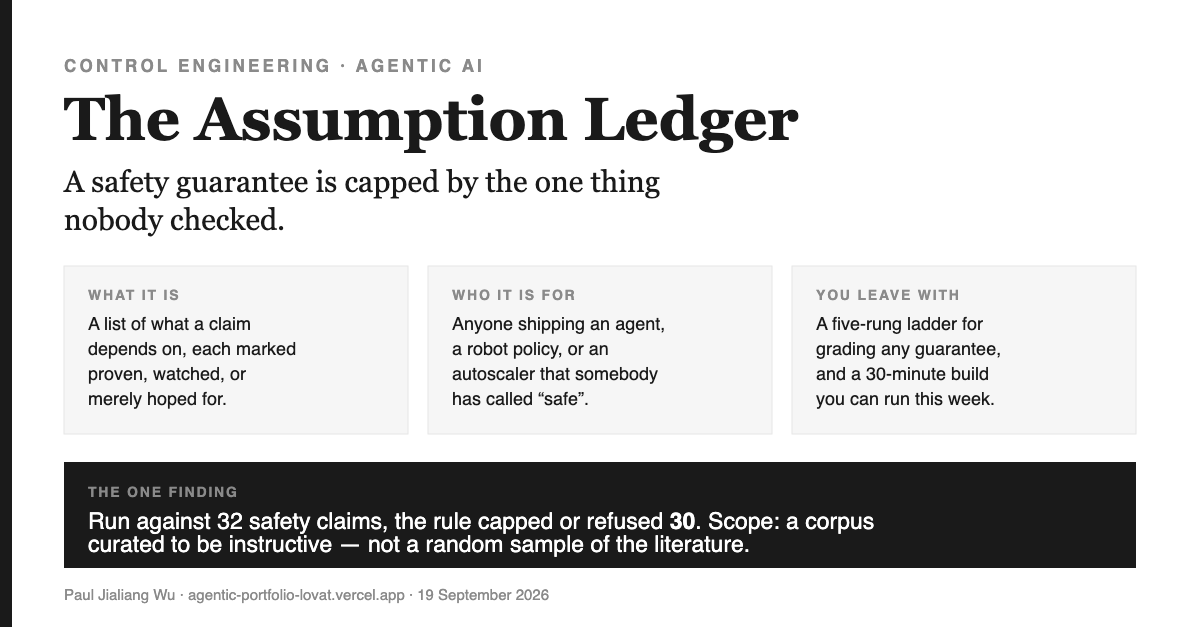
En un minuto — lo que te llevas de aquí
¿Qué es esto? Un truco de control de riesgos, heredado de la ingeniería de control. Un registro de supuestos es una lista de todo lo que debe cumplirse para que una afirmación de seguridad tenga sentido — y junto a cada elemento, una marca que indica si está comprobado, vigilado en tiempo de ejecución, o simplemente esperado. La garantía de la afirmación queda limitada por la suposición más débil de la lista. Basta con que un solo punto no esté verificado para que todo el alcance quede restringido, aunque el resto sea impecable.
Por qué importa. “Usamos un controlador predictivo por modelo, así que es seguro” es la sobreafirmación más común en control aplicado, y su versión en software — “agregamos un guardarraíl, así que el agente es seguro” — ya es rutina semanal. El teorema de estabilidad habla solo del modelo,[8]. Si nadie contrasta el modelo con el robot real, el teorema sigue siendo válido, pero la promesa no. Esta falla pasa completamente desapercibida: una suposición sin verificar no avisa cuando deja de cumplirse, por eso solo la ves reflejada en el informe de incidentes.
Qué puedes hacer después de leer. Puedes clasificar cualquier garantía usando una escala de cinco niveles (de G0 anécdota a G4 certificado), escribir la tabla de supuestos debajo y quedarte con el nivel más bajo. Al final tienes una guía de 30 minutos — entradas, invariante, regla de paro y el umbral de CI — más la implementación open-source que generó todos los números de este artículo.
Qué es un assumption ledger y para quién sirve
Un assumption ledger es una tabla que acompaña a una afirmación. Cada fila enumera algo de lo que depende esa afirmación (aunque no se diga explícitamente), y cada fila lleva un estado:discharged (comprobado o asegurado físicamente),monitored (hay una verificación activa en tiempo de ejecución y ocurre algo cuando se dispara),assumed (creído, sin comprobar, ni vigilado), oviolated (sabidamente falso). Eso es todo el mecanismo. El resto de este artículo es lo que pasa cuando lo conviertes en cuentas.
Está dirigido a cualquiera que lance un sistema que otra persona describa como seguro, estable, alineado o confiable: un agente con acceso a herramientas, una política robótica aprendida, un autoscaler, un filtro de contenido, un guardarraíl para trading. No hace falta saber teoría de control para aplicarlo. Vas a salir con un vocabulario que convierte cualquier argumento vago sobre seguridad en algo breve y comprobable — y con la experiencia de enfrentarte a tu propio sistema bajo esta lupa.
La teoría de control[9] es la única rama madura de la ingeniería que se dedica por completo a responder la pregunta:“this thing acts, the world answers back, now what?” (Traducción: ‘esto actúa, el mundo responde, ¿y ahora qué?’) — que es exactamente el escenario en el que entró la IA cuando los agentes empezaron a tomar acciones y observar los resultados. Lleva un siglo produciendo resultados sobre cuándo esos bucles se estabilizan y cuándo se descontrolan. Y también un siglo de cicatrices sobre cómo se malinterpretan esos resultados; la tabla de supuestos es, en cierto modo, esa cicatriz hecha método.
Toda la explicación gira en torno a una sola analogía, y merece la pena presentarla de frente en vez de dejar que se cuele sin avisar.
La escalera de la cocina: cinco cocinas, cinco tipos de promesa
Piensa en la diferencia entre cocinar solo para ti y encargarte de una red nacional de suministro de alimentos. No es que lo segundo sea necesariamente más difícil; lo que cambia es que la promesa es de una naturaleza distinta en cada nivel.
Cocinas para ti: lo pruebas y está bien. Esa promesa solo cubre una comida que ya te comiste. Cocinas para tu familia cada semana: ahora sabes que funciona para estas cinco personas, en esta cocina. Si tienes un restaurante: cuentas cuántos platos sirves y cuántas quejas recibes, y puedes decir algo sobre la frecuencia con la que sale bien. Si gestionas una cadena de comida rápida: la receta tiene que sobrevivir en quinientas sucursales, cambios de proveedor y cocineros que nunca te han visto — debe aguantar la variabilidad que ya anticipaste y anotaste. Si manejas una red nacional de suministro: alguien te audita, y la promesa es un documento firmado.
Cada escalón es una afirmación más fuerte que el anterior, y cada uno exige algo más que solo probar la comida. Aquí va la correspondencia, uno a uno:
| Cocina | La promesa | Término de control |
|---|---|---|
| Cocinar para ti | “Estaba rico.” | G0 · anécdota — funcionó una vez |
| Cocinar para la familia | “Funciona para nosotros, cada semana.” | G1 · empírico — medido, en distribución |
| Manejar un restaurante | “Noventa y cinco por ciento de los servicios, sin quejas.” | G2 · estadístico — un límite, con un nivel de confianza |
| Manejar una cadena | «Se cumple en todas las sucursales y proveedores de nuestra lista.» | G3 · robusto — válido frente a un conjunto de incertidumbre declarado |
| Operar una cadena de suministro nacional | «Auditado, y aquí está el certificado.» | G4 · certificado — comprobado contra un modelo formal |
El peldaño clave es el salto de G1 a G2. Por debajo, sabes lo que ya ocurrió. En G2 o más arriba, puedes anticipar lo que va a ocurrir — pero solo dentro de las suposiciones que dejaste explícitas. La mayoría de las afirmaciones de seguridad en IA en 2026 se quedan en G1, aunque suelen estar redactadas con la confianza de G3.
Aquí es donde la analogía cobra sentido. Un restaurante no fracasa porque el chef olvide cocinar, sino porque el congelador estuvo dos grados más caliente durante una semana y nadie miró el termómetro. La receta nunca fue el problema. El proveedor sin auditar era el verdadero riesgo — y el ledger no es más que la lista de proveedores, con una columna para marcar si alguien de verdad los está vigilando.
La regla del límite
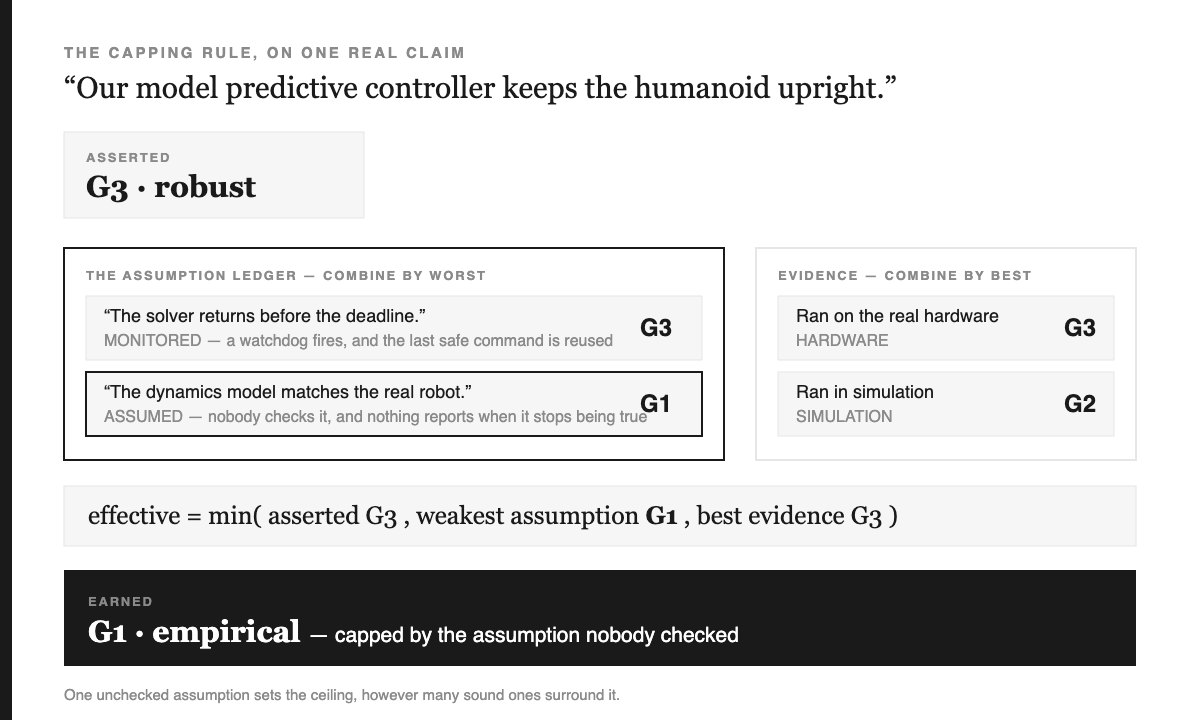
Escribe el nivel que afirma la garantía. Haz el ledger. Y después, quédate con el nivel más bajo:
effective = min( asserted , weakest assumption , best evidence )Dos detalles son los que realmente importan, y tiran para lados opuestos.
Las suposiciones se combinan por la más débil. Una cadena solo es tan fuerte como su eslabón más frágil. Una sola suposición sin vigilar limita la garantía, por muchas otras rigurosas que la rodeen — porque el fallo entra justo por la que nadie miró, y lo hace sin avisar.
La evidencia se combina por la más sólida. La evidencia no es una cadena. Tener una analogía floja junto a un resultado de hardware no debilita el resultado de hardware. Así que te quedas con tu respaldo más fuerte, no con el más débil.
Cada estado de una suposición impone un techo, y esta tabla es el único juicio de diseño real en todo el esquema:
| Estado | Techo | Por qué ese límite |
|---|---|---|
discharged — comprobado, o asegurado físicamente | G4 | No representa un obstáculo. |
monitored — se activa una comprobación y entra un fallback | G3 | Aquí estás detectando la violación, no evitándola. Eso te da robustez, pero no certificación. |
assumed — asumido, sin verificar, ni vigilar | G1 | Puedes informar lo que realmente mediste. No puedes prometer lo que ocurrirá, porque la base de tu promesa está sin revisar. |
violated — sabido como falso | G0 | Rechazado. Solo te queda mostrar una demo. |
La fila que siempre genera debate entre lectores atentos es la de monitored. ¿Por qué una comprobación en tiempo real te deja en robusto y no en certificado? Aunque el detector funcione y el fallback esté comprobado, ¿qué falta? Siempre son las mismas tres cosas. Un monitor solo reacciona cuando la violación ya empezó, así que su garantía depende de cuánto tarda en detectarla. Solo observa las señales que alguien decidió vigilar, así que su cobertura es otra suposición más. Y el fallback tiene que activarse a tiempo, lo cual depende del mundo real, no solo del monitor. Una prueba o un mecanismo físico no tienen estos problemas: excluyen el estado peligroso en vez de solo detectarlo. Esa es toda la diferencia entre detectar y excluir, y por eso el límite está donde está.
Hay una regla que mantiene honesto el registro de supuestos, y es justo la que más se intenta esquivar: marcar una suposición como monitored o discharged exige ponerle nombre a la comprobación. No basta con describirla: hay que nombrarla. ¿Qué monitor, sobre qué señal, con qué umbral y qué ocurre cuando se activa? Una comprobación sin nombre es solo un deseo, y un registro lleno de deseos vale lo mismo que no tener nada.
¿Qué pasó cuando lo apliqué a 32 afirmaciones?
Incorporé este registro de supuestos en un motor open-source pequeño [11] y redacté 32 afirmaciones de seguridad — abarcando los doce dominios que cubre el motor, sobre todo alignment, robótica e IA física, pero también aeroespacial, infraestructura de servicios, medicina y mercados — cada una con sus supuestos y su evidencia. La compuerta, en 30 de los 32 casos, puso un límite o directamente rechazó la afirmación.30 de 32.
Ese número solo tiene sentido con su contexto: el alcance es casi todo su significado. Este conjunto lo armé a propósito para enseñar: metí a mano afirmaciones infladas famosas y contraejemplos célebres, porque un set didáctico sin fallos no enseña nada.No es una muestra aleatoria de la literatura, y ese 30/32 no es un dato estadístico del campo. Si quieres la versión honesta y directa: en un grupo de afirmaciones elegidas para incluir fallos conocidos, la regla encontró justo esos fallos — lo que prueba que la regla funciona, pero no dice nada sobre cuán frecuentes son en general.
Dos afirmaciones sí pasaron al nivel que decían, y pesan tanto como las otras treinta: una compuerta que lo rechaza todo es tan inútil como una que nunca rechaza nada.
Las dos que sobrevivieron, y por qué son distintas
Speculative decoding se sostiene en G4 porque su garantía fue derivada y no observada. Un modelo pequeño y rápido propone varios tokens; el modelo grande los revisa de una sola pasada; si rechaza un borrador, se vuelve a muestrear usando una regla elegida justo para que la distribución de salida no cambie. El artículo reporta que la aceleración se logra “without changing the distribution” (Traducción: sin cambiar la distribución) y “without any changes to the outputs” (Traducción: sin ningún cambio en las salidas) [4]. Lo clave es que ambas suposiciones están respaldadas por mecanismos concretos: la regla de aceptación se comprueba con un test de equivalencia de distribuciones usando una semilla fija en integración continua, y el requisito de vocabulario compartido se valida al cargar el modelo, así que si hay incompatibilidad, el sistema ni siquiera arranca en vez de degradarse en silencio. No son promesas: es código que falla de forma ruidosa. En términos culinarios: hay un catador en la línea revisando cada plato contra la receta del chef, y una regla escrita para recocinar los rechazados que deja el menú idéntico. No es una política que diga que alguien debería probar.discharged
Tube model predictive control se sostiene en G3 — robusto, tal como se afirma, y ni un peldaño más. Garantiza el cumplimiento de restricciones para cualquier perturbación dentro de un conjunto acotado asumido [8]. Esa última condición lo es todo. La garantía depende de que la perturbación real se mantenga dentro del rango para el que diseñaste, y un despliegue honesto por eso mismo vigila esa condición: un monitor de residuo compara la perturbación observada contra el conjunto de diseño, y si hay desvíos, se registran y se disparan alarmas. Monitoreado, no eliminado — por eso es G3 y no G4. Es la cadena que aguanta mientras cada proveedor sigue dentro de la hoja de especificaciones, con alguien leyendo de verdad el termómetro. Un sitio muy bueno para estar. Solo que no es lo mismo que “auditado”.
El patrón común en ambos casos:una afirmación sobrevive cuando sus suposiciones están respaldadas por mecanismos reales, no por buenas intenciones. Ningún equipo necesitaba un modelo mejor. Lo que hacía falta era una verificación con nombre, umbral y consecuencia.
Patrones y antipatrones
| Antipatrón | El patrón que lo reemplaza |
|---|---|
| «Usamos la técnica X, así que estamos seguros.» | Nombra exactamente sobre qué trata el teorema de X, y luego comprueba si eso se cumple en tu despliegue. |
| Un guardarraíl sin ningún disparador definido. | Un monitor con señal, umbral y un fallback concreto que realmente se ejecuta. |
| El generador se evalúa a sí mismo. | Una segunda opinión que falla de forma distinta; si hay desacuerdo, se escala. |
| Una página de seguridad escrita en lenguaje de demostración. | Una página de seguridad donde cada afirmación lleva el peldaño que realmente le corresponde. |
| Exprimir una métrica hasta que deje de cambiar. | Detenerse cuando la métrica y lo que realmente te importa siguen alineados. |
| Una compuerta que nadie ha visto activarse. | Una compuerta con una prueba que la fuerza a activarse a propósito. |
Tres trampas que sí valen tu atención
1. «Es óptimo, así que tiene buenos márgenes de seguridad.» Durante años, el campo creyó esto del controlador óptimo estándar. Hasta que en 1978 John Doyle publicó un artículo de dos páginas — título: Guaranteed margins for LQG regulators; resumen, famoso, una sola frase que viene a decir que no hay ninguno — construyendo un diseño óptimo cuyo margen de ganancia puede ser tan pequeño como quieras [5]. «Óptimo» y «seguro» resultaron ser adjetivos que no tienen nada que ver. Cualquier afirmación del tipo «lo optimizamos, así que es robusto» es esta misma trampa con disfraz moderno.
2. «El modelo critica su propia salida, así que la calidad mejora.» Rechazado, ni siquiera limitado — porque el crítico y el generador son el mismo sistema, lo que hace que una suposición sea directamente falsa en vez de simplemente no comprobada. La primera regla de la instrumentación es simple y antigua: nunca cierres un bucle sobre tu propio instrumento. La autocrítica solo funciona de verdad cuando hay una señal externa en el bucle — un test suite, un compilador, el entorno devolviendo feedback — y sin eso, se desvía. El arreglo no es un mejor prompt. Es una segunda opinión que falla de otra manera.
3. «Dale suficientes pasos al agente y terminará la tarea.» Rechazado, porque parte de que los errores son independientes, y no lo son. Midiendo directamente la ejecución a largo plazo, Sinha y sus colegas encuentran que “models become more likely to make mistakes when the context contains their errors from prior turns” (Traducción: los modelos tienen más probabilidades de cometer errores cuando el contexto contiene sus propios errores de turnos anteriores).[2]. Eso no es ruido que se acumula: es retroalimentación positiva. La salida se convierte en la siguiente entrada y sigue empujando en la misma dirección. Así empiezan todos los grandes desastres de ingeniería: una pequeña oscilación, y acabas recogiendo los pedazos.
Por qué esto es especialmente crítico en sistemas agénticos
Si comparas un agente que usa herramientas con los seis órganos que tiene todo lazo de retroalimentación, verás que una fila queda sospechosamente vacía:
| Órgano | En un termostato | En un agente que usa herramientas |
|---|---|---|
| referencia — lo que buscas | la temperatura que ajustaste | el objetivo del usuario, declarado una vez y nunca más leído |
| comparador — cómo detectas la diferencia | resta | normalmente nada [10] |
| controlador — quién decide | el interruptor del termostato | la política de siguiente token |
| actuador — quién ejecuta | el relé de la caldera | la llamada de herramienta que se emite |
| planta — sobre qué se actúa | la habitación | el sistema de archivos, la red, el usuario |
| sensor — quién informa de vuelta | el termómetro | valores devueltos por la herramienta |
Y luego están los tres aspectos que casi siempre se dejan de lado—y justo ahí es donde los sistemas reales suelen tropezar. Latencia: segundos por paso, decenas de pasos, sin límite en el horizonte temporal. Autoridad: lo que permitan los permisos de la herramienta — el límite de autoridad menos explorado en la computación moderna, y casi siempre el más laxo. Plan B: normalmente ninguno.
Un termostato cableado así — objetivo leído una sola vez, sin señal de error, autoridad sin límites y sin plan B — quemaría tu casa, y lo haría mientras te dice que todo está perfecto. No es una broma sobre el campo; yo mismo he desplegado esa arquitectura, más de una vez, y la llamé framework de agentes.
La buena noticia: la solución existe y es vieja conocida. Casi nunca tienes que volver infalible la parte sofisticada. Deja que el controlador no verificado haga lo suyo, pon una línea base probada y segura detrás de un monitor que pueda tomar el control, y permite que una persona pueda intervenir o salir en cualquier momento. En ingeniería de control, esto se llama arquitectura Simplex, parte de una familia de diseños para asegurar el sistema en tiempo de ejecución [6] que también incluye el filtro de seguridad basado en funciones de barrera [7]; su versión neuronal lo dice sin rodeos: “not only provides safety assurances in the presence of a possibly unsafe neural controller, but can also improve the safety of such a controller in an online setting via retraining, without overly degrading its performance” (Traducción: «no solo ofrece garantías de seguridad en presencia de un controlador neuronal posiblemente inseguro, sino que también puede mejorar la seguridad de dicho controlador en un entorno en línea mediante reentrenamiento, sin degradar excesivamente su rendimiento»)[3]. La garantía está en la capa de restricciones, no en la política. Así es como funciona el avión en el que volaste la última vez, y tu agente puede tenerlo hoy mismo.
Hazlo en 30 minutos
No necesitas el repo. Solo una tabla y un min().
Entradas. Una afirmación, en una frase. El nivel que su autor declara (G0–G4). Una lista de supuestos, cada uno con su estado y — para monitored o discharged — el nombre de la verificación. Una lista de tipos de evidencia (prueba, hardware, simulación, benchmark, ablación, analogía).
Salida. El nivel efectivo, más el identificador de lo que lo limitó.
El invariante. La compuerta nunca sube el nivel. Es árbitro, no porrista: una afirmación modesta, aunque tenga evidencia abrumadora, sigue siendo modesta.
La regla para detener. A violated una suposición rechazada detiene el proceso de inmediato — no limita, simplemente corta ahí y no sigues leyendo.
Estructura mínima:
CEIL = {"discharged": 4, "monitored": 3, "assumed": 1, "violated": 0}
EVID = {"proof": 4, "hardware": 3, "simulation": 2,
        "benchmark": 1, "ablation": 1, "analogy": 0}

def judge(asserted, assumptions, evidence):
    if any(a.status == "violated" for a in assumptions):
        return 0, "refused"
    if asserted > 0 and not evidence:
        return 0, "unproven"          # no evidence means no
    if asserted >= 2 and not assumptions:
        return 1, "capped"            # a guarantee resting on nothing
    floor = min((CEIL[a.status] for a in assumptions), default=4)
    roof  = max((EVID[e] for e in evidence), default=0)
    return min(asserted, floor, roof), "..."
Los dos default= argumentos no son adorno: son la diferencia entre código que funciona y código que lanza ValueError en el primer ledger que escriba alguien — una afirmación G1 sin suposiciones listadas aún. Un ledger vacío no pone ningún límite, por eso existe el chequeo aparte de “afirma G2 o más y no nombra suposiciones”.
El umbral para CI. Cuenta cuántas afirmaciones la compuerta limita o rechaza y falla la build si el número es cero. Una compuerta que nunca se activa es puro decorado, y eso es peor que nada porque genera una falsa confianza — como el termómetro en la cámara frigorífica que marca cuatro grados todo el año porque nadie lo conectó a nada. La mía falla en doce de treinta y dos.
Deliberadamente ausente. Sin intervalos de confianza para los techos — los cuatro números en CEIL son un juicio, no un resultado, y fingir lo contrario sería justo el error que este artículo quiere evitar. Nada de extracción automática de suposiciones: un modelo que adivina de qué depende tu sistema produce un ledger que suena bien pero está mal, lo cual es peor que dejarlo vacío. Escribir el ledger a mano es el trabajo real; la aritmética es la parte fácil.
La misma historia, cinco salidas posibles
| Tú eres… | La decisión | La acción para esta semana |
|---|---|---|
| Estudiante | En qué peldaño realmente está la afirmación de tu proyecto. | Escribe una frase sobre tu sistema y luego el ledger debajo. La mayoría de los primeros ledgers tienen una sola fila y dice assumed. |
| Ingeniero | Si tu baranda es un monitor o solo un deseo. | Por cada chequeo de seguridad que implementes, ponle nombre a la señal, el umbral y qué ocurre cuando se activa. Si no puedes nombrarlo, es assumed. |
| Fundador | Qué puede afirmar tu página de seguridad. | Evalúa cada afirmación de la página. Reescribe cualquier cosa que esté por encima del nivel que realmente le corresponde—antes de que alguien más lo haga por ti. |
| Ejecutivo | Si decir “tenemos guardrails” realmente responde algo. | Haz una sola pregunta en la próxima revisión: ¿cuál es el supuesto clave y quién lo está vigilando? Si nadie responde, ahí tienes el hallazgo. |
| Inversionista | Si esa supuesta barrera técnica es un teorema o solo una demo. | Pregunta en qué se apoya la afirmación y cómo se verifica cada punto. G4 en un sistema aprendido y desplegado es raro; escuchar que alguien lo afirma sin más ya es información. |
Lo que no estoy diciendo
La escalera es un criterio, no un teorema. Los cinco peldaños y los cuatro techos son diseño mío. Son defendibles y mecánicos; nadie los ha demostrado. Viven en una sola función para que sea fácil discutirlos, que es lo más honesto que puedo ofrecer.
30 de 32 no es una encuesta. Lo aclaro aquí y arriba porque es el número más fácil de citar fuera de contexto: el corpus fue curado a propósito para incluir fallos conocidos.
La bitácora de supuestos no hace que nada sea seguro. Lo que hace es que la afirmación sea honesta. Son cosas distintas, y confundirlas sería justo el tipo de error que la bitácora existe para señalar.
Una quinta parte de mi propio corpus no está verificada, y la herramienta lo dice. El motor reporta un unverified_rate de 0.22: 7 de 32 afirmaciones. Actualizado el 2026-09-24: este artículo salió diciendo 0.53, cuando «verificado» era una marca que yo escribía a mano. Una marca escrita a mano es justo la garantía no ganada que la compuerta existe para atrapar, así que ahora una afirmación cuenta como verificada solo cuando cada fuente que cita se ha consultado en su servicio primario (arXiv, doi.org, la editorial) y la respuesta queda registrada. Esa pasada resolvió diez afirmaciones más, y atrapó una que yo había marcado como verificada sin nada detrás. Seis de las siete que quedan son folclore de la industria, registrado a propósito como folclore, sin fuente primaria por diseño; la séptima se apoya en una norma de certificación de pago que ningún script puede abrir. Publico el número en vez de reportar solo el subconjunto que me favorece: un proyecto cuya tesis entera es «di en qué se apoya tu afirmación» no puede maquillarse su propia métrica.
Referencias
- Sinha, A., Arun, A., Goel, S., Staab, S., & Geiping, J. (2025). The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs. arXiv:2509.09677, enviado el 11 de septiembre de 2025. arxiv.org/abs/2509.09677
- Phan, D. T., Grosu, R., Jansen, N., Paoletti, N., Smolka, S. A., & Stoller, S. D. (2019). Neural Simplex Architecture. arXiv:1908.00528, enviado el 1 de agosto de 2019. arxiv.org/abs/1908.00528
- Leviathan, Y., Kalman, M., & Matias, Y. (2022). Fast Inference from Transformers via Speculative Decoding. arXiv:2211.17192, enviado el 30 de noviembre de 2022. arxiv.org/abs/2211.17192
- Doyle, J. C. (1978). Guaranteed margins for LQG regulators. IEEE Transactions on Automatic Control, 23(4), 756–757. doi.org/10.1109/TAC.1978.1101812 — acceso restringido; descrito, no citado.
- Hobbs, K. L., et al. (2021). Run Time Assurance for Safety-Critical Systems: An Introduction to Safety Filtering Approaches. arXiv:2110.03506. arxiv.org/abs/2110.03506
- Ames, A. D., Coogan, S., Egerstedt, M., Notomista, G., Sreenath, K., & Tabuada, P. (2019). Control Barrier Functions: Theory and Applications. arXiv:1903.11199. arxiv.org/abs/1903.11199
- Mayne, D. Q., Rawlings, J. B., Rao, C. V., & Scokaert, P. O. M. (2000). Constrained model predictive control: Stability and optimality. Automatica, 36(6), 789–814. doi.org/10.1016/S0005-1098(99)00214-9
- Åström, K. J., & Murray, R. M. Feedback Systems: An Introduction for Scientists and Engineers. PDF gratuito: cds.caltech.edu — la mejor puerta de entrada si este artículo te dejó con ganas de sumergirte en el tema de fondo.
- Anthropic (2024). Building effective agents. anthropic.com/engineering/building-effective-agents — el patrón evaluador-optimizador es un controlador de retroalimentación, pero sin el vocabulario de control.
- La implementación y el corpus de donde salió cada cifra aquí: github.com/wjlgatech/control-anything — un motor open-source que ejecuta el ledger como compuerta de build.
make checkreproduce cada número en este artículo — 32 afirmaciones, 30 limitadas o rechazadas,unverified_rate0.22 — offline y sin llaves. Las cifras están escritas a mano y viven en el repo de este sitio, no en aquel.
Escrito por Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app