AI-NATIVE 系列 · 智能体工程 · 控制工程
假设清单:安全保障的天花板,往往是唯一没人盯的那一项
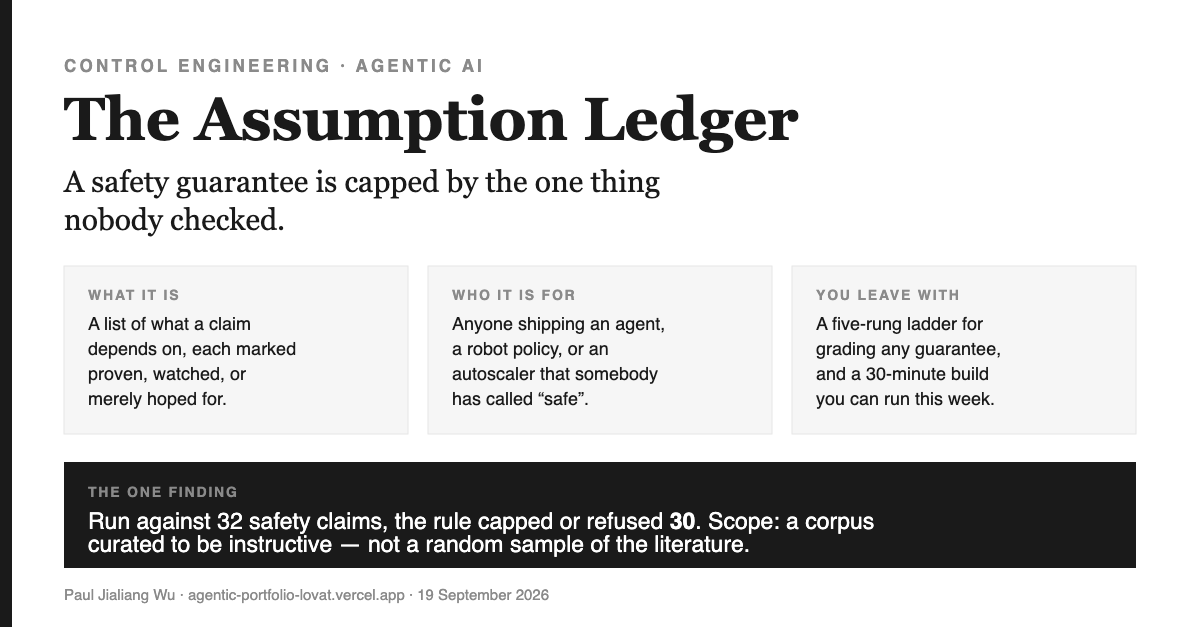
一分钟速读 | 你会收获什么
这是什么 这是一个来自控制工程的“假设账本”方法。所谓假设清单,就是把一个安全声明赖以成立的所有前提列出来——每一项旁边都要标明:已验证, 运行时监控,或者纯靠祈祷。最终,保障能力的上限取决于最薄弱的那条假设。哪怕其他假设再牢靠,只要有一条没人管,它就成了天花板。
为什么你该关心这件事在实际控制领域,最常见的过度承诺就是“我们用了模型预测控制器,所以它是安全的”;它的软件版本——“我们加了护栏,所以智能体没问题”——现在几乎每周都能见到。可稳定性定理只关心模型本身[8]。如果没人把模型和机器人本体对上号,定理依然没错,但承诺就成了空头支票。这类失效天生不会报警:只要有假设没人盯着,哪天失效了也不会冒泡,所以你只会在事故报告里见到它。
读完你能立刻做什么用五级阶梯(G0 见闻→G4 认证)给任何保障打分,把假设清单写在下面,然后直接取最低那档。文末有个 30 分钟上手的实操指南——输入、守恒条件、终止规则、CI 阈值——以及产出所有数据的开源实现。
假设清单是什么,这篇文章写给谁
所谓假设清单,就是承诺下面的一张表。每一行都是承诺背后悄悄依赖的条件,每行都要标明状态:discharged(已验证或物理互锁)monitored(运行时有监控触发,并且触发时会有动作)assumed(相信但未验证、无人监控)violated(已知为假)。机制就这么简单。剩下的内容,就是把它变成算术之后的结果。
这篇文章写给所有要交付系统、而别人会用“安全”“稳定”“对齐”“可靠”来评价其行为的人:比如有工具权限的智能体、训练出来的机器人策略、自动扩缩容器、内容过滤器、交易风控。你不需要懂控制理论也能用这套方法。读完你会多一套词,把模糊的安全论证变成简明、可检验的说法——以及,亲手把它用在自己系统上时的那种微妙不适。
控制理论[9]是唯一一个把“这个东西会行动,世界会反馈,然后怎么办?”作为全部主题的成熟工程学科“this thing acts, the world answers back, now what?”(中译:这个系统采取行动,世界给出反馈,然后怎么办?)——这正是智能体开始行动、读取结果时,AI 领域正面临的局面。控制理论有一百年的成果,研究这种循环什么时候能稳定、什么时候会失控。它也有一百年被误用的教训,而假设清单,就是这些教训的结晶。
有一个类比贯穿全文,值得直接亮出来,而不是偷偷带进去。
烹饪的五级阶梯:厨房越大,承诺越重
想象一下,从自己做饭到运营全国食品供应链,区别其实不在于难度,而在于——承诺在每个阶段都变成了完全不同的东西。
自己做饭:你尝一口,觉得没问题。这只是对你刚吃掉那一顿的承诺。每周给家人做饭:你知道这套做法在这个厨房、这五个人身上一直靠谱。开餐厅:你要统计上桌人数和投诉,能说出大致的成功率。开快餐连锁:你的配方得经得起五百家门店、供应商更换,甚至一个从没见过你的厨师来操作——必须能扛住你提前列出来的所有变数。全国供应链:有人来审计你,这份承诺成了一份带签名的正式文件。
每往上走一级,主张就更强,也远不止“尝一口”那么简单。下面是一一对应的映射:
| 厨房类型 | 承诺方式 | 控制论术语 |
|---|---|---|
| 自己做饭 | “尝过,没问题。” | G0 · 见闻——就那一次成功 |
| 给家人做饭 | “我们家每周都行。” | G1 · 经验型——有测量,分布内 |
| 开餐厅 | “95%上桌无投诉。” | G2 · 统计型——有置信区间的界限 |
| 开连锁 | “我们清单上每家门店、每个供应商都能覆盖。” | G3 · 鲁棒——在预先声明的不确定性范围内都成立 |
| 全国供应链运营 | “已审计,证书在此。” | G4 · 认证——已与形式化模型核查 |
最关键的分界线,是从 G1 跨到 G2。G1 及以下,你只知道已经发生了什么。G2 及以上,你才知道将要发生什么——而且前提是你写清楚了所有假设。2026 年的大多数 AI 安全声明其实只停在 G1,却喜欢用 G3 的口吻来写。
现在说说这个比喻真正想点明的地方。餐厅倒闭,通常不是因为厨师手艺变差,而是冷库一周高了两度,没人盯着温度计。菜谱本身从来不是风险点,真正的风险,是那个没人审过的供应商——而 ledger,其实就是供应商清单,旁边多了一列:有没有人在认真盯着。
封顶规则
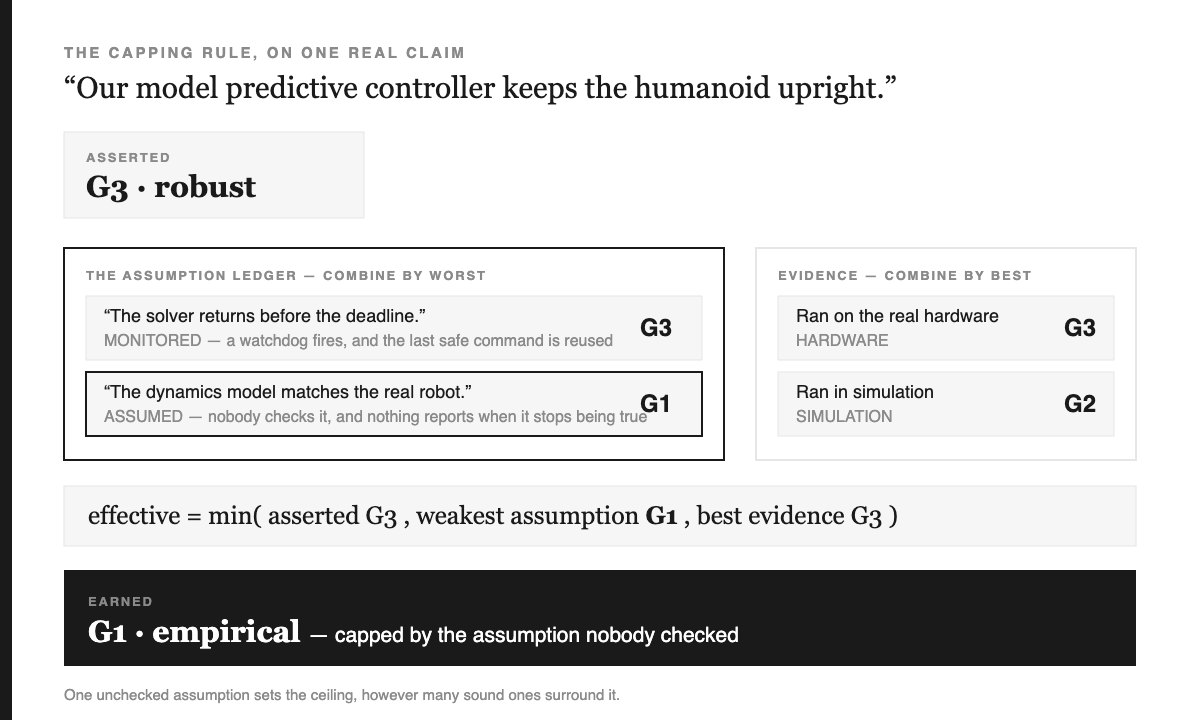
先写下你主张的等级,再列出 ledger,最后取两者的最小值:
effective = min( asserted , weakest assumption , best evidence )真正决定结果的有两个细节,而且方向还正好相反。
假设以最薄弱者为准。一条链条的强度取决于最弱的那一环。只要有一个假设没人检查,不管旁边多严密,这个声明的上限就被它锁死了——因为风险总是从那个没被看住的地方溜进来,而且毫无征兆。
证据则以最有力者为准。证据不是链条。硬核的硬件结果旁边多放一个类比,不会拖后腿。所以你要看最硬的那项,而不是最弱的。
每种假设状态都有自己的上限,这张表是整个方法里唯一真正需要设计判断的地方:
| 状态 | 上限 | 为什么是这个上限 |
|---|---|---|
discharged——已被证明,或硬件互锁 | G4 | 这类假设不会成为障碍。 |
monitored——有检查触发,并有兜底方案执行 | G3 | 你是在检测违规,而不是彻底排除违规。这带来的是健壮性,而不是认证。 |
assumed——只是相信、未验证、无人监控 | G1 | 你可以如实报告你测量到的内容,但不能承诺未来会怎样,因为你的承诺依赖的基础没人检查。 |
violated——已知为假 | G0 | 直接拒绝。你只剩下一个演示 Demo。 |
细心读者最容易质疑的,就是这一行:monitored。为什么运行时检查只能让你停在健壮(robust),而不是认证(certified)?哪怕检测器完全正确、兜底方案也已被证明,究竟还缺了什么?答案其实每次都一样:第一,监控器只有在违规已经发生后才会触发,所以保障能力受限于它自身的检测延迟;第二,它只监控那些被人想到要监控的信号,覆盖范围本身又成了新的假设;第三,兜底方案必须能及时介入,这其实是对外部世界的要求,而不是对监控器本身的要求。证明或硬件互锁则没有这些问题——它们直接把不希望出现的状态排除在外,而不是等违规发生后才发现。这就是“检测”与“排除”的全部差距,也是为什么上限要设在这里。
有一条规则能让 ledger 保持靠谱,而这也是大家最容易想跳过的:如果你把某个假设标记为monitored或discharged,就必须明确写出具体的检查机制。不是泛泛地“描述”——而是要“点名”:到底是哪个监控器、监控哪个信号、阈值是多少、触发后具体做什么。没有名字的检查只是许愿,ledger 里全是许愿,和没 ledger 没区别。
我实际把它跑在 32 条安全声明上,结果如何
我把 ledger 集成进了一个小型开源引擎 [11],然后写了 32 条安全声明——涵盖引擎支持的全部十二个领域,重点是 alignment、机器人和物理 AI,也包括航天、服务基础设施、医疗和市场——每条都列明了假设和证据。gate 最终把32 条结论里,有 30 条被拦下或降级.
看这个数字时,必须结合它的适用范围——因为意义几乎全在范围里。 这组案例是我特意挑选、用来教学的:里面故意收录了那些著名的过度承诺和反例。毕竟,没有失败的教学集,根本教不出什么。 它不是文献的随机抽样,30/32 也不是对整个领域的调查结果。 如果你要一句实话总结:在一组特意包含已知失败的结论里,这条规则确实找出了那些已知失败——这说明规则有效,但对底层概率没有任何说明。
有两条结论在自报等级上幸存下来,这两条和那三十条一样重要:一个什么都拒绝的闸门,和什么都不拒绝的闸门一样没用。
这两条幸存者,以及它们为何与众不同
Speculative decoding 达到 G4,因为它的保障是推导出来的,而不是观测到的。小模型先草拟几个 token,大模型一次性检查;被拒绝的草稿会按特定规则重采,确保输出分布不变。论文报告这种加速带来了“without changing the distribution”(中译:分布没有发生变化) 和 “without any changes to the outputs”(中译:输出没有任何变化) [4]。关键在于,它的两个前提假设都discharged有明确的落地机制:验收规则通过 CI 里的定种子分布等价性测试来校验,共享词表的要求在模型加载时就 assert,不匹配直接拒绝启动,而不是悄悄降级。两者都不是承诺,而是会大声报错的代码。厨房类比:有专人现场逐盘对照主厨菜谱验菜,退回重做的菜也有明文规则,菜单始终如一。不是“应该有人尝一口”这种口头承诺。
Tube model predictive control 达到 G3——正如它自己宣称的那样稳健,但也仅止于此。它保证只要干扰落在假定的有界集合内,约束就能被满足[8]。这句话的后半句就是全部关键。这个保障前提是实际干扰必须始终在你设计的集合内,所以真正靠谱的部署会实时监控这个条件:残差监控器会把实际观测到的干扰和设计集做对比,超出就记录并报警。是监控,不是消除——所以是 G3,不是 G4。这就像供应链里每个供应商都在规格表内,而且真的有人在读温度计。很好的状态,但和“已审计”不是一回事。
两者的共同点:只有当假设被绑定在具体机制上,而不是停留在意愿上,结论才能站得住。两个团队都不需要更好的模型,他们需要的是一个有名字、有阈值、有后果的检查。
模式与反模式
| 常见误区 | 更靠谱的做法 |
|---|---|
| “我们用了 X 技术,所以系统就安全了。” | 先说清楚 X 的定理到底针对什么对象,然后认真核查你的实际部署里,这个条件是否真的成立。 |
| 没有明确触发条件的 guardrail。 | 监控器要有具体的信号、阈值,以及明确命名的 fallback 动作。 |
| 生成器自己给自己打分。 | 引入一个失败方式不同的第二视角;遇到分歧就升级处理。 |
| 安全页全是证明体写法。 | 安全页上每条声明都标明它实际获得的等级。 |
| 把某个指标一路优化到不再变化。 | 在指标和你真正想要的东西还一致时就停下。 |
| 没人见过它变红的 gate。 | 有专门测试能故意触发的 gate。 |
三个你值得警惕的陷阱
1. “它是最优的,所以安全裕度肯定很好。” 这个领域曾经多年都相信标准最优控制器自带安全裕度。直到 1978 年,John Doyle 发了一篇两页的论文——标题:Guaranteed margins for LQG regulators;摘要就一句话,意思就是“没有”——他构造了一个增益裕度可以无限趋近于零的最优设计。[5] “最优”和“安全”其实风马牛不相及。任何“我们优化过了,所以它很鲁棒”的说法,本质上就是这个坑换了身新衣服。
2. “模型自己批判自己的输出,所以质量会提升。” 直接拒绝,不是降级——因为评论家和生成器其实是同一个系统,这让其中一个假设直接为假,而不是仅仅没验证。仪表的第一条古老铁律:永远别用自己的仪表闭环。自我批判只有在有系统外部信号参与时才真有效——比如测试集、编译器、环境的反馈——没有外部信号就会一路漂移。解决办法不是更好的 prompt,而是引入一个失败方式完全不同的第二意见。
3. “只要给 agent 足够多步,它总能把任务做完。”拒绝。因为这个假设建立在“每次出错都是独立事件”之上,而现实并非如此。Sinha 等人直接测量长序列任务的执行表现后发现:“models become more likely to make mistakes when the context contains their errors from prior turns”(中译:当上下文里带着模型前几步的错误时,模型后续更容易再次犯错)[2]。这可不是普通的噪声叠加,而是正反馈——输出变成了下一步的输入,错误一路自我放大。这正是那些从小小振荡演变成满地狼藉的工程事故背后的经典机制。
在智能体系统里,这一问题尤其致命
如果把一个用工具的智能体,逐项对照反馈回路的六个“关键部件”,你会发现有一格始终是空的:
| 部件 | 在恒温器中 | 在用工具的智能体中 |
|---|---|---|
| reference —— 目标设定 | 你调的温度 | 用户的目标,只读一次,之后再也不更新 |
| comparator —— 差距感知 | 做减法 | 通常啥都没有 [10] |
| controller —— 决策单元 | 恒温器的开关 | next-token policy |
| actuator —— 执行器 | 加热器继电器 | 发出的工具调用 |
| plant —— 被作用对象 | 房间 | 文件系统、网络、用户 |
| sensor —— 反馈信号 | 温度计 | 工具返回值 |
下面这三项,往往是大家最容易忽略的——而真正的系统,常常就倒在这里。延迟:每步几秒,几十步,整个流程没有任何时长上限。权限:只要工具权限放得下,理论上就能做——这是现代计算领域里最少被分析、通常也是最宽泛的权限边界。兜底机制:基本没有。
如果你把恒温器也这么接线——目标只读一次,没有误差信号,权限无限大,没有兜底——它能把你家烧成灰,还会一边烧一边报告“一切正常”。这不是在黑同行,我自己就造过这种架构不止一次,还堂而皇之叫它 agent framework。
好消息是,补救方案其实早就有了,而且很成熟。你几乎不用让“聪明的那部分”变得绝对可靠。让未经验证的控制器先跑着,把一个经过验证的安全基线放在可接管的监控器后面,随时允许人类一键退出。在控制工程里,这叫 Simplex 架构,是一类运行时保障设计的代表,[6]还包括 barrier-function safety filter(障碍函数安全过滤器)[7];它的神经网络版本直接写明「not only provides safety assurances in the presence of a possibly unsafe neural controller, but can also improve the safety of such a controller in an online setting via retraining, without overly degrading its performance」(中译:不仅能在可能不安全的神经控制器存在时提供安全保障,还能通过在线再训练提升控制器的安全性,同时不会显著降低其性能)[3]。真正的安全保障其实在约束层,不在策略里。你上次坐的飞机就是靠这个原理在飞,你的 agent 今天下午也能用上。
30 分钟就能搭出来
你不需要仓库,只需要一张表和一条规则。min().
输入。一句话写明你的主张。作者声称的等级(G0–G4)。假设列表,每项都要标明状态——如果是monitored或discharged,还要写清楚检查项的名字。证据类型列表(证明、硬件、仿真、基准、消融、类比)。
输出。实际等级,以及限制它的那一项的 id。
不变式。闸门从不抬高主张。它是裁判,不是加油团:哪怕证据堆积如山,主张本身保守,最后也只能保守。
停止规则。 A violated 只要遇到被拒绝的假设,立刻终止——不会再“封顶”,也不用继续往下看。
最简形态:
CEIL = {"discharged": 4, "monitored": 3, "assumed": 1, "violated": 0}
EVID = {"proof": 4, "hardware": 3, "simulation": 2,
        "benchmark": 1, "ablation": 1, "analogy": 0}

def judge(asserted, assumptions, evidence):
    if any(a.status == "violated" for a in assumptions):
        return 0, "refused"
    if asserted > 0 and not evidence:
        return 0, "unproven"          # no evidence means no
    if asserted >= 2 and not assumptions:
        return 1, "capped"            # a guarantee resting on nothing
    floor = min((CEIL[a.status] for a in assumptions), default=4)
    roof  = max((EVID[e] for e in evidence), default=0)
return min(asserted, floor, roof), "..."这两个default=参数不是多余的防线;它们决定了代码到底能不能顺利跑起来,还是一上来就ValueError在读者写下的第一个账本时就报错——比如一个G1主张但还没列出任何假设。空账本不会加盖任何上限,所以才有“主张G2及以上但没写假设”这个单独的检查。
CI 阈值。 统计闸门封顶或拒绝了多少主张,如果是零就让构建失败。一个永远不会触发的闸门只是摆设,而摆设型闸门比没有更糟——它们制造了虚假的安全感,就像冷库门上的温度计一年都显示四度但没人接线。我的账本里,32条有12条会让它失败。
有意留白。 天花板没有置信区间——这四个数字CEIL是判断,不是测量结果,假装成结果正是本文要批判的那种错误。没有自动假设提取:让模型去猜你的系统依赖什么,写出来的账本流畅但全错,比空账本还糟。账本必须手写,这本身就是核心工作,算术只是顺手的事。
同一套故事,五种出口
| 你是哪一类…… | 要做的决策 | 本周该做的动作 |
|---|---|---|
| 学生 | 你项目的主张到底在哪一档? | 写一句话描述你的系统,再在下面写出账本。绝大多数人的第一个账本只有一行,而且内容是assumed. |
| 工程师 | 你的防护栏到底是监控,还是许愿? | 你交付的每一个安全检查,都要写明信号、阈值,以及触发后跑什么。任何说不清楚的,都是assumed. |
| 创始人 | 你的安全页到底能写什么。 | 把页面上的每条声明都逐一打分。凡是高于实际得分的内容,统统重写——要在别人来挑刺之前,自己先把分数打实。 |
| 管理层 | “我们有防护栏”到底算不算答案。 | 下次评审只问一个问题:哪条假设真的是命门,谁在盯着它? 沉默,就是答案。 |
| 投资人 | 你的技术壁垒到底是定理,还是个演示? | 问清楚每个声明的依赖是什么、每项假设怎么被验证。在已部署的学习系统里,G4 极其罕见;如果有人轻描淡写地说自己有 G4,这本身就是重要信号。 |
我没在兜售什么绝对论断
这套分级梯子是判断标准,不是数学定理。 五个等级、四个上限,都是我自己定的。它们有理有据、可机械执行,但没人能证明它们放之四海而皆准。全都写在一个函数里,方便你随时质疑——这已经是我能给出的最大诚意了。
30/32 不是行业调研。 前面已经说过,这里再强调一次,因为这个数字最容易被断章取义:这个语料库是我特意挑选的,里面故意收录了已知的失败案例。
账本本身不会让任何系统变得安全。 它只是让声明 变得诚实。这是两回事,把它们混为一谈,正好是账本要防的那类错误。
我自己的语料有五分之一没验证,工具也如实标出来了。 引擎报告的 unverified_rate 是 0.22——32 条声明里有 7 条。2026-09-24 更新:这篇文章刚发布时写的是 0.53,那时“已验证”还是我手动敲上去的一个标记。手敲的标记,恰恰就是这个 gate 要抓的那种“没挣来的保证”。所以现在,一条声明只有在它引用的每个来源都被拿到一手服务(arXiv、doi.org、出版方)那里查过、并把结果记录下来之后,才算已验证。这一轮又核实了 10 条声明——还抓出 1 条我标了“已验证”、背后却什么都没有的。剩下的 7 条里,6 条是行业里流传的说法,我就是故意把它们当作传说记录的,本来就没有一手来源;第 7 条依据的是一份付费的认证标准,脚本打不开。我把这个数字公开出来,而不是只报好看的那部分——毕竟,这个项目的全部主张就是“把你的声明依赖写清楚”,自己洗数据就太讽刺了。
参考文献
- Sinha, A., Arun, A., Goel, S., Staab, S., & Geiping, J. (2025). The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs. arXiv:2509.09677,2025年9月11日提交。arxiv.org/abs/2509.09677
- Phan, D. T., Grosu, R., Jansen, N., Paoletti, N., Smolka, S. A., & Stoller, S. D. (2019). Neural Simplex Architecture. arXiv:1908.00528,2019年8月1日提交。arxiv.org/abs/1908.00528
- Leviathan, Y., Kalman, M., & Matias, Y. (2022). Fast Inference from Transformers via Speculative Decoding. arXiv:2211.17192,2022年11月30日提交。arxiv.org/abs/2211.17192
- Doyle, J. C. (1978). Guaranteed margins for LQG regulators. IEEE Transactions on Automatic Control,23(4),756–757。doi.org/10.1109/TAC.1978.1101812 —— 付费墙,仅描述,未引用原文。
- Hobbs, K. L., 等(2021)。Run Time Assurance for Safety-Critical Systems: An Introduction to Safety Filtering Approaches. arXiv:2110.03506。arxiv.org/abs/2110.03506
- Ames, A. D., Coogan, S., Egerstedt, M., Notomista, G., Sreenath, K., & Tabuada, P. (2019). Control Barrier Functions: Theory and Applications. arXiv:1903.11199。arxiv.org/abs/1903.11199
- Mayne, D. Q., Rawlings, J. B., Rao, C. V., & Scokaert, P. O. M. (2000). Constrained model predictive control: Stability and optimality.Automatica,36(6),789–814。doi.org/10.1016/S0005-1098(99)00214-9
- Åström, K. J., & Murray, R. M.Feedback Systems: An Introduction for Scientists and Engineers。免费 PDF:cds.caltech.edu ——如果你读完这篇文章想系统入门,这本是最友好的起点。
- Anthropic (2024)。Building effective agents. anthropic.com/engineering/building-effective-agents ——Evaluator-optimizer pattern 本质上就是把控制论词汇拿掉的反馈控制器。
- 实现代码,以及文中所有数据的出处:github.com/wjlgatech/control-anything ——一个开源引擎,把 ledger 作为构建 gate 执行。
make check能完整复现本文里的所有 数据 ——共 32 条 claim,30 条被 capped 或 refused,unverified_rate0.22 ——离线运行,无需密钥。所有数据均为手工撰写,托管在本站仓库,而非该开源库。
作者:Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app