AI-NATIVE 시리즈 · 에이전트 엔지니어링 · 제어 엔지니어링
가정 레저: 아무도 확인하지 않은 단 하나의 가정이 안전성 보장의 한계를 결정한다
핵심만 1분: 이 글을 읽고 얻어갈 것
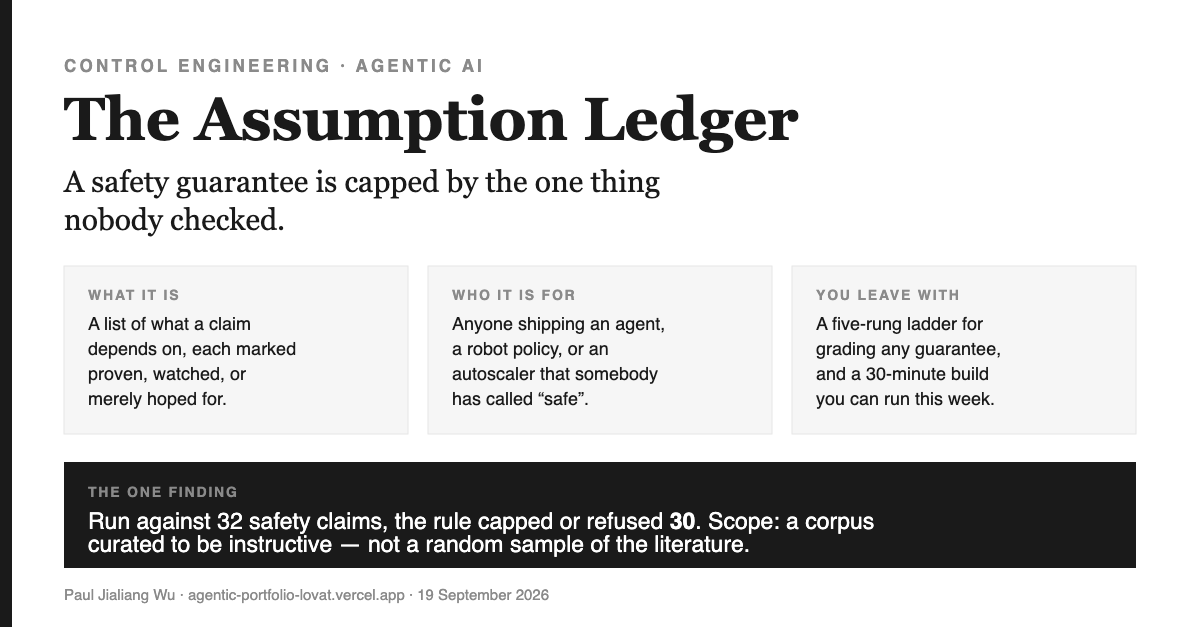
이 글은 무엇을 다루는가제어 엔지니어링에서 빌려온 실용적 정산법이다. 가정 레저란, 안전성 주장이 성립하려면 반드시 참이어야 하는 조건들을 한 줄씩 적고,입증됨, 실시간으로 감시됨, 또는 그저 바란다. 결국 보장은 가장 약한 가정이 허용하는 수준에서 멈춘다. 아무리 튼튼한 가정이 여러 개 있어도, 하나라도 확인되지 않은 항목이 있으면 그 하나가 전체 보장의 한계를 정한다.
왜 이게 중요한가 “우리는 모델 예측 제어기를 썼으니 안전하다”는 말은 실제 제어 분야에서 가장 흔한 과장이고, 소프트웨어 쪽에서는 “가드레일을 추가했으니 에이전트가 안전하다”는 버전이 매주 등장한다. 그런데 안정성 정리는 모델 자체에 대한 이야기다 [8]. 아무도 모델을 로봇과 대조해 확인하지 않으면, 정리는 여전히 성립하지만 약속은 공허하다. 이 실패는 겉으로 드러나지 않는다. 확인하지 않은 가정은 더 이상 성립하지 않아도 아무 신호도 내지 않으니, 결국 사고 보고서에서야 발견된다.
이 글을 읽고 나면 할 수 있는 일 어떤 보장이든 다섯 단계(일화 G0부터 인증 G4까지)로 등급을 매기고, 그 아래에 레저를 작성한 뒤, 가장 낮은 단계를 취한다. 마지막에는 30분 만에 만들 수 있는 빌드—입력, 불변 조건, 중단 규칙, CI 임계값—그리고 여기서 제시한 모든 수치를 산출한 오픈소스 구현이 있다.
가정 레저란 무엇이고, 누구를 위한 것인가
가정 레저는 어떤 주장 아래에 붙는 표다. 각 행은 그 주장이 조용히 기대고 있는 전제이고, 각 행에는 다음과 같은 상태가 붙는다: discharged (입증되었거나 하드웨어적으로 물리적으로 연결됨), monitored (실시간 체크가 작동하고, 그때마다 실제로 무언가가 일어남), assumed (믿고 있지만 검증하지 않았고 감시하지도 않음), 또는 violated (거짓임이 확인됨). 이게 전부다. 나머지는 이것을 산술로 다뤘을 때 따라오는 결과다.
이 글은 누군가가 안전하다, 안정적이다, 정렬되었다, 신뢰할 수 있다고 평가하는 시스템을 실제로 배포하는 모든 사람을 위해 썼다. 도구를 쓰는 에이전트, 학습된 로봇 정책, 오토스케일러, 콘텐츠 필터, 트레이딩 가드 등이 여기에 해당한다. 제어 이론을 몰라도 쓸 수 있다. 이 글을 읽고 나면, 안전에 대한 모호한 주장을 짧고 검증 가능한 언어로 바꿀 수 있는 어휘를 얻게 될 것이다. 그리고 그 어휘를 자기 시스템에 적용할 때 느끼는 불편함도 경험하게 될 것이다.
제어 이론[9]은 공학에서 유일하게, 전체 주제가 “이것이 행동하고, 세상이 응답한다. 그다음은?”인 분야다. 바로 이 구조가, 에이전트가 행동하고 결과를 읽기 시작하면서 AI가 진입한 세계다. 이런 루프가 언제 안정화되고 언제 스스로 붕괴하는지에 대한 100년치 연구가 쌓여 있다. 그리고 그 결과들이 어떻게 잘못 인용되어 왔는지에 대한 100년치의 흉터도 있다. 레저란 바로 그 흉터의 목록이다.
이 글 전체를 관통하는 비유가 하나 있다. 억지로 끼워 넣는 것이 아니라, 일부러 소개할 만한 가치가 있다.
요리의 사다리: 다섯 주방, 다섯 가지 약속
혼자 밥을 해먹는 것과 전국 식품 공급망을 책임지는 일을 비교해보자. 둘 중 어느 쪽이 더 어렵다는 얘기가 아니다. 핵심은 약속이라는 것이 단계마다 전혀 다른 성질을 띤다는 점이다.
혼자 요리할 때는 내가 직접 맛보고 괜찮으면 그걸로 끝이다. 이미 먹어본 한 끼에 대한 약속이다. 가족을 위해 매주 요리한다면, 적어도 이 다섯 명, 이 주방에서는 매번 잘 된다는 사실을 안다. 식당을 운영하면 손님 수와 불만 건수를 세면서, 얼마나 자주 성공하는지 통계로 말할 수 있다. 패스트푸드 체인이라면 레시피가 500개 매장, 공급업체 교체, 한 번도 본 적 없는 요리사까지 견뎌야 한다 — 즉, 사전에 명시한 모든 변동성을 버텨내야 한다. 전국 공급망을 돌린다면, 누군가가 감사를 하고 그 약속은 서명된 공식 문서로 남는다.
사다리의 단계가 올라갈수록 주장의 강도도 커지고, 단순히 맛만 보는 것으로는 부족해진다. 아래는 그 대응 관계를 표로 정리한 것이다:
| 주방 | 약속 | 제어 용어 |
|---|---|---|
| 혼자 요리 | “맛이 괜찮았다.” | G0 · 일화 — 한 번 성공 |
| 가족 요리 | “우리 가족, 매주 잘 먹는다.” | G1 · 경험적 — 측정, 분포 내 |
| 식당 운영 | “손님 95% 불만 없음.” | G2 · 통계적 — 신뢰 구간이 있는 경계 |
| 체인점 운영 | "우리 목록에 있는 모든 매장과 공급업체에 대해 성립한다." | G3 · 강인함 — 미리 명시한 불확실성 집합 전체에서 보장이 유지됨 |
| 공급망 운영 | "감사 완료, 그리고 여기에 인증서가 있다." | G4 · 인증 — 공식 모델에 따라 검증됨 |
진짜로 중요한 구간은 G1에서 G2로 넘어가는 순간이다. G1 이하는 이미 일어난 일만 알 수 있다. G2 이상에서는 앞으로 일어날 일을 예측할 수 있다 — 물론, 어디까지나 명시한 가정 안에서만. 2026년의 AI 안전성 주장의 대부분은 실제로는 G1에 머물러 있으면서, G3의 문체로 쓰여 있다.
이 비유에서 얻을 수 있는 핵심은 이렇다. 레스토랑이 망하는 이유는 셰프가 요리를 못해서가 아니다. 냉장고가 일주일 내내 2도 높았는데 아무도 온도계를 안 봤기 때문이다. 레시피 자체는 위험 요소가 아니었다. 진짜 위험은 감사받지 않은 공급업체였다 — 그리고 레저란 결국 그 공급업체 목록에, 실제로 누가 점검하고 있는지 표시한 표일 뿐이다.
보장 상한 결정 규칙
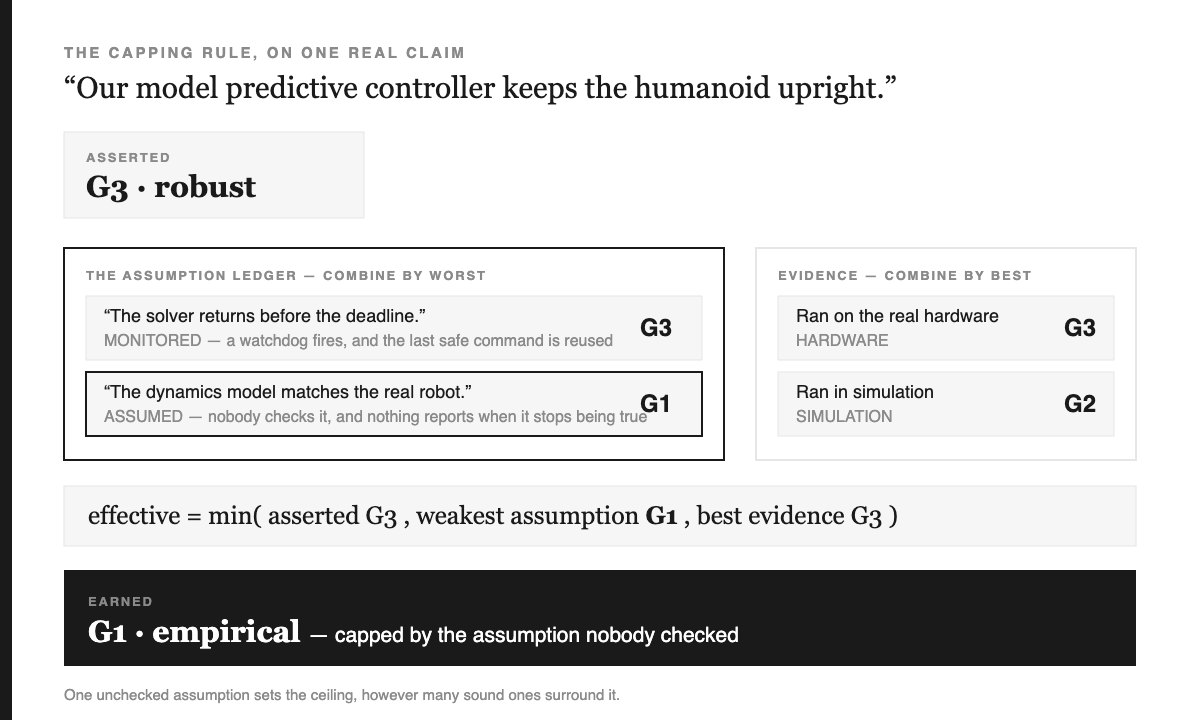
주장이 요구하는 등급을 먼저 적는다. 그 아래에 레저를 쓴다. 그리고 둘 중 더 낮은 쪽이 최종 등급이다:
effective = min( asserted , weakest assumption , best evidence )실제로 중요한 두 가지 원리가 있는데, 서로 정반대 방향을 가리킨다.
가정은 가장 약한 고리 기준으로 묶인다. 사슬은 가장 약한 고리만큼만 강하다. 아무리 튼튼한 가정이 옆에 있어도, 하나라도 검증되지 않은 가정이 있으면 그 하나가 전체 보장의 한계를 정한다 — 실패는 늘 그 틈으로, 아무런 신호도 없이 찾아온다.
증거는 가장 강한 근거만 본다. 증거는 사슬이 아니다. 느슨한 비유가 하드웨어 결과 옆에 있다고 해서 하드웨어 결과가 약해지지 않는다. 그러니 가장 강력한 근거만 취하면 된다.
각 가정의 상태마다 보장 등급의 한계가 정해진다. 이 표가 이 체계에서 유일하게 설계적 판단이 개입된 부분이다:
| 상태 | 상한 | 상한의 근거 |
|---|---|---|
discharged — 입증되었거나, 하드웨어적으로 물리적으로 연동됨 | G4 | 이 경우에는 더 이상 장애물이 없다. |
monitored — 체크가 실제로 동작하고, 폴백이 실행됨 | G3 | 여기서는 위반을 감지할 뿐, 미리 차단하지는 않는다. 즉, 위반이 발생한 뒤에야 대응하므로, 견고함(robust)까지만 인정되고 인증(certified)까지는 가지 않는다. |
assumed — 신뢰하지만, 검증되지 않았고, 감시도 되지 않음 | G1 | 측정한 결과는 보고할 수 있다. 하지만 그 결과에 기대어 앞으로 일어날 일을 보장할 수는 없다. 약속의 근거가 실제로 확인되지 않았기 때문이다. |
violated — 거짓임이 확인됨 | G0 | 거부. 이제 남는 건 데모뿐이다. |
신중한 독자가 반드시 따지고 들 부분은 바로 이 행이다.monitored왜 런타임 체크가 견고함(robust)까지만 인정받고 인증(certified)에는 미치지 못하는가? 감지기가 완벽하고 폴백이 입증되었다 해도, 빠지는 것이 세 가지 있다. 첫째, 모니터는 위반이 이미 시작된 뒤에야 작동하므로, 보장은 감지 지연 시간에 한정된다. 둘째, 모니터는 누군가 감시하겠다고 지정한 신호만 본다. 즉, 커버리지는 또 하나의 가정이다. 셋째, 폴백이 제때 동작해야 한다는 것은 모니터가 아니라 현실 세계에 대한 주장이다. 증명이나 하드웨어 연동에는 이런 제약이 없다. 애초에 해당 상태 자체가 발생하지 않도록 배제하기 때문이다. 이것이 감지와 배제의 본질적 차이이며, 그래서 상한이 여기서 결정된다.
장부의 신뢰성을 지키는 단 하나의 규칙이 있다. 그리고 사람들이 가장 자주 건너뛰려는 규칙이기도 하다:가정에 monitored 또는 discharged 체크를 표시할 때는 반드시 그 이름을 명시해야 한다.설명만으로는 부족하다. 어떤 모니터가, 어떤 신호에, 어떤 임계값으로, 작동 시 어떤 조치가 취해지는지 구체적으로 이름을 붙여야 한다. 이름 없는 체크는 그저 희망 사항일 뿐이고, 희망만 가득한 장부는 없는 것이나 다름없다.
32개 주장에 실제로 적용해보니
나는 이 장부를경량 오픈소스 엔진 [11]에 내장하고, 이 엔진이 다루는 12개 도메인(특히 얼라인먼트, 로보틱스, 피지컬 AI, 그리고 항공우주, 서빙 인프라, 의료, 시장까지 포함)에 걸쳐 32개의 안전 주장을 직접 작성했다. 각 주장에는 해당 가정과 근거를 명확히 적었다. 그 결과, 게이트는 이 중 32개 중 30개.
이 숫자는 반드시 맥락과 함께 읽어야 한다. 맥락이 곧 의미의 대부분이기 때문이다.이 집합은 내가 교육적 목적을 위해 직접 선별했다. 일부러 유명한 과장 주장과 반례를 포함시켰다. 실패가 없는 교재는 아무것도 가르치지 못한다.이는 논문 전체에서 무작위로 뽑은 표본이 아니며, 30/32라는 수치는 이 분야의 실태를 보여주는 조사 결과가 아니다.정직하게 한 줄로 요약하자면: 실패 사례가 포함되도록 선정한 주장 집합에서, 이 규칙은 실제로 알려진 실패를 찾아냈다. 즉, 규칙이 작동함을 보여주지만, 그 이상의 통계적 의미는 없다.
두 개의 주장이 원래 주장한 수준을 통과했다. 이 둘의 존재는 나머지 서른 개만큼이나 중요하다. 모든 것을 거부하는 게이트는 아무것도 거부하지 않는 게이트만큼이나 쓸모없기 때문이다.
통과한 두 사례와, 그들이 특별한 이유
Speculative decoding은 G4에서 통과했다— 그 보장이 관찰이 아니라 도출된 것이기 때문이다. 작은 빠른 모델이 여러 토큰을 초안으로 만들고, 큰 모델이 한 번에 이를 검증한다. 거부된 초안은 출력 분포가 변하지 않도록 정밀하게 설계된 규칙에 따라 다시 샘플링된다. 논문에서는 속도 향상이 “without changing the distribution”(번역: 분포를 바꾸지 않고) 그리고 “without any changes to the outputs”(번역: 출력에 아무 변화 없이) [4] 라고 보고한다. 결정적으로, 이 방식의 두 가지 가정 모두 discharged실제로 손에 잡히는 코드로 보장된다. 수용 규칙은 CI에서 고정된 시드로 분포 동등성 테스트를 통해 검증되고, 공유 어휘 요구사항은 모델 로드 시점에 명시적으로 확인된다. 쌍이 맞지 않으면 조용히 성능 저하가 일어나지 않고 아예 시작을 거부한다. 둘 다 약속이 아니라, 실패 시 명확하게 드러나는 코드다. 주방에 비유하자면: 주방장 레시피와 일치하는지 모든 접시를 검사하는 시식자가 있고, 불합격품을 다시 조리하는 명문화된 규칙이 있어 메뉴가 동일하게 유지된다. 누군가 시식해야 한다는 정책이 아니라는 뜻이다.
Tube model predictive control은 G3에서 통과했다— 명시된 대로 견고하며, 그 이상은 아니다. 이는 설계된 유한 집합 내의 모든 외란에 대해 제약 만족을 보장한다.[8]이 마지막 조건이 핵심이다. 보장은 실제 외란이 설계된 집합 내에 머무를 때만 유효하다. 그래서 정직한 배포에서는 해당 조건을실시간으로 모니터링한다. 잔차 모니터가 실제 관측된 외란을 설계 집합과 비교하고, 범위를 벗어나면 로그를 남기고 경보를 울린다. 모니터링은 했지만, 완전히 배제한 것은 아니므로 G3이지 G4는 아니다. 이는 모든 공급자가 명세서 범위 내에 있고, 누군가 실제로 온도계를 읽고 있을 때만 유지되는 체인과 같다. 매우 훌륭한 상태이지만, “감사 완료”와는 다른 문장이다.
두 사례 모두에서 드러나는 공통점:주장의 가정이 의도가 아니라 실제 기계적 장치에 연결되어 있을 때만 그 주장은 살아남는다.두 팀 모두 더 나은 모델이 필요한 게 아니었다. 이름, 임계값, 그리고 결과가 명확히 정의된 체크가 필요했던 것이다.
패턴과 함정, 그리고 그 대안
| 잘못된 관행 | 이렇게 바꿔야 한다 |
|---|---|
| “We use technique X, therefore we are safe.”(번역: 우리는 X 기법을 썼으니 안전하다.) | X가 보장하는 대상이 실제로 무엇인지 명확히 밝히고, 그 조건이 실제 배포 환경에서 충족되는지 직접 확인한다. |
| 트리거가 명확하지 않은 가드레일 | 신호, 임계값, 그리고 실행 주체가 명확히 지정된 폴백이 있는 모니터 |
| 생성기가 자기 결과를 스스로 평가한다 | 다른 방식으로 실패하는 두 번째 관점 도입; 불일치 시에는 이를 근거로 조치한다 |
| 증명체 문장으로만 채워진 안전성 페이지 | 각 주장마다 실제로 획득한 등급이 명시된 안전성 페이지 |
| 지표가 더 이상 변하지 않을 때까지 무작정 최적화 | 지표와 실제로 원하는 결과가 여전히 일치할 때 멈춘다 |
| 아무도 빨간불이 켜지는 걸 본 적 없는 게이트 | 일부러 트립시켜 보는 테스트가 있는 게이트 |
꼭 짚고 넘어가야 할 세 가지 함정
1. “It is optimal, therefore it has good safety margins.”(번역: 최적이므로 안전 여유도도 충분하다.)이 분야는 표준 최적 컨트롤러에 대해 오랫동안 이런 믿음을 가져왔다. 그런데 1978년 John Doyle이 두 쪽짜리 논문을 발표했다. 제목:Guaranteed margins for LQG regulators; 초록은 유명하게도 '그런 여유도는 없다'는 한 문장뿐이었다. 이 논문은 이득 여유도가 임의로 0에 가까운 최적 설계를 실제로 만들어 보였다.[5]즉, '최적(optimal)'과 '안전(safe)'은 아무 상관 없는 형용사였다. “우리는 최적화했으니 견고하다”는 주장은, 결국 이 고전적 함정의 현대판일 뿐이다.
2. “The model critiques its own output, so quality improves.”(번역: 모델이 자기 출력을 비평하니 품질이 좋아진다.)이 주장은 상한이 아니라 즉시 거부된다. 크리틱과 생성기가 동일 시스템이기 때문에, 한 가정이 아예 거짓이 되어버린다(단순히 미확인 상태가 아니라). 계측의 첫 번째 원칙은 단순하고 오래됐다: 자기 계측기만으로 루프를 닫지 마라. 자기 비평이 실제로 효과를 내는 건, 시스템 외부에서 들어오는 신호가 루프에 포함될 때뿐이다. 예를 들어 테스트 슈트, 컴파일러, 환경의 피드백 등이 그렇다. 이런 외부 신호 없이 자기 비평만 하면 점점 표류한다. 해결책은 더 나은 프롬프트가 아니라, 완전히 다른 방식으로 실패하는 두 번째 의견이다.
3. “Give the agent enough steps and it will finish the task.”(번역: 에이전트에게 충분한 단계를 주면 결국 과제를 완수한다.)이 주장은 오류가 서로 독립적이라는 가정 위에 세워졌으나, 실제로는 그렇지 않으므로 바로 거부된다. 장기 실행을 직접 측정한 Sinha와 동료들은 “models become more likely to make mistakes when the context contains their errors from prior turns” (번역: 맥락에 이전 턴의 오류가 포함될수록 모델이 실수할 가능성이 더 높아진다)라는 사실을 밝혀냈다.[2]이 현상은 단순한 잡음 누적이 아니다. 출력이 다음 입력으로 되먹임되어 같은 방향으로 계속 증폭되는, 전형적인 양의 피드백 구조다. 이런 메커니즘이야말로, 작은 진동에서 시작해 결국 파국으로 치닫는 모든 공학적 실패의 본질적 원인이다.
이 문제가 에이전트 시스템에서 특히 치명적으로 드러나는 지점
피드백 루프의 여섯 가지 핵심 구성 요소에 도구를 사용하는 에이전트를 대응시켜 보면, 한 항목이 뚜렷하게 비어 있음을 알 수 있다.
| 구성 요소 | 온도조절기 | 도구 기반 에이전트 |
|---|---|---|
| 참조값 — 목표 | 설정한 온도 | 사용자의 목표(한 번만 명시되고 다시 읽지 않음) |
| 비교기 — 차이 인식 | 뺄셈 | 대부분 없음 [10] |
| 컨트롤러 — 의사결정 | 온도조절기 스위치 | next-token policy |
| 액추에이터 — 실제 동작 | 난방기 릴레이 | 실행된 도구 호출 |
| 플랜트 — 작용 대상 | 방 | 파일시스템, 네트워크, 사용자 |
| 센서 — 피드백 신호 | 온도계 | 툴 반환값 |
그리고 실전 시스템이 실제로 무너지는 지점, 바로 사람들이 흔히 건너뛰는 세 가지 항목이 있다.지연 시간: 단계마다 수 초씩, 수십 단계가 이어지며, 언제 끝날지 아무런 제한도 없다.권한: 툴이 허용하는 권한 한도 내에서 움직인다. 현대 컴퓨팅에서 가장 분석이 부족한 권한 제한이자, 대개 가장 넓은 범위다.폴백: 거의 항상 없다.
이런 식으로 설계된 온도조절기는 — 목표는 한 번만 읽고, 오류 신호는 없으며, 권한은 무제한이고, 폴백도 없다 — 당신 집을 태워버릴 것이다. 그리고 모든 것이 정상이라고 보고할 것이다. 이건 업계를 풍자하려는 농담이 아니다. 나 역시 이 구조를 여러 번 직접 배포했고, 에이전트 프레임워크라 불렀다.
다행히 해법은 이미 오래전부터 알려져 있다. 똑똑한 부분을 굳이 신뢰할 필요조차 거의 없다.검증되지 않은 컨트롤러는 그대로 두고, 검증된 안전 기준선을 인수 가능한 모니터 뒤에 배치하라. 그리고 언제든 사람이 개입해 종료할 수 있게 하라. 제어공학에서는 이를 Simplex 아키텍처라 부른다. 런타임 보증 설계군의 대표적 예다.[6] 여기에 barrier-function 세이프티 필터도 포함된다.[7]; 그 신경망 버전은 명확히 다음과 같이 밝힌다: “not only provides safety assurances in the presence of a possibly unsafe neural controller, but can also improve the safety of such a controller in an online setting via retraining, without overly degrading its performance” (번역: 잠재적으로 안전하지 않은 신경망 컨트롤러가 있어도 안전을 보장할 뿐 아니라, 온라인 환경에서 재학습을 통해 해당 컨트롤러의 안전성까지 향상시킬 수 있다. 성능 저하도 크지 않다.)[3]. 이 보장은 정책이 아니라 제약 계층에 존재한다. 당신이 최근에 탑승한 항공기가 바로 이렇게 동작하며, 오늘 오후 당신의 에이전트에도 적용할 수 있다.
30분 만에 직접 만들어보기
레포는 필요 없다. 표 하나와 min().
입력값. 한 문장으로 요약한 주장 하나. 작성자가 주장하는 등급(G0–G4). 각 가정의 상태와 — monitored 또는 discharged — 체크의 이름. 증거 종류 목록(증명, 하드웨어, 시뮬레이션, 벤치마크, 어블레이션, 유추).
출력값. 실제로 얻은 등급과, 그 등급을 제한한 항목의 id.
불변 조건.게이트는 결코 주장을 상향 판정하지 않는다. 이 장치는 심판이지, 부풀려주는 역할이 아니다. 아무리 증거가 넘쳐도, 소박하게 제시된 주장은 끝까지 소박하게 남는다.
정지 규칙 A violated 가정이 거부되면 즉시 중단한다 — 상한을 씌우는 게 아니라, 그 시점에서 더 이상 읽지 않는다.
최소 형태
CEIL = {"discharged": 4, "monitored": 3, "assumed": 1, "violated": 0}
EVID = {"proof": 4, "hardware": 3, "simulation": 2,
        "benchmark": 1, "ablation": 1, "analogy": 0}

def judge(asserted, assumptions, evidence):
    if any(a.status == "violated" for a in assumptions):
        return 0, "refused"
    if asserted > 0 and not evidence:
        return 0, "unproven"          # no evidence means no
    if asserted >= 2 and not assumptions:
        return 1, "capped"            # a guarantee resting on nothing
    floor = min((CEIL[a.status] for a in assumptions), default=4)
    roof  = max((EVID[e] for e in evidence), default=0)
    return min(asserted, floor, roof), "..."
이 두 default= 인자는 방어적 장식이 아니다. 이 둘이 바로 실제로 동작하는 코드와, 첫 원장부터 ValueError 를 일으키는 코드의 차이다 — 즉, 아직 가정이 하나도 적히지 않은 G1 주장에 대한 첫 원장이다. 빈 원장은 아무런 상한도 만들지 않으므로, “G2 이상을 주장하면서 가정이 하나도 없는 경우”를 따로 검사한다.
CI 임계값 게이트가 상한을 씌우거나 거부한 주장 개수를 세고, 그 수가 0이면 빌드를 실패시킨다. 한 번도 발동하지 않는 게이트는 장식품에 불과하다. 장식용 게이트는 없는 것보다 더 해롭다. 왜냐하면 이런 게이트는 가짜 신뢰를 만들어내기 때문이다. 마치 냉장고 문에 붙은 온도계가 1년 내내 4도를 가리키지만, 아무도 그걸 어디에도 연결하지 않은 것과 같다. 내 경우는 32개 중 12개에서 실패한다.
의도적으로 뺀 것 상한에 대한 신뢰 구간은 없다 — CEIL에 나오는 네 숫자는 결과가 아니라 판단이다. 이걸 결과인 척하는 게 바로 이 글이 비판하는 오류다. 자동 가정 추출도 없다. 시스템이 무엇에 의존하는지 모델이 추측해서 만든 원장은 그럴듯해 보여도 틀린 결과를 내며, 이는 빈 원장보다 더 나쁘다. 원장을 손으로 쓰는 것 자체가 본질적 작업이고, 산수는 쉬운 부분이다.
같은 이야기, 다섯 갈래 출구
| 당신의 역할 | 판단 | 이번 주에 할 일 |
|---|---|---|
| 학생 | 내 프로젝트의 주장이 실제로 어느 단계에 있는지. | 내 시스템을 한 문장으로 적고, 그 아래에 원장을 쓴다. 대부분의 첫 원장은 한 줄이고, 그 내용은 assumed. |
| 엔지니어 | 내가 만든 가드레일이 실제 모니터인지, 아니면 그냥 희망사항인지. | 출시하는 모든 안전 점검에 대해 신호, 임계값, 그리고 발동 시 실행되는 동작을 반드시 명시한다. 이름 붙일 수 없는 것은 assumed. |
| 창업자 | 내 안전 페이지에 실제로 쓸 수 있는 내용이 무엇인지. | 페이지의 모든 주장에 등급을 매기고, 실제로 획득한 수준(G0~G4)보다 높게 쓴 부분은 전부 다시 써라. 누군가 당신 대신 등급을 매기기 전에 스스로 정리하는 것이 낫다. |
| 임원 | “우리는 가드레일이 있다”는 말이 진짜 답이 되는지 확인하라. | 다음 리뷰에서 반드시 이 질문을 던져라:실제로 시스템을 지탱하는 핵심 가정은 무엇이며, 그걸 누가 감시하고 있는가? 아무도 대답하지 못한다면, 그게 바로 결론이다. |
| 투자자 | 기술적 해자가 진짜 증명인지, 아니면 그저 데모에 불과한지 구분하라. | 해당 주장이 무엇에 근거하는지, 각 항목이 어떻게 점검되는지 물어라. 실제로 배포된 학습 시스템에서 G4 등급이 나오는 경우는 매우 드물다. 이를 아무렇지 않게 주장하는 팀이 있다면, 그 사실 자체가 중요한 정보다. |
내가 주장하지 않는 것
이 사다리는 어디까지나 판단 기준이지, 수학적 정리가 아니다. 다섯 단계와 네 개의 상한선은 내가 직접 설계한 것이다. 방어할 수 있고 기계적으로 적용되지만, 누구도 이를 증명하지 않았다. 하나의 함수로 구현되어 있으니 논쟁하기도 쉽다. 내가 정직하게 내놓을 수 있는 건 이 정도다.
32개 중 30개라는 수치는 설문조사 결과가 아니다. 위에서 이미 밝혔지만 다시 강조한다. 이 숫자는 범위 맥락 없이 인용될 가능성이 크기 때문이다. 이 코퍼스는 의도적으로 알려진 실패 사례를 포함하도록 선별했다.
레저는 시스템 자체를 안전하게 만들지 않는다. 레저가 바꾸는 것은 주장의 정직성이다. 이 둘은 전혀 다른 가치이며, 둘을 혼동하는 것은 레저가 바로 잡으려는 대표적인 오류다.
내가 직접 만든 코퍼스의 5분의 1은 검증되지 않았고, 도구는 그 사실을 그대로 보고한다. 엔진이 내놓은 unverified_rate는 0.22, 즉 32개 주장 중 7개다. 2026-09-24 업데이트: 이 글이 처음 나갈 때는 0.53이었다. 그때 ‘검증됨’은 내가 손으로 입력하는 표시였다. 손으로 입력한 표시야말로 이 게이트가 잡아내려는 ‘벌지 않은 보증’이다. 그래서 이제는 주장이 인용하는 모든 출처를 1차 서비스(arXiv, doi.org, 출판사)에서 실제로 조회하고 그 응답을 기록해야만 ‘검증됨’으로 인정된다. 이 과정에서 주장 10개가 추가로 확인되었고, 근거 없이 ‘검증됨’으로 표시해 둔 주장 1개가 드러났다. 남은 7개 중 6개는 업계에 떠도는 통념으로, 일부러 통념으로서 기록한 것이라 애초에 1차 출처가 없다. 나머지 1개는 스크립트로는 열 수 없는 유료 인증 표준에 근거한다. 나는 보기 좋은 부분만 조용히 골라내는 대신 이 숫자를 공개한다. “당신의 주장이 무엇에 근거하는지 명시하라”는 게 이 프로젝트의 전체 논지인데, 자기 지표를 세탁할 수는 없다.
참고문헌
- Sinha, A., Arun, A., Goel, S., Staab, S., & Geiping, J. (2025). The Illusion of Diminishing Returns: Measuring Long Horizon Execution in LLMs. arXiv:2509.09677, 2025년 9월 11일 제출.arxiv.org/abs/2509.09677
- Phan, D. T., Grosu, R., Jansen, N., Paoletti, N., Smolka, S. A., & Stoller, S. D. (2019). Neural Simplex Architecture. arXiv:1908.00528, 2019년 8월 1일 제출.arxiv.org/abs/1908.00528
- Leviathan, Y., Kalman, M., & Matias, Y. (2022). Fast Inference from Transformers via Speculative Decoding. arXiv:2211.17192, 2022년 11월 30일 제출.arxiv.org/abs/2211.17192
- Doyle, J. C. (1978). Guaranteed margins for LQG regulators. IEEE Transactions on Automatic Control, 23(4), 756–757.doi.org/10.1109/TAC.1978.1101812 — 유료 논문이므로 인용 없이 설명만 포함함.
- Hobbs, K. L. 외 (2021). Run Time Assurance for Safety-Critical Systems: An Introduction to Safety Filtering Approaches. arXiv:2110.03506.arxiv.org/abs/2110.03506
- Ames, A. D., Coogan, S., Egerstedt, M., Notomista, G., Sreenath, K., & Tabuada, P. (2019). Control Barrier Functions: Theory and Applications. arXiv:1903.11199.arxiv.org/abs/1903.11199
- Mayne, D. Q., Rawlings, J. B., Rao, C. V., & Scokaert, P. O. M. (2000). Constrained model predictive control: Stability and optimality. Automatica, 36(6), 789–814. doi.org/10.1016/S0005-1098(99)00214-9
- Åström, K. J., & Murray, R. M. Feedback Systems: An Introduction for Scientists and Engineers. 무료 PDF: cds.caltech.edu — 이 글을 읽고 본격적으로 제어 이론을 공부하고 싶어진 독자라면 가장 친절하게 안내해 줄 입문서다.
- Anthropic (2024). Building effective agents. anthropic.com/engineering/building-effective-agents — evaluator-optimizer 패턴은 컨트롤 용어만 뺀 피드백 컨트롤러 그 자체다.
- 이 글의 모든 수치가 나온 구현과 코퍼스:github.com/wjlgatech/control-anything — 레저를 빌드 게이트로 실행하는 오픈소스 엔진.
make check이 글의 number 전체를 재현한다 — 32개 주장, 이 중 30개가 제한되거나 거부됨,unverified_rate0.22 — 오프라인에서 별도 키 없이 동작한다. 모든 수치는 직접 작성되어 이 사이트의 레포에 저장되어 있다(저쪽 레포가 아님).
글쓴이: Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app