AIネイティブ・シリーズ · エージェント型システムの制御
与える身体
1分でわかる要点——この記事で得られるもの
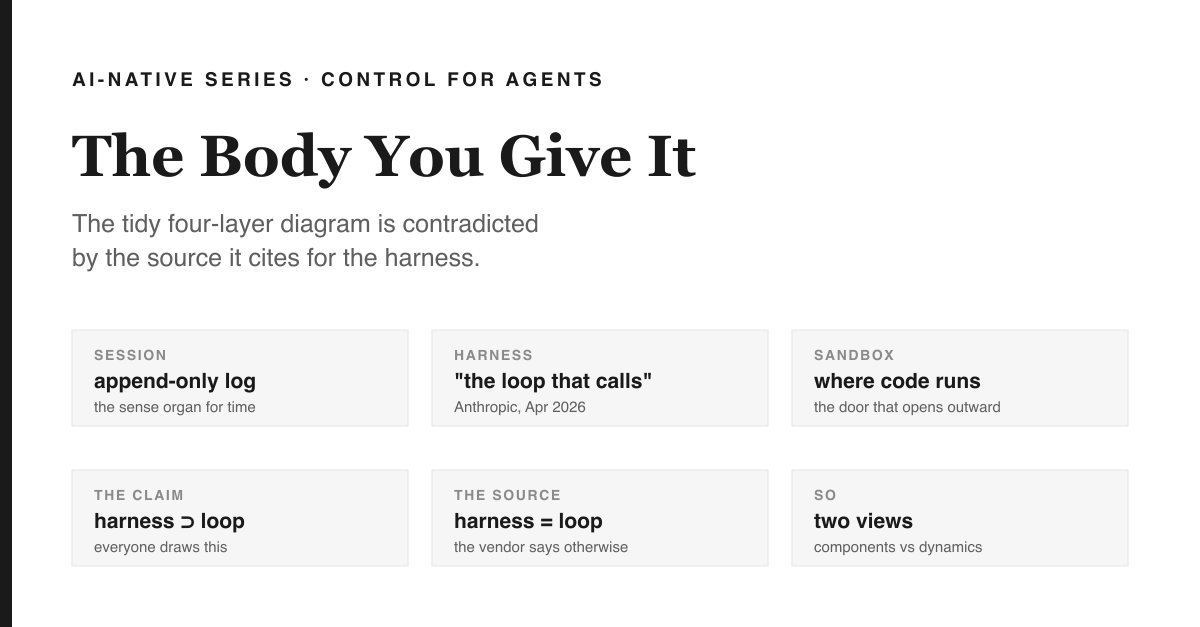
より良い指示を書くことをやめ、モデルが働く「部屋」を作り始める。ツール、サンドボックス、コンテキストアセンブリ、権限、そして追記専用のセッションログ。ここで語彙が行き詰まる——AnthropicのScaling Managed Agentsはハーネスをこう定義している:“the loop that calls Claude and routes Claude's tool calls”(訳:Claudeを呼び出し、Claudeのツール呼び出しをルーティングするループ)したがって、harnessとloopは二層構造ではなく、一つの対象を異なる側面から捉えたものだ。ここで重要なのは、原因の見誤りが修正される点である。典型的な「40分後にモデルの性能が落ちた」という現象は、プロンプトの問題に見えて、実際はharnessの問題だ。なぜなら、トランスクリプトが増え続けることで、最初に記載した制約がコンテキストウィンドウの外に押し出されてしまうからである。
冒頭のたとえ
より良い伝票を書くことを諦め、今度はキッチンそのものを設計する。
手の届く場所に包丁。ラベル付きのパントリー。温度計。ゴミ箱。外側にしか開かないドア。ベンチに打ち付けられたノートには、出ていく料理が一品ずつ記録されていく。
料理人自身が賢くなったわけではない。変わったのは料理人ができること、そして何よりも料理人が知ることができる範囲である。これこそがharness engineeringであり、現代の本質的なエンジニアリングの多くが集約されている層だ。プロンプトに関する文献が、名前すら付く前から既に踏み込んでいた領域(arXiv:2401.14423)であり、Promptware Engineering(arXiv:2503.02400)が「より良い言い回し」ではなく「プロンプトを取り巻くプロセス」の重要性を指摘したときに示していたものでもある。
定義を確認すると、誰もが描く整然とした図が崩れる。
図を覆す定義
一般的な説明では、プロンプトがharnessの中にあり、harnessがloopを回し、その上にグラフが重なるという四層構造になっている。見た目は整っていて理解しやすいが、最も引用される出典自身がこの構造を否定している。
AnthropicのScaling Managed Agents(Anthropic, 2026a)は、エージェントを三つの要素に分解している:
「session(起きたことすべてのappend-onlyログ)」「harness(the loop that calls Claude and routes Claude's tool calls to the relevant infrastructure)(Claudeを呼び出し、そのツールコールを適切なインフラにルーティングするループ)」「sandbox(Claudeがコードを実行したりファイルを編集したりできる実行環境)」
[DEF] この真ん中の定義を改めて見てほしい。ベンダ自身の定義では、harnessはループそのもの——すなわち、モデルを呼び出しツールコールをルーティングする存在であり、ループを内包するコンテナではない。
[DESIGN]「ハーネスエンジニアリング」と「ループエンジニアリング」は、積み重なる隣接した二層ではなく、一つの対象を異なる側面から捉えたものである。ハーネスは構成要素——ツール、サンドボックス、コンテキストアセンブリ、メモリ、権限、評価——を指す。一方、ループは動的な挙動——何が繰り返され、何が観測され、どこで止まるか——を指す。貧弱なループを持つハーネスもあれば、機能が乏しいハーネスに優れたループを組み合わせることもできる。だからこそ両者を区別して語る意味がある。ただし、一方がもう一方の中にきっちり収まるという描き方は、出典が支持していない。
1対1の技術対応表
| キッチン | 技術的名称 | 防げるトラブル |
|---|---|---|
| 手の届く包丁 | ツールスキーマ/関数定義 | モデルが実行できない行動を語る |
| ラベル付きパントリー | コンテキストアセンブリ/リトリーバル | 自信満々で間違ったファイルを扱う |
| 温度計 | 評価とテスト実行 | 「できているように見える」 |
| 外側にしか開かないドア | サンドボックス+権限モデル | 本番環境を消してしまう修正 |
| 作業台に固定されたノート | セッションログ(追記専用) | なぜその判断に至ったかが分からなくなる |
| 作業台のスペース | コンテキストウィンドウの予算 | 新しい指示が、最初に与えた制約を押し出してしまう |
主張の分類
[DESIGN] ハーネスは、長時間動作する作業が実際に破綻する場所である——これはベンダー自身による設計レポートに基づく話であり、計測データではない。AnthropicのEffective harnesses for long-running agents(Anthropic, 2026b)は、プロンプト層からは見えない失敗——状態の引き継ぎ、進捗の追跡、コンテキスト管理と圧縮、初期化、インクリメンタルなセッション——に焦点を当てて構成されている。これらはプロンプトの問題ではなく、どんな言い換えでも解決しない。
[OPEN] OpenAIのHarness engineeringの記事およびUnrolling the Codex agent loop(OpenAI, 2026)は、他ベンダー側から見た同じ変化を描いている。エンジニアリングの本質的な論点は、環境と「ユーザー入力→指示→モデル呼び出し→ツール実行→繰り返し」という変換の流れにあり、指示そのものだけではない。(両URLともスクリプトでアクセスすると403となる——これはボット対策であり、ページが存在しないわけではない。私自身はどちらの本文も未読のため、この主張にはevidencedではなくopenタグを付けている。)
[DESIGN] Building Effective AI Agents(Anthropic, 2026c)は、業界全体が繰り返し引き直してきた境界線を示している:ワークフローはあらかじめ決められたオーケストレーションの経路であり、エージェントはモデルが動的にプロセスやツールの利用を制御するシステムである。この違いは重要だ——エピソード4は、両者を混同したときに何が起きるかだけを扱っている。
[OPEN] ハーネスの品質について、公開され比較可能な指標は存在しない。タスクの成功率自体はエンドツーエンドで測定できるが、その成果がコンテキストアセンブリによるものか、ツール設計によるものか、あるいはループの停止条件によるものかを切り分けて評価する方法は未解決のままだ——これはエピソード1で未解決だった帰属問題が、もう一段上の層でそのまま現れている。
予測ゲート
この先を読む前に、自分の予想を決めておけ。
あるエージェントが20万トークンのコンテキストを持ち、すべてのツールの出力を逐語的に追加するハーネスで動いている。最初の40分間は問題なく動作するが、その後、5分目には見られなかったミスをし始める——すでに終えた作業を再実行することも含む。
問い: この現象の原因を特定せよ。モデルの劣化か、プロンプトの劣化か、それともハーネスか?
「モデルが悪くなった」と考えたなら、それはこの分野で最も典型的な帰属ミスだ。モデル自体はまったく同じである。つまり、最初に記述された制約がトランスクリプトの増大によってウィンドウの外に押し出され、エージェントは自分自身の指示の切り詰められたバージョンに対して最適化を始めている。これは一見プロンプトの問題に見えるが、実際はハーネスの問題である——だからこそ、コンパクション(圧縮)はハーネスの本質的な課題であり、単なる付加機能ではない。
失敗実験室
意図的に壊してみる:すべてのツールはそのままに、セッションログだけを削除する。
エージェントに全ツールへのアクセス、良質なサンドボックス、そして毎ターン新しいコンテキスト(追記不可の記録なし)を与える。するとどうなるか——完了済みの作業を繰り返し、以前の自分の判断と矛盾し、そして決定的なのは、まったく気づかない。なぜなら「気づく」には今と過去を比較することが不可欠だからだ。
診断:セッションログは単なるストレージではなく、時間を感じ取る感覚器官である。これを取り除いてもエージェントの速度は変わらないが、ループそのものを持てなくなる。それこそがエピソード3への引き継ぎであり、ベンダーの定義でセッションとハーネスが並列に置かれている理由でもある。
ラボ——15分チャレンジ
誰も測っていないものを測定せよ:コンテキストアセンブリのコスト.
- ひとつのエージェントタスクを計測対象にする。各ターンごとに、指示、命令のトークン数、取得したコンテキスト、トランスクリプト、そしてそのターンが成功したかどうかを記録する。
- この3要素を全ターンでプロットする。多くのシステムでは、命令は一定、取得は山型、トランスクリプトは単調増加して最終的に支配的になる。
- 次に、トランスクリプトをウィンドウの50%で素朴に切り捨てて再実行する。そのとき、失敗パターンの変化に注目する。ただの失敗率ではなく、素朴な切り捨てはたいてい「遅くて正確」だったものを「速くて自信満々に間違う」へと変えてしまう。
ここで見るべき数字は、トランスクリプトが命令を上回るターンのインデックスだ。その時点以降、プロンプトは自分のコンテキストの中で少数派になる。
現場ミッション
実際に運用しているエージェントを一つ選び、そのハーネスを1ページに「ツール」「サンドボックスの境界」「コンテキストアセンブリ」「メモリ/セッション」「権限」「評価」の6項目で整理してみる。コードから(意図ではなく)埋められない項目があれば、それはあなたのシステムで誰も管理していない部分だ。自分のエンジンでは、この作業が散在していたフラグをレビュー可能なファイルにまとめるきっかけとなり、そこに付随するパースゲートについては別記事「I Scored 100% on My Own Checklist(訳:自作チェックリストで100%を達成した話).
リサーチ課題
エージェントを使い、未だ存在しないハーネスの指標を作る。モデルとループは固定し、コンテキストアセンブリだけを「全トランスクリプト」「直近ウィンドウ」「要約+制約ピン留め」の3戦略で変え、同じタスク群で実験する。成功率と、トランスクリプトが命令を上回るターンインデックスを報告する。検証すべき主張はこうだ:「2つ目の数字(ターンインデックス)は、どんなプロンプト編集よりも成功率をよく予測する」。現状、[OPEN].
確認テスト
- Anthropic自身の分解で、ハーネスとは何か?(the loop that calls the model and routes its tool calls)(訳:モデルを呼び出し、そのツールコールをルーティングするループ)
- 「ループが中で動くハーネス」というのが定義ではなく主張であるのはなぜか?
- プロンプトの問題に見えて、実はハーネスの問題である失敗例を挙げよ。(トランスクリプトが増え、最初に述べた制約がコンテキストから押し出される現象)
続きは次回
身体、パントリー、温度計、ノートが揃った。皿は出ていき、また戻ってくる。そして今、その皿が戻る様子を自分の目で確かめている。そこで自然とこうする——戻ってきた皿を観察し、調整し、次の伝票を出す。観察、調整、伝票。観察、調整、伝票。
こうして君はフィードバックループを組み上げた。これはこのシーズンで最も古く、徹底的に分析されてきた対象であり、19世紀の人々がこのループに対して投げかけた唯一の問いが、今のエージェントスタックではまだ表現できない問いであることに、これから気づくことになる。
次に読むべき記事
『インテリジェンス・エンジニアリング・アドベンチャーズ』シーズン6のエピソード2— ガバナー・エンジンシリーズの出典にある主張はすべて、定義・導出・証拠・設計選択・未解決問題のいずれかでタグ付けされている。比喩は主張の導入には使われるが、証拠には決してならない。このシーズンは4ラベル図を一次資料に照らして本気で検証しており、その結果、Anthropicの定義ではハーネスはループそのものであり、上位レイヤーではないことが判明する。すべての主張はクラスでタグ付けされ、本当に未解決の問題はopenとして明示されている——LLM制御ループの安定性基準を公表した者はいまだにいない。本記事には雇用主やクライアントの素材は一切含まれていない。— Paul Jialiang Wu · futuremake.io
参考文献
- (Anthropic, 2026a) Scaling Managed Agents: Decoupling the brain from the hands (2026年4月8日)— session / harness / sandbox の分解。上記で原文引用。https://www.anthropic.com/engineering/managed-agents
- (Anthropic, 2026b) Effective harnesses for long-running agents — 状態の引き継ぎ、進捗管理、コンテキストの管理と圧縮。 https://www.anthropic.com/engineering/effective-harnesses-for-long-running-agents
- (Anthropic, 2026c) Building Effective AI Agents — ワークフロー(あらかじめ決められた手順)とエージェント(モデルが自律的にプロセスやツール利用を制御するもの)の違い。 https://www.anthropic.com/engineering/building-effective-agents
- (OpenAI, 2026) Harness engineering: leveraging Codex in an agent-first world; Unrolling the Codex agent loop。どちらも2026-08-24時点でスクリプトによる取得ではHTTP 403(ボット対策)となったため、要約記述からの引用であり、本文自体は未取得。