AI-Nativeシリーズ · エージェント工学 · ループエンジニアリング実践編
AIレビュー・ループ:11日間の沈黙、1枚のチャットカード、そして24%の上限
何が起き、どう作り直したか、設計上の判断6つとその理由、レビュワーが自分の修正をレビューして発見した問題、そして今後の方針——それぞれに「これが間違いだったと証明する観測条件」を添えて。
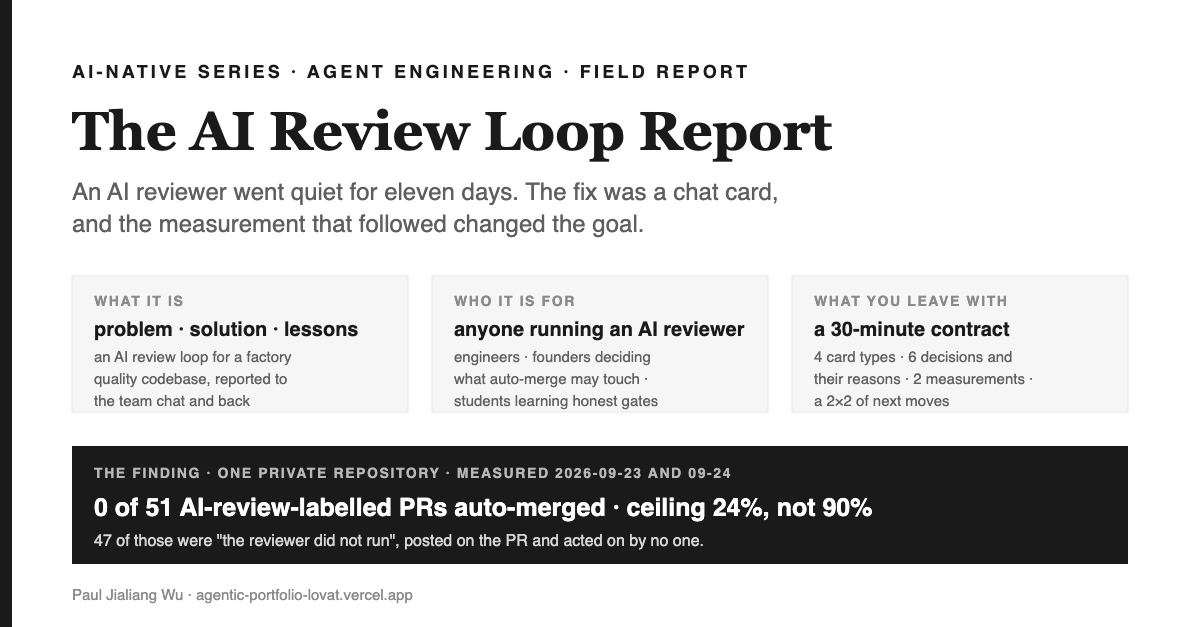
1分でつかめる要点——読み終えたときに得られるもの
本稿の概要 製造業向けの品質管理コードベースで、すべてのプルリクエストを読むAIレビュー・ループと、その判定をチームのチャットアプリに届ける新たな仕組みについてのレポート。問題(レビュワーが11日間予算切れのまま誰にも気づかれなかった)、解決策(判定ごとに1つのチャットカード、レビュワー自体が故障した場合は別カード)、設計上の判断6つとその理由、学び、そして今後の方針を扱う。
なぜ重要なのか エンジニアにとって:「決して沈黙しない」は必要条件だが、それだけでは不十分。誰も見ない場所に投稿された失敗は、沈黙と同じだ。創業者にとって:チームは「90〜95%の変更を人手なしでマージする」ことを目標にしたが、このコードベースの実測上限は24%。ほとんどの変更は人間の承認が必要な部分に触れるためだ。その現実を四半期かけて追いかける前に知る価値は、ループ自体より大きい。学生にとって:目標を立てる前に実際に計測する、という実例になる。
読後にできること 今日、自分のリポジトリで2つの計測を試してみてほしい(自分のレビュアーが実際に何回判定を実行したか、そして自動マージ規則が理論上許容できるマージ済み変更の割合)。下記の「30分契約」を参考に、レビュアーの判定結果をチームが普段見ているチャンネルに届ける仕組みを導入してほしい。「the reviewer did not run」(訳:レビュアーが実行されなかった)専用のアラームも、他と区別して通知すること。
このAIレビュー・ループ報告の内容と対象
この報告は、ひとつのリポジトリで積み重ねてきた実践の流れを受け継いでいる。AI PR Review That Cannot Lie でレビュアーを作った。すべての主張はファイルと行番号を根拠として示し、「unmeasured」(未計測)は沈黙ではなく明示的な投稿状態となった。ANDON シリーズでそれを5つのルールにまとめ、第4回「the auto-merge envelope」では「ボットがマージできる扉は一度も開かなかった」という率直な一文で締めくくられた。同時進行で「Visionboard」シリーズでは、私がプロジェクト運営に使う計器を作り、最終回「the scoreboard」は次の四半期に向けた3つの賭けと、それぞれに日付付きの反証条件を添えて終わった。2つ目の賭けがa sensor that cannot be silent.
この報告は、そうした設計が現実の1週間に直面したときに何が起きたかを記録したものだ。2026-09-23、品質領域を担当する共同創業者と私はAIレビュー・ループについて3点で合意した。レビュアーは「変更が要件通りか」「エンジニアリング規則に従っているか」の2軸で判定する。不確かな場合のみ人間にエスカレーションする(プルリクの5〜10%程度と予想)。通知はすべてメールではなくチームチャットに送る。その日のうちにこの予想を実測したところ、実際は100%だった。
この報告は三部構成になっている。レポート:問題、解決策、そして6つの設計上の判断とその理由。ふりかえり:構築から得た学び、レビュアーが自分の修正をレビューした際に見つけたこと、そして「委任」にまつわる半日分の信頼を失った経験。プロジェクト:次の一手(小さなもの・大きなもの、短期・長期)、それぞれがVisionboardの賭けやANDONの扉に結びつき、「これが間違いだったと証明する観測」も添えている。
対象読者は、AIレビュアーを運用している、または導入を検討しているエンジニア。「自動マージ」の適用範囲を決める創業者。失敗から計測・設計・未検証事項まで、ひとつのループとして学びたい学生。コードベース自体は非公開だが、すべての仕組みはここで再現できるだけの詳細を記している。
一枚の情景――料理の受け渡し台、スーシェフ、そして料理長のポケットで鳴るベル
このレポートを象徴するのは一枚の情景であり、これは 最初のレポート の「レストラン経営」編で描いたキッチンの続きだ。すべての皿は受け渡し台(パス)を経て出ていく。スーシェフが味見し、伝票にメモを挟む。料理長はそのメモを読み、一口味見してから、皿を出すか戻すかを判断する。スーシェフが自信を持てる冷菜は、そのまま客席へ送り出せる。
十一日間、スーシェフは現場を離れていた。キッチンのルールは「味見したふりは絶対にしない」なので、代理のスーシェフはすべての皿に not tasted と書いたメモを添えた。ルールは忠実に守られたが、メモは受け渡し台に積み重なったまま。料理長はダイニングでスマートフォンを手にしており、受け渡し台の前を一度も通らなかった。すべての皿は料理長の判断待ちとなり、それは安全ではあるが、「ほとんどの皿は料理長抜きで流れる」というキッチンの約束は、静かにゼロ皿へと変わった。誰も嘘はついていないが、誰も気づかなかった。
その解決策は、料理長のポケットで鳴るベル――しかも二種類の音で知らせるベルだった。
| キッチンの場合 | AIレビュー・ループの場合 |
|---|---|
| 伝票に添えられたスーシェフのメモ | プルリクエストに投稿されたAIのレビューサマリー:人間への質問、指摘事項(file:line)、提案された判定、そしてその変更が自動マージの条件を満たすかどうか。 |
| 「not tasted」のメモが受け渡し台に積み重なる | 47件中45件のサマリーが「unmeasured」と記載:レビュワーの予算上限に達し、実行されなかった。投稿はされたが、正直なまま誰にも読まれなかった。 |
| オレンジ色の通知:「この皿には自信がない」 | 「needs your decision」というタイトルのチャットカード:AIの未解決の質問、満たされていない自動マージ条件すべて、そしてプルリクエストへのボタン。 |
| グレーの通知:「私はキッチンにいない」 | 別のカード:「the reviewer did not run」、原因とその対処法が平易な言葉で書かれている。これはシステムの障害であり、皿に関する質問として誤魔化されることはない。 |
| 料理長が受け渡し台まで歩いて判断を下す | ボタンを押すとGitHubでプルリクエストが開く。承認は必ずそこで記録され、チャットで返信して承認することはない。 |
| ダイニングの照明:「料理が提供された」 | A merged カード。プルリクエストがマージされてクローズされたとき、別のワークフローで発火する。ループは出発点に戻って閉じる。 |
この比喩が通用しなくなるのはここだ。実際のスーシェフがシフトから外れると、厨房の動きが遅くなり、その不在はすぐに気づかれる。一方、レビューアが「不在」でも、目に見える損失は起きない。人間による経路はそのまま動くからだ。これがまさに問題の本質であり、「グレーの通知」が必要だった理由だ。
パートI・レポート——修正前に計測した問題
同じ日の米国時間(中国では22:04に会議)、私はレビューアがラベルを付けたすべてのプルリクエストを取得し、それぞれのサマリーに書かれた理由を読んだ。ラベル自体ではなく、「AIが判断できなかった」と「AIが一度も動かなかった」は同じラベルだったからだ。
| 読取(2026-09-23、ラベル付きプルリクエスト47件) | 件数 |
|---|---|
| 自動マージされたもの | 0 |
| AIが判断できなかった、または問題を検出してエスカレーション(=レビューアが実際に動いた) | 2 |
| レビューアが一度も動かずエスカレーション(「未計測」) | 45 |
| 全47件のうち、サマリーに書かれていた理由(1件のプルリクエストに複数の場合あり):レビューアが未実行・自動マージ対象外の変更・マシンゲートが赤 | 45 · 33 · 6 |
人間まで到達したプルリクエストの割合:47件中47件。対象範囲:1リポジトリ、レビューアが最初にラベル付けしたプルリクエストから2026-09-23まで。[計測値]
翌日、さらに4件のプルリクエストを加えて再度確認:ラベル付き51件、自動マージ0件、レビューアが動いてエスカレーション4件、未実行47件。傾向は変わらず、件数だけが増えた。
なぜを5回——すべてリポジトリやログから答えた:
- なぜすべてのプルリクエストが人間まで到達したのか? 47件中45件のサマリーが「レビューアが動いていない」と書かれていたから。
- なぜレビューアは動かなかったのか? 2026-09-12頃からすべての呼び出しが同じエラーを返していた:組織の月間利用上限に達し、2026-10-01までアクセスが戻らない状態だった。
- なぜ上限に達したのか? レビューアは他のすべてのジョブ(記事を4言語に翻訳するバッチジョブなど)と同じAPIキー、同じ月額$100の上限を共有していた。請求コンソールはキーごとの利用額しか表示されず、どのジョブが最も使ったかは分からない。ただ、レビューアが割を食ったのは確かだ。
- なぜ11日間誰も気づかなかったのか? レビュージョブは失敗してもマージをブロックしない設定だったので、ワークフローはグリーン(成功)を示していた。「未計測」サマリーはすべてのプルリクエストに投稿され、「never silent」ルール通りだったが、11日間誰にも読まれなかった。なぜなら、手動でレビューする人はサマリーを開かないからだ。決して沈黙しないルール の要件通り、十一日間誰にも気づかれなかった。なぜなら、手動でレビューするつもりのプルリクエストでサマリーを開く人などいなかったからだ。
- 根本原因: レビュワー自身の失敗が人間の耳に届く経路を持っていなかった。「決して沈黙しない」はページ上では守られていたが、現実では破られていた。
リポジトリのlessonsファイルには、ほぼ同じ内容が二週間前にすでに書かれていた。つまり、unmeasured needs someone watching it(訳:未計測状態には見張る人が必要だ)、という「次の一手」が記されていたが、実行されないままだった。文章で記録した教訓は、その文章が現実と食い違った瞬間に無効化される。これがANDONエピソード3の主題であり、ルールを文章ではなくデータとして扱うという話だ。そして私は、これをもう一度身をもって学ぶことになった。
パートI・レポート — 解決策:人が普段いるチャンネルに届くAIレビュー・ループ
チームではすでに「チャットアプリ(Feishu)だけが唯一の受信箱」と決まっていた。だからループは四つの経路をたどる:GitHubがレビュワーを実行し、スクリプトがそのサマリーをチャットカードに変換し、カードのボタンが人間をGitHubに戻し、マージイベントがもう一枚カードを送る。
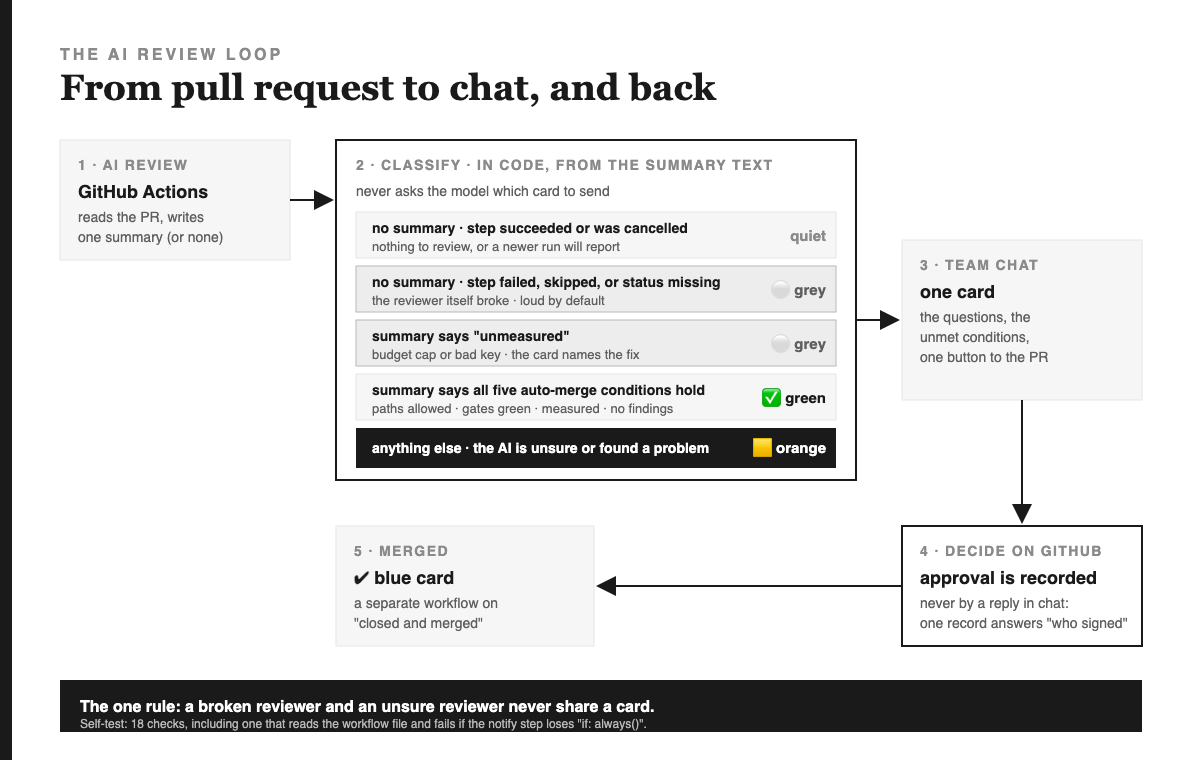
カードの種類と、それぞれを決める条件:
| カード | 発火条件 | 人間の対応 |
|---|---|---|
| 🟨 判断が必要 | レビュワーが実行され、かつ変更が自動マージの条件を満たさなかった場合:許可されたパス外、ゲートが赤、指摘事項、あるいは人間しか答えられない質問があるとき。 | 質問を読む(これまでの計測レビューでは平均2.3件/プルリクエスト、n=7)、ボタンを押してGitHubで判断する。 |
| ⚪ レビュワーが実行されなかった | サマリーに「unmeasured」(予算切れ・無効なキー)と記載されている、またはサマリー自体がなくレビュー工程が成功を報告しなかった場合。 | システムを修正する。カードには原因と対処法が明記され、プルリクエスト自体が問題ではないことが太字で示される。 |
| ✅ 自動マージ中 | 自動マージの五つの条件すべてがエンベロープ回(the envelope episode) ホールド。 | 何もしない。設定ひとつで無効化できる。 |
| ✔ マージ完了 | プルリクエストがマージされてクローズする。 | 何もしない。ここでループが閉じる。 |
| (カードなし) | レビュー対象がなかった、または新しいプッシュで実行がキャンセルされた。 | 何もしない。この沈黙は明示的な判断であり、既知の抜けが下に記してある。 |
初めてのエンドツーエンド実行(2026-09-24)。組織の上限を引き上げた後、レビュワーが実際のプルリクエストで動き、警告3件と人間への質問2件を出した。チームチャットにはその質問付きのオレンジ色のカードが届き、修正後のマージで青いカードが出た。すべての経路が本番のプルリクエストで動作するのを実際に確認できた(テストだけでなく)。
パートI・レポート――6つの設計上の判断とその理由
| # | 判断 | 却下した案 | 理由 |
|---|---|---|---|
| 1 | 故障したレビュワーには専用のカードを出す。 グレーで「実行されなかった」とタイトルし、原因と対処法を明記。 | 自動マージされなかったものすべてに「人間が必要」カードを1種類で出す。 | この2つの状態は必要とする人も行動も異なる。混ぜてしまうと、45件のシステム障害が45件のレビュー質問に見えてしまう。もし1種類のカードで出していたら、初日で全プルリクエストに通知が飛び、2日目には全員にミュートされていただろう。 |
| 2 | カードの種類はサマリーのテキスト(コード上)で決まる。 | どのカードを送るかモデルに判定させる。 | ルーターは自分がルーティングする対象に依存してはいけない。予算切れのレビュワーに「予算切れか?」と尋ねることはできない。 |
| 3 | 承認はGitHub上でのみ行う。 カードのボタンで人間をGitHubに誘導する。 | チャットで返信して承認する(チャットプラットフォームのアプリ+コールバックサーバ経由) | これは品質エビデンス・システムだ。監査の際、「誰がいつこの変更を承認したのか」は一つの記録から答えられなければならない。チャットでの返信は別の記録となり、元の記録と食い違う可能性がある。さらに、アプリやサーバ、認証情報の管理も必要になる。 |
| 4 | レビュアーの状態が不明な場合は、必ずアラートを鳴らす。 明示的に「success」かつサマリーが空の場合のみ、通知を出さず静かにする。 | ステップが明確に失敗した場合以外は、静かにせず必ず通知する。 | ステータスが欠落したり壊れていたりするのは、まさにシステムの不具合でよく起きる現象だ。デフォルトは「うるさい」側でなければならない。唯一の例外は、新しいpushでキャンセルされた実行であり、その場合は新しい実行が報告するので静かでよい。そのコストについては後述する。 |
| 5 | 「5〜10%だけエスカレーション」という目標値はやめ、リポジトリが自動的に計算する2つの数値に置き換える。 | 「5〜10%だけ人間にエスカレーション」という目標を維持しつつ、auto-mergeの対象範囲を広げて目標達成を目指す。 | 実測結果:直近でマージされた変更のうち、24%だけが本当にauto-mergeの対象になり得た(理由は正当、詳細はPart Iの天井参照)。90%を目指すのは、エビデンスチェーンを速度と引き換えにすることになる。置き換え後の指標は、Tier-1 auto-merge率と1レビューあたりの人間の負担だ。 |
| 6 | レビュアー専用の予算枠を設ける。 2026-09-24に実施:新しいキーを別ワークスペースで発行し、支出が個別に見えるようにした。同時に組織全体の上限も$100から$200に引き上げた。 | すべて同じキーで運用し、上限に達したらリミットを引き上げる案。 | 予算を共有すると、重要度の低いジョブが重要なジョブのリソースを食い尽くすことがある。正直な注意点として、組織全体の上限は各ワークスペースの上にあるため、完全な分離にはならない(この点についてはlessonsセクションで自分の誤解を書いている)。 |
7つ目の判断は「拒否」だ:このループ自体は何も決めない。決定を運ぶだけ。レビュアーが提案し、rulesファイルがauto-mergeの可否を決め、残りは人間が判断する。これはVisionboardをチームに適用した設計で、エージェントが提案・報告し、人間はループの外側に立つ。「small-team episode」ではhuman-onlyフィールドが職務分離された役割となった。ここでの役割は「コードオーナー」であり、カードがその役割に問い合わせる手段となる。
Part I・レポート──24%の上限:auto-mergeが実際に到達できる範囲
意思決定のルーティングが速くなっても、人間が何回意思決定しなければならないかは分からない。そこで2つ目の計測は別の問いを立てた。直近でマージされた60件のpull requestのうち、auto-mergeルールで許可されたファイルだけ(例:ドキュメント、設計書、テスト、ゴールデンケース)にしか触れていないものは何件か?これが上限だ。どんなに優秀なレビュアーでも、ルールで除外された変更はauto-mergeできない。60件のうち1件はちょうど100ファイル(GitHubが返す最大値)で、リストが途中で切れている可能性があるため「unmeasured」としてカウントし、残りは59件となる。
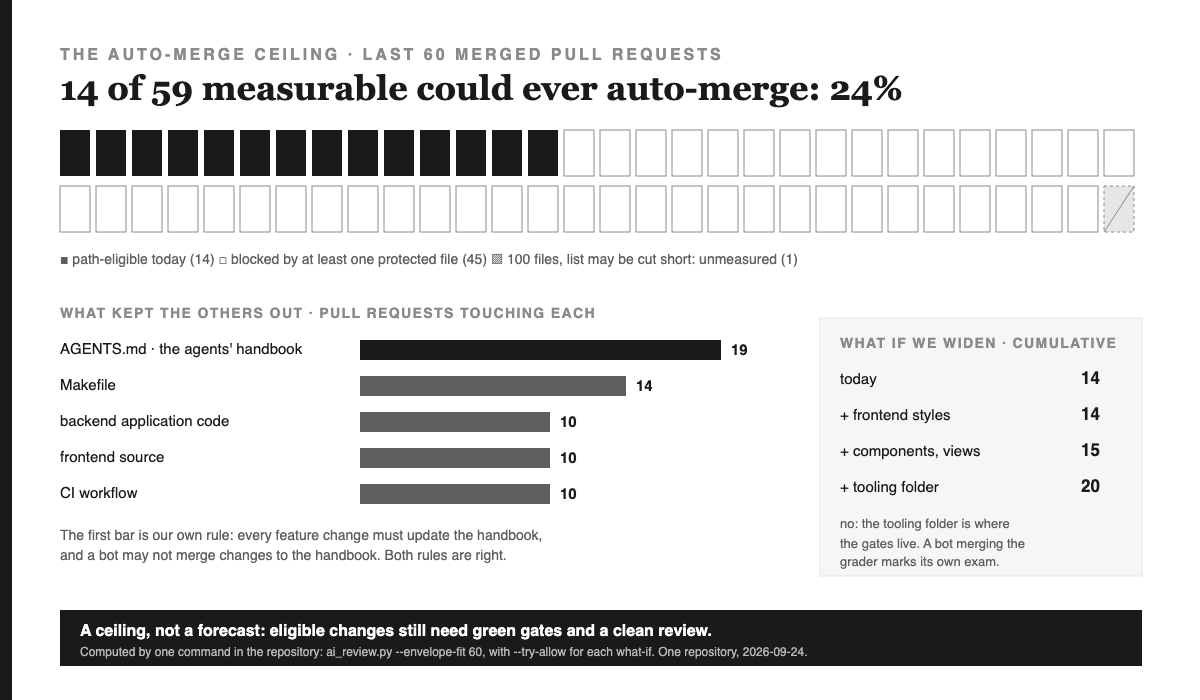
auto-merge対象パス:直近60件のうち測定可能な59件中14件(24%)。フロントエンドのスタイル・コンポーネント・ビューを追加すると15件。ツーリングフォルダも追加すると20件。範囲:1リポジトリ、2026-09-24時点の測定。これは上限であり予測値ではない。対象変更でもゲートが緑でレビューがクリーンである必要がある。[MEASURED]
最大のボトルネックは意外なものだった。そしてそれは自分たちのルールだった。そのうち19件は、AGENTS.mdこれはコーディングエージェントが作業前に読むハンドブックに触れていた。リポジトリには「すべての機能変更は必ずこのハンドブックを更新する」というルールがあり、人間もエージェントも古い手順を読むことがないようになっている。そしてauto-mergeのルールは、ハンドブックの変更をbotがマージすることを正しく禁じている。なぜなら、ハンドブックが変わればすべてのエージェントの挙動が変わるからだ。この2つのルールを組み合わせると、機能変更には必ず人間による確認が必要になる。ロボットは自分たちのハンドブックを更新しなければならず、同時にその更新を自分たちで承認してはならない。どちらのルールも正しい。間違っていたのは目標設定のほうだった。
フロントエンドの範囲を広げても、追加されるプルリクエストは1件だけだった。実際のフロントエンド変更はたいてい保護されたファイルにも触れるからだ。さらにツール用フォルダまで対象を広げると(この仮定は累積的)、さらに5件増えるが、そのフォルダにはゲートやレビュワー自身が含まれている。つまり、botがグレーダーの変更をマージできるようにするのは、料理人が自分の皿を自分で採点するようなものだ。だから、次のチーム判断への提案は「ルールは現状維持、目標を見直し、2週間のパイロットを実施する」となる。ここにはソフトウェアとは無関係なゲートがもう一つある。GitHubはこのリポジトリに対してブランチ保護を拒否し、「Upgrade to GitHub Pro」と返してくるため、botは承認はできてもマージはできない。この状態が変わるまでは、auto-merge率は設計上ゼロであり、これはthe envelope episodeで閉じていたのと同じ扉だ。
訂正 2026-09-25。このレポートは当初「その扉には月額4ドルのプランが必要」と書いたが、オーナーはすでにそのプランを持っていた。同じアカウントの他のプライベートリポジトリはすべてブランチ保護を受け入れていたが、このリポジトリは古いリポジトリのプライベートフォークであり、フォークはオーナーではなく上流ネットワークからこれらの機能を継承する。エラーメッセージは、すでに適用済みの修正を指していた。本当の修正はフォークを切り離すことだった。これは本レポート全体と同じ教訓を一段深いレイヤーで示している。私は状態をメッセージから読み取ってしまい、実測しなかった。実際の計測はAPIコールを数回投げるだけで済んだ。
パートII・内省――レビュワーが自分の修正をレビューしたときに見つけたもの
ループの修正自体がプルリクエストだったので、復活したばかりのレビュワーは最初の午後を自分を復活させたコードの採点に費やした。4件の自分のプルリクエストに対して10回実行し、5回は追加作業を要求し、5回は承認した。どのラウンドも、承認を含めて何かしら実際の指摘があった。以下はその順番通りに並べたキャッチであり、その順番自体が教訓になっている。
| # | レビュワーが見つけたもの | ミスの種類 |
|---|---|---|
| 0 | 自作スクリプトが、レビュー対象が何もないプルリクエストに誤って「needs your decision」カードを送ってしまった。これはレビュワーの初ライブ日に、チャットで自分で気づいた。 | 空の結果を指摘事項として扱ってしまった。 |
| 1 | 自分の修正は、サマリーにマーカー文字列がなければカードをスキップするものだった。もしテンプレート名が変われば、すべてのカードが黙って消えることになる。 | 本質的な条件(空であること)ではなく、偶発的なディテールに依存していた。 |
| 2 | 新しいテストは「最後に送信されたカード」をチェックしていたが、「新しいカードが送信されたか」を見ていなかった。壊れたブランチでも前のテストのカードを読めばパスできてしまう。 | 失敗できないテストだった。修正し、ミューテーションテストも実施。 |
| 3 | テスト専用フラグが本番コマンドラインに追加され、「no summary」には2つの原因(レビュー対象なし、またはレビュワーのクラッシュ)があり、どちらも同じサイレント分岐を通っていた。 | 製品コードにテスト用の足場が混入し、2つの状態が1つのコードパスにまとめられていた。 |
| 4 | クラッシュアラーム全体が、差分外のワークフローファイル1行に依存しており、どのテストもそれを読んでいなかった。 | テスト外に存在する保証だった。今はチェックがそのファイルを読み、行が消えたら失敗するようにした。 |
| 5 | 証拠として貼り付けたgrep出力から1行抜けていた。 | 証拠を自分で削っていた。レビュワーは出力がファイルと一致しないことに気づいた。 |
| 6 | 自分の天井測定はGitHubのプルリクエストごとのファイルリストを読んでいたが、これは100ファイルで打ち切られるため、巨大な変更が対象に見えてしまう。そして新しい「1レビューあたりの質問数」指標には、失敗できるテストがなかった。 | この数字は、間違うとしても都合のいい方向にしかズレないものだった。 |
今回いちばん印象に残った指摘は、実はレビューア自身ではなく、新しいテストが失敗したことで僕が気づいたものだ。レビューアのスクリプトがクラッシュしたとき、アラームカードはその理由を僕自身の言葉で説明する:"the script itself failed; this is not a budget or 401 problem"(訳:スクリプト自体が失敗した。これは予算や401の問題ではない)。カードの説明文は「401」という文字列を探して無効なキーを判別する仕組みだった。僕の但し書きに「401」が含まれていたため、読者にキーのローテーションを促してしまった。アラームは「これは違う」と書いた文から自分自身を誤診断した。修正は但し書きの書き換え。教訓は、キーワード検出器を作っておきながら、自分でその検出器にキーワードを流し込んでしまったことだ。
キャッチ6には、あまり胸を張れない後日談がある。レビューアは提案の最終更新で「hold」として投稿し、チャットにはオレンジ色のカードが届いたが、僕はテストがグリーンだったのでカードを開かずにマージしてしまった。ループ自体は端から端まで動いたが、その最後にいた人間が読まなかった。修正はフォローアップのプルリクエストで、切り捨てた変更を除外したことで天井は23%から24%に上がった。リポジトリの実装ログには、僕が破ったルールが今は記されている:マージ前にテスト結果とレビューアの最新判定を両方確認し、「hold」を上書きする場合は理由を書き残すこと。
キャッチ5は、僕が見逃していたし、同僚もたぶん気づかなかったものだ。プルリクには「これがgrepの出力、該当行は存在する」と書いた。だが僕が出力を短縮しており、レビューアはdiffの文脈を読んで、僕が示したより1つ多くマッチを数えた。結果、その主張を「unverified(未検証)」とマークし、議論はしなかった。これは最初のレポートのルール、つまり「証拠なき主張は認めない」を自分自身に適用した例だ。
パートII・振り返り——得た教訓
- 「沈黙しない」は必要条件だが、それだけでは足りない。状態は、誰かの耳に届いて初めて意味を持つ。 レビューアは45件のプルリクでルール通り動いたが、誰の役にも立たなかった。アラームのテストは「投稿されたか」ではなく「誰が1日以内に読んだか」だ。これはVisionboardの2つ目の賭け、"a sensor that cannot be silent"(訳:沈黙できないセンサー)、さらに強い条件として「センサーはunheard(聞かれない).
- ことも許されない」も加わる。 割合を議論する前に分母を測れ。僕らは5~10%のエスカレーションを目指して会議の一部を費やした。だが実際は100%で、そのうち45件はエスカレーションですらなく、壊れたセンサーだった。「未計測」ケースは率を計算する前に別のバケツに分けるべきで、バケツが全部なら率は「未計測」だ。0%でも100%でもない。
- 予算を共有すると、重要度の低いジョブが重要なジョブを食い潰す。 レビューアはバッチ翻訳ジョブや他の全プロジェクトと予算を共有しており、結局餓死したのはレビューアだった。どのジョブが月の予算を使い切ったかは、全てが1つの古いキーに紐づいていたためコンソールでも分からなかった。クリティカルパスには専用予算を与え、キー単位でなくジョブ単位で消費を追跡せよ。
- 他人のために書いたゲートは、いずれ自分自身も評価することになる。 自分の修正に10回レビューを回し、5回は追加作業を求められ、無視した1回も正しかった。レビューアが復活した日に、最も多くレビューされたのは作った本人だった。これが今のところ「1レビューあたり約0.25ドルの価値がある」という最良の証拠だ(推定値:キーのコスト欄は約8レビューで1.96ドルだった)。
- ナビゲーションではなく、結果を届けよ。 このビルドを担当したエージェントは、僕を4回も課金コンソールに誘導した。「設定→制限」「レートリミット」「ワークスペース切り替え→課金」……最後の目的地は存在しない。ベンダーのヘルプセンターには"The default Workspace is not editable and cannot be removed."(訳:デフォルトのWorkspaceは編集できず、削除もできません) [5]とある。僕は、プランナーが確認していなかった計画の実行者だった。その後自分に書いたルールはこうだ:人間に行動を求める前に目的地を検証し、リンク1つとアクション1つだけ渡す。検証できない・本質的でないステップは省き、結果だけを人間に届ける。人に上に委任する場合も同じで、上司にはレシピやパントリーの地図ではなく、盛り付け済みの料理を渡すべきだ。
パターン、アンチパターン、仕組み
- パターン:2種類の異常に2種類の通知音。「判定者が迷っている」と「判定者が不在」は、それぞれ異なるカード・色・担当者に振り分ける。
- パターン:ルーターは意図的に単純。システム自身が出力したテキストだけをもとに決定論的に分類し、モデル自身の自己申告には一切頼らない。
- パターン:デフォルトは「うるさい」設計。沈黙はケースごとに明示的に決めた場合のみ許され、それ以外は必ず通知が鳴る。
- アンチパターン:緑色のまま失敗するケース。失敗してもマージを止めないジョブは、何もしていなくても緑(成功)表示になる。マージを止めない設計自体は正しいが、失敗が見えなくなるのが本質的なバグだ。
- アンチパターン:上限を測らずに目標だけ立てること。ルールが実際に許す範囲を測る前に比率目標を決めてしまうこと。
- 仕組み:自働化(jidoka)。トヨタはこれを、異常発生時に"the machine or equipment can detect the abnormality and stop automatically, or the operator can stop the line by pulling the stop cord themselves"(訳:機械や装置が異常を検知して自動で停止するか、作業者自身が停止コードを引いてラインを止める能力) [1]と説明している。厨房で言えば、コードはスーシェフのメモ、ボードはベルだ。コードを引いても、シェフがいる場所でベルが鳴らなければ意味がない。チャットカードがそのベルにあたる。
- 第一原理を一文でまとめると:チェックの現実性は、「失敗」から行動できる人までの最短経路の短さで決まる。
パートIII・プロジェクト——次の一手、小さなものから大きなもの、短期から長期まで
各アクションはVisionboardの賭けやANDONの扉に結びつき、それぞれ「これが間違いだったと証明される観察」を日付付きで持つ。これはscoreboardエピソードのスタイルだ。Visionboardの2つ目の賭け「サイレントセンサー」の反証日は2026-10-07で、最初の2つのアクションはその検証報告となる。
| 短期(今月) | 長期(今四半期) | |
|---|---|---|
| 小規模 | S1 · 週次の数値をチームミーティングに持ち込む。 毎週月曜、リポジトリがエスカレーション率・自動マージの上限・1レビューあたりの人間の負担を出力する。 不成立条件: 2026-10-07までにグレーのカードが発報し、チームの誰もその意味を説明できなければ、その時点でカードの文言自体が問題ということになる。 S2 · 指摘済みの抜け穴を塞ぐ。 現状、タイムアウトや手動キャンセルなどでレビューがキャンセルされ、後続の実行もなければ、そのまま何も通知されずに終わる。 不成立条件: ログに「キャンセルされ、その後一度も再実行されなかったレビュー」が見つかった場合、その日が例外条件の許容範囲を超えた日となる。 | S3 · レビュアーのキャリブレーション。 レビュアーが承認したプルリクごとに、その後リバートやバグが発生した件数を数える。保留にしたプルリクごとには、人間がそのままマージした件数を数える。これは キャリブレーション ——自分たちの判定者に対して投げる問いである。 不成立条件: 2026-12-31まで、またはレビュー済みプルリク50件時点で「マージ」「保留」判定がリバート発生を偶然以上に予測できなければ、そのレビュアーは単なるフォーマッターとして扱うべきだ。 |
| 大きな施策 | B1 · 一度だけドアを開ける。 フォークを元リポジトリから切り離し、ブランチ保護を適用し、ルールはそのままで2週間のパイロットを実施する。成功条件は、実際の自動マージが3件以上・リバート0件・1レビューあたり人間の質問が最大3件であること。 不成立条件: 2026-10-31まで、またはドアを開けて2週間後までに3件未満しか自動マージが成立しなければ、上限は測定値より低く、このリポジトリは人間レビュー前提だと明言し、現状維持の幻想を捨てるべきだ。 | B2 · レビューループをVisionboardのセンサーに昇格させる。 エスカレーション率と自動マージ率をVisionboardのエンジニアリングトラックのゲージとして可視化し、「24時間レビュアーが動かなかった」をカードだけでなく明示的なトリップワイヤーとして扱う。これはスコアボードの「第二の未来」を具体化するものであり、「署名付きの意思決定が実際の動きを予測するか?」という「ダブルループ」への第一歩である(詳細は スコアボード回). 不成立条件: 2026-12-01までにゲージがボード上に表示されているにもかかわらず、レビューループに関するチームの意思決定がそのゲージを参照せずに行われていた場合。 |
あえてやらないこと:チャット上での承認、パイロット前に自動マージのルールを広げること、あるいは最初のレビュアーをチェックするための二つ目のレビュアーを作ること。どれも興味深いが、今この場で開いたままのループを閉じるものは一つもない。
30分で形にする:レビュー・ループの契約
ここで示すのはコードではなく「契約」だ。30分というのは、すでにAIレビュアーがサマリーを投稿しているリポジトリにこの契約を移植する読者のために設定した目安時間であり、私自身が計測したわけではない。
| 要素 | 仕様 |
|---|---|
| 入力 | レビュアーのサマリーファイル(空の場合あり)、レビュー工程の結果(success, failure, cancelled, skipped、または未入力)、プルリクエスト番号、チャット用WebhookのURL。 |
| 出力 | チャットカードは最大1枚:タイトル、色、本文、プルリクエストへのリンクボタン1つ。加えて、CIジョブのサマリーに「何を送信したか/なぜ何も送らなかったか」を1行記録する。 |
| 分類ロジック | サマリーが空で結果が{success, cancelled}:何もしない。それ以外でサマリーが空:グレー、「reviewer did not run(レビュアーが実行されなかった)」、原因を合成。サマリーに「unmeasured」セクションがあれば:グレー、原因をそのまま対処法に翻訳。サマリーが自動マージ適格を示す場合:グリーン。それ以外はオレンジ、人間への質問と未達成条件をすべて記載。 |
| 不変条件 | グレーのカードとオレンジのカードは決して同一にならない。承認はチャット上では行わない。 |
| 配線 | notifyステップは if: always() で実行される。GitHubのドキュメントによれば:"Causes the step to always execute, and returns true, even when canceled."(訳:このステップは常に実行され、キャンセル時もtrueを返す。) [2] 結果はクォート付きで渡し、空値も引数として残す。別のワークフローが pull_request: closed で merged == true マージ済みカードを送信する。 |
| Webhook未設定時 | CIではexit 0で終了し、ジョブサマリーに「chat not notified, here is how to get a webhook(チャット通知されていません。Webhookの取得方法はこちら)」と記載する。通知の有無でプルリクエストを失敗扱いにしない。 |
| 必ず失敗できるテスト | サマリーが空なら何も送らない。クラッシュ時はグレーのカードを1枚だけ送る。outcomeがなければアラームを鳴らす。キャンセルされた実行は通知しない。不正な署名は拒否。テストはワークフローファイルを読み、if: always()が消えたら失敗する。各分岐を一度ずつ書き換え、そのテストが赤くなることを確かめる。 |
| 2つの計測 | ラベルとサマリーテキストから集計したエスカレーションの内訳(自動/エスカレーション/未実行)、および自動マージの上限(直近でマージされた変更のうち、すべてのファイルが許可対象だった割合)。 |
| 意図的に実装していないもの | チャットからの承認、アラームの重複抑制、個人ごとのルーティング、モデルによる分類。 |
同じ話を5つの立場で読む
| 読者 | このレポートが示す判断 | 今週できるアクション |
|---|---|---|
| 学生 | 「安全」なルール(嘘をつかず、未測定は未測定と言う)だけで、届ける経路がなくても十分か。 | 身の回りのアラーム(バッテリー切れランプや煙探知機など)を一つ探し、それを誰がどれくらい早く気づくか考えてみる。 |
| エンジニア | 自分のAIレビュアーの「実行失敗」状態が、誰かの耳に届いているか。 | 過去30日間で、レビュアーが実際の判定を出さなかった実行回数を数える。 |
| 創業者 | 自分のコードベースで、人間による確認をスキップできる変更の割合はどれくらいか。 | 自動化の目標を立てる前に、直近60件のマージ済み変更でその上限を計算する。 |
| 経営層 | AIレビュー用の予算がバッチ処理のワークロードからきちんと分離されているか。 | 先月のAI予算をどのジョブが(キーごとに)消費したか、レビュアーに専用の上限があるかを確認する。 |
| 投資家 | チームの「90%自動化」主張に、実測された上限が裏付けとして存在するか。 | 分母と、「未計測」だった実行の割合を確認せよ。 |
現場検証ミッション
チームで信頼されている自動チェックを一つ選び、今夜あえて入力(無効なキーや空ファイルなど)を壊してみる。翌朝、その失敗がどこに現れ、誰が最初に気づくかを見てほしい。もし答えが「誰も開かないページ」や「誰も気づかない」なら、それが本稿で扱った問題だ。その場合、グレーのカードが30分で直せる解決策になる。
次に読むべき記事
AI-Native Series · Agent Engineering の一部AI-Native Series · Agent Engineering。数値は本文中でスコープされ、2026-09-23および2026-09-24に一つのプライベートリポジトリで実際に計測したコマンドに基づく。1レビューあたりのコストは課金コンソールのキーごとのコスト列から私が見積もった値であり、厳密な平均値ではない。キッチンはあくまでモデルであり、実測値ではない。
参考文献
- トヨタ自動車株式会社。トヨタ生産方式。 global.toyota ― 上記jidoka引用箇所、2026-09-24にページと逐語照合済み。
- GitHub Docs。Expressions: status check functions, always. docs.github.com — 上記の定義の引用元。2026年9月24日時点でページソースと照合済み。
- GitHub Docs. ワークフローやジョブの同時実行制御について docs.github.com —
cancel-in-progress——後続のレビューが発生した場合にキャンセルされる理由、およびそのケースが通知されない理由。 - GitHub Docs. 保護ブランチについて docs.github.com — ブランチ保護ルール。このリポジトリ(プライベートフォーク)では、APIが「Upgrade to GitHub Pro」と返したが、オーナーのアカウントはすでにProだった。
- Anthropic Help Center. ClaudeコンソールでのWorkspace作成と管理 support.claude.com — "The default Workspace is not editable and cannot be removed."(訳:「デフォルトのWorkspaceは編集できず、削除もできません。」)の引用元。2026年9月24日時点でページと照合済み。
- Anthropic. Workspaces(Claude Platformドキュメント)platform.claude.com — 引用ではなく説明:すべての組織にデフォルトWorkspaceがあり、追加Workspaceごとに利用上限が設定される(組織全体の上限の範囲内)。
- Feishu Open Platform. カスタムBot利用ガイド open.feishu.cn — カード投稿用Webhookについての説明(引用ではない)。