AI-Native Series · Agent Engineering
AIが私のリポジトリをレビューし、悪化させろと言ってきた
10点満点中8.6点をつけられ、12の改善案を提案された。そのうち半分は本物だった。1つは、コードベース内で最良の決断をひっそりと台無しにするところだった——その違いを見分ける唯一の方法は、レビューを読むのをやめて、コードそのものを読みに行くことだった。
1分で読める
私のオープンソースのループエンジンに対するAIレビューは、思慮深く、よく整理されており、その根拠はほぼすべて自分自身のREADMEから来ていた。12の提案のうち6つは本物の欠陥であり、5つは私が中途半端に作りかけて文書化を怠っていたもので、残る1つはすでに実装済みで、その提案はそれ——オープンなプラグインレジストリ——をクローズドなリストに置き換えるものだった。私は本物の欠陥のうち最大のものを実装した。それは、あるrunを記述する契約ファイルであり、難しかったのはスキーマではなかった。難しかったのは、そのファイルに私を拒否する能力を持たせることだった。それを実現したのが3つのルールであり、それはあなたがこれまでに書いたどんなガバナンスファイルにも一般化できる。
そのレビュー
誰かがフロンティアモデルを loop-engineering-anything ——独立した審査者に対して生成ツールをGrade FからGrade Aへと引き上げる私のエンジン——にかけ、その出力を私に送ってきた。それは良い出来だった。私がこれまで受けた人間によるコードレビューの大半より優れていた。構造的で、具体的で、実際に力を入れた箇所をきちんと評価していた。それは12件のアップグレードを提案し、さらに23項目のバックログを示した。
見出しもあった。曰く、your architecture is too CLI-shaped.(訳:あなたのアーキテクチャはCLI的すぎる) その最終的な提言は、正式な「アーティファクト型」を導入すること——エンジンが収束できるものの種類を固定リスト化すること——で、リポジトリの「anything」という約束を技術的に真にすべきだ、というものだった。
"Keep CLI as the first proven lane, but abstract the engine around 'artifact convergence,' not 'CLI convergence.'"(訳:CLIは最初の実証済みレーンとして残しつつ、エンジンは「CLI収束」ではなく「アーティファクト収束」を軸に抽象化せよ)
ここで重要な点がある。このレビューが私のコードについて行ったあらゆる主張は、たった一つの出典しか引いていなかった——私のREADMEだ。
これは揚げ足取りではない。この記事で最も有用な一文だ。表玄関しか読めないレビュアーは表玄関をレビューする。そして表玄関に「これはCLIを作るものだ」と書いてあれば、レビュアーは「これはCLIを作るものだ」と正しく結論づける。その指摘自体は本物だった。ただ、私のアーキテクチャについての指摘ではなかった。それは、アーキテクチャの衣を着た、私のドキュメントについての指摘だったのだ。
そこで私は地味な作業に取りかかった。コードに一行も手を入れる前に、まる一時間かけて自分自身のソースを読み直したのだ。
コードが語り返したこと
その提案は、中央のスキーマファイルに次のようなものを追加せよ、というものだった。
artifact_type: Literal["cli", "mcp_server", "agent_skill", "workflow", "spec"]閉じたリストだ。エンジンが改善できる新しい種類のものはすべて、その一つのファイルへの編集となり、そのファイルを持つ人間がレビューすることになる。
しかし、エンジンには8週間前に追加された汎用化のためのseam(継ぎ目)がすでに存在しており、それは正反対の方向に機能していた。domain(ドメイン) とは、3つの問いに答える小さなプラグインだ——このターゲットは自分の担当か、最初のバージョンをどう作るか、誰がそれを審査するか——そしてそれは起動時にレジストリへ自ら名乗りを上げる。新しい種類のターゲットを追加するとは、登録することにほかならない。中枢部分は何も変わらない。当時私が書いたモジュールのdocstringにはこうある。「新しいドメインは登録として到着するのであって、レジストリrouter.py やコントローラーへの編集としてではない……」
レビュアーの提案は、開いたシステムを閉じてしまうものだっただろう。悪意があったわけでも、愚かだったわけでもない——単に、その継ぎ目が見えなかったのだ。なぜなら、継ぎ目はREADMEには書かれていないからだ。
12件の提案のうち6件は本物のギャップだった。5件は私が半分だけ作り、ドキュメント化を怠っていたものだった。そして1件が、これだった。私は判定結果を項目ごとに書き上げ、コードの隣にコミットした[5]。内輪で議論して終わりにするレビューは、半年後にまた蒸し返すことになるからだ。
本物のギャップと、その内側に潜む罠
最大の正真正銘の穴は、名指ししてみると気恥ずかしいものだった。私のエンジンに「何を」させるか——何を改善するか、どこまで良ければ十分か、試行回数はいくつか、予算はいくらか、いつ止めるか——これらはすべて、コマンドラインのフラグとしてしか存在していなかった。ターミナルに打ち込まれ、ウィンドウを閉じれば消える。それだけのものだった。
つまり、ask(依頼)そのものを表すアーティファクトが存在しなかった。私はある実行が達成したことの美しい証明を見せることはできても、そのaskが何を求めたものだったのかを見せることはできなかった。この修正は明白に思える——askをファイルに書き込み、そのファイルをコミットすればいい。ask。私が見せられるのは、あるランが何を達成したかという美しい証明であって、そもそも何を頼まれたのかは見せられない。直すべき点は明白だ。依頼の内容をファイルに書き、そのファイルをコミットすればいい。
そして、そここそが落とし穴なのだ。なぜなら、その明白な直し方こそが、ソフトウェアが嘘をつく最もありふれた手口だからだ。
消えた一文字、消えた千台のサーバー
Kubernetesは、世界のサーバー群の大部分を動かしているシステムだ。何をしてほしいかはYAMLファイルで伝える。2023年4月、Kubernetesブログで検証機能を発表したGoogleの2人のエンジニアは、そのファイルにほんの少しでも誤りがあった場合に何が起きていたかを、こう説明している[1]:
"Before Kubernetes v1.8 (!), typos, mis-indentations or minor errors in YAMLs could have catastrophic consequences (e.g. a typo like forgetting the trailing s in replica: 1000 could cause an outage, because the value would be ignored and missing, forcing a reset of replicas back to 1)."(訳:Kubernetes v1.8以前(!)では、YAMLのタイプミス、インデントの誤り、ちょっとしたエラーが致命的な結果を招くことがあった――たとえば replica: 1000 の末尾の s を書き忘れるようなタイプミスひとつで、その値が認識されずに無視され、レプリカ数がデフォルトの1にリセットされてサービス停止に至る、といったことが起こり得た)
もう一度、じっくり読んでほしい。あなたは千台を頼んだ。だが書いたのはreplicaであって、replicasではなかった。システムは何も言わなかった。あなたのファイルを受理し、認識できない単語を捨て、台数についての指示が見つからないまま、律儀にデフォルトの1台へと戻ったのだ。
あなたのファイルは受理された。だが、あなたのサーバー群はそうならなかった。
あの引用文中の感嘆符は、エンジニア自身がつけたものだ。「v1.8より前」というのが、スペルミスをデフォルト値への無言の投票として扱うシステムを世に出していた期間として、いかに長かったかを物語っているからこそ、彼らはそこに感嘆符を置いたのだ。
これはKubernetes固有の欠陥ではない。これまで書かれてきたほぼすべてのコンフィグパーサーのデフォルトの振る舞いであり、根底には「受け取るものについては寛容であれ」という、本当に善意から生まれたエンジニアリングの伝統がある。2023年、Internet Architecture Boardはその助言を撤回する文書を発表した。理由は、寛容さが「もはやすべての場面でベストプラクティスとは見なされない」からだ。Martin ThomsonとDavid Schinaziはこう書いている[2]:
"Time and experience show that negative consequences to interoperability accumulate over time if implementations silently accept faulty input."(訳:時間と経験が示すところによれば、実装が不正な入力を黙って受理し続ければ、相互運用性への悪影響は時間とともに積み重なっていく)
彼らの論拠は、そのまま盗む価値がある部分だ。寛容さは無償でも、局所的でもない。ある実装が不正な形式のものをひそかに受理してしまえば、それ以降に構築されるものはすべて、仕様ではなくその「ひそかな受理」を前提にして組み立てられていく。彼らはこれを連鎖反応と呼び――「Overapplication of the robustness principle therefore encourages a chain reaction that can create interoperability problems over time」(訳:したがって頑健性の原則を過剰に適用すると、時間とともに相互運用性の問題を生み出す連鎖反応を助長することになる)――システムが若い時期にこそ最も痛手を負うと指摘する。今日の些細な癖が、明日には互換性の要件になってしまうからだ。
生まれたばかりのガバナンスファイルは、まさに生まれたばかりのプロトコルなのだ。
外出許可証
私が使ったモデルはこうだ。あなたが持っているどのコンフィグファイルにも当てはめて考えることができる。
学校の遠足には外出許可証が必要だ。ただの紙切れではなく、本当の意味での管理手段にする要素は3つある。
- 学校が実際に提供できることしか頼めない。 バスを頼むことはできる。だが許可証に「そしてヘリコプターも」と書いたところで、それで飛んでくるわけではない。
- 事務局が認識できないことを書けば、送り返されてくる。 来る予定などない乗り物を本人に信じさせたまま、バスに乗せるようなことはしない。最悪の結果は許可証が却下されることではなく、許可証が受理されたのに子どもが滑走路に取り残されることだ。
- 自分自身で署名することはできない。 親は「ピーナッツ禁止」と書き加えてもいい。だがどちらも「署名が必要」という項目を消すことはできない。
その三つの文が、私が実装した契約ファイルの設計のすべてだ。コード上では、こう表現される。
ルール1 — コンパイルはする、しかし拡張はしない
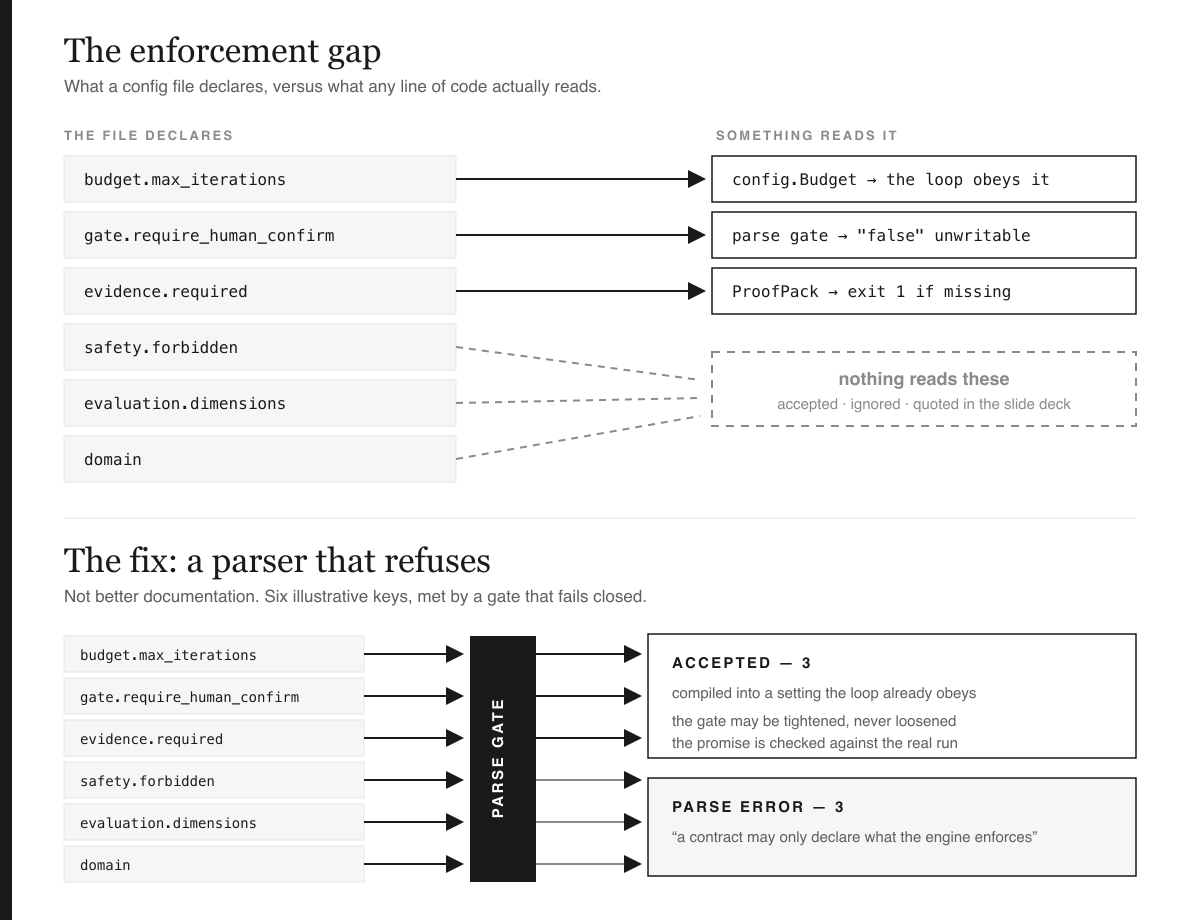
何かを設定するキーはすべて、ループがすでに従っている設定項目に変換される。ファイルが新しいノブを持ち込むことはできず、既存のものを埋めることしかできない。内訳はトップレベルが8個、budgetブロックが10個、gateブロックとevidenceブロックがそれぞれ1個ずつで、それ以外は存在しない。フラグ駆動の経路とファイル駆動の経路は、最終的に同一のオブジェクトをエンジンに渡す——コードパスは一つ、扉は二つだ。
ルール2 — 未知の単語はエラーであって、肩をすくめて済ませるものではない
これはKubernetesの教訓を、そのまま強制に変えたものだ:
$ loop-anything contract check loop.yaml
Error: loop.yaml.budget: unknown key(s) ['max_iteratons']; accepted:
['compression_interval', 'max_iterations', 'max_tool_retries', 'max_wall_seconds',
'min_score_gain', 'plateau_patience', 'plateau_pivots', 'target_grade',
'target_score', 'token_budget']. A contract may only declare what the engine enforces.パースは失敗する。runは開始しない。そしてエラーメッセージはやることリストになる——受理されるすべてのキーの名前をそこに挙げるので、タイプミスはデバッグセッションではなく数秒で片づく(この出力はターミナル上では一行だが、ページに収めるためにここでは折り返している)。
このルールの後半部分こそが、実際に判断力を要した箇所だ。レビュアーが提案したスキーマには、こんなブロックが含まれていた。
safety:
  forbidden:
    - delete_production_data
    - expose_credentials
これは見事な内容だ。どんなコンプライアンス審査も難なく通るだろう。だが私のエンジンでは、これを読むものは何一つ存在しない——実際の強制力は別の場所、シェルのメタ文字を拒否し、書き込みをワークスペースに閉じ込めるサンドボックスにある。あのブロックを受理していたら、スライドに引用されることだけを目的とした、装飾的な第二の安全システムができあがっていただろう。
誰も遵守させないルールは、煙感知器のない建物に掲げられた「禁煙」の看板のようなものだ。火事は止まらない。ただ、その火事が今や規則違反になるというだけのことだ。
だからパーサーはそれを名指しで、理由付きで拒否する。同じことがdomain:キーにも当てはまる(run経路はまだドメインを強制できないので、受理しても何も起こらない)。ディメンションごとのスコアリング重みについても同様だ(採点基準はジャッジ自身が持つべきものであり、採点される側が書いたファイルが採点を誘導することは決してあってはならない)。それぞれのキーは、何かがそれを強制した瞬間に合法になる。エラーメッセージこそがロードマップなのだ。
ルール3 — ゲートは締まる一方であり、緩むことはない
私のエンジンには、これらすべてに先立つルールがある。runが成功を報告しても、それは人間が確認するまでは主張であって、出荷済みの事実ではない、というものだ。アテンド付きのrunで人間のyesを供給するフラグは存在する。だが、ゲートを無効化するフラグは意図的に存在しない——そして、無人のスケジュール実行が自らの成果を事前承認しようとした場合、それはきっぱりと拒否される。
レビュアーが提案した契約デザインには、ブール値を持つヒューマンゲートのブロックが含まれていた:`require_human_gate: true`require_confirm_before_ship: true。つまりこうも書ける——`require_human_gate: false`false。しかもその契約を書くのは、まさにそのランを出荷したがっている当人自身なのだ。
だから私の実装では、このフィールドは省略するか、あるいはtrueに設定することしかできない。これをfalseに設定すると、説明付きのパースエラーになる。契約はレビュアーを追加してよいが、署名を取り除くことは決して許されない。許可証は親の署名を不要にすることができないのだ。
この記事は精度についての記事なのだから、ここも正確に言っておく価値がある——そのフィールドは実行時には何にもコンパイルされない。ゲートはデフォルトで既に有効になっており、どのコードパスもこのキーを読まない。このキーの唯一の仕事は、`require_human_gate: false`falseを書き換え不能にすることだ。契約の中でここだけは、パーサーが設定への入口ではなく強制そのものになっている。私自身のルール2に従えば、これは読み取り手のいないキーということになる。それでも残しているのは、拒否する対象が声高に拒否する価値があるからだ。(このゲートには例外的なバイパスが一つだけ存在するが、呼び出し側が使えるものではない。ビルドプラットフォームが所有する環境変数で、スケジュール実行では決して有効にならない。)
エビデンス:約束を約束のままにしない仕組み
ファイルの最後の節には、ランが証明すべきことが列挙されている——前後のグレード、次元別の差分、修正が受理された際に記録された回帰テストだ。こうした項目は七つ存在し、書き込む名前は必ずその七つのいずれかでなければならない。実際のランが生成できるのはそれだけだからだ。
そして、あるコマンドがそのファイルを実際に記録されたランと照合する:
$ loop-anything contract evidence loop.yaml --run 12
  present  grade_trajectory
  MISSING  regression_tests
Error: run #12 is missing declared evidence: regression_tests
終了コード1。私のプルーフパックは、根拠のないフィールドをでっち上げるのではなく省略する仕組みになっている。だから項目が欠けているということは、約束されたことと証明されたことの間に本物のギャップがあることを意味する。この例では、バグの再発を検知できるはずのテストを一度も記録せずに収束したランがあったということだ。
これこそが、ガバナンスのアーティファクトとガバナンスの見せかけを分ける違いである。片方は、あなたの名前入りの失敗を印字できる。
レビュアーが重要な意味で間違っていた理由
私がバックログをそのまま実行しなかったもう一つの理由があり、それは今回の個別のレビューについてのものではない。
このエンジンの中心的な規律は、構築するものと採点するものを決して同一にしないということだ。Arjun Panickssery、Samuel Bowman、Shi Fengは2024年、その規律に一つの測定を与えた。[3]:
"One such bias is self-preference, where an LLM evaluator scores its own outputs higher than others' while human annotators consider them of equal quality."(訳:そうしたバイアスの一つが自己優先であり、これはLLM評価者が自身の出力を他者の出力よりも高く評価する一方で、人間の注釈者はそれらを同等の品質と判断する現象である。)
さらに彼らは踏み込んでいて、ここが核心なのだが、モデルを自分自身のテキストをより正確に認識できるようにファインチューニングすると、次のような結果が生じたという。"a linear correlation between self-recognition capability and the strength of self-preference bias."(訳:自己認識能力と自己優先バイアスの強さとの間には線形の相関がある。) モデルが自分自身の「声」を認識する能力を高めれば高めるほど、その声を自分でより強く優遇するようになる。自己評価はランダムに失敗するのではなく、方向性を持って.
失敗するのだ。あなたのリポジトリに対するAIレビューは、AIが自分自身の出力を採点する行為とは違う——このレビュアーには私のコードに対する利害はなかった。しかし根底にある動きは同一であり、それはこのエンジン全体がまさに拒むために存在している動きそのものだ。すなわち——検証していない相手の評価を、そのまま受け入れてしまうこと——それに尽きる。レビューの根拠は私のREADMEだった。実際のソースと突き合わせてみると、8つの評価軸のうち5つが私自身の再採点でスコアを動かした——3つは下方修正、2つは上方修正だ。レビューが最も低く評価した軸である汎用性は、私自身が最も強く指摘した軸でもあった。一方、私が評価を下げたのは安全性、可観測性、エンタープライズ対応の3項目で、これらはコードの実態以上に甘く評価されていた。
パターンとアンチパターン
パターンはこうだ。パーサーは受理せずに落とす設計にし、失敗メッセージには許可されている選択肢を列挙させる。ポリシーファイルにはデフォルトを厳しくすることだけを許し、緩めることは決して許さない。各フィールドを受理する前に、それを読み取る側の実体に名前を与えておく。宣言された証拠と実際に生成された証拠を突き合わせ、終了コードで結果を示す。レビューの採否判断はコードのそばにコミットし、議論そのものをバージョン管理下に置く。
アンチパターンはこうだ。読み手のいない設定キー。安全性コードが一切開かない、ファイル内の安全性ブロック。作成者自身が自分のレビューを免除できるブール値。システムを拡張するために編集を要求される、閉じた型リストを持つスキーマ。番号が振られ整形されているというだけでバックログを実行してしまうこと。そして最も古典的なもの——「パースできた」ことを「理解された」ことと取り違えること。
メカニズムの正体
このメカニズムには名前がある。enforcement gap(実施ギャップ)——設定ファイルが宣言していることと、実際にどのコード行がそれを読んでいるかとの間の距離だ。あらゆる静かな設定バグと、あらゆる見せかけのコンプライアンス成果物は、このギャップに潜んでいる。しかもこのギャップは構造上見えない。受理されただけで遵守されていないファイルは、遵守されているファイルとまったく同じ見た目をしているからだ。
記録に残る最大級の事例は、設定ファイルですらない。Do Not Trackは、オンにするとブラウザが送信するヘッダーで、「追跡されたくない」という意思を示すものだった。ブラウザは何年もの間、律儀にこれを送り続けた。だが、どのサーバーもそれを読む義務を負ってはいなかった。そのワーキンググループは2019年1月17日に閉鎖され、仕様も廃止された[4]——十年間、完璧に送信され続けた選好が、結局誰にも遵守を求められることはなかった。
したがって第一原則はこうなる。失敗し得ない宣言は統制ではない。それは衣装にすぎない——システムにガバナンスを加える唯一誠実なやり方は、拒否する仕組みを同時に加えることなのだ。
本稿が主張しないこと
- ベンチマークはない。この契約書が実世界での設定ミスを減らすかどうかは測定していない。これは設計上の論証と一つの実装であって、研究ではない。
- レビューが悪かったわけではない。その半分は正しかったし、最良のアイデア——より強力な判定者なら異議を唱えるはずの場面で、私のループがどれほどの頻度で成功を報告してしまうかを測定すること——は、私がまだ実装していない、そして最も必要としているものだ。
- エンジンは一つ、著者も一人だ。 3つのルールは私自身のコードベースに由来する。KubernetesとIABの事例はこの原則を裏付けるものであって、私の特定の実装を裏付けるものではない。
- テストの本数は品質を意味しない。 テストスイートは543から600のパステストに増えた。だがこれは新しいコードのカバレッジを測るものであって、設計が正しいことを測るものではない。
結論
アップグレード自体は一日で片づいた。だが教訓を得るのにはまるまる一日かかった。しかもそれはYAMLの話ではなかった。
非常に流暢なシステムが、あなたの成果物の何が悪いかを整然としたリストにして手渡してくるとき、そのリストの流暢さは根拠の確かさについて何も語らない。それが何を読んだのかを問え。そして、それが読めなかったものを自分で読みに行け。
そして、ようやくガバナンスファイル――契約書、ポリシー、標準、チェックリスト――を書くときには、拒否条件を最初に書け。あなたの名前入りでエラーを出力させる入力を記述できないなら、それは制御を作ったのではない。看板を印刷しただけだ。
出典
- Jeffrey Ying、Antoine Pelisse(Google)、Kubernetes 1.27: Server Side Field Validation and OpenAPI V3 move to GA(訳:Kubernetes 1.27:サーバーサイド・フィールド検証とOpenAPI V3がGAに)、Kubernetes Blog、2023年4月24日。kubernetes.io/blog/2023/04/24/openapi-v3-field-validation-ga。逐語引用。カッコ内の感嘆符は原著者によるもの。
- M. Thomson、D. Schinazi、Maintaining Robust Protocols(訳:頑健なプロトコルを維持する)、RFC 9413、Internet Architecture Board(IAB)ストリーム、2023年6月。rfc-editor.org/rfc/rfc9413。両方の引用は、RFC本文(第2節および第4.1節)と照合し、逐語的に検証済みである。
- Arjun Panickssery, Samuel R. Bowman and Shi Feng, LLM Evaluators Recognize and Favor Their Own Generations, arXiv:2404.13076, 15 April 2024. arxiv.org/abs/2404.13076。引用はアブストラクトより。
- W3C Tracking Protection Working Group。同ワーキンググループのページには「The working group is currently closed. It closed on 17 January 2019」(訳:本ワーキンググループは現在閉鎖されており、2019年1月17日に閉鎖された)とあり、Tracking Preference Expression(DNT)関連文書は廃止済み仕様(retired specifications)に分類されている。 w3.org/2011/tracking-protection.
- レビューへの項目別の裁定は、それが論じるコードのすぐ隣にコミットしてある: docs/solutions/external-eval-2026-08-12.md。契約ファイル自体は
src/loopeng/contracts/run_contract.py、その設計ノートはdocs/solutions/run-contract.md、そして注釈付きの実例はdocs/examples/loop.yaml、いずれも github.com/wjlgatech/loop-engineering-anything.
2026年8月12日執筆。本稿の発端となったレビューは、読者の依頼を受けてフロンティアモデルが生成したものだ。私が残したのはその論旨であって、その正体ではない――重要なのは出典であって、モデルそのものではないからだ。