AI-Native 시리즈 · 에이전트 엔지니어링 · 루프 엔지니어링 실전
AI 리뷰 루프 리포트: 11일의 침묵, 하나의 채팅 카드, 24%의 한계
무엇이 망가졌고, 무엇을 만들었는지, 여섯 가지 결정과 그 이유, 리뷰어가 자기 수리에서 잡아낸 실수들, 그리고 각각을 반증할 수 있는 관찰과 함께 다음 단계까지 정리했다.
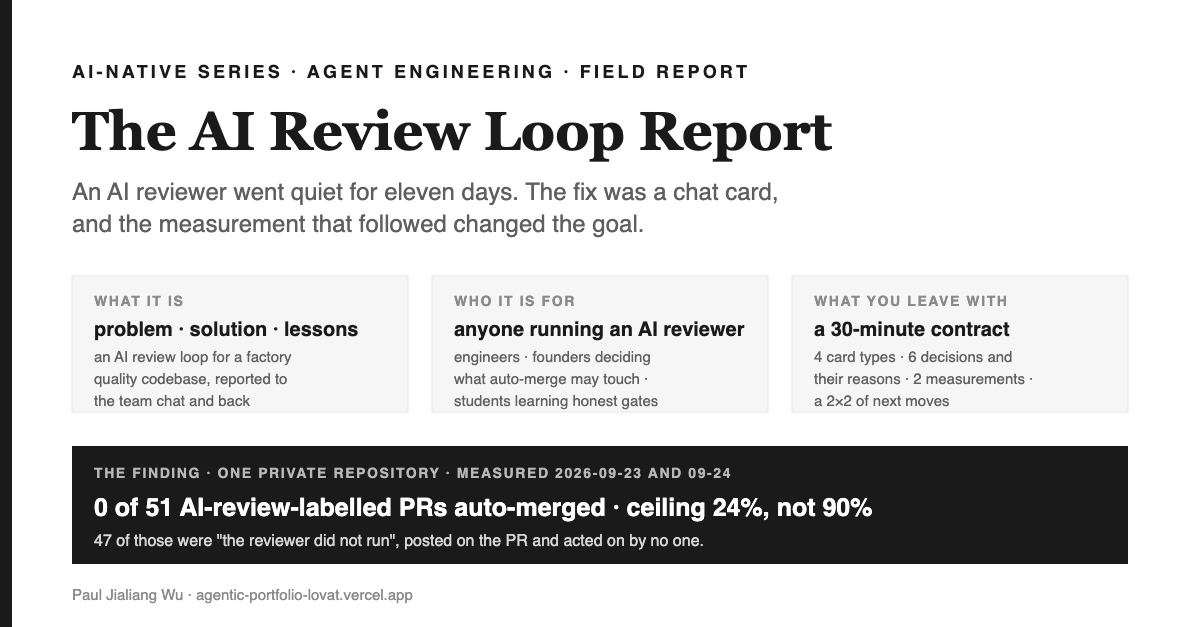
1분 요약 — 이 글을 읽고 남는 것
이 글은 이런 내용이다. 제조 품질 관리 코드베이스의 모든 풀 리퀘스트를 AI가 읽고, 그 판정을 팀 채팅 앱으로 바로 보내는 새 경로를 구축한 AI 리뷰 루프에 대한 보고서다. 문제(리뷰어가 11일간 예산 소진으로 아무도 눈치채지 못한 채 멈췄던 일), 고친 방식(결정마다 채팅 카드 하나, 리뷰어 자체가 고장 났을 때는 또 다른 카드), 여섯 가지 설계 결정과 그 이유, 얻은 교훈, 그리고 다음 단계까지 다룬다.
왜 중요한가. 엔지니어라면 "절대 침묵하지 않는다"는 게 필요조건일 뿐 충분조건은 아니라는 점을 알게 된다. 아무도 보지 않는 곳에 게시된 실패는 침묵과 다를 바 없다. 창업자라면: 팀이 변경의 90~95%를 인간 개입 없이 병합하겠다고 목표를 세웠지만, 실제 코드베이스에서 측정된 한계는 24%였다. 대부분의 변경이 반드시 사람이 서명해야 하는 부분을 건드리기 때문이다. 이 사실을 분기 내내 쫓아다니기 전에 아는 것이 루프 자체보다 더 값지다. 학생이라면: 목표를 세우기 전에 먼저 측정하는 실제 사례를 볼 수 있다.
읽고 나면 무엇이 달라질까. 오늘 바로 자신의 저장소에서 두 가지를 직접 측정해보라. 첫째, 리뷰어가 실제로 판정을 내린 비율은 얼마나 되는가? 둘째, 자동 병합 규칙이 실제로 허용할 수 있는 병합된 변경의 비율은 얼마인가? 아래 30분 계약서를 참고해, 리뷰어의 판정이 이미 팀이 읽는 채널로 흘러가도록 만들고, "리뷰어가 실행되지 않음"에는 별도의 알람이 울리게 하라.
이 AI 리뷰 루프 보고서의 범위와 독자
이 글은 한 저장소에서 이어진 실험의 연속이다.AI PR Review That Cannot Lie에서는 리뷰어를 만들었다. 모든 주장은 파일과 줄 번호를 근거로 삼고, "측정되지 않음"은 침묵이 아니라 명시적으로 게시되는 상태다.ANDON 시리즈는 이를 다섯 가지 규칙으로 구체화했고, 네 번째 에피소드인the auto-merge envelope에서는 "봇이 병합할 수 있는 문은 한 번도 열린 적 없다"는 정직한 결론으로 끝났다. 한편Visionboard 시리즈는 내가 프로젝트를 굴리는 도구를 만들었고, 마지막 에피소드인the scoreboard는 다음 분기를 위한 세 가지 내기와 각각의 반증 조건으로 닫혔다. 두 번째 내기는 "침묵할 수 없는 센서"였다.
이 보고서는, 그 설계들이 실제 한 주간의 현실과 부딪혔을 때 벌어진 일의 기록이다. 2026-09-23, 품질을 책임지는 공동창업자와 나는 AI 리뷰 루프에 대해 세 가지에 합의했다. 리뷰어는 두 가지를 판정한다: 변경이 요구사항을 충족하는가, 그리고 엔지니어링 규칙을 따르는가. 리뷰어가 확신이 없을 때만 인간에게 넘긴다—우리는 5~10%의 PR에서만 그럴 거라 추정했다. 모든 알림은 이메일이 아니라 팀 채팅으로 간다. 그날 바로 이 추정을 측정했다. 결과는 100%였다.
이 보고서는 세 부분으로 나뉜다.Report: 문제, 해결책, 그리고 그 뒤에 있는 여섯 가지 결정과 그 이유.Reflect: 실제 구축 과정에서 얻은 교훈, 리뷰어가 자기 수리 PR을 리뷰하며 잡아낸 것들, 그리고 위임에 대해 내가 신뢰를 잃은 오후에 배운 교훈 하나.Project: 다음 단계들—작고 큰 것, 짧고 긴 것—각각이 Visionboard의 내기나 ANDON의 문과 연결되어 있고, 각 단계마다 그것이 틀렸음을 증명할 수 있는 관찰이 붙는다.
이 글의 독자는 이렇다. AI 리뷰어를 직접 운영 중이거나 도입을 앞둔 엔지니어, "자동 병합"이 어디까지 허용될지 결정하는 창업자, 실패에서 측정·설계·미증명까지 한 번의 완전한 루프를 보고 싶은 학생. 코드베이스는 비공개지만, 모든 메커니즘은 여기서 재현할 수 있을 만큼 충분히 상세히 설명했다.
한 컷으로 보는 리뷰 루프: 패스, 수셰프, 그리고 셰프 주머니의 종
이 보고서를 관통하는 이미지는 주방에서 시작한다. 이 그림은 the first report의 주방 비유를 이어받는다. '레스토랑 운영'이라는 요리 계단 위, 모든 접시는 패스를 거쳐 나간다. 수셰프가 먼저 맛을 보고, 티켓에 메모를 단다. 헤드 셰프는 그 메모를 읽고 한 숟갈 맛을 본 뒤, 접시를 내보내거나 다시 돌려보낸다. 수셰프가 확실히 판단한 차가운 스타터는 바로 나갈 수 있다.
열한 날 동안 수셰프는 자리를 비웠다. 주방의 원칙은 "맛본 척하지 말 것"이었기에, 대타 수셰프는 모든 접시에 이렇게 썼다: not tasted. 규칙은 완벽히 지켜졌다. 메모는 패스에 쌓여만 갔다. 셰프는 식당 홀에서 휴대폰을 들고 있었고, 패스 쪽으로는 한 번도 가지 않았다. 모든 접시는 셰프의 결정을 기다렸다. 안전하긴 했지만, '셰프 없이도 대부분의 접시는 흐른다'는 주방의 약속은 조용히 0이 되었다. 거짓말은 없었고, 아무도 듣지 못했다.
이 문제의 해법은 셰프 주머니에 들어 있는 종이다. 두 가지 다른 소리로 울린다.
| 주방에서 | AI 리뷰 루프에서 |
|---|---|
| 티켓에 붙은 수셰프의 메모 | 풀 리퀘스트에 게시된 AI의 리뷰 요약: 인간에게 묻는 질문, 발견 사항들file:line, 제안된 판정, 그리고 이 변경이 자동 병합 대상인지 여부. |
| "not tasted" 메모가 패스에 쌓이는 모습 | 47개 중 45개의 요약이 "unmeasured"로 표시됐다. 리뷰어의 예산 한도가 초과되어 한 번도 실행되지 않았다. 게시는 됐지만, 아무도 조치하지 않았다. |
| 주황색 링: "이 접시에 대해 확신이 없다" | 채팅 카드 제목: needs your decision: AI가 던진 미해결 질문, 충족되지 않은 자동 병합 조건, 그리고 풀 리퀘스트로 가는 버튼. |
| 회색 링: "주방에 없다" | 다른 카드: the reviewer did not run, 원인과 해결책을 평이한 언어로 안내한다. 시스템 오류이며, 결코 접시에 대한 질문으로 위장하지 않는다. |
| 셰프가 결정을 내리기 위해 패스로 향한다 | 버튼을 누르면 GitHub에서 풀 리퀘스트가 열린다. 승인도 그 자리에서 이루어지고 기록된다. 채팅에서 답장하는 방식으로 승인하는 일은 없다. |
| 식당 홀에 켜진 불빛: "요리가 나갔다" | A merged 카드. 풀 리퀘스트가 머지될 때 별도의 워크플로우가 이 카드를 발송한다. 루프는 출발점에서 다시 닫힌다. |
이 주방 비유가 어긋나는 지점이 있다. 실제로 수셰프가 교대에서 빠지면 주방이 곧 느려지고 모두가 바로 알아차린다. 반면, 리뷰어가 '교대 중'이어도 눈에 띄는 손해는 없다. 인간 경로가 여전히 작동하기 때문이다. 바로 이것이 문제의 본질이고, 회색 알람(그레이 카드)이 반드시 필요했던 이유다.
Part I · 보고 — 문제, 고치기 전에 먼저 측정하다
같은 날 미국 시간(중국에서는 22:04에 회의가 끝났다), 나는 리뷰어가 라벨을 단 모든 풀 리퀘스트를 모아 각 요약에 적힌 이유를 직접 읽었다. 라벨이 아니라 요약이다. 'AI가 확신하지 못함'과 'AI가 실행되지 않음'은 같은 라벨을 썼다.
| 읽기(2026-09-23, 라벨이 붙은 풀 리퀘스트 47개) | 개수 |
|---|---|
| 자동 머지 | 0 |
| AI가 확신하지 못하거나 문제를 발견해서 에스컬레이션됨(리뷰어가 실제로 실행됨) | 2 |
| 리뷰어가 실행되지 않아 에스컬레이션됨("미측정") | 45 |
| 총 47개 중, 요약에 인쇄된 사유(한 풀 리퀘스트에 여러 사유가 있을 수 있음): 리뷰어 미실행 · 자동 머지 경로 외 변경 · 머신 게이트 레드 | 45 · 33 · 6 |
휴먼에게 도달한 풀 리퀘스트 비율: 47개 중 47개. 범위: 하나의 저장소, 리뷰어가 처음 라벨을 단 시점부터 2026-09-23까지의 라벨. [MEASURED]
하루 뒤 다시 읽었을 때, 풀 리퀘스트 4개가 더 늘어 51개가 라벨링되었고, 자동 머지는 0, 리뷰어가 실행된 에스컬레이션 4개, 실행되지 않은 경우 47개였다. 모양은 변하지 않았고, 단지 숫자만 늘었다.
다섯 번의 '왜', 각 질문은 저장소나 로그에서 답을 찾았다:
- 왜 모든 풀 리퀘스트가 휴먼에게 도달했는가? 47개 중 45개의 요약이 리뷰어가 실행되지 않았다고 적혀 있었기 때문이다.
- 왜 리뷰어가 실행되지 않았는가? 2026-09-12경 이후 모든 호출이 같은 오류를 반환했다. 조직의 월간 사용 한도에 도달했으며, 2026-10-01에 접근이 복구될 예정이었다.
- 왜 한도에 도달했는가? 리뷰어는 내가 그 머신에서 돌리는 모든 것(네 개 언어로 기사 번역하는 배치 작업 포함)과 하나의 API 키, 그리고 월 $100 한도를 공유했다. 결제 콘솔은 키별 사용량만 보여주고 작업별로는 보여주지 않는다. 그래서 어떤 작업이 가장 많이 썼는지는 알 수 없지만, 리뷰어가 굶주렸다는 사실만은 확실하다.
- 왜 11일 동안 아무도 눈치채지 못했는가? 리뷰 작업이 실패해도 머지를 막지 않도록 설정되어 있어서, 워크플로우는 초록불(성공)로 표시됐다. '미측정' 요약은 각 풀 리퀘스트에 정확히 침묵 금지 규칙을(를) 지켰지만, 11일 동안 아무도 움직이지 않았다. 수동 리뷰를 할 사람은 굳이 PR 요약을 열어보지 않기 때문이다.
- 근본 원인: 리뷰어가 스스로 실패했을 때, 그 사실이 사람 귀에 닿을 길이 없었다. '침묵 금지'는 화면에서는 지켜졌지만, 현실에서는 무력했다.
이 저장소의 교훈 파일에는 이미 2주 전에 거의 같은 내용이 남아 있었다. unmeasured needs someone watching it — 다음 단계는 끝내 실행되지 않았다. 산문으로 적힌 교훈은, 그 산문이 더는 사실이 아닐 수 있다는 뜻이다. 바로 이것이 ANDON episode 3의 주제다. 규칙을 산문이 아닌 데이터로 남겨야 한다는 것, 그리고 나는 이 교훈을 두 번이나 몸소 겪었다.
Part I · 보고 — 해결책: 모두가 실제로 머무는 채널로 알림을 보내는 AI 리뷰 루프
팀은 이미 채팅 앱(Feishu)만을 유일한 인박스로 쓰기로 결정했다. 그래서 루프는 네 단계로 이어진다. GitHub가 리뷰어를 실행하고, 스크립트가 그 요약을 채팅 카드로 바꾼다. 카드의 버튼을 누르면 사람이 다시 GitHub로 이동하고, 머지 이벤트가 한 장의 카드를 더 보낸다.
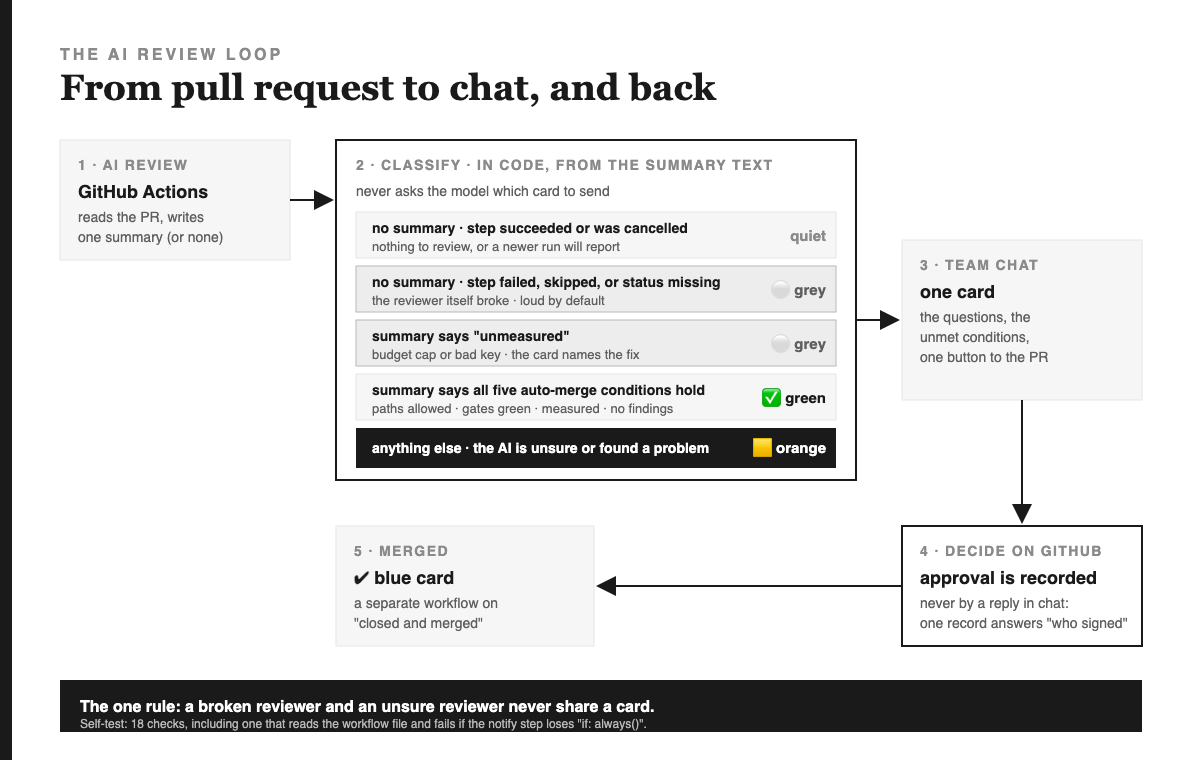
카드 종류와, 각 카드를 결정하는 기준:
| 카드 종류 | 발송 조건 | 사람이 할 일 |
|---|---|---|
| 🟨 결정 필요 | 리뷰어가 실행되었으나 변경사항이 자동 머지 대상이 아닌 경우: 허용 경로 외, 게이트 레드, 발견 사항, 혹은 인간만이 답할 수 있는 질문이 있을 때. | 질문을 읽고(지금까지 측정된 리뷰 기준, PR당 평균 2.3개, n=7), 버튼을 눌러 GitHub에서 결정한다. |
| ⚪ 리뷰어 미실행 | 요약에 'unmeasured'(예산, 잘못된 키)가 표시되었거나, 요약이 없고 리뷰 단계가 성공을 보고하지 않은 경우. | 시스템을 고친다. 카드에는 원인과 해결책이 명시되어 있고, 굵게 해당 PR이 문제가 아님을 알린다. |
| ✅ 자동 머지 중 | 자동 머지 조건 5가지가 모두 충족된 경우envelope 에피소드 보류. | 별도로 할 일 없음. 한 가지 설정으로 비활성화할 수 있다. |
| ✔ 병합됨 | 풀 리퀘스트가 병합되며 종료된다. | 별도로 할 일 없음. 루프가 닫힌다. |
| (카드 없음) | 리뷰할 내용이 없었거나, 더 최근에 푸시된 커밋이 실행을 취소했다. | 별도로 할 일 없으며, 이 침묵은 명시적으로 선언된 결정이다. 단, 아래에 언급한 한 가지 예외가 있다. |
최초의 엔드 투 엔드 실행(2026-09-24): 조직 한도를 올린 뒤, 리뷰어가 실제 풀 리퀘스트에서 동작했다. 세 가지 경고와 두 가지 인간에게 묻는 질문을 남겼고, 팀 채팅에는 해당 질문이 담긴 오렌지색 카드가 도착했다. 수정 후 병합이 이루어지면 파란색 카드가 발송된다. 모든 단계가 실제 풀 리퀘스트에서 작동하는 것이 확인됐고, 단순 테스트가 아니었다.
Part I · 보고 — 여섯 가지 설계 결정과 그 이유
| # | 결정 | 기각한 대안 | 이유 |
|---|---|---|---|
| 1 | 고장난 리뷰어는 별도의 카드를 받는다. 회색, 제목은 "did not run", 원인과 해결책을 명시. | 자동 병합이 아닌 모든 경우를 "사람이 필요함" 카드 하나로 처리. | 이 두 상태는 서로 다른 사람과 서로 다른 조치를 요구한다. 이 둘을 섞으면 45건의 시스템 결함이 45건의 리뷰 질문처럼 보이게 된다. 만약 루프가 한 가지 카드 타입으로 출시됐다면, 첫날에 전체 풀 리퀘스트의 100%에 알림이 갔을 것이고, 둘째 날에는 모두 무시당했을 것이다. |
| 2 | 카드 종류는 요약 텍스트로, 코드에서 결정한다. | 어떤 카드를 보낼지 모델에게 묻는다. | 라우터는 자신이 라우팅하는 대상에 의존해서는 안 된다. 예산이 소진된 리뷰어에게 예산이 소진됐는지 물을 수는 없다. |
| 3 | 승인은 GitHub에서만 이뤄진다. 카드의 버튼이 사람을 그곳으로 안내한다. | 채팅에서 답글로 승인, 콜백 서버가 있는 채팅 플랫폼 앱을 통해 처리. | 이 시스템은 품질 증거 체계다. 감사에서 "누가 언제 이 변경을 승인했는가"라는 질문에는 단 하나의 기록으로 답할 수 있어야 한다. 채팅 답변은 첫 번째 기록과 불일치할 수 있는 두 번째 기록이 되어버린다. 게다가 별도의 앱, 서버, 인증 정보까지 관리해야 한다. |
| 4 | 리뷰어의 상태가 확실하지 않으면, 반드시 알람을 울려야 한다. 명시적으로 "성공"이고 요약이 비어 있을 때만 조용히 넘어간다. | 단계가 명확히 실패한 경우가 아니면, 기본적으로 조용히 있지 않는다. | 상태가 없거나 깨진 경우야말로 망가진 설정에서 흔히 나오는 현상이다. 기본값은 반드시 시끄러워야 한다. 단, 최신 푸시로 인해 실행이 취소된 경우만 예외로 조용하다. 왜냐하면 새 실행이 다시 보고할 것이기 때문이다. 이 예외의 대가는 아래에서 따로 밝힌다. |
| 5 | 5–10%라는 목표 대신, 저장소가 직접 산출하는 두 가지 수치로 대체한다. | "5–10%만 에스컬레이션"이라는 목표를 고수하며, 그 비율에 도달할 때까지 오토머지가 허용하는 범위를 넓히는 방식은 버린다. | 측정 결과: 최근 머지된 변경 중 실제로 오토머지 자격이 있는 것은 24%에 불과했다(이유는 모두 타당하다, Part I의 ceiling 참고). 90%를 목표로 쫓는 것은 증거 체인을 속도와 맞바꾸는 일이다. 대체 수치는 Tier-1 오토머지 비율과 리뷰당 인간의 부담이다. |
| 6 | 리뷰어에게는 별도의 예산을 배정한다. 2026-09-24에 적용: 별도 워크스페이스에 새 키를 발급해, 해당 키의 지출이 따로 보이게 했다. 조직 한도도 $100에서 $200으로 상향했다. | 모든 작업에 하나의 키만 쓰고, 한도가 다하면 그때마다 올리는 방식은 버린다. | 예산을 공유하면 덜 중요한 작업이 가장 중요한 작업을 굶길 수 있다. 단, 조직 한도는 여전히 모든 워크스페이스 위에 있으므로, 격리는 완전하지 않다(이 부분에서 내가 실수한 내용은 lessons 섹션에 적었다). |
일곱 번째 결정은 거부다. 이 루프는 어떤 결정도 내리지 않는다. 결정을 전달만 한다. 리뷰어가 제안하고, 규칙 파일이 오토머지 가능 여부를 결정하며, 나머지는 모두 사람이 판단한다. 이것이 바로 the Visionboard를 팀에 적용한 설계다. 에이전트는 제안하고 보고만 하며, 인간은 루프 바깥에 선다. small-team episode에서는 인간 전용 필드가 역할 분리로 진화했다. 여기서 그 역할은 "코드 오너"이고, 카드는 그 역할에게 질문하는 방식이다.
Part I · 보고서 — 24% 천장: 오토머지가 실제로 닿을 수 있는 한계
결정을 더 빨리 전달하는 루프가 인간이 직접 내려야 할 결정의 총량을 줄여주지는 않는다. 그래서 두 번째 측정은 다른 질문을 던졌다. 최근 머지된 60개의 풀 리퀘스트 중 오직 오토머지 규칙이 허용하는 파일(문서, 계획, 테스트, 골든 테스트 케이스 등)만 건드린 것은 몇 개인가? 이것이 천장이다. 아무리 뛰어난 리뷰어라도 규칙이 제외한 변경은 오토머지할 수 없다. 60개 중 하나는 정확히 100개의 파일을 포함했는데, 이는 GitHub이 풀 리퀘스트당 반환하는 최대치라 목록이 잘렸을 수 있다. 이 경우는 미측정으로 간주해 59개가 남는다.
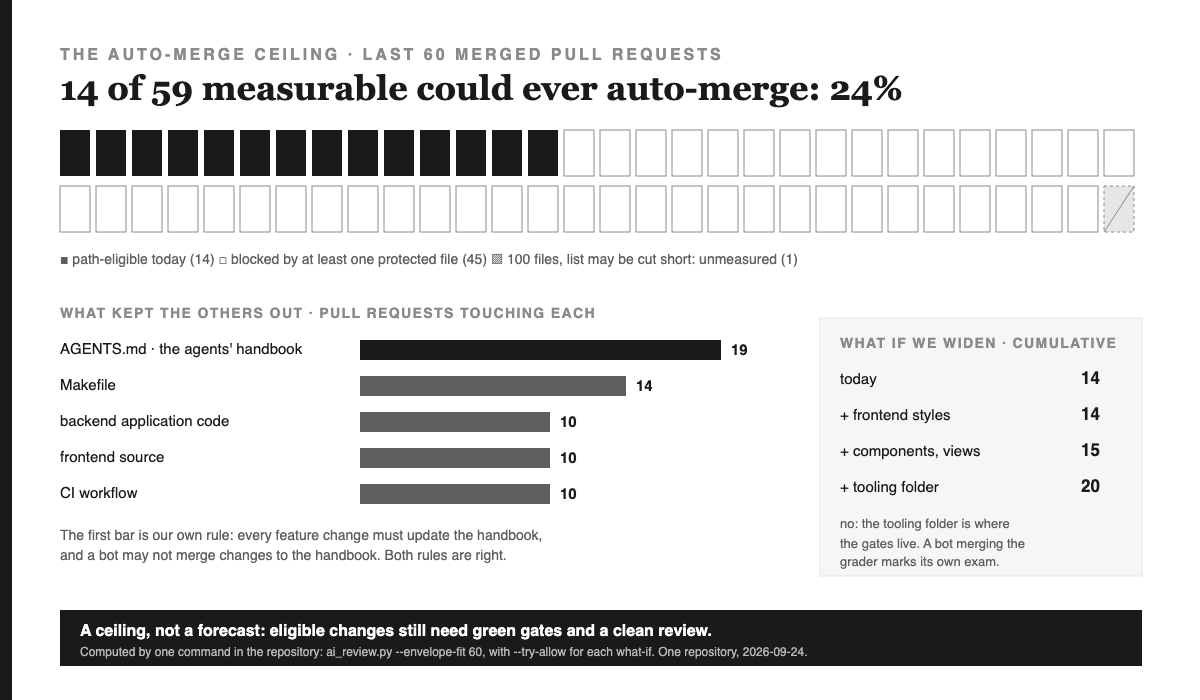
오토머지 경로 적합: 최근 머지된 60개 중 측정 가능한 59개 풀 리퀘스트 중 14개(24%). 프론트엔드 스타일, 컴포넌트, 뷰까지 포함하면 15개. 툴링 폴더까지 더하면 20개. 범위: 하나의 저장소, 2026-09-24 측정. 이는 천장이지 예측이 아니다. 자격을 갖춘 변경도 여전히 그린 게이트와 깔끔한 리뷰가 필요하다. [MEASURED]
가장 큰 장애물은 뜻밖이었고, 그 원인은 바로 우리였다.그중 19건은 AGENTS.md을 건드렸다. 이 파일은 코딩 에이전트들이 작업 전 반드시 읽는 핸드북이다. 저장소에는 '모든 기능 변경 시 핸드북을 반드시 갱신할 것'이라는 규칙이 있다. 덕분에 사람과 에이전트 모두 낡은 지침을 읽지 않는다. 동시에, 오토머지 규칙은 핸드북 변경을 봇이 머지하는 것을 정확히 금지한다. 핸드북이 바뀌면 모든 에이전트의 동작이 달라지기 때문이다. 두 규칙을 합치면, 모든 기능 변경에는 설계상 반드시 사람이 개입해야 한다. 로봇은 핸드북을 직접 갱신해야 하지만, 자기 핸드북 변경을 승인할 수는 없다. 두 규칙 모두 옳고, 잘못된 것은 목표였다.
프론트엔드까지 허용 범위를 넓혀도 풀 리퀘스트가 하나 더 늘 뿐이다. 실제 프론트엔드 변경은 보호된 파일도 함께 건드리는 경우가 많기 때문이다. 툴링 폴더까지 포함하면(가정은 누적된다) 다섯 개가 더 늘어난다. 이 폴더에는 게이트와 리뷰어 자체가 들어 있다. 즉, 봇이 그레이더 변경을 머지하도록 두는 것은 요리사가 자기 요리를 직접 평가하는 꼴이다. 그래서 다음 팀 결정 제안은 규칙은 그대로 두고 목표만 바꾼 뒤, 2주간 파일럿을 돌리는 것이다. 여기에 소프트웨어와 무관한 게이트가 하나 더 있다. GitHub는 이 저장소에 브랜치 보호를 적용하지 않고 "Upgrade to GitHub Pro"라는 답만 내놓는다. 그래서 봇은 승인만 할 수 있고, 머지는 할 수 없다. 이 문제가 풀리기 전까지 오토머지 비율은 구조적으로 0이다. 이 문은 the envelope episode에서 이미 닫혀 있던 바로 그 문과 같다.
정정, 2026-09-25. 이 보고서는 처음에 그 문을 열려면 월 $4 요금제가 필요하다고 썼다. 실제로 소유자는 이미 그 요금제를 쓰고 있었다. 같은 계정의 다른 비공개 저장소는 모두 브랜치 보호가 잘 적용됐다. 이 저장소만 예전 저장소의 비공개 포크였고, 포크는 소유자가 아니라 업스트림 네트워크에서 이런 기능을 상속받는다. 에러 메시지는 이미 적용된 해결책을 안내하고 있었다. 진짜 해결책은 포크를 분리하는 것이다. 이 역시 이 보고서의 나머지와 같은 교훈을 한 단계 더 내려서 보여준다. 나는 메시지에서 상태를 읽었지, 직접 측정하지 않았다. 실제 측정은 API 호출 몇 번이면 충분했다.
Part II · 성찰 — 리뷰어가 자기 수리 과정을 리뷰하며 잡아낸 것들
루프에 대한 수정 역시 풀 리퀘스트로 올렸다. 그래서 갓 부활한 리뷰어는 자기 자신을 살린 코드를 첫 오후 내내 채점했다. 내 풀 리퀘스트 네 개에서 열 번 실행됐다. 다섯 번은 추가 작업을 요구했고, 다섯 번은 승인했다. 매 라운드마다(승인 포함) 실제로 의미 있는 무언가를 지적했다. 아래는 잡아낸 순서대로 정리한 목록이다. 순서 자체가 교훈이다.
| # | 잡아낸 것 | 실수 유형 |
|---|---|---|
| 0 | 내 스크립트가 리뷰할 내용이 없는 풀 리퀘스트에 잘못된 "needs your decision" 카드를 보냈다. 이건 리뷰어의 첫 실전 날, 내가 직접 채팅에서 발견했다. | 빈 결과를 발견 사항으로 처리했다. |
| 1 | 내 수정은 요약에 마커 문자열이 없으면 카드를 건너뛰도록 했다. 만약 템플릿 이름이 바뀌면 모든 카드가 조용히 사라질 뻔했다. | 실제 조건(빈 값)이 아니라 우연한 세부사항에 키를 맞췄다. |
| 2 | 내 새 테스트는 새 카드가 전송됐는지 아닌지 대신 마지막으로 전송된 카드만 확인했다. 깨진 브랜치도 이전 테스트의 카드를 읽어 통과할 수 있었다. | 실패할 수 없는 테스트였다. 수정했고, 변이 테스트도 통과했다. |
| 3 | 테스트 전용 플래그가 프로덕션 커맨드라인에 추가됐고, "no summary"에는 리뷰할 게 없거나 리뷰어가 크래시한 두 가지 원인이 있었지만 둘 다 같은 조용한 분기로 처리됐다. | 제품에 테스트용 발판이 들어갔다; 두 상태가 한 코드 경로로 합쳐졌다. |
| 4 | 전체 크래시 알람이 diff 바깥 워크플로 파일 한 줄에 의존했는데, 어떤 테스트도 그 줄을 읽지 않았다. | 보장이 테스트 밖에 있었다. 이제는 체크가 파일을 읽고, 그 줄이 사라지면 실패한다. |
| 5 | 증거로 붙인 grep 출력에서 한 줄이 빠져 있었다. | 내가 증거를 잘랐다. 리뷰어는 출력이 파일과 일치하지 않는 걸 알아챘다. |
| 6 | 내 ceiling 측정은 GitHub의 풀 리퀘스트별 파일 목록을 읽었는데, 이 목록은 100개에서 끊긴다. 그래서 대형 변경은 eligible로 보일 수 있다. 그리고 내 새 "questions per review" 지표는 실패할 수 있는 테스트가 없었다. | 숫자가 잘못될 수 있는 방향이 오직 듣기 좋은 쪽뿐이었다. |
가장 인상 깊었던 실수는 리뷰어가 아니라 내가 직접 발견했다. 새로운 테스트가 실패하면서 드러난 문제였다. 리뷰어 스크립트가 크래시 나면, 알람 카드에는 내가 직접 쓴 설명이 들어간다: "the script itself failed; this is not a budget or 401 problem"(번역: 스크립트 자체가 실패했다; 이건 예산 문제나 401 문제가 아니다). 카드의 설명자는 "401"이라는 단어를 찾아 잘못된 키를 감지한다. 그런데 내 변명문에서 그 단어를 발견하고, 독자에게 키를 교체하라고 안내했다. 알람이 자기 자신을, '이 문제가 아니다'라는 문장에서 진단해버린 셈이다. 해결은 변명문을 다시 쓰는 것이었고, 교훈은 내가 키워드 탐지기를 만들어놓고 거기에 키워드를 직접 먹였다는 점이다.
6번 실수에는 내가 덜 자랑스러운 후일담이 있다. 리뷰어가 마지막 업데이트에서 "hold"로 표시했고, 채팅에는 오렌지색 카드가 도착했지만, 나는 테스트가 초록불이길래 카드를 열어보지도 않고 머지했다. 루프는 처음부터 끝까지 잘 동작했지만, 마지막 인간이 읽지 않았다. 해결은 후속 풀리퀘스트였고, 잘린 변경사항을 제외하자 ceiling이 23%에서 24%로 올랐다. 그리고 이제 레포지토리의 구현 로그에는 내가 어긴 규칙이 남았다: 머지 전에 테스트 결과와 리뷰어의 최신 평결을 모두 읽고, hold를 무시할 때는 그 이유를 기록할 것.
5번 실수는 내가 놓쳤을 것이고, 동료도 굳이 언급하지 않았을 실수다. 풀리퀘스트에는 "여기 grep 출력, 해당 줄이 있다"고 썼다. 그런데 내가 grep 출력을 줄여서 붙였고, 리뷰어는 diff 컨텍스트를 읽고 내가 보여준 것보다 한 줄 더 매칭되는 걸 세었다. 그래서 해당 주장에 대해 논쟁하지 않고 "unverified"로 표시했다. 이것이 바로 the first report's 규칙, 즉 증거 없는 주장은 금지라는 원칙이 자기 저자에게도 적용된 사례다.
Part II · 반성 — 얻은 교훈
- 침묵하지 않는 것만으로는 충분하지 않다. 상태는 반드시 누군가의 귀에 닿아야 한다. 리뷰어는 45개의 풀리퀘스트에서 규칙을 완벽히 지켰지만, 아무에게도 도움이 되지 않았다. 어떤 알람이든 진짜 테스트는 "게시됐는가"가 아니라 "하루 안에 누가 읽었는가"다. 이것이 Visionboard의 두 번째 베팅, "침묵할 수 없는 센서"의 더 강한 조건이다: 센서는 들리지 않아서도 안 된다.
- 비율을 논하기 전에 분모부터 측정하라. 우리는 회의 시간 일부를 5–10% 에스컬레이션을 목표로 설계하는 데 썼다. 실제 숫자는 100%였고, 그중 45건은 에스컬레이션이 아니라 고장난 센서였다. "측정하지 못함" 케이스는 따로 분리해서 비율을 계산해야 한다. 그 버킷이 전부라면, 비율은 0%나 100%가 아니라 "unmeasured"(측정 불가)다.
- 공유 예산은 덜 중요한 작업이 가장 중요한 작업을 굶길 수 있다. 리뷰어는 배치 번역 작업과 머신의 다른 모든 프로젝트와 예산을 공유했고, 결국 굶주린 쪽은 리뷰어였다. 콘솔은 어떤 작업이 한 달 예산을 썼는지 알려주지 못했다. 모두가 하나의 오래된 키를 썼기 때문이다. 중요한 경로에는 별도의 예산을 주고, 키가 아니라 작업별로 지출을 추적하라.
- 남을 위해 만든 게이트가 결국 나를 평가한다. 내 수리 PR에 대해 10번 리뷰를 돌렸고, 5번은 추가 작업을 요청받았으며, 내가 무시한 그 한 번이 옳았다. 리뷰어가 돌아온 날, 가장 많이 리뷰받은 저자는 바로 리뷰어를 만든 나였다. 지금까지 이 리뷰어가 리뷰당 약 $0.25의 가치는 한다는 가장 좋은 증거다(추정치: 키의 비용 열이 약 8번 리뷰 후 $1.96을 기록했다).
- 경로 안내가 아니라 결과를 전달하라. 이 빌드를 대신해준 에이전트는 나를 결제 콘솔로 네 번이나 보냈다: "설정, 그다음 한도", "Rate limits", "워크스페이스 전환 후 Billing". 마지막 목적지는 존재하지 않는다. 벤더의 공식 헬프센터에는 "The default Workspace is not editable and cannot be removed."(번역: 기본 Workspace는 수정할 수 없으며 삭제할 수 없습니다.) [5] 나는 플래너가 확인하지 않은 계획의 실행자였다. 그 이후 스스로 세운 규칙: 인간에게 목적지를 요구하기 전에 직접 검증하고, 링크 하나와 액션 하나만 넘겨라. 검증이 불가능하거나 필수적이지 않은 단계는 빼고, 결과만 전달하라. 사람에 대한 교훈도 마찬가지다. 위로 위임할 때, 내 윗사람은 레시피와 식재료 지도가 아니라 완성된 요리를 받아야 한다.
패턴, 안티패턴, 그리고 그 작동 원리
- 패턴: 두 가지 결함에는 두 가지 알림음이 있다."판단자가 확신이 없을 때"와 "판단자가 자리에 없을 때"는 각각 다른 카드, 다른 색, 다른 담당자에게 간다.
- 패턴: 라우터는 의도적으로 단순하게 설계한다. 시스템이 직접 쓴 텍스트만으로 결정적으로 분류한다. 모델이 자기 상태를 어떻게 생각하는지는 절대 쓰지 않는다.
- 패턴: 기본값은 시끄럽게. 침묵은 각 경우마다 명시적으로, 목록에 올려서 결정한다. 목록에 없는 건 전부 알람을 울린다.
- 안티패턴: 초록불이지만 실패. 병합을 막지 않아도 되는 작업이 실제로는 아무것도 안 하면서 초록불(성공)로 표시된다. 병합을 막지 않는 건 맞지만, 그게 곧 아무도 못 보게 만드는 건 버그다.
- 안티패턴: 상한선 없는 목표. 규칙이 허용하는 범위를 측정하기도 전에 비율 목표부터 세운다.
- 작동 원리: 지도가(jidoka). Toyota는 이를 이상이 발생했을 때"the machine or equipment can detect the abnormality and stop automatically, or the operator can stop the line by pulling the stop cord themselves"(번역: 기계나 설비가 이상을 감지하면 자동으로 정지하거나, 작업자가 직접 정지 코드를 당겨 라인을 멈출 수 있는 능력) [1]이라고 설명한다. 주방에서는 그 코드가 수셰프의 메모이고, 벨이 바로 알람이다. 코드를 당겨도 셰프가 있는 곳에서 벨이 울리지 않으면 아무 소용이 없다. 채팅 카드가 바로 그 벨이다.
- 첫 번째 원칙, 한 문장으로 정리하자면 이렇다. 어떤 점검도, 그 실패가 행동할 수 있는 사람에게 닿는 가장 짧은 경로만큼만 현실이 된다.
Part III · 프로젝트 — 다음 단계들, 크고 작은 것, 짧고 긴 것
각 단계는 Visionboard의 베팅이나 ANDON 도어에 연결되어 있고, 각각은 그 단계가 틀렸음을 증명할 수 있는 관찰 지표와 날짜를 갖는다. 이 형식은the scoreboard episode의 스타일을 따른다. Visionboard의 두 번째 베팅(침묵하지 않는 센서)에 대한 반증일자는 2026-10-07이고, 첫 두 단계가 이에 대해 보고한다.
| 단기(이번 달) | 장기(이번 분기) | |
|---|---|---|
| 소규모 | S1 · 팀 미팅에 주간 리포트 추가. 매주 월요일, 저장소가 에스컬레이션 비율과 자동 병합 한계, 그리고 리뷰당 인간 부담을 출력한다. 실패 기준: 2026-10-07까지 회색 카드가 발송됐는데도 팀 누구도 그 의미를 설명하지 못한다면, 그때는 카드의 문구 자체가 문제다. S2 · 명시된 예외 닫기. 현재는 타임아웃이나 수동 취소 등으로 리뷰가 취소되면 아무 알림 없이 조용히 넘어간다. 이때는 새 실행이 보고하지 않는다. 실패 기준: 로그에서 '취소 후 재실행되지 않은 리뷰'가 발견되는 날이 오면, 그 시점이 바로 예외 범위가 너무 넓어진 때다. | S3 · 리뷰어의 보정. 리뷰어가 승인한 모든 풀 리퀘스트에 대해 롤백과 버그 발생 건수를 세고, 보류한 경우에는 사람이 그대로 병합한 건수를 센다. 이것이 바로 보정(calibration) 질문이 우리 심판에게 던지는 과제다. 실패 기준: 2026-12-31까지, 또는 50개의 풀 리퀘스트 리뷰 후(둘 중 먼저 도달하는 시점)에 'merge'와 'hold' 판정이 롤백을 무작위보다 더 잘 예측하지 못한다면, 그때 리뷰어는 포매터에 불과하며 그에 맞는 가격이 매겨져야 한다. |
| 대형 과제 | B1 · 문을 한 번 연다. 포크를 상위 네트워크에서 분리하고, 브랜치 보호를 적용한 뒤, 규칙은 그대로 두고 2주간 파일럿을 돌린다. 성공 기준은 실제 자동 병합 3건 이상, 롤백 0건, 리뷰당 인간 질문 3건 이하이다. 실패 기준: 2026-10-31까지(또는 문을 연 후 2주 이내, 더 늦은 쪽) 3건 미만의 변경만 자격을 얻는다면, 그때는 한계가 측정치보다 더 낮다는 뜻이고, 팀은 이 저장소가 사실상 인간 리뷰임을 명확히 선언하고 더 이상 자동화인 척하지 말아야 한다. | B2 · 리뷰 루프를 Visionboard 센서로 만든다. 에스컬레이션 비율과 자동 병합 비율을 Visionboard의 엔지니어링 트랙 게이지로 연결하고, "reviewer did not run for 24 hours"가 단순 카드가 아니라 명명된 트립와이어가 된다. 이것이 바로 스코어보드의 두 번째 미래가 구체화된 모습이며, 세 번째 미래(더블 루프: 서명된 결정이 실제 변화를 예측하는지 묻는 것)로 가는 첫걸음이다(자세한 내용은 the scoreboard episode). 실패 기준: 2026-12-01까지 보드에 게이지가 표시되어 있는데도 팀이 리뷰 루프 관련 결정을 내릴 때 이를 참고하지 않았다면, 그때는 실패다. |
내가 의도적으로 하지 않는 세 가지가 있다. 채팅에서 바로 승인하는 기능, 파일럿 전에 오토머지 규칙을 넓히는 일, 그리고 첫 번째 리뷰어를 감시할 두 번째 리뷰어를 만드는 것이다. 각각 흥미로운 시도이긴 하지만, 오늘 당장 열려 있는 루프를 닫아주지는 않는다.
30분 만에 구현하는 리뷰 루프 계약서
여기서 말하는 것은 코드가 아니라 계약서다. 30분은 이미 AI 리뷰어가 요약을 남기는 저장소에 이 계약서를 복사해 적용하는 데 필요한 예산이다. 실제로 내가 시간을 쟀던 것은 아니다.
| 구성 요소 | 명세 |
|---|---|
| 입력 | 리뷰어의 요약 파일(비어 있을 수 있음), 리뷰 단계의 결과(success, failure, cancelled, skipped, 또는 누락), 풀 리퀘스트 번호, 채팅 웹훅 URL. |
| 출력 | 채팅 카드 0개 또는 1개: 제목, 색상, 본문, 풀 리퀘스트로 연결되는 버튼 1개. 그리고 CI 작업 요약에 무엇을 보냈는지, 혹은 아무것도 보내지 않은 이유를 남기는 한 줄. |
| 분류 기준 | 요약이 비어 있고 결과가 {success, cancelled}라면: 아무것도 보내지 않는다. 그 외에 요약이 비어 있으면: 회색, "reviewer did not run"(리뷰어가 실행되지 않음), 원인 합성. 요약에 "unmeasured"(측정되지 않음) 섹션이 있으면: 회색, 원인을 해결책으로 번역. 요약이 오토머지 자격을 표시하면: 초록색. 그 외에는: 주황색, 인간이 답해야 할 질문들과 충족되지 않은 모든 조건을 포함한다. |
| 불변 조건 | 회색 카드와 주황색 카드는 절대 한 장으로 합쳐지지 않는다. 승인 절차는 채팅에서 일어나지 않는다. |
| 연결 방식 | notify 단계는 if: always()와 함께 실행된다. GitHub 문서의 설명은 다음과 같다: "Causes the step to always execute, and returns true, even when canceled."(번역: 이 단계는 항상 실행되며, 취소되어도 true를 반환한다.) [2] 결과값을 인용하여 전달한다. 비어 있는 값도 인자로 남긴다. pull_request: closed에서 별도의 워크플로우가 merged == true를 사용해 머지된 카드를 보낸다. |
| 웹훅 누락 시 | CI에서는 0으로 종료하고, 작업 요약에 "chat not notified, here is how to get a webhook"(번역: 채팅 알림이 가지 않았습니다. 웹훅을 얻는 방법은 다음과 같습니다.)라고 남긴다. 알림 문제로 풀 리퀘스트를 실패 처리하지 않는다. |
| 실패를 검증할 수 있어야 하는 테스트 | 요약이 비어 있으면 아무것도 보내지 않는다. 크래시가 나면 회색 카드 하나만 보낸다. outcome이 없으면 알람을 울린다. 취소된 실행은 조용하다. 서명이 잘못되면 거부한다. 테스트는 workflow 파일을 읽어 if: always() 가 빠지면 실패한다. 각 분기를 한 번씩 변형해서, 테스트가 실제로 실패(빨간색)하는지 확인한다. |
| 두 가지 측정값 | 라벨과 요약 텍스트에서 얻는 에스컬레이션 분포(자동/에스컬레이션/실행 안 됨), 그리고 최근 머지된 변경 중 모든 파일이 허용된 경우의 비율로 계산한 오토머지 최대치. |
| 의도적으로 뺀 항목 | 채팅에서 승인하기, 반복 알람 중복 제거, 사람별 라우팅, 그리고 분류에 모델을 쓰는 모든 방식. |
같은 이야기, 다섯 갈래 출구
| 독자 | 이 보고서가 겨냥하는 결정 | 이번 주에 바로 할 수 있는 한 가지 |
|---|---|---|
| 학생 | "안전한" 규칙(거짓말 금지, 미측정 상태 표기)만으로 전달 경로 없이 충분한지. | 당신 삶에서 알람 하나(저전압 경고등, 연기 감지기 등)를 골라, 누가 그 알람을 듣고 얼마나 빨리 반응하는지 직접 확인해 보라. |
| 엔지니어 | 당신의 AI 리뷰어가 "실행 실패" 상태일 때, 그 사실이 실제로 누군가에게 닿는지. | 지난 30일 동안 리뷰어가 실제 판정을 내지 못한 실행 횟수를 직접 세어보라. |
| 창업자 | 당신 코드베이스에서 변경 중 인간 확인 없이 넘어갈 수 있는 비율이 실제로 얼마인지. | 자동화 목표를 세우기 전에, 최근 머지된 60건의 변경 중 오토머지 최대치를 직접 계산하라. |
| 임원 | AI 리뷰 예산이 배치 작업과 분리되어 있는지. | 지난달 AI 예산을 어떤 작업이, 어떤 키로 소진했는지, 그리고 리뷰어가 자체 한도를 갖고 있는지 직접 물어보라. |
| 투자자 | 팀의 "90% 자동화" 주장에 실제 측정된 최대치가 근거로 있는지 확인하라. | 분모와, 실제로 측정이 이루어지지 않은 실행의 비율을 물어보라. |
현실 점검 미션
팀이 믿고 있는 자동화 체크 하나를 골라 오늘 밤 일부러 입력을 망가뜨려 보라. 예를 들어 잘못된 키나 빈 파일을 넣으면 된다. 그리고 내일 아침, 그 실패가 어디에 나타나는지, 누가 가장 먼저 알아채는지 직접 확인하라. 만약 그 답이 '아무도 열지 않는 페이지'이거나 '아무도'라면, 바로 이 보고서가 다루는 문제를 당신도 안고 있는 셈이다. 그레이 카드는 이 문제를 30분 만에 고칠 수 있는 처방이다.
이어 읽기
AI-Native Series · Agent Engineering의 일부AI-Native Series · Agent Engineering. 본문에 등장하는 모든 수치는 해당 위치에서 범위가 명확히 제시되어 있으며, 2026-09-23과 2026-09-24에 하나의 비공개 저장소에서 직접 측정한 값이다. 리뷰 1회당 비용은 빌링 콘솔의 키별 비용 열을 보고 내가 추산한 값이지, 계량된 평균이 아니다. 주방은 실제가 아니라 모델이다.
참고문헌
- Toyota Motor Corporation. Toyota Production System. global.toyota — 위에 인용된 jidoka 구절을 2026-09-24 해당 페이지와 한 글자씩 대조함.
- GitHub Docs. Expressions: status check functions, always. docs.github.com — 위 인용 정의는 2026-09-24에 해당 페이지 소스와 대조하여 확인했다.
- GitHub Docs. 워크플로와 작업의 동시성 제어 docs.github.com —
cancel-in-progress, 선행 리뷰가 취소되는 원인과 그 상황이 조용한 이유. - GitHub Docs. 보호 브랜치 안내 docs.github.com — 브랜치 보호 규칙. 이 저장소(비공개 포크)에서는 소유자 계정이 이미 Pro임에도 API가 "Upgrade to GitHub Pro"라고 응답했다.
- Anthropic Help Center. Claude 콘솔에서 워크스페이스 생성 및 관리 support.claude.com — "The default Workspace is not editable and cannot be removed."(번역: 기본 워크스페이스는 편집할 수 없으며 삭제할 수 없습니다.)라는 인용문을 2026-09-24에 해당 페이지에서 확인했다.
- Anthropic. Workspaces (Claude Platform documentation). platform.claude.com — 인용은 아니고 설명: 모든 조직에는 기본 워크스페이스가 있고, 추가 워크스페이스별로 지출 한도가 설정되며 조직 전체 한도 아래에 있다.
- Feishu Open Platform. 커스텀 봇 사용 가이드 open.feishu.cn — 카드가 전송되는 웹훅에 대한 설명(인용 아님).