Serie AI-Native · Ingeniería Agéntica · Ingeniería de Bucles en la Práctica
Informe del Ciclo de Revisión con IA: Once Días en Silencio, Una Notificación y un Techo del 24%
Qué falló, lo que construimos, las seis decisiones y la razón de cada una, lo que el revisor detectó al revisar sus propias correcciones, y los siguientes pasos, cada uno con la observación que lo podría refutar.
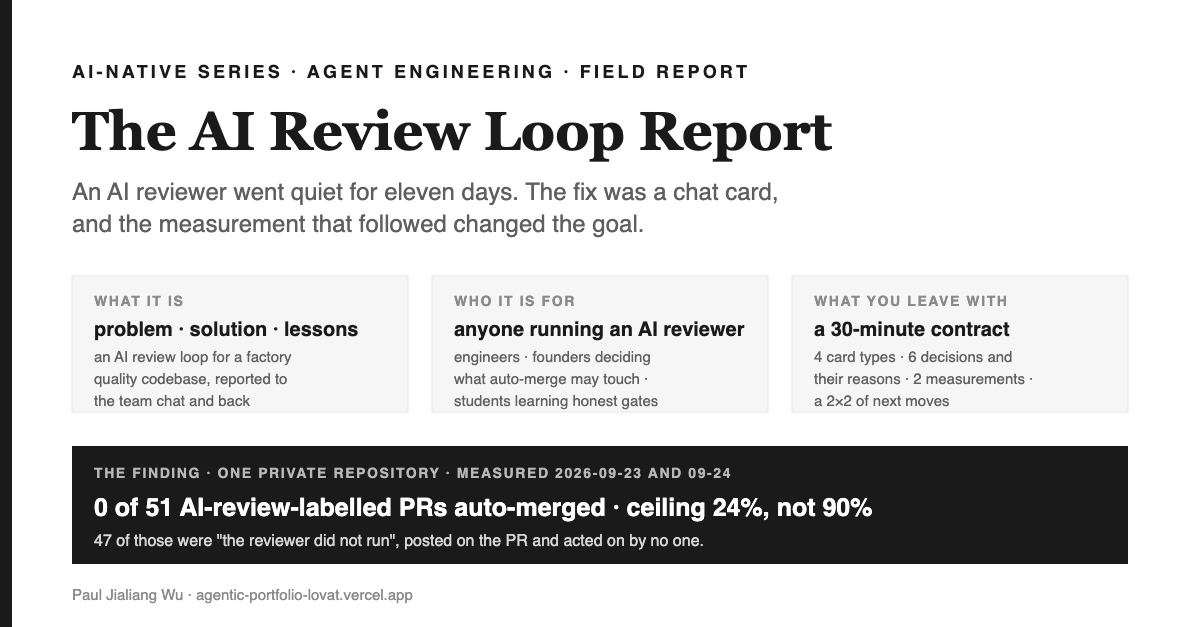
Resumen en 1 minuto — lo esencial
Qué es esto. Un informe sobre un ciclo de revisión con IA: la IA que lee cada pull request en una base de código de gestión de calidad para manufactura, y el nuevo camino que lleva su veredicto al chat del equipo y de regreso. Cubre el problema (el revisor se quedó sin presupuesto durante once días y nadie se enteró), la solución (una notificación por decisión, con una notificación distinta cuando el propio revisor falló), las seis decisiones de diseño y la razón de cada una, las lecciones y los próximos pasos.
Por qué importa. Para un ingeniero: "nunca en silencio" es necesario pero no suficiente. Un fallo que se publica donde nadie lo ve se comporta igual que el silencio. Para un fundador: el equipo fijó como meta que el 90–95% de los cambios se fusionaran sin intervención humana, y el techo medido en esta base de código es del 24%, porque la mayoría de los cambios tocan cosas que debe firmar una persona. Saber eso antes de dedicarle un trimestre vale más que el propio ciclo. Para un estudiante: un ejemplo trabajado de cómo medir una meta antes de construir hacia ella.
Qué puedes hacer tras leerlo. Ejecuta hoy mismo las dos mediciones en tu propio repositorio (cuántos de los veredictos de tu revisor realmente se ejecutaron, y qué porcentaje de los cambios fusionados podrían, en teoría, ser aprobados automáticamente por tus reglas de auto-merge). Copia el contrato de 30 minutos que aparece más abajo para redirigir los veredictos de tu revisor al canal que tu equipo ya consulta, con una notificación distinta para "the reviewer did not run" (el revisor no se ejecutó).
Qué cubre este informe sobre el ciclo de revisión con IA y a quién va dirigido
Este informe continúa una línea de trabajo en un único repositorio. AI PR Review That Cannot Lie construyó el revisor: cada afirmación va acompañada de un archivo y una línea, y "unmeasured" (no medido) es un estado publicado en vez de silencio. El ANDON convirtió eso en cinco reglas, y su cuarto episodio, the auto-merge envelope, terminó con una frase honesta: la puerta que permite a un bot fusionar nunca se había abierto. En paralelo, la serie Visionboard construyó la herramienta con la que gestiono mis proyectos, y su último episodio, the scoreboard, cerró con tres apuestas para el siguiente trimestre, cada una con su falsador y fecha. La segunda apuesta fue a sensor that cannot be silent.
Este informe es lo que ocurrió cuando esos diseños se enfrentaron a una semana real. El 2026-09-23, mi cofundador, que es responsable del área de calidad, y yo acordamos tres cosas para el ciclo de revisión con IA: el revisor evalúa dos aspectos (si el cambio cumple los requisitos y si sigue las reglas de ingeniería); solo escala a un humano cuando no está seguro, lo que calculamos sería entre el 5 y el 10% de los pull requests; y todas las notificaciones van al chat del equipo en vez de al correo. Ese mismo día comprobé la hipótesis. Era 100%.
El informe tiene tres partes. Informe: el problema, la solución y las seis decisiones con la razón de cada una. Reflexión: lo que enseñó la construcción, incluyendo lo que el revisor detectó al revisar sus propias correcciones, y una lección sobre delegar que me costó una tarde de confianza. Proyecto: los siguientes pasos, pequeños y grandes, a corto y largo plazo, cada uno vinculado a una apuesta de Visionboard o a una puerta ANDON, y cada uno con la observación que lo invalidaría.
Lectores: ingenieros que ya usan o están por implementar un revisor con IA; fundadores que deciden hasta dónde puede llegar el "auto-merge"; estudiantes que quieren ver un ciclo completo, desde el fallo hasta la medición, el diseño y lo que aún está por probar. El código es privado; aquí se reproduce cada mecanismo con suficiente detalle para reconstruirlo.
Una imagen: la barra, el sous-chef y la campana en el bolsillo del chef
Una imagen va a sostener el informe, y continúa la cocina desde el primer informe, en el peldaño de la escalera culinaria de “dirigir un restaurante”. Cada plato sale por la barra. Un sous-chef lo prueba y engancha una nota al ticket. El chef principal lee la nota, prueba una cucharada y decide si el plato sale o regresa. Los entrantes fríos en los que el sous-chef confía pueden salir directo.
Durante once días el sous-chef estuvo fuera de turno. La regla de la cocina decía “nunca finjas que lo probaste”, así que en cada plato el suplente del sous-chef colocaba una nota: no probado. La regla se cumplió a la perfección. Las notas se acumulaban en la barra. El chef estaba en el comedor, teléfono en mano, y nunca pasó por la barra. Cada plato quedaba esperando al chef, lo cual era seguro, y la promesa de la cocina de que la mayoría de los platos saldrían sin él, en silencio, se convirtió en ningún plato. Nadie mintió. Nadie se enteró.
La solución es una campana en el bolsillo del chef que suena en dos tonos distintos.
| En la cocina | En el ciclo de revisión con IA |
|---|---|
| La nota del sous-chef en el ticket | El resumen de la revisión de la IA publicado en el pull request: preguntas para un humano, hallazgos con file:line, un veredicto sugerido y si el cambio califica para auto-merge. |
| Notas de “no probado” acumulándose en la barra | 45 de 47 resúmenes diciendo “no medido”: se alcanzó el tope de presupuesto del revisor, así que nunca corrió. Publicado, honesto, y sin que nadie actuara. |
| Un aro naranja: “No estoy seguro de este plato” | Una notificación en el chat titulada needs your decision: las preguntas abiertas de la IA, cada condición de auto-merge no cumplida y un botón al pull request. |
| Un aro gris: “No estoy en la cocina” | Otra notificación: the reviewer did not run, con la causa en palabras claras y la solución. Una falla del sistema, nunca disfrazada de pregunta sobre el plato. |
| El chef camina hacia la barra para decidir | El botón abre el pull request en GitHub. La aprobación ocurre ahí, donde queda registrada, nunca por una respuesta en el chat. |
| Una luz en el comedor: "plato servido" | A merged notificación, activada por un flujo de trabajo aparte cuando el pull request se cierra como merged. El ciclo se cierra donde empezó. |
Donde la analogía falla: a un sous-chef real que está fuera de turno se le extraña de inmediato, porque la cocina se ralentiza. Un revisor que está "fuera de turno" no cuesta nada visible, porque la ruta humana sigue funcionando. Ese es todo el problema, y la razón por la que el aro gris tenía que existir.
Parte I · Reporte — el problema, medido antes de corregirse
Más tarde ese mismo día, hora de EE. UU. (la reunión fue a las 22:04 en China), extraje todos los pull requests que el revisor había etiquetado y leí la razón impresa en cada resumen. No la etiqueta: la etiqueta para "la IA no está segura" y la etiqueta para "la IA nunca corrió" eran la misma.
| Lectura (2026-09-23, 47 pull requests etiquetados) | Conteo |
|---|---|
| Se fusionaron automáticamente | 0 |
| Escalados porque la IA no estaba segura o encontró un problema (el revisor sí corrió) | 2 |
| Escalados porque el revisor nunca corrió ("no medido") | 45 |
| De los 47, razones impresas (un pull request puede tener varias): el revisor no corrió · cambio fuera de las rutas de auto-merge · una compuerta de máquina en rojo | 45 · 33 · 6 |
Proporción de pull requests que llegaron a un humano: 47 de 47. Alcance: un repositorio, las etiquetas del revisor desde su primer pull request etiquetado hasta 2026-09-23. [MEDIDO]
Leído de nuevo un día después, con cuatro pull requests más: 51 etiquetados, 0 se fusionaron automáticamente, 4 escalados por un revisor que sí corrió, 47 donde nunca corrió. La forma no cambió, solo el conteo.
Cinco preguntas clave, cada una respondida desde el repositorio o sus logs:
- ¿Por qué cada pull request llegó a un humano? Porque 45 de 47 resúmenes decían que el revisor no había corrido.
- ¿Por qué no había corrido? Cada llamada desde más o menos el 2026-09-12 devolvía el mismo error: se alcanzó el límite mensual de gasto de la organización, y el acceso volvería el 2026-10-01.
- ¿Por qué se alcanzó el límite? El revisor compartía una sola API key, y un límite mensual de $100, con todo lo demás que ejecuto en esa máquina, incluyendo un job por lotes que traduce artículos a cuatro idiomas. La consola de facturación muestra el gasto por key, no por job, así que no puedo decir qué job gastó más; sí puedo decir que el revisor fue el que se quedó sin recursos.
- ¿Por qué nadie se dio cuenta durante once días? El job de revisión está configurado para no bloquear merges cuando falla, así que el workflow aparecía en verde. El resumen "no medido" se publicó en cada pull request, exactamente como la regla de nunca quedarse en silencio exige, y nadie actuó en once días, porque nadie abre un resumen en un pull request que ya va a revisar manualmente.
- Causa raíz: el propio fallo del revisor no tenía camino hacia un oído humano. "Nunca quedarse en silencio" se cumplió en la página y se incumplió en la realidad.
El archivo de lecciones del repositorio ya tenía una entrada de dos semanas antes que decía casi exactamente esto, unmeasured needs someone watching it, con un siguiente paso que nunca se implementó. Una lección registrada en prosa es una lección sobre la que la prosa puede dejar de ser cierta. Esa es la tesis de ANDON episodio 3, reglas como datos en vez de prosa, y al parecer necesitaba aprenderlo una segunda vez.
Parte I · Informe — la solución: un ciclo de revisión AI que reporta en el canal donde realmente está la gente
El equipo ya había decidido que la app de chat (Feishu) sería la única bandeja de entrada. Así que el ciclo tiene cuatro saltos: GitHub ejecuta el revisor, un script convierte su resumen en una notificación de chat, un botón en la notificación regresa al humano a GitHub, y el evento de fusión manda una notificación más de vuelta.
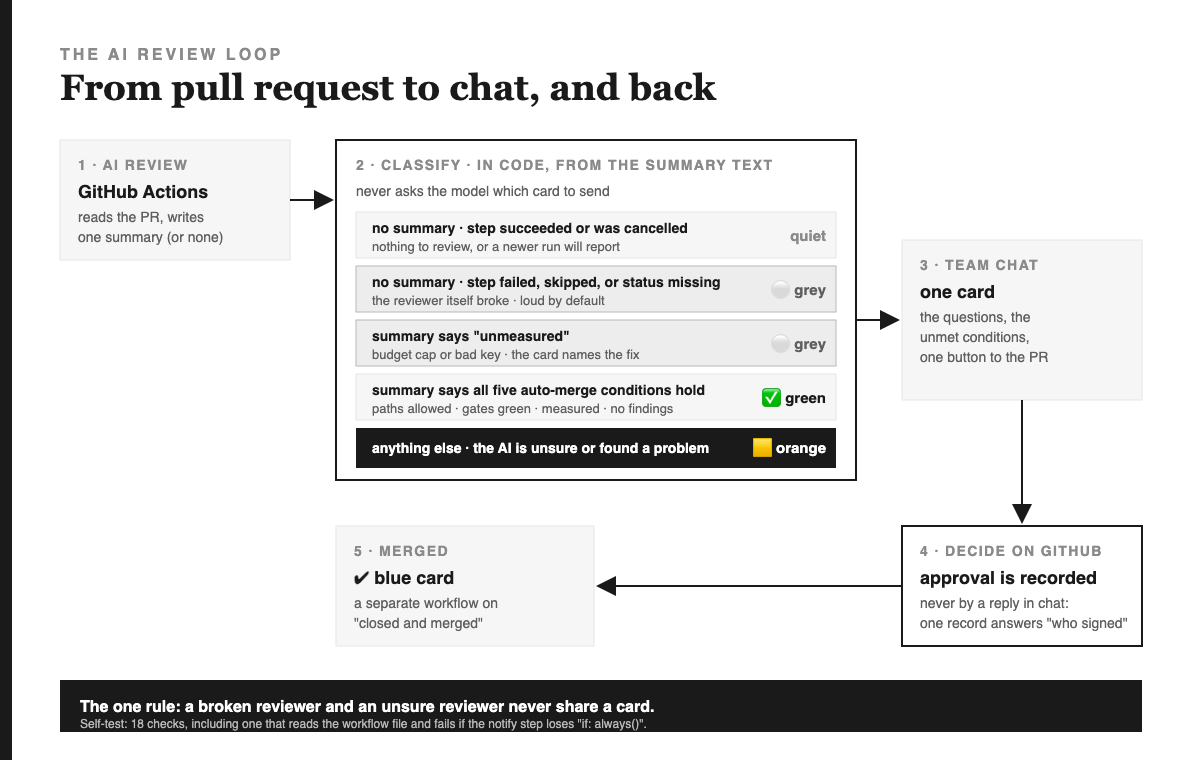
Los tipos de notificación, y qué decide cada uno:
| Notificación | Se activa cuando | Qué hace la persona |
|---|---|---|
| 🟨 Necesita tu decisión | El revisor funcionó y el cambio no calificó para auto-fusión: fuera de las rutas permitidas, una compuerta roja, un hallazgo, o una pregunta que solo un humano puede responder. | Lee las preguntas (en las revisiones medidas hasta ahora, 2.3 por pull request en promedio, n=7), presiona el botón y decide en GitHub. |
| ⚪ El revisor no funcionó | El resumen dice "unmeasured" (presupuesto, clave inválida), o no hay resumen y el paso de revisión no reportó éxito. | Corrige el sistema. La notificación nombra la causa y la solución; indica en negritas que el pull request no es el problema. |
| ✅ Auto-fusión | Se cumplen las cinco condiciones de auto-fusión del el episodio del sobre retener. | Nada. Se puede desactivar con un solo ajuste. |
| ✔ Fusionado | La pull request se cierra como fusionada. | Nada. El ciclo queda cerrado. |
| (sin notificación) | No había nada que revisar, o un push más reciente canceló la ejecución. | Nada, y ese silencio es una decisión explícita, con una brecha conocida que se menciona más abajo. |
La primera ejecución de extremo a extremo, 2026-09-24: una vez que se aumentó el límite de la organización, el revisor corrió sobre una pull request real, levantó tres advertencias y dos preguntas para un humano, y el chat del equipo recibió una notificación naranja con sus preguntas; después de los arreglos, el merge produjo una notificación azul. Cada paso se vio funcionando en una pull request real, no solo en una prueba.
Parte I · Informe — seis decisiones de diseño y la razón de cada una
| # | Decisión | Alternativa rechazada | Por qué |
|---|---|---|---|
| 1 | Un revisor que falla recibe su propia notificación. Gris, titulada "no se ejecutó", con la causa y la solución. | Una sola notificación de "necesita un humano" para todo lo que no sea auto-fusionado. | Los dos estados requieren personas y acciones distintas. Mezclarlos es la razón por la que 45 fallos del sistema parecieron 45 preguntas de revisión. Si el ciclo hubiera salido con un solo tipo de notificación, habría hecho ping en el 100% de las pull requests el primer día y habría sido silenciado al segundo. |
| 2 | El tipo de notificación se decide por el texto del resumen, en código. | Preguntar al modelo qué notificación enviar. | El router no debe depender de lo que está redirigiendo. Un revisor sin presupuesto no puede ser consultado sobre si está sin presupuesto. |
| 3 | La aprobación se mantiene en GitHub. El botón de la notificación lleva al humano allí. | Aprobar respondiendo en el chat, a través de una app de la plataforma de chat con un servidor de callback. | Este es un sistema de evidencia de calidad: en una auditoría, "quién aprobó este cambio y cuándo" debe poder responderse a partir de un único registro. Una respuesta en el chat es un segundo registro que puede contradecir al primero. Además, requiere una app, un servidor y una credencial que mantener. |
| 4 | Cuando no tengas claro el estado del revisor, haz sonar la alarma. Solo un "success" explícito sin resumen permanece en silencio. | Permanece en silencio salvo que el paso haya fallado de forma explícita. | Un estado ausente o corrupto es justo lo que produce una configuración rota. El valor predeterminado debe ser el ruidoso. La única excepción: una ejecución cancelada por un push más reciente permanece en silencio porque la nueva ejecución reportará. Su costo está explicado más abajo. |
| 5 | Reemplaza el objetivo del 5–10% por dos cifras que el propio repositorio calcule. | Mantén "escalar solo el 5–10%" y amplía lo que el auto-merge puede abarcar hasta que se alcance. | Medido: el 24% de los cambios recientes fusionados podrían llegar a calificar, por razones correctas (Parte I, el techo). Perseguir el 90% significa sacrificar la cadena de evidencia por velocidad. Los números de reemplazo son la tasa de auto-merge de Nivel 1 y la carga humana por revisión. |
| 6 | El revisor recibe su propio presupuesto. Hecho el 2026-09-24: una nueva clave en un workspace separado, así su gasto es visible en su propia línea; el límite de la organización también se subió de $100 a $200. | Mantén una sola clave para todo; sube el límite cuando se acabe. | Un presupuesto compartido significa que el trabajo menos importante puede dejar sin recursos al más importante. El matiz honesto: el límite de la organización sigue por encima de cada workspace, así que el aislamiento es parcial (la sección de lecciones cuenta en qué me equivoqué con esto). |
Una séptima decisión es una negativa: el loop no decide nada. Solo transporta decisiones. El revisor sugiere, el archivo de reglas decide qué puede auto-fusionarse, y una persona decide todo lo demás. Ese es el diseño de la Visionboard aplicado a un equipo: los agentes proponen y reportan, y la persona queda por encima del loop. En el episodio de equipo pequeño, el campo solo-humano se volvió un rol con separación de funciones. Aquí el rol es "code owner", y la notificación es cómo se le consulta.
Parte I · Reporte — el techo del 24%: hasta dónde puede llegar realmente el auto-merge
Un loop que redirige decisiones más rápido no te dice cuántas decisiones debe tomar una persona. Así que la segunda medición hizo otra pregunta: de los últimos 60 pull requests fusionados, ¿cuántos tocaron únicamente archivos permitidos por las reglas de auto-merge, como docs, planes, tests y casos de prueba dorados? Ese es el techo. Ningún revisor, por bueno que sea, puede auto-fusionar un cambio que las reglas excluyen. Uno de los 60 tenía exactamente 100 archivos, el máximo que GitHub devuelve por pull request, así que su lista puede estar cortada; se cuenta como no medido, lo que deja 59.
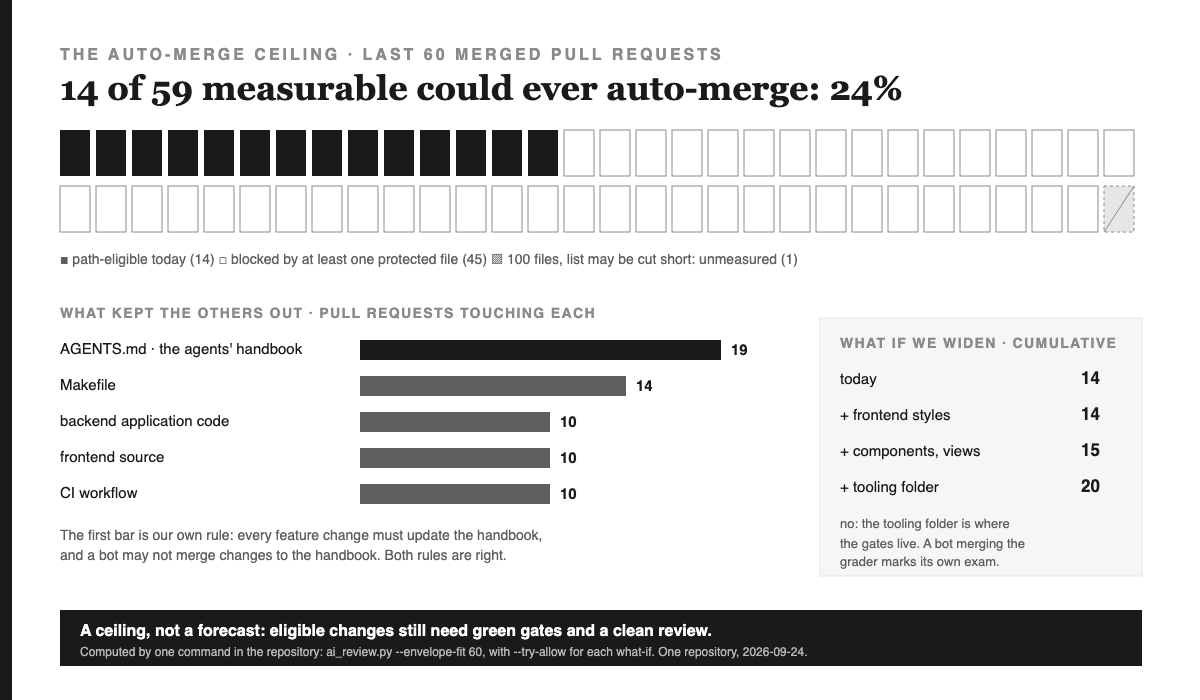
Elegibles por ruta para auto-merge: 14 de los 59 pull requests medibles entre los últimos 60 fusionados (24%). Sumando estilos, componentes y vistas de frontend: 15. Sumando la carpeta de tooling: 20. Alcance: un repositorio, medido el 2026-09-24; es un techo, no una predicción, porque los cambios elegibles igual necesitan puertas verdes y una revisión limpia. [MEDIDO]
El mayor bloqueo fue una sorpresa, y es nuestro.Diecinueve de ellas tocaron AGENTS.md, el manual que leen los agentes de código antes de trabajar. El repositorio tiene una regla: cada cambio de funcionalidad debe actualizar ese manual, para que ni humanos ni agentes lean instrucciones desactualizadas. Y las reglas de auto-fusión prohíben correctamente que un bot fusione cambios al manual, porque modificarlo cambia el comportamiento de todos los agentes. Si unes ambas reglas, cualquier cambio de funcionalidad requiere intervención humana, por diseño. Los robots deben actualizar su manual, pero no pueden aprobar actualizaciones a su propio manual. Ambas reglas son correctas. El objetivo era el equivocado.
Ampliar el frontend habría sumado un pull request, porque los cambios reales de frontend suelen tocar también archivos protegidos. Ampliar la carpeta de tooling (los “qué pasaría si” son acumulativos) suma cinco más, y esa carpeta es donde viven las compuertas y el propio revisor: dejar que un bot fusione un cambio al evaluador es dejar que el cocinero califique su propio plato. Así que la propuesta para la próxima decisión del equipo es mantener las reglas como están, cambiar el objetivo y hacer un piloto de dos semanas. Hay una compuerta más que no es de software: GitHub rechaza la protección de ramas en este repositorio, respondiendo "Upgrade to GitHub Pro", así que el bot puede aprobar pero no fusionar. Hasta que eso cambie, la tasa de auto-fusión es cero por construcción, que es la misma puerta que el episodio del sobre encontró cerrada.
Corrección, 2026-09-25. Este informe primero dijo que la puerta requería un plan mensual de $4. El propietario ya tenía ese plan. Todos los demás repositorios privados en la misma cuenta aceptaban protección de ramas; este es un fork privado de un repositorio más antiguo, y un fork hereda esas funciones de su red upstream, no de su propietario. El mensaje de error sugería una solución que ya se había aplicado. La solución real es desvincular el fork. Es la misma lección que el resto de este informe, un nivel más abajo: leí el estado en el mensaje en vez de medirlo, y la medición tomó un puñado de llamadas a la API.
Parte II · Reflexión — lo que el revisor detectó al revisar sus propias correcciones
Las correcciones al loop fueron en sí mismas pull requests, así que el revisor, recién resucitado, pasó su primera tarde calificando el código que lo revivió. Corrió diez veces sobre cuatro de mis pull requests. Pidió más trabajo cinco veces y aprobó cinco, y en cada ronda, incluso en las aprobaciones, señaló algo real. Aquí están los hallazgos en orden, porque el orden es la lección.
| # | Lo que detectó | Tipo de error |
|---|---|---|
| 0 | Mi propio script envió una notificación falsa de "necesita tu decisión" para un pull request que no tenía nada que revisar. Yo mismo la detecté, desde el chat, el primer día en vivo del revisor. | Un resultado vacío tratado como hallazgo. |
| 1 | Mi corrección omitía la notificación cuando el resumen no tenía la cadena marcador. Si algún día se renombraba la plantilla, todas las notificaciones desaparecerían en silencio. | Basado en un detalle incidental en vez de la condición real (vacío). |
| 2 | Mi nueva prueba verificaba la última notificación enviada, no que se hubiera enviado una nueva. Una rama rota podía pasar leyendo la notificación de la prueba anterior. | Una prueba que no podía fallar. Corregida y probada por mutación. |
| 3 | Se había añadido una bandera solo para pruebas a la línea de comandos de producción, y "sin resumen" tenía dos causas (nada que revisar, o el revisor se cayó) que tomaban el mismo camino silencioso. | Andamiaje de pruebas en el producto; dos estados, un solo camino de código. |
| 4 | Toda la alarma de crash dependía de una línea en un archivo de workflow fuera del diff, que ninguna prueba leía. | Una garantía viviendo fuera de su prueba. Ahora una verificación lee el archivo y falla si la línea desaparece. |
| 5 | La salida de grep que pegué como evidencia tenía una línea menos. | Había recortado la evidencia. El revisor notó que la salida no coincidía con el archivo. |
| 6 | Mi medición del techo leía la lista de archivos por pull request de GitHub, que se detiene en 100 archivos, así que un cambio enorme podía parecer elegible. Y mi nueva métrica de "preguntas por revisión" no tenía ninguna prueba que pudiera fallar. | Un número que solo podía equivocarse a mi favor. |
Mi hallazgo favorito no fue del revisor, y solo lo descubrí porque una prueba nueva falló. Cuando el script del revisor se cae, la notificación de alarma explica el motivo con palabras que yo mismo escribí: "the script itself failed; this is not a budget or 401 problem" (Traducción: el propio script falló; esto no es un problema de presupuesto ni de 401). El texto explicativo de la notificación busca "401" para reconocer una clave inválida. Encontró mi propio descargo y le dijo al lector que rotara la clave. La alarma se autodiagnosticó a partir de la frase que decía lo que no era. La solución fue reescribir el descargo; la lección fue que había creado un detector de palabras clave y luego le di esas mismas palabras clave.
La sexta captura tiene una segunda parte de la que no me enorgullezco. El revisor la marcó como "hold" en la última actualización de la propuesta, el chat recibió una notificación naranja y yo fusioné igual, porque las pruebas estaban en verde y no abrí la notificación. El ciclo funcionó de punta a punta; el humano al final no leyó. La solución fue un pull request de seguimiento, el techo subió de 23% a 24% cuando se apartó el cambio truncado, y ahora el registro de implementación del repositorio lleva la regla que rompí: antes de fusionar, lee tanto el resultado de las pruebas como el último veredicto del revisor, y anota por qué si decides ignorar un "hold".
La quinta captura es la que yo habría pasado por alto y que un colega quizá ni habría mencionado. El pull request decía "aquí está la salida de grep, la línea existe". Yo había recortado la salida de grep, y el revisor, leyendo el contexto del diff, contó una coincidencia más de las que mostré. Entonces marcó la afirmación como "unverified" en vez de discutirla. Esa es la regla del primer informe: ninguna afirmación sin evidencia, aplicada al propio autor.
Parte II · Reflexión — lecciones aprendidas
- "Nunca en silencio" es necesario, pero no suficiente. Un estado tiene que llegar a un oído. El revisor cumplió la regla en 45 pull requests y no ayudó a nadie. La prueba de cualquier alarma no es "¿se publicó?" sino "¿quién la leyó en menos de un día?". Esta es la segunda apuesta de Visionboard, "a sensor that cannot be silent" (Traducción: un sensor que no puede quedarse en silencio), con una cláusula más fuerte: un sensor tampoco puede ser ignorado.
- Mide el denominador antes de discutir la proporción. Pasamos parte de una reunión diseñando para una escalada del 5–10%. El número real fue 100%, y 45 de esos ni siquiera eran escaladas, sino un sensor roto. Pon los casos de "no midió" en su propio grupo antes de calcular cualquier tasa; cuando el grupo es todo, la tasa es "no medido", no 0% ni 100%.
- Un presupuesto compartido deja que el trabajo menos importante deje sin recursos al más importante. El revisor compartía presupuesto con un trabajo por lotes de traducción y todos los demás proyectos en la máquina, y fue el que se quedó sin recursos; la consola no podía decir qué trabajo gastó el mes, porque todo el gasto caía en una sola clave antigua que usaban todos. Dale al camino crítico su propio presupuesto y rastrea el gasto por trabajo, no por clave.
- La compuerta que escribes para otros te evaluará a ti. Diez rondas de revisión sobre mis propias correcciones, cinco solicitudes de más trabajo, y la que ignoré era correcta. El día que volvió el revisor, el autor al que más revisó fue quien lo construyó. Esa es la mejor evidencia hasta ahora de que vale más o menos $0.25 por revisión (estimado: la columna de costos de la clave marcaba $1.96 tras unas ocho revisiones).
- Entrega resultados, no rutas de navegación. El agente que hizo este build para mí me mandó por la consola de facturación cuatro veces: "Settings, luego Limits", "Rate limits", "cambia de workspace, luego Billing". El último destino no existe. El propio centro de ayuda del proveedor dice "The default Workspace is not editable and cannot be removed." (Traducción: El Workspace predeterminado no se puede editar ni eliminar.) [5] Yo fui el ejecutor de un plan que el planificador no había comprobado. La regla que se escribió después: verifica el destino antes de pedirle a un humano que vaya, entrega un solo enlace y una sola acción, y si un paso no se puede verificar y no es esencial, elimínalo y entrega el resultado sin involucrar al humano. La lección humana es igual: cuando delegas hacia arriba, la persona por encima de ti debe recibir el plato servido, no una receta y un mapa de la despensa.
Patrones, anti-patrones y el mecanismo
- Patrón: dos tonos para dos fallos. "El juez no está seguro" y "el juez está ausente" van a notificaciones, colores y personas diferentes.
- Patrón: el router es tonto a propósito. Clasificación determinista a partir del texto que escribió el sistema, nunca de la opinión del modelo sobre sí mismo.
- Patrón: ruidoso por defecto. El silencio es una decisión explícita y registrada caso por caso; cualquier situación no listada activa la alarma.
- Antipatrón: el fallo verde. Un trabajo al que se le permite fallar sin bloquear muestra verde mientras no hace nada. Permitir que no bloquee las fusiones está bien; dejar que eso también lo vuelva invisible es el verdadero error.
- Antipatrón: una meta sin techo. Un objetivo de proporción fijado antes de medir lo que permiten las reglas.
- Mecanismo: jidoka. Toyota lo describe como la capacidad, cuando ocurre una anomalía, de "the machine or equipment can detect the abnormality and stop automatically, or the operator can stop the line by pulling the stop cord themselves" (Traducción: la máquina o el equipo puede detectar la anomalía y detenerse automáticamente, o el operador puede detener la línea tirando él mismo del cordón de paro) [1]. En la cocina, el cordón es la nota del sous-chef y el tablero es la campana: tirar del cordón solo sirve si suena donde está el chef. La notificación de chat es esa campana.
- Primer principio, en una frase: una verificación solo es tan real como el camino más corto desde su fallo hasta una persona que pueda actuar.
Parte III · Proyecto — los próximos pasos, grandes y pequeños, a corto y largo plazo
Cada movimiento está vinculado a una apuesta de Visionboard o a una puerta ANDON, y cada uno lleva la observación que lo refutaría, con fecha, al estilo de el episodio del marcador. La fecha de falsificación de la segunda apuesta de Visionboard, el sensor silencioso, es 2026-10-07; los dos primeros movimientos reportan contra ella.
| Corto plazo (este mes) | Largo plazo (este trimestre) | |
|---|---|---|
| Pequeño | S1 · Lecturas semanales en la reunión del equipo. Cada lunes, el repositorio muestra la tasa de escalamiento, el techo de auto-fusión y la carga humana por revisión. Falla si: para el 2026-10-07 se activa una notificación gris y nadie en el equipo puede explicar qué significaba; en ese caso, el problema está en las palabras de la notificación. S2 · Cerrar la brecha identificada. Hoy, cualquier revisión cancelada es silenciosa, incluyendo las canceladas por timeout o manualmente, donde no habrá un nuevo intento que reporte. Falla si: se encuentra en el registro una revisión cancelada y nunca reintentada; ese es el día en que la excepción se vuelve demasiado amplia. | S3 · La calibración del revisor. Por cada pull request que el revisor aprobó, cuenta los reverts y bugs rastreados hasta ahí; por cada uno que detuvo, cuenta cuántos un humano fusionó sin cambios. Esta es la pregunta de calibración que le hacemos a nuestro propio juez. Falla si: para el 2026-12-31, o después de 50 pull requests revisados si eso ocurre antes, sus veredictos de "merge" y "hold" predicen reverts igual de mal que el azar; entonces el revisor es solo un formateador y debería costar como tal. |
| Grande | B1 · Abrir la puerta, una vez. Desvincula el fork de su red upstream, aplica protección de rama y ejecuta el piloto de dos semanas con las reglas sin cambios. El éxito son al menos tres auto-fusiones reales, cero reverts y como máximo tres preguntas humanas por pull request revisado. Falla si: para el 2026-10-31, o dos semanas después de abrir la puerta si eso ocurre después, menos de tres cambios califican; entonces el techo es menor al medido y el equipo debería decir claramente que este repositorio es revisado por humanos, y dejar de fingir lo contrario. | B2 · El review loop se convierte en un sensor de Visionboard. La tasa de escalamiento y la tasa de auto-fusión alimentan la pista de ingeniería del tablero como un indicador, y "reviewer did not run for 24 hours" se vuelve un disparador nombrado, no solo una notificación. Este es el segundo futuro del scoreboard hecho concreto, y el primer paso hacia su tercer futuro, el doble loop, que pregunta si una decisión firmada predice movimiento (ver el episodio del scoreboard). Falla si: para el 2026-12-01 el tablero muestra el indicador y las decisiones del equipo sobre el review loop se tomaron sin mirarlo. |
Lo que deliberadamente no hago: aprobar desde el chat, ampliar las reglas de auto-fusión antes del piloto, ni construir un segundo revisor para revisar al primero. Todas son ideas interesantes. Ninguna cierra un ciclo que hoy sigue abierto.
Constrúyelo en 30 minutos: el contrato del review-loop
El contrato, no el código. Treinta minutos es el tiempo que este contrato asigna para que un lector lo copie en un repositorio que ya tiene un revisor de IA publicando un resumen; no es un tiempo que yo haya medido.
| Elemento | Especificación |
|---|---|
| Entradas | El archivo de resumen del revisor (posiblemente vacío), el resultado del paso de revisión (success, failure, cancelled, skipped, o ausente), el número del pull request, una URL de webhook para notificaciones en chat. |
| Salida | Cero o una notificación en chat: título, color, cuerpo y un botón que lleva al pull request. Además, una línea en el resumen del trabajo de CI indicando qué se envió o por qué no se envió nada. |
| Clasificador | Resumen vacío y resultado en {success, cancelled}: nada. Resumen vacío en cualquier otro caso: gris, "reviewer did not run", causa sintetizada. Si el resumen contiene la sección "unmeasured": gris, causa traducida a su solución. Si el resumen indica que califica para auto-fusión: verde. En cualquier otro caso: naranja, con las preguntas para una persona y cada condición no cumplida. |
| Invariante | Una notificación gris y una naranja nunca son la misma. La aprobación nunca ocurre en el chat. |
| Cableado | El paso de notificación corre con if: always(), que GitHub documenta así: "Causes the step to always execute, and returns true, even when canceled." (Traducción: Hace que el paso siempre se ejecute y devuelve true, incluso cuando se cancela.) [2] Pasa el resultado entre comillas, para que un valor vacío siga siendo un argumento. Un flujo de trabajo aparte en pull_request: closed con merged == true envía la notificación de merge. |
| Webhook faltante | Exit 0 en CI y escribe "chat not notified, here is how to get a webhook" en el resumen del trabajo. Nunca hagas fallar el pull request por una notificación. |
| Pruebas que deben poder fallar | Un resumen vacío no envía nada; un fallo envía exactamente una tarjeta gris; la ausencia de resultado activa la alarma; una ejecución cancelada permanece en silencio; una firma incorrecta es rechazada; una prueba lee el archivo de workflow y falla si if: always() es eliminado. Modifica cada rama una vez y observa cómo su prueba falla. |
| Dos mediciones | La división de escalamiento (auto / escalado / no ejecutado) a partir de las etiquetas junto con el texto del resumen; el techo de auto-fusión (proporción de cambios fusionados recientemente en los que todos los archivos están permitidos). |
| Omisiones deliberadas | Aprobar desde el chat, eliminar notificaciones repetidas, redirigir por persona y cualquier uso del modelo para clasificar. |
La misma historia, cinco salidas
| Lector | La decisión que informa este informe | Una acción para esta semana |
|---|---|---|
| Estudiante | Si una regla "segura" (nunca mentir, decir no medido) es suficiente sin una vía de entrega. | Identifica una alarma en tu vida (una luz de batería baja, un detector de humo) y pregúntate quién la escucha y con qué rapidez. |
| Ingeniero | Si el estado "no se ejecutó" de tu revisor de IA realmente llega a alguien. | Cuenta cuántas veces tu revisor ejecutó en los últimos 30 días sin producir un veredicto real. |
| Fundador | Qué proporción de cambios puede realmente saltarse la revisión humana en tu base de código. | Calcula el techo en tus últimos 60 cambios fusionados antes de fijar cualquier meta de automatización. |
| Ejecutivo | Si los presupuestos de revisión de IA están aislados de los trabajos por lotes. | Pregunta qué trabajo gastó el presupuesto de IA del mes pasado, por clave, y si el revisor tiene su propio límite. |
| Inversionista | Si la afirmación de "90% automatizado" de un equipo tiene detrás un techo medido. | Pregunta por el denominador y la proporción de ejecuciones que no midieron. |
Misión de realidad
Elige una verificación automatizada en la que tu equipo confíe. Rompe su entrada a propósito esta noche—una clave inválida o un archivo vacío—y observa dónde aparece la falla mañana por la mañana, y quién la detecta primero. Si la respuesta es "en una página que nadie abre" o "nadie", tienes justo el problema que aborda este informe, y la tarjeta gris es una solución de 30 minutos.
Lee también
Parte de la Serie AI-Native · Ingeniería de agentes. Las cifras están acotadas donde aparecen y provienen de los propios comandos de medición de un repositorio privado el 23 y 24 de septiembre de 2026; el costo por revisión es mi estimación a partir de la columna de costos por clave en la consola de facturación, no un promedio medido. La cocina es un modelo, no una medición.
Referencias
- Toyota Motor Corporation. Toyota Production System. global.toyota — el pasaje de jidoka citado arriba, cotejado palabra por palabra con la página el 24 de septiembre de 2026.
- GitHub Docs. Expressions: status check functions, always. docs.github.com — la definición citada, verificada con la fuente de la página el 24-09-2026.
- GitHub Docs. Control de la concurrencia de flujos de trabajo y jobs. docs.github.com —
cancel-in-progress, la razón por la que una revisión reemplazada se cancela y por qué ese caso permanece en silencio. - GitHub Docs. Acerca de las ramas protegidas. docs.github.com — reglas de protección de ramas; en este repositorio, un fork privado, la API respondió "Upgrade to GitHub Pro" aunque el propietario ya tenía cuenta Pro.
- Anthropic Help Center. Creating and managing Workspaces in the Claude Console. support.claude.com — la nota citada sobre el workspace predeterminado, verificada contra la página el 24-09-2026.
- Anthropic. Workspaces (documentación de la plataforma Claude). platform.claude.com — descrito, no citado: cada organización cuenta con un workspace predeterminado; los límites de gasto se establecen por workspace adicional, bajo el límite general de la organización.
- Feishu Open Platform. Guía de uso de bots personalizados. open.feishu.cn — el webhook al que se envían las notificaciones; descrito, no citado.