AI 原生系列 · Harness 工程
Silence Is Not a Status
一分钟读完
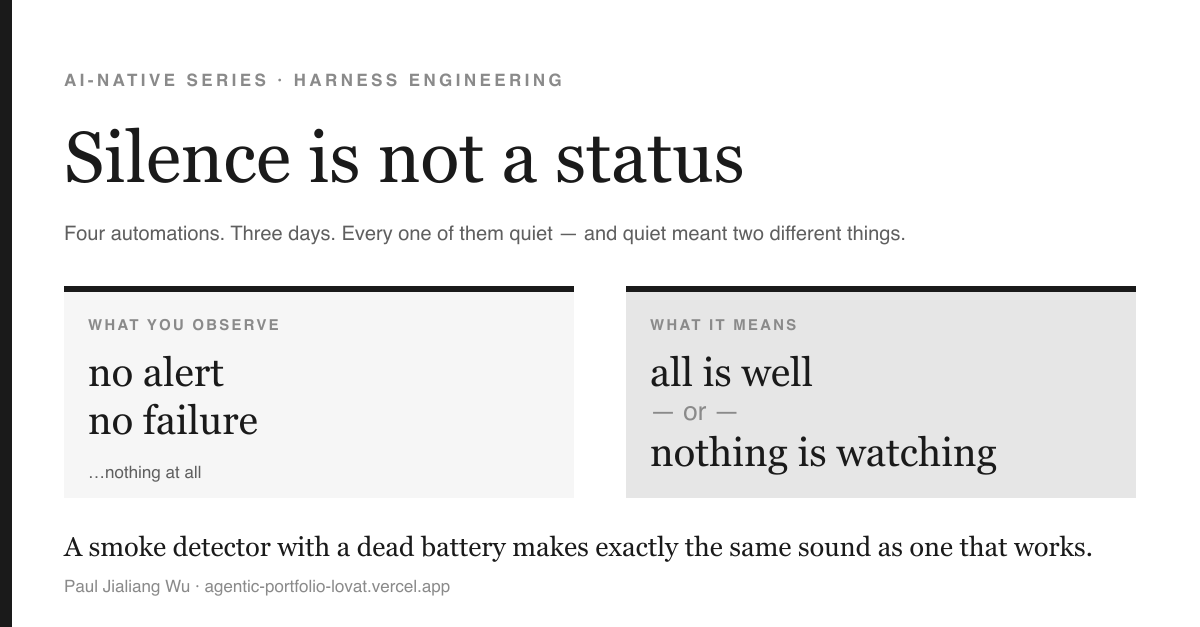
三天里,我发现四个自动化任务都悄无声息。「安静」,既是健康系统的样子,也是失效系统的样子。一个仪表盘是空的,因为唯一能填充它的命令从未被运行过。一个每周任务显示绿色,因为一次手动点击,掩盖了一个失败的定时任务。三个已合并的 pull request 并没有真正上线,因为部署配额早已悄悄停止构建。而我专门写来抓这最后一种问题的检查程序,打印出「skipping」,然后以 success 退出。修复方法不是「保持警惕」。电池没电的烟雾报警器,发出的声音和正常工作的一模一样,所以你要做的,是让「正常工作」这个状态变得noisy(吵闹)——发出一声代表「我还活着」的蜂鸣,这样一来,沉默就只能意味着「坏了」。监控团队十年前就已经用一个名字把这套方案实现并交付了,叫dead man's switch;几乎 没人把它用在自己的 agent harness 上。
一周,一个数字
四个。三天里,在一个我拥有并痴迷般审计着的代码库中,我发现了四个 各自独立的自动化流程,早已不再干活,却没告诉任何人。它们没有一个抛出 错误,没有一个让仪表盘变红。按照我搭建的每一个监控信号来看, 它们看起来都像是运行得完美无缺的系统。
我想把这份难堪说得精确一点,因为教训就藏在其中。我说的不是 接手来的遗留系统。这四个都是我自己写的。其中两个就是那一周刚上线的, 还有一个正是我专门写来抓这类 bug 的工具。
心智模型:电池死去的那一刻,你永远听不见
一个电池没电的烟雾报警器,发出的声音和正常工作的烟雾报警器一模一样: 都是沉默。没有蜂鸣声,不代表你家很安全,它什么也证明不了 ——什么都证明不了——在这两种世界里,观测到的现象完全相同。
这就是全部的核心思想。如果你只想从这篇文章里记住一件事,那就记住这句:沉默 不是一种状态。它是状态的缺失,而你的大脑会很「贴心」地 用你偏好的解读把这个空白填满。你拥有的每一个自动化流程都有两种从外部看 一模一样的状态——正在运行、且什么都没发现,以及根本没在运行——除非你专门做过工作把这两者区分开来,否则你根本无法判断自己 究竟处在哪一种状态里。
这件事之所以难,不是技术问题,而是「什么都没发生」这种感觉本身就像是一种信息。 它不是。
我究竟发现了什么
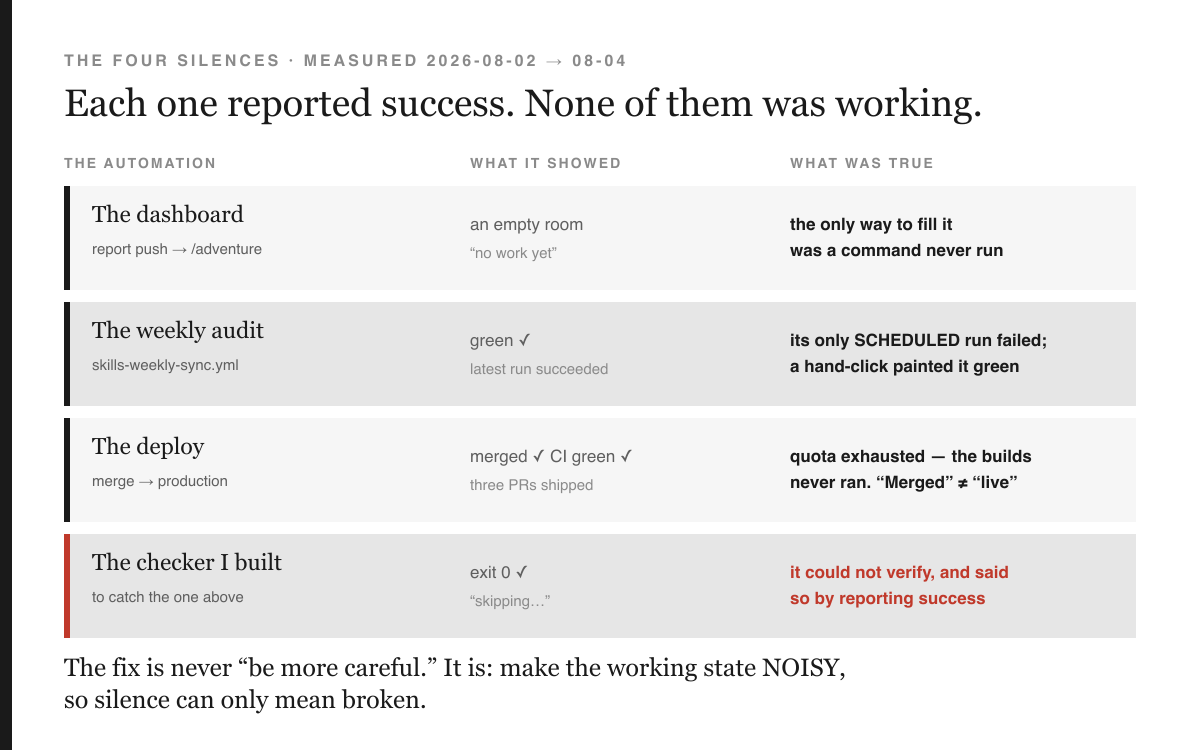
第一个:一个结构性地永远填不满的仪表盘。 我搭建了一个私有的
成绩单仪表盘,让它接收由一条 CLI 命令推送过来的数据。这条命令需要一个
密钥令牌。这个令牌被存成了 Vercel 的一个Sensitive环境变量,这意味着
它无法被读回——vercel env pull对它返回的是一个空字符串。所以这次推送
只能靠人手动执行,而且只有知道密码的那一个人能做,而在这个功能存在的
那几周里,它被执行了零次。房间被锁着,且空无一物。空,和坏,是没法区分的——三次汇报里,我都对合作者说这只是他手头一分钟的小事,而不是把一个我自己造成的阻塞,当作真正的 bug 来对待。
第二个:一个从未真正跑过的每周任务。 我查了仓库里每一个 cron 定时工作流的运行历史。每晚一次的那个确实健康:五次计划运行,五次成功。两个每周一次的却不是。其中一个历史上只有一次计划运行,而那次运行失败了;之后手动重跑成功了,于是每一处汇总视图——工作流列表、那个绿色小勾、徽章——都把这个工作流报告为「通过」。另一个在它整个生命周期里只跑过三次,全部是人手动点按钮触发的。
这是四个里最微妙的一个,值得细细体会:手动运行,恰恰就是这套节奏本该替代的东西,而它同时也正是让一套已经失灵的节奏看起来一切正常的原因。 自动化并没有在自动运行。正是那个手动干活的人,让没人注意到自动化早已停摆。
第三个:合并了,不代表上线了。 三个 pull request 合并了,CI 三个全绿,线上网站却持续数小时仍在提供旧版本。托管服务的免费套餐把生产环境部署次数限制在每天 100 次(Vercel, n.d.)。超过这个数,合并照样成功,检查照样通过,但什么都不会部署。哪里都没有红色。「已合并」这个词,已经悄悄不再等同于「已上线」,而我所有的习惯,都建立在这两个词是同义词这个假设之上。
第四个:那个明明无法判断,却报告成功的检查器。 发现第三个问题之后,我写了一道防线:把实际正在对外提供服务的 commit SHA 发布出来,拿它和origin/main做比对,不一致就失败。听起来不错。可我一运行它,它打印出了· the
deployment reports no commit SHA — skipping,然后以退出码 0 结束。
我造了一个用来抓「静默失败」的检测器,而它自己失败的方式,恰恰就是静默失败。它没法判断答案,于是就报告了那个让人安心的答案。在一条全绿的流水线里,“I could not check”(中译:我没法检查)和“I checked and it is fine”(中译:我检查过了,没问题),呈现出来是同一个勾。
为什么没人发现:那次把一切涂成绿色的手动运行
这四个问题里,有三个共享同一种机制,值得点名,因为它同样潜伏在你的系统里。每一次,都是人类的操作产生了与自动化动作相同的可观察信号——而所有人能看到的,也就只有这个可观察信号。
有人点了一下「run workflow」,徽章就变绿了。有人本可以手动跑一下那条推送命令,仪表盘就会被填满。有人看到「已合并」,就顺理成章推断出「已上线」。手动路径和自动路径最终汇聚到同一个指示器上,而这个指示器根本没法告诉你究竟是哪条路径产生的结果。自动化在悄悄失灵,人在悄悄补位,仪表盘的颜色却从未变过。
这个问题业界早就解决了,只是我没读过自己这个领域的文献
这一切都不新鲜。监控团队在 2010 年代就撞上过这个问题,并给出了一个具体、朴实却极其好用的答案。
Google 的《Site Reliability Engineering》一书中由 Rob Ewaschuk 撰写的监控章节,坚持了一条并不炫目的原则:“Rules that generate alerts for humans should be simple to understand and represent a clear failure”(中译:面向人类的告警规则,必须简单易懂,并且代表一次明确的失败)(Ewaschuk, 2016)。他给出的理由是信噪比与稳健性——报警路径必须简单,因为这是你输不起的那一条。我想再补一句:这也是唯一一条你没法用自己的告警系统去调试的路径。不过说老实话,那一章能给你的,也止步于此:关于「静默的歧义」,书里一字未提。我查过了。下面的答案,不是 Google 给的。
而真正正面回答「静默的歧义」这个问题的模式,是watchdog(看门狗),PromLabs 把它描述为:“a watchdog alert (also sometimes called a ‘dead man’s switch’, sentinel alert, beacon alert, or heartbeat alert) that helps you continuously test your entire alerting pipeline from beginning to end”(中译:一种看门狗告警——有时也被称为「死人开关」、哨兵告警、信标告警,或心跳告警——它能帮你持续地端到端测试整条告警链路)(PromLabs, n.d.)。这个机制是一次漂亮的反转:你创建一条持续不断、永远在触发的告警,只要一切健康它就一直响,然后把它接到你整套系统之外的某个服务上。用 PromLabs 的话说:「当你的告警链路中任何一环出了问题,外部服务就会注意到告警通知不再进来,然后就会给你发一条通知,告诉你这件事。」
带着烟雾报警器的例子,再读一遍。其他每一条告警,都是坏了才响。只有这一条,是没坏才响——于是静默本身变成了失败信号。你把一个含糊的观测,转换成了一个不含糊的观测,方法就是让健康状态变成那个「大声」的状态。
我搭建智能体 harness 已经好几个月了,却从未把这个我在生产集群里会脱口而出「这不是常识吗」的模式,用到自己的自动化上。我猜原因是,个人的 harness 感觉起来不像基础设施。它不过是几个 YAML 文件加一个 CLI。但一个你真正依赖的 cron 任务,确实是infrastructure(基础设施),它腐坏的方式和收费版一模一样。
第二个发现:我称错了绳子的重量
同一周,我的合作者提出了另一个改进意见:以现在前沿模型的能力,长长的 system prompt 已经从「权限」变成了「负担」——该精简了。
他说得对,而且有趣的是,我早就证明过这一点。几个月前,我做过一次三臂消融实验——完整 prompt、三行的极简 prompt、以及完全不给 prompt——横跨三个模型,在六个能力测试用例上按「满足断言的比例」做确定性打分(另有四个注入测试用例按通过/失败打分)。三臂的完整结果如下:
| prompt 版本 | Sonnet-5 | Opus-5 | Haiku-4.5(弱对照组) |
|---|---|---|---|
| 完整版(161 词) | 100.0% | 100.0% | 88.9% |
| 极简版(3 行) | 100.0% | 100.0% | 96.7% |
| 无(空) | 100.0% | 100.0% | 96.7% |
无论给不给 prompt,前沿模型都稳稳地打满 100%。弱对照组的分数有 prompt 反而比没有更差,而极简版和空版毫无区别。得出的结论很直白:这个 prompt 既不是在为能力买单,也不是在为安全买单——真正守住底线的是 harness 本身,因为工具层会拒绝非法操作,从一开始就没有危险工具可调用。
那么:同意、精简、了事?不行。因为我消融的对象,只是挂在某一个功能上、881 字节的 prompt。真正在每一次会话都会加载的,是 skill 文件——那个告诉 agent「这个工具能做什么」的路由器。这个我从没测过。
结果它有23,016 字节,约 5,750 个 token,是我仔细消融过的那个 prompt 的二十六倍。而且它在十一天里从 16,704 字节涨到了 23,016 字节——增长 38%,一次都没削减过,其中大约 1,700 字节还是我当天刚加进去的。
眼下的实践让这层对比比我预想的更刺眼。在一篇分析 Agent Skills 惯例的文章里,Aurimas Griciūnas 指出,“the median discovery cost is ~80 tokens per skill” while “body size ranges from ~275 tokens (internal-comms) to ~8,000 tokens (skill-creator), with a median around 2,000”(中译:单个技能的中位发现成本约为 80 个 token;正文体量从约 275 个 token(internal-comms)到约 8,000 个 token(skill-creator)不等,中位数在 2,000 左右)(Griciūnas, 2026)。我这个是中位数的 2.9 倍。同一篇文章还点出了代价:“As context grows, the model’s attention degrades and important information gets buried. Models reliably miss information placed in the middle of long contexts, a well-documented phenomenon called ‘lost-in-the-middle.’”(中译:随着上下文变长,模型的注意力会退化,重要信息被淹没。模型稳定地会漏掉埋在长上下文中间位置的信息,这是一个有据可查的现象,称为「lost-in-the-middle」。)
关于我自己框架的一句老实话:如果你仔细读那份来源,它其实拆了我自己的台。 Griciūnas 描述的是一种三层架构,其中发现成本约为 80 个 token,而主体只在被激活时才加载——所以对大多数技能来说,一个臃肿的主体根本不构成每次会话都要付的成本。 但对这个技能来说,它恰恰是每次会话都要付的成本:它是在工作开始时,作为一个斜杠命令、按名字被调用的。激活就是这里的每一次会话。这让这个数字对我的场景是真实的,却推广不到你的场景——这个区别,我第一次写这段话时轻轻带过了。
接下来这部分让我笑出了声。那份技能文件的第 4 节标题叫 情境化操作手册(渐进式披露)。它长篇大论地解释:你不该携带用不上的上下文——然后紧接着把全部九份操作手册正文原样内联了进去,8,410 字节,占每次会话的 36%,不管任务对不对得上号。这份鼓吹渐进式披露的文档,成了这个仓库里对它自己教条最大的违反者。
我做了什么——以及为什么“精简”是错的解法
显而易见的做法是删掉一些字。我没有这么做,因为精简会重新长回来。我刚刚亲眼看着这份文件在十一天里膨胀了 38%,每次都是加一行看似合理的内容,每一行都振振有词。系统里没有任何机制,能在有人添加新的一行时,让这一行的代价当场显形。
所以我没有精简,而是把这份文件放上了秤。现在有一个测试钉死它的体积,任何超过实际体积 10% 的预算都会被拒绝(一个松松垮垮的预算只是摆设,算不上限制),文件一旦变大,构建就会失败。调高这个数字是允许的——但必须以一次 diff 的形式发生,写明理由,让审阅者看得见。 堆积问题不能靠意志力解决;你得让每一次“交易”本身,在发生的那一刻就摆到台面上。
结果一小时之内它就逮住了我。我加了一行,记录新的 satellite-sync 命令,超了 363 字节,构建立刻变红。按我自己定的规矩,我得为此“买单”,于是我把两处啰嗦的“此功能不存在”墓碑式说明压缩掉,又删掉一段历史性的题外话。这份文件有生以来第一次瘦身成功。然后我才做了真正该做的事——把全部九份操作手册正文挪进各自独立的文件,按触发条件加载,只在主文件里留一份索引:触发条件、一行摘要、路径。
22,833 → 17,681 字节。削减 22.6%,每次会话省回约 1,300 个 token,而且什么都没删:有一个配套测试会检查——如果索引指向一个不存在的文件,或者被抽取出去的正文缩水到某个下限以下,测试就会失败。靠丢掉来之不易的经验换来的 token 节省,算不上真正的胜利;正是这个测试,能在我疲惫的时候拦住我抄这种近路。
另一半:那些悄悄腐烂掉的指针
同一场审计也向外延伸。我的每个元仓库都把评分较高的外部项目集成为satellite:一个指针,加一个 SHA 锁定的摘要,从不 fork。很久以前写下的内部规矩是:“新鲜度靠测量说话,不是靠承诺。”
结果它成了一句空头承诺。131 个外部 satellite 中,76 个(58%)根本没有锁定 SHA,也就是说,从一开始,漂移就是无法被侦测到的。有一个仓库里 59 个全都没锁定,一个都没锁。接下来我检查了前 40 个有锁定值可核对的 satellite——漂移只有在有锁定值时才谈得上可测量——结果发现其中 18 个已经偏离了锁定的版本,包括整个合集据以创建的那个种子仓库本身;另外还有 15 个已经不再符合准入标准: 一个闲置了 111 天,一个 180 天,还有一个 468 天,而 恰好停在225颗星,准入门槛是500颗星,也没人记录过例外许可。
我对整个卫星仓库群的第一次计数其实也是错的,这一点我想如实留在这里。我一开始报告的是「178个卫星仓库,124个未锁定」,后来才注意到有三种不同的东西共用了同一个文件名
registry.yml:真正的外部卫星仓库、某个仓库自身的内部技能清单,以及
我自己组件的列表。其中两个仓库指向了它们自己。修正后的
数字是131个外部卫星仓库,其中55个已锁定,76个未锁定。
这两个数字对不上,减法算不出来,而这个出入本身就很说明问题。从178/124
变成131/76,少了47条记录,但未锁定的只少了48条——所以已锁定的总数反而多了一个。之
所以会多出一个,是因为第二遍排查同时修复了两件事,而不是一件:一是统计范围本身,二是判定标准——我原本把这次修正说成一次纯粹的删减,其实并不准确。我最早的脚本只有在条目携带一个字面命名为
head_sha 的键时,才把它算作已锁定。有一个卫星仓库把它的锁定记录
写成了pinned_sha,所以它其实一直都是锁定状态,却被我算成了一个漏洞。一个你从未试图证伪过的测量结果,不过是你喜欢的一个数字——
包括,事实证明,连修正后的那个数字也不例外。
模式与反模式
反模式:模棱两可的对勾。 一个把「已验证没问题」 和「无法检查」显示成同一个结果的指标。我这四次故障,每一次都有这么一个指标。
模式:让健康状态发出声响。 系统正常运行时发出心跳, 心跳消失才报警。这就是「dead man's switch」,也是唯一能把 沉默转化为信息的构造方式。
反模式:把人工手动执行也算作节奏在正常运转。 要核查触发 方式,而不只是结果。人去手动点按钮,恰恰就是你本来想要消除的那件事。
模式:绝不能让「我判断不了」以零退出码收场。 不确定不等于通过。如果一次检查 拿不到它需要的证据,它就必须大声地失败,并说明自己是哪部分证据拿不到。
反模式:用一次性清理来解决累积问题。 任何东西的一次性瘦身—— 提示词、配置、依赖列表、会议邀请——都会重新长回来,因为让它变大的那些力量 根本没被触及。应该给它设一个预算,让预算被突破时构建也随之失败。
模式:把「查不到」和「已经没了」分开对待。 我的卫星依赖检查器会在上游不可达时,直接短路跳过其余所有检测——因为一个 403 错误看起来会和零星标、零提交、零活动一模一样,也就是说,看起来就像一个该被删除的仓库。审计工具里最危险的 bug,就是对着缺失的数据自信地采取行动。
机制
上面这些故障全都是同一个形状。总有一条信号通道——一个徽章、一个仪表盘、一个退出码、一个像「merged」这样的词——而这条通道有一个默认值,是它在没有任何东西驱动它时发出的值。这个默认值几乎总是那个让人安心的值:绿色、零、空、安静。系统被设计成空闲时保持安静,而「因为健康而空闲」和「因为已死而空闲」,用的是同一种表示方式。
所以这个 bug 的机制不是疏忽,而是编码碰撞:世界的两种状态被压缩进同一个符号来传输,接收端根本无从解码发出的究竟是哪一种。更加小心,治不好编码碰撞;唯一的解法是多加一个比特。
第一性原理
任何一个可能「失败」却与「成功」呈现出同一种观测结果的监控,都不是监控;要让健康状态主动发出信号,这样「没有信号」才会变得毫无歧义。
我们现在在做什么,以及我们主动在做什么
复盘不值钱。下面才是真正改变了的东西,也是读者可以直接照搬的部分。
现在,已经上线的: 一个每周一次的全仓库审计,从六个维度给每个仓库打分,其中一个维度是定时任务的存活度——它会读取每个 cron 工作流的运行历史,要求存在一次触发方式为「定时」且结论为「成功」的运行记录。手动运行明确不计入。还有一个发布服务中提交版本号的部署端点,以及一个在无法验证时会以非零状态退出的检查器。一次针对「吞掉的错误」的静态扫描,在一个仓库里就找出了 43 处,我抽样检查的两处全都是真的问题:一份被损坏的账本被悄悄读成了「没有决策」,还有一次权限调用的失败,本会让凭证留在一个可读目录里。给 prompt 文件设置了大小预算。还有一个只会提议、绝不会自行执行删除的卫星依赖同步机制。
而主动这一侧,是我现在在上线任何自动化之前都会执行的规则:
1. 在新增一个定时任务之前,先核实你现有的那些还活着。 这是全篇里投入产出比最高的一项检查,我只花了四分钟。列出你所有的 cron 工作流,把它们的运行历史按 event == "schedule" 和 conclusion == "success" 过滤,然后看最近一次记录。我敢打赌你至少能找到一个从未真正触发过的。在你再添加一个新任务之前先做这件事,否则你就是在一块从未测试过的地基上继续盖楼。
2. 把调度时间错开整点。 定在 :00是每台调度器
在这个点上全体拥堵、开始丢任务的时刻。挑一个:20.
3. 把失败路由到人类已经会看的地方。 一个没人打开的标签页里的红色方块,只是拐了个弯的沉默。我们的做法是打开并更新同一个 issue——只有一个,原地更新, 因为每周新开一个 issue,只会训练你去无视 issue。
4. 让每一道闸门在无知时拒绝通过。 在我们的审计里,一个必须评估 却未被测量 的维度,失败方式和真正坏掉的维度一模一样。老实说,可扩展性这个维度我们今天测不了——所以它被标记为不可测量, 从评分中剔除,而不是给它凑一个假的替代指标。一道 因为没人看就通过的闸门,正是这一切要防止的假绿灯。
5. 只做棘轮,不做修剪。 无论你清理了什么,当天就把清理后的值 钉成测试里的预算,否则十一天后你又会回到原点。
6. 工具错了,就把这错误写在工具本身所在的地方。 我们的 playbook 现在带着一份自我验证(dogfooding)日志,记录着新审计工具第一次跑起来时自己犯的六个错误—— 那个把自己的测试夹具当成秘密标记出来的密钥扫描器,那个把 自己 标记出来的独立性检查——因为它自己的正则表达式里,恰好包含了它正在搜索的那些词。一个连自己的测试都能测挂的 检测器,是没人会信任的检测器;而一个能活下来的误报,正是一项检查最终被人关掉的原因。
就以这个诚实的边界收尾吧:以上所有内容现在都在持续监测中,没有一项已经完工。
更新,2026-08-04——这篇文章在发布一天之内就错了
原本这一段写的是:新的每周工作流还没有过一次计划内运行,第一次机会还要再等几天。它其实已经跑过了。 Cron 设定的时间是 周一 16:20 UTC;GitHub 实际在 18:05 运行,晚了将近一小时四十五分钟,而我用错误的方式去检查,得出了“根本没跑”的结论。所以正确的说法是:它确实跑了,而且失败了。
它失败有两个原因,而这两个原因,恰好都是这篇文章自己的论点反咬了文章自己一口。第一,它用来做棘轮比对的基准,
是在我笔记本电脑上生成的,以本地目录名作为键,而这项审计任务读取的却是 GitHub 上的仓库名——于是
AnyAgent 和 anyagent 被读成了两个
不同的项目,旗舰仓库看起来像是一个全新出现、在两个维度上都不达标的项目。
一个东西,两个名字。第二个原因更糟:向人类报告结果的那一步,传入了一个
--label根本不存在的标签,而我写的那段调用代码,恰好会忽略它自己的退出码。
于是审计照常运行,发现了十项回归,却谁也没告诉。这个专为侦测静默失败而生的任务,恰恰在它自己该出声的那一步,静默地失败了。
两处都已修复:仓库键名现在不区分大小写比较,基线改为从 CI 运行中重新生成,而不是来自我的笔记本电脑;上报环节去掉了那个标签,遇到非零退出码就会报错;后续新增一步会在流程通过之前,先确认那个 issue 确实存在。七十六个未锁定的卫星仓库现已全部锁定——七十四个已推送,另外两个因为该仓库没有远程地址,只能提交在本地。技能文件在我尚未拆分的地方,仍然是一整块。而这次更新正是重点所在:我发表了一个关于「沉默」的论断,结果自己就说错了,原因是没有去核实——这恰恰就是本文所讨论的那种失败模式。
我选择公布这个数字,而不是当初的本意,因为这一整周的教训归结起来就是:意图和沉默,从外面看,一模一样。
参考文献
- Ewaschuk, R. (2016). “Monitoring Distributed Systems.” In B. Beyer, C. Jones, J. Petoff & N. R. Murphy (Eds.), Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. sre.google/sre-book/monitoring-distributed-systems(访问于 2026 年 8 月 4 日)。
- PromLabs. (n.d.). “End-to-End Watchdog Alerts.” Monitoring and Debugging Prometheus. training.promlabs.com(访问于 2026 年 8 月 4 日)。
- Vercel. (n.d.). “Limits — Deployments.” Vercel Documentation. vercel.com/docs/limits(访问于 2026 年 8 月 5 日)。
- Griciūnas, A. (2026, March 11). “Agent Skills: Progressive Disclosure as a System Design Pattern.” SwirlAI Newsletter. newsletter.swirlai.com(访问于 2026 年 8 月 4 日)。
作者:Paul Jialiang Wu。文中数据均来自我自己的代码仓库,采集于 2026 年 8 月 2 日至 8 月 4 日。以上所有引文均已逐字核对原始出处。