AI 原生系列 · 智能体工程
绿灯亮了六周
1 分钟速览——你能带走什么
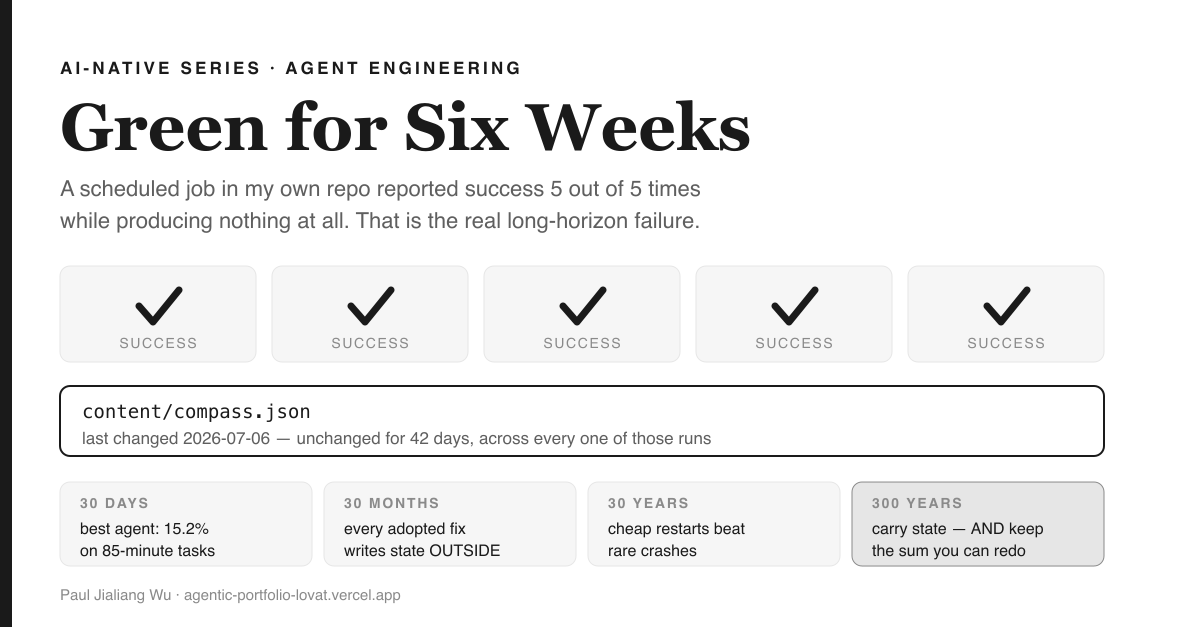
我自己作品集里的一个定时智能体报告了5 次运行 5 次成功,而它本该写入的那个文件却连续 42 天纹丝不动。原因是三行 shell 代码:一个缺失的凭证让它悄悄退出,却谎称任务完成exit 0。之后我用四个时间窗口——30天、30个月、30年、300年——研究了长时程智能体工程,每个窗口都指向同一个结论。 真正被采用的方案,没有一个是靠让模型记住更多东西。 每一个幸存方案都把状态挪到 模型之外,让重启变得便宜:压缩、笔记、检查点、监督树、可重放日志,以及——三个世纪前——一块你可以随身携带、同时保留可随时重算之能力的钟。这样一来,唯一剩下的灾难性失败就只有一种:明明什么都没发生,记录却说 一切正常 。这个心智模型就是一本 航海日志,它有三条规矩。第三条,正是所有人都会跳过的那一条。
周四早上,我打开自己仓库的 Actions 标签页,去看一个「侦察兵」的运行情况——这是个小型定时智能体,唯一的工作就是每周查看一次我在 GitHub 上的公开项目群,写下哪些项目值得深耕、该联系谁。它把答案写进一个文件(content/compass.json),然后网站再把它渲染出来。
五次定时运行。五个绿色对勾。一列整整齐齐的「成功」。
然后我去看了那个文件。最后修改时间是 2026-07-06。那是 42天 之前的事了。整整六周,一天不差。
原因只用三行 shell 就能说清,而且是我自己亲手写下的:
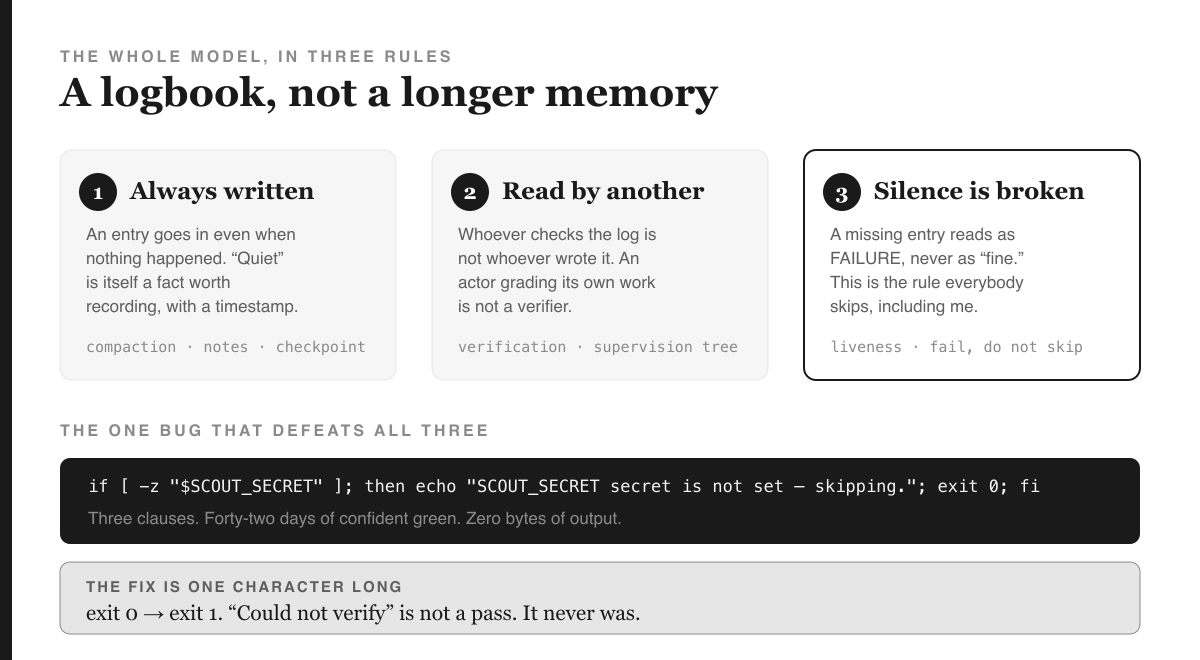
if [ -z "$SCOUT_SECRET" ]; then echo "SCOUT_SECRET secret is not set — skipping."; exit 0; fi那个凭证从来没有设置过。所以每次定时运行时,任务都会醒来,发现自己没有密钥,礼貌地把这事写进一个没人会看的日志里,然后以退出码零结束。退出码零意味着成功。GitHub 画上了那个对勾。我信了。
你细想一下就知道,这不是「我的定时任务坏了」这么简单。一个坏掉的定时任务是没问题的——它会去叫一个人来。 而这一个,把人打发走了五次。 这是唯一一类 bug,出了事还倒像在跟你说「谢谢惠顾」。
我原本打算花一整天研究长时程智能体工程——也就是让一个智能体能有效工作数小时乃至数天、而不只是几分钟的那门学问。结果我花了一上午来修这个 bug,然后发现我原本要做的那份研究,说的正 是这件事本身。全都是。四个不同的时间窗口,四种不同的文献,一个答案。
模型:一本航海日志,而非一段更长的记忆
整个想法其实很简单,不需要后面那堆术语你也能理解。
一艘船离港,要航行好几个月。船上没有人能把整趟航程都记在脑子里——航向的每一次调整、天气的变化、水深的起伏,都记不住。所以他们干脆不记。他们靠的是一本航海日志:位置、航向、状况,每隔一段时间就记一笔,写成任何一个陌生人接手后都能看懂、接着往下走的样子。
要让这本日志真正能救船,必须满足三个条件。
- 即使什么都没发生,也要记一笔。「平静无事,一切照旧」本身就是一条记录。空白的一页不是。
- 没写这条记录的人,也要能看懂它。值班记录的军官,不该是唯一会去翻这本日志的人。
- 日志里出现空缺,就说明出了问题。而不是「这周风平浪静」。是出了问题。
就这么简单。这篇文章里提到的每一种技术,说穿了都是这三条规则换了身技术的外衣。而我那个「侦察」程序,恰恰栽在第三条上——这一条不需要写下任何东西,所以也最容易被漏掉。
📰 窗口一:这个月,业内都在争论什么
最新鲜的这扇窗口声音最大,可信度却最低,所以这一节里的一切,都请当作大家在关注什么来看,而不是什么是真的。它是按热度排的,热度不等于证据。
2026年7月,这个领域终于给自己起了名字、定了形状。由中国人民大学 RUC-NLPIR 实验室维护的一份长时程智能体路线图 [1],把整个领域的文献归纳成两大支柱:外部化的 harness(围绕模型搭建的脚手架)与内部化的训练优化(把能力训练进模型本身)。 harness 这一半又细分出整整六个器官:循环与工作流、上下文与记忆、工具、编排、钩子与中间件,以及验证。
把这份清单对照日志本来看:上下文与记忆 对应第一条规则。验证 对应第二条规则。钩子与中间件 本该是第三条规则安身之处——如果真有人把它造出来的话。
与此同时,最新的测量数据令人清醒。2026 年 7 月 9 日发布的一个基准测试构建了 46 个货真价实的长任务,横跨九个类别的终端任务,每个任务都拆成有分级的子任务,让部分进展可见,而不是被压扁成「过/不过」两种结果 [2]。单次运行平均耗费约 231 个 episode、85.3 分钟,消耗约 990 万 token。表现最强的模型在部分得分阈值下的成绩是 15.2%15.2%,满分阈值下的成绩是 10.9%10.9%。所有受测模型的平均成绩:4.3%4.3% 和 1.7%1.7%.
另有一篇综合了 27 篇论文、19 个基准测试的研究,于 2026 年 7 月 7 日提交,归纳出智能体失败的六大类型,并用一句话给出三条结论 [3]。三条都很重要,所以原文照录:作者发现——"that failures compound nonlinearly with task length, that strong performance on individual sub-tasks does not reliably translate into end-to-end success, and that additional scaffolding does not consistently improve reliability."(中译:失败会随任务长度非线性累积;在单项子任务上的出色表现,并不能可靠地转化为端到端的成功;额外的脚手架也未必能持续提升可靠性。)
中间那句话,正是一个能给出部分分数的基准测试才能让人看清的地方;而最后那句,才是真正代价高昂的地方。
组件越多,不等于日志本越完整。你完全可以给一个智能体装上六个 harness 组件,结果造出来的还是我那个报错不响的侦察兵。
🌗 窗口二:真正从演示走到默认配置的东西
三十个月,是「是否被采用」的观察窗口:时间长到一个演示项目要么已经落地,要么已经黄了;又短到判决依然作数。这里按「生产环境中的使用证据」排序,而不是按发布时的声量。
先说人人都爱引用的那个数字。METR 衡量的是一个 AI 智能体能自主完成的任务时长有多长,而这条趋势线确实是指数级的。METR 给出的说法是「a doubling time of around 7 months」(中译:翻倍周期约为 7 个月),覆盖 2019 到 2025 年,他们拟合出的 P50 数值是 195.8 天,姑且算作六个半月;按他们更新后的方法论,从 2023 年起翻倍周期是每 130.8 天 一次,从 2024 年起则是每 88.6 天,自 2024 年以来 [4]。翻一倍所需的时间已经不到三个月。
而图表旁边很少一并出现的部分是:METR 自己是这么说的——"These confidence intervals are still very wide, and we are actively working on adding more long tasks…"(中译:这些置信区间目前仍然很宽,我们正在积极补充更多长任务……),人类基线用时"measured for only 5 of our 31 long (8h+) tasks. The remainder use estimated times"(中译:在我们的 31 个长任务(8 小时以上)中,只有 5 个是实测的,其余用的是估算时间) [4]。曲线本身是真的,但曲线最远端那一段,是靠五个计时数据点画出来的。在你打算拿这条外推曲线去做商业规划之前,这点值得先弄清楚。
那到底有什么真正落地了?三项技术,全都被我正在用来写这篇文章的这个编程 agent 所属的实验室记录为生产实践 [5]。他们的表述值得原样引用,因为它把「资源」这件事重新定义了:"LLMs have an 'attention budget' that they draw on when parsing large volumes of context. Every new token introduced depletes this budget by some amount…"(中译:大语言模型拥有一种「注意力预算」,在解析大量上下文时会消耗它。每新增一个 token,都会消耗掉一部分这个预算……) 上下文不是存储空间,而是一笔要花的预算。
既然如此,被真正采纳的三种做法,本质上都是「把东西写到别处去」:
- 压缩(Compaction) — "the practice of taking a conversation nearing the context window limit, summarizing its contents, and reinitiating a new context window with the summary"(中译:当对话快要触及上下文窗口上限时,将其内容摘要出来,再用这份摘要重新开启一个新的上下文窗口) [5]。写一条日志,再翻开新的一页。
- 结构化笔记(Structured note-taking) — "a technique where the agent regularly writes notes persisted to memory outside of the context window"(中译:一种技术,agent 定期把笔记写入上下文窗口之外的持久化记忆) [5]。这就是那本日志本身。
- 子智能体(Sub-agents) — "Rather than one agent attempting to maintain state across an entire project, specialized sub-agents can handle focused tasks with clean context windows"(中译:与其让一个 agent 试图在整个项目中维持状态,不如让专门的子 agent 以干净的上下文窗口去处理各自聚焦的任务) [5]。这就是值班轮换制。
与此同时,底层管道也被标准化了。Model Context Protocol 于 2024 年 11 月发布,到了2025 年 12 月 9 日,Anthropic 将其捐赠给了 Linux Foundation 旗下的 Agentic AI Foundation——该基金会由 Anthropic 与 Block、OpenAI 共同创立,并有 Google、Microsoft、AWS、Cloudflare 和 Bloomberg 撑腰 [6]。几家互相竞争的实验室,在十三个月之内就把一个共享接口交给了一个中立基金会,这已经不是「发布」了,这是「标准」。同一时期,「持久化执行」基础设施——也就是让进程能在崩溃后存活下来的那套机制——也明确转向了 agent 领域:Temporal 在 2026 年的大会上发布了专门针对这类工作流的无服务器 worker [7]。
规律就在这里,我想说得直白一点,因为这正是整篇文章的脊梁所在。被采纳的技术里,没有一个是靠让模型记住更多东西取胜的。每一个都是把状态挪到模型外面,放进某种持久、可检查、可恢复的东西里。
同一扇窗口下的坟场
一份不算上那些搁浅原型的采纳榜单,不过是篇公关稿——所以说句实话:这个时代最响亮的智能体项目,恰恰是那些没能成功的。AutoGPT 和 BabyAGI 在 2023 年初火速蹿红,而当时的实测评价是,一位评测者找不出一个它们能干好的实际用例[8]。AgentGPT 的开发已于 2023 年 11 月停滞;其母公司在 2024 年 7 月转向别的方向,留下这个平台处于维护状态,积压了 130 多个未处理的问题 [9]。
而最有教育意义的一具「尸体」,是一份 API 设计。LangChain 的 AgentExecutor——那个「把模型循环调用到完成为止」的经典抽象——已被弃用,与之一起被弃用的还有 initialize_agent,以及更老的 create_react_agent;官方认可的替代方案是单一的 create_agent[10]。给出的理由是:循环处理不了分支、人类介入、或持久执行,而图运行时可以。
循环输给了图。循环是一个把状态藏在自己内部的过程。图则是一个把状态写下来、随时可以暂停、检查、接着往下走的过程。规则一,再一次,裁定了一场框架战争的胜负。
窗口三:什么撑过了三十年
现在改用「存活」而非「采纳」来排序,名单一下变得又短又不起眼。关于分级我要坦白:下面这两项都只能算是老当益壮,而不是『幸存』(survived),因为在这一轮研究里,我没能找到两者完整的「消亡又复活」证据。
监督树,以及「随它崩溃」(let it crash)。Erlang/OTP 对长期运行系统给出的答案,不是去写不会出错的代码,而是把进程排成一棵树:监督者唯一的职责,就是发现子进程死了,然后重启它。这套机制至今仍是承重墙:WhatsApp 曾以不到五十名工程师的团队,让每台服务器扛住约两百万个并发连接,Discord 的实时基础设施也出自同一血脉 [11]。这种理念常被误读,所以这里要纠正一个要点:它不是说「可以马虎」。Erlang/OTP 自己的设计原则,是把恢复逻辑放进一个独立进程,与干活的代码分开——监督者存在的意义,正是让干活的代码永远不用自己扛住「怎么从自身失败中活下来」这件事。正常运行和错误恢复是两套不同的程序,由这棵树的不同部分分别写成。(这个说法我见过被十几篇博客当引言引用,我自己这段的初稿也是这么写的,但翻遍资料都没找到真正的出处,所以这里不加引号照实写出。)
从持久化日志中重放。持久执行——Temporal,由曾在 Uber 打造 Cadence 的那批工程师所建——把每个工作流的历史,保存成一份存在于进程之外、永不丢失的持久事件日志。重启时,工作进程会从头重放工作流代码,但只执行那些还没发生过的部分;已经成功过的活动会被直接跳过 [7],[12]。这个想法比这款产品本身还要古老——它其实就是「预写日志」(write-ahead log)换了顶新帽子——我在这里描述的是这一脉络,而非声称为其找到了确切的引用来源。
把这两者放在一起看,机制就显现出来了:
"Neither one tries to stop the long run from failing."(中译:两者都不试图阻止长程运行失败。) 二者的着力点都是让失败之后的恢复更便宜。三十年的可靠性工程,买到的不是更少的崩溃,而是更便宜的重启。
这就是为什么「让模型更聪明一点,别丢了线索」是一个毫无先例的策略,而「勤加检查点,丢了线索也只损失九十秒」则是一个有着三十年历史的策略。
🏺 第四个窗口:三百年淘洗下来的东西
在这个尺度上,一个人的职业生涯长度只是噪音。一样东西得跨越好几代人,还得挺过原本足以致命的底层介质更替,才算数。在与我们同样的领域里,有两样东西做到了:在一份长到记不住的差事里,知道自己身在何处。
随身携带的钟,与重新算一遍的账
经度问题,正是那个长程问题的原型。纬度好办——看太阳就知道。经度却要求你知道“别处”此刻是几点,而在人类历史的大半段时间里,海上没有任何东西能告诉你这个。十八世纪,两种方案彼此竞争,而它们正是今天依然摆在桌面上的两种策略。
把状态一路带着走:John Harrison 的航海精密计时器让一个参考时间持续走着,于是定位不过是读一次数。每次都重新推导:月距法测量月亮与某颗恒星之间的夹角,再反推回参考时间——每次定位都要重新观测、查历书表、走一长串球面三角运算,从头再来。
在讲数字之前,我得先转达一个警告,因为我最倚重的这份资料,其存在的主要目的之一,恰恰就是发出这个警告。Royal Museums Greenwich 在讲述这段竞争的开篇便说,"The brilliant John Harrison has long been portrayed as the plucky underdog…"(中译:才华横溢的 John Harrison 长久以来都被塑造成一个奋起抗争的弱者形象……),而这种塑造"has however tarnished the reputation of another brilliant man: Nevil Maskelyne"(中译:却因此玷污了另一位杰出人物——Nevil Maskelyne——的声誉。) [13]。这个「弱者逆袭」的版本,正是我从小听到大、也正是我一开始动笔就想写的版本。但历史学家讲的不是这个版本。
所以,得小心一点讲。在第二次海上试验中——也就是两种方法被放在一起对照测量的那一次——Harrison 的 H4 号,精度达到了大约十英里 ,而月距法的误差约在 三十 英里以内 [13]。原始资料写的是「miles」,未注明是statute mile还是nautical mile,所以我也不做区分。(H4那次著名的约一英里 误差是真实的,但来自另一次航行;把两次拼在一起比较,等于把两场 实验硬凑成一场竞赛。)时任皇家天文学家的Maskelyne出版了让月距法真正能被普通水手使用的《航海历书》表格,作为董事会成员,他「continued to resist Harrison's claim for the award」(中译:持续反对将奖金授予Harrison)[13]——他还评估过Harrison的钟表,据Linda Hall Library记载,他 "wrote a negative report, saying that the chronometer had built-in errors which just happened to cancel each other out"(中译:写了一份负面报告,声称这台精密计时器内部本身就存在误差,只是恰好相互抵消而已) [13]。这可不是轻飘飘一句「纯属侥幸」,而是更具体、也更诛心的说法:你的仪器是蒙对了。
月距法在整个十九世纪的大部分时间里都很好用,也是当时的标准做法。精密计时器大约在1850年前后才变得平价,而英国的《航海历书》从1767年一直刊登月距表,直到1906 [15].
现在要说句老实话,因为这个故事的高光版本本身就是一种以今度古的偏见——我自己一开始也是这么写的。当年人们反对精密计时器的理由是它太贵、难以量产——而在将近一个世纪的时间里,这个反对意见是站得住脚的。 格林尼治皇家博物馆说得很直白:精密计时器「remained rare and expensive; it took decades to establish their reliability and for seafarers to trust them」(中译:长期以来依然稀有而昂贵,花了几十年时间才建立起可靠性,也让水手们真正信任它)[13]。Harrison的海试是1761年,平价化大约在1850年到来——姑且算九十年,这个「大约」也是原始资料自己的措辞,并非精确测量。一个成本方面的反对意见,完全可能正确了三代人的时间,最后却还是输掉。这比“先驱终获平反”更有用的一课,也是我真正想套用到agent系统里检查点开销上的一点:这个反对意见眼下也许此刻是对的,却依然可能是错误的设计取向。
然后,输家又回来了——以候补身份重新登场
这是一个我差点归错边、险些放进自己论证错误一侧的转折。
美国海军学院在1990年代末把天文导航移出了课程,把那部分课时换成了GPS和电子导航,然后又在 2015年夏天让它复活,原因是GPS可能被干扰。该校海务与导航系副主任把理由讲得很干脆:电脑是很好,但 "The problem is there's no backup"(中译:问题在于它没有备份手段) [14].
但请看看回来的到底是什么。六分仪观测、历书、天文定位归算——这正是那套 重新推算法。十八世纪那场较量中落败的一方,如今被现代海军重新启用为备用手段。不是因为重新推算更便宜——它显然更贵。而是因为重新推算只依赖天空,携带式状态却依赖着别人运营的卫星。
由此得到一条比「携带状态、而非重新推算」更锋利的规则:
把紧凑状态往前带,因为它便宜。同时保留从零重新推算的能力,因为一旦那条便宜路径走不通,这是唯一还能用的办法。
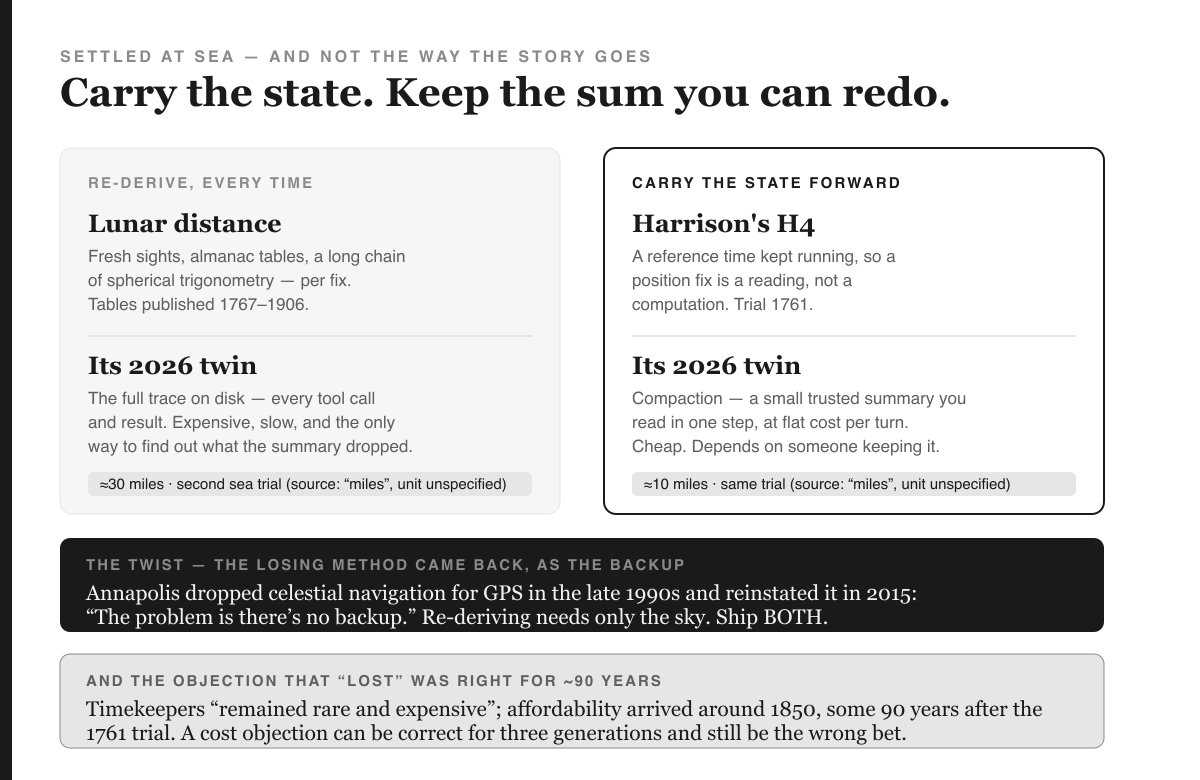
对一个智能体来说,这不是比喻,而是架构。压缩摘要就是那台精密计时器:一份可信的小摘要,一步读完。完整轨迹——磁盘上的每一次工具调用与返回结果——则是六分仪:昂贵、缓慢,却是当摘要恰好漏掉了关键之处时,唯一能查清自己身在何处的办法。两样都要留。我见过的大多数智能体系统只留了前者,然后在出事故的时候才发现,压缩后的历史就是它们所拥有的一切。
而这一点我甚至不必搬出十八世纪来论证,因为本文里已经有一套生产系统正是这么做的。持久化执行把完整的事件日志保留下来,并据此重放:日志就是六分仪,重放就是那套「测算归位」,而它跳过的那些已经成功过的操作,就是被随身携带的状态 [7], [12]。Temporal 两样都做了。而海上其实也从未真的只选一边:给精密计时器的胜利定下年份的同一份资料也提到,"a mariner with a chronometer could check its accuracy using a lunar determination of Greenwich time"(中译:带着精密计时器的水手,仍可以用月距法测算的格林尼治时间来校验它的准确性)[15]。带上钟,也留着六分仪,让它们互相校验。一支海军在 2015 年重新学会了故事的后半段。如今还在非此即彼地二选一的,只剩智能体技术栈了。
不过我得对「回归的到底是什么」如实交代,因为诚实的版本比高光版本更好笑,也更有用。回来的并不是当年那门课,而是一场三小时的入门讲座[14]。问题第一次被解决的两百六十五年后,这条后备方案被重新启用时,长度大致相当于公司里一堂讲报销制度的入职培训。机构从来不是真的吸取了这个教训,它们只是就此贴了张便利贴。
检查清单——外加两处诚实的更正
第二个幸存者,是所有人都自以为熟悉的那个。1935 年 10 月 30 日在莱特机场,波音 299 型——B-17 的原型机——爬升到约 300 英尺时失速坠毁,五名机组人员中两人遇难。原因是一个未解除的操纵锁:据当时的事故记录,这是一个同时锁死了升降舵和方向舵的内部锁定装置 [16]。(大众版本的复述把它称为「阵风锁」。而我实际能核实到出处的事故记录并没有用这个说法——这一节本来就是在纠正各种以讹传讹的复述。)
事故调查委员会的结论,是我愿意挂在任何一块智能体仪表盘上方的一句话。委员会的结论是,考虑到飞机的体积与操纵系统的设计,"it was improbable that any pilot, taking off under the same conditions, would discover the locked controls until it was too late to prevent a crash"(中译:在相同条件下起飞,任何飞行员都不太可能在为时已晚、无法阻止坠机之前发现操纵被锁死) [16].
一种无法被观测到的状态。飞机没有任何办法把自己的状况告诉任何人。
而我必须把这条结论,和紧挨着它的另一句话放在一起看,因为同一份资料还补充道,"Ordinarily, pilots make checks of their movement as a precaution, but apparently this did not occur"(中译:按常规,飞行员本应出于谨慎检查各操纵面的活动情况,但显然这一步并未发生)——而且它还用自己的措辞补充说,这份结论"by implication, a 'pilot error' verdict—but the board did not say that directly"(中译:言外之意其实是一个「飞行员失误」的结论——但委员会并未直接这么说)[16]。所以这并不是那种「机构高风亮节、不肯归咎于个人」的干净故事。它更混乱,也更常见:这份报告里,开脱与责备两样都有,而这个组织真正拿它做了什么才是真正要紧的部分。
他们具体做了什么呢?面对「飞机根本大到没法操控」这类说法,Air Corps "properly recognized that the limiting factor here was human memory, not the aircraft's size or complexity"(中译:正确地认识到,这里的限制因素是人类的记忆,而非飞机的尺寸或复杂程度) [16]。于是他们为起飞、飞行、降落前、降落后各写了一份检查清单。
第二处更正,因为流行版本是一种「辉格史观」,我差点就照单全收发出去了: 检查清单并非1935 年发明的。按照 Merriam-Webster 的考证,这个词本身早在 1853 年就已经出现,而同一来源明确指出这个概念 "had already been around for decades, and was in scattered use in aviation worldwide, but it took the Model 299 crash to institutionalize its use"(中译:几十年前就已经存在,并且在全世界航空界都有零星使用,但正是 Model 299 坠机事故促使它被制度化) [16]。1935 年提供的不是这个想法本身,它 提供的是一场葬礼。
这一点值得让人坐立不安。这篇文章里提到的每一项规范,都是在有所损失之后才被制度化的。我自己付出的代价,不过是这个侦察兵六周的输出——而我发现这件事,纯粹是因为我碰巧多点开了一个标签页。
第一性原理
四扇窗口最终收束成一句话。
智能体的时间视野,不在于它能记住多久,而在于它能不能被打断、被恢复,同时始终不对自己身在何处撒谎。
这条链条很短:上下文是一种会被逐渐耗尽的注意力预算,所以持久状态必须存在于模型之外。一旦状态挪到了外部,那份外部记录——而非模型本身——就成了系统的权威记录。而一旦记录本身就是权威记录,唯一还剩下的灾难性失败,就是一份在什么都没发生时却报告一切正常的记录。
这就使得长时程工程的最后一公里,变成一件古怪又不起眼的事:让沉默变得响亮。
模式与反模式
| 模式 | 反模式 |
|---|---|
| 哪怕是平静无事的一次运行,也要写下检查点——空白的条目本身就是一种缺失。 | exit 0凭证缺失时,任务应当报错,而不是悄悄跳过。 |
| 负责校验的,不能是负责执行的那一个。 | 智能体给自己的轨迹打分,然后上报这个分数。 |
| 「空缺」本身就是一种失败状态,且带有容差。 | 把「空缺」当作空值,渲染成绿色。 |
| 让重启变得便宜,而不是让崩溃变得罕见。 | 把模型调得更聪明,指望它「不会跟丢」。 |
| 把精简后的状态往前传递同时保留可供你重新推导的完整轨迹。 | 只保留摘要——结果在故障发生时才发现完整轨迹早已不在。 |
| 让失败自动流向人类本就会看的地方。 | 把仪表盘的某个标签页当作报警渠道。 |
事后九十分钟里,我到底改了什么
说具体点,方便你直接抄,或者拿来跟我抬杠。五条规则,现在都写进了代码里,不再靠脑子记:
- 调度时间要避开整点。 计划任务在整点最容易被丢弃、被延迟。我现在把任务排在
:00。我的任务现在跑在:47,:53和:11. - 凭证缺失应当直接报错,而不是被悄悄跳过。
exit 0变成了一条报错注解,exit 1——这是新任务里的写法;而旧任务正是靠没有这一条,才把这个教训教给了我。 - 失败必须开一个 issue。 藏在没人会点开的标签页里的一个红色方块,算不上任何报警。
- 这个任务会测量自己上一次输出距今的时间 并在每次运行时报告结果,容忍度按周期设定:每日任务 2 天,每周任务 10 天,每月任务 40 天。一个已经悄悄停摆的任务,现在会在恢复运行时大声说出来。
- 「无法验证」绝不会以 exit zero 退出。 这就是那个「一个字符的修复」,如今被用成了通用规则。
而且它现在跑的这个 review,被设计成是可以失败的:如果底层的目标图谱空到没法据以审查,输出就会以NOT REVIEWABLE(不可审查) 打头,而不是给一份干净的体检报告——因为「无事可报」和「无据可依所以无法报告」是两件不同的事,其中只有一件是好消息。
我终于亲眼看它跑起来的那部分
刚开始写这一节的时候,GitHub 正赶上一场大规模宕机——API、Actions、Issues 和 Pull Requests 全都一起挂了——我当时写道,我还没能亲眼看到任何一次计划任务跑出绿色,所以按本文自己定的规矩,我没资格说这事儿已经搞定了。
后来宕机解除了,我把任务派发了出去。 结果失败了。一连四次,出于两个完全不同的原因,而且没有一个是我预料到的。
第一次失败反倒是比较体面的那种。review 本身工作得很完美:它调用了接口,生成了报告,写入了docs/reviews/2026-08-17-weekly.md,推送了分支——然后在最后一步栽了,报错是GitHub Actions is not permitted to create or approve pull
requests。一个默认关闭、我从来没看过的仓库设置。
你细想一下,这对我在这篇文章里剖析了半天的那个 cron 意味着什么——这个侦察兵缺了三样东西:一个从来没被注册过的密钥、一个本该报错却直接 exit zero 的步骤,还有一个没人打开过的仓库权限。这三个随便修好一个,它照样什么都干不成。 我之前还挺得意,觉得自己抓到了一个 bug。 结果数下来是三个,而我能找到第三个,纯粹是因为我这次让任务失败得足够响亮,它才肯告诉我。
接下来的三次失败,是 GitHub 自己的 503 错误,在一场局部宕机里反复横跳,卡在同一个最后步骤上。第四次尝试终于亮了绿灯。运行32054945733,我一直盯到它跑完,随后开出了
PR #303 containing a real
评审 —— 窗口期内十二次投递、三个仓库冷置超过十四天、一次营收速度触发的绊线、以及十三个节点权重未签名并被中和。它还打印出了自己的节奏检查:no prior weekly review — this is the first.(中译:此前没有任何一次周度评审——这是第一次。)
于是我终于可以这么说了。也请留意这需要什么代价:这篇文章结尾那个诚实的版本,比起我只写代码、只相信绿色标记就发布的那个自信版本,多花了四次失败和一项仓库设置。
有一件事我依然刻意没有做。有一个凭据——技能循环需要的那个——存在于部署环境里,却不在仓库里,我本可以在三十秒内轮换它,让那个 cron 任务变绿。我没有这么做,因为文档显示另一个系统正用旧值无人值守地调用那个端点,而轮换一个还有隐形调用方持有的凭据,恰恰会制造出这一整天都在努力消除的那种静默故障。所以那个任务现在会大声地、正确地失败,并一直失败下去,直到有人把那个值手动同步过去。响亮的红色是一件完成的工作,安静的绿色不是。
我想,这就是 2026 年 8 月长时程智能体工程的真实状态。曲线陡峭,而且是真实的。目前记录在案的最强系统,能完成智能体耗时约 85 分钟、消耗 990 万 token 的任务中的 15.2%——而那篇论文完全没有报告人类基线,所以没人能告诉你这些任务人类要花多久。真正会让你付出代价的失败,从来不是智能体停了下来,而是它停下之后还报告成功——一停就是四十二天,还排成一列整整齐齐的绿色。
相关文章
参考文献
- RUC-NLPIR。《Awesome-Long-Horizon-Agents:长时程智能体路线图》。 双支柱分类法(harnesses / optimization)与六大 harness 组件;仓库已为 2026 年 7 月的综述发布重新整理结构。github.com/RUC-NLPIR/Awesome-Long-Horizon-Agents
- Li, Z., Li, Z., Shi, Y., 等(2026 年 7 月 9 日)。《Long-Horizon-Terminal-Bench:以密集奖励评分测试智能体在长时程终端任务上的极限》。 arXiv:2607.08964。九大类别共 46 项任务;每次运行约 231 个 episode、85.3 分钟;每项任务约耗费 990 万 token;在 0.95 与 1.0 奖励阈值下,最强模型 pass@1 分别为 15.2% / 10.9%,所有模型均值为 4.3% / 1.7%。arxiv.org/abs/2607.08964
- Albayaydh, W., Zhao, R., & Flechais, I.(2026年7月7日)。 Beyond the Leaderboard: A Synthesis of Tool-Use, Planning, and Reasoning Failures in Large Language Model Agents. arXiv:2607.05775。27 篇论文,19 个基准测试,六大类失败模式。三项发现以摘要中连续的一整句原文引用,其中包括本文早期草稿曾遗漏的中间那一分句。 arxiv.org/abs/2607.05775
- METR(2026年1月29日)。 Time Horizon 1.1. P50 翻倍周期全程约为 195.8 天;按 TH1.1 方法论,2023 年以来为 130.8 天,2024 年以来为 88.6 天;两句说明性附注均为逐字引用。 metr.org/blog/2026-1-29-time-horizon-1-1/ · 更早的方法论: Measuring AI Ability to Complete Long Tasks
- Anthropic。 Effective context engineering for AI agents. 区分了上下文工程与提示工程的定义;「注意力预算」的框架;压缩、结构化笔记与子智能体架构——全部四处引用均已逐字核对原文无误。 anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic(2025年12月9日)。 Donating the Model Context Protocol and establishing the Agentic AI Foundation. AAIF 隶属于 Linux Foundation;由 Block 与 OpenAI 共同创立,Google、Microsoft、AWS、Cloudflare 与 Bloomberg 提供支持。 anthropic.com/news/donating-the-model-context-protocol…
- The New Stack(2026)。 Temporal reveals a serverless option for its Durable Execution platform. Replay 2026 大会公告;持久化执行机制明确指向面向 AI agent 的工作流。 thenewstack.io/temporal-replay-2026-news/ · 官方博文: temporal.io/blog/replay-2026-product-announcements
- Tom's Hardware。 Auto-GPT and BabyAGI Are AI's New Hotness, But They Suck Right Now. (2023年4月22日。)同期的实测评价;此处为转述而非逐字引用。原文未给出星标数——正文对 AutoGPT 星标情况的描述因此是定性的,未断言具体数字。 tomshardware.com/news/autonomous-agents-new-big-thing
- DataCamp。 AgentGPT: A Guide to Browser-Based Autonomous AI Agents. 2023年11月开发停止;母公司于2024年7月转向;目前处于维护状态,积压130多个未处理问题。 datacamp.com/tutorial/agentgpt
- BSWEN(2026年6月17日)。 Is AgentExecutor Deprecated in LangChain? The Real State of LangChain Agent APIs in 2026.
AgentExecutor,initialize_agent以及更早的create_react_agent均已被弃用,create_agent成为官方认可的替代方案,并统一收拢到图(graph)运行时之上——这也是正文从该来源援引的全部内容。另有两个细节流传于二手报道中,但并未见于该页面本身:一是2026年12月的终止支持日期,二是经典构造函数迁移进某个langchain-classic包。两者本文均未采信。 docs.bswen.com/blog/2026-06-16-is-agentexecutor-deprecated-langchain/ - OneUptime(2026年2月3日)。 How to Use Supervisors in Elixir. 监督树(supervision tree)的运作机制;工作与恢复的分离,原文是转述而非逐字引用 ——那句「separating the concerns of normal operation from the concerns of error recovery」在各类博客中广为流传、被当作引文使用,但我未能找到真正包含这句话的出处,这一点正文中也如实说明了。 oneuptime.com/blog/post/2026-02-03-elixir-supervisors/view · WhatsApp 的数据(“2 million simultaneous connections per server with a team of fewer than 50 engineers”(中译:每台服务器承载约两百万个并发连接,工程团队不到五十人))以及 Discord 的例子出自 Elixir and OTP for AI Agent Systems
- Temporal。 Workflow Execution overview 与 Event History walkthrough. 事件历史(event history)作为存于进程之外、永不丢失的持久化日志;从头重放工作流代码,但跳过已经成功执行过的活动;Temporal 的血统可追溯到 Uber 的 Cadence。 docs.temporal.io/workflow-execution · docs.temporal.io/encyclopedia/event-history/…
- Royal Museums Greenwich。 Longitude found: Nevil Maskelyne and the lunar method. 正文中逐字引用的“不公平的低估英雄”警示语出自此处,Maskelyne 的主张与《航海历书》表格亦源于此,另有一句:航海计时器“remained rare and expensive; it took decades to establish their reliability and for seafarers to trust them”(中译:长期稀有而昂贵,花了几十年才建立起可靠性,才让水手们愿意信任它)。 这个页面存在的主要目的,就是纠正「Harrison 是被低估的英雄」这一流行叙事,正文也是这样交代的,而不是引用它来佐证那个叙事本身。 rmg.co.uk/stories/time/longitude-found-nevil-maskelyne-lunar-method · Linda Hall Library, Nevil Maskelyne ——正文中第二次海试数据的出处(H4「accurate to within 10 miles」(中译:误差在十英里以内),「the lunar distance-method was accurate to within 30 miles」(中译:月距法误差在三十英里以内)),以及 Maskelyne 报告原话的出处(“wrote a negative report, saying that the chronometer had built-in errors which just happened to cancel each other out”(中译:他写了一份负面报告,称这台精密计时器内部存在误差,只是碰巧相互抵消了)),也是他作为董事会当然成员持续反对 Harrison 索赔一事的出处: lindahall.org/…/nevil-maskelyne/。H4 那个约一英里的著名数据来自另一次不同的 航行,本文刻意不将它与三十英里的数据并列比较。
- Slate(2015 年 10 月)。 Naval Academy Brings Back Celestial Navigation Training in Case of a Cyberattack on GPS. 于十多年后的 2015 年夏天恢复;该课程在上世纪九十年代末曾被 GPS/电子导航取代;文中逐字引用了 LCDR Ryan Rogers 的原话;这次重启只是一堂三小时的入门讲座。 slate.com/technology/2015/10/… · 印证来源:Military Times · Sky & Telescope
- Wikipedia. Lunar distance (navigation). 仅用于两个日期,且都能在该页面找到依据:英国《航海历书》(Nautical Almanac)的月距表「published between 1767 and 1906」,以及约1850年前后被廉价航海钟取代。本文早前一稿还把1907年、1919年,以及1905年的无线电报时截止日期归到这一来源,但这三个日期没有一个真的出现在该页面里,所以三者都被直接删除,而不是另找出处补救。 en.wikipedia.org/wiki/Lunar_distance_(navigation) · 学术性论述,本文未据此立论:Wepster,A (not so) brief history of lunar distances,arXiv:2007.14504
- Boyne, W. J.(2013年8月)。The Checklist. Air Force Magazine。1935年10月30日Model 299坠机事故;事故调查委员会「improbable that any pilot…」的结论;「the limiting factor here was human memory, not the aircraft's size or complexity」;以及关于该做法(检查单)早于1935年就已存在、只是因这次坠机才被制度化的更正说明——以上三处均逐字引自文章原文。airandspaceforces.com/…/0813checklist.pdf · 坠机记录:National Air and Space Museum
研究资料包整理于2026年8月17日,横跨四个时间窗口——30天、30个月、30年、 300年。共十六个来源。 这份初稿第一次自我审查就没能通过。 一位带着新鲜视角的独立审校者,将每一条引文都逐一核对回原始出处, 结果发现了 六处影响结论的硬伤和十二处小问题,然后第二次审查修改稿时,又发现十六处问题,其中十处是实质性的——这正是为什么一篇讲“虚假绿灯报告”的文章,它的后记不应该写“一切已核实”,而应该写清楚哪里出过错。发布前已修正的问题包括:一句关于 Erlang supervision 的话,其实查不到no 出处支持,现已改为不加引号的转述,并在正文中说明了这一点;关于计时器“太贵、太难以规模化制造”的说法,曾经以引号形式出现在配图、条目登记和推广素材中——正文里则以斜体“近似引用”的方式出现,还加了个“大意如此”的免责声明,这反而更糟——但这句话其实不存在于任何来源中,现已替换为 Maskelyne 报告里真正写的内容;“一海里对三十海里”这个对比,其实是把两次不同的海上试验拼接在了一起,现已改为同一次试验中的“十对三十”;三个日期(1907、1919、1905)曾被错误地归到一个根本不包含它们的页面上,现已删除而非重新找出处;一个终止支持日期和一个 GitHub 星标数也因同样原因被删去;而三百年跨度里最有力的例证——美国海军学院 2015 年恢复相关课程一事——此前被错放在了本文自设二分法中错误的那一边,错误的那一边,这正是本文最终得出那条更犀利的结论的原因所在。经核实未作改动的引文包括:全部四段来自 Anthropic 的引用、全部三段 1935 年事故记录中的引用、METR 的两处警示说明、海军学院的那句话,以及 arXiv 摘要里那整句话。有两项“三十年”跨度的案例被归为“aging well”(意为“老当益壮”),而非归为“survived”(意为“历经考验、存活至今”),因为在这一轮研究中,我没能找到它们“曾遭淘汰又重获新生”的完整证据。5 次运行 5 次全绿,以及那 42 天的空档,都来自作者本人公开的仓库;结尾处描述的那四次失败的任务派发,以及那个仓库权限设置,也是如此——那一节是在 cron 真正运行之后重写的,因为它最初的版本如实写着“这次运行从未被人看过”,而这句话一旦发布出来,本身就会成为一句谎言。文中不含任何来自雇主或客户的材料。——Paul Jialiang Wu ·agentic-portfolio-lovat.vercel.app