SERIE AI-NATIVE · INGENIERÍA DE HARNESS (arnés de agentes)
El silencio no es un estado
Un minuto
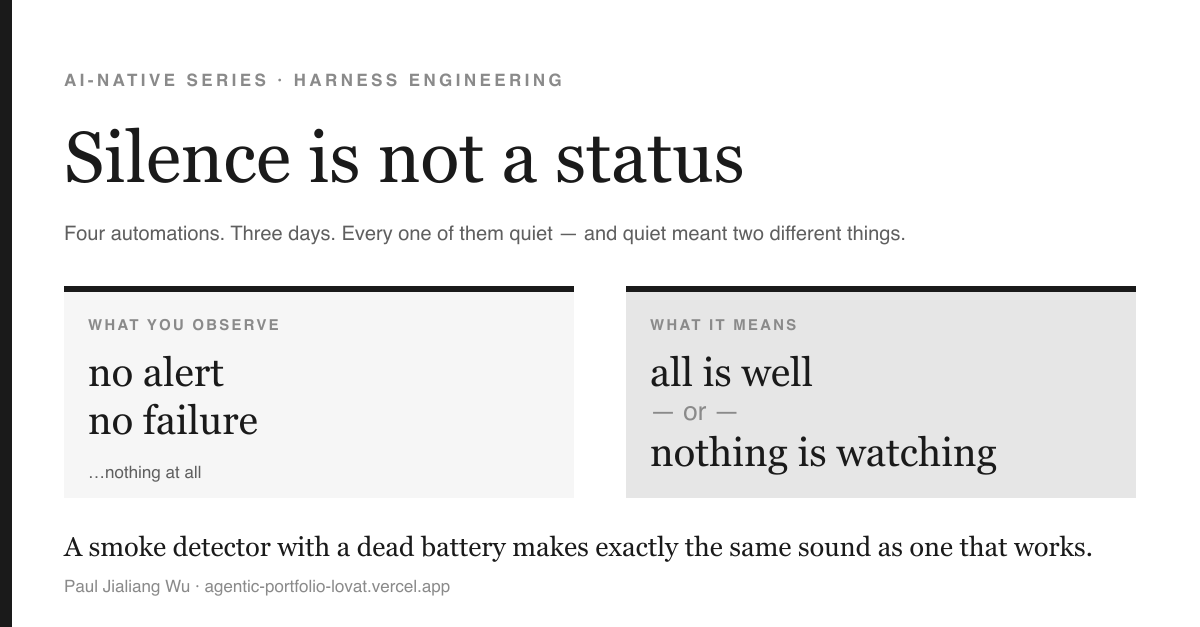
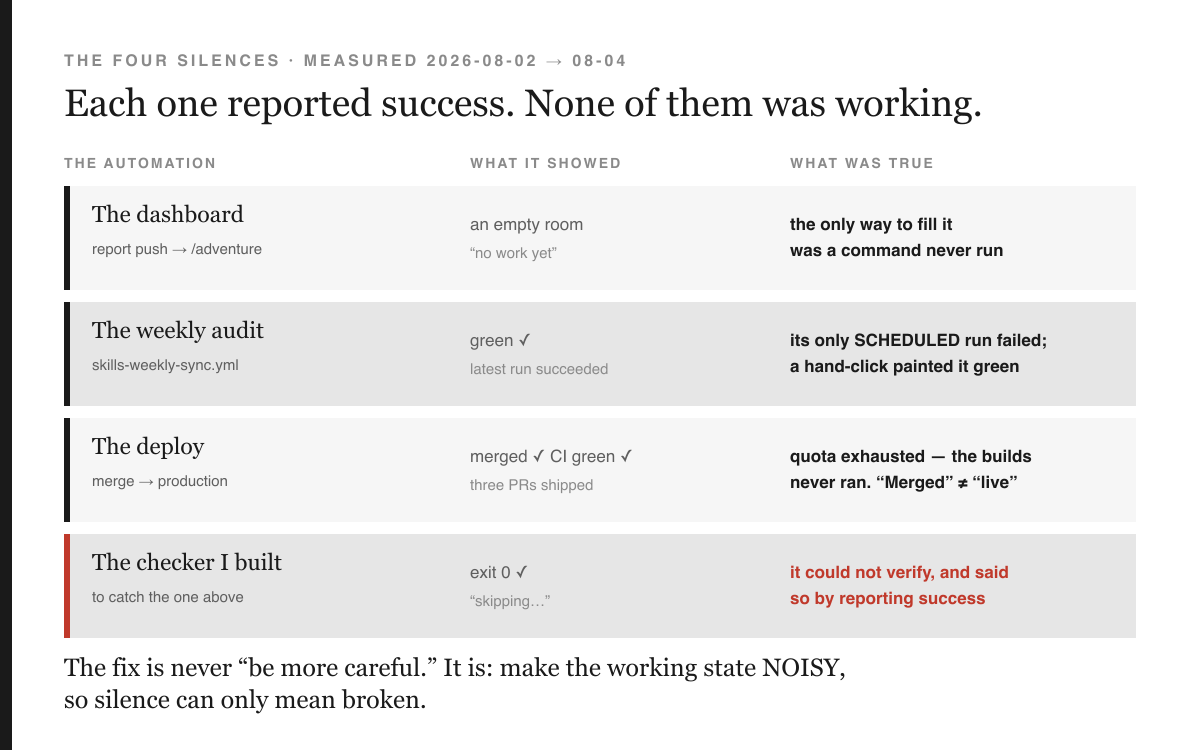
En tres días encontré cuatro automatizaciones que estaban calladas. Callado es lo que parece un sistema sano —y también lo que parece uno muerto—. Un panel estaba vacío porque el único comando que podía llenarlo nunca se había ejecutado. Un trabajo semanal marcaba verde porque un clic manual había estado cubriendo un cronograma que fallaba. Tres pull requests fusionados no estaban en producción porque una cuota de despliegue había dejado de compilar en silencio. Y el verificador que escribí para detectar eso último imprimió «skipping» y terminó con éxito. La solución no es la vigilancia. Un detector de humo con la batería muerta hace exactamente el mismo sonido que uno que funciona, así que haces que el estado sano sea algo ruidoso —un pitido que significa «sigo vivo»— y entonces el silencio solo puede significar que algo se rompió. Los equipos de monitoreo llevan una década implementando esto bajo el nombre de interruptor de hombre muerto (dead man's switch); casi nadie aplica esto a su propio arnés de agentes.
La semana en un número
Cuatro. En tres días, en una base de código que administro y audito obsesivamente, encontré cuatro automatizaciones independientes que habían dejado de hacer su trabajo y no se lo habían dicho a nadie. Ninguna arrojó un error. Ninguna puso un panel en rojo. Cada una, según toda señal que yo mismo había construido para vigilarlas, se veía exactamente como un sistema funcionando a la perfección.
Quiero ser preciso respecto a la vergüenza que esto me da, porque ahí vive la lección. No estoy describiendo un sistema heredado de otra persona. Construí las cuatro. Dos las había lanzado esa misma semana, y una de ellas era justo la herramienta que había escrito específicamente para atrapar este tipo de error.
El modelo mental: la batería cuya muerte nunca escuchas
Un detector de humo con la batería muerta hace exactamente el mismo sonido que uno que funciona: ninguno. La ausencia de un pitido no es evidencia de que tu casa esté a salvo. Es evidencia de nada en absoluto — la observación es idéntica en ambos mundos.
Esa es toda la idea, y si te llevas una sola cosa de este artículo, que sea esta: el silencio no es un estado. Es la ausencia de un estado, y tu cerebro se encargará amablemente de llenar el vacío con la lectura que prefieras. Cada automatización que tienes cuenta con dos estados que se ven idénticos desde afuera — funcionando y sin encontrar nada, y no funcionando — y a menos que hayas hecho un trabajo específico para separarlos, no puedes saber en cuál de los dos estás.
La razón por la que esto es difícil no es técnica. Es que «no pasó nada» se siente como información. No lo es.
Lo que en verdad encontré
Uno: un panel estructuralmente imposible de llenar. Había construido un panel
privado de resultados, conectado para aceptar datos enviados por un comando de CLI. Ese comando
necesita un token secreto. El token está guardado como una variable de entorno Sensitive de Vercel, lo que significa
que no puede volverse a leer: la propia plataformavercel env pull devuelve una cadena vacía cuando se la consulta. Así que el envío
solo podía ejecutarse a mano, por la única persona que conocía la contraseña, y en las semanas que
la función llevaba existiendo se había ejecutado cero veces. El espacio estaba bloqueado y vacío. Vacío es
indistinguible de roto, y en tres informes distintos le dije a mi colaborador que era
una tarea de una línea para él, en lugar de tratar como el bug un bloqueo que era responsabilidad mía.
Dos: un trabajo semanal que nunca se había disparado. Revisé el historial de ejecución de cada flujo de trabajo programado por cron en el repositorio. El nocturno estaba genuinamente sano: cinco de cinco ejecuciones programadas tuvieron éxito. Los dos semanales no. Uno tenía una sola ejecución programada en su historial, y esa ejecución había fallado; una nueva ejecución manual posterior había tenido éxito, así que cada vista de resumen —la lista de flujos de trabajo, el check verde, la insignia— reportaba el flujo de trabajo como exitoso. El otro tenía tres ejecuciones en toda su vida, todas disparadas por un humano al presionar un botón.
Este es el más sutil de los cuatro, así que detente a pensarlo: una ejecución manual es exactamente lo que la cadencia existe para reemplazar, y también es lo que hace que una cadencia rota parezca estar bien. La automatización no estaba automatizando. El humano que hacía el trabajo a mano era la razón por la que nadie notó que la automatización se había detenido.
Tres: fusionado no significaba en vivo. Tres pull requests fusionados, con CI en verde en los tres, y el sitio desplegado siguió sirviendo una versión anterior durante horas. La capa gratuita del alojamiento limita los despliegues de producción a 100 por día (Vercel, n.d.). Pasado ese límite, las fusiones tienen éxito, las verificaciones pasan, y nada se despliega. No hay rojo por ningún lado. La palabra «merged» había dejado de significar «en vivo» en silencio, y todos mis hábitos estaban construidos sobre que esas dos palabras eran sinónimos.
Cuatro: el verificador que reportaba éxito cuando no podía saberlo. Habiendo encontrado
el número tres, escribí un guardián: publicar el SHA del commit que realmente está sirviendo tráfico, compararlo
con el que se supone que debería estar en producciónorigin/main, y fallar si difieren. Bien. Luego lo ejecuté, y el resultado imprimió «skipping»· the
deployment reports no commit SHA — skipping y salió con éxito.
Había construido un detector de fallas silenciosas cuyo propio modo de falla era fallar en silencio. No podía determinar la respuesta, así que reportó la buena. En un pipeline en verde, “I could not check” y “I checked and it is fine” se representan como el mismo tick. (Traducción: «no pude verificar» y «verifiqué y está bien» se representan como el mismo tick.)
Por qué nadie lo notó: la ejecución manual que lo pinta de verde
Tres de los cuatro comparten un mecanismo, y vale la pena nombrarlo porque también estará en tus sistemas. En cada caso, una acción humana produjo la misma señal observable que la acción automáticala acción humana producía la misma señal observable que la acción automatizada — y la señal observable es lo único que alguien mira alguna vez.
Alguien hizo clic en «ejecutar flujo de trabajo» y la insignia se puso verde. Alguien podría haber ejecutado el comando de envío y el panel se habría llenado. Alguien leyó «merged» e infirió «deployed». La ruta manual y la ruta automática convergen en un solo indicador, y el indicador no puede decirte qué ruta lo produjo. La automatización decae, la persona compensa en silencio, y el panel nunca cambia de color.
La industria ya resolvió esto, y yo no había leído mi propio campo
Nada de esto es novedoso. Los equipos de monitoreo se toparon con esto en la década de 2010 y produjeron una respuesta específica, aburrida y excelente.
El capítulo de Site Reliability Engineering de Google sobre monitoreo, escrito por Rob Ewaschuk, insiste en una propiedad nada glamurosa: “Rules that generate alerts for humans should be simple to understand and represent a clear failure” (Traducción: «Las reglas que generan alertas para humanos deben ser sencillas de entender y representar una falla clara») (Ewaschuk, 2016). La razón que él plantea es la relación señal-ruido y la robustez — la ruta de aviso debe ser simple porque es la parte que no puedes darte el lujo de tener mal. Yo añadiría la mía: es también la única ruta que no puedes depurar con tu propio sistema de alertas. Para ser honesto sobre lo que ese capítulo sí y no te da, sin embargo: no contiene nada sobre la ambigüedad del silencio. Lo verifiqué. La respuesta que sigue no es de Google.
Y el patrón que responde directamente a la ambigüedad del silencio es el watchdog, descrito por PromLabs como “a watchdog alert (also sometimes called a ‘dead man’s switch’, sentinel alert, beacon alert, or heartbeat alert) that helps you continuously test your entire alerting pipeline from beginning to end” (Traducción: «una alerta watchdog (a veces también llamada “interruptor de hombre muerto”, alerta centinela, alerta baliza o alerta de latido) que te ayuda a probar continuamente todo tu flujo de alertas de principio a fin») (PromLabs, n.d.). El mecanismo es una inversión hermosa: creas una alerta que se dispara constantemente, para siempre, cuando todo está sano, y la enrutas a un servicio fuera de tu stack. Como lo dice PromLabs, “When anything in your alerting pipeline breaks, the external service will then notice that no more alert notifications are coming in and will send you a notification about it.” (Traducción: «Cuando algo en tu flujo de alertas se rompe, el servicio externo notará que ya no llegan notificaciones de alerta y te enviará una notificación al respecto»)
Lee eso de nuevo con el detector de humo en mente. Cualquier otra alerta se dispara cuando algo se rompe. Esta se dispara cuando nada está roto — así que el silencio se convierte en la señal de falla. Has convertido la observación ambigua en una inequívoca, al hacer que el estado sano sea el estado ruidoso.
Llevaba meses construyendo arneses de agentes y nunca había aplicado a mis propias automatizaciones un patrón que habría llamado obvio en un clúster de producción. La razón, creo, es que un arnés personal no se siente como infraestructura. Son unos cuantos archivos YAML y una CLI. Pero un cron job del que dependes es infraestructura, y se degrada exactamente igual que la de pago.
El segundo hallazgo: aposté a la cuerda equivocada
Esa misma semana, mi colaborador planteó otra mejora: con modelos de frontera tan capaces, un prompt de sistema largo dejó de ser una ventaja y se convirtió en un pasivo — recórtalo.
Tenía razón, y yo ya lo había demostrado, que es la parte interesante. Meses antes había hecho una prueba de tres brazos — prompt completo, un prompt mínimo de tres líneas, y ningún prompt — en tres modelos, sobre seis casos de capacidad puntuados de forma determinista como la fracción de afirmaciones cumplidas (más cuatro casos de inyección puntuados con aprobado/reprobado). Los tres brazos, completos:
| brazo del prompt | Sonnet-5 | Opus-5 | Haiku-4.5 (control débil) |
|---|---|---|---|
| completo (161 palabras) | 100.0% | 100.0% | 88.9% |
| mínimo (3 líneas) | 100.0% | 100.0% | 96.7% |
| ninguno (vacío) | 100.0% | 100.0% | 96.7% |
Los modelos de frontera se mantienen planos en 100%, se les dé el prompt o nada en absoluto. El control débil puntúa peor con el prompt que sin él, y el caso mínimo y el vacío son indistinguibles. El veredicto registrado fue tajante: el prompt no justifica la capacidad, y tampoco justifica la seguridad. Lo que sostiene la línea es el andamiaje de control del agente: la capa de herramientas rechaza movimientos ilegales y, de entrada, no hay ninguna herramienta peligrosa que invocar.
Entonces, ¿de acuerdo, recortar, listo? No. Porque lo que yo había puesto a prueba era un prompt de 881 bytes adherido a una sola funcionalidad. El prompt que en realidad se carga en cada sesión es el archivo de skill — el enrutador que le dice al agente qué puede hacer la herramienta. Nunca lo había medido.
Pesaba 23.016 bytes, unos 5.750 tokens. Veintiséis veces el tamaño del prompt que tan cuidadosamente había puesto a prueba. Y había crecido de 16.704 bytes a 23.016 en once días — un aumento del 38% sin una sola reducción, unos 1.700 bytes de los cuales yo mismo había añadido ese mismo día.
La práctica actual hace la comparación más reveladora de lo que esperaba. En un análisis de la convención Agent Skills, Aurimas Griciūnas reporta que el costo mediano de descubrimiento es de unos 80 tokens por skill, mientras que “el tamaño del cuerpo va de ~275 tokens (internal-comms) a ~8.000 tokens (skill-creator), con una mediana de alrededor de 2.000” (Griciūnas, 2026). El mío era 2,9× la mediana. La misma pieza nombra el costo: “As context grows, the model’s attention degrades and important information gets buried. Models reliably miss information placed in the middle of long contexts, a well-documented phenomenon called ‘lost-in-the-middle.’” (Traducción: A medida que el contexto crece, la atención del modelo se degrada y la información importante queda sepultada. Los modelos consistentemente pasan por alto información ubicada en medio de contextos largos, un fenómeno bien documentado llamado «perdido en el medio».)
Una advertencia honesta sobre mi propio enfoque, porque esa fuente lo socava si la lees con cuidado. Griciūnas describe una arquitectura de tres niveles en la que el descubrimiento cuesta ~80 tokens y el cuerpo se carga solo al activarse — así que, para la mayoría de las skills, un cuerpo pesado no representa un costo en cada sesión. Es distinto para esta skill en particular: se invoca por nombre, como comando de barra, al comienzo del trabajo. Aquí la activación es cada sesión. Eso hace que el número sea real para mi caso y no generalizable al tuyo, una distinción que pasé por alto la primera vez que escribí este párrafo.
Esta es la parte que me hizo reír a carcajadas. La sección 4 de ese archivo de skill se titula «Situational playbooks (progressive disclosure)» (Traducción: «Guías situacionales (divulgación progresiva)»). Explica, con detalle, que no debes cargar contexto que no necesitas — y luego incluye en línea los nueve cuerpos completos de los playbooks, 8.410 bytes, el 36% de cada sesión, sin importar si la tarea coincide o no. El documento que predicaba la divulgación progresiva era la mayor violación de ese principio en todo el repositorio.
Lo que hice al respecto — y por qué recortar era la solución equivocada
La respuesta obvia es borrar algunas palabras. No hice eso, porque un recorte vuelve a crecer. Acababa de ver cómo este archivo ganaba un 38% en once días, una fila razonable a la vez, cada una justificada. Nada en el sistema hacía visible el costo de una fila nueva en el momento en que alguien la agregaba.
Así que, en vez de recortar, sometí el archivo a una prueba de peso. Ahora una prueba fija su tamaño y rechaza cualquier presupuesto que supere en más de un 10% el tamaño real (un presupuesto con margen es decoración, no un límite), y hace fallar la compilación si el archivo crece. Está permitido subir el número — pero tiene que suceder en un diff, con una razón, donde un revisor lo vea. No se resuelve la acumulación con fuerza de voluntad; se resuelve haciendo explícita la contrapartida en el momento en que ocurre.
Lo descubrí en menos de una hora. Agregué una fila documentando el nuevo comando `satellite-sync`, me pasé por 363 bytes, y la compilación se puso en rojo. Según mi propia regla tuve que pagar por eso, así que comprimí dos verbosas lápidas de “esta funcionalidad no existe” y recorté un aparte histórico. El archivo se redujo por primera vez en su vida. Después hice el trabajo real — moví los nueve cuerpos de playbooks a archivos separados que se cargan al coincidir el disparador, dejando un índice de disparador, resumen de una línea, y ruta.
22.833 → 17.681 bytes. Un recorte del 22,6%, unos 1.300 tokens recuperados en cada sesión, sin borrar nada: una prueba complementaria falla si el índice apunta a un archivo faltante, o si los cuerpos extraídos se reducen por debajo de un piso mínimo. Una ganancia de tokens lograda a costa de tirar lecciones ganadas con esfuerzo no es una ganancia, y la prueba es lo que me impide tomar ese atajo cuando estoy cansado.
La otra mitad: los punteros que se habían echado a perder en silencio
La misma auditoría se volcó hacia afuera. Cada uno de mis metarrepositorios integra proyectos externos bien calificados como satélites: un puntero más un resumen fijado por SHA, nunca un fork. La regla de la casa, escrita hace mucho tiempo, es que «la frescura se mide, no se promete».
Era una promesa. De 131 satélites externos, 76 (58%) no tenían ningún SHA fijado, así que la deriva era indetectable por construcción. Un repositorio tenía 59 de ellos, con cero fijados. Luego revisé los primeros 40 satélites que sí tenían una fijación contra la cual revisar — la deriva solo es medible contra uno — y encontré 18 que se habían movido más allá de ese punto, incluido el repositorio semilla alrededor del cual se había construido toda la colección, más 15 que ya no cumplían los criterios de admisión: uno inactivo durante 111 días, otro durante 180, otro durante 468 días y que se quedó en 225 estrellas frente a un mínimo de 500 estrellas para el que nadie había registrado una excepción.
Mi primer conteo de la flota también estaba mal, y quiero dejar constancia de eso. Reporté “178
satélites, 124 sin fijar” antes de notar que tres tipos distintos de cosas comparten el mismo nombre de archivo
registry.yml: satélites externos reales, el inventario interno de habilidades propio de un repositorio, y
una lista de mis propios componentes. Dos de los repositorios se apuntaban a sí mismos. El número
corregido es 131 satélites externos, de los cuales 55 estaban fijados y 76 no.
Esos dos conteos no se restan de forma limpia, y la discrepancia es reveladora. Al pasar de 178/124
a 131/76 se eliminan 47 entradas, pero solo 48 sin fijar — así que el total de
satélites fijados subió en uno,
durante lo que yo había descrito como una corrección puramente sustractiva. Subió porque la segunda
pasada corrigió dos cosas, no una: la población y la definición. Mi primer script contaba una entrada como
fijada solo si llevaba una clave llamada literalmente «pinned_sha». Un satélite registraba su fijación
como head_sha«pin»pinned_sha, así que había estado fijado todo ese tiempo y yo lo había contado
como una brecha.Una medición que no has intentado refutar es solo un número que te gusta —
incluyendo, resulta, la ya corregida.
Patrones y antipatrones
Antipatrón: la marca ambigua. Un solo indicador que representa «verificado, todo bien» y «no pude verificar» de forma idéntica. Cada uno de mis cuatro fallos tenía uno.
Patrón: haz que el estado saludable sea ruidoso. Emite un latido cuando las cosas funcionan y da alarma cuando falta. Esto es el interruptor de hombre muerto, y es la única construcción que convierte el silencio en información.
Antipatrón: contar las ejecuciones manuales como si la cadencia funcionara. Revisa el tipo de disparador, no solo el resultado. Una persona presionando el botón es justo lo que intentabas eliminar.
Patrón: nunca dejes que «no puedo saberlo» salga como éxito. Lo desconocido no es un pase. Si una verificación no puede acceder a su evidencia, debe fallar de forma ruidosa e indicar qué evidencia no pudo alcanzar.
Antipatrón: arreglar la acumulación con una limpieza puntual. Un recorte de una sola vez de lo que sea — prompt, configuración, lista de dependencias, invitación a una reunión — vuelve a crecer, porque las fuerzas que lo hicieron crecer siguen intactas. Presupuéstalo en cambio, y haz que el presupuesto haga fallar la compilación si se excede.
Patrón: separa “no pude revisar” de “ya no está.” Mi verificador de satélites corta en seco cualquier otra prueba cuando un origen externo no está disponible, porque un 403, de otro modo, se ve exactamente igual que cero estrellas, cero commits y ninguna actividad — es decir, igual que un repositorio que debería eliminarse. El error más peligroso en una herramienta de auditoría es actuar con confianza sobre datos ausentes.
El mecanismo
Todos estos fallos tienen la misma forma. Hay un canal que transporta una señal —una insignia, un panel, un código de salida, una palabra como «fusionado»— y ese canal tiene un valor predeterminado que emite cuando nada lo está impulsando. Ese valor predeterminado es casi siempre el tranquilizador: verde, cero, vacío, silencio. Los sistemas están construidos para estar en silencio cuando están inactivos, y «inactivo porque está sano» se representa igual que «inactivo porque está muerto».
Así que el mecanismo del error no es la negligencia. Es una colisión de codificación: dos estados del mundo se transmiten con un mismo símbolo, y quien recibe no tiene forma de decodificar cuál fue el que se envió. Ser más cuidadoso no puede arreglar una colisión de codificación. Solo agregar un bit puede hacerlo.
El primer principio
Cualquier monitor que pueda fallar y producir la misma observación que un éxito no es un monitor; haz que el estado sano emita una señal, para que la ausencia se vuelva inequívoca.
Lo que hacemos ahora, y lo que hacemos de forma proactiva
Las retrospectivas salen baratas. Esto es lo que realmente cambió, y lo que cualquier lector puede copiar.
Ahora, ya en producción: una auditoría semanal de la flota que puntúa cada repositorio en seis dimensiones, donde una de las dimensiones es la vigencia del trabajo programado — lee el historial de ejecuciones de cada flujo de trabajo programado por cron y exige una ejecución cuyo disparador haya sido el horario programado y cuya conclusión haya sido exitosa. Las ejecuciones manuales explícitamente no cuentan. Un endpoint de despliegue que publica el commit que está sirviendo, y un verificador que sale con código distinto de cero cuando no puede confirmarlo. Un escaneo estático de errores tragados que encontró 43 en un repositorio, de los cuales los dos que muestreé eran ambos reales: un registro contable dañado que en silencio se leía como “sin decisiones”, y una llamada de permisos cuyo fallo habría dejado credenciales en un directorio legible. Presupuestos de tamaño en los archivos de instrucciones. Una sincronización de satélites que propone, y nunca ejecuta, eliminaciones.
De forma proactiva, las reglas que ahora aplico antes de lanzar cualquier automatización:
1. Antes de agregar un trabajo programado, verifica los que ya tienes. Esta es la verificación con el mayor
retorno por esfuerzo de todo este artículo, y me tomó cuatro minutos. Enumera tus flujos de trabajo programados por cron,
filtra su historial de ejecuciones por event == "schedule" y conclusion == "success",
y revisa la más reciente. Predigo que encontrarás al menos uno que nunca se ha disparado. Haz esto
antes de agregar otro, o estarás construyendo sobre un piso que no has probado.
2. Programa fuera de la hora en punto. Cron en :00 es la hora en la que todos los planificadores del
mundo se saturan y empiezan a perder tareas. No cuesta nada elegir :20.
3. Enruta el fallo hacia un lugar donde un humano ya suela mirar. Un cuadrado rojo en una pestaña que nadie abre es silencio con pasos extra. El nuestro abre y actualiza un único issue —uno solo, actualizado en el mismo lugar—, porque un issue nuevo cada semana te entrena para ignorar los issues.
4. Haz que toda compuerta rechace por ignorancia. En nuestra auditoría, una dimensión obligatoria que está sin medir falla exactamente igual que una que está rota. La escalabilidad, honestamente, no podemos medirla hoy, así que se marca como no medible y se excluye del puntaje, en lugar de asignarle un indicador falso. Una compuerta que pasa porque nadie miró es el verde falso que todo esto existe para evitar.
5. Ajusta el trinquete, no recortes. Todo lo que limpies, fíjalo como presupuesto en una prueba ese mismo día. De lo contrario, en once días estarás de vuelta al mismo lugar.
6. Cuando tu herramienta se equivoca, escribe el error donde vive la herramienta. Nuestra guía de trabajo ahora lleva un registro de autoprueba con las seis cosas que la nueva auditoría hizo mal en su propia primera corrida: el escáner de secretos que marcó sus propios archivos de prueba, el chequeo de independencia que se marcó a sí mismo porque su propia expresión regular contenía las palabras que estaba buscando. Un detector que falla su propia prueba es un detector en el que nadie confía, y un falso positivo que sobrevive es cómo termina apagándose un chequeo.
Voy a cerrar con el borde honesto. Todo lo anterior ya se mide, y nada de esto está terminado.
Actualización, 2026-08-04 — este artículo estuvo mal en menos de un día
El párrafo que estaba aquí decía que el nuevo flujo de trabajo semanal todavía no había tenido una corrida programada y que su primera oportunidad estaba a varios días. Ya se había ejecutado. El cron decía lunes 16:20 UTC; GitHub lo ejecutó a las 18:05, con una hora y tres cuartos de retraso, y yo revisé de la manera equivocada y concluí que no se había ejecutado en absoluto. Así que la corrección es: sí se ejecutó, y falló.
Falló por dos razones, y ambas son la propia tesis de este artículo mordiendo al artículo. Primero, la
línea base contra la que se ajusta el trinquete se capturó en mi laptop, indexada por nombres de directorios locales, mientras que
el trabajo audita nombres de repositorios de GitHub, así que AnyAgent y anyagent se leyeron como dos
proyectos distintos, y el repositorio insignia pareció una llegada completamente nueva que fallaba en dos dimensiones.
Dos nombres para una misma cosa. Segundo, y peor: el paso que reporta hallazgos a un humano pasó una
etiqueta--label que no existe, y yo había escrito esa llamada para que ignorara su propio código de salida.
Así que la auditoría corrió, encontró diez regresiones, y no le avisó a nadie. El trabajo diseñado para detectar
fallos silenciosos falló en silencio, justo en el paso cuya única función era no hacerlo.
Ambos problemas están resueltos: ahora las claves de repositorio se comparan sin distinguir mayúsculas y minúsculas, la línea base se regenera a partir de la ejecución en CI en lugar de mi laptop, el paso que reporta hallazgos elimina la etiqueta y lanza un error ante cualquier código de salida distinto de cero, y un paso posterior verifica que el issue realmente exista antes de que la ejecución pueda aprobarse. Los setenta y seis satélites sin fijar ahora están fijados —setenta y cuatro subidos, dos confirmados solo localmente porque ese repositorio no tiene remoto. El archivo de skill sigue siendo un monolito en las partes que no he dividido. Y este es justamente el punto de esta actualización: publiqué una afirmación sobre el silencio y me equivoqué por no comprobarlo, que es exactamente el modo de falla del que trata este artículo.
Publico el número en lugar de la intención, porque la lección de toda la semana es que las intenciones y el silencio se ven igual desde afuera.
Referencias
- Ewaschuk, R. (2016). “Monitoring Distributed Systems.” En B. Beyer, C. Jones, J. Petoff & N. R. Murphy (Eds.), Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. sre.google/sre-book/monitoring-distributed-systems (consultado el 4 de agosto de 2026).
- PromLabs. (s.f.). “End-to-End Watchdog Alerts.” Monitoring and Debugging Prometheus. training.promlabs.com (consultado el 4 de agosto de 2026).
- Vercel. (s.f.). “Limits — Deployments.” Vercel Documentation. vercel.com/docs/limits (consultado el 5 de agosto de 2026).
- Griciūnas, A. (11 de marzo de 2026). “Agent Skills: Progressive Disclosure as a System Design Pattern.” SwirlAI Newsletter. newsletter.swirlai.com (consultado el 4 de agosto de 2026).
Escrito por Paul Jialiang Wu. Las mediciones provienen de mis propios repositorios, tomadas entre el 2 y el 4 de agosto de 2026. Cada cita de este artículo fue verificada palabra por palabra contra su fuente.