AI-NATIVE SERIES · HARNESS ENGINEERING
침묵은 상태가 아니다
1분
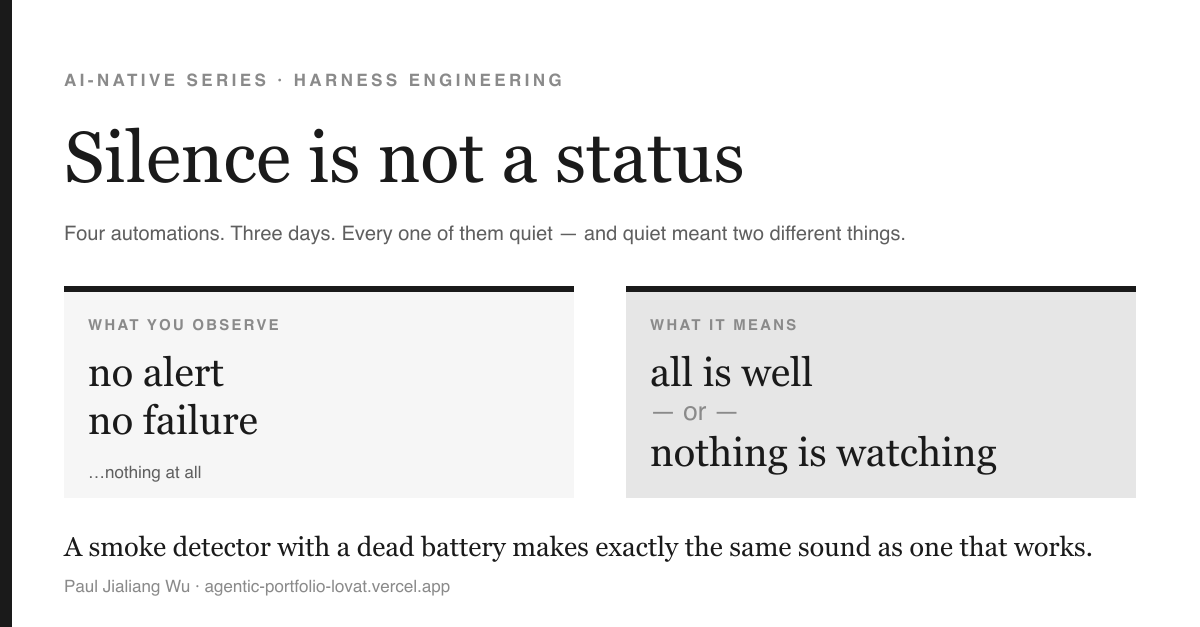
사흘에 걸쳐 나는 조용해진 자동화 네 개를 발견했다. 조용함은 건강한 시스템의 모습이기도 하고, 죽은 시스템의 모습이기도 하다. 어느 대시보드는 그것을 채울 수 있는 유일한 명령어가 한 번도 실행된 적이 없어서 비어 있었다. 어느 주간 작업은 실패한 스케줄을 수동 클릭이 덮어써서 초록색으로 표시되었다. 병합된 풀 리퀘스트 세 건은 배포 쿼터가 조용히 빌드를 멈춰버린 탓에 실제로는 반영되지 않았다. 그리고 마지막 문제를 잡아내라고 내가 작성한 검사기는 “skipping”을 출력하고 success로 종료되었다. 해결책은 경계심이 아니다. 배터리가 죽은 화재경보기는 정상 작동하는 것과 정확히 같은 소리를 낸다. 그러니 정상 작동 상태를 시끄럽게 만들어야 한다 — “아직 살아있음”을 뜻하는 신호음을 울리게 하면, 그때부터 침묵은 오직 고장만을 의미할 수 있게 된다. 모니터링 팀들은 이것을 10년 전부터 데드맨 스위치(dead man’s switch; 이 패턴을 자기 자신의 에이전트 하네스에 적용하는 사람은 거의 없다.
그 주를 숫자 하나로 요약하면
넷. 사흘 동안, 내가 소유하고 강박적으로 감사(監査)하는 코드베이스 전체에서 나는 자기 일을 멈췄으면서도 아무에게도 알리지 않은 독립적인 자동화 네 개를 발견했다. 그중 어느 것도 에러를 던지지 않았다. 그중 어느 것도 대시보드를 빨갛게 만들지 않았다. 내가 그것들을 감시하려고 만든 모든 신호로 보면, 넷 다 완벽하게 작동하는 시스템처럼 보였다.
여기서 창피함을 정확히 짚고 넘어가고 싶다. 교훈이 바로 그 창피함 안에 있기 때문이다. 나는 물려받은 낡은 시스템을 이야기하고 있는 게 아니다. 넷 다 내가 직접 만들었다. 그중 둘은 바로 그 주에 내가 배포한 것이고, 그중 하나는 바로 이런 종류의 버그를 잡기 위해 내가 특별히 작성한 도구였다.
멘탈 모델: 죽어가는 소리를 절대 들을 수 없는 배터리
배터리가 죽은 화재경보기는 정상 작동하는 화재경보기와 정확히 같은 소리를 낸다: 무음. 삐 소리가 없다는 것은 집이 안전하다는 증거가 아니다. 그것은 아무것도 아니라는 증거일 뿐이다 — 두 세계에서 관찰값이 동일하기 때문이다.
이것이 이 글의 핵심이다. 이 글에서 단 하나만 가져가야 한다면 이것을 가져가라: 침묵은 상태가 아니다. 침묵은 상태의 부재일 뿐이며, 당신의 뇌는 그 공백을 당신이 원하는 해석으로 친절하게 채워준다. 당신이 소유한 모든 자동화는 겉에서 보기에 똑같아 보이는 두 가지 상태를 갖는다 — 실행 중이며 아무것도 찾지 못한 상태와 실행되지 않은 상태 — 그리고 이 둘을 구분하기 위한 구체적인 작업을 해두지 않았다면, 당신은 지금 어느 쪽에 있는지 알 수 없다.
이게 어려운 이유는 기술적인 게 아니다. "아무 일도 일어나지 않았다"는 것이 정보처럼 느껴진다는 게 문제다. 그것은 정보가 아니다.
실제로 발견한 것들
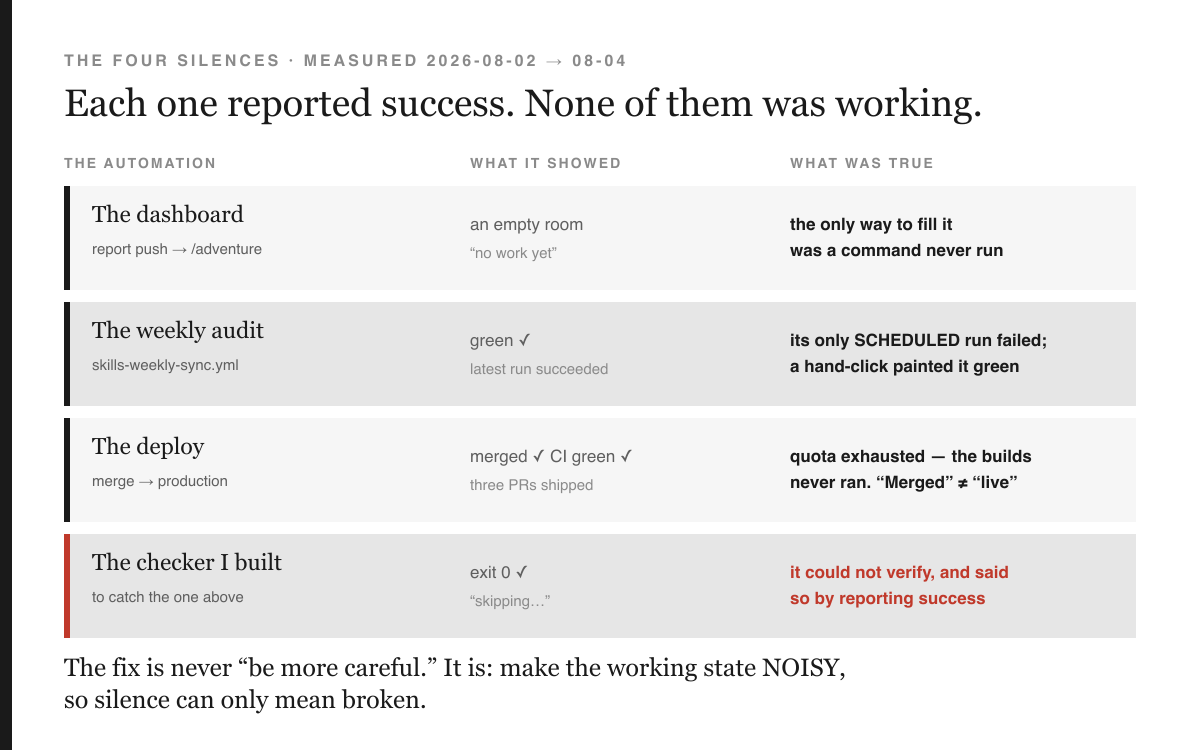
하나: 구조적으로 채워질 수 없었던 대시보드. 나는 CLI 명령이 푸시하는 데이터를 받도록 연결된 개인용 성적표 대시보드를 만들었다. 그 명령에는 비밀 토큰이 필요하다. 이 토큰은 Vercel Sensitive 환경 변수로 저장되는데, 이는 그것을 다시 읽어올 수 없다는 뜻이다 — vercel env pull 는 그 값에 대해 빈 문자열을 반환한다. 그래서 그 푸시는 오직 그 암호를 아는 단 한 명의 인간이 손으로 실행할 때만 가능했고, 이 기능이 존재한 몇 주 동안 실행된 횟수는 zero times. 방은 잠긴 채 비어 있었다. 비어 있다는 것은
고장난 것과 구분되지 않는다. 그런데도 나는 세 번이나 이걸 보고하면서, 정작 내가 책임져야 할 병목을 버그로 다루는 대신
동료에게 넘기면 되는 한 줄짜리 작업이라고 말했다.
둘: 한 번도 실행된 적 없는 주간 작업. 나는 저장소에 있는 모든 cron 예약 워크플로의 실행 이력을 확인했다. 야간 작업은 정말로 건강했다: 예약된 실행 다섯 번 중 다섯 번이 성공했다. 문제는 주간 작업 두 개였다. 하나는 이력에 예약 실행이 단 한 번뿐이었는데 그 실행마저 실패했다. 이후 수동으로 재실행해서 성공했기 때문에, 워크플로 목록, 작은 초록색 체크, 배지 같은 모든 요약 화면에는 그 워크플로가 통과한 것으로 표시됐다. 다른 하나는 평생 실행이 세 번뿐이었는데, 전부 사람이 버튼을 눌러서 발생한 것이었다.
이것이 넷 중 가장 미묘한 지점이니, 잠시 곱씹어 보자: 수동 실행은 정확히 그 주기(cadence)가 대체하려고 존재하는 바로 그것이며, 동시에 고장난 주기를 멀쩡해 보이게 만드는 바로 그것이다. 자동화는 자동화되고 있지 않았다. 사람이 수작업으로 그 일을 대신하고 있었다는 사실이야말로, 아무도 자동화가 멈췄다는 것을 눈치채지 못한 이유였다.
셋: 머지됐다고 해서 배포된 것은 아니었다. 풀 리퀘스트 세 개가 머지됐고, 셋 다 CI는 초록불이었는데, 배포된 사이트는 몇 시간 동안 계속 예전 빌드를 서빙하고 있었다. 호스팅 무료 티어는 프로덕션 배포를 하루 100회로 제한한다(Vercel, n.d.). 그 한도를 넘으면 머지는 성공하고, 체크도 통과하는데, 아무것도 배포되지 않는다. 어디에도 빨간불은 뜨지 않는다. “머지됐다”는 말은 어느새 조용히 “배포됐다”라는 의미가 아니게 되어 있었고, 내가 가진 모든 습관은 이 두 단어가 동의어라는 전제 위에 세워져 있었다.
넷: 판단할 수 없는데도 성공을 보고한 체커. 세 번째 문제를 발견하고
나서, 나는 방어 장치를 하나 만들었다: 실제로 트래픽을 서빙 중인 커밋 SHA를 게시하고, 그것을 origin/main와 비교해서,
다르면 실패 처리하는 것이다. 좋다. 그런데 그걸 실행했더니 · the
deployment reports no commit SHA — skipping가 출력되고 exit 코드는 0이었다.
나는 조용한 실패를 잡기 위한 탐지기를 만들었는데, 정작 그 탐지기 자신의 실패 모드가 조용히 실패하는 것이었다. 그것은 답을 판단할 수 없자, 그냥 좋은 쪽 답을 보고해버렸다. 초록불 파이프라인 안에서는, “I could not check”와 “I checked and it is fine”가 똑같은 체크 표시로 나타난다.
왜 아무도 눈치채지 못했나: 초록불을 칠하는 수동 실행
넷 중 셋은 같은 메커니즘을 공유하는데, 이건 이름을 붙여둘 가치가 있다. 당신의 시스템에도 똑같이 있을 것이기 때문이다. 각각의 경우, 휴먼 액션이 자동화된 액션과 똑같은 관측 신호를 만들어냈다 — 그리고 사람들이 실제로 보는 것은 그 관측 신호뿐이다.
누군가 “run workflow”를 클릭했고 배지는 초록색이 되었다. 누군가 푸시 명령을 직접 실행했다면 대시보드는 채워졌을 것이다. 누군가 “merged”라는 단어를 읽고 “배포됨”이라고 추론했다. 수동 경로와 자동 경로가 하나의 지표로 수렴하고, 그 지표는 어느 경로가 자신을 만들어냈는지 알려주지 않는다. 자동화는 조용히 썩어가고, 인간은 조용히 그 빈자리를 메우며, 대시보드는 결코 색을 바꾸지 않는다.
업계는 이미 이 문제를 풀어놓았는데, 나는 내 분야의 문헌조차 읽지 않았다
이 중 새로운 것은 하나도 없다. 모니터링 팀들은 2010년대에 이미 이 문제에 부딪혔고, 구체적이고 따분하지만 훌륭한 답을 내놓았다.
Google의 Site Reliability Engineering 중 모니터링을 다룬 장에서, 저자 Rob Ewaschuk는 화려하지 않은 원칙 하나를 고집한다: “Rules that generate alerts for humans should be simple to understand and represent a clear failure” (번역: 사람에게 경보를 발생시키는 규칙은 이해하기 쉽고 명확한 실패를 나타내야 한다) (Ewaschuk, 2016). 그가 밝힌 이유는 신호 대 잡음비와 견고성이다 — 페이징 경로는 틀려서는 안 되는 부분이기 때문에 단순해야 한다. 나라면 여기에 내 나름의 이유를 하나 더 보태겠다: 그것은 또한 당신의 경보 시스템으로는 디버깅할 수 없는 유일한 경로이기도 하다는 것이다. 다만 그 장이 무엇을 주고 무엇을 주지 않는지 정직하게 말하자면: 그 안에는 침묵의 모호성에 관한 내용이 전혀 없다. 내가 직접 확인했다. 아래의 답은 Google의 것이 아니다.
그리고 침묵의 모호성에 정면으로 답하는 패턴이 바로 워치독(watchdog)이다. PromLabs는 이를 이렇게 설명한다: “a watchdog alert (also sometimes called a ‘dead man’s switch’, sentinel alert, beacon alert, or heartbeat alert) that helps you continuously test your entire alerting pipeline from beginning to end” (번역: 워치독 경보란 — '데드맨 스위치', 센티널 경보, 비컨 경보, 하트비트 경보라고도 불리며 — 경보 파이프라인 전체를 처음부터 끝까지 지속적으로 테스트할 수 있게 해주는 경보다) (PromLabs, n.d.). 이 메커니즘은 아름다운 역발상이다: 모든 것이 정상일 때 끊임없이, 영원히 울리는 경보 하나를 만들어, 그것을 당신의 스택 바깥에 있는 서비스로 보낸다. PromLabs는 이렇게 쓴다. “When anything in your alerting pipeline breaks, the external service will then notice that no more alert notifications are coming in and will send you a notification about it.”(번역: 경보 파이프라인 어딘가가 고장 나면, 외부 서비스는 더 이상 경보 알림이 들어오지 않는다는 것을 감지하고 당신에게 그 사실을 알려준다.)
스모크 디텍터를 염두에 두고 다시 읽어보라. 다른 모든 경보는 무언가 고장 났을 때 울린다. 이것은 아무것도 고장 나지 않았을 때 울린다 — 그래서 침묵 자체가 실패 신호가 된다. 정상 상태를 시끄러운 상태로 만듦으로써, 모호했던 관측을 명확한 관측으로 바꿔놓은 셈이다.
나는 몇 달째 에이전트 하네스를 만들어오면서도, 프로덕션 클러스터에서라면 당연하다고 말했을 그 패턴을 내 자신의 자동화에는 단 한 번도 적용하지 않았다. 그 이유는, 개인용 하네스는 인프라처럼 느껴지지 않기 때문인 것 같다. 그것은 그저 몇 개의 YAML 파일과 CLI일 뿐이다. 하지만 당신이 의지하는 크론 작업은 엄연히 인프라이고, 유료 인프라와 똑같이 부식된다.
두 번째 발견: 나는 엉뚱한 밧줄의 무게를 재고 있었다
같은 주에 내 협업자가 다른 개선안을 제기했다: 지금처럼 강력한 프론티어 모델을 쓰는 상황에서는 긴 시스템 프롬프트가 더 이상 자산이 아니라 부채가 되었으니 — 줄이자는 것이었다.
그의 말이 맞았고, 나는 이미 그것을 증명해 놓은 상태였다는 점이 흥미롭다. 몇 달 전 나는 전체 프롬프트, 세 줄짜리 최소 프롬프트, 프롬프트 없음이라는 세 가지 조건으로 세 모델에 걸쳐 절제 실험(ablation)을 진행했다. 여섯 개의 역량 테스트는 충족된 검증 항목의 비율로 결정론적으로 채점했고, 그 외 인젝션 테스트 네 개는 통과/실패로 채점했다. 세 조건의 결과 전체는 다음과 같다:
| 프롬프트 조건 | Sonnet-5 | Opus-5 | Haiku-4.5 (약한 대조군) |
|---|---|---|---|
| 전체 (161단어) | 100.0% | 100.0% | 88.9% |
| 최소 (3줄) | 100.0% | 100.0% | 96.7% |
| 없음 (빈 프롬프트) | 100.0% | 100.0% | 96.7% |
프론티어 모델들은 프롬프트가 있든 아예 없든 100%로 평평하다. 약한 대조군은 프롬프트가 있을 때 오히려 없을 때보다 더 낮은 점수를 기록했다, 최소 조건과 없음 조건은 구별이 안 됐다. 기록된 결론은 단호했다: 프롬프트는 역량에 대한 대가를 치르고 있는 것이 아니고, 안전성에 대한 대가를 치르고 있는 것도 아니다. 선을 지키는 것은 하네스다. 도구 계층이 불법적인 동작을 애초에 거부하고, 애초에 호출할 수 있는 위험한 도구 자체가 없기 때문이다.
그렇다면: 동의하고, 줄이고, 끝? 아니다. 내가 절제 실험을 한 대상은 한 기능에 붙어 있는 881바이트짜리 프롬프트였을 뿐이기 때문이다. 실제로 매 세션마다 로드되는 프롬프트는 스킬 파일 — 에이전트에게 도구가 무엇을 할 수 있는지 알려주는 라우터 — 이다. 나는 이것을 측정해 본 적이 단 한 번도 없었다.
이 파일의 크기는 23,016바이트였다, 토큰으로 약 5,750개. 내가 그토록 공들여 실험했던 프롬프트의 스물여섯 배 크기였다. 그리고 11일 사이에 16,704바이트에서 23,016바이트로 늘어나 있었다 — 단 한 번의 축소도 없이 38% 증가한 것이며, 그중 약 1,700바이트는 바로 그날 내가 추가한 것이었다.
현재의 관행을 보면 이 비교는 내가 예상했던 것보다 더 날카로워진다. Agent Skills 컨벤션을 분석한 글에서 Aurimas Griciūnas는 “the median discovery cost is ~80 tokens per skill”(번역: 스킬 하나당 발견 비용의 중앙값은 약 80토큰이다)이라고 보고하면서 동시에 “body size ranges from ~275 tokens (internal-comms) to ~8,000 tokens (skill-creator), with a median around 2,000”(번역: 본문 크기는 약 275토큰(internal-comms)에서 약 8,000토큰(skill-creator)까지 분포하며 중앙값은 약 2,000토큰이다)이라고 밝힌다 (Griciūnas, 2026). 내 것은 중앙값의 2.9배였다. 같은 글은 그 대가가 무엇인지도 짚는다: “As context grows, the model’s attention degrades and important information gets buried. Models reliably miss information placed in the middle of long contexts, a well-documented phenomenon called ‘lost-in-the-middle.’”(번역: 컨텍스트가 늘어날수록 모델의 주의력은 저하되고 중요한 정보는 묻혀버린다. 모델은 긴 컨텍스트의 중간에 놓인 정보를 어김없이 놓치는데, 이는 '로스트-인-더-미들 (lost-in-the-middle)'이라는 이름으로 잘 알려진 현상이다.)
이 지점에서 내 논지에 대해 솔직한 단서 조항을 하나 달아야겠다. 출처를 꼼꼼히 읽어보면 오히려 내 주장을 약화시키는 대목이 있기 때문이다. Griciūnas는 3단 구조를 설명하는데, 여기서 탐색 비용은 ~80토큰이고 본문은 활성화될 때만 로드된다 — 즉 대부분의 스킬에서는 본문이 무거워도 매 세션마다 드는 비용이 아니라는 것이다. 하지만 이 스킬만큼은 사정이 다르다. 이 스킬은 작업을 시작할 때 슬래시 명령으로 이름을 지정해 호출된다. 여기서는 활성화가 곧 매 세션에서 일어난다. 그래서 이 수치는 내 사례에서는 실재하지만, 여러분의 경우로 일반화할 수는 없다 — 이 글을 처음 썼을 때는 이 구분을 얼버무리고 넘어갔었다.
여기서부터는 나도 모르게 웃음이 터진 대목이다. 그 스킬 파일의 4절 제목은 상황별 플레이북 (점진적 공개)이다. 이 절은 필요 없는 컨텍스트를 짊어지고 다니면 안 된다고 장황하게 설명한다. 그래 놓고 정작 아홉 개 플레이북 본문 전체를, 8,410바이트를, 전체 세션의 36%를, 작업 내용과 맞든 안 맞든 그대로 인라인으로 끼워 넣고 있었다. 점진적 공개를 설파하는 그 문서 자체가 저장소 안에서 그 원칙을 가장 크게 위반하는 사례였다.
내가 취한 조치 — 그리고 왜 '군살 빼기'가 잘못된 해법인가
가장 뻔한 대응은 단어를 좀 지우는 것이다. 나는 그렇게 하지 않았다. 잘라내 봐야 다시 불어나기 때문이다. 이 파일이 11일 만에 38% 불어나는 과정을 나는 방금 지켜봤다. 그럴듯해 보이는 줄이 한 줄씩 쌓였고, 매번 나름의 이유로 정당화됐다. 새 줄을 추가하는 순간 그 비용을 눈에 보이게 만드는 장치가 시스템 어디에도 없었다.
그래서 잘라내는 대신 이 파일을 저울 위에 올렸다. 이제 테스트 하나가 파일 크기를 고정해둔다. 실제 크기보다 10% 넘게 여유를 준 예산은 거부한다(여유 예산은 제한이 아니라 장식일 뿐이다). 파일이 커지면 빌드를 실패시킨다. 숫자를 올리는 것 자체는 허용된다 — 다만 반드시 diff 안에서, 이유와 함께, 리뷰어가 볼 수 있는 자리에서 일어나야 한다.축적은 의지력으로 해결할 수 없다. 거래가 일어나는 바로 그 순간에 그 거래를 명시적으로 드러냄으로써 해결하는 것이다.
한 시간도 안 돼 이 장치가 나를 붙잡았다. 새로운 satellite-sync 명령을 문서화하는 줄 하나를 추가했더니 363바이트를 초과했고, 빌드가 빨간불이 됐다. 내 규칙에 따라 그 대가를 치러야 했으므로, 장황한 '이 기능은 존재하지 않음' 묘비문 두 개를 압축하고 지난 이야기 한 토막을 잘라냈다. 파일이 생긴 이래 처음으로 줄어들었다. 그다음 진짜 작업에 들어갔다 — 아홉 개 플레이북 본문 전체를 트리거 매칭 시 로드되는 별도 파일로 옮기고, 트리거·한 줄 요약·경로로 이루어진 색인만 남겼다.
22,833 → 17,681바이트. 22.6% 감축, 세션마다 약 1,300토큰을 되찾았다. 그것도 아무것도 버리지 않고 이룬 결과다. 색인이 존재하지 않는 파일을 가리키거나 추출된 본문이 일정 크기 아래로 줄어들면 짝을 이루는 테스트가 실패하도록 해두었다. 힘들게 얻은 교훈을 내버려서 얻은 토큰 절감은 절감이 아니다. 그리고 내가 지쳐서 그런 지름길을 택하려 할 때 나를 막아주는 것이 바로 이 테스트다.
나머지 절반: 조용히 썩어가던 포인터들
같은 감사(監査)가 이번엔 바깥을 향했다. 내 메타 레포들은 저마다 평가가 높은 외부 프로젝트들을 '위성(satellites)'로 편입시키는데, 이는 포크가 아니라 포인터에 SHA로 고정된 다이제스트를 붙이는 방식이다. 오래전에 적어둔 원칙은 "신선도는 측정되는 것이지, 약속되는 것이 아니다"였다.
그것은 약속에 그쳤다. 외부 위성 131개 중 76개(58%)는 SHA 고정이 아예 없었다. 드리프트는 구조적으로 감지 자체가 불가능했던 셈이다. 어느 저장소 하나는 그런 위성을 59개나 품고 있었는데, 고정된 것은 0개였다. 이어서 나는 고정되어 있어 대조 가능한 위성 40개를 확인했다 — 드리프트는 오직 그런 것들에 대해서만 측정 가능하니까 — 그 결과 18개가 이미 고정 지점을 지나쳐버렸다는 것을 발견했는데, 여기에는 이 컬렉션 전체가 기반으로 삼은 시드 저장소도 포함돼 있었다. 게다가 더 이상 채택 기준을 충족하지 못하는 것도 15개 있었다: 하나는 111일, 하나는 180일, 하나는 468일 동안 활동이 없었고 그리고 별 225개로 500개 기준에 못 미치는데도 아무도 예외 처리를 기록해두지 않은 경우까지 있었다.
전체 목록 집계도 처음에는 틀렸는데, 이 부분도 그대로 남겨두고 싶다. 나는 “위성 178개, 그중 미고정 124개”라고 보고했다가, 세 가지 서로 다른 종류의 대상이
registry.yml 파일명을 공유한다는 사실을 뒤늦게 알아챘다: 진짜 외부 위성, 어느 레포 자체의 내부 스킬 인벤토리, 그리고 내 컴포넌트 목록. 레포 두 개는 자기 자신을 가리키고 있었다. 정정된 수치는 외부 위성 131개, 그중 고정된 것 55개, 고정되지 않은 것 76개다.
이 두 집계는 뺄셈이 딱 맞아떨어지지 않는데, 그 어긋남이 의미심장하다. 178/124에서 131/76으로 가면서 항목 47개가 빠졌는데 미고정 항목은 48개만 줄었다 — 즉 고정된 항목 총계는 오히려 하나 늘었다, 순전히 빼기만 하는 정정이라고 내가 설명했던 바로 그 작업에서. 늘어난 이유는 두 번째 작업이 한 가지가 아니라 두 가지를 고쳤기 때문이다: 대상 집합 그리고 정의. 첫 번째 스크립트는 어떤 항목이 문자 그대로 이름 붙은 키 head_sha를 갖고 있어야만 고정된 것으로 셌다. 그런데 어떤 위성은 자기 고정값을 pinned_sha이라는 이름으로 기록해두고 있었다. 그래서 그 위성은 계속 고정되어 있었는데도 나는 그것을 빠진 항목으로 잘못 센 것이다.스스로 반증해보려 한 적 없는 측정값은 그저 마음에 드는 숫자일 뿐이다 — 정정된 숫자도 예외는 아니었다.
패턴과 안티패턴
안티패턴: 모호한 체크 표시. “확인해보니 문제없음”과 “확인할 수 없었음”을 똑같이 렌더링하는 단일 지표. 내가 겪은 네 가지 실패 모두 이런 지표를 하나씩 갖고 있었다.
패턴: 건강한 상태를 시끄럽게 만들라. 정상 작동 중일 때 심장박동 신호를 내보내고, 그 신호가 없을 때 경보를 울려라. 이것이 데드맨 스위치(dead man's switch)이며, 침묵을 정보로 바꾸는 유일한 구성이다.
안티패턴: 수동 실행을 주기가 작동한 것으로 치는 것. 결과만이 아니라 트리거 유형을 확인하라. 사람이 버튼을 누르는 것이야말로 애초에 없애려던 그 행위다.
패턴: “확인할 수 없음”을 성공 종료 코드로 빠져나가게 두지 말라. 알 수 없음은 통과가 아니다. 어떤 체크가 근거 자료에 접근하지 못한다면, 크게 실패를 알리고 어떤 근거에 접근하지 못했는지 밝혀야 한다.
안티패턴: 대청소로 누적 문제를 해결하려는 것. 프롬프트든, 설정이든, 의존성 목록이든, 회의 초대 목록이든, 무언가를 한 번 정리하는 것은 다시 자라난다. 그것을 키운 힘이 그대로 남아 있기 때문이다. 대신 예산을 정하고, 그 예산이 초과되면 빌드가 실패하게 만들어라.
패턴: “확인할 수 없음”과 “사라졌음”을 구분하라. 내 새틀라이트(위성) 체커는 업스트림에 접근할 수 없을 때 다른 모든 테스트를 즉시 중단시킨다. 그렇지 않으면 403 에러가 별점 0개, 커밋 0개, 활동 0개인 상태 — 즉 삭제해야 마땅한 저장소 — 와 정확히 똑같아 보이기 때문이다. 감사 도구에서 가장 위험한 버그는 누락된 데이터를 두고 자신 있게 행동하는 것이다.
메커니즘
이 실패들은 하나같이 같은 형태를 띤다. 신호를 실어 나르는 채널이 있다 — 배지, 대시보드, 종료 코드, “merged” 같은 단어 — 그리고 그 채널에는 기본값이 있어서, 아무것도 그것을 구동하지 않을 때 이 값을 내보낸다. 그 기본값은 거의 언제나 안심시키는 쪽이다: 초록, 0, 빈 상태, 조용함. 시스템은 유휴 상태일 때 조용하도록 만들어지며, 건강해서-조용한 상태와 죽어서-조용한 상태가 똑같은 방식으로 표현된다.
이 버그의 메커니즘은 부주의가 아니다. 이것은 인코딩 충돌이다: 세상의 서로 다른 두 상태가 하나의 기호로 전송되고 있고, 수신자는 어느 쪽이 보내졌는지 해독할 방법이 없다. 더 조심한다고 인코딩 충돌이 고쳐지지는 않는다. 비트를 하나 추가해야만 고쳐진다.
제1원칙
성공과 관측 결과가 똑같아지는 방식으로 실패할 수 있는 모니터는 모니터가 아니다. 건강한 상태가 신호를 내보내게 만들어서, 침묵이 모호하지 않게 하라.
지금 우리가 하는 일, 그리고 앞으로 선제적으로 하는 일
회고는 값싸다. 실제로 무엇이 바뀌었는지, 그리고 독자가 그대로 따라 할 수 있는 것은 무엇인지 여기 적는다.
지금 배포된 것: 저장소 하나하나를 여섯 가지 차원에서 점수화하는 주간 함대 감사. 그 차원 중 하나가 바로 예약 작업의 생존 여부다 — 각 크론 워크플로의 실행 이력을 읽어서, 트리거가 스케줄이었고 결론이 성공이었던 실행을 요구한다. 수동 실행은 명시적으로 카운트되지 않는다. 실제로 서비스 중인 커밋을 게시하는 배포 엔드포인트, 그리고 검증할 수 없을 때 0이 아닌 값으로 종료하는 체커. 삼켜진 에러를 찾는 정적 스캔은 한 저장소에서 43건을 찾아냈는데, 내가 표본으로 살펴본 두 건 모두 실제 문제였다: “결정 없음”으로 조용히 읽히는 손상된 원장, 그리고 실패 시 자격 증명을 읽기 가능한 디렉터리에 남겨두었을 권한 호출. 프롬프트 파일에 대한 크기 예산. 제거를 제안만 할 뿐 절대 실행하지는 않는 새틀라이트 동기화.
선제적으로, 이제 어떤 자동화든 출시하기 전에 내가 적용하는 규칙들:
1. 예약 작업을 추가하기 전에, 이미 가진 것들부터 검증하라. 이것은 이 글 전체에서 노력 대비 가장 큰 수익을 주는 점검이며, 나에게는 4분이 걸렸다. 크론 워크플로 목록을 뽑아서, 실행 이력을 event == "schedule"와 conclusion == "success"로 필터링한 뒤,
가장 최근 실행을 확인하라. 최소 한 개는 한 번도 발동한 적이 없는 것을 발견하리라 예상한다. 다른 것을 더 추가하기 전에 이것부터 하라. 그러지 않으면 검증된 적 없는 바닥 위에 뭔가를 짓는 셈이다.
2. 정각을 피해 스케줄을 잡아라. 크론을 :00은 지구상의 모든 스케줄러가 한꺼번에 몰려서
작업을 떨어뜨리기 시작하는 시각이다. 대신 :20.
3. 실패는 사람이 이미 보고 있는 곳으로 보내라. 아무도 열어보지 않는 탭의 빨간 네모는 겉치레만 더한 침묵일 뿐이다. 우리 쪽은 이슈 하나를 열어서 그 자리에서 계속 업데이트한다 — 매주 새 이슈를 만들면 이슈를 무시하도록 스스로를 훈련시키는 셈이기 때문에, 딱 하나만 두고 제자리에서 업데이트한다.
4. 모든 게이트는 '알 수 없음'에 대해 통과를 거부하게 하라. 우리 감사 체계에서는, 측정이 안 된 필수 항목은 고장난 항목과 똑같이 취급되어 탈락한다. 솔직히 말해 확장성은 오늘날 우리가 측정할 수 없는 항목이라, 가짜 대리 지표를 붙이는 대신 측정 불가로 표시하고 점수에서 제외한다. 아무도 보지 않아서 통과되는 게이트야말로, 이 모든 장치가 막으려는 가짜 초록불이다.
5. 정리하지 말고 고정하라. 무엇을 정리하든, 정리된 값을 그날 바로 테스트 안에 예산으로 고정해 두어라. 그러지 않으면 11일 뒤에 똑같은 자리로 돌아와 있을 것이다.
6. 도구가 틀렸을 때는, 그 틀림을 도구가 사는 바로 그 자리에 적어두라. 우리 플레이북에는 이제 새 감사 체계가 첫 실행에서 스스로 틀렸던 여섯 가지 사례를 기록한 도그푸딩 로그가 딸려 있다 — 자기 자신의 테스트 픽스처를 적발해버린 시크릿 스캐너, 그리고 독립성 검사 자신을 적발한 독립성 검사가 그것인데, 후자는 검사에 쓰인 정규 표현식 자체에 검색 대상 단어가 들어 있었기 때문이다. 자기 자신을 적발한 셈이다. 자기 자신의 테스트에서 실패하는 검출기는 아무도 신뢰하지 않는 검출기이며, 살아남은 오탐(false positive)이야말로 검사가 결국 꺼지게 되는 경위다.
솔직한 결론으로 글을 맺겠다. 위의 모든 것은 이제 측정되고 있으며, 그중 어느 것도 끝난 것은 없다.
업데이트, 2026-08-04 — 이 글은 하루 만에 틀린 것으로 드러났다
여기 있던 문단은 새 주간 워크플로가 아직 예정된 실행을 한 번도 하지 않았고 첫 실행 기회는 며칠 뒤라고 적고 있었다. 그것은 이미 실행된 뒤였다. 크론 설정은 월요일 16:20 UTC였지만, GitHub는 그것을 18:05에, 그러니까 한 시간 사십오 분 늦게 실행했고, 나는 확인 방법을 잘못 짚어서 아예 실행되지 않았다고 결론지었다. 정정하자면: 그것은 실행되었고, 그리고 실패했다.
실패한 데는 두 가지 이유가 있는데, 둘 다 이 글의 주장이 이 글 자체를 겨눈
셈이다. 첫째, 고정된 값을 기준으로 대조하는 기준선(baseline)이 내 노트북에서, 로컬 디렉터리
이름을 키로 삼아 만들어진 반면, 실제 작업은 GitHub 저장소 이름을 감사하고 있었다 — 그래서
AnyAgent와 anyagent이 서로 다른 두 프로젝트로 읽혀버렸고, 플래그십 저장소는
두 항목에서 실패한 완전히 새로운 신규 진입자처럼 보이고 말았다.
이름 하나에 이름이 둘 붙은 셈이다. 둘째, 더 나쁜 것은: 결과를 사람에게 보고하는 단계가
존재하지 않는 --label 를 넘겼는데, 나는 그 호출이 자신의 종료 코드를 무시하도록
작성해두었다는 점이다. 감사는 실행되어 열 개의 회귀(regression)를 찾아냈지만, 아무에게도 알리지 않았다. 침묵하는 실패를 잡아내려고 만든 잡(job)이, 바로 그 지점에서 침묵하며 실패했다.
둘 다 고쳤다: 이제 레포지토리 키는 대소문자를 구분하지 않고 비교하고, 베이스라인은 내 노트북이 아니라 CI 실행에서 다시 생성하며, 리포팅 단계는 라벨을 없애고 0이 아닌 종료 코드에서 예외를 발생시키고, 그다음 단계는 실행이 통과되기 전에 이슈가 실제로 존재하는지 확인한다. 핀이 없던 76개의 새틀라이트(위성 저장소)는 이제 모두 핀이 붙었다 — 74개는 푸시했고, 2개는 해당 레포지토리에 원격 저장소가 없어서 로컬에만 커밋했다. 스킬 파일은 아직 분리하지 못한 부분에서는 여전히 하나의 거대한 덩어리다. 그리고 이번 업데이트가 바로 핵심이다: 나는 침묵에 관한 주장을 발표했는데, 그것이 틀렸다. 확인하지 않았기 때문에 틀린 것이었고, 이는 이 글이 다루는 바로 그 실패 양상 그대로다.
나는 의도가 아니라 숫자를 그대로 공개한다. 이번 주의 교훈 전체가, 의도와 침묵은 바깥에서 보면 똑같아 보인다는 것이었으니까.
참고문헌
- Ewaschuk, R. (2016). “Monitoring Distributed Systems.” In B. Beyer, C. Jones, J. Petoff & N. R. Murphy (Eds.), Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. sre.google/sre-book/monitoring-distributed-systems (2026년 8월 4일 접속).
- PromLabs. (n.d.). “End-to-End Watchdog Alerts.” Monitoring and Debugging Prometheus. training.promlabs.com (2026년 8월 4일 접속).
- Vercel. (n.d.). “Limits — Deployments.” Vercel Documentation. vercel.com/docs/limits (2026년 8월 5일 접속).
- Griciūnas, A. (2026, March 11). “Agent Skills: Progressive Disclosure as a System Design Pattern.” SwirlAI Newsletter. newsletter.swirlai.com (2026년 8월 4일 접속).
Paul Jialiang Wu 씀. 측정치는 모두 내 레포지토리에서 나온 것이며, 2026년 8월 2일부터 8월 4일 사이에 수집했다. 위의 모든 인용문은 원문과 대조해 그대로 검증했다.