AI-NATIVE SERIES · HARNESS ENGINEERING
Silence Is Not a Status
所要時間:一分
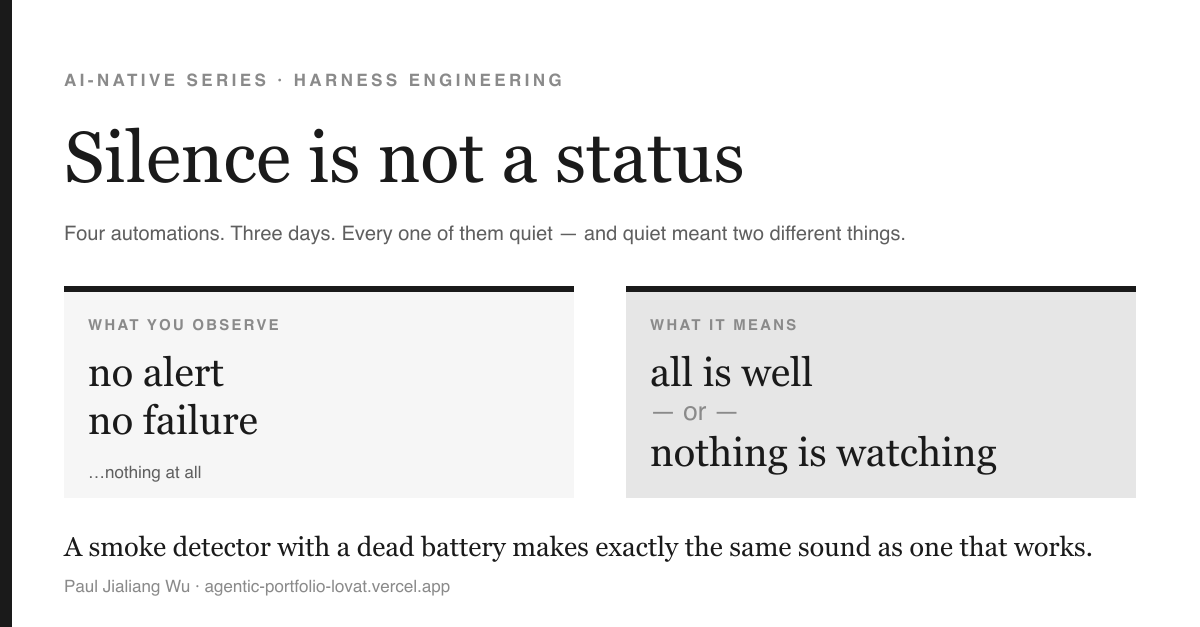
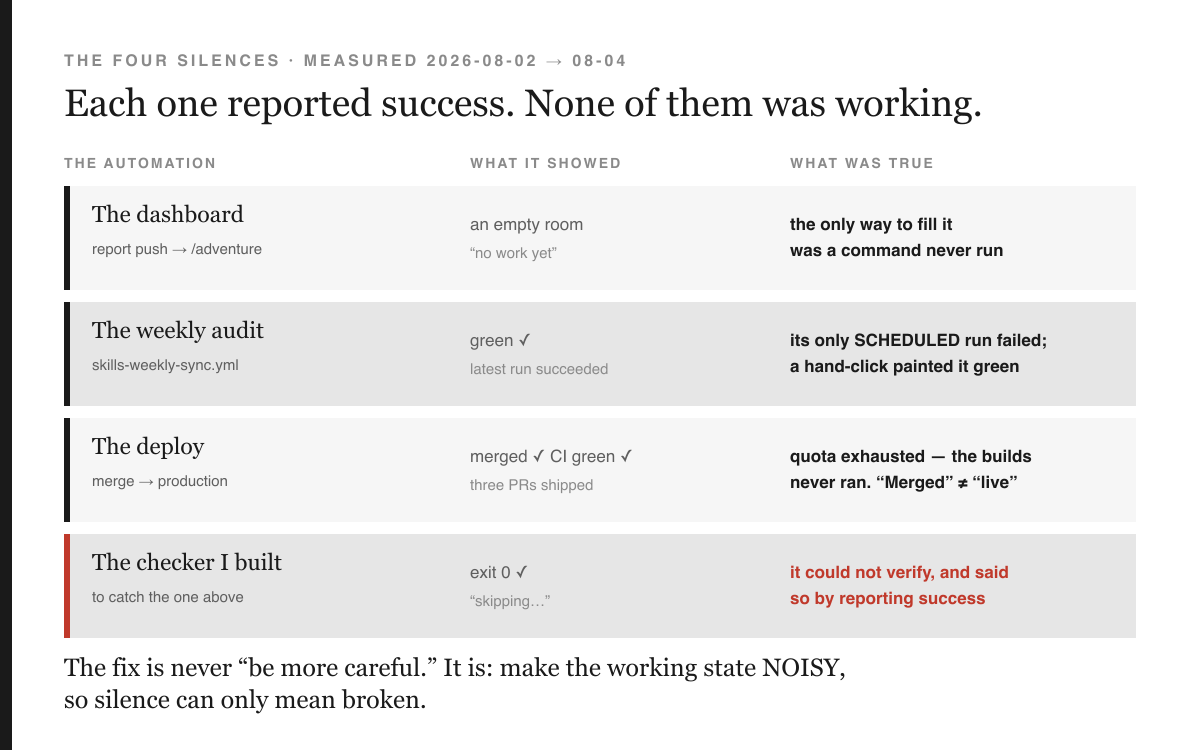
三日間で、私は静まりかえった四つの自動化を見つけた。静けさは、健全なシステムの見た目そのものであり——同時に、死んだシステムの見た目でもある。あるダッシュボードは空だった。なぜなら、そこにデータを入れられる唯一のコマンドが、一度も実行されたことがなかったからだ。ある週次ジョブは緑のまま表示されていた。なぜなら、失敗したスケジュールを人手によるクリックがこっそり穴埋めしていたからだ。マージ済みの三つのプルリクエストは本番に反映されていなかった。デプロイのクォータが静かにビルドを止めていたからだ。そして、その最後の問題を捕まえるために私が書いたチェッカーは、「skipping」と出力してsuccessで終了した。必要な修正は「もっと注意する」ことではない。電池が切れた火災報知器は、動作している報知器とまったく同じ音——無音——を出す。だからこそ、正常に動いている状態の方をうるさくする必要がある——「まだ生きている」という意味のビープ音を鳴らすのだ。そうすれば、沈黙は「壊れている」以外の意味を持ちえなくなる。監視チームはこの手法を「dead man’s switch。監視チームはこの手法を「dead man's switch」という名前のもと、この十年ずっと当たり前のように運用してきた。それなのに、ほぼ誰も自分自身のエージェントハーネスにそれを適用していない。
その週をひとつの数字で表すなら
四つ。自分が所有し、しつこいほど監査しているコードベース全体で、三日のあいだに、仕事を止めたのに誰にも知らせなかった独立した自動化を四つ見つけた。エラーを吐いたものはひとつもない。ダッシュボードを赤くしたものもひとつもない。自分が監視のために作ったあらゆるシグナルに照らせば、それぞれが完璧に動作するシステムそのものに見えた。
ここでの恥ずかしさについては正確に述べておきたい。教訓はまさにその恥ずかしさの中にあるからだ。これは自分が引き継いだレガシーシステムの話ではない。四つとも自分で作ったものだ。そのうち二つは同じ週にリリースしたばかりで、しかも一つは、まさにこの種のバグを捕まえるために自分で書いたツールだった。
メンタルモデル:電池が切れても、その音は聞こえない
電池切れの煙探知機は、正常に動作している煙探知機とまったく同じ音を出す。つまり無音だ。ビープ音がないことは、家が安全である証拠にはならない。それは何の証拠にもならない――どちらの世界でも観測結果は同一なのだ。
これが全体のアイデアであり、この記事から一つだけ持ち帰るなら、これにしてほしい。沈黙はステータスではない。それはステータスの不在であり、あなたの脳はそのすき間を、あなたが望む解釈で親切に埋めてしまう。あなたが所有するすべての自動化には、外から見ると同じに見える二つの状態がある――動いていて、何も見つかっていない状態と、動いていない状態だ。両者を切り分ける特別な工夫をしていない限り、あなたはいまどちらの状態にいるのか判別できない。
これが難しいのは技術的な理由からではない。「何も起きなかった」ということが、それ自体で情報であるかのように感じられてしまう、という点にある。しかしそれは情報ではない。
実際に見つけたもの
その一:構造的に埋まりようのないダッシュボード。自分は非公開のレポートカード・ダッシュボードを作り、CLIコマンドから送信されるデータを受け取るよう配線していた。そのコマンドにはシークレットトークンが必要だ。トークンはVercelのSensitive環境変数として保存されており、これは読み戻しができないことを意味する――vercel env pullは、それに対して空文字列を返す。つまりそのプッシュは、パスフレーズを知っているただ一人の人間が手動で実行する以外に方法がなく、この機能が存在していた数週間のあいだ、実行された回数はゼロ回。この部屋はゲートされたまま空だった。空であることは壊れていることと
見分けがつかない。それなのに私は三度も別々の報告で、自分が抱えていたブロッカーをバグとして扱わず、
共同作業者に「一行で終わる作業だ」と伝えてしまった。
その二:一度も発火しなかった週次ジョブ。リポジトリ内のcronスケジュール ワークフローすべての実行履歴を確認した。夜間ジョブは本当に健全で、5回中5回のスケジュール実行が 成功していた。だが週次の2つはそうではなかった。一方はスケジュール実行の履歴がたった1回しかなく、 その実行は失敗していた。その後の手動再実行が成功していたため、あらゆるサマリー ビュー――ワークフロー一覧、小さな緑のチェックマーク、バッジ――はそのワークフローを「合格」として 報告していた。もう一方は生涯でわずか3回しか実行されておらず、そのすべてが人間によるボタン押下で トリガーされたものだった。
これが四つのうちで最も見抜きにくいものなので、じっくり考えてほしい。手動実行はまさに定期実行の仕組みが 置き換えようとしている当のものであり、同時に、壊れた定期実行を正常に見せかけるものでもある。自動化は自動化として機能していなかった。その仕事を人間が手作業でこなしていたからこそ、 誰も自動化が止まっていることに気づかなかったのだ。
その三:マージされても本番反映とは限らない。3件のプルリクエストがマージされ、CIは3件とも 緑だったが、デプロイ済みサイトは何時間も古いビルドを配信し続けていた。ホスティングの無料枠は 本番デプロイを1日100回に制限している(Vercel, n.d.)。それを超えると、マージは成功し、 チェックも通過するが、何もデプロイされない。赤信号はどこにも出ない。「マージ済み」という言葉はいつの間にか「本番反映済み」を意味しなくなっていたのに、 私のあらゆる習慣はこの二つの言葉が同義であるという前提の上に築かれていた。
その四:判断できないときに成功と報告してしまうチェッカー。その三を発見したので、
私は防御策を書いた。実際にトラフィックを処理しているコミットSHAを公開し、それを`expected_sha`(期待するSHA値)origin/mainと比較し、
食い違えば失敗させる、というものだ。ここまではいい。ところが実際に実行してみると、それは`unknown`(不明)· the
deployment reports no commit SHA — skippingと出力し
、そのままゼロ終了した。 私はサイレント障害を検知するための検知器を作ったつもりだったのに、その検知器自身の障害モードが サイレント障害だったのだ。答えを判定できなかったので、都合の良い方を報告していた。緑色の パイプラインの中では、「確認できなかった」と「確認して問題なかった」は、まったく同じチェックマークとして表示されてしまう。
誰も気づかなかった理由――手動実行が緑色に塗ってしまう
四つのうち三つは同じ仕組みを共有しており、これは名指しする価値がある。あなたのシステムにも 必ず潜んでいるからだ。いずれの場合も、人間の行為が自動化された行為とまったく同じ観測可能な信号を生み出しており、human action produced the same observable signal as the automated action――人間の操作が、自動化された動作とまったく同じ観測可能なシグナルを生み出していた。そして人の目に映るのは、結局のところその観測可能なシグナルだけなのだ。
誰かが「run workflow」をクリックしてバッジが緑になった。誰かがプッシュコマンドを実行していれば、ダッシュボードは埋まっていたはずだ。誰かが「merged」を読んで「deployed」だと推測した。手動の経路と自動の経路はひとつの指標に収束し、その指標はどちらの経路が生み出したものかを教えてくれない。自動化は劣化し、人間がひっそりと穴埋めをし、ダッシュボードの色は決して変わらない。
業界はとうにこれを解決していた。自明のはずのことを、私は知らなかった
これは何ひとつ目新しい話ではない。モニタリングチームは2010年代にこの問題にぶつかり、地味だが優れた特定の答えを出している。
Google のSite Reliability Engineering」のモニタリングの章では、Rob Ewaschuk が地味だが譲れない性質をこう主張している。“Rules that generate alerts for humans should be simple to understand and represent a clear failure”(訳:人間向けにアラートを生成するルールは、理解しやすく、明確な失敗を表すものでなければならない)(Ewaschuk, 2016)。彼が挙げる理由はシグナル対ノイズ比と堅牢性だ——ページングの経路は単純でなければならない、なぜならそこは間違いが許されない部分だからだ。私自身の理由も付け加えたい。それはまた、自分のアラート機構ではデバッグできない唯一の経路でもあるということだ。ただし公平を期すために言えば、あの章が与えてくれるもの、与えてくれないものについて正直に言うと——そこには沈黙の曖昧さについての記述は一切ない。確認済みだ。以下の答えは Google のものではない。
そして、沈黙の曖昧さに正面から答えるパターンがウォッチドッグであり、 PromLabs はこう説明している。“a watchdog alert (also sometimes called a ‘dead man’s switch’, sentinel alert, beacon alert, or heartbeat alert) that helps you continuously test your entire alerting pipeline from beginning to end”(訳:ウォッチドッグ・アラート——「デッドマンズ・スイッチ」「センチネル・アラート」「ビーコン・アラート」「ハートビート・アラート」とも呼ばれる——は、アラート・パイプライン全体を最初から最後まで継続的にテストするのに役立つ)(PromLabs, n.d.)。この仕組みは見事な逆転の発想だ。すべてが健全なときに常に、永遠に発火し続けるアラートをひとつ作り、それをスタックの外部にあるサービスへ送る。PromLabs の言葉を借りれば、「アラート・パイプラインのどこかが壊れたとき、その外部サービスはアラート通知が届かなくなったことに気づき、あなたに通知を送る」。
煙探知機のことを念頭に置いてもう一度読んでほしい。他のあらゆるアラートは、何かが壊れたときに発火する。 ところがこれだけは、何も壊れていないときに発火する——つまり沈黙そのものが故障シグナルになる。健全な状態を、あえて騒がしい状態に変える。それだけで、曖昧だった観測は曖昧でなくなる。
私は何か月もエージェント・ハーネスを構築してきたのに、本番クラスタでなら当たり前だと言うようなパターンを、自分自身の自動化には一度も適用していなかった。理由はおそらく、個人用のハーネスはインフラだという実感が湧かないからだと思う。しょせん数個の YAML ファイルと CLI にすぎない、と。しかし自分が頼りにしている cron ジョブは紛れもなく インフラだ。そして課金制のそれとまったく同じように劣化する。
二つ目の発見:私は的外れなものを問題視していた
同じ週、共同作業者が別の改善案を持ちかけてきた。ここまで能力の高いフロンティアモデル相手なら、長いシステムプロンプトはもはやアクセスではなく負債になっている——削るべきだ、というのだ。
彼は正しかった。そして興味深いことに、私はすでにそれを証明済みだった。数ヶ月前、私は三本立てのアブレーション実験——フルプロンプト、三行の最小プロンプト、プロンプトなし——を三つのモデルにわたって実施していた。評価対象は、決定論的に採点される六つの能力ケース(満たされたアサーションの割合として算出)と、パス/フェイルで採点される四つのインジェクションケースだ。三本すべての結果を、全て示すとこうなる:
| プロンプト条件 | Sonnet-5 | Opus-5 | Haiku-4.5(弱い対照群) |
|---|---|---|---|
| フル(161語) | 100.0% | 100.0% | 88.9% |
| 最小(3行) | 100.0% | 100.0% | 96.7% |
| なし(空) | 100.0% | 100.0% | 96.7% |
フロンティアモデルは、プロンプトを与えても何も与えなくても、100%でフラットだ。弱い対照群はプロンプトがある方がない場合より悪いスコアになる。そして最小と空は見分けがつかない。記録された結論は率直だった——プロンプトは能力の対価を払っていないし、安全性の対価も払っていない。線を守っているのはハーネスであり、ツール層が違法な操作を拒むからであって、そもそも呼び出せる危険なツールが存在しないからだ。
では、同意して削れば、それで済む話か。違う。なぜなら私がアブレーションしたのは、一つの機能に紐づいた881バイトのプロンプトだったからだ。実際に毎セッション必ず読み込まれるプロンプトは、スキルファイル——エージェントにそのツールが何をできるかを教えるルーターの方だ。私はそれを一度も計測していなかった。
それは23,016バイト、トークン数にして約5,750。私が慎重にアブレーションしたプロンプトの26倍の大きさだ。しかも11日間で16,704バイトから23,016バイトへと膨れ上がっていた——一度も削減されることなく38%の増加であり、そのうちおよそ1,700バイトはまさにその日に私自身が追加したものだった。
現在の慣行を踏まえると、この比較は私が予想していた以上に際立って見える。Agent Skills規約の分析の中で、Aurimas Griciūnasは「発見コストの中央値はスキルあたり約80トークン」であり、「本体サイズは約275トークン(internal-comms)から約8,000トークン(skill-creator)まで幅があり、中央値はおよそ2,000」だと報告している(Griciūnas, 2026)。私のものは中央値の2.9倍だった。同じ論考はそのコストの正体をこう名指ししている:“As context grows, the model’s attention degrades and important information gets buried. Models reliably miss information placed in the middle of long contexts, a well-documented phenomenon called ‘lost-in-the-middle.’”(訳:コンテキストが増えるにつれ、モデルの注意力は低下し、重要な情報が埋もれてしまう。モデルは長いコンテキストの中間に置かれた情報を確実に見落とす——これは「lost-in-the-middle」として広く知られた現象である)
自分の枠組みについて正直に一つ注意を添えておく。その出典を注意深く読むと、この主張は自分自身で崩れるからだ。 Griciūnas は三層アーキテクチャを説明していて、そこでは発見コストは約80トークンで、本体(body)は 発動時にしかロードされない──つまりほとんどのスキルでは、本体が太っていてもセッションごとのコストにはならない。 このスキルに限っては、それがそのまま毎回のコストになる。作業開始時にスラッシュコマンドとして名前で呼び出されるからだ。ここでは発動(activation)が毎セッションで起きる。だからこの数字は自分のケースでは現実のものであり、他人のケースに一般化できるものではない。この区別を、最初にこの段落を書いたときは見落としていた。
ここで思わず笑ってしまった部分がある。そのスキルファイルのセクション4のタイトルは Situational playbooks (progressive disclosure)(訳:状況別プレイブック(漸進的開示))だ。そこでは、必要のないコンテキストを持ち込んではいけないと長々と説明しておきながら、直後で九つのプレイブックの本文すべて、8,410バイト、毎セッションの36%を、タスクに合うかどうかにかかわらずインラインで埋め込んでいる。progressive disclosureを説いている当のドキュメントが、リポジトリ内でその原則に対する最大の違反だったわけだ。
何をしたか──そしてなぜ「削る」だけでは間違った直し方なのか
分かりやすい対応は、言葉を削ることだろう。だが私はそれをしなかった。削っても、また膨らむからだ。このファイルが11日で38%も肥大化するのを、まさに目の当たりにしたばかりだった。もっともらしい一行が、理由を添えられながら一つずつ積み上がっていく。新しい一行を足すコストを、追加した瞬間に可視化する仕組みが、システムのどこにもなかった。
だから削る代わりに、ファイルを秤に載せた。テストが今ではサイズを固定し、実サイズの10%を超える余裕(バジェット)を許さず(緩いバジェットは制限ではなく飾りにすぎない)、ファイルが肥大化したらビルドを失敗させる。数字を引き上げること自体は許される──ただしそれはdiffの中で、理由を添えて、レビュアーの目に触れる形で行われなければならない。肥大化は意志の力では解決できない。取引の瞬間にその取引を明示化することでしか解決できない。
そしてそれは一時間もしないうちに私を捕まえた。新しいsatellite-syncコマンドを説明する一行を追加したところ、363バイト超過し、ビルドが赤くなった。自分で決めたルールに従って、その代償を払わねばならず、冗長だった「この機能は存在しない」という墓標的な記述を二つ圧縮し、歴史的な余談を一つ削った。ファイルは、その生涯で初めて縮んだ。そのあとで本当の作業に取りかかった──九つのプレイブック本文すべてを別ファイルに移し、トリガーに一致したときだけ読み込むようにし、トリガー・一行要約・パスだけのインデックスを残した。
22,833 → 17,681バイト。22.6%の削減、毎セッションでおよそ1,300トークンの節約であり、しかも何も失われていない。抽出したインデックスが存在しないファイルを指していたり、抽出した本文が下限を下回って縮んだりすれば、付随するテストが失敗する仕組みだ。苦労して得た教訓を捨てて得るトークンの節約は、節約ではない。そして疲れているときにその近道を取らせないようにするのが、このテストの役目だ。
残る半分の問題──静かに劣化していたポインタたち
同じ監査が、外側にも向けられた。私のメタリポジトリはそれぞれ、高評価の外部プロジェクトを サテライトとして組み込んでいる──フォークではなく、ポインタとSHA固定のダイジェストとしてだ。ずっと以前に書かれた社内ルールには、こう記されていた。“freshness is measured, not promised.”(訳:新しさは約束するものではなく、測定するものだ)
それは約束にすぎなかった。131の外部サテライトのうち、76個(58%)はSHAが一切ピン留めされていなかった。つまり構造上、ずれ(drift)は検出不可能だった。あるリポジトリは59個を抱えながら、ピン留めはゼロだった。そこで、ピン留めがあって照合可能な最初の40個のサテライトを確認した──ずれは、ピン留めがあって初めて測定できるものだからだ──すると、18個がピン留め先を超えて進んでいたことが分かった。そこにはこのコレクション全体の元になったシード・リポジトリも含まれていた。さらに、採用基準をもはや満たさなくなっていたものが15個あった。ひとつは111日、ひとつは180日、ひとつは468日も活動停止していて、そして スター数225にとどまっており、誰も例外扱いを記録していない500スターという基準を満たしていない。
この衛星群についての最初の集計もまた間違っていた——その恥ずかしい事実も、あえてここに残しておく。私は「178個のサテライト、124個が未ピン留め」と報告したが、その後、`satellites.json`という同じファイル名を3種類の異なるものが共有していることに気づいたregistry.yml:実際の外部サテライト、あるリポジトリ自身の内部スキル一覧、そして自分自身のコンポーネントのリストだ。2つのリポジトリは自分自身を指していた。修正後の数字は外部サテライト131個で、そのうち55個がピン留め済み、76個が未ピン留めだった。
この2つの集計はきれいに引き算できず、その食い違いにこそ学びがある。178/124から131/76へ移ると、47件が除去されるはずだが、未ピン留め分は48件しか減っていない——つまりピン留め済みの合計は1件増えている。私はこれを純粋な減算的修正だと説明していたのだが、実際には増えていたわけだ。増えた理由は、2回目のパスが1つではなく2つのことを修正したからだ:母集団と、そして定義の両方だ。最初のスクリプトは、あるエントリを、`pinned: true`という名前のキーを文字通り持っている場合に限ってピン留め済みとしてカウントしていたhead_sha。あるサテライトは自分のピン情報をpinned_sha`pin:
パターンとアンチパターン
アンチパターン:曖昧なチェックマーク。「確認済みで問題なし」と「確認できなかった」を同一に表示してしまう単一の指標。私の4つの失敗はすべてこれを抱えていた。
パターン:健全な状態を騒がしくする。正常に動いているときにハートビートを発し、それが途絶えたら警報を鳴らす。これがデッドマンスイッチであり、沈黙を情報に変える唯一の構造だ。
アンチパターン:手動実行をカデンスが機能している証拠としてカウントする。結果だけでなく、トリガーの種類を確認せよ。人間がボタンを押すこと自体が、本来排除しようとしていたものなのだ。
パターン:「判断できない」を exit zero にさせない。不明はパスではない。チェックが証拠にアクセスできない場合、大きな声で失敗を示し、どの証拠にアクセスできなかったのかを述べなければならない。
アンチパターン:蓄積を一回限りの掃除で解決する。プロンプト、設定、依存関係リスト、会議の招待——何であれ、一度きりのトリムは再び膨れ上がる。なぜならそれを増大させた力そのものには手を付けていないからだ。トリムする代わりに予算を設定し、予算超過でビルドを失敗させよ。
パターン:「見えなかった」と「消えた」を切り分ける。 私の衛星チェッカーは、上流に到達できない場合、他のすべてのテストを即座に打ち切る。なぜなら、そうしないと403エラーが「星ゼロ、コミットゼロ、活動ゼロ」――つまり削除すべきリポジトリ――と見分けがつかなくなるからだ。監査ツールにおける最も危険なバグは、欠測データを根拠に確信をもって行動してしまうことである。
そのメカニズム
これらの失敗はすべて同じ形をしている。バッジ、ダッシュボード、終了コード、「merged」といった単語――シグナルを運ぶチャネルが存在し、そのチャネルにはデフォルト値がある。何も駆動していないときにそれが発する値だ。そのデフォルトはほぼ常に安心できる方――緑、ゼロ、空、静寂――である。システムはアイドル時には静かであるように作られており、「健全だから静か」と「死んでいるから静か」はまったく同じ形で表現されてしまう。
つまりこのバグの正体は怠慢ではない。それはエンコーディングの衝突である。世界の二つの状態が一つの記号で送信されており、受信側にはどちらが送られたのかを復号する手立てがない。より注意深くなったところで、この衝突は直らない。直せるのはビットを一つ追加することだけだ。
第一原理
成功と同じ観測結果に落ち込みうる監視は、そもそも監視ではない。健全な状態にシグナルを発させ、沈黙が曖昧さを持たないようにせよ。
いま何をしているか、そしてこれから何を先回りしてやるか
振り返りは安上がりだ。ここでは実際に変わったこと、そして読者がそのまま真似できることを記す。
現在、すでに実装済みなのは:六つの観点ですべてのリポジトリを採点する週次のシステム群監査で、その観点の一つがスケジュール済み作業の生存確認だ――各cronワークフローの実行履歴を読み取り、トリガーがスケジュールによるもので、結果が成功だった実行を必須とする。手動実行は明示的にカウントしない。稼働中のコミットを公開するデプロイ用エンドポイント。検証できない場合は非ゼロで終了するチェッカー。握りつぶされたエラーを検出する静的スキャンは、あるリポジトリで43件を発見し、私がサンプルとして確認した2件はどちらも本物のバグだった――破損した台帳が静かに「決定なし」として読み込まれていたケースと、失敗すれば認証情報が読み取り可能なディレクトリに残ってしまう権限呼び出しのケースだ。プロンプトファイルにはサイズ予算を設定した。衛星の同期は削除を提案するだけで、決して自動実行はしない。
先回りして、自動化を出荷する前に今適用しているルールは以下の通りだ:
1. スケジュールジョブを追加する前に、すでにあるものを検証せよ。 これはこの記事全体の中で最も投資対効果の高いチェックであり、私の場合は4分で済んだ。自分のcronワークフローを一覧化し、実行履歴を「トリガーがスケジュールによるもの」event == "schedule"かつ「結果が成功」であるものconclusion == "success"で絞り込み、直近の実行を確認する。少なくとも一つは一度も発火していないものが見つかるはずだ。もう一つ追加する前にこれをやるべきだ。さもないと、検証していない床の上に家を建てることになる。
2. 毎時ちょうどのスケジューリングは避けよ。 たとえば :00 は、地球上のあらゆるスケジューラが詰まって処理を落とし始める時刻だ。それを避けるのにコストはかからない。選ぶべきは他の時刻、たとえば毎時17分だ。:20.
3. 人間がすでに見ている場所に、失敗を送り込め。 誰も開かないタブの中の赤い四角は、余計な手間がかかっているだけの沈黙にすぎない。私たちの仕組みは、単一のissueを開いてその場で更新し続ける——毎週新しいissueを作ると、issueを無視する習慣がついてしまうからだ。
4. 無知を理由にゲートを通してはならない。 私たちの監査では、必須の評価軸が 未計測 の場合、壊れている場合とまったく同じように失敗扱いになる。正直なところ、スケーラビリティは今日の時点では測定できない——だから偽のプロキシを与える代わりに「測定不能」と印をつけ、スコアから除外している。誰も見ていなかったから通ってしまうゲートこそ、この仕組み全体が防ごうとしている偽物のグリーンにほかならない。
5. トリムではなくラチェットせよ。 何かを片付けたら、その日のうちにクリーンな値をテストの予算として固定せよ。さもないと十一日後にはまた元通りだ。
6. ツールが間違っていたときは、その間違いをそのツールがある場所に書き残せ。 私たちのプレイブックには、新しい監査が初回実行時に自分自身で間違えた六つのことを記録したドッグフーディング・ログがある——シークレットスキャナーが自分のテストフィクスチャにフラグを立てた件、独立性チェックが自分自身にフラグを立てた件(自身の正規表現が、探している語句そのものを含んでいたからだ)。自分自身のテストに落ちる検出器は誰にも信頼されない検出器であり、生き残った偽陽性はチェックが無効化される原因になる。
最後に率直な限界を記しておく。上記のすべては今や計測されているが、そのどれも完成してはいない。
更新、2026年8月4日——この記事は一日で誤りだと判明した
ここに載っていた段落は、新しい週次ワークフローがまだ一度もスケジュール実行されておらず、最初の機会は数日先だと書いていた。実はすでに実行されていた。 cronはUTC月曜16時20分と指定していたが、GitHubが実際に実行したのは18時05分——予定の16時20分から一時間四十五分遅れだ。私は確認の仕方を誤り、一度も実行されていないと結論づけてしまった。よって訂正はこうだ。実行はされていた。そして失敗していた。
失敗の理由は二つあり、どちらもこの記事自身の主張が、その記事自身に噛みついた形になっている。第一に、ラチェットの基準となるベースラインは私のノートパソコン上で、ローカルのディレクトリ名をキーにして取得されたものだった。一方でジョブが監査するのはGitHubのリポジトリ名だ——そのため AnyAgent と anyagent は別々のプロジェクトとして読み取られ、旗艦リポジトリはまるで新規参入者であるかのように二つの評価軸で失敗した扱いになった。一つのものに二つの名前があったわけだ。第二に、さらに悪いことに、発見事項を人間に報告するステップが、存在しないラベル名 --label を渡していた。しかも私は、そのコールが自身の終了コードを無視するように書いてしまっていた。こうして監査は実行され、十件の回帰を見つけたが、誰にも知らせなかった。サイレントな失敗を検知するために作ったジョブそのものが、まさに検知してはならないはずのステップで、静かに失敗していたのだ。
両方とも修正済みだ。リポジトリのキーは大文字小文字を区別せずに比較するようになり、ベースラインはノートPCではなくCI実行から再生成されるようになった。レポート出力のステップはラベルを外し、ゼロ以外の終了コードで例外を発生させるようになり、後続のステップは実行を通す前にそのイシューが実際に存在することを確認するようになった。ピンされていなかった76個のsatelliteは、今はすべてピン留めされている——74個はプッシュ済みで、2個はそのリポジトリにリモートが存在しないためローカルコミットのみだ。skillファイルは、まだ分割していない箇所ではモノリシックなままだ。そして、この追記こそが肝心な点なのだ。私はサイレンス(沈黙)についての主張を発表し、それを確認しなかったことによって誤らせてしまった——これはまさに、この記事が扱っている失敗モードそのものだ。
私は意図ではなく数字を公表することにした。なぜなら今週得た教訓のすべては、意図と沈黙が外からは同じに見えるということだからだ。
参考文献
- Ewaschuk, R. (2016). “Monitoring Distributed Systems.” In B. Beyer, C. Jones, J. Petoff & N. R. Murphy (Eds.), Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media. sre.google/sre-book/monitoring-distributed-systems(2026年8月4日アクセス)
- PromLabs. (n.d.). “End-to-End Watchdog Alerts.” Monitoring and Debugging Prometheus. training.promlabs.com(2026年8月4日アクセス)
- Vercel. (n.d.). “Limits — Deployments.” Vercel Documentation. vercel.com/docs/limits(2026年8月5日アクセス)
- Griciūnas, A. (2026, March 11). “Agent Skills: Progressive Disclosure as a System Design Pattern.” SwirlAI Newsletter. newsletter.swirlai.com(2026年8月4日アクセス)
執筆:Paul Jialiang Wu。測定値はすべて筆者自身のリポジトリから、2026年8月2日から4日にかけて取得したものである。上記の引用はすべて原典と一字一句照合済みだ。