AI-Native 시리즈 · 에이전트 엔지니어링
6주간의 초록불
1분 요약 — 이 글을 통해 얻게 될 핵심
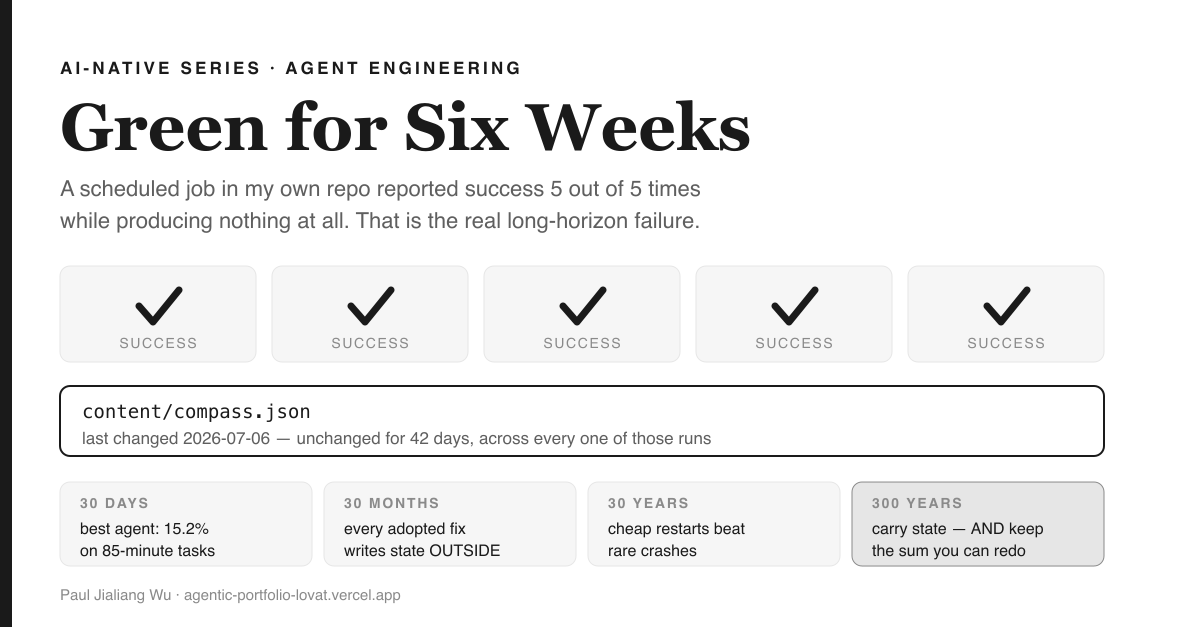
내 포트폴리오의 예약 에이전트가 5회 연속 성공 을 기록했지만, 이 에이전트가 작성해야 할 파일은 42일간 한 번도 바뀌지 않았다. 원인은 셸 스크립트의 세 문장으로 요약된다. 자격 증명이 빠져 있어서 exit 0. 나는 이후 30일, 30개월, 30년, 300년이라는 네 가지 시간대를 기준으로 장기적 에이전트 엔지니어링을 조사했다. 그리고 모든 시간대가 한 방향을 가리켰다. 실제로 도입된 그 어떤 방법도 모델의 기억을 늘려주지 못했다. 살아남은 모든 방식은 상태를 모델 밖으로 옮기고, 재시작 비용을 최소화한다. 압축, 노트, 체크포인트, 감독 트리, 재생 가능한 로그, 그리고 — 3세기 전에는 — 언제든 다시 계산할 수 있도록 들고 다니는 시계까지. 결국 마지막까지 남는 치명적 실패는 단 하나다: fine이라고 적힌 기록이 남았지만, 실제로는 아무 일도 없었던 경우다. 이때의 사고 모델은 로그북이며, 여기에 세 가지 규칙이 있다. 그중 세 번째가 모두가 건너뛰는 규칙이다.
어느 목요일 아침, 나는 내 저장소의 Actions 탭을 열어 일주일에 한 번 내 공개 GitHub 프로젝트들을 훑고, 어떤 프로젝트를 더 깊이 파고들지, 누구에게 연락할지 한 파일에 기록하는 작은 예약 에이전트를 확인했다. 이 에이전트는 결과를 하나의 파일에 쓴다, content/compass.json, 그리고 사이트는 그 파일을 렌더링한다.
예약 실행 다섯 번, 초록 체크마크 다섯 개, 그리고 줄지어 선 성공의 행렬.
그리고 나는 그 파일을 확인했다. 마지막 변경: 2026-07-06. 그게 바로 42일 전이었다. 정확히 6주 전이다.
원인은 세 문장으로 정리된다. 그리고 그 원인은 내 손에서 비롯됐다:
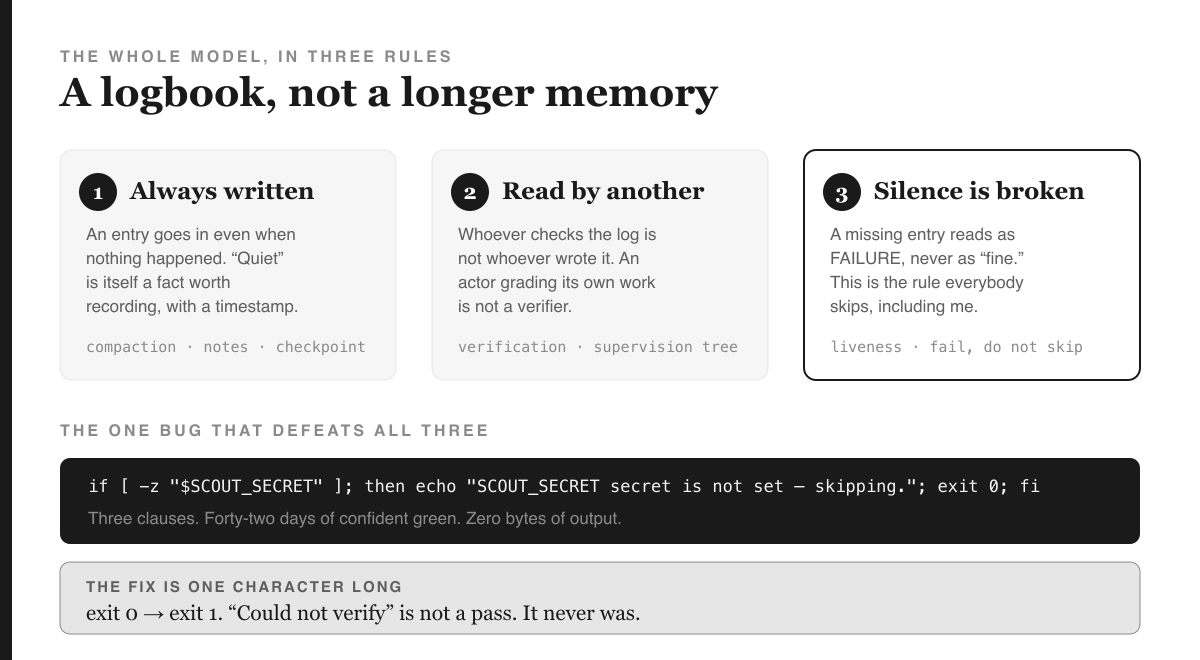
if [ -z "$SCOUT_SECRET" ]; then echo "SCOUT_SECRET secret is not set — skipping."; exit 0; fi자격 증명이 한 번도 설정된 적이 없었다. 그래서 매번 예약 실행 때마다 잡은 깨어나서, 키가 없다는 사실을 발견하고, 아무도 읽지 않는 로그에 정중히 그 사실을 남긴 뒤, 0으로 종료했다. 0으로 종료하면 성공이다. GitHub는 체크 표시를 그려줬고, 나는 그걸 믿었다.
이 구조를 잠시 곱씹어보라. 이건 "내 크론이 고장났다"가 아니다. 크론이 고장나면 괜찮다. 고장난 크론은 사람을 부른다. 이 경우에는 사람을 다섯 번이나 내보냈다. 이것만이 당신에게 감사 인사를 건네는 버그의 유일한 종류다.
나는 원래 오늘 하루를 장기적 에이전트 엔지니어링 — 즉, 에이전트가 몇 분이 아니라 몇 시간, 며칠 동안 유용하게 동작하도록 만드는 기술 — 을 연구하는 데 쓸 계획이었다. 그런데 아침 내내 이 문제를 고치다가, 내가 계획했던 연구 주제가 바로 이 문제였다는 사실을 깨달았다. 전부 그랬다. 네 개의 시간대, 네 개의 서로 다른 문헌, 그리고 하나의 답.
모델: 더 긴 기억이 아니라, 항해일지이다
핵심은 이것이다. 이후에 나오는 전문 용어를 몰라도 바로 실천할 수 있다.
배가 몇 달에 걸친 항해를 위해 항구를 떠난다. 선원 누구도 그 모든 여정을 머릿속에 담을 수 없다. 항로 변경도, 날씨도, 수심도 마찬가지다. 그래서 애초에 외우려 들지 않는다. 대신 항해일지를 쓴다. 위치, 방위, 상태를 일정 간격마다 기록한다. 낯선 이가 집어 들어도 어디서든 이어서 쓸 수 있도록 남긴다.
이 항해일지가 실제로 배를 구하려면 세 가지 조건이 충족되어야 한다.
- 아무 일도 없을 때도 반드시 기록한다. "조용한 당직, 변화 없음"도 하나의 항목이다. 빈 페이지는 기록이 아니다.
- 기록하지 않은 사람이 읽는다. 항해일지를 작성한 장교만이 그걸 보는 유일한 사람이 아니다.
- 기록에 빈틈이 있으면, 그건 '평온한 한 주'가 아니라 뭔가 잘못된 신호이다. '평온한 한 주'가 아니라, 이상 신호이다.
이것이 전부이다. 이 글에서 다루는 모든 기술은 이 세 가지 규칙 중 하나에 기술적 외피를 씌운 것에 불과하다. 그리고 내 스카우트는 세 번째 규칙에서 실패했다 — 아무것도 쓰지 않는 것에 관한 규칙, 그래서 늘 빠지는 바로 그 항목이다.
📰 창 하나: 이번 달 이 분야에서 논쟁이 집중되는 지점
가장 최근의 창은 가장 시끄럽고, 신뢰도는 가장 낮다. 그러니 이 절의 모든 내용을 사람들이 주목하는 흐름으로 받아들이고, 사실로 받아들이지는 마라. 이 순위는 참여도 기준이고, 참여도가 곧 증거는 아니다.
주목할 점은, 2026년 7월에 이 분야가 스스로 이름과 구조를 부여했다는 것이다. 인민대학교 RUC-NLPIR 연구실이 관리하는 장기 지평 에이전트 로드맵[1]은 전체 문헌을 두 축으로 조직한다. 하나는 외부화된 harness (모델을 둘러싼 스캐폴딩), 다른 하나는 내부화된 optimisation (능력을 모델에 직접 학습시키는 것)이다. harness 쪽에는 정확히 여섯 가지 구성 요소가 있다: 루프와 워크플로, 컨텍스트와 메모리, 도구, 오케스트레이션, 훅과 미들웨어, 그리고 검증.
이 목록을 로그북의 세 가지 규칙에 비추어 보라. 컨텍스트와 메모리가 첫 번째 규칙에 해당한다. 검증이 두 번째 규칙이다. 훅과 미들웨어는, 누군가 실제로 구현했다면, 세 번째 규칙이 들어갈 자리다.
한편, 최신 측정치는 만만치 않다. 2026년 7월 9일 공개된 벤치마크는 9개 범주에 걸쳐 실제로 긴 46개의 터미널 작업을 만들었고, 각 작업은 부분 진행 상황이 단순히 통과/실패로 뭉개지지 않도록 등급별 하위 작업으로 세분화했다 [2]. 한 번의 실행은 평균적으로 약 231회 에피소드와 85.3분이 소요되고, 작업당 약 990만 토큰을 소모한다. 가장 강력한 모델은 15.2%에서 부분 점수 기준을 통과했고 10.9%에서 만점 기준을 통과했다. 모든 테스트 모델의 평균은 4.3%와 1.7%.
이다. 그리고 2026년 7월 7일 제출된, 19개 벤치마크에 걸친 27편 논문의 종합 분석은 에이전트 실패를 여섯 가지 유형으로 분류한 뒤, 세 가지 결론을 한 문장에 담아 제시한다 [3]. 셋 모두 중요하니, 전체 문장을 그대로 인용한다: 저자들은 "that failures compound nonlinearly with task length, that strong performance on individual sub-tasks does not reliably translate into end-to-end success, and that additional scaffolding does not consistently improve reliability."(번역: 실패는 작업 길이가 길어질수록 비선형적으로 누적되고, 개별 하위 작업에서의 강한 성능이 전체 작업의 성공으로 신뢰성 있게 이어지지 않으며, 추가적인 스캐폴딩이 신뢰성을 꾸준히 개선하지도 않는다.)
중간 절이 바로 부분 점수 벤치마크에서 가장 두드러지는 부분이고, 마지막 절이 비용이 많이 드는 대목이다.
구성 요소를 늘린다고 해서 로그북의 본질이 더해지는 것은 아니다. 에이전트에 하니스 컴포넌트 여섯 개를 덕지덕지 붙여도, 결국 내 스카우트와 똑같은 허점을 남길 수 있다.
🌗 두 번째 창: 데모에서 실제 표준이 된 것들
30개월은 도입의 기준선이다. 데모가 실제로 배포됐는지 안 됐는지 판가름 나기에 충분히 길고, 그 평결이 아직 유효할 만큼은 짧다. 출시 당시의 소음이 아니라 실제 운영 증거로 순위를 매겨야 한다.
모두가 인용하는 숫자부터 시작하자. METR은 AI 에이전트가 자율적으로 완수할 수 있는 작업의 길이를 측정하는데, 그 추세는 정말로 기하급수적이다. METR은 2019~2025년 기준 "약 7개월마다 두 배"라며, P50 적합치는 195.8일이니 대략 6개월 반쯤 된다. 최신 방법론에서는 130.8일마다 한 번씩 두 배가 된다(2023년 이후 기준) 88.6일 2024년 이후 [4]. 두 배로 늘어나는 데 석 달도 걸리지 않는다.
이제 그래프만 보면 놓치기 쉬운 부분을 짚겠다. METR의 표현을 그대로 옮기면, "These confidence intervals are still very wide, and we are actively working on adding more long tasks…"(번역: "이 신뢰 구간은 여전히 매우 넓으며, 우리는 더 많은 장기 과제를 추가하기 위해 적극적으로 노력하고 있습니다…") 그리고 인간 기준 시간은 "measured for only 5 of our 31 long (8h+) tasks. The remainder use estimated times"(번역: "31개의 장기(8시간 이상) 과제 중 단 5개만 실제로 측정되었고, 나머지는 추정치를 사용했습니다") [4]. 곡선 자체는 실제다. 하지만 그 끝은 고작 다섯 개의 측정값을 잇는 선분에 불과하다. 이 점을, 이 추세선을 근거로 사업 계획을 세우기 전에 반드시 알아둬야 한다.
그렇다면 실제로 현장에 안착한 것은 무엇인가? 내가 지금 이 글을 작성하는 연구실에서 실제 운영 사례로 문서화한 세 가지 기법이 있다 [5]. 이들이 자원을 어떻게 재정의하는지, 그 표현을 그대로 인용할 만하다: "LLMs have an 'attention budget' that they draw on when parsing large volumes of context. Every new token introduced depletes this budget by some amount…"(번역: "LLM은 대량의 컨텍스트를 해석할 때 '어텐션 예산'을 사용한다. 새로운 토큰이 추가될 때마다 이 예산이 일정 부분 소모된다…") 컨텍스트는 저장소가 아니다. 예산처럼 소진되는 자원이다.
이 전제를 받아들이면, 실제로 채택된 세 가지 방법은 모두 어딘가에 기록을 남기는 방식으로 수렴한다:
- 컴팩션 — "the practice of taking a conversation nearing the context window limit, summarizing its contents, and reinitiating a new context window with the summary"(번역: "컨텍스트 윈도우 한계에 다다른 대화를 요약하고, 그 요약으로 새로운 컨텍스트 윈도우를 시작하는 관행") [5]. 로그북에 한 줄 적고, 새 페이지를 여는 셈이다.
- 구조적 노트 작성 — "a technique where the agent regularly writes notes persisted to memory outside of the context window"(번역: "에이전트가 컨텍스트 윈도우 외부의 메모리에 정기적으로 노트를 남기는 기법") [5]. 바로 그 로그북 자체다.
- 서브 에이전트 — "Rather than one agent attempting to maintain state across an entire project, specialized sub-agents can handle focused tasks with clean context windows"(번역: "하나의 에이전트가 전체 프로젝트의 상태를 유지하려 애쓰는 대신, 특화된 서브 에이전트들이 깔끔한 컨텍스트 윈도우로 집중된 작업을 처리할 수 있다") [5]. 교대 근무와 같다.
이와 함께, 기반 구조도 표준화의 길을 밟았다. Model Context Protocol이 2024년 11월에 등장했고, 2025년 12월 9일에 Anthropic이 이를 Linux Foundation 산하 Agentic AI Foundation에 기증했다. 이 재단은 Block, OpenAI와 공동 설립되었고, Google, Microsoft, AWS, Cloudflare, Bloomberg가 후원한다 [6]. 경쟁하는 연구실들이 13개월 만에 중립 재단에 공통 인터페이스를 넘긴 것은 출시가 아니라 표준의 수립이다. 같은 기간, 장애에도 살아남는 프로세스를 위한 내구성 실행 인프라—즉, 크래시에도 지속되는 워크플로우를 위한 시스템—도 에이전트에 초점을 맞췄다. Temporal의 2026년 컨퍼런스에서는 바로 이런 워크플로우를 겨냥한 서버리스 워커가 공개되었다 [7].
여기서 원리가 드러난다. 이 점이 바로 이 글의 척추이므로, 단도직입적으로 말하겠다.실제로 도입된 어떤 기법도 모델의 기억 용량을 늘려주지 않았다. 모든 기법은 상태를 모델 바깥, 내구성 있고 점검 가능하며 언제든 재개할 수 있는 외부로 옮긴다.
같은 기간에 사라진 사례들
채택만으로 순위를 매기고 실패한 데모를 빼면 그건 그저 보도자료일 뿐이다. 이 시기 가장 화제가 됐던 에이전트 프로젝트들은 결국 살아남지 못한 것들이다. AutoGPT와 BabyAGI는 2023년 초에 급부상했지만, 당시 직접 써본 평가는 다음과 같다. "couldn't find a single practical use case where they do a good job" (번역: 실제로 잘 작동하는 실용적 사례를 하나도 찾지 못했다) [8]. AgentGPT는 2023년 11월에 개발이 중단됐고, 모회사도 2024년 7월에 방향을 틀면서 플랫폼은 130건이 넘는 미해결 이슈를 남긴 채 유지보수 모드로 전환됐다 [9].
그리고 가장 시사점이 큰 실패 사례는 API 설계에서 나왔다. LangChain의 AgentExecutor — 대표적인 "모델을 반복해서 돌리기만 하면 된다"라는 추상화 — 는 더 이상 권장되지 않게 되었고,initialize_agent 그리고 더 오래된 create_react_agent 역시 마찬가지다. 공식적으로 권장되는 대체 방식은 단일한 create_agent [10]. 공식 사유는 루프 구조가 분기, human-in-the-loop, 내구성 실행을 처리하지 못하는 반면, 그래프 런타임은 이를 지원한다는 점이다.
루프는 그래프에 패배했다. 루프는 상태를 내부에만 보관하는 프로세스이고, 그래프는 상태를 외부에 기록해두어 언제든 멈추고, 점검하고, 다시 이어갈 수 있는 구조다. 결국 1번 규칙이 프레임워크의 운명을 갈랐다.
🕰 세 번째 창: 30년을 견딘 생존 전략
이제 채택이 아니라 생존을 기준으로 순위를 매기면, 목록은 짧고 화려함과는 거리가 멀다. 솔직히 말하자면, 아래 두 항목 모두 아직 쓸 만하게 노화 중인 사례이지 완전히 입증된 생존자는 아니다. 이번 조사에서 둘 다 완전한 사망과 부활의 증거를 찾지 못했기 때문이다.
슈퍼비전 트리, 그리고 "실패를 허용하라." Erlang/OTP가 장기 실행 시스템에 내린 해답은, 실패하지 않는 코드를 짜는 것이 아니었다. 대신 프로세스들을 트리 구조로 배치하고, 슈퍼바이저의 유일한 임무는 자식 프로세스가 죽었는지 감지해서 재시작하는 것이었다. 이 구조는 여전히 현역이다. WhatsApp은 서버 한 대당 2백만 동시 접속을 50명도 안 되는 엔지니어로 운영했고, Discord 역시 같은 계보의 실시간 인프라를 쓴다 [11]. 이 철학은 자주 오해받으니, 중요한 정정을 하겠다. 이것은 '대충 해도 된다'는 뜻이 아니다. Erlang/OTP의 설계 원칙은 복구 로직을 별도의 프로세스에 두라고 명시한다. 즉, 실제 작업을 하는 코드는 자기 실패를 복구하는 코드를 절대 품지 않는다 [11]. 정상 동작과 오류 복구는 서로 다른 프로그램이고, 트리의 서로 다른 부분이 작성한다. (이 아이디어는 수많은 블로그에서 인용문처럼 돌아다니지만, 실제로 그런 문장이 있는 출처는 찾지 못했다. 내 초고에도 인용문으로 썼다가, 결국 인용 없이 이렇게 남긴다.)
내구성 로그에서의 재실행. 내구성 실행(Durable execution) — Uber에서 Cadence를 만든 엔지니어들이 개발한 Temporal — 은 각 워크플로의 이력을 프로세스 외부의 내구성 이벤트 로그로 남기고, 이 로그는 절대 사라지지 않는다. 재시작 시 워커는 워크플로 코드를 처음부터 다시 재생하지만, 이미 성공한 활동은 건너뛴다 [7], [12]. 이 아이디어는 제품보다 오래됐고, 'write-ahead log'가 새 옷을 입은 셈이다. 나는 그 계보를 설명하는 것이지, 특정 인용을 주장하는 것은 아니다.
이 둘을 나란히 놓고 보면, 원리가 명확해진다.
어느 쪽도 장기 실행의 실패 자체를 막으려 들지 않는다. 둘 다 실패해도 쉽게 다시 시작할 수 있도록 만든다. 30년간의 신뢰성 엔지니어링이 충돌을 줄여준 적은 없다. 대신 재시작의 비용을 획기적으로 낮췄을 뿐이다.
그래서 '모델을 더 똑똑하게 만들어 실마리를 놓치지 않게 하자'는 전략에는 선례가 없고, '실마리를 잃어도 90초 만에 복구할 수 있도록 체크포인트를 자주 남기자'는 전략에는 30년의 실전 경험이 쌓여 있다.
🏺 네 번째 창: 300년을 견딘 생존 전략
이쯤 되면 한 세대의 경험치는 잡음에 불과하다. 세대를 건너뛰며, 기반이 바뀌어도 살아남은 것만이 의미를 가진다. 실제로 우리와 같은 영역에서 두 가지가 살아남았다: 기억하기엔 너무 긴 작업에서, 내가 어디에 있는지 아는 방법.
들고 다니는 시계, 그리고 매번 다시 계산하는 합계
경도 문제는 곧 장기 지평 에이전트의 문제였다. 위도는 쉽다 — 태양만 보면 된다. 경도는 '다른 곳의 시간'을 알아야 하는데, 대부분의 역사에서 바다 위에서는 그걸 알 방법이 없었다. 18세기에 두 가지 해법이 경쟁했고, 오늘날까지도 그 두 전략이 여전히 살아 있다.
상태를 이어서 들고 간다: John Harrison의 해상 시계는 기준 시간을 계속 유지했다. 그래서 위치를 고정하는 것은 시계의 판독이었다. 매번 새로 도출한다: 달 거리법은 달과 별 사이의 각도를 측정해 기준 시간으로 다시 계산했다 — 매번 새롭게 관측하고, 연감표를 참고하며, 구면삼각법의 긴 사슬을 처음부터 다시 밟았다.
숫자 이야기에 들어가기 전에, 반드시 전해야 할 경고가 있다. 내가 가장 많이 참고한 출처는 사실상 이 경고를 위해 존재한다고 해도 과언이 아니다. Royal Museums Greenwich는 이 경쟁을 이렇게 시작한다: "The brilliant John Harrison has long been portrayed as the plucky underdog…"(번역: 뛰어난 John Harrison은 오랫동안 용감한 언더독으로 그려져 왔다…) 그리고 이것이 "has however tarnished the reputation of another brilliant man: Nevil Maskelyne"(번역: 그러나 또 다른 뛰어난 인물인 Nevil Maskelyne의 명성을 훼손했다) [13]. 내가 자라면서 접한 것도, 초안을 쓸 때 떠올린 것도 바로 이 언더독 버전이다. 하지만 역사가들이 말하는 버전은 다르다.
그러니 신중하게. 두 번째 항해 실험 — 두 방법이 직접 맞붙었던 그 실험 — 에서 Harrison의 H4는 약 10마일 그리고 달 거리법은 약 삼십 [13]. 출처에서는 "miles"라고만 되어 있고, 법정 마일인지 해상 마일인지는 밝히지 않는다. (H4의 유명한 약 1마일 오차는 실제로 존재하지만, 다른 항해에서 나온 결과이므로 두 실험을 한 판으로 섞는 것은 옳지 않다.) Maskelyne은 왕립 천문관으로서 항해자들이 실제로 쓸 수 있도록 Nautical Almanac 표를 출간했고, 위원회 위원으로서 "continued to resist Harrison's claim for the award" [13] — 그리고 Linda Hall Library의 기록에 따르면 Harrison의 시계를 평가하며 "wrote a negative report, saying that the chronometer had built-in errors which just happened to cancel each other out"(번역: 크로노미터에 내재된 오류가 우연히 서로 상쇄되어 정확해진 것이라고 부정적인 보고서를 썼다) [13]. 즉, "그저 운이 좋았다"는 식의 말이 아니라, 훨씬 더 구체적이고 치명적인 의미다: 당신의 기기는 우연히 맞은 것이다.
달 거리법은 19세기 내내 실제로 널리 쓰였고 표준이었다. 크로노미터는 1850년경에 이르러서야 대중화되었고, 영국은 1767년부터 1906 [15].
이제 여기서 솔직하게 짚고 넘어가야 할 부분이 있다. 이 이야기의 승리자 서사는 현재의 시각이고, 나 역시 한때 그렇게 썼다. 크로노미터에 대한 반론은 비싸고 대량생산이 어렵다는 점이었는데, 이 반론은 거의 한 세기 동안 사실이었다. RMG는 명확히 밝힌다: 해상 시계는 "remained rare and expensive; it took decades to establish their reliability and for seafarers to trust them" [13](번역: 여전히 희귀하고 비쌌으며, 신뢰성과 선원들의 신뢰를 얻는 데 수십 년이 걸렸다). Harrison의 시험은 1761년, 저렴해진 것은 1850년경 — 대략 90년이 걸렸고, 여기서 "around"라는 표현 역시 출처의 단어이지 수치가 아니다. 비용에 대한 반론이 세대를 거쳐 옳을 수 있지만, 결국에는 패할 수도 있다. 이것이 "선구자가 결국 옳았다"는 식의 단순한 결론보다 훨씬 유용한 교훈이고, 실제로 나는 이 점을 에이전트 시스템의 체크포인팅 오버헤드 논의에 적용하고 싶다: 그 반론이 지금 옳더라도, 결국 설계 기준이 되지 않을 수 있다.
그리고 패자는 다시 돌아왔다 — 백업으로서.
여기서 내 논증의 반대편에 넣을 뻔했던 반전이 있다.
미 해군사관학교는 1990년대 후반에 천문항법 과정을 커리큘럼에서 제외하고, 그 시간은 GPS와 전자항법으로 대체했다. 그리고 2015년 여름에 다시 도입했다 GPS는 언제든 교란될 수 있기 때문이다. 항해 및 조함학과 부의장은 그 이유를 한 문장으로 정리했다: 컴퓨터는 훌륭하지만 "The problem is there's no backup"(번역: 문제는 백업이 없다는 것이다) [14].
그런데, 실제로 무엇이 돌아왔는지 보자. 돌아온 것은 육분의 관측, 연감, 관측값 환산 — 즉, 재도출 방식이다. 18세기 경쟁에서 졌던 쪽이 현대 해군에서 백업으로 부활했다. 재도출이 더 저렴해서가 아니다. 분명히 그렇지 않다. 재도출은 오직 하늘만 있으면 되고, 반면 상태를 들고 가는 방식은 남이 운영하는 위성에 의존하기 때문이다.
이로써 "상태를 들고 가느냐, 재도출하느냐"보다 더 날카로운 규칙이 생긴다:
상태를 작게 압축해 앞으로 넘기는 이유는 비용이 적게 들기 때문이다. 그리고 값싼 경로가 막혔을 때 유일하게 작동하는 방법은, 처음부터 다시 도출할 수 있는 능력을 반드시 남겨두는 것이다.
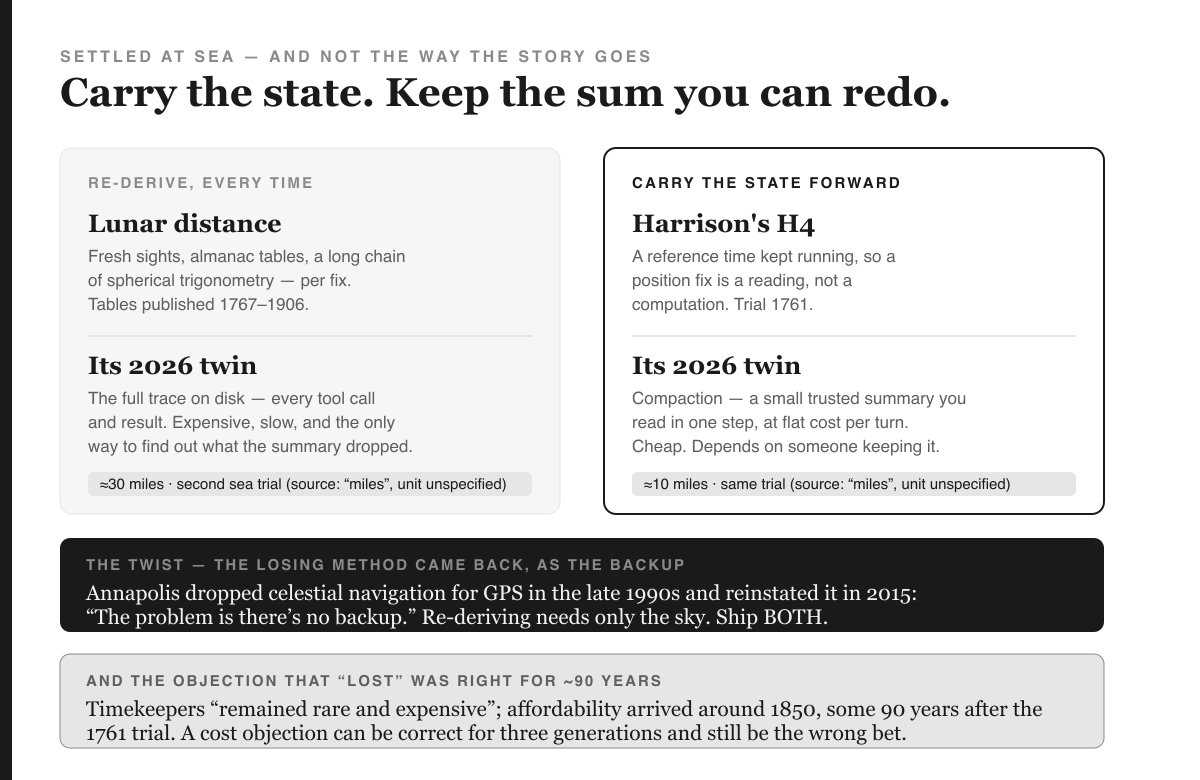
비유가 아니라 실제 에이전트에게는 이것이 곧 아키텍처다. 컴팩션은 크로노미터와 같다. 한 번에 읽을 수 있는 작고 신뢰할 수 있는 요약본이다. 모든 도구 호출과 결과가 디스크에 남는 전체 트레이스는 섹스턴트와 같다. 비싸고 느리지만, 요약본이 중요한 정보를 놓쳤을 때 실제로 내가 어디에 있는지 알 수 있는 유일한 방법이다. 둘 다 반드시 실어야 한다. 내가 살펴본 대부분의 에이전트 스택은 첫 번째만 남기고, 사고가 터졌을 때 압축된 기록만 남았다는 사실을 그제야 깨닫는다.
굳이 18세기까지 거슬러 올라갈 필요도 없다. 이 글에서 이미 다룬 프로덕션 시스템이 바로 이 원리를 구현하고 있다. 내구적 실행은 전체 이벤트 로그를 보존하고그리고 그 기록에서 다시 재생한다. 로그는 섹스턴트이고, 재생은 관측값 환산이며, 이미 성공한 활동을 건너뛰는 부분이 바로 전달된 상태다 [7], [12]. Temporal은 둘 다 제공한다. 그리고 실제로 바다 역시 어느 한쪽만 고르지 않았다. 크로노미터가 승리한 시점을 기록한 바로 그 페이지에는 "a mariner with a chronometer could check its accuracy using a lunar determination of Greenwich time" (번역: 크로노미터를 가진 선원은 달의 위치로부터 그리니치 표준시를 산출해 그 정확도를 검증할 수 있었다) [15]라고도 적혀 있다. 시계를 들고, 섹스턴트를 챙기고, 서로를 감시하게 하라. 해군은 2015년에 이 두 번째 절반을 다시 배웠다. 아직도 둘 중 하나만 고르는 쪽은 에이전트 스택뿐이다.
정확히 짚고 넘어가자. 솔직한 버전이 승리담보다 더 유쾌하고, 실용적이기 때문이다. 돌아온 것은 옛날 그 강의가 아니었다. 실제로 복귀한 것은3시간짜리 입문 세션 [14]이었다. 이 문제가 처음 해결된 지 265년이 지난 뒤, 백업은 기업 신입교육에서 경비 처리법을 배우는 정도의 길이로 재도입되었다. 조직은 이 교훈을 학습한다기보다, 그저 포스트잇 한 장 붙여두는 데 그친다.
체크리스트 — 그리고 두 가지 정직한 교정
두 번째 생존자는 모두가 안다고 생각하는 바로 그것이다. 1935년 10월 30일 라이트 필드에서, 보잉 Model 299 — B-17의 시제품 — 이 약 300피트까지 상승하다가 실속해 추락했고, 승무원 5명 중 2명이 사망했다. 원인은 컨트롤 락이 해제되지 않은 채 남아 있었기 때문이다. 당시 기록에 따르면, 이는 엘리베이터와 러더 모두를 고정시키는 내부 락이었다 [16]. (널리 퍼진 재구성에서는 이를 "gust lock"이라고 부르지만, 내가 실제로 확인한 사고 기록에는 그런 표현이 없다. 이 단락은 바로 그런 잘못된 통념을 바로잡기 위한 것이다.)
사고 조사위원회의 결론은 내가 어떤 에이전트 대시보드 위에도 올려두고 싶은 문장이다. 위원회는 항공기의 크기와 조종계 설계를 고려할 때, "it was improbable that any pilot, taking off under the same conditions, would discover the locked controls until it was too late to prevent a crash" (번역: 동일한 조건에서 이륙하는 어떤 조종사도, 조종 장치가 잠겨 있다는 사실을 너무 늦게야 발견하게 되어 추락을 막을 수 없었을 것이라는 점이 개연성이 높다고 결론지었다) [16].
즉, 관측 불가능한 상태였다. 비행기는 자신이 어떤 상태인지 누구에게도 알릴 방법이 없었다.
그리고 나는 그 결론 바로 옆에 있는 문장도 함께 봐야 한다. 같은 출처에서 이렇게 덧붙인다. "Ordinarily, pilots make checks of their movement as a precaution, but apparently this did not occur" (번역: 평소라면 조종사들은 안전을 위해 조종 장치의 움직임을 점검하지만, 이번에는 그 점검이 이루어지지 않았다) — 그리고 같은 출처의 목소리로, 그 평결에 대해 이렇게 덧붙인다. "by implication, a 'pilot error' verdict—but the board did not say that directly" (번역: 암묵적으로는 '조종사 실수'라는 평결이지만, 위원회는 이를 직접적으로 언급하지 않았다) [16]. 그러니 이것은 조직이 개인에게 책임을 돌리지 않고 고귀하게 거부한 깔끔한 이야기가 아니다. 훨씬 더 복잡하고 익숙한 이야기다. 보고서에는 면죄부와 질책이 모두 담겨 있고, 조직이 실제로 무엇을 했는지가 중요하다. 그 이후 실제로 무엇을 했는지가 중요하다.
실제로 한 일은 다음과 같다. 항공기가 너무 커서 조종이 어렵다는 주장에 직면했을 때, 미 공군은 "properly recognized that the limiting factor here was human memory, not the aircraft's size or complexity"(번역: 이 경우의 한계 요인은 항공기의 크기나 복잡성이 아니라 인간의 기억력임을 제대로 인식했다) [16]. 그리고 이들은 이륙, 비행, 착륙 전후를 위한 체크리스트를 만들었다.
두 번째 바로잡음이다. 대중적 버전은 휘그사관(Whig history)이고, 나 역시 거의 그렇게 쓸 뻔했다: 체크리스트는 1935년에 새로 만들어진 것이 아니다. 메리엄-웹스터(Merriam-Webster)에 따르면 이 단어 자체는 1853년에 등장했고, 같은 출처는 그 개념이 "had already been around for decades, and was in scattered use in aviation worldwide, but it took the Model 299 crash to institutionalize its use"(번역: 이미 수십 년 전부터 존재했고 전 세계 항공계에서 산발적으로 사용되고 있었으나, Model 299 추락 사고를 계기로 제도화되었다) [16]. 1935년이 새로운 아이디어를 낸 것이 아니라, 장례식을 치른 셈이다.
이 점은 불편하지만 곱씹을 만하다. 이 글에서 다루는 모든 제도는 무언가를 잃은 뒤에야 제도화되었다. 내 경우는 정찰 에이전트의 6주치 산출물밖에 잃은 것이 없었고, 그것도 우연히 두 번째 탭을 클릭했기에 발견할 수 있었다.
첫 번째 원칙
네 개의 시계창이 모두 한 문장으로 수렴한다.
에이전트의 지평은 얼마나 오래 기억하는지가 아니다. 중단됐다가 재개될 때, 자신이 어디까지 했는지 거짓 없이 이어갈 수 있는 시간이 곧 지평이다.
논리는 단순하다. 컨텍스트는 소모되는 어텐션 예산이므로, 내구성 있는 상태는 그 밖에 존재해야 한다. 상태가 외부로 나가면, 외부 기록—즉 모델이 아니라—이 시스템의 기준선이 된다. 그리고 기록이 기준선이 된 순간, 남는 유일한 치명적 실패는 아무 일도 없었는데 fine 이라고 기록하는 것이다.
그래서 장기 지평 에이전트 엔지니어링의 마지막 관문은, 의외로 평범하고 화려하지 않다: 침묵을 드러나게 만드는 일이다.
패턴과 안티패턴
| 패턴 | 안티패턴 |
|---|---|
| 조용한 실행에서도 체크포인트를 남긴다 — 빈 항목도 기록이다. | exit 0 자격 증명이 없을 때. |
| 검증하는 주체와 행동한 주체가 다르다. | 에이전트가 자기 궤적을 스스로 평가하고, 그 결과를 직접 보고하는 구조. |
| 부재는 허용 오차가 붙은 실패 상태로 간주한다. | 부재를 null로 처리하고, 이를 초록색(성공)으로 표시하는 것. |
| 드물게 크래시가 나는 시스템이 아니라, 언제든 쉽게 재시작할 수 있는 시스템을 만든다. | 모델을 더 똑똑하게 만들어서 '실마리를 놓치지 않게' 하려는 접근. |
| 요약된 상태를 계속 앞으로 넘기고 또한 언제든 다시 복원할 수 있는 전체 이력도 반드시 함께 보관한다. | 요약본만 남기고, 사고가 터진 뒤에야 전체 이력이 없다는 사실을 뒤늦게 깨닫는 것. |
| 실패가 이미 사람이 주시하는 곳으로 바로 연결되도록 한다. | 대시보드의 탭을 알림 채널로 삼는다. |
실제로 내가 90분 만에 바꾼 것
구체적으로, 복사해서 써도 되고 반박해도 좋다. 이제는 기억이 아니라 코드로 강제되는 다섯 가지 규칙:
- 정각이 아닌 시각에 스케줄한다. 예약 작업은 정각에 가장 심하게 누락되거나 지연된다.
:00이제 내 작업은:47,:53와:11. - 자격 증명이 없으면 건너뛰지 않고 반드시 실패로 처리한다.
exit 0은 이제 에러 주석이 되었고exit 1— 새 작업에서는 또 이 교훈을 준 이전 작업에서는 - 실패하면 이슈를 연다. 아무도 열지 않는 탭의 빨간 네모는 결코 알림이 아니다.
- 이 작업은 자신의 마지막 출력물이 언제 생성됐는지 스스로 측정한다. 그리고 매번 실행할 때마다, 주기별 허용 오차(일간 2일, 주간 10일, 월간 40일)에 맞춰 그 사실을 직접 알린다. 조용히 멈춘 작업도, 다시 살아날 때는 반드시 그 사실을 명확히 보고한다.
- "Could not verify"는 결코 정상 종료(0)로 끝나지 않는다. 이것이 바로 한 글자만 바꾸면 되는, 그러나 본질을 바꾼 일반화된 수정이다.
그리고 이제 이 리뷰는 실패할 수 있도록 설계되어 있다. 만약 기반 목표 그래프가 너무 비어 있어 검토 자체가 불가능하다면, 출력은 NOT REVIEWABLE로 시작한다. 청정 통과 대신이다. "보고할 내용 없음"과 "비교할 대상 자체가 없음"은 전혀 다른 사실이며, 둘 중 좋은 소식은 하나뿐이다.
드디어 직접 지켜본 순간
이 부분을 처음 쓸 때만 해도 GitHub는 대규모 장애 중이었다. API, Actions, Issues, Pull Requests가 모두 멈췄다. 나는 예약 실행이 단 한 번도 초록불에 도달하는 것을 직접 본 적이 없다고 썼고, 이 글의 규칙대로라면 그 상태로는 끝났다고 할 수 없었다.
그러다 장애가 풀렸고, 나는 작업을 실제로 보냈다.실패했다. 네 번이나, 그것도 전혀 예측하지 못한 두 가지 이유로.
첫 번째 실패가 더 유익했다. 리뷰 자체는 완벽하게 동작했다. 엔드포인트를 호출했고, 리포트를 만들었고, docs/reviews/2026-08-17-weekly.md을(를) 기록했고, 브랜치를 푸시했다. 그리고 마지막 단계에서 GitHub Actions is not permitted to create or approve pull
requests로 멈췄다. 기본값이 꺼져 있던 저장소 설정 — 나는 한 번도 들여다본 적 없는 옵션이었다.
이것이 내가 이 글 내내 해부한 크론(예약 작업)에 어떤 의미인지 곱씹어볼 만하다. 이 스카우트에는세 가지가 빠져 있었다. 한 번도 등록되지 않은 시크릿, 0으로 종료하지 않고 실패하는 단계, 아무도 켜지 않은 저장소 권한. 셋 중 하나만 고쳐도 여전히 아무 일도 일어나지 않는다.나는 버그 하나를 찾아낸 걸로 스스로를 칭찬했다. 실제로는 세 개였고, 그 중 세 번째는 작업이 충분히 크게 실패해준 덕분에야 비로소 드러났다.
이후 세 번의 실패는 GitHub 자체의 503 오류였다. 부분 장애로 마지막 단계에서 계속 흔들렸다. 네 번째 시도에서야 초록불이 떴다. 실행 32054945733을(를) 끝까지 지켜봤고, 그 결과 PR #303 실제
리뷰가 포함되어 있다 — 해당 기간 12건의 딜리버리, 14일 넘게 정지된 레포지토리 3개, 수익 속도에 걸린 트립와이어 1건, 그리고 서명되지 않고 중립화된 노드 가중치 13개. 또한 자체
주기 점검 결과도 함께 출력했다: 이전 주간 리뷰 없음 — 이번이 첫 번째다.
이제야 말할 수 있게 되었다. 그리고 그 과정에 주목하라: 이 글의 솔직한 결말에 도달하려면 네 번의 실패와 저장소 설정 변경 이 더 필요했다. 단순히 코드를 짜고 초록불만 믿었다면 결코 알 수 없었을 것이다.
아직도 내가 의도적으로 하지 않은 일이 하나 남아 있다. 크레덴셜 중 하나 — 스킬 루프에 필요한 것 — 는 배포 환경에는 있지만 저장소에는 없다. 그 값을 교체하면 30초 만에 크론을 초록불로 만들 수 있었지만, 문서에 따르면 다른 시스템이 여전히 이전 값으로 해당 엔드포인트를 헤드리스 호출하고 있다. 보이지 않는 호출자가 가진 크레덴셜을 교체했다면, 오늘 하루 종일 없애려던 바로 그 조용한 고장을 새로 만들어냈을 것이다. 그래서 그 작업은 이제 명확하고 크게 실패하며, 사람이 값을 복사해 넣을 때까지 계속 실패 상태로 남는다. 분명한 빨간불은 끝난 일이다. 조용한 초록불은 아니다.
이것이 2026년 8월 현재, 내가 보는 장기 지평 에이전트 엔지니어링의 솔직한 현주소다. 성장 곡선은 가파르고 실제다. 기록상 가장 뛰어난 시스템도 15.2%의 작업만을 완수한다. 그 작업은 agent 기준 약 85분, 990만 토큰이 걸린다 — 그리고 그 논문은 인간 기준선을 전혀 보고하지 않으니, 이 작업이 사람에게 얼마나 걸리는지 누구도 말할 수 없다. 그리고 실제로 비용을 발생시키는 실패는 에이전트가 멈추는 것이 아니다. 멈춘 채로 성공을 보고하는 것 — 42일 동안, 가지런히 정렬된 초록불 열로 남는 것이다.
관련 글
참고문헌
- RUC-NLPIR. Awesome-Long-Horizon-Agents: 장기 지평 에이전트의 로드맵. 두 축 분류(harnesses / optimization)와 여섯 가지 harness 구성요소; 2026년 7월 서베이 공개에 맞춰 리포지토리 구조 개편. github.com/RUC-NLPIR/Awesome-Long-Horizon-Agents
- Li, Z., Li, Z., Shi, Y., 외. (2026년 7월 9일). Long-Horizon-Terminal-Bench: Testing the Limits of Agents on Long-Horizon Terminal Tasks with Dense Reward-Based Grading. arXiv:2607.08964. 9개 카테고리에서 46개 과제; 실행당 약 231 에피소드, 85.3분; 과제당 약 990만 토큰; 0.95 및 1.0 보상 임계값에서 최고 모델 pass@1이 각각 15.2% / 10.9%, 평균 4.3% / 1.7%.arxiv.org/abs/2607.08964
- Albayaydh, W., Zhao, R., & Flechais, I. (2026년 7월 7일). Beyond the Leaderboard: A Synthesis of Tool-Use, Planning, and Reasoning Failures in Large Language Model Agents. arXiv:2607.05775. 총 27편 논문, 19개 벤치마크, 6가지 실패 유형을 다루며, 세 가지 주요 발견은 초록에서 하나의 연속된 영문 인용문으로 제시된다(이 중 두 번째 절은 본문 이전 초안에서 누락된 부분임). arxiv.org/abs/2607.05775
- METR (2026년 1월 29일). Time Horizon 1.1. P50 기준 두 배 증가 주기: 전체 기간 약 195.8일, 2023년 이후 130.8일, 2024년 이후 88.6일(TH1.1 기준); 두 개의 주의 문장은 모두 영문 인용문으로 인용됨. metr.org/blog/2026-1-29-time-horizon-1-1/ · 이전 방법론: Measuring AI Ability to Complete Long Tasks
- Anthropic. Effective context engineering for AI agents. 컨텍스트 엔지니어링과 프롬프트 엔지니어링의 정의, "attention budget"(주의 예산) 프레이밍, 컴팩션(compaction), 구조적 노트 작성, 서브에이전트 아키텍처 등 네 가지 인용문이 모두 원문과 일치함을 검증함. anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic (2025년 12월 9일). Donating the Model Context Protocol and establishing the Agentic AI Foundation. AAIF는 Linux Foundation 산하에 설립되었으며, Block 및 OpenAI와 공동 설립, Google, Microsoft, AWS, Cloudflare, Bloomberg가 후원한다. anthropic.com/news/donating-the-model-context-protocol…
- The New Stack (2026). Temporal, Durable Execution 플랫폼에 서버리스 옵션 공개. Replay 2026 발표; 내구성 실행 인프라가 AI 에이전트 워크플로우를 명확히 겨냥함. thenewstack.io/temporal-replay-2026-news/ · 벤더 포스트: temporal.io/blog/replay-2026-product-announcements
- Tom's Hardware. Auto-GPT와 BabyAGI: AI의 새로운 화제, 그러나 지금은 실망스럽다. (2023년 4월 22일.) 동시대 실사용 평가로, 직접 인용이 아닌 서술로 전달된다. 별점 수치는 언급되지 않으며, AutoGPT의 인기 평가는 본문에서 정성적으로만 다루고 구체적 수치는 제시하지 않는다.tomshardware.com/news/autonomous-agents-new-big-thing
- DataCamp. AgentGPT: 브라우저 기반 자율 AI 에이전트 안내서. 2023년 11월 개발 중단, 2024년 7월 모회사 사업 전환; 130건이 넘는 미해결 이슈와 함께 유지보수 모드로 전환.datacamp.com/tutorial/agentgpt
- BSWEN (2026년 6월 17일). LangChain에서 AgentExecutor는 더 이상 권장되지 않는가? 2026년 LangChain 에이전트 API의 실제 동향.
AgentExecutor,initialize_agent그리고 이전create_react_agent도 더 이상 권장되지 않으며,create_agent가 공식 대체안으로 지정되고 그래프 런타임으로 통합된다 — 본문에서 주장하는 내용은 여기까지이다. 추가로 2가지 세부사항이 2차 자료에 등장하지만 이 페이지에는 없음: 2026년 12월 지원 종료일, 그리고 기존 생성자들이langchain-classic패키지로 이동했다는 점. 둘 다 본문에서는 주장하지 않는다.docs.bswen.com/blog/2026-06-16-is-agentexecutor-deprecated-langchain/ - OneUptime (2026년 2월 3일). Elixir에서 Supervisor 활용법. 슈퍼비전 트리의 동작 원리와, 작업과 복구의 분리 방식은 설명만 되었고 직접 인용은 아님 — "separating the concerns of normal operation from the concerns of error recovery"라는 문장이 인용문으로 널리 회자되지만, 실제로 이 문구를 담은 출처는 찾지 못했으며, 이 사실 자체가 본문에 명시되어 있다.oneuptime.com/blog/post/2026-02-03-elixir-supervisors/view · WhatsApp의 수치("서버당 동시 접속 200만 건, 50명 미만 엔지니어 팀")와 Discord 사례는 Elixir and OTP for AI Agent Systems
- Temporal. Workflow Execution overview 및 Event History walkthrough. 이벤트 기록을 영구적으로 보존되는 로그로 관리하며, 이미 성공한 작업은 건너뛰고 처음부터 재실행한다는 점, 그리고 Temporal이 Uber의 Cadence에서 이어진 계보임을 설명한다. docs.temporal.io/workflow-execution · docs.temporal.io/encyclopedia/event-history/…
- Royal Museums Greenwich. Longitude found: Nevil Maskelyne and the lunar method. 본문에 인용된 "plucky underdog" 경계 문구, Maskelyne의 옹호, Nautical Almanac 표, 그리고 해상 시계가 "여전히 희귀하고 비쌌으며, 신뢰성과 선원들의 신뢰를 얻기까지 수십 년이 걸렸다"는 문장의 출처이다. 이 페이지는 Harrison을 약자 영웅으로 보는 내러티브를 바로잡기 위해 존재하며, 본문에서도 이를 인용하지 않고 그 사실을 직접 언급한다. rmg.co.uk/stories/time/longitude-found-nevil-maskelyne-lunar-method · Linda Hall Library, Nevil Maskelyne — 본문에서 사용된 두 번째 항해 시험 수치(H4 "정확도 10마일 이내", "lunar distance-method는 30마일 이내 정확도")와 Maskelyne의 보고서 원문("wrote a negative report, saying that the chronometer had built-in errors which just happened to cancel each other out"), 그리고 그가 이사회 위원 자격으로 Harrison의 상금 청구를 계속 반대한 사실의 출처이다. lindahall.org/…/nevil-maskelyne/. H4의 약 1마일 정확도 수치는 다른 항해에서 나온 것이며, 본문에서는 의도적으로 30마일 수치와 함께 제시하지 않았다.
- Slate (2015년 10월). Naval Academy Brings Back Celestial Navigation Training in Case of a Cyberattack on GPS. 10여 년 만에 2015년 여름 재도입; 1990년대 후반 GPS/전자 항법으로 대체되었던 과정; LCDR Ryan Rogers의 발언이 원문 그대로 인용됨; 재도입은 3시간 분량의 입문 세션이었다.slate.com/technology/2015/10/… · 추가 확인: Military Times · Sky & Telescope
- Wikipedia. Lunar distance (navigation). 두 날짜만 해당 페이지에 명시되어 있다. 영국 Nautical Almanac의 lunar tables는 "1767년부터 1906년까지 출간"되었고, 저렴한 마린 크로노미터의 등장으로 1850년경 대체되었다. 이 글의 초기 초안에서는 1907년, 1919년, 1905년의 무선 시보 중단을 이 페이지에 근거해 언급했으나, 셋 중 어느 것도 실제로는 포함되어 있지 않다 그래서 세 항목 모두 재출처화하지 않고 삭제했다. en.wikipedia.org/wiki/Lunar_distance_(navigation) · 학술적 논의이나, 여기서 주장에 인용되지는 않음: Wepster, A (not so) brief history of lunar distances, arXiv:2007.14504
- Boyne, W. J. (2013년 8월). The Checklist. Air Force Magazine. 1935년 10월 30일 Model 299 추락 사고; 사고 조사위원회의 "it was improbable that any pilot…"(번역: 동일 조건에서 이륙하는 어떤 조종사도 잠긴 조종 장치를 너무 늦게 발견하지 않을 가능성은 낮았다) 판정, "the limiting factor here was human memory, not the aircraft's size or complexity"(번역: 이 사례의 제한 요인은 항공기의 크기나 복잡성이 아니라 인간의 기억력이었다), 그리고 이 개념이 1935년 이전부터 존재했으며 사고로 제도화되었을 뿐이라는 정정 — 세 가지 모두 기사 본문에서 그대로 인용됨.airandspaceforces.com/…/0813checklist.pdf · 사고 기록: National Air and Space Museum
2026-08-17 기준, 30일·30개월·30년·300년 네 개의 시계열에 걸쳐 조합된 리서치 패킷. 총 16개 출처.이 초안은 첫 번째 자체 리뷰에서 탈락했다. 새로운 맥락을 가진 독립 리뷰어가 모든 인용문을 해당 페이지와 대조해 확인했고,핵심 결함 6건과 부차적 결함 12건을 발견했다, 그리고 수정된 초안을 두 번째로 검토했을 때도 16개의 추가 결함(그중 10개는 본질적인 문제)이 더 드러났다. 그래서 거짓된 초록불 보고에 관한 글의 말미에는 '모두 검증됨'이라고 쓰지 말고, 무엇이 잘못되었는지 밝혀야 한다. 출간 전 바로잡은 내용: Erlang 슈퍼비전에 관한 한 문장은 어느 인용 출처에도 없어서 인용부호 없이 본문에 사실대로 썼다. 크로노미터가 '너무 비싸고, 대량생산이 너무 어렵다'는 문구는 아트워크, 등록정보, 홍보 키트에 인용부호로 등장했고, 본문에서는 '사실상 인용'이라는 애매한 표현으로 기울임꼴 처리되어 있었으나, 실제로는 어떤 출처에도 없었으므로 Maskelyne의 실제 보고서 내용으로 대체했다. '1해리 대 30해리' 비교는 서로 다른 두 항해 실험을 합친 것이었으나, 이제는 동일 실험의 10대 30으로 바로잡았다. 세 날짜(1907, 1919, 1905)는 해당 페이지에 없었으므로 모두 삭제했다. 지원 종료일과 GitHub 별점도 같은 이유로 삭제했다. 그리고 300년짜리 가장 강력한 사례였던 해군사관학교의 2015년 복귀는 이 글의 반대편에 잘못 분류되어 있었고, 그 덕분에 글의 결론이 더 날카로워졌다. 검증을 통과한 인용문: Anthropic의 네 문장, 1935년 사고 내러티브의 세 문장, METR의 두 가지 주의사항, 해군사관학교 인용문, arXiv 초록의 전체 문장. 30년짜리 두 사례는 건재함으로 분류했지 생존으로는 분류하지 않았다. 그 이유는 이번 조사에서 부고와 부활의 증거를 찾지 못했기 때문이다. 5회 연속 초록불과 42일간의 공백은 모두 필자의 공개 저장소에서 가져온 것이고, 네 번의 실패한 실행과 저장소 권한 문제 역시 마지막에 설명한 대로 직접 경험한 것이다. 이 부분은 실제로 cron을 돌린 뒤에 다시 썼다. 초안에서는 실행을 한 번도 지켜본 적이 없다고 썼는데, 만약 그대로 뒀다면 실행되는 순간 페이지에 거짓말이 남았을 것이다. 어떤 고용주나 클라이언트의 자료는 일절 포함되지 않았다. — Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app