AIネイティブ連載:エージェント工学
六週間、緑のまま
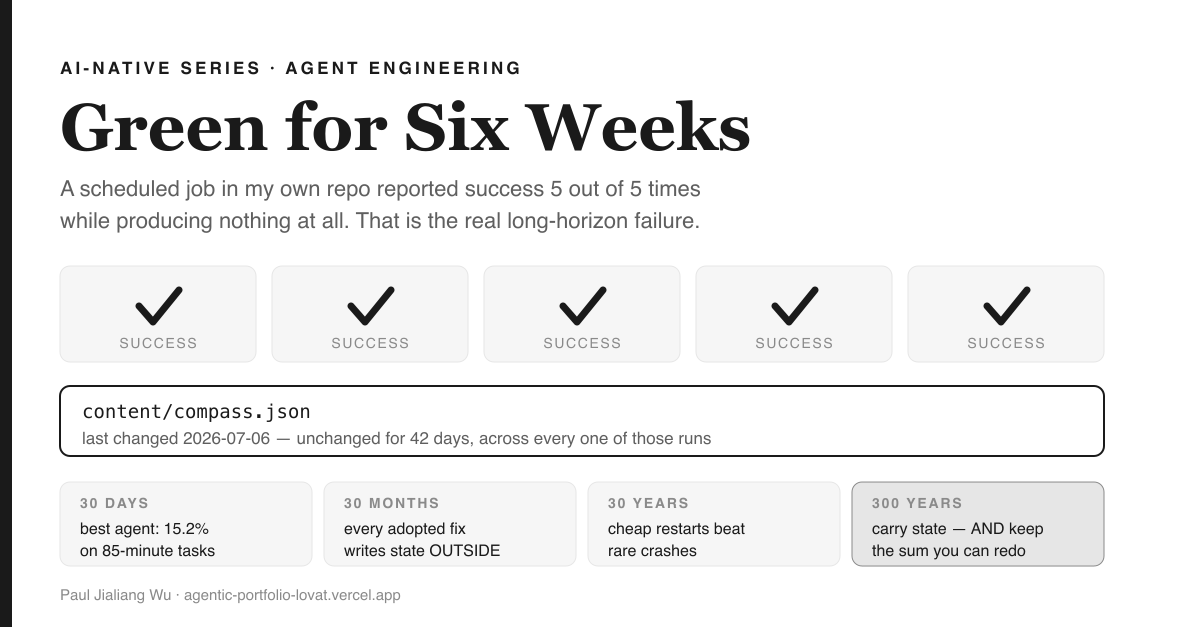
1分でつかめる要点:この記事で得られるもの
自分のポートフォリオで定期実行しているエージェントが5回連続で成功と記録し続けていたが、出力先のファイルは42日間一度も更新されなかった。原因はシェルの三行——資格情報が設定されていなかった。exit 0。自分のエージェントが本当に長期間役立つにはどう設計すべきか、30日、30カ月、30年、300年という4つの時間軸で調べてみた。どの時代を切り取っても、行き着く先は同じだった。実際に現場で使われている手法で、モデル自身の記憶力を伸ばしたものは一つもない。生き残った仕組みはすべて、状態をモデルの外に出し、再起動のコストを下げている。圧縮、ノート、チェックポイント、スーパービジョンツリー、リプレイ可能なログ、そして三百年前なら持ち運びできる時計と、いつでもやり直せる計算。結局、最後に残る致命的な失敗はただ一つ――「問題なし」と記録されているのに、実際には何も起きていないケースだ。頭の中で思い描くべきモデルは航海日誌で、そこには三つのルールがある。三つ目こそ、誰もが見落とす。
木曜の朝、リポジトリのActionsタブを開き、スカウト――毎週一度、自分の公開GitHub群を巡回し、どのプロジェクトを深掘りするか・誰に連絡するかを記録する小さなスケジュールエージェント――の様子を見た。答えは一つのファイルに書き込まれる。content/compass.json。このファイルをサイトがそのまま表示する。
5回分のスケジュール実行。5つの緑のチェックマーク。きれいに並んだ成功の列。
そしてファイルを確認した。最終更新日は2026-07-06。それが42日前――ちょうど6週間前だった。
原因は三つの条件文からなる、自分が書いたシェルスクリプトだった。
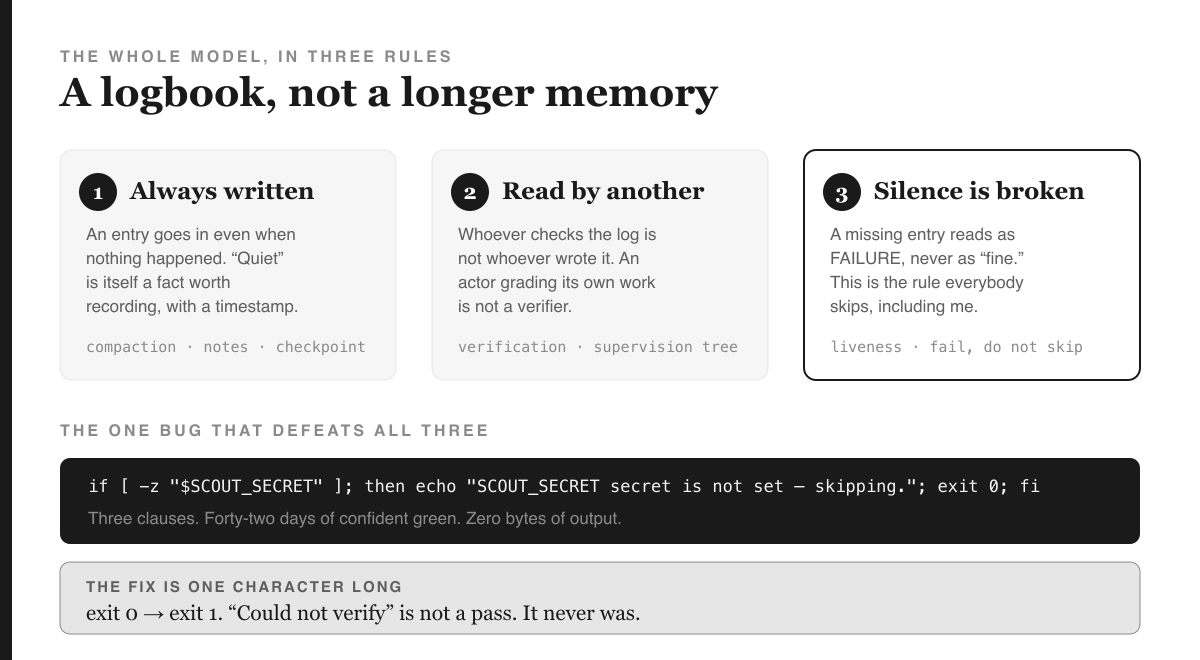
if [ -z "$SCOUT_SECRET" ]; then echo "SCOUT_SECRET secret is not set — skipping."; exit 0; fi認証情報が一度も設定されていなかった。だから毎回、ジョブは起動して鍵がないことに気づき、誰も読まないログに丁寧にそれを書き残し、exit 0で終了した。exit 0は「成功」を意味する。GitHubはチェックマークを描いた。私はそれを信じてしまった。
この状況を少し想像してほしい。これは「cronが壊れた」話ではない。壊れたcronなら人間が呼ばれるから、まだ健全だ。だが今回は、人間が五度も排除された。「ご利用ありがとうございます」と言ってくる唯一のバグの種別である。
本来ならこの日、長期ホライズンのエージェントエンジニアリング――エージェントを数分ではなく数時間・数日間まともに動かす技術――を調べる予定だった。だが午前中はこの修正に追われ、そして気づいた。自分が調べようとしていたテーマはまさにこの現象そのものだった。四つの時間軸、四つの分野、答えは一つ。
モデルは「ログブック」であって、単なる長期記憶ではない
要点はこれだけだ。以下の専門用語を知らなくても、すぐに実践できる。
船が何ヶ月にも及ぶ航海に出る。乗組員の誰も、その全行程――進路の変更も、天候も、水深も――を頭の中にすべて覚えておくことはできない。だから最初から覚えようとしない。その代わりにログブック――位置や針路、状況などを定期的に記録し、見知らぬ人でも手に取って続きを始められるように残す。
このログブックが本当に船を救うには、三つの条件が必要だ。
- 何も起きなかったときでも、必ず記録すること。「異常なし、変化なし」も立派な記録だ。空白のページは違う。
- 記録を書いていない人が、それを読むこと。ログをつけている士官だけが、その記録を見るわけではない。
- 記録に抜けがあれば、それは「穏やかな一週間」ではなく「何かがおかしい」というサインだ。「穏やかな一週間だった」ではない。異常である。
これだけだ。本記事で紹介するあらゆる技術は、この三つのルールのどれかが技術的な衣をまとったものにすぎない。そして私のスカウトは三つ目――「何も書かないこと」に関するルール――で失敗した。だからこそ、よく抜け落ちる。
📰 ウィンドウ1:今月、現場で話題になっていること
最新の話題は最も注目されやすいが、最も信頼しにくい。だからこのセクションは「人々の注目を集めていること」として受け止めてほしい。真実とは限らない。注目度で順位が決まるが、注目度は証拠ではない。
特筆すべきは、2026年7月にこの分野が自らに名前と輪郭を与えたことだ。人民大学RUC-NLPIRラボが管理する長期視野エージェントのロードマップ[1]は、全文献を二本柱で整理している:外部化されたharness(モデルの外側の足場)と、内部化されたoptimisation(能力をモデル自体に学習させること)。harness側には、ループとワークフロー、コンテキストとメモリ、ツール、オーケストレーション、フックとミドルウェア、検証――ちょうど六つの構成要素がある。
この一覧を航海日誌の三つのルールに重ねてみる。コンテキストとメモリが第一のルール。検証が第二のルール。フックやミドルウェアは、もし誰かが本当に作れば第三のルールが居場所を得るはずの領域だ。
一方で、最新の計測結果はなかなか手厳しい。2026年7月9日に公開されたベンチマークは、9カテゴリ・全46の本格的な長期ターミナルタスクを用意し、それぞれを段階的なサブタスクに分解して、進捗が単なる合格/不合格に押しつぶされず見えるようになっている[2]。1回の実行で平均231エピソード・85.3分、さらに1タスクあたり約990万トークンを消費する。最強モデルのスコアは15.2%で部分点の閾値、10.9%で満点。全モデルの平均は4.3%と1.7%.
さらに、2026年7月7日提出の論文27本・ベンチマーク19種の総括は、エージェントの失敗を6分類し、そこから3つの発見を1文で述べている[3]。どれも重要なので、全文をそのまま引用する。著者らは"that failures compound nonlinearly with task length, that strong performance on individual sub-tasks does not reliably translate into end-to-end success, and that additional scaffolding does not consistently improve reliability."(訳:失敗はタスクが長くなるほど非線形に積み重なり、個々のサブタスクで高いパフォーマンスを出しても全体の成功には安定してつながらず、足場を増やしても信頼性が一貫して向上するとは限らない。)
このうち、部分点ベンチマークで最も際立つのが真ん中の節で、最後の節がコストのかかる部分だ。
部品をいくら増やしても、航海日誌の本質は増えない。ハーネスの6要素を全部盛っても、私のスカウトと同じ落とし穴に落ちる。
🌗 ウィンドウ2:デモ止まりか、標準になったか
30か月は「採用されたか否か」がはっきり見える期間だ。デモが本当に現場に届いたか、話題だけで消えたか。評価はローンチ時の熱狂ではなく、実運用の証拠で決める。
まず、誰もが引用する数字から。METRはAIエージェントが自律的にこなせるタスクの長さを測っており、その伸びは本当に指数的だ。METRによれば「約7か月ごとに倍増」しており(2019〜2025年)、フィットしたP50値は195.8日、つまり約6か月半。そして新しい手法では130.8日が2023年以降、88.6日(2024年以降[4]。倍増まで3か月を切った。)
さて、グラフの裏に隠れて語られにくい話に移る。METR自身の言葉をそのまま引く。"These confidence intervals are still very wide, and we are actively working on adding more long tasks…"(訳:これらの信頼区間はいまだ非常に広く、私たちはより多くの長時間タスクの追加に積極的に取り組んでいる…) そして人間によるベースライン計測時間については、"measured for only 5 of our 31 long (8h+) tasks. The remainder use estimated times"(訳:31個の長時間(8時間超)タスクのうち、実測値があるのは5つだけで、残りは推定値を使っている) [4]。カーブ自体は本物だが、その先端は5つの実測データ点だけで描かれている。これを知らずに外挿してビジネスを立てるのは危うい。
では、実際に現場で定着したのは何か。ここで挙げる3つの技法は、まさに今この文章を打っているラボのコーディングエージェントでも実運用されている[5]。そのリソース観の転換が本質なので、引用も正確にいく。"LLMs have an 'attention budget' that they draw on when parsing large volumes of context. Every new token introduced depletes this budget by some amount…"(訳:LLMは大量のコンテキストを解析する際に「アテンション予算」を消費する。新たなトークンが追加されるたびに、この予算は一定量ずつ減っていく…) コンテキストはストレージではなく、消費する予算だ。
この前提に立つと、実際に採用された3つの手法はすべて「どこか別の場所に書き残す」系統になる:
- コンパクション(要約圧縮) — "the practice of taking a conversation nearing the context window limit, summarizing its contents, and reinitiating a new context window with the summary"(訳:コンテキストウィンドウの上限に近づいた会話を要約し、その要約で新たなコンテキストウィンドウを開始する手法) [5]。航海日誌に一行書いて、新しいページを開くようなものだ。
- 構造化ノートテイキング — "a technique where the agent regularly writes notes persisted to memory outside of the context window"(訳:エージェントが定期的に、コンテキストウィンドウの外部に永続化されたノートを書き残す手法) [5]。これが航海日誌そのもの。
- サブエージェント — "Rather than one agent attempting to maintain state across an entire project, specialized sub-agents can handle focused tasks with clean context windows"(訳:1体のエージェントがプロジェクト全体の状態を保持しようとするのではなく、専門化されたサブエージェントが、クリーンなコンテキストウィンドウで個別のタスクを担当する) [5]。これは当直交代に近い。
こうした手法と並行して、基盤の標準化も進んだ。Model Context Protocolは2024年11月に登場し、2025年12月9日、AnthropicがこれをLinux Foundation傘下のAgentic AI Foundationへ寄贈した。BlockやOpenAIと共同設立、Google、Microsoft、AWS、Cloudflare、Bloombergが支援に名を連ねる[6]。競合ラボが13か月で共通インターフェースを中立財団に渡した時点で、それはもはや単なる新製品ではなく標準だ。同じ時期、クラッシュ耐性のある実行基盤もエージェント用途に明確に舵を切った。Temporalの2026年カンファレンスでは、まさにこうしたワークフロー向けのサーバーレスワーカーが発表された[7]。
ここにパターンがある。この記事の背骨なので、はっきり書く。どの手法も、モデル自体の記憶力を伸ばすことには一切成功していない。 すべて、状態をモデルの外に出し、耐久性・可観測性・再開性のある仕組みに移しているだけだ。
同じ期間で消えていったものたち
採用ランキングから失速したデモを除けば、それは単なるプレスリリースに過ぎない。つまり、この時代で最も話題になったエージェントプロジェクトは、結局定着しなかったものばかりだ。AutoGPTとBabyAGIは2023年初頭に一気に注目を集めたが、その当時の実地評価は、レビュアーがcouldn't find a single practical use case where they do a good job(訳:彼らがうまく機能する実用的なユースケースを一つも見つけられなかった) [8]。AgentGPTの開発は2023年11月に停止し、親会社は2024年7月に方向転換。プラットフォームは130件以上の未解決課題を抱えたままメンテナンスモードに入った [9]。
そして最も示唆的なのは、API設計の顛末だ。LangChainのAgentExecutor ― いわゆる「モデルをひたすらループさせて終わるまで回す」ための定番抽象化 ― は非推奨となり、initialize_agent および従来のcreate_react_agentも同様に廃止された。公式な代替は単一のcreate_agent [10]。理由は明快で、ループでは分岐や人間の介入、耐久実行に対応できず、グラフランタイムならそれができるからだ。
ループはグラフに敗北した。ループは状態を自分の中に抱え込むプロセス、グラフは状態を外に書き出し、途中で止めて中身を見たり再開したりできるプロセスだ。ここでも「状態を外に出す」というルールがフレームワークの勝敗を分けた。
🕰 ウィンドウ3:30年持ちこたえたもの
今度は「どれだけ生き残ったか」で並べると、リストは一気に地味で短くなる。正直に言うと、以下の2つは今も現役であって、「完全な生存証明」ではない。なぜなら、どちらも「死んで復活した」証拠まではこの調査で見つからなかったからだ。
スーパービジョンツリーと「落ちたら再起動」 Erlang/OTPが長時間稼働システムに出した答えは、「失敗しないコードを書く」ことではなかった。プロセスをツリー状に配置し、スーパーバイザーの役割は子プロセスの死を検知して再起動することだけ。今も現役で使われている:WhatsAppは1台のサーバーで200万同時接続を50人未満のエンジニアで支えたし、Discordも同じ系譜のリアルタイム基盤を使っている [11]。この哲学はよく誤解されるので、ここで補足しておく。「雑にやれ」という意味ではない。Erlang/OTP自身の設計原則では、リカバリのロジックを別プロセスに分離している。つまり、スーパーバイザーは「本体のコードが自分の障害復旧まで抱え込まなくて済む」ために存在している [11]。通常運用とエラー回復はまったく別のプログラムで、ツリーの別の枝がそれぞれ担当する。(この考え方は多くのブログ記事で引用され、私自身もこの段落の初稿で引用していたが、実際にそう書いている出典は見つからなかったので、ここでは引用符なしで記す。)
耐久ログからのリプレイ 耐久実行、つまりUberでCadenceを作ったエンジニアたちが開発したTemporalは、すべてのワークフロー履歴をプロセス外の耐久イベントログとして保持し、決して失われない。再起動時にはワーカーがワークフローコードを最初からリプレイするが、まだ実行されていない部分だけを実行し、すでに成功したアクティビティはスキップされる [7], [12]。この発想自体は製品よりも古く、「書き込み先行ログ」の新しい顔だ。私はその系譜を説明しているだけで、特定の引用を主張しているわけではない。
この2つを並べてみると、仕組みがはっきりする。
どちらも長時間運用の失敗そのものを防ぐことは考えていない。 どちらも「失敗してもすぐに立て直せる」ことに全振りしている。信頼性工学が30年かけて手にしたのは、クラッシュの減少ではなく、再起動の安さだった。
だから「モデルを賢くしてスレッドを見失わないようにする」路線には前例がなく、「スレッドを見失っても90秒で復帰できるように頻繁にチェックポイントを打つ」路線には30年分の実績がある。
🏺 300年生き残ったもの
このスケールになると、一世代の成功例など誤差でしかない。世代をまたぎ、致命的な基盤の変化すら乗り越えたものだけが残る。そして実際、我々と同じ領域で生き残ったのは2つだけだ。「長すぎて覚えきれない仕事で、自分が今どこにいるかを知る」ための仕組みである。
持ち運ぶ時計と、毎回やり直す計算
経度の問題は、まさにロングホライズン問題そのものだった。緯度は簡単で、太陽を見れば済む。 経度は「他所の時刻」を知る必要があり、長い間、海上でそれを知る術はなかった。18世紀には2つの解法が競い合い、今もこの2つが現役の戦略だ。
状態を持ち運ぶ: John Harrison のマリンタイムキーパーは基準時刻を持ち続けたので、位置の特定はその時刻を読むだけで済んだ。毎回再導出する: 月距法は月と星の角度を測り、基準時刻を逆算する——新しい観測、天文暦表、そして球面三角法の長い計算を毎回ゼロからやる方法だ。
数字に入る前に、どうしても伝えておきたい注意がある。私が最も頼った情報源は、ほぼこの警告を発するために存在している。Royal Museums Greenwich はこの対立の冒頭でこう述べている:"The brilliant John Harrison has long been portrayed as the plucky underdog…"(訳:卓越した John Harrison は長らく、勇敢な負け犬として描かれてきた……) そしてこのことが"has however tarnished the reputation of another brilliant man: Nevil Maskelyne"(訳:しかしそのことが、もう一人の卓越した人物 Nevil Maskelyne の名声を傷つけてきた) [13]。自分が育ち、最初に下書きしたのはこの「負け犬」バージョンだが、それは歴史家が語るものではない。
なので慎重に。話は2回目の航海試験——両方の手法が直接比較された試験——で、Harrison の H4 はおよそ10マイル そして、ルナーディスタンス法はおよそ30マイルの精度だった [13]。出典は「miles」とだけあり、陸マイルか海里かは明記されていないので、私も区別しない(H4の有名な「約1マイル」精度の記録は実際に存在するが、それは別の航海での話であり、両者を比較するのは2つの実験を1つに混ぜることになる)。Maskelyneは王立天文官としてNautical Almanacの表を出版し、ルナー法を実用的なものにした。また、委員会メンバーとしてHarrisonの賞金請求に「continued to resist Harrison's claim for the award」[13](訳:Harrisonの受賞請求に引き続き反対した)とし、さらに彼の時計を評価し、Linda Hall Libraryの記録によれば、"wrote a negative report, saying that the chronometer had built-in errors which just happened to cancel each other out"(訳:クロノメーターには内在的な誤差があり、それらがたまたま互いに打ち消し合っただけだとする否定的な報告を書いた) [13]。つまり「偶然うまくいっただけ」とは違う、より具体的で、より厳しい指摘だ。君の器械は、偶然正しかっただけだ。
ルナー法は19世紀のかなりの期間、実際に有効かつ標準的な手法だった。クロノメーターが手頃になったのは1850年頃で、イギリスは1767年から1906 [15].
ここからは、勝者の物語が現代の価値観で美化されていることを正直に書いておく。クロノメーターへの異議は「高価で大量生産が難しい」というものだった——そしてその異議は、1世紀近くにわたって正しかった。RMGははっきり書いている:海洋用時計は「remained rare and expensive; it took decades to establish their reliability and for seafarers to trust them」[13](訳:希少かつ高価なままであり、その信頼性が確立され、船乗りたちが信用するまでには何十年もかかった)。Harrisonの試験は1761年、手頃になったのは1850年頃——約90年と見てよい(「around」は出典の表現で、厳密な数値ではない)。コストへの異議は三世代にわたって正しかったが、最終的には敗れた。それは「先見の明が勝利した」という話よりもずっと実用的な教訓であり、私はこのことをエージェントシステムのチェックポイント・オーバーヘッドにも当てはめたい:その異議は今は正しくても、設計方針としては間違いになることもある。
そして、敗者は「バックアップ」として戻ってきた。
ここで、自分でも危うく逆の側に分類しそうになった事例を挙げる。
米海軍兵学校は1990年代後半に天文航法をカリキュラムから外し、その時間をGPSや電子航法に振り替えたが、2015年夏に復活させた。理由は「GPSは妨害されうる」からだ。航海・航法部門の副部長は、その理由を一行でこう言っている:コンピュータは素晴らしい、だが"The problem is there's no backup"(訳:問題はバックアップがないことだ) [14].
さて、何が戻ってきたのかを見てほしい。六分儀観測、天文暦、観測値の計算——つまり再導出の手法である。18世紀の勝負で敗れた側が、現代の海軍でバックアップとして復活した。再導出が安いからではない——明らかにそうではない。再導出は「空」以外に依存しないが、持ち運ぶ状態は他人が運用する衛星に依存するからだ。
ここから「状態を持ち運ぶか再導出するか」という単純な二択よりも、もっと鋭いルールが導ける:
状態はできるだけ小さくまとめて持ち運ぶ。それが安上がりだからだ。ただし、その安い道が塞がれたときに唯一頼れるのは、ゼロから状態を再構築できる手段を残しておくことだ。
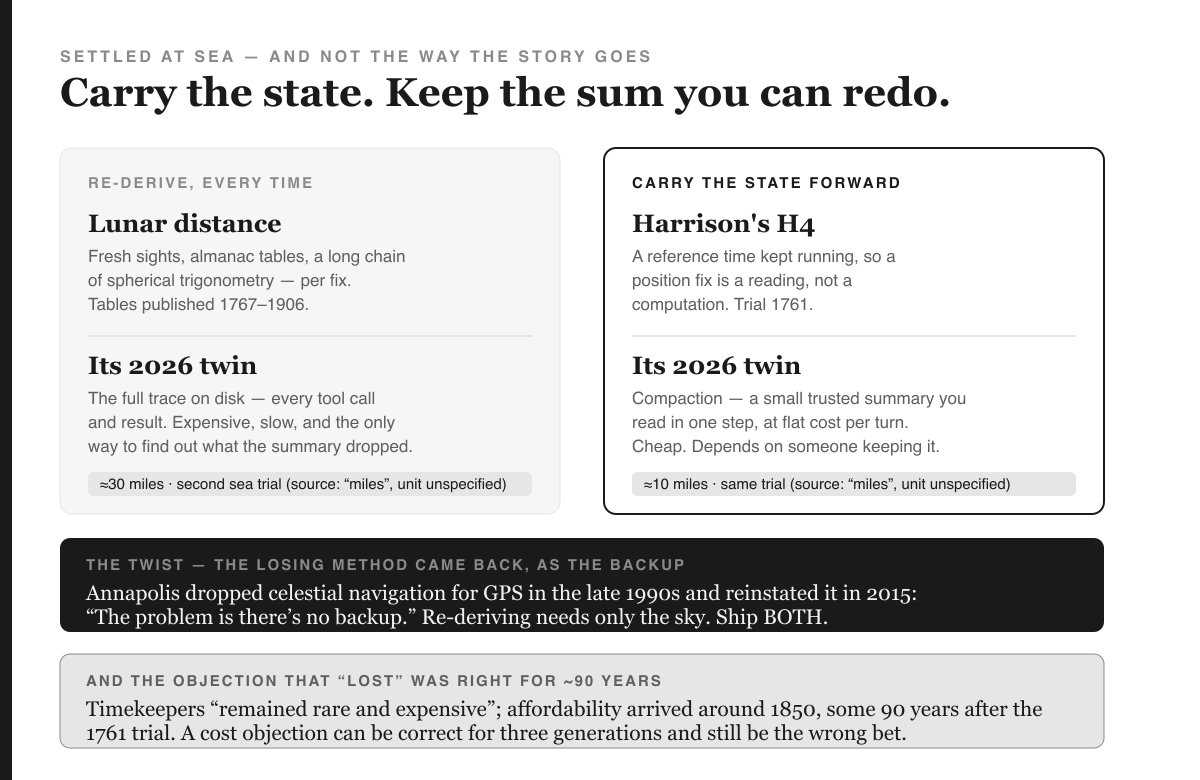
これは比喩ではなく、エージェントの設計そのものだ。コンパクションはクロノメーター――一瞬で読める信頼できる要約。すべてのツール呼び出しと結果をディスクに残す完全なトレースは六分儀――高価で遅いが、要約が肝心な情報を落としたときに自分の現在地を唯一突き止められる手段だ。両方積むのが筋だ。だが多くのエージェントスタックは前者しか持たず、いざという時に「要約しか残っていなかった」と気づく羽目になる。
これを十八世紀の逸話で正当化する必要はない。なぜなら、この記事で紹介した実運用システムがすでに実践しているからだ。Durable execution(耐障害実行)は、完全なイベントログを保持し、さらに そこからリプレイする。ログは六分儀、リプレイは観測値からの再計算、そして既に成功したアクティビティをスキップするのが持ち運ばれた状態だ[7], [12]。Temporalは両方を備えている。そして海も、実際にはどちらか一方だけを選んだわけではない。同じページには「a mariner with a chronometer could check its accuracy using a lunar determination of Greenwich time」(訳:クロノメーターを持つ航海士は、月距離法でその精度を確認できた)[15]とも記されている。時計を持ち、六分儀も残し、互いに監査する。2015年、海軍は後者を再び学び直した。唯一「どちらか一方」しか選んでいないのは、エージェントスタックだけだ。
ただ、何が復活したのかは正確に書いておきたい。なぜなら、正直なバージョンの方が皮肉も効いていて役に立つからだ。戻ってきたのは昔のカリキュラムそのものではない。実際はたった三時間の入門セッション [14]だった。問題が最初に解決されてから265年後、バックアップは経費精算システムの社内研修くらいの長さで復活した。組織はこの教訓を「学ぶ」というより、付箋を貼って済ませるものらしい。
チェックリスト――そして二つの正直な訂正
二つ目の生き残りは、誰もが「知っているつもり」になっているものだ。1935年10月30日、ライトフィールドでボーイングModel 299(B-17の試作機)が約300フィートまで上昇したところで失速し、墜落。乗員5人中2人が死亡した。原因はコントロールロックの解除忘れ。当時の記録によれば、エレベーターとラダーの両方を固定する内部ロックだった[16]。(世間では「ガストロック」と呼ばれるが、実際の事故記録にはその語は出てこない。この節は通説の訂正でもある。)
事故調査委員会の結論は、どんなエージェントのダッシュボードにも掲げたい一文だ。委員会は、機体の大きさと操縦系の設計を踏まえ、"it was improbable that any pilot, taking off under the same conditions, would discover the locked controls until it was too late to prevent a crash"(訳:同じ条件下で離陸するどのパイロットも、操縦桿のロックに気づくのは墜落を防ぐには遅すぎる時点だろう、というのはありそうなことではなかった) [16].
つまり、機体自身が自分の状態を誰にも伝えられない「不可視の状態」だった。
この結論のすぐ隣に、同じ資料がこうも付け加えている。"Ordinarily, pilots make checks of their movement as a precaution, but apparently this did not occur"(訳:通常、パイロットは念のため操縦系の動作確認を行うが、今回はそれが行われなかったようだ)――そして同じ資料は自らの言葉で、判定についてこう述べている。 "by implication, a 'pilot error' verdict—but the board did not say that directly"(訳:暗に『パイロットエラー』判定だが、委員会はそれを直接は述べなかった) [16]。つまり、これは「組織が個人を責めるのを高潔に拒んだ」という単純な話ではない。もっと混沌とした、よくある現実だ。報告書には免責と非難の両方が混在し、組織がどう動いたか で、それが本質だった。
実際に組織が取った行動はこうだ。機体が大きすぎて人間には扱えないという意見に直面したとき、空軍は"properly recognized that the limiting factor here was human memory, not the aircraft's size or complexity"(訳:ここでの制約要因は航空機の大きさや複雑さではなく、人間の記憶力であると正しく認識した) [16]。そこで離陸、飛行、着陸前、着陸後のためのチェックリストを作った。
もう一つ訂正しておく。よくある通説はウィッグ史観で、私も危うくそのまま出しかけたが、チェックリストは1935年に生まれたものではない。Merriam-Websterによれば、この言葉自体は1853年に遡る。同じ出典には、この概念についてもこうある。"had already been around for decades, and was in scattered use in aviation worldwide, but it took the Model 299 crash to institutionalize its use"(訳:何十年も前から存在し、世界中の航空界で散発的に使われていたが、Model 299の墜落事故によって制度化された) [16]。1935年がもたらしたのはアイデアではなく、制度化のきっかけだった。
これは心地よい話ではない。この記事で扱ったどの分野も、何かを失ったあとで制度化された。私の場合はスカウトの6週間分の出力を失っただけで済んだ——しかも、たまたまもう一つタブを開いたから気づけただけだ。
最初の原則
四つの窓をまとめると、たった一文になる。
エージェントのホライズンとは、どれだけ長く覚えていられるかではない。どれだけ長く中断されても、再開時に「どこまで進んでいたか」を偽らずに済むか、である。
話は単純だ。コンテキストは消費されるアテンション予算なので、耐久的な状態はその外に置くしかない。状態が外部に出れば、システムの記録はモデルではなく外部記録になる。そしてそれが成立した瞬間、残る壊滅的な失敗は「fine」と記録されているのに、実際には何も起きていない場合だけになる。
だから、ロングホライズン・エンジニアリングの最後の一歩は、地味で目立たない作業になる。沈黙に音を与えることだ。
パターンとアンチパターン
| パターン | アンチパターン |
|---|---|
| 静かな実行でも必ずチェックポイントを書く。空のエントリも立派な記録だ。 | exit 0資格情報がないときに黙って通す。 |
| 検証する役割は、実際に動いたものとは分ける。 | エージェントが自分の軌跡を自分で採点し、その点数を自ら報告する。 |
| 何も出力がない状態は失敗とみなす。ただし、許容できる猶予期間を設ける。 | 出力がないことを単なるヌル扱いし、グリーンで済ませてしまう。 |
| クラッシュを珍しくするより、再起動を簡単にする。 | 「スレッドを見失わないように」モデルを賢くすること。 |
| コンパクトな状態を持ち運ぶかつ 必要になれば再導出できる全トレースも残しておく。 | 要約だけを残し、いざという時にトレースが消えていたと気づく。 |
| 失敗は、すでに人間が目を通す場所に流す。 | ダッシュボードのタブをアラートの経路にする。 |
実際にこのあと90分で自分が変えたこと
具体的に。コピペでも反論でもどうぞ。今や記憶ではなくコードで強制される5つのルール:
- 毎正時を避けてスケジューリングする。 スケジュールジョブは
:00に最も落ちやすく遅れやすい。今は:47,:53と:11. - 資格情報がなければスキップせず失敗にする。
exit 0はエラー注釈となり、exit 1― 新しいジョブではかつ 教訓をくれた古いジョブでも同様。 - 失敗したらイシューを立てる。 誰も見ないタブの赤い四角はアラートではない。
- ジョブ自身が、直近の出力がどれだけ前かを測るようになった そして毎回の実行でその情報を表示する。許容期間は頻度ごとに違い、毎日なら2日、毎週なら10日、毎月なら40日。静かに止まっていたジョブも、再開したときには必ず「止まっていた」と自分で言うようになった。
- 「Could not verify」は絶対にexit 0しない。(訳:「検証できませんでした」は決して正常終了しない) これはたった1文字の修正だが、一般化して全体に適用した。
そして今のレビューは、きちんと失敗できる つくりにした。もし下敷きのゴールグラフがスカスカでレビューできるものがなければ、出力の冒頭にNOT REVIEWABLE と明記する。「報告すべきことがない」と「報告すべき対象がない」はまったく別物で、良いニュースなのは前者だけだ。
ようやく自分の目で見届けた
このセクションの初稿を書いていたとき、ちょうどGitHubが大規模障害の真っ最中だった——APIもActionsもIssuesもPull Requestsも全部落ちていた——ので、スケジュールされたジョブが一度も緑になるところを見ていなかった。だからこの記事自身のルールに従えば「完了」とは言えなかった。
障害が明けて、ジョブを流した。失敗した。しかも4回、しかも2種類のまったく別の理由で——どちらも想定外だった。
最初の失敗はむしろ良い失敗だった。レビュー自体は完璧に動いた。エンドポイントを叩き、レポートを作り、docs/reviews/2026-08-17-weekly.mdを書いてブランチをプッシュ——そして最後のステップでGitHub Actions is not permitted to create or approve pull
requestsで落ちた。デフォルトでオフのリポジトリ設定で、自分は一度も見たことがなかった。
この一連の出来事が、この記事でずっと分解してきたcronにとって何を意味するか、考えてみてほしい。scoutには3つ 足りないものがあった。登録されていないシークレット、exit 0せずに失敗するステップ、誰も有効化していなかったリポジトリ権限。このうちどれか一つでも直していれば、やっぱり何も起きなかった。自分はバグを一つ見つけたことをちょっと誇らしく思っていた。 実際は三つで、三つ目はジョブをちゃんと大きな音で失敗させて初めて気付けた。
次の三回の失敗はGitHub自身の503で、部分的な障害の中、同じ最後のステップで起きた。四回目の試行でようやく緑になった。実行番号は32054945733、最後まで見届けて、PR #303 実際の
レビュー内容:この期間に12件のデリバリー、14日以上動きのなかったリポジトリが3つ、収益速度のトリップワイヤーが作動、ノードウェイト13件が未署名で中立化された。さらに自分自身の
ケイデンスチェックも出力した:これまで週次レビューは存在せず、今回が初回である。
ようやく、これで言える。だが、ここに至るまでに必要だったのは、この記事の「正直な結末」バージョンが 求めたものだ。4回の失敗とリポジトリ設定 ―もし単にコードを書いて緑色を信じていたら、あの自信満々なバージョンよりも多くのものが必要だった。
まだあえて手を付けていないことが一つある。クレデンシャルのうちskill loopが必要とするものはデプロイ先にはあるが、リポジトリにはない。クレデンシャルをローテーションすれば30秒でcronを緑にできたが、やらなかった。なぜなら、ドキュメントによれば別のシステムが旧値でそのエンドポイントをヘッドレスで呼んでおり、見えない呼び出し元が持つクレデンシャルをローテーションすると、まさに今日一日かけて取り除いた静かな破損を新たに生むことになるからだ。だからそのジョブはいま大きな音で、正しく失敗し続けている。人間が値を一つコピーするまで、失敗し続ける。大きな赤は仕事が完了した証だ。静かな緑は違う。
これが2026年8月時点での長期ホライズン・エージェントエンジニアリングの正味の姿だと思う。カーブは急で、現実だ。記録上もっとも優れたシステムは、85分・990万トークンかかるタスクのうち15.2%を完了する。エージェント であり、その論文は人間のベースラインを一切報告していない。だから、これが人間にどれだけ時間がかかるか誰も語るべきではない。そして本当にコストになる失敗は、エージェントが止まることではない。止まったまま成功を報告することだ…42日間、きれいに並んだ緑色の列で。
関連リンク
参考文献
- RUC-NLPIR. Awesome-Long-Horizon-Agents: 長期ホライズンエージェントのロードマップ。 二本柱の分類法(harnesses / optimization)と6つのharness構成要素。2026年7月のサーベイリリースに合わせてリポジトリ再構成。github.com/RUC-NLPIR/Awesome-Long-Horizon-Agents
- Li, Z., Li, Z., Shi, Y., 他 (2026年7月9日). Long-Horizon-Terminal-Bench: Testing the Limits of Agents on Long-Horizon Terminal Tasks with Dense Reward-Based Grading. arXiv:2607.08964。9カテゴリ46タスク、1回あたり約231エピソード・85.3分、1タスクあたり約990万トークン。0.95および1.0報酬閾値でのbest-model pass@1は15.2% / 10.9%、平均は4.3% / 1.7%。arxiv.org/abs/2607.08964
- Albayaydh, W., Zhao, R., & Flechais, I.(2026年7月7日)。Beyond the Leaderboard: A Synthesis of Tool-Use, Planning, and Reasoning Failures in Large Language Model Agents. arXiv:2607.05775。全27論文・19ベンチマーク・6分類の失敗パターンを整理。3つの発見は要約から連続した1文として引用されており、その中には本記事の初稿で省略された中間の節も含まれている。arxiv.org/abs/2607.05775
- METR(2026年1月29日)。Time Horizon 1.1. P50倍増期間は全期間で約195.8日、2023年以降は130.8日、2024年以降は88.6日(いずれもTH1.1基準)。両方の注意書き文は原文通り引用。metr.org/blog/2026-1-29-time-horizon-1-1/ ・従来手法:Measuring AI Ability to Complete Long Tasks
- Anthropic.Effective context engineering for AI agents. コンテキストとプロンプトエンジニアリングの定義、「attention budget(注意予算)」の考え方、コンパクション・構造化ノート・サブエージェントのアーキテクチャ——以上4つの引用はすべて出典と照合済み。anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic(2025年12月9日)。Model Context Protocolの寄贈とAgentic AI Foundation設立について。 AAIFはLinux Foundation傘下で、BlockとOpenAIが共同設立し、Google、Microsoft、AWS、Cloudflare、Bloombergが支援。anthropic.com/news/donating-the-model-context-protocol…
- The New Stack(2026年)。Temporal、Durable Executionプラットフォームのサーバーレスオプションを発表。 Replay 2026発表内容。Durable ExecutionはAIエージェントのワークフローを明確にターゲットとするようになった。thenewstack.io/temporal-replay-2026-news/ ・ベンダー投稿:temporal.io/blog/replay-2026-product-announcements
- Tom's Hardware. Auto-GPTとBabyAGIはAI界の新星だが、今のところ実用には程遠い。(2023年4月22日。)当時の実地検証による評価。本文では引用ではなく記述として紹介されている。AutoGPTのスター数などの定量的な数字はなく、評価もあくまで定性的なものにとどまる。tomshardware.com/news/autonomous-agents-new-big-thing
- DataCamp. AgentGPT:ブラウザ上で動く自律AIエージェントのガイド。 2023年11月に開発が停止し、2024年7月に親会社が方針転換。130件以上の未対応課題を抱えたままメンテナンスモードに移行している。datacamp.com/tutorial/agentgpt
- BSWEN(2026年6月17日)。LangChainのAgentExecutorは非推奨?2026年時点のLangChainエージェントAPIの実態。
AgentExecutor,initialize_agentおよび従来のcreate_react_agentが非推奨となり、create_agentが公式な代替とされ、グラフランタイムへの統合が進んでいる――本文で主張しているのはこの範囲のみ。二つの追加情報が二次的な報道で流通しているが、このページには記載がない:2026年12月のサポート終了日、および従来のコンストラクタがlangchain-classicパッケージに移動したこと。いずれも本文では主張されていない。docs.bswen.com/blog/2026-06-16-is-agentexecutor-deprecated-langchain/ - OneUptime(2026年2月3日)。Elixirにおけるスーパーバイザーの使い方。 スーパービジョンツリーの仕組みや、通常動作とリカバリの分離については 記述のみで引用はなし――「separating the concerns of normal operation from the concerns of error recovery(通常動作とエラー回復の責務を分離する)」という文言が引用として広く流通しているが、実際にその記載がある出典は見つからなかったことも本文で触れている。oneuptime.com/blog/post/2026-02-03-elixir-supervisors/view · WhatsAppの「1サーバーで同時接続200万件、エンジニアは50人未満」という数字とDiscordの事例は、Elixir and OTP for AI Agent Systems
- Temporal. Workflow Execution overview と Event History walkthrough. イベント履歴は、決して失われない耐久ログとして扱われる。再実行時には最初からリプレイし、すでに成功したアクティビティはスキップされる。TemporalはUberのCadenceをルーツに持つ。docs.temporal.io/workflow-execution · docs.temporal.io/encyclopedia/event-history/…
- Royal Museums Greenwich. Longitude found: Nevil Maskelyne and the lunar method. 本文で引用されている「plucky underdog(勇敢な負け犬)」への注意喚起、Maskelyneの擁護、Nautical Almanac表、そして「海洋用時計は依然として希少かつ高価であり、その信頼性が確立され、船乗りたちがそれを信頼するまでには何十年もかかった」という一文の出典。このページは主に「Harrison=アンダードッグ」説の訂正を目的としており、本文でもその旨が明記されている。 rmg.co.uk/stories/time/longitude-found-nevil-maskelyne-lunar-method · Linda Hall Library, Nevil Maskelyne — 本文で使われている2回目の航海試験の数値(H4は「10マイル以内の精度」、lunar distance法は「30マイル以内の精度」)の出典であり、Maskelyneの報告の逐語引用「wrote a negative report, saying that the chronometer had built-in errors which just happened to cancel each other out」(訳:クロノメーターには内在的な誤差があり、それらがたまたま相殺し合っただけだとする否定的な報告を書いた)、および彼が理事としてHarrisonの請求に抵抗し続けたことの出典。lindahall.org/…/nevil-maskelyne/。H4の約1マイルという数値は別の 航海で得られたものであり、本記事では意図的に30マイルの数値と並べていない。
- Slate(2015年10月)。Naval Academy Brings Back Celestial Navigation Training in Case of a Cyberattack on GPS. 2015年夏、10年以上ぶりに再導入。1990年代後半にGPS・電子航法へと授業時間が置き換えられていた。LCDR Ryan Rogersの発言を逐語引用。再導入は3時間の入門セッションだった。slate.com/technology/2015/10/…・参考:Military Times · Sky & Telescope
- Wikipedia. Lunar distance (navigation). このページで扱われているのは2つの日付のみ:英国Nautical Almanacのルナーテーブル「1767年から1906年まで発行」、そして手頃な価格のマリンクロノメーターによる1850年頃の置き換え。本記事の初稿では1907年、1919年、1905年のラジオ時報廃止もこのページに帰していたが、その3つはいずれも記載がなかったため、すべて再出典せず削除した。en.wikipedia.org/wiki/Lunar_distance_(navigation)・学術的な解説(本稿の主張には未使用):Wepster, A (not so) brief history of lunar distances, arXiv:2007.14504
- Boyne, W. J.(2013年8月)。The Checklist. Air Force Magazine。1935年10月30日のModel 299墜落事故、事故調査委員会による「it was improbable that any pilot…(訳:同じ条件下で離陸するどのパイロットも、手遅れになるまで操縦不能に気付くことはまずなかった)」という所見、「the limiting factor here was human memory, not the aircraft's size or complexity(訳:ここでの制約要因は航空機の大きさや複雑さではなく、人間の記憶力であった)」、そしてこの概念が1935年以前から存在し、事故によって制度化されたという訂正——この3点はいずれも記事本文からの逐語引用。airandspaceforces.com/…/0813checklist.pdf・事故記録:National Air and Space Museum
2026年8月17日、4つの時間軸(30日、30カ月、30年、300年)を横断してまとめた調査パケット。全16ソース。この原稿は初回レビューで不合格となった。 独立したレビュアーが新たな視点で全引用を元ページと照合し、本質的な欠陥6件と小さなもの12件を発見修正版のドラフトも二度目のレビューでさらに十六件(うち十件は本質的な欠陥)が指摘された。だから、偽りのグリーンレポートを扱う記事のコロフォンには「すべて検証済み」とは書かず、「どこが間違っていたか」を明記すべきだ。公開前に修正した点:Erlangのスーパービジョンに関する一文はどの引用元にも存在せず、本文では引用符なしで記載し、その旨も明記した。クロノメーターが「高価すぎる、大量生産が難しい」といった表現は、アートワークやレジストリ、プロモキットでは引用符付き、本文ではイタリック体の準引用(「spiritとしては原文通り」)として扱われていたが、実際にはどの出典にもなく、Maskelyneの報告書の実際の記述に差し替えた。「1海里対30海里」の比較は2つの異なる航海試験を混ぜていたが、同一試験の「10対30」に修正。3つの日付(1907、1919、1905)は該当ページに記載がなく、再出典せず削除。EOL日やGitHubスター数も同様の理由で削除。最も強力な300年級の事例――Naval Academyによる2015年の再導入――は、この記事自身の二項対立の誤った側に分類されており、それが本稿の最後に登場するより鋭いルールを生んだ。検証でそのまま残った引用は、Anthropicの4件、1935年事故記録の3件、METRの2つの注意書き、Naval Academyの一文、arXivアブストラクトの全文。30年級の2件は「経年してなお現役」であり「生き残った」とは言い切れない。今回の調査では「死亡→復活」の証拠が見つからなかったからだ。5回中5回のグリーンランと42日間の空白は著者自身の公開リポジトリから、4回の失敗したディスパッチと最後に述べたリポジトリ権限も同様である。このセクションは実際にcronを走らせた後で書き直されており、初稿では「一度もランを見届けていない」と正直に記していたが、もしそうでなければページ上で即座に嘘になっていた。雇用主やクライアントの素材は一切含まれていない。―― Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app