Serie AI-Native · Ingeniería de Agentes
Verde durante seis semanas
Resumen de 1 minuto — con qué te quedas
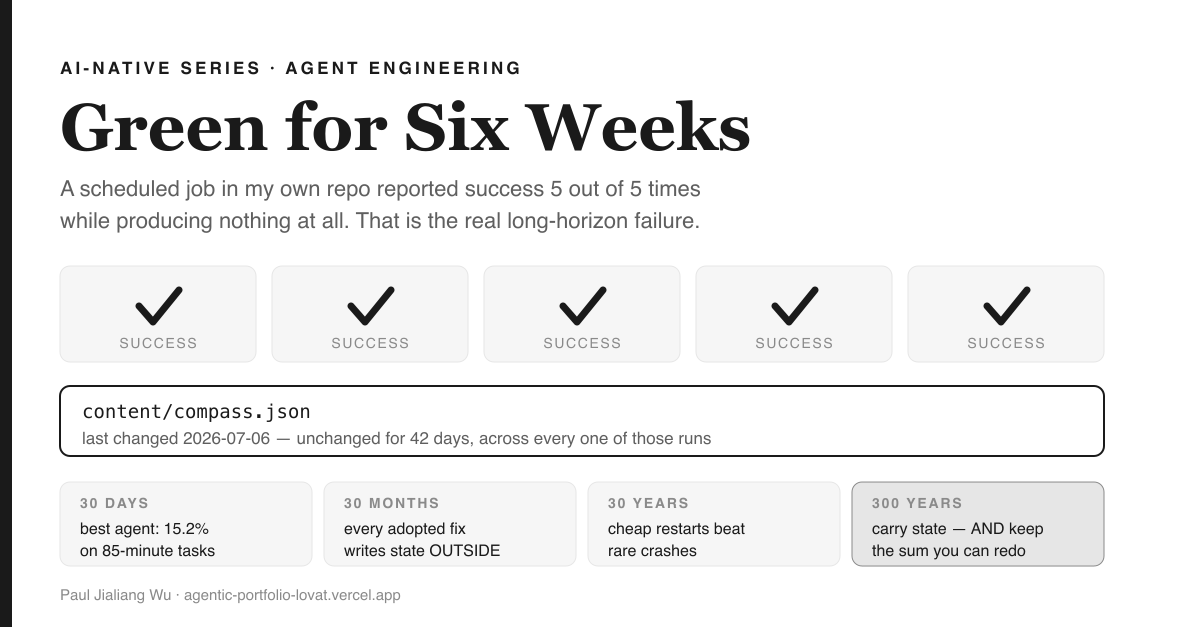
Un agente programado en mi propio portafolio reportó éxito en 5 de 5 ejecuciones mientras que el archivo que existe para escribir permaneció sin cambios durante 42 días. La causa fueron tres cláusulas de shell: una credencial faltante hizo que exit 0. Luego investigué la ingeniería de agentes de largo horizonte a lo largo de cuatro ventanas temporales —30 días, 30 meses, 30 años, 300 años— y cada ventana apuntaba a lo mismo. Nada de lo que realmente se ha adoptado hizo que un modelo recordara más. Todo superviviente mueve el estado hacia afuera del modelo y abarata los reinicios: compactación, notas, checkpoints, árboles de supervisión, registros reproducibles y —hace tres siglos— un reloj que podías llevar contigo mientras conservabas el cálculo que siempre podías rehacer. Lo cual deja exactamente un fallo catastrófico posible: un registro que dice todo bien cuando no pasó nada. El modelo mental es un cuaderno de bitácora, y tiene tres reglas. La tercera es la que todos se saltan.
Un jueves por la mañana abrí la pestaña de Actions de mi propio repositorio para revisar un scout —un pequeño agente programado cuyo único trabajo es mirar mi flota pública de GitHub una vez por semana y anotar qué proyectos profundizar y a quién contactar. Escribe su respuesta en un solo archivo, content/compass.json, que el sitio luego renderiza.
Cinco ejecuciones programadas. Cinco marcas verdes. Una prolija columna de éxito.
Entonces revisé el archivo. Última modificación: 2026-07-06. Eso había sido 42 días antes. Seis semanas, al día.
La causa tiene tres cláusulas de largo, y salió de mi propia mano:
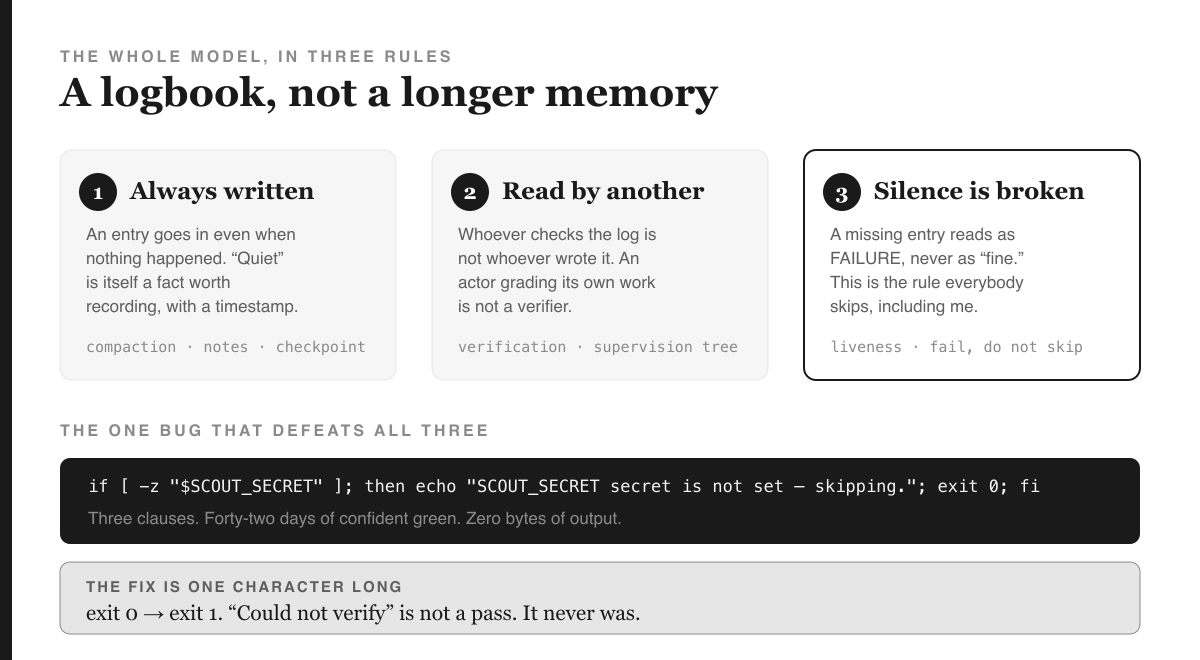
if [ -z "$SCOUT_SECRET" ]; then echo "SCOUT_SECRET secret is not set — skipping."; exit 0; fiLa credencial nunca se había configurado. Así que en cada ejecución programada el job despertaba, descubría que no tenía clave, lo informaba educadamente en un log que nadie lee, y salía con código cero. Salir con código cero significa éxito. GitHub dibujó la marca verde. Yo le creí.
Detente un segundo a pensar en lo que esto implica, porque no es "se rompió mi cron". Un cron roto está bien. Un cron roto llama a un humano. Este despidió a un humano, cinco veces. Es la única categoría de bug que te da las gracias por elegirlo.
Había planeado pasar el día investigando la ingeniería de agentes de largo horizonte —la disciplina de lograr que un agente trabaje de forma útil durante horas o días en vez de minutos. En cambio, pasé la mañana arreglando esto, y luego descubrí que la investigación que tenía planeada era sobre esto. Toda ella. Cuatro ventanas temporales distintas, cuatro literaturas distintas, una sola respuesta.
El modelo: un cuaderno de bitácora, no una memoria más larga
Aquí está la idea completa, y puedes aplicarla sin nada del vocabulario que sigue.
Un barco zarpa para un viaje de muchos meses. Nadie a bordo puede retener el viaje entero en la cabeza —ni los cambios de rumbo, ni el clima, ni las profundidades. Así que no lo intentan. Llevan un cuaderno de bitácora: posición, rumbo, condiciones, anotadas a intervalos, en una forma que un desconocido podría tomar y continuar.
Para que ese cuaderno realmente salve al barco, tres cosas tienen que ser ciertas.
- Se escribe incluso cuando no pasa nada. "Guardia tranquila, sin cambios" es una entrada. Una página en blanco no lo es.
- Alguien que no lo escribió lo lee. El oficial que lleva el registro no es la única persona que alguna vez lo revisa.
- Un vacío en el registro significa que algo anda mal. No "una semana tranquila". Mal.
Eso es todo. Cada técnica de este artículo es una de esas tres reglas disfrazada de solución técnica. Y mi scout falló en la tercera —la que no tiene que ver con escribir nada, y que por eso es la que se salta.
📰 Ventana uno: de qué está discutiendo el campo este mes
La ventana más reciente es la más ruidosa y la menos confiable, así que toma todo en esta sección como lo que tiene la atención de la gente, no como lo que es cierto. Se ordena por interacción, y la interacción no es evidencia.
Lo notable es que en julio de 2026 el campo se dio un nombre y una forma. Una hoja de ruta de agentes de largo horizonte mantenida por un solo laboratorio —RUC-NLPIR, de Renmin University [1]— organiza toda la literatura en torno a dos pilares: un harness externalizado (el andamiaje alrededor del modelo) y una optimización internalizada (entrenar la capacidad dentro del modelo). La mitad del harness tiene exactamente seis órganos: bucles y flujos de trabajo, contexto y memoria, herramientas, orquestación, hooks y middleware, y verificación.
Lee esa lista pensando en el cuaderno de bitácora. Context and memory es la regla uno. Verification es la regla dos. Hooks and middleware es donde viviría la regla tres, si alguien la construyera.
Mientras tanto, las mediciones más recientes son duras. Un benchmark publicado el 9 de julio de 2026 construyó 46 tareas de terminal genuinamente largas repartidas en nueve categorías, cada una dividida en subtareas graduadas para que el progreso parcial sea visible en vez de aplanarse en un simple aprobado/reprobado [2]. Una corrida dura en promedio unos 231 episodios y 85.3 minutos, y consume cerca de 9.9 millones de tokens por tarea. El mejor modelo obtuvo 15.2% en el umbral de crédito parcial y 10.9% en crédito completo. El promedio entre todos los modelos evaluados: 4.3% y 1.7%.
Y una síntesis de 27 papers repartidos en 19 benchmarks, enviada el 7 de julio de 2026, nombra seis familias de fallos de agentes y luego entrega tres hallazgos en una sola oración [3]. Los tres importan, así que aquí está completa, textual: los autores encuentran "that failures compound nonlinearly with task length, that strong performance on individual sub-tasks does not reliably translate into end-to-end success, and that additional scaffolding does not consistently improve reliability." (Traducción: que los fallos se acumulan de forma no lineal con la duración de la tarea, que un buen desempeño en subtareas individuales no se traduce de manera confiable en éxito de extremo a extremo, y que más andamiaje no mejora la fiabilidad de forma consistente.)
La cláusula del medio es la que un benchmark de crédito parcial vuelve vívida, y la última es la que sale cara.
Más órganos no es más cuaderno de bitácora. Puedes atornillarle seis componentes de harness a un agente y aun así haber construido a mi scout.
🌗 Ventana dos: lo que realmente pasó de la demo a lo estándar
Treinta meses es el horizonte de adopción: lo suficientemente largo como para que una demo haya despegado o no, lo suficientemente corto como para que el veredicto siga vigente. Aquí se ordena por evidencia de uso en producción, no por ruido de lanzamiento.
Empecemos por el número que todos citan. METR mide cuánto dura una tarea que un agente de IA puede completar de forma autónoma, y la tendencia es genuinamente exponencial. METR la describe con "a doubling time of around 7 months" (Traducción: un tiempo de duplicación de alrededor de 7 meses) entre 2019 y 2025 —su cifra P50 ajustada es de 195.8 días, así que digamos seis y medio— y, con su metodología actualizada, es cada 130.8 días desde 2023 y cada 88.6 días desde 2024 [4]. Menos de tres meses por cada duplicación.
Ahora la parte que casi nunca se cita junto con el gráfico. En palabras del propio METR, "These confidence intervals are still very wide, and we are actively working on adding more long tasks…" (Traducción: estos intervalos de confianza siguen siendo muy amplios, y estamos trabajando activamente para añadir más tareas largas…) y los tiempos de referencia humana "measured for only 5 of our 31 long (8h+) tasks. The remainder use estimated times" (Traducción: se midieron solo para 5 de nuestras 31 tareas largas (8h+). El resto usa tiempos estimados) [4]. La curva es real. El extremo lejano de esa curva se está trazando a partir de apenas cinco puntos de datos cronometrados. Vale la pena saberlo antes de planear un negocio sobre la extrapolación.
Entonces, ¿qué terminó adoptándose de verdad? Tres técnicas, documentadas como práctica de producción por el laboratorio cuyo agente de código estoy usando para escribir esto [5]. Vale la pena citar su planteamiento tal cual, porque replantea el recurso: "LLMs have an 'attention budget' that they draw on when parsing large volumes of context. Every new token introduced depletes this budget by some amount…" (Traducción: los LLM tienen un 'presupuesto de atención' del que echan mano al procesar grandes volúmenes de contexto. Cada nuevo token introducido agota este presupuesto en cierta medida…) El contexto no es almacenamiento. Es un presupuesto que se gasta.
Dado esto, los tres movimientos adoptados son, todos, formas de anotar las cosas en otra parte:
- Compactación — "the practice of taking a conversation nearing the context window limit, summarizing its contents, and reinitiating a new context window with the summary" (Traducción: la práctica de tomar una conversación que se acerca al límite de la ventana de contexto, resumir su contenido, y reiniciar una nueva ventana de contexto con el resumen) [5]. Una entrada de bitácora, y luego una página nueva.
- Toma de notas estructurada — "a technique where the agent regularly writes notes persisted to memory outside of the context window" (Traducción: una técnica en la que el agente escribe regularmente notas que se conservan en la memoria fuera de la ventana de contexto) [5]. La bitácora misma.
- Subagentes — "Rather than one agent attempting to maintain state across an entire project, specialized sub-agents can handle focused tasks with clean context windows" (Traducción: en lugar de que un solo agente intente mantener el estado a lo largo de todo un proyecto, subagentes especializados pueden encargarse de tareas puntuales con ventanas de contexto limpias) [5]. Una guardia rotativa.
Junto con esto, la fontanería se estandarizó. El Model Context Protocol se lanzó en noviembre de 2024 y, el 9 de diciembre de 2025, Anthropic lo donó a la Agentic AI Foundation de la Linux Foundation, cofundada con Block y OpenAI y respaldada por Google, Microsoft, AWS, Cloudflare y Bloomberg [6]. Que laboratorios competidores entreguen una interfaz compartida a una fundación neutral en apenas trece meses no es un lanzamiento; es un estándar. Y en esa misma ventana, la infraestructura de ejecución duradera —la maquinaria para procesos que sobreviven a fallos— se orientó explícitamente hacia los agentes: la conferencia 2026 de Temporal presentó workers serverless dirigidos exactamente a estos flujos de trabajo [7].
Aquí está el patrón, y quiero ser directo al respecto porque es la columna vertebral del artículo. Ninguna de las técnicas adoptadas hizo que el modelo recordara más. Todas y cada una mueven el estado fuera del modelo, hacia algo duradero, inspeccionable y reanudable.
El cementerio de la misma ventana
Un ranking de adopción sin las demos estancadas es un comunicado de prensa, así que: los proyectos de agentes más sonados de esta era son los que no lo lograron. AutoGPT y BabyAGI se dispararon a comienzos de 2023, y el veredicto práctico de la época fue que un revisor couldn't find a single practical use case where they do a good job (Traducción: no pudo encontrar un solo caso de uso práctico en el que hicieran un buen trabajo) [8]. El desarrollo de AgentGPT se detuvo en noviembre de 2023; su empresa matriz se retiró del proyecto en julio de 2024, dejando la plataforma en modo mantenimiento con más de 130 problemas sin resolver [9].
Y el cadáver más instructivo es una pieza de diseño de API. El AgentExecutor de LangChain — la abstracción canónica de "simplemente hacer un bucle con el modelo hasta que termine" — está obsoleto, junto con initialize_agent y el más antiguo create_react_agent; el reemplazo sancionado es un único create_agent [10]. La razón declarada es que el bucle no podía manejar ramificaciones, intervención humana en el proceso ni ejecución duradera, y un runtime de grafos sí.
El bucle perdió frente al grafo. Un bucle es un proceso con su estado adentro. Un grafo es un proceso con su estado escrito en algún lugar donde puedes pausarlo, inspeccionarlo y reanudarlo. La regla uno, otra vez, decidió una guerra de frameworks.
🕰 Ventana tres: lo que ha sobrevivido treinta años
Ahora clasifiquemos por supervivencia en lugar de por adopción, y la lista se vuelve corta y poco glamorosa. Seré honesto sobre la categorización: ambos elementos de abajo están envejeciendo bien en lugar de ser sobrevivientes comprobados, porque no pude encontrar la evidencia completa de necrológica y resurrección para ninguno de los dos dentro de esta ronda de investigación.
Árboles de supervisión, y "dejar que falle". La respuesta de Erlang/OTP a los sistemas de larga duración no fue escribir código que no falle. Fue organizar los procesos en un árbol donde el único trabajo de un supervisor es notar que un proceso hijo ha muerto y reiniciarlo. Sigue siendo estructural: WhatsApp corría, famosamente, del orden de dos millones de conexiones simultáneas por servidor con menos de cincuenta ingenieros, y Discord ejecuta su infraestructura en tiempo real sobre el mismo linaje [11]. Y la filosofía se malinterpreta con frecuencia, así que aquí va la corrección que importa: no significa ser descuidado. Los propios principios de diseño de Erlang/OTP colocan la lógica de recuperación en un proceso separado del trabajo mismo — el supervisor existe precisamente para que el código que hace el trabajo nunca tenga que cargar también con el código para sobrevivir a su propio fallo [11]. La operación normal y la recuperación de errores son programas distintos, escritos por partes distintas del árbol. (He visto esa idea presentada como cita textual en una docena de posts de blog, incluyendo mi propio primer borrador de este párrafo. No pude encontrarla en ninguna fuente que realmente la diga, así que aquí aparece sin comillas.)
Repetición desde un registro duradero. La ejecución duradera — Temporal, construida por los ingenieros que crearon Cadence en Uber — mantiene el historial de cada flujo de trabajo como un registro de eventos duradero que vive fuera del proceso y nunca se pierde. Al reiniciar, el worker repite el código del flujo de trabajo desde el principio, pero solo ejecuta lo que aún no ha ocurrido; las actividades que ya tuvieron éxito se omiten [7], [12]. La idea es más antigua que el producto — es el write-ahead log con un sombrero nuevo — y estoy describiendo ese linaje en lugar de reclamar una cita para ello.
Pon ambas cosas una junto a la otra y el mecanismo queda a la vista:
Neither one tries to stop the long run from failing. Ambas hacen que el fallo sea barato de retomar. Treinta años de ingeniería de confiabilidad no compraron menos caídas. Compraron reinicios más baratos.
Por eso «hacer que el modelo sea más inteligente para que no pierda el hilo» es una estrategia sin ningún precedente detrás, y «hacer checkpoint con la frecuencia suficiente para que perder el hilo cueste noventa segundos» es una estrategia con tres décadas.
🏺 Ventana cuatro: qué ha sobrevivido trescientos años
A esta distancia, una sola carrera profesional de relevancia es ruido. Algo tiene que haber cruzado generaciones y sobrevivido a un cambio de sustrato que podría haberlo matado. Dos cosas lo lograron, en el mismo dominio que el nuestro: saber dónde estás, en un trabajo demasiado largo para recordarlo.
El reloj que llevas contigo, y la cuenta que vuelves a rehacer
El problema de la longitud era, exactamente, el problema del horizonte largo. La latitud es fácil: se lee en el sol. La longitud exige saber qué hora es en otro lugar, y durante casi toda la historia nada en el mar podía decírtelo. Dos soluciones compitieron durante el siglo XVIII, y son las dos estrategias que siguen sobre la mesa hoy.
Llevar el estado hacia adelante: los cronómetros marinos de John Harrison mantenían corriendo una hora de referencia, de modo que fijar la posición era simplemente hacer una lectura. Volver a derivarlo cada vez: el método de la distancia lunar medía el ángulo entre la luna y una estrella y calculaba hacia atrás hasta una hora de referencia: observaciones frescas, tablas de almanaque y una larga cadena de trigonometría esférica, desde cero, en cada fijación.
Antes de los números, una advertencia que tengo que transmitir, porque la fuente en la que más me apoyé existe en buena medida para plantearla. Royal Museums Greenwich abren su relato de esta rivalidad diciendo que "The brilliant John Harrison has long been portrayed as the plucky underdog…" (Traducción: El brillante John Harrison ha sido presentado durante mucho tiempo como el desvalido con agallas…) y que esto "has however tarnished the reputation of another brilliant man: Nevil Maskelyne" (Traducción: sin embargo ha empañado la reputación de otro hombre brillante: Nevil Maskelyne) [13]. La versión del desvalido con agallas es la que yo crecí escuchando y la que empecé a redactar. No es la versión que cuentan los historiadores.
Así que, con cuidado. En la segunda prueba en el mar —aquella en la que ambos métodos se midieron uno contra el otro—, el H4 de Harrison resultó preciso a unas diez millas y el método de la distancia lunar dentro de un margen de unas treinta [13]. La fuente dice "miles" (millas) y no especifica si son estatutarias o náuticas, así que yo tampoco lo hago. (El famoso resultado de H4 de aproximadamente una milla es real, pero proviene de un viaje distinto, y comparar ambos sería mezclar dos experimentos en un solo contraste.) Maskelyne, el Astrónomo Real, publicó las tablas del Nautical Almanac que hicieron prácticos los métodos lunares para los marinos comunes, y como miembro de la Junta "continued to resist Harrison's claim for the award" (Traducción: siguió resistiéndose a reconocer el premio a Harrison) [13] — y también evaluó el reloj de Harrison y, tal como lo registra Linda Hall Library, "wrote a negative report, saying that the chronometer had built-in errors which just happened to cancel each other out" (Traducción: escribió un informe negativo, diciendo que el cronómetro tenía errores incorporados que simplemente resultaron cancelarse entre sí) [13]. No fue un "es pura casualidad" dicho con esas palabras. Algo más específico y más condenatorio: tu instrumento acierta por accidente.
Los métodos lunares fueron genuinamente buenos y genuinamente estándar durante gran parte del siglo diecinueve. Los cronómetros se volvieron asequibles alrededor de 1850, y Gran Bretaña publicó tablas lunares en el Nautical Almanac desde 1767 hasta 1906 [15].
Ahora la parte con la que quiero ser honesto, porque la versión triunfalista de esta historia es presentismo y yo la había escrito así. La objeción al cronómetro era que resultaba caro y difícil de fabricar en cantidad — y esa objeción fue correcta durante buena parte de un siglo. RMG lo dice con claridad: los cronómetros marinos "remained rare and expensive; it took decades to establish their reliability and for seafarers to trust them" (Traducción: siguieron siendo raros y costosos; tomó décadas establecer su fiabilidad y que los marinos confiaran en ellos) [13]. El ensayo de Harrison fue en 1761; la asequibilidad llegó alrededor de 1850 — digamos noventa años, y noto que "alrededor" es palabra de la fuente, no una medición. Una objeción de costo puede tener razón durante tres generaciones y aun así perder al final. Esa es una lección más útil que "el visionario fue reivindicado", y es la que en realidad aplicaría a la sobrecarga de los checkpoints en un sistema de agentes: la objeción puede ser correcta ahora y aun así ser el criterio equivocado sobre el cual diseñar.
Y entonces el perdedor regresó — como respaldo
Aquí está el giro que estuve a punto de archivar en el lado equivocado de mi propio argumento.
La Academia Naval de Estados Unidos sacó la navegación celestial del plan de estudios a finales de los años noventa, reemplazando ese tiempo de curso con GPS y navegación electrónica, y luego la trajo de vuelta en el verano de 2015 porque el GPS se puede interferir (jamming). El subdirector del departamento de náutica y navegación resumió la razón en una línea: las computadoras son excelentes, pero "The problem is there's no backup" (Traducción: el problema es que no hay respaldo) [14].
Pero fíjate en qué fue lo que volvió. Observaciones con sextante, almanaque, reducción de la observación — eso es el método de re-derivación . El bando perdedor de la contienda del siglo dieciocho es lo que una armada moderna reinstauró como su respaldo. No porque re-derivar sea más barato; claramente no lo es. Porque re-derivar no depende de nada más que del cielo, mientras que el estado llevado hacia adelante depende de un satélite que otro opera.
Lo cual arroja una regla más precisa que "lleva el estado hacia adelante en vez de re-derivarlo":
Lleva hacia adelante el estado compacto porque sale barato. Conserva la capacidad de re-derivarlo desde cero porque es lo único que funciona cuando el camino barato no está disponible.
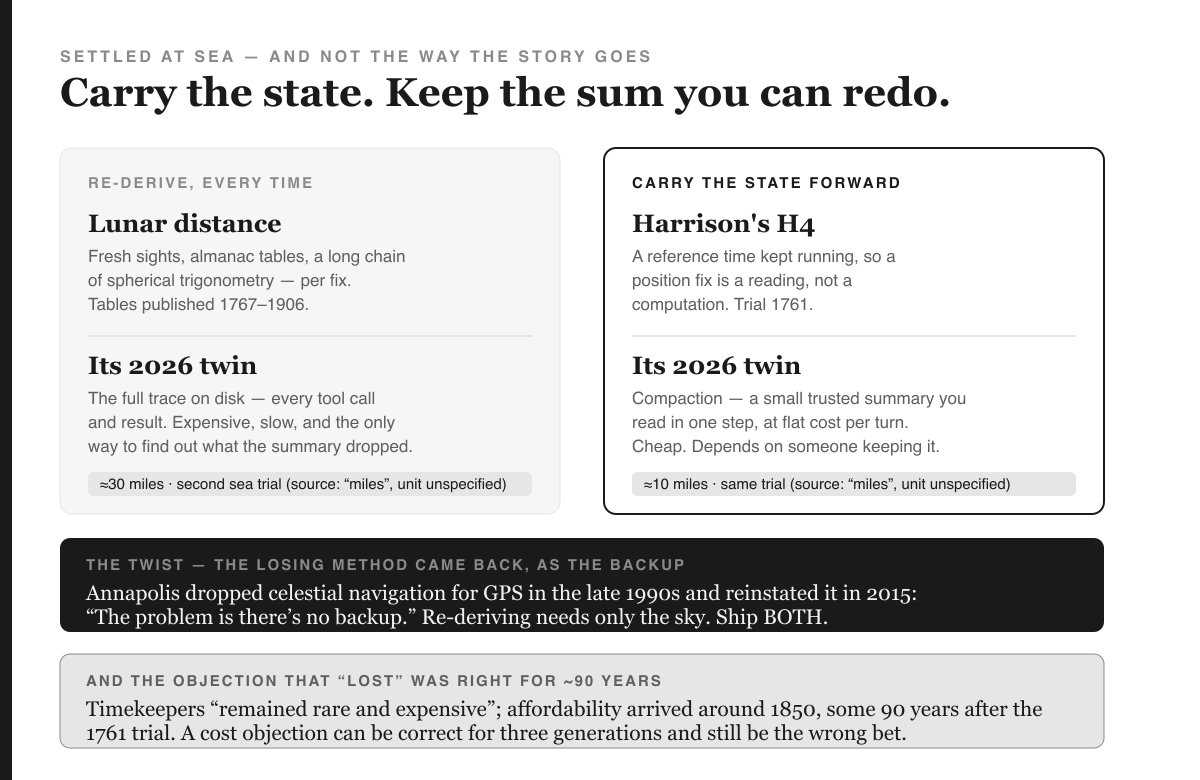
Para un agente eso no es una metáfora: es una arquitectura. La compactación es el cronómetro: un pequeño resumen confiable que lees en un solo paso. La traza completa —cada llamada a herramienta y su resultado, en disco— es el sextante: costosa, lenta, y la única forma de averiguar dónde estás en realidad cuando resulta que el resumen dejó fuera lo que importaba. Usa los dos a la vez. La mayoría de los stacks de agentes que reviso solo usan el primero, y después descubren durante un incidente que el historial compactado es todo lo que conservaron.
Y no necesito el siglo XVIII para justificar eso, porque un sistema en producción que ya aparece en este artículo lo hace. La ejecución durable conserva el registro de eventos completo y lo reproduce desde ahí: el registro es el sextante, la reproducción es la reducción de la observación, y las actividades que ya tuvieron éxito y que se saltan son el estado llevado hacia adelante [7], [12]. Temporal usa los dos a la vez. Y el mar tampoco eligió realmente uno solo: la misma página que fecha la victoria del cronómetro también señala que "a mariner with a chronometer could check its accuracy using a lunar determination of Greenwich time" (Traducción: un marino con un cronómetro podía comprobar su precisión mediante una determinación lunar de la hora de Greenwich) [15]. Lleva el reloj, conserva el sextante, usa cada uno para auditar al otro. Una marina volvió a aprender la segunda mitad en 2015. La única parte que todavía elige uno solo es el stack de agentes.
Debería ser preciso sobre qué fue lo que volvió, eso sí, porque la versión honesta es más graciosa y más útil que la triunfalista. Lo que volvió no fue el curso original. Fue una sesión introductoria de tres horas [14]. Doscientos sesenta y cinco años después de que el problema quedara resuelto por primera vez, el respaldo se reinstauró con una duración equivalente, más o menos, a la de un módulo corporativo de inducción sobre el sistema de gastos. Las instituciones no aprenden tanto esta lección como dejan una nota adhesiva al respecto.
La lista de verificación — y dos correcciones de honestidad
El segundo sobreviviente es el que todo el mundo cree conocer. El 30 de octubre de 1935 en Wright Field, el Model 299 de Boeing —el prototipo del B-17— subió a unos 300 pies, entró en pérdida y se estrelló, matando a dos de los cinco tripulantes. La causa fue un seguro de mandos que había quedado activado: tal como lo describe el relato de la época, un seguro interno que inmovilizaba tanto el elevador como el timón de dirección [16]. (La versión popular lo llama "gust lock" (seguro de ráfagas). El relato del accidente que realmente pude verificar como fuente no usa esa expresión, y esta es justamente una sección dedicada a corregir versiones populares.)
El hallazgo de la junta investigadora del accidente es la frase que yo pondría por encima de cualquier panel de control de un agente. Concluyó que, dado el tamaño de la aeronave y el diseño de su sistema de mandos, "it was improbable that any pilot, taking off under the same conditions, would discover the locked controls until it was too late to prevent a crash" (Traducción: era improbable que ningún piloto, despegando en las mismas condiciones, descubriera los mandos bloqueados antes de que fuera demasiado tarde para evitar un accidente) [16].
Un estado inobservable. El avión no tenía forma de decirle a nadie qué le ocurría.
Y tengo que poner ese hallazgo junto a la frase que lo acompaña, porque la misma fuente agrega que "Ordinarily, pilots make checks of their movement as a precaution, but apparently this did not occur" (Traducción: normalmente los pilotos verifican el movimiento de los mandos como precaución, pero, al parecer, esto no ocurrió) —y agrega, con voz propia, que el veredicto es "by implication, a 'pilot error' verdict—but the board did not say that directly" (Traducción: por implicación, un veredicto de "error del piloto" —pero la junta no lo dijo directamente) [16]. Así que esta no es la historia limpia en la que una institución se niega noblemente a culpar a una persona. Es la más desordenada y más familiar: el informe contiene tanto la exoneración como el reproche, y lo que la organización hizo lo que importaba fue lo que la organización hizo con eso.
Esto fue lo que hicieron. Ante los argumentos de que el avión era simplemente demasiado grande para manejarlo, el Air Corps "properly recognized that the limiting factor here was human memory, not the aircraft's size or complexity" (Traducción: reconoció correctamente que el factor limitante aquí era la memoria humana, no el tamaño ni la complejidad del avión) [16]. Luego escribieron listas de verificación para el despegue, el vuelo, antes de aterrizar y después de aterrizar.
Segunda corrección, porque la versión popular de esto es historia whig y estuve a punto de publicarla: la lista de verificación no se inventó en 1935. La palabra en sí data de 1853 según Merriam-Webster, y la misma fuente es explícita en que el concepto "had already been around for decades, and was in scattered use in aviation worldwide, but it took the Model 299 crash to institutionalize its use" (Traducción: ya existía desde hacía décadas y se usaba de forma dispersa en la aviación de todo el mundo, pero hizo falta el accidente del Model 299 para institucionalizar su uso) [16]. 1935 no aportó la idea. Aportó el funeral.
Vale la pena sentirse incómodo con esto. Cada disciplina de este artículo se institucionalizó después de que se perdiera algo. Mi propia versión no me costó más que seis semanas de producción de un scout — y solo lo descubrí porque se me ocurrió abrir una segunda pestaña.
El primer principio
Las cuatro ventanas colapsan en una sola frase.
El horizonte de un agente no es cuánto tiempo puede recordar. Es cuánto tiempo puede ser interrumpido y reanudado sin mentir sobre dónde estaba.
La cadena es corta. El contexto es un presupuesto de atención que se agota, así que el estado duradero tiene que vivir fuera de él. Una vez que el estado vive afuera, el registro externo — no el modelo — se convierte en el sistema de registro. Y una vez que el registro es el sistema de registro, el único fallo catastrófico que queda es un registro que reporta todo bien cuando en realidad no pasó nada.
Lo cual convierte la última milla de la ingeniería de agentes de largo horizonte en algo extraño y poco glamoroso: hacer que el silencio suene fuerte.
Patrones y antipatrones
| Patrón | Antipatrón |
|---|---|
| Escribir el checkpoint incluso en una corrida silenciosa — una entrada vacía sigue siendo una entrada. | exit 0 cuando falta una credencial. |
| Lo que verifica no es lo mismo que lo que actuó. | Un agente que califica su propia trayectoria y reporta la calificación. |
| La ausencia es un estado de fallo, con una tolerancia asignada. | La ausencia como un nulo, renderizada como verde. |
| Que reiniciar salga barato, en vez de que los fallos sean raros. | Hacer que el modelo sea más inteligente para que "no pierda el hilo". |
| Lleva el estado compacto hacia adelante y conserva el registro completo del que puedas volver a derivarlo. | Quedarte solo con el resumen — y luego descubrir, en medio de un incidente, que el registro completo ya no existe. |
| El fallo se enruta hacia donde un humano ya está mirando. | Una pestaña de dashboard como canal de alerta. |
Lo que realmente cambié, en los noventa minutos siguientes
En concreto, para que lo copies o lo discutas. Cinco reglas, ahora aplicadas en código y no solo recordadas:
- Programar fuera de la hora en punto. Los trabajos programados se caen y se retrasan con más fuerza justo cuando marca la hora
:00. Los míos ahora corren a las:47,:53y:11. - Una credencial faltante falla, no se salta.
exit 0se convirtió en una anotación de error yexit 1— en el trabajo nuevo y en el antiguo que me enseñó la lección. - Un fallo abre un issue. Un cuadrado rojo en una pestaña que nadie abre no es una alerta.
- El job mide la antigüedad de su propia última salida y lo informa en cada ejecución, con una tolerancia por cadencia: 2 días para diaria, 10 para semanal, 40 para mensual. Un job que se detuvo en silencio ahora lo dice en voz alta en la ejecución que retoma.
- "Could not verify" never exits zero. (Traducción: "No se pudo verificar" nunca sale con código cero.) Este es el arreglo de un carácter, generalizado.
Y la revisión que ahora ejecuta está construida para que sí pueda fallar: si el grafo de objetivos subyacente está demasiado vacío como para revisar algo contra él, la salida encabeza con NOT REVIEWABLE en lugar de un certificado de salud impecable, porque "nada que reportar" y "nada contra qué reportarlo" son hechos distintos, y solo uno de ellos es una buena noticia.
La parte en la que por fin pude verlo
Cuando redacté por primera vez esta sección, GitHub estaba en medio de una interrupción mayor —API, Actions, Issues y Pull Requests, caídos todos a la vez— y escribí que no había visto una sola ejecución programada llegar a verde, y que, según la propia regla de este artículo, no me correspondía darlo por terminado.
Luego se resolvió, y ejecuté el job. Falló. Cuatro veces, por dos razones completamente distintas, ninguna de las cuales había previsto.
El primer fallo fue el mejor de todos. La revisión en sí funcionó perfectamente: llamó al endpoint,
armó el reporte, escribió docs/reviews/2026-08-17-weekly.md, subió la rama —y entonces
murió en el último paso con GitHub Actions is not permitted to create or approve pull
requests. Una configuración del repositorio, desactivada por defecto, que nunca había revisado.
Piensa por un momento qué significa eso para el cron que llevo todo este artículo diseccionando. El scout necesitaba tres cosas que no tenía: un secreto que nunca se había registrado, un paso que fallaba en lugar de salir con código cero, y un permiso del repositorio que nadie había activado. Arregla cualquiera de los tres y aun así no hace nada. Yo me había sentido orgulloso de encontrar un solo bug. La cuenta real era tres, y solo encontré el tercero al hacer que el job fallara lo bastante alto como para avisarme.
Los siguientes tres fallos fueron errores 503 del propio GitHub, intermitentes durante una interrupción parcial, en el mismo
paso final. El cuarto intento dio verde. Ejecución 32054945733, observada hasta el final, que abrió
PR #303 que contiene una revisión
real — doce entregas en la ventana, tres repos enfriados por más de catorce días, un disparador
activado por velocidad de ingresos, y trece pesos de nodo sin firmar y neutralizados. También imprimió su propia
verificación de cadencia: no prior weekly review — this is the first. (Traducción: sin revisión semanal previa — esta es la primera.)
Así que ahora puedo decirlo. Y fíjate qué hizo falta: la versión honesta del final de este artículo requirió cuatro fallos y un ajuste de permisos del repositorio más que la versión confiada que habría publicado si simplemente hubiera escrito el código y confiado en el verde.
Hay una cosa que deliberadamente todavía no he hecho. Una de las credenciales —la que necesita el bucle de habilidades— existe en el despliegue pero no en el repositorio, y podría haber puesto ese cron en verde en treinta segundos con solo rotarla. No lo hice, porque la documentación muestra que otro sistema llama a ese endpoint sin supervisión usando el valor antiguo, y rotar una credencial que sostiene un llamador invisible habría fabricado exactamente el tipo de rotura silenciosa que todo este día se dedicó a eliminar. Así que ese trabajo ahora falla de forma ruidosa y correcta, y sigue fallando hasta que un humano copie un valor manualmente. Un rojo ruidoso es un trabajo terminado. Un verde silencioso no lo es.
Este es, creo, el estado honesto de la ingeniería de agentes de largo horizonte en agosto de 2026. La curva es pronunciada y real. El mejor sistema registrado termina el 15.2% de las tareas que le toman a un agente unos 85 minutos y 9.9 millones de tokens — y ese paper no reporta ninguna línea base humana, así que nadie debería decirte cuánto tardan estas tareas para una persona. Y el fallo que realmente te va a costar caro no es que el agente se detenga. Es que el agente reporte éxito mientras está detenido — durante cuarenta y dos días, en una prolija columna de verde.
Relacionados
Referencias
- RUC-NLPIR. Awesome-Long-Horizon-Agents: the roadmap of long-horizon agents. Taxonomía de dos pilares (harnesses / optimization) y los seis componentes del harness; repositorio reestructurado para el lanzamiento del estudio de julio de 2026. github.com/RUC-NLPIR/Awesome-Long-Horizon-Agents
- Li, Z., Li, Z., Shi, Y., et al. (9 de julio de 2026). Long-Horizon-Terminal-Bench: Testing the Limits of Agents on Long-Horizon Terminal Tasks with Dense Reward-Based Grading. arXiv:2607.08964. 46 tareas en nueve categorías; ≈231 episodios y 85.3 minutos por corrida; ≈9.9M tokens por tarea; 15.2% / 10.9% de pass@1 del mejor modelo en los umbrales de recompensa 0.95 y 1.0, 4.3% / 1.7% de media. arxiv.org/abs/2607.08964
- Albayaydh, W., Zhao, R., & Flechais, I. (7 de julio de 2026). Beyond the Leaderboard: A Synthesis of Tool-Use, Planning, and Reasoning Failures in Large Language Model Agents. arXiv:2607.05775. 27 artículos, 19 benchmarks, seis categorías de fallos. Los tres hallazgos se citan como una sola oración textual continua tomada del resumen, incluida la cláusula intermedia que un borrador anterior de este artículo omitió. arxiv.org/abs/2607.05775
- METR (29 de enero de 2026). Time Horizon 1.1. Duplicación de la P50 ≈195,8 días en todo el periodo; 130,8 días desde 2023 y 88,6 días desde 2024 bajo TH1.1; ambas advertencias citadas textualmente. metr.org/blog/2026-1-29-time-horizon-1-1/ · metodología anterior: Measuring AI Ability to Complete Long Tasks
- Anthropic. Effective context engineering for AI agents. Definiciones de ingeniería de contexto frente a ingeniería de prompts; el planteamiento del "attention budget"; compactación, toma de notas estructurada y arquitecturas de sub-agentes — las cuatro citas verificadas textualmente contra la fuente. anthropic.com/engineering/effective-context-engineering-for-ai-agents
- Anthropic (9 de diciembre de 2025). Donating the Model Context Protocol and establishing the Agentic AI Foundation. AAIF bajo la Linux Foundation; cofundada con Block y OpenAI, respaldada por Google, Microsoft, AWS, Cloudflare y Bloomberg. anthropic.com/news/donating-the-model-context-protocol…
- The New Stack (2026). Temporal reveals a serverless option for its Durable Execution platform. Anuncios de Replay 2026; ejecución duradera orientada explícitamente a flujos de trabajo de agentes de IA. thenewstack.io/temporal-replay-2026-news/ · publicación del proveedor: temporal.io/blog/replay-2026-product-announcements
- Tom's Hardware. Auto-GPT and BabyAGI Are AI's New Hotness, But They Suck Right Now. (22 de abril de 2023.) Evaluación práctica contemporánea; descrita en lugar de citada textualmente. No incluye conteo de estrellas — la caracterización que hace el cuerpo del texto sobre el protagonismo de AutoGPT es, por lo tanto, cualitativa, sin cifra alguna. tomshardware.com/news/autonomous-agents-new-big-thing
- DataCamp. AgentGPT: A Guide to Browser-Based Autonomous AI Agents. Desarrollo detenido en noviembre de 2023; la empresa matriz cambió de rumbo en julio de 2024; queda en modo mantenimiento con más de 130 issues sin resolver. datacamp.com/tutorial/agentgpt
- BSWEN (17 de junio de 2026). Is AgentExecutor Deprecated in LangChain? The Real State of LangChain Agent APIs in 2026.
AgentExecutor,initialize_agenty el más antiguocreate_react_agentquedan obsoletos, concreate_agentcomo el reemplazo avalado y la consolidación en un runtime de grafos — que es todo lo que el cuerpo del texto afirma a partir de esta fuente. Otros dos detalles circulan en cobertura secundaria y no aparecen en esta página: una fecha de fin de vida útil en diciembre de 2026, y el traslado de los constructores clásicos a un paquetelangchain-classic. Ninguno de los dos se afirma aquí. docs.bswen.com/blog/2026-06-16-is-agentexecutor-deprecated-langchain/ - OneUptime (3 de febrero de 2026). How to Use Supervisors in Elixir. Mecánica de los árboles de supervisión; la separación entre el trabajo y la recuperación se describe, no se cita — la frase "separating the concerns of normal operation from the concerns of error recovery" (Traducción: separar las preocupaciones de la operación normal de las preocupaciones de la recuperación de errores) circula ampliamente como si fuera una cita, y no pude encontrar ninguna fuente que realmente la contenga, lo cual se indica así en el propio cuerpo del texto. oneuptime.com/blog/post/2026-02-03-elixir-supervisors/view · la cifra de WhatsApp ("2 million simultaneous connections per server with a team of fewer than 50 engineers" [Traducción: 2 millones de conexiones simultáneas por servidor con un equipo de menos de 50 ingenieros]) y el ejemplo de Discord aparecen en Elixir and OTP for AI Agent Systems
- Temporal. Workflow Execution overview y Event History walkthrough. El historial de eventos como registro (log) duradero que nunca se pierde; repetición desde el inicio saltando las actividades que ya se completaron con éxito; el linaje de Temporal desde Cadence en Uber. docs.temporal.io/workflow-execution · docs.temporal.io/encyclopedia/event-history/…
- Royal Museums Greenwich. Longitude found: Nevil Maskelyne and the lunar method. Fuente de la advertencia sobre el "plucky underdog" citada textualmente en el cuerpo del artículo (Traducción: el desvalido con suerte), de la defensa que hizo Maskelyne y de las tablas del Nautical Almanac, y de la frase que dice que los cronómetros marinos "remained rare and expensive; it took decades to establish their reliability and for seafarers to trust them." (Traducción: siguieron siendo raros y costosos; tomó décadas establecer su fiabilidad y que los marinos confiaran en ellos.) Esta página existe en gran medida para corregir la narrativa de Harrison como desvalido, y así lo dice el cuerpo del artículo en lugar de citarla para esa narrativa. rmg.co.uk/stories/time/longitude-found-nevil-maskelyne-lunar-method · Linda Hall Library, Nevil Maskelyne — fuente de las cifras del segundo ensayo usadas en el cuerpo del artículo (H4 "accurate to within 10 miles" [Traducción: preciso dentro de unas 10 millas], "the lunar distance-method was accurate to within 30 miles" [Traducción: el método de la distancia lunar era preciso dentro de unas 30 millas]), del informe de Maskelyne citado textualmente ("wrote a negative report, saying that the chronometer had built-in errors which just happened to cancel each other out") y de que siguiera resistiéndose a la reclamación de Harrison como miembro ex officio de la Junta: lindahall.org/…/nevil-maskelyne/. La famosa cifra de H4 de aproximadamente una milla proviene de un viaje distinto, y deliberadamente no se yuxtapone con la cifra de 30 millas en este artículo.
- Slate (octubre de 2015). Naval Academy Brings Back Celestial Navigation Training in Case of a Cyberattack on GPS. Restablecida en el verano de 2015 tras más de una década; el tiempo lectivo del curso había sido reemplazado por navegación GPS y electrónica a fines de los años noventa; se cita textualmente al LCDR Ryan Rogers; la reincorporación fue una sesión introductoria de tres horas. slate.com/technology/2015/10/… · corroborando: Military Times · Sky & Telescope
- Wikipedia. Lunar distance (navigation). Usado solo para dos fechas, ambas presentes en la página: las tablas de distancias lunares del British Nautical Almanac "published between 1767 and 1906" (Traducción: publicadas entre 1767 y 1906), y su reemplazo por el cronómetro marino asequible alrededor de 1850. Un borrador anterior de este artículo también atribuía 1907, 1919 y un corte de señal horaria por radio de 1905 a esta página; none of the three appears in it (Traducción: ninguna de las tres aparece en ella), así que las tres se eliminaron en lugar de volver a citarlas. en.wikipedia.org/wiki/Lunar_distance_(navigation) · tratamiento académico, no usado como fuente de ninguna afirmación aquí: Wepster, A (not so) brief history of lunar distances, arXiv:2007.14504
- Boyne, W. J. (agosto de 2013). The Checklist. Air Force Magazine. El accidente del Model 299 del 30 de octubre de 1935; la conclusión de la junta investigadora "improbable that any pilot…" (Traducción: improbable que ningún piloto…); "the limiting factor here was human memory, not the aircraft's size or complexity" (Traducción: el factor limitante aquí era la memoria humana, no el tamaño o la complejidad de la aeronave); y la corrección de que el concepto ya existía antes de 1935 y que el accidente solo institucionalizó su uso — las tres citas son textuales, tomadas del texto del artículo. airandspaceforces.com/…/0813checklist.pdf · registro del accidente: National Air and Space Museum
Paquete de investigación armado el 2026-08-17 a lo largo de cuatro ventanas — 30 días, 30 meses, 30 años, 300 años. Dieciséis fuentes. Este borrador reprobó su propia revisión la primera vez. Un revisor independiente con mirada fresca contrastó cada cita contra la página que la origina y encontró seis defectos estructurales y doce menores, y luego reprobó el borrador corregido una segunda vez y encontró dieciséis más, diez de ellos sustantivos — por eso el colofón de un artículo sobre falsos reportes en verde no debería decir "todo verificado" — debería decir qué estaba mal. Corregido antes de publicar: una oración sobre la supervisión de Erlang no estaba en ninguna fuente citada y ahora aparece sin comillas, con ese hecho señalado en el cuerpo del texto; una frase sobre que el cronómetro era "demasiado caro, demasiado complicado de fabricar a escala" aparecía entre comillas en el arte, en la ficha de registro y en el kit promocional — y en la prosa como una casi-cita en cursiva matizada con "verbatim en espíritu", lo cual es peor — sin existir en ninguna de las fuentes, y fue reemplazada por lo que el informe de Maskelyne realmente decía; una comparación de "una milla náutica contra treinta" mezclaba dos pruebas marítimas distintas y ahora es la misma prueba, diez contra treinta; tres fechas (1907, 1919, 1905) se atribuyeron a una página que no contenía ninguna de ellas y fueron eliminadas en lugar de volver a sustentarse; una fecha de fin de vida útil y un conteo de estrellas de GitHub se eliminaron por la misma razón; y el ejemplo más contundente de los trescientos años — la reincorporación de la Academia Naval en 2015 — había quedado archivado en el lado equivocado de la propia dicotomía del artículo, que es lo que produjo la regla más precisa con la que ahora cierra la pieza. Citas que sobrevivieron la verificación sin cambios: las cuatro de Anthropic, las tres del relato del accidente de 1935, ambas advertencias de METR, la línea de la Academia Naval, y toda la oración del resumen de arXiv. Dos elementos de treinta años se clasifican como envejeciendo bien en lugar de sobrevividos porque no se encontró en esta pasada la evidencia de obituario-y-resurrección. Las 5 de 5 ejecuciones en verde y el vacío de 42 días provienen del propio repositorio público del autor, al igual que los cuatro despachos fallidos y el permiso de repositorio descrito al final — esa sección se reescribió después de que el cron realmente se ejecutó, porque la primera versión decía, con toda honestidad, que la ejecución nunca se había observado, y habría quedado en la página como una mentira en el momento en que dejó de serlo. Sin material de ningún empleador ni cliente. — Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app