AI-NATIVE 系列 · PLAY-ENGINEERING,第1/4集
Play-Engineering:玩出机制,再用工程方法验证新场景
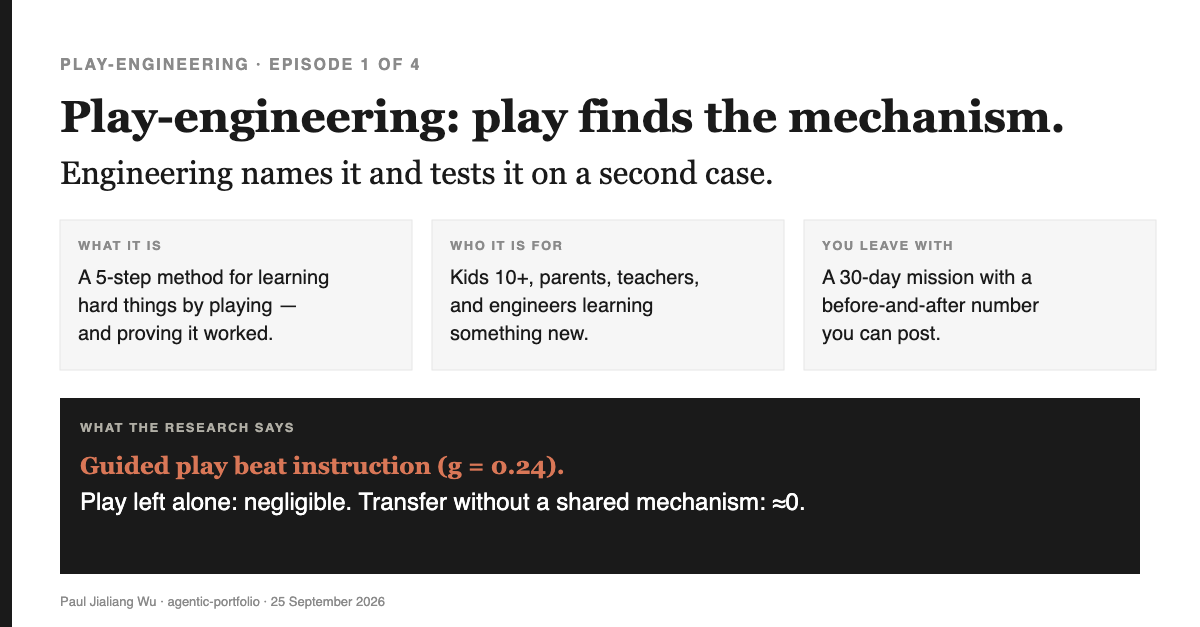
方法简介Play-engineering 是一种先玩、后总结机制、再迁移验证的学习和创新方法,适合攻克难题,甚至发明新东西。 先玩一轮,然后做大多数游戏都跳过的那一步:把你发现的机制用一句话说清楚,并在第二个、不同的场景里测试它。这最初是我在一次访谈里开的一个玩笑。研究表明,这个玩笑其实有严肃内核,而且我原本相信的两点其实都错了。
为什么重要孩子(和大人)之所以放弃难学的科目,是因为练习像惩罚;而他们之所以原地踏步,是因为单靠玩耍并不能稳定提升。在一项关于运动员的综述中,自由玩耍对能力提升几乎没有影响(6,096 在运动员的研究中,孩子们自由玩耍对技能提升几乎没有影响(Güllich et al., 2022). 引导式 游戏则不同:在年幼儿童中,它在早期数学学习上优于直接教学(g = 0.24, Skene et al., 2022)。关键区别在于“工程”这一步——而这一步是可以教的。
你能做什么? 来试试一个10岁孩子也能完成的30天任务:在两种游戏里找到一个共同机制,用一句话说清楚它,然后测一测一个全新 动作在前后分别需要尝试多少次才能成功。 把你的数字发在评论区——这就是你为本系列要共建的领域贡献数据的方式。
Play-Engineering — 系列脉络
- 玩找到机制——这就是 play-engineering 的本质 本集
- 燃料:着迷,而不是分数 第 2 集
- 科幻到原型——故事、机制、玩具、测试、第二案例 第 3 集
- 复兴行动清单——把愿景拆成30天小项目 第 4 集
如何看懂这些数字: g 和 d 表示差异有多大——0.2左右算小,0.5算中等,0.8算大。“SD”(标准差)也是同类单位。
本集要回答的核心问题什么是 play-engineering?玩耍能做到哪些反复操练做不到的事?
本篇不回答不会 解答是什么让你能坚持多年玩下去——那是 第二集,着迷 ——也不会讲怎么把科幻小玩意变成原型,那是 第三集,或者如何把复兴世界的愿景变成可执行的计划,那是 第四集.
本系列讲什么,适合谁
本系列面向所有十岁以上、想学难东西或想创造新事物的人——以及想帮他们的家长、老师和工程师。全系列共四集。这一集定义了什么是 play-engineering,并用证据来检验它。后面几集分别讲:是什么让你坚持下去(第二集)、怎么把科幻变成原型(第三集)、以及如何把“复兴世界”的愿景变成可衡量的计划(第四集)。
先说实话,因为整个系列都建立在这一点上。“play-engineering”最初其实只是我开的一个玩笑。有个研究攀岩工程师的研究生采访我,我跟她说我和她在 Stanford 共同创立了“play engineering”。其实谁也没真创什么。但当我解释我指的是什么时,这个玩笑里居然藏着个真想法,于是我查了查相关研究。有的地方对得上,有的地方对不上。你会看到两面,因为一个不能告诉你哪里错了的方法,根本算不上工程。
有一张图会贯穿四集,先把它作为工具介绍一下。
贯穿全系列的一张图:对练室
大一那年我加入了武术社,教练教我套路——那种给裁判看的漂亮套路。我每天午后一个人练一拳。直到有一天,一个比我高一头的日本交换生看我练,问我:你想对练吗? 我其实不知道什么是对练,但我说了“好”。
头十几分钟他想踢哪就踢哪。慢慢地,我开始能读懂他的腿。我抓住他的脚,试着把他拉倒,没成功。又练了几轮,我找到了诀窍:先把他拉向我,让他本能地调整重心去抗,然后——再 把他甩到一边。半小时下来,我虽然没赢,但已经能应付他所有的腿法。这半小时学到的,比我几周练套路还多。
这间对练室,正好映射了学习相关的研究结论:
| 在对练室里 | 在 play-engineering 里 |
|---|---|
| 为裁判表演的套路 | 以分数为目标的练习——分数、星星、奖品 |
| 一轮对练 | 对练:你自己选动作,结果真实,过程有趣 |
| 负责设定回合规则的教练 | 引导式游戏:大人设计游戏规则,你来做选择(Weisberg et al., 2016) |
| 终于读懂了他的踢法 | 找到机制——动作背后的原理 |
| “先拉,让他调整重心,再甩到一边” | 用一句话把这个机制说清楚 |
| 换个对手再试一次 | 在另一个场景里 |
| 需要多少回合,新对手的踢法才不再得分 | 衡量标准:尝试多少次,新动作才能成功 |
一句话总结 play-engineering:玩找到机制;工程师负责给机制命名,并在另一个场景里验证。
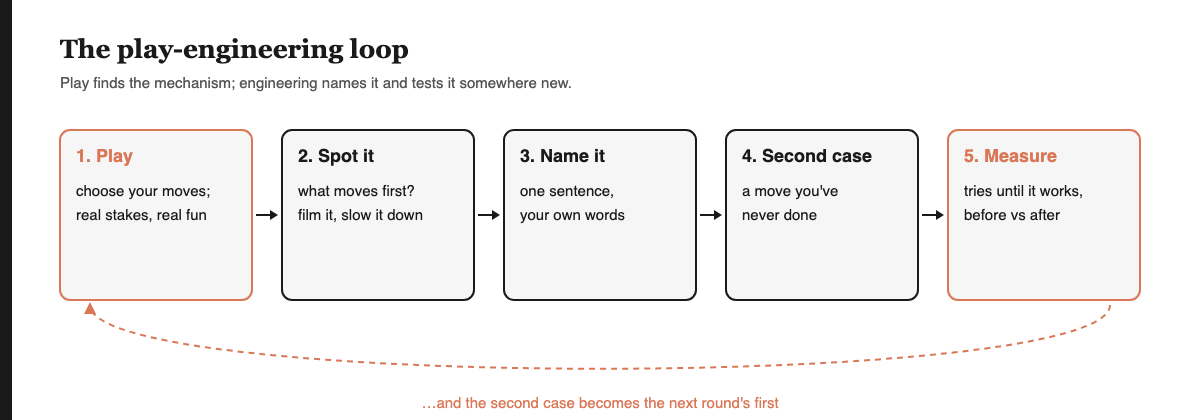
我讲的四个故事,以及相关证据如何评价每个故事
我当时给采访者讲了四个故事来解释这个想法。现在再讲一遍,这次把相关研究也放在旁边——包括那些和我观点不一致的地方。
1. 攀岩墙其实就是一盘棋。我第一次真正的攀岩是在研究生暑假的户外课结业时。第一面墙其实不陡,但我爬到顶已经筋疲力尽——不是因为难度,而是因为害怕。第二天墙陡了不少,反而觉得更轻松,因为我的神经系统已经适应了高度。现在我在办公室附近的健身房攀岩,因为攀岩要求你同时做到两件事:控制身体,还有像下棋一样制定计划——而当计划半路失灵时,你要在墙上临场发明新方案。这种玩法有真实风险、即时反馈,正是研究最推崇的那类游戏。
2. 足球:近迁移,披着远迁移的外衣(先解释两个词:near transfer 指的是在相似场景下用同一个技能;far transfer 则是把技能用到完全不相关的地方。)有次家庭聚会,孩子队把家长队打得落花流水,一位妈妈让我上场救火。我这辈子踢过足球不超过五次。接下来的十五分钟里,我进了四五个球。当时我自信地解释:“武术能迁移到足球。”但研究表明,这种说法太夸张了。科学家们测试过:训练一种技能能不能提升完全无关的另一种技能——只要对照组也在训练别的,效果几乎归零:0.03 音乐训练和0.05 记忆训练的标准差(Sala & Gobet, 2017)。真正能迁移的,是共同机制。踢、打、掷其实用的是同一套动作顺序——先髋和躯干,后四肢,像鞭子一样(生物力学称为 proximal-to-distal)。我用身体接球、用核心发力踢球,就像踢腿时一样。这不是“武术迁移到足球”,而是同一个机制被用在了两次。近迁移,穿着远迁移的外衣。还有第二个证据站在我这边:世界级运动员小时候做过更多多项运动训练,专业化比国家级运动员更晚(Güllich et al., 2022)——多玩多试,才有机会发现共通机制。
3. 游泳:飞跃——但有个必须说明的前提多年来我的自由泳一直很笨拙。今年夏天,练习了武术里的脊柱转动后,我不再只靠手拉脚踢,而是开始用核心带动全身转动——一两天内,自由泳水平像跳台阶一样飞跃。这是真实体验,运动学习的研究也确实描述过类似的突然重组。但这只是我一个人的经历,没有对照组,而且游泳时身体的滚转部分也受水流影响。所以我把它当作帮到我的类比,而不是证据。
4. 那句我得收回的话 我跟采访者说,大约80%的学习不是逻辑或语言层面的——而是身体和情感层面的。我去查了文献,根本没有这个说法。它和“学习风格”神话很接近,而后者已经被严谨综述证伪了(Pashler et al., 2008)。真正有根据的其实更窄也更有趣:有项研究发现,128四年级学生在学习方程时,那些学会了正确手势的孩子能解出更多新题——他们通过自己的双手领会了老师从未用语言讲过的概念(Goldin-Meadow et al., 2009)。 身体确实能承载某些机制,但绝不是“80%的一切”。
成绩单有引导的游戏在儿童早期数学学习上优于直接教学(g = 0.24),在形状知识上也有优势(g = 0.63),覆盖3,893岁儿童——不过作者也提醒,样本量较小、可能有偏差。孩子主导的自由玩耍,比如野球场上的自发比赛,在运动表现上的提升几乎可以忽略不计。6,096名运动员。没有共同机制的远迁移:几乎为零。结论就是:有引导的游戏、机制要命名、第二案例要验证。
为什么这不仅对孩子重要:机器也是这样学的
这一点让我开始认真对待自己那个玩笑。Google 的机器人研究者收集了“游戏”数据——人们通过机器人随意摆弄桌上的物体,完全没有任务目标——然后用这些数据训练机器人。 游戏探索覆盖的可能交互空间,比同样时间内收集的任务演示要广得多。~4x用游戏数据训练出的单一机器人策略,在 18 项任务上的平均成功率为85.5%,而用专家演示分别训练的 18 个策略则为70.3%(Lynch et al., 2019)。虽然实验是在仿真环境下进行,且这些“游戏”是人类操控机器人而非机器人自己玩——但这个结论和“对练室”如出一辙:自由探索能发现比脚本化教学更多的世界。越来越多的 AI 研究者也认为,开放式、富有玩心的探索,是让 AI 持续发现新事物的关键(Hughes et al., 2024)。孩子需要的机制和机器人需要的机制,看起来就是同一个。
五个为什么:一个从没踢过足球的人,为什么能进四个球?
- 我为什么能进球? 因为我用全身控球,而不是只靠脚。 证据:这是我在采访中的自述;只参加过一场比赛,没有对照组——纯属个人经历,已按轶事标注。
- 我为什么能做到? 因为多年的对练训练,让我习惯了从核心发力,先动髋再动手。 证据:上文的对练故事。
- 为什么这在足球里有用? 因为足球的踢和武术的踢,本质上用的是同一个机制——从近端到远端的鞭打式发力。 证据:击打和投掷的生物力学 (Putnam, 1993,文献有描述,未直接引用)。
- 为什么不能说“武术能帮你搞定一切”? 因为没有共同机制时,迁移效应在对照组也训练的情况下几乎为零。 证据:0.03 和 0.05 标准差 (Sala & Gobet, 2017).
- 那真正起作用的是什么? 是我清楚地知道 自己 掌握的是哪一个机制。 本质:当玩耍让你发现了某个机制,并且你能清楚地给它命名、迁移到别处试一试时,学习就会出现飞跃。 对比两个案例,正是人们找到共通结构的方式。 证据:两案例对比与图式迁移(Gick & Holyoak, 1983,描述); 引导式游戏 vs 自由游戏:g = 0.24,而自由游戏几乎无效。
🥋 你的30天任务:两种游戏,一个机制
适合10岁及以上。你需要一个朋友或家长、一只球和一本笔记本。共30天。
- 第1–7天:先玩。 玩两种都涉及投掷或击打的游戏:比如扔球和踢球,或者用枕头打拳和发网球。怎么玩都行,尽情玩就好。
- 第8–10天:找机制。 用手机慢动作互相观察。先动的是手臂,还是髋部?用你自己的话,把这个机制写成一句话。
- 第11天:测量前。 选 两个你从没做过的动作(比如侧手掷石头——在开阔水面、前方没人时——、凌空抽球、飞盘反手)。抛硬币:现在测试一个,另一个留到第30天。数一数要试多少次才能连续三次成功。把数字记下来。
- 第12–29天:工程实践。 练习第11天选的那个动作——绝不碰你留到第30天的那个——有意识地用你那句机制。
- 第30天:测量后,用你之前保存的那个动作。 还是一样数尝试次数。
要测什么: 第11天和第30天的“成功所需尝试次数”。参与方式: 把两个数字和你的那句机制发在评论区。这就是你为一个还不存在的领域贡献的数据点——直到你帮它诞生。
未满13岁? 让家长帮你发。无需实名——只写年龄段(10–12、13–15、50+)。
Operate——运行方式
一句话总结:本页所有数字在上线前,都会由机器人自动核查。更详细地说:本系列的构建方式,和它描述的方法完全一致。页面上的每一个研究数据,都来自同一个文件,content/series/play-engineering/evidence.yml,每条数据都带有来源和标签:FETCHED(已在原始出处阅读)或 UNVERIFIED(仅见于二手资料)。构建脚本只会输出 FETCHED 行的数据——绝不会输出 UNVERIFIED 的——而系列的闸门,scripts/check-play-engineering.mjs,会在以下情况下让网站构建失败:任何已打印的数字与文件不符、第4个故事中已废弃的说法被重新引入,或某一集丢失了它的任务卡。
反馈——你如何判断它真的有效,以及那些数字看不到的部分
你的任务数字就是信号:新动作“成功所需尝试次数”,分别记录前后。如果“后”的数字更小,说明机制确实帮上了忙。整个系列有个在发布前就定下的目标:30天内评论区至少收集10位读者的任务结果,由scripts/play-missions.mjs统计。至于数字看不到的部分:次数变少,也可能只是第30天你更热身、更自信,或者运气更好。这也是为什么任务要用第二个全新动作——一个人的结果是故事,五十个人的结果才开始成为证据。
预设措施——在结果出来前就决定的应对方案
- 如果30天内收到的任务结果少于10份,说明任务太难或太隐蔽:那就缩短为一周,并移到本页更显眼的位置。
- 如果大多数“后”的数字没有变小,我会在本页更新中如实说明——并把结论收缩到“有引导的游戏能帮助小孩学数学”,这也是目前最有力的证据所能支持的全部。
- 如果有读者报告某个机制在意想不到的地方迁移,它就会成为第3集.
本集在整个系列中的位置
| 起源 | 核心概念 | 基本原理 | 主要贡献者 | |
|---|---|---|---|---|
| 游戏(第1集) | Froebel 的第一所幼儿园(1837)→ Papert 的Mindstorms(1980)→ Resnick 的 Lifelong Kindergarten | 在你真正关心的事物中动手学习 | 引导式引导式游戏优于直接教学;单靠自由玩耍效果有限 | Froebel · Papert · Resnick · Hirsh-Pasek & Golinkoff · Skene 等 |
| 动力(第2集) | Deci & Ryan 的自我决定理论(1985) | 沉迷其中,以及对未来自我的鲜明想象 | 预期奖励会消耗动力;有策略才能让未来自我落地 | Deci · Ryan · Lepper · Oyserman |
| 作品原型(第3集) | Wells、Verne 及科幻杂志 → Goddard、Lake、Sikorsky | 一个故事会先于机器的诞生为其命名 | 当某个作品的机制能在第二个场景下被验证时,它才算真正进入工程 | Goddard · Lake · XPRIZE · Lynch 等(让机器人玩耍) |
| 复兴(第4集) | 创世纪 2:15 —— 耕耘与守护 | 这个愿景是对现实世界的召唤,而不仅仅是对未来的承诺 | 一个已被验证的机制,在本地运行,前后可量化 | Rinaudo(FMNR)· Megatons to Megawatts · 屠呦呦 · Experience Corps |
同一个故事,五种分岔
| 你的身份是…… | 这会改变你哪个决策 | 一个具体行动 |
|---|---|---|
| 学生(10–15 岁) | 你要怎么练习自己不擅长的东西 | 先玩一遍,然后用一句话写下为什么那些成功的尝试能奏效 |
| 家长或老师 | 自由玩耍还是反复操练 | 设计游戏(引导式游戏);别只是把孩子单独放着让他们自由玩,也别只让他们死记硬背 |
| 工程师 | 你如何学习一项新工具或新领域 | 找出它和你已掌握的技能有什么共通机制;在第二个问题上试一试再决定是否信得过 |
| 创始人 | 培训与入职 | 衡量新任务从零到第一次成功所需的时间,而不是累计了多少培训时长 |
| 投资人 | 教育科技和机器人领域的投资选择 | 问清楚产品是否明确机制、能否测量迁移效果——而不是只统计用户活跃度 |
30分钟上手
- 输入:你觉得可能有共通机制的两项活动。
- 输出:一句话点明机制,以及两个数字(练习前尝试次数,练习后尝试次数)。
- 不变条件:“练习后”测试必须用你从未做过的新动作——绝不能用你练习过的那个。
- 停止规则:如果你连续尝试了三种不同的新动作都没有进步,那说明你找的机制并不是关键所在;回去继续玩吧。
- 最简记录:
mechanism, move_before, tries_before, move_after, tries_after, date. - 特意省略:对照组。找个朋友一起练,但他/她不去给机制命名,这样你就有了真正的实验。
5S自评体系,附带证据
| S | 自评分项 | 证据 |
|---|---|---|
| 简明 | 4/5 | 一张图——表格里的“对练房间”一一对应;一句话,画成五步循环:玩找到机制,工程师把它命名并在第二个场景里验证。 |
| 扎实 | 4/5 | 所有数字只来自 中 FETCHED 行content/series/play-engineering/evidence.yml (e.g. g = 0.24;无来源的“80%”说法已被撤下并加闸门。 |
| 敏锐 | 4/5 | 作者自己的足球故事被重新诊断为近迁移;远迁移测得0.03 SD(Sala & Gobet). |
| SMART | 4/5 | 一个30天任务,带前后对比数字,系列目标是30天内有10位读者提交结果,由 统计scripts/play-missions.mjs. |
| 特别有趣 | 4/5 | 一个适合孩子的任务和一个让人自省的起源故事——见五个为什么:“近迁移,披着远迁移的外衣。” |
参考文献
- Skene 等(2022),Child Development 93, 1162–1180 ——引导式游戏与直接教学、自由玩耍的对比(1–8 岁儿童的元分析)。
- Güllich, Macnamara & Hambrick(2022),Perspectives on Psychological Science ——青少年多项运动训练、专项化与自由玩耍。
- Sala & Gobet(2017),Current Directions in Psychological Science ——在主动对照条件下的远迁移。
- Goldin-Meadow, Cook & Mitchell(2009),Psychological Science 20(3), 267–272 ——手势与数学学习。
- Pashler, McDaniel, Rohrer & Bjork(2008),Psychological Science in the Public Interest ——学习风格:概念与证据。
- Lynch 等(2019),CoRL ——Learning Latent Plans from Play。
- Hughes 等(2024),ICML ——开放探索与超人类 AI。
- Weisberg, Hirsh-Pasek, Golinkoff, Kittredge & Klahr(2016),“Guided Play: Principles and Practices”,Current Directions in Psychological Science 25(3) ——文献综述,非直接引文。
相关阅读
content/series/play-engineering/evidence.yml;故事部分均为我的亲身经历,并已注明为故事。