AI-NATIVE 시리즈 · 플레이-엔지니어링, 에피소드 1/4
플레이-엔지니어링: 놀이로 메커니즘을 찾고, 엔지니어링으로 두 번째 사례에 시험한다
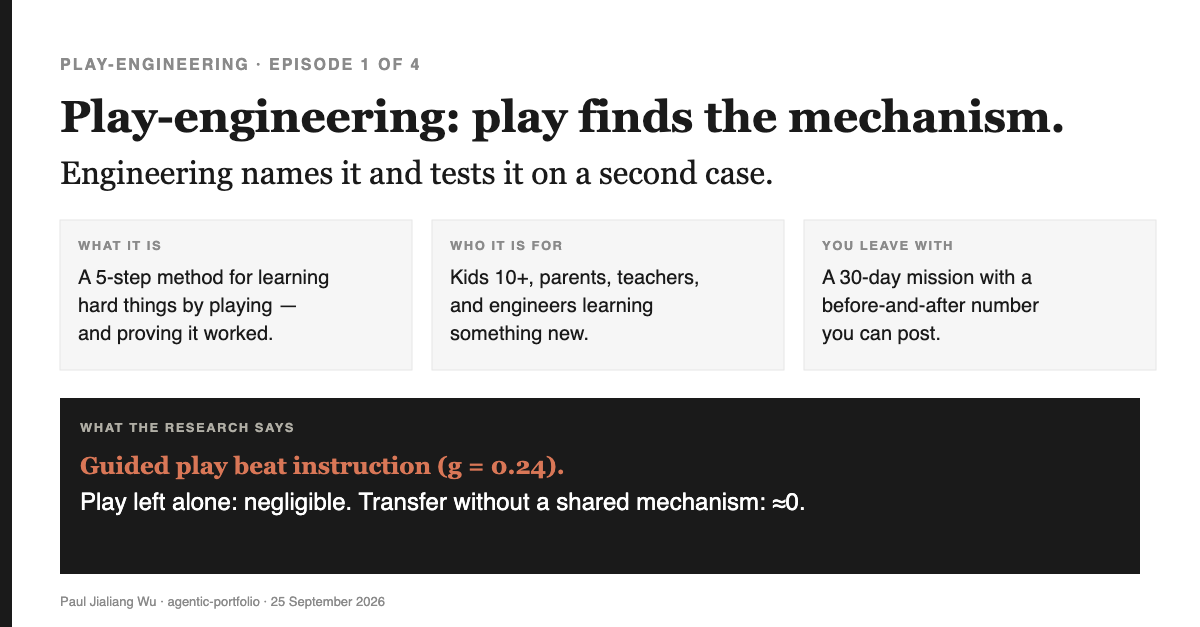
이 방법은 무엇인가플레이-엔지니어링은 어려운 것을 배우거나 새로운 것을 발명할 때, 먼저 자유롭게 놀아보고그 다음, 대부분의 놀이가 건너뛰는 단 한 가지 단계를 더한다: 바로 발견한 메커니즘에 이름을 붙이고, 전혀 다른 두 번째 사례에 시험하는 것이다. 이 방법은 내가 한 인터뷰에서 농담처럼 시작됐다. 그런데 연구를 찾아보니, 그 농담에는 진지한 핵심이 있었고, 내가 믿었던 두 가지는 사실이 아니었다.
왜 이 방법이 중요한가아이들(그리고 어른들)도 연습이 벌처럼 느껴져서 어려운 과목을 포기한다. 놀이만으로는 실력이 꾸준히 늘지 않기 때문에, 그냥 제자리에 머물기 쉽다. 한 리뷰에 따르면6,096 운동선수들을 대상으로 한 리뷰에 따르면, 아이들이 스스로 주도하는 자유 놀이는 실력 향상에 거의 영향을 주지 못했다 (Güllich et al., 2022). 가이드 놀이는 다르다. 어린아이의 경우, 가이드 놀이가 직접 지도식 수학 교육보다 더 좋은 초기 성과를 냈다(g = 0.24, Skene et al., 2022). 차이를 만드는 것은 바로 '엔지니어링'의 절반이며, 이 절반은 가르칠 수 있다.
이후에 할 수 있는 일. 10살도 할 수 있는 30일 미션을 해보라. 두 가지 게임에서 공통된 메커니즘 하나를 찾아내고, 한 문장으로 정리한 뒤, 처음 해보는 동작이 성공하기까지 각각 몇 번 시도했는지, 전후로 측정하라. 댓글에 두 숫자를 남겨라. 이 시리즈가 초대하는 새로운 분야에 직접 기여하는 방법이다.
Play-Engineering — 시리즈 줄기
- 플레이가 메커니즘을 찾는다 — 이것이 플레이-엔지니어링이다 이번 화
- 연료 — 점수가 아니라 매혹 2화
- SF에서 프로토타입까지: 이야기, 메커니즘, 장난감, 실험, 두 번째 사례 3화
- 회복 플레이북: 비전을 30일 프로젝트로 4화
숫자 읽는 법: g와 d는 차이의 크기를 나타낸다. 약 0.2는 작고, 0.5는 중간, 0.8은 크다. "SD"(표준편차)도 같은 종류의 단위다.
이번 편이 답하는 핵심 질문플레이-엔지니어링이란 무엇이며, 놀이가 반복 훈련으로는 할 수 없는 것은 무엇인가?
이 글은 아니다 몇 년이고 계속하게 만드는 동기가 무엇인지에 대한 답은 여기서 다루지 않는다 — 그건 episode 2, fascination(2화, 몰입) — 또는 공상과학 소품을 어떻게 프로토타입으로 바꾸는지에 대한 답도 아니다. 그건 episode 3(3화), 혹은 회복된 세계에 대한 비전을 어떻게 실행 가능한 계획으로 바꾸는지에 대한 답도 아니다. 그건 episode 4(4화).
이 시리즈의 범위와 대상
이 시리즈는 대략 열 살 이상, 어려운 것을 배우고 싶거나 아직 세상에 없는 무언가를 만들고 싶은 사람, 그리고 그들을 돕고자 하는 부모·교사·엔지니어 모두를 위한 것이다. 총 네 편으로 구성되어 있다. 이번 편에서는 놀이-엔지니어링이란 무엇인지 정의하고, 실제 근거와 비교해 검증한다. 나머지 편에서는 계속해나가는 힘(2화), 공상과학을 프로토타입으로 바꾸는 방법(3화), 그리고 성경적 회복의 비전을 측정 가능한 계획으로 바꾸는 방법(4화)을 다룬다.
처음부터 솔직하게 밝힌다. 이 시리즈 전체가 이 솔직함에 기대고 있기 때문이다. '놀이-엔지니어링'이라는 말은 농담에서 시작했다. 등반하는 엔지니어를 연구하는 대학원생이 나를 인터뷰했을 때, 나는 그녀와 Stanford에서 '놀이-엔지니어링'을 공동 창립했다고 말했다. 사실 아무도 창립한 적 없다. 하지만 내가 그 의미를 설명하자, 그 농담 안에 실제 아이디어가 숨어 있다는 걸 알게 되었고, 연구 결과와 대조해 보았다. 일부는 들어맞았고, 일부는 아니었다. 둘 다 보여주겠다. 언제 틀렸는지 말해주지 못하는 방법론은 엔지니어링이 아니기 때문이다.
네 편을 관통하는 하나의 그림이 있다. 우선 그 그림을 도구로 소개한다.
시리즈 전체를 관통하는 한 장면: 스파링 룸
대학 1학년 때 나는 무술 동아리에 들어갔다. 코치는 나에게 품새를 가르쳤다 — 심사위원 앞에서 선보이는 아름답고 짜인 동작들이다. 나는 매일 오후 혼자 한 동작을 연습했다. 그러던 어느 날, 일본에서 온 키가 훨씬 큰 교환학생이 나를 지켜보다가 이렇게 물었다: do you want to spar?(스파링 해볼래?) 나는 스파링이 뭔지 몰랐다. 그래도 하겠다고 했다.
처음 10~15분 동안 그는 원하는 대로 나를 찼다. 그러다 점차 그의 발차기를 읽기 시작했다. 나는 그의 발을 잡아당기려다 실패했다. 몇 번 더 반복하자 마침내 답을 찾았다: 그를 내 쪽으로 끌어당기고, 그가 균형을 잡으려 할 때 — 그리고 그때 옆으로 휙 넘긴다. 30분이 끝날 무렵 나는 이기진 못했지만, 그의 모든 발차기를 받아낼 수 있었다. 그 반 시간 동안 나는 몇 주간의 품새 연습보다 더 많이 배웠다.
그 방에서의 경험은 학습에 관한 연구 결과와 정확히 맞닿아 있다:
| 스파링 룸에서는 | 놀이-엔지니어링에서는 |
|---|---|
| 심사위원 앞에서 선보이는 품새 | 점수(점수, 별, 상장 등)를 목표로 한 연습 |
| 스파링 한 판 | 놀이: 내가 움직임을 선택하고, 결과는 실제로 일어나며, 그 자체로 즐겁다 |
| 라운드의 규칙을 정하는 코치 | 가이드 놀이: 어른이 게임의 틀을 짜고, 선택권은 내가 가진다 (Weisberg et al., 2016) |
| 마침내 그의 킥을 읽어내다 | 메커니즘을 포착하는 순간메커니즘 — 겉으로 드러난 움직임 아래 숨은 원인 |
| "당기고, 상대가 균형을 맞추게 한 뒤, 옆으로 휘두른다" | 메커니즘을 한 문장으로 명확히 정의하기 |
| 다른 파트너에게 같은 원리를 적용해 보기 | 두 번째 사례에서 실제로 시험해 보기두 번째 사례 |
| 새 파트너의 킥이 더 이상 들어오지 않게 되기까지 몇 라운드가 걸리는지 | 측정: 새로운 움직임이 성공할 때까지 시도한 횟수 |
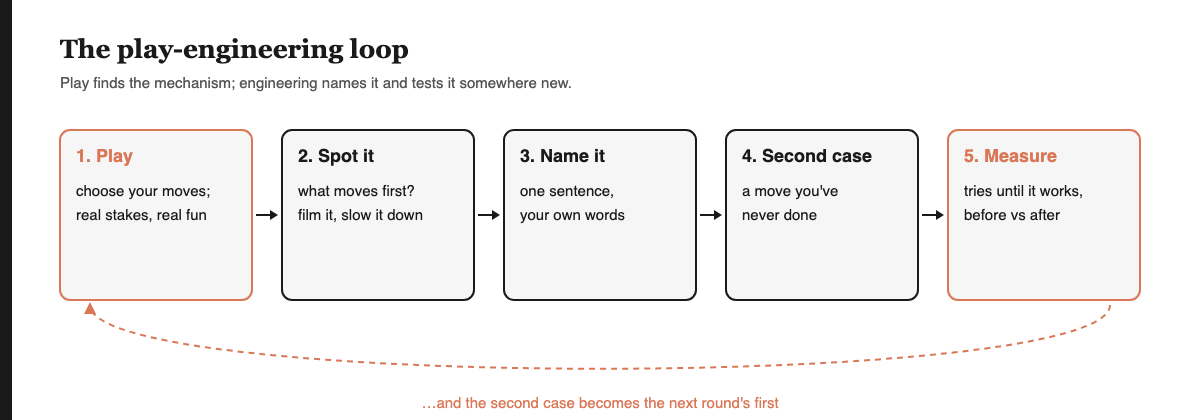
이걸 한 줄로 정리하면 이렇다:놀이는 메커니즘을 발견하고, 엔지니어는 그 메커니즘에 이름을 붙여 다른 상황에서 다시 시험한다.
내가 직접 겪은 네 가지 사례와, 각각에 대한 연구의 평가
이 아이디어를 설명하려고 인터뷰에서 네 가지 이야기를 들려줬다. 이번에는 연구 결과와 함께 다시 꺼내 본다 — 내 생각과 어긋나는 부분까지 포함해서.
1. 암벽 등반장은 체스판이다. 내 첫 진짜 등반은 대학원 여름 수업 마지막 날 야외에서 했다. 첫 벽은 가파르지 않았지만, 정상에 오르자 완전히 탈진했다 — 어려워서가 아니라, 두려움 때문이었다. 다음 날 벽은 훨씬 더 가팔랐는데도 오히려 더 쉬웠다, 내 신경계가 높이에 적응했기 때문이다. 지금은 사무실 근처 실내 암장에서 등반한다. 등반은 내 몸을 통제하는 능력과 체스처럼 계획을 세우는 두 가지를 동시에 요구한다 — 그리고 계획이 중간에 무너지면, 벽 위에서 즉석에서 새로운 계획을 만들어야 한다. 이게 바로 실제로 판이 걸려 있고 즉각적으로 피드백이 오는 진짜 놀이다. 연구가 높이 평가하는 바로 그 유형의 놀이이기도 하다.
2. 축구: 근거리 전이, 그러나 겉모습은 다르다. (먼저 용어부터 짚고 가겠다: near transfer는 비슷한 상황에서 기술을 옮겨 쓰는 것이고, far transfer는 전혀 다른 분야에 적용하는 것이다.) 가족 모임에서 아이들 팀이 부모 팀을 압도하고 있었고, 한 엄마가 나에게 교체로 들어가 달라고 했다. 나는 평생 축구공을 다섯 번쯤 차본 게 전부였다. 그런데 15분 만에 네다섯 골을 넣었다. 그때 나는 "무술이 축구로 전이된다"고 설명했다. 하지만 연구는 그게 과장된 해석이라고 말한다. 한 기술을 연습한다고 해서 아무 관련 없는 기술까지 좋아지는지 실험할 때, 비교 집단도 뭔가를 연습하면 그 효과는 거의 사라진다: 0.03 음악 훈련과 0.05 기억력 훈련에서의 표준편차 (Sala & Gobet, 2017). 실제로 전이되는 것은 공유된 메커니즘이다. 킥, 펀치, 던지기는 모두 같은 순서를 따른다 — 엉덩이와 몸통이 먼저 움직이고, 그 다음에 팔다리가 채찍처럼 따라간다(생체역학에서는 proximal-to-distal이라 부른다). 나는 공을 몸 전체로 받아내고, 중심에서 힘을 내어 찼다. 이건 "무술이 축구로 전이된 것"이 아니라, 같은 메커니즘을 두 번 쓴 것이다. 근거리 전이가 겉으로는 먼거리 전이처럼 보였을 뿐이다. 또 하나 내 쪽에 유리한 근거가 있다. 세계적 수준의 성인 선수들은 어릴 때 다종목 연습을 더 많이 했고, 국가대표급 선수들보다 전문화도 더 늦게 시작했다(Güllich et al., 2022) — 다양한 게임을 하며 공유된 메커니즘을 발견할 기회가 많았다는 뜻이다.
3. 수영: 도약 — 그리고 솔직한 단서. 내 자유형은 오랫동안 어설펐다. 그런데 올여름, 무술에서 척추를 돌리는 법을 연습한 뒤로 팔로 끌거나 다리로 차는 대신, 중심에서 몸을 돌리기 시작했다. 그러자 하루 이틀 만에 내 자유형이 계단처럼 확 달라졌다. 실제 경험이고, 운동학습 연구에서도 이런 급격한 재조직화 현상을 설명한다. 하지만 이건 비교 집단도 없는 한 사람의 사례일 뿐이고, 수영에서는 몸의 롤이 물에 의해 부분적으로 유도된다. 그래서 나는 이걸 내게 도움이 된 비유로만 받아들이고, 증거로 삼지는 않는다.
4. 내가 철회해야 할 주장. 나는 인터뷰에서 학습의 약 80%는 논리적이거나 언어 기반이 아니라 신체적이고 정서적이라고 말했다. 출처를 찾아봤다. 없었다. 이건 '학습 유형' 신화와 비슷한 위치에 있다. 신중한 리뷰들은 이에 대한 근거를 찾지 못했다(Pashler et al., 2008). 실제로 근거가 있는 부분은 더 좁고, 오히려 흥미롭다. 예를 들어, 초등학교 4학년 학생들이 방정식을 배울 때, 올바른 손동작을 배운 아이들이 새로운 문제를 더 많이 풀었다—128말로 설명받지 않은 개념을 자기 손을 통해 받아들인 것이다 (Goldin-Meadow et al., 2009). 몸도 메커니즘을 담을 수는 있지만, 그렇다고 해서 모든 학습의 80%를 몸이 담당하는 것은 아니다.
점수판을 보자. 가이드 놀이가 초기 수학 학습에서 직접 지도를 이겼다(g = 0.24), 도형 지식에서도 마찬가지였다(g = 0.63)—3,893 1~8세 아동을 대상으로 한 결과다. 다만, 저자들은 연구 규모가 작고 편향 가능성이 있음을 지적한다. 아이들이 주도하는 자유 놀이는, 즉석 경기처럼, 선수들의 성과에 거의 영향을 주지 않았다(리뷰 결과). 6,096 선수들. 공유된 메커니즘이 없는 먼 전이는 거의 0에 가깝다. 결론: 놀이, 가이드; 메커니즘, 명명; 두 번째 사례, 검증.
이것이 아이들만의 이야기가 아닌 이유: 기계도 이 방식으로 배운다
여기서부터 내가 농담을 진지하게 받아들이게 된 이유가 있다. Google의 로보틱스 연구자들은 '놀이'—사람들이 로봇을 통해 테이블 위의 물건을 아무 목적 없이 자유롭게 만지는 것—를 수집해 로봇을 훈련시켰다. 놀이는 같은 시간 동안 수집된 과제 시연보다 ~4x 더 넓은 상호작용 공간을 탐색했고, 놀이로 훈련된 하나의 로봇 정책은 18개 과제에서 평균 85.5%의 성공률을 보였다. 반면, 전문가 시연으로 각각 따로 훈련된 18개 정책은 70.3%에 그쳤다 (Lynch et al., 2019). 이 실험은 시뮬레이션 환경에서 진행됐고, 놀이 역시 로봇이 혼자 논 것이 아니라 사람이 조종한 것이었다. 하지만 교훈은 대련실에서 얻은 것과 같다: 자유로운 탐색이 각본 있는 수업보다 더 많은 세계를 발견한다. 그리고 점점 더 많은 AI 연구자들은 열린 결말의 장난스러운 탐색이 계속해서 새로운 것을 발견하는 AI 구축에 필수적이라고 주장한다 (Hughes et al., 2024). 아이에게 필요한 메커니즘과 로봇에게 필요한 메커니즘은 결국 같은 구조다.
다섯 번의 왜: 축구를 한 번도 해본 적 없는 내가 네 골을 넣은 이유는?
- 내가 왜 골을 넣었을까? 내가 공을 발이 아니라 온몸 전체로 다뤘기 때문이다. 근거: 인터뷰에서 내가 직접 말한 내용, 단 한 번의 경기, 대조군 없음 — 일화이며, 일화로 명확히 밝힘.
- 내가 그걸 할 수 있었던 까닭은? 수년간 스파링을 하며 항상 손보다 엉덩이, 즉 몸통부터 움직이는 동작이 몸에 밴 덕분이다. 근거: 위에 나온 스파링 경험.
- 그게 축구에서 왜 통했을까? 축구의 킥과 무술의 킥 모두 같은 메커니즘, 즉 몸통에서 말단으로 이어지는 채찍 동작(proximal-to-distal whip)을 쓰기 때문이다. 근거: 타격과 투척의 생체역학 (Putnam, 1993, 설명만 있고 직접 인용은 아님).
- "무술은 모든 데 도움이 된다"는 결론이 왜 따라오지 않는가? 공유된 메커니즘 없이 단순히 전이만 시도하면, 대조군도 훈련할 경우 효과가 사실상 0에 가깝기 때문이다. 근거: 0.03 그리고 0.05 SD (Sala & Gobet, 2017).
- 그럼 실제로 차이를 만든 건 무엇이었을까? 내가 어떤 메커니즘을 내 몸에 담고 있다는 사실을 자각했다는 점이다. 핵심: 놀면서 메커니즘을 발견하고, 그걸 명확히 이름 붙여 다른 곳에 적용해볼 때 학습이 도약한다. 두 사례를 비교하는 과정에서야말로 사람들이 공통 구조를 처음으로 찾아낸다. 근거: 두 사례 비교와 스키마 전이 연구 (Gick & Holyoak, 1983, 설명됨); 가이드 놀이 vs 자유 놀이: g = 0.24 vs 무시할 만한 수준.
🥋 30일 챌린지: 두 가지 게임, 하나의 메커니즘
10세 이상이라면 누구나 참여할 수 있다. 친구나 부모, 공 하나, 노트 한 권만 있으면 된다. 기간은 30일이다.
- 1~7일차 — 놀이. 던지거나 치는 동작이 들어가는 서로 다른 두 가지 게임을 해본다. 예를 들어, 공을 던지기와 공을 차기, 혹은 베개를 주먹으로 치기와 테니스 서브 등이다. 방법에는 아무런 제한이 없다. 그냥 자유롭게 논다.
- 8~10일차 — 메커니즘 찾기. 휴대폰으로 서로를 슬로모션으로 촬영해본다. 먼저 움직이는 게 팔인지, 엉덩이인지 관찰한다. 발견한 메커니즘을 자기만의 말로 한 문장으로 적는다.
- 11일차 — 사전 측정. 한 번도 해본 적 없는 두 가지 동작을 고른다(예: 돌을 옆으로 던져 물수제비 뜨기 — 앞에 아무도 없는 넓은 물가에서 —, 발리슛, 프리스비 백핸드 등). 동전을 던져 하나는 지금 시도하고, 다른 하나는 30일차까지 남겨둔다. 세 번 연속 성공할 때까지 시도한 횟수를 센다. 그 숫자를 기록한다.
- 12~29일차 — 실험. 11일차에 고른 동작만 연습한다 — 남겨둔 동작은 절대 연습하지 않는다 — 그리고 한 문장으로 정리한 메커니즘을 의식적으로 적용한다.
- 30일차 — 남겨둔 동작으로 사후 측정. 동일하게 시도 횟수를 센다.
측정 항목: 11일차(사전)와 30일차(사후)에 성공까지 걸린 시도 횟수.참여 방법: 두 숫자와 한 문장 메커니즘을 댓글로 남긴다. 당신이 직접 남긴 데이터가, 아직 존재하지 않는 새로운 분야의 첫 번째 기록이 된다.
13세 미만인가? 부모님께 대신 댓글을 부탁하라. 이름은 쓰지 말고, 나이대만 남긴다(10–12, 13–15, 50+).
Operate — 작동 원리
한 문장으로:이 페이지의 모든 수치는 페이지가 공개되기 전에 자동화된 검증을 거친다. 더 구체적으로 말하자면, 이 시리즈 전체는 여기서 설명하는 방법론 그대로 설계되어 있다. 이 페이지의 모든 연구 수치는 하나의 파일에서 관리된다,
content/series/play-engineering/evidence.yml, 여기서 각 주장에는 출처와 태그가 붙는다: FETCHED(원본에서 직접 확인) 또는 UNVERIFIED(2차 정보). 빌드 스크립트는 오직 FETCHED 행의 숫자만 출력한다. UNVERIFIED는 절대 출력하지 않는다. 그리고 시리즈 게이트인 scripts/check-play-engineering.mjs가 작동하여, 만약 출력된 숫자가 파일과 불일치하거나, 이야기 4에서 폐기된 주장이 다시 등장하거나, 어떤 에피소드든 미션 카드가 빠지면 사이트 빌드를 중단한다.
피드백 — 무엇으로 효과를 판단할 수 있고, 그 숫자가 보여주지 못하는 것은 무엇인가
신호는 바로 여러분의 미션 결과 수치다: 새로운 동작에서 성공까지 걸린 시도 횟수의 전후 비교. 만약 '이후' 숫자가 더 작아진다면, 메커니즘이 실제로 도움이 된 것이다. 시리즈 전체의 목표는 출간 전에 미리 정해진다: 30일 이내에 댓글로 10명 이상의 독자 미션 결과가 집계되는 것, 이 수치는 scripts/play-missions.mjs가 자동으로 센다. 하지만 이 숫자만으로는 알 수 없는 부분도 있다. 예컨대, 숫자가 줄어든 것이 단순히 몸이 풀렸거나, 자신감이 붙었거나, 30일째 운이 좋았기 때문일 수도 있다. 그래서 미션에서는 두 번째 새로운 동작을 사용한다. 한 사람의 결과는 이야기일 뿐이지만, 오십 명의 결과부터는 비로소 증거가 되기 시작한다.
피드포워드 — 결과가 나오기 전에 이미 정해둔 대응
- 30일 안에 미션 결과가 10개 미만이면, 미션이 너무 어렵거나 너무 눈에 띄지 않는다는 뜻이다. 이 경우 미션은 1주일로 단축되어 페이지 상단으로 이동한다.
- 만약 대부분의 '이후' 숫자가 더 작지 않다면, 이 페이지에 업데이트로 그 사실을 밝히겠다. 그리고 주장은 '가이드 놀이가 어린이의 수학 학습에 도움이 된다'라는, 가장 강력한 증거가 뒷받침하는 수준으로 후퇴한다.
- 만약 독자가 예상 밖의 전이 사례를 보고하면, 그것은 에피소드 3.
이 에피소드의 시리즈 내 위치
| 구상 | 핵심 개념 | 지배 원리 | 주요 기여자 | |
|---|---|---|---|---|
| 놀이 (에피소드 1) | 프뢰벨의 최초 유치원(1837) → Papert의 Mindstorms (1980) → Resnick의 Lifelong Kindergarten | 내가 진짜로 신경 쓰는 것을 직접 만들어보며 배우기 | 가이드 놀이가이드 놀이가 직접 지도를 이긴다. 자유 놀이만으로는 효과가 없다 | Froebel · Papert · Resnick · Hirsh-Pasek & Golinkoff · Skene et al. |
| 연료(에피소드 2) | Deci & Ryan의 자기결정성 이론(1985) | 매혹, 그리고 또렷한 미래의 나 | 기대 보상은 동기를 깎아먹고, 전략은 미래의 나를 현실에 붙잡아둔다 | Deci · Ryan · Lepper · Oyserman |
| 아티팩트(에피소드 3) | Wells, Verne과 펄프 소설 → Goddard, Lake, Sikorsky | 이야기가, 아무도 만들기 전에, 기계에 이름을 붙인다 | 아티팩트의 메커니즘이 두 번째 사례에서 검증될 때, 비로소 그것이 엔지니어링이 된다 | Goddard · Lake · XPRIZE · Lynch et al. (로봇 놀이 사례) |
| 복원(에피소드 4) | 창세기 2:15 — 경작하고 지키라 | 비전은 훗날의 약속이 아니라, 지금 이 땅에서 실천해야 할 명령이다 | 입증된 메커니즘 하나를 지역에서 실행하고, 사전·사후로 측정한다 | Rinaudo (FMNR) · Megatons to Megawatts · Tu Youyou · Experience Corps |
같은 이야기, 다섯 갈래의 출구
| 당신이 … 라면 | 이 결정이 바꾸는 것 | 실제로 할 수 있는 한 가지 |
|---|---|---|
| 학생(10–15세) | 자신이 약한 분야를 어떻게 연습할 것인가 | 먼저 자유롭게 놀아보고, 좋은 시도가 왜 통했는지 한 문장으로 정리한다무엇이 좋은 시도를 성공으로 이끌었는지 |
| 부모나 교사 | 자유 놀이와 반복 훈련의 선택 | 게임을 설계해라(가이드 놀이). 아이를 그냥 내버려두지도 말고, 반복 훈련만 시키지도 말 것 |
| 엔지니어 | 새로운 도구나 분야를 어떻게 익힐 것인가 | 이미 아는 것과 공유하는 메커니즘을 찾아내고, 두 번째 문제에 적용해보기 전까진 확신하지 않는다 |
| 창업자 | 교육과 온보딩 | 교육에 쏟은 시간 대신, 새로운 과제에서 첫 성공까지 걸린 시도를 측정한다 |
| 투자자 | 에듀테크·로보틱스 투자 판단 | 제품이 메커니즘을 명확히 짚고 전이까지 측정하는지, 아니면 단순히 참여도만 세는지 따져본다 |
30분 안에 실험해보기
- 입력: 공통 메커니즘이 있을 것 같은 활동 두 가지
- 출력: 메커니즘을 한 문장으로 정리한 것과, 시도 전·후의 숫자 두 개(몇 번 만에 성공했는지)
- 불변 조건: '시도 후' 테스트는 연습했던 동작이 아니라, 한 번도 해본 적 없는 새로운 동작으로만 한다
- 중단 규칙: 세 가지 서로 다른 새로운 동작에서 모두 변화가 없다면, 그 메커니즘은 핵심이 아니다. 다시 놀이로 돌아가라.
- 최소 기록:
mechanism, move_before, tries_before, move_after, tries_after, date. - 의도적 생략: 비교 집단. 메커니즘을 명확히 말하지 않고 연습하는 친구를 추가하면, 제대로 된 실험이 된다.
5S 자기평가 — 근거와 함께
| S | 자기평가 | 근거 |
|---|---|---|
| 단순함 | 4/5 | 한 장의 그림 — 대련실 — 표에서 1:1로 대응되고, 한 문장으로 요약되는 5단계 순환: 놀이는 메커니즘을 찾고, 엔지니어링은 그것을 두 번째 사례에 시험한다. |
| 견고함 | 4/5 | 모든 수치는 FETCHED 행에서만 가져온다 content/series/play-engineering/evidence.yml (e.g. g = 0.24); 근거 없는 80% 주장은 폐기 및 게이트 처리. |
| 예리함 | 4/5 | 저자 자신의 축구 경험을 근거리 전이로 재해석; 원거리 전이는 0.03 SD (Sala & Gobet). |
| SMART | 4/5 | 30일 미션: 전/후 수치와 10명 독자 결과(시리즈 목표), 카운트는 scripts/play-missions.mjs. |
| 슈퍼-재미 | 4/5 | 아이도 할 수 있는 미션과 겸손한 시작 이야기 — 참고 다섯 번의 왜: "근거리 전이, 원거리 전이의 옷을 입다." |
참고문헌
- Skene et al. (2022), Child Development 93, 1162–1180 — 가이드 놀이와 직접 지도, 자유 놀이의 효과 비교 (메타분석, 1–8세 대상).
- Güllich, Macnamara & Hambrick (2022), Perspectives on Psychological Science — 다종목 청소년 훈련, 전문화 시기, 그리고 청소년 주도 놀이.
- Sala & Gobet (2017), Current Directions in Psychological Science — 적극적 통제 조건에서의 원거리 전이 효과.
- Goldin-Meadow, Cook & Mitchell (2009), Psychological Science 20(3), 267–272 — 제스처와 수학 학습의 관계.
- Pashler, McDaniel, Rohrer & Bjork (2008), Psychological Science in the Public Interest — 학습 스타일: 개념과 근거.
- Lynch et al. (2019), CoRL — 놀이 기반 잠재 계획 학습(Learning Latent Plans from Play).
- Hughes et al. (2024), ICML — 개방형 탐색(open-endedness)과 초인공지능.
- Weisberg, Hirsh-Pasek, Golinkoff, Kittredge & Klahr (2016), "Guided Play: Principles and Practices", Current Directions in Psychological Science 25(3) — 설명만 있고 직접 인용은 아님.
관련
content/series/play-engineering/evidence.yml에서 확인할 수 있다. 이야기들은 모두 내 경험담이며, 각기 스토리로 명시했다.