AI-NATIVE 系列 · 目的地,不只是工具箱 · 第 2/3 集 · 原则 2
跨尺度 OEC:代码库与团队如何无需提醒也能持续进化
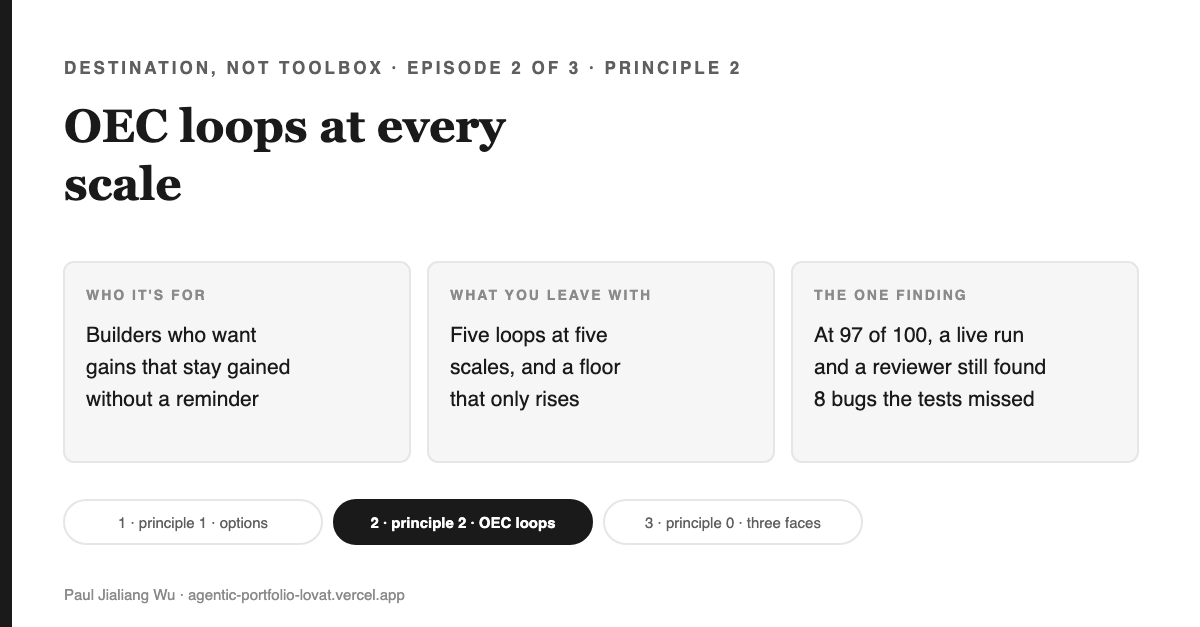
1 分钟速览
这是什么 这是一篇写给一线建设者的随笔,也是一次关于 OEC 循环(观察、评估、控制)的演练场。为什么同样的循环要在每个时间尺度上都跑一遍?从秒、分钟、pull request、一周到一个月,这个代码库曾把自己从 65 分打到 97 分,自动拒绝回退,但依然需要线上实测和外部评审来发现测试遗漏,修复后才到 98 分。
为什么重要 大多数改进之所以会消退,是因为太依赖人去记住。只有那种能观察、提前设定标准、并主动采取行动的循环(不管是出错后的 feedback,还是出错前的 feedforward),才能让进步不靠提醒也能持续。团队和产品的“掉链子”方式和代码库如出一辙,所以这些循环同样适用。
读完后你能做什么 选一个你手头的系统。按五个时间尺度(从秒到一个月),各写出一个循环,再写一个带日期的前馈 tripwire,然后去 Playground(演练场,下文简称 Playground)试试,能不能让一个变更悄悄溜过质量底线。
Destination, Not Toolbox — 系列脉络
▶ 看它实际运行:打开在线演示 公开 · 无需登录
- 智能体化软件给你的是选项,而不是工具 第 1 集
- OEC 循环,层层递进 本集
- 真理、爱与美:同一系统 第 3 集
核心问题:系统上线后,没人记得去改进,它还能怎么持续变好?
本文不会解释这个系统的用途,也不会讨论为什么它的核心是人的选择——这些内容请见 第 1 部分。至于“真理、善意与美”如何在这些循环中彼此守护,详见 第 3 部分.
这篇文章讲什么:OEC 循环,以及为什么一个循环永远不够
这是一篇关于 OEC 循环(观察、评估、控制)的文章。讨论的是:系统上线后,如何在没人需要记得去改进它的情况下,依然持续变好。写给那些眼见干净代码库、好团队习惯或精心计划在短短一个月内就开始变味的建设者。你只需要一个浏览器、一支笔,和四十分钟左右的空档。
故事依然来自同一个代码库,见 第 1 部分:一个为小型创始团队自托管的办公系统,完全用代码驱动。九月时它还只是个空文件夹,后来变成了能自我评分的系统。第一天自评分 65/100,第二天 91。到十月底已经 97,并且一路上自己挡住了回退。但上线实测和外部审阅者还是找出了 8 个所有测试都漏掉的 bug;修完这些,分数升到 98。故事的两半都是教训。
本文背后的原则,是本系列的第二条,我称之为 跨尺度、跨维度 OEC。在所有尺度(秒、分、天、周、月;一行代码、一个团队、一个预算)和所有你能度量的维度(一个数字、一条时间线、一张表格、一个结构,甚至循环自身的嵌套)上,同时进行观察、评估和控制。单一尺度的循环只是记分牌;把循环叠起来,系统才能自我修正。
第 3 部分,真理、关爱与美感:一体的控制系统,探讨是什么让所有这些循环保持真实可信,并用一个系统串联起本系列的三条原则。
第 1 部分的烹饪阶梯也贯穿本篇,因为它天然就是一个多尺度的例子。厨房每个层级都在执行同样的三步流程,只是各自的节奏不同。
| 厨房层级 | 观察 | 对照标准 | 控制 |
|---|---|---|---|
| 厨师,秒级 | 尝一口勺里的菜 | 菜谱 | 立刻加盐 |
| 传菜口,分钟级 | 看一眼盘子 | 本店标准 | 退回重做 |
| 主厨,新菜品 | 冷静地从外部品尝 | 菜单承诺的味道 | 上桌前就改菜 |
| 每周菜单例会 | 卖了什么,退了什么 | 上周的目标 | 下周改一个 |
| 连锁,一季度 | 每家餐厅的运营数据 | 提前设定的各项指标 | 调整整体策略 |
请先停一下。你最终要帮一位同事,为他们手头的某个系统,画出一张五层级循环表。请带着“我要用一支笔讲明白 feedback 和 feedforward 区别”的心态来读。元分析显示,39项研究中,带着“要教别人”预期去学习再讲解,得分提升 g = 0.48(某子组结果);而没有这种预期的讲解则没有显著提升(g = −0.02) (Kobayashi(2024),Educational Psychology Review(ERIC EJ1414484)).
活动 1 · 用手掌平衡一支笔
站起来,把一支笔或铅笔竖直放在张开的手掌上,平衡十秒。然后再试一次,这次边慢慢走动边平衡它。
继续往下读前,先写下两点:你的眼睛在看什么?你的手是什么时候动的?开始走路后,又发生了什么变化?
站着不动时,你盯着笔尖,等笔开始倾斜才动手,这就是 feedback:必须先出错才会纠正。走路时,你大概率会提前把手往前,因为你知道自己要动了,这就是 feedforward:在错误发生前,基于计划或已知干扰提前行动。控制工程师一句话就能概括这两种方式。Åström 和 Murray 写道:“Feedback is reactive: there must be an error before corrective actions are taken.(反馈是被动的:必须先出现错误,才会采取纠正措施。)”并且描述了提前应对已知干扰的做法:“This way of controlling a system is called feedforward.(这种控制系统的方法叫前馈。)”Feedback is reactive: there must be an error before corrective actions are taken.(反馈是被动的:必须先出现错误,才会采取纠正措施。)”,并且描述了提前应对已知干扰的做法:“This way of controlling a system is called feedforward.(这种控制系统的方法叫前馈。)" (Åström & Murray(2020),Feedback Systems: An Introduction for Scientists and Engineers,第二版,v3.1.5,§1.2他们对两者取舍的结论,其实就是本文的缩影:“Experience indicates that it is often advantageous to combine feedback and feedforward(经验表明,将反馈与前馈结合往往更有优势。)”Experience indicates that it is often advantageous to combine feedback and feedforward(经验表明,将反馈与前馈结合往往更有优势。)" (Åström & Murray(2020),Feedback Systems,第二版,§1.2).
三个动词,最容易被漏掉的那个
一句话总结:OEC 循环在每个层级都做三件事——先观察测量,再用提前定好的标准评估,最后据此控制下一步行动。
一个OEC 循环 包含三个环节。观察:用你信得过的传感器测量当前状态。评估:和你事先定下的标准作比较。控制:根据差异采取行动。这个思路由来已久。Norbert Wiener 甚至以此为名,开创了一个全新领域,他在《1948: 控制论》的副标题里写道「Cybernetics, or control and communication in the animal and the machine(中译:控制论,或动物与机器中的控制与通信)" (Wiener (1948), Cybernetics: Or Control and Communication in the Animal and the Machine (Open Library work OL4307531W)).
实际工作中,最容易被忽略的就是第三步。我在早期的一篇文章里就写过,这也是我见过最常见的失败:「evaluation without a control hook is just a scoreboard(中译:没有控制动作的评估,只是个记分牌)" (Wu, P. J., The App That Audits Itself」。没人采取行动的看板只是观察没有控制;发现问题没人修的评审只是评估没有控制。两者看似有条理,实际什么都没变。
控制分两类,这两样你都得有。反馈:在出错后纠正。前馈:在错误发生前,基于计划主动出手,比如一条规则、一个限制,或者一条预设触发线,提前写好日期和触发动作。只有反馈总是慢半拍,只有前馈则对意外视而不见。
一个循环,五种时间刻度
同样的循环,在五个时间尺度下都在运行,每一环都被办公室代码库的某次失败亲自“教育”过。
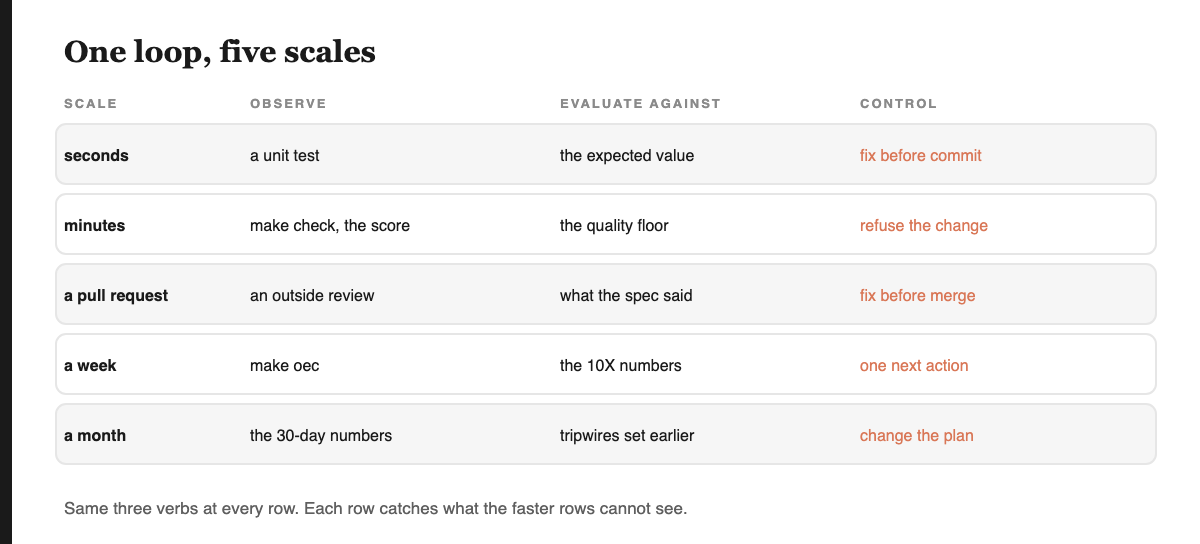
秒级:单元测试。 每个测试观测一个值,对照预期结果评估,并决定是否允许提交。这是最快的循环,也最容易被假象欺骗。这个代码库的测试用的是一个虚拟文件驱动,任何上传都能通过。而真实驱动会拒绝将文件保存到不存在的文件夹。所有离线测试全都通过了,第一次线上运行却直接翻车。快循环只能看到它的假传感器能看到的世界。
分钟级:棘轮。 每次变更都会运行一个命令,把代码(文档、函数体积、嵌套、类型、测试)量化成一个分数,然后和 ratchet(棘轮)对比:分数下限写在一个文件里,只能上调不能下调。低于下限的变更会被直接拒绝。每次真正提升后,下限会上调,想要下调则必须写明理由。在第一次运行时,棘轮就揪出了自己的四舍五入 bug、README 徽章与实际分数不符,以及实现每周循环的文件导致分数跌到 90。循环第一次跑就自己抓住了自己引入的回归。
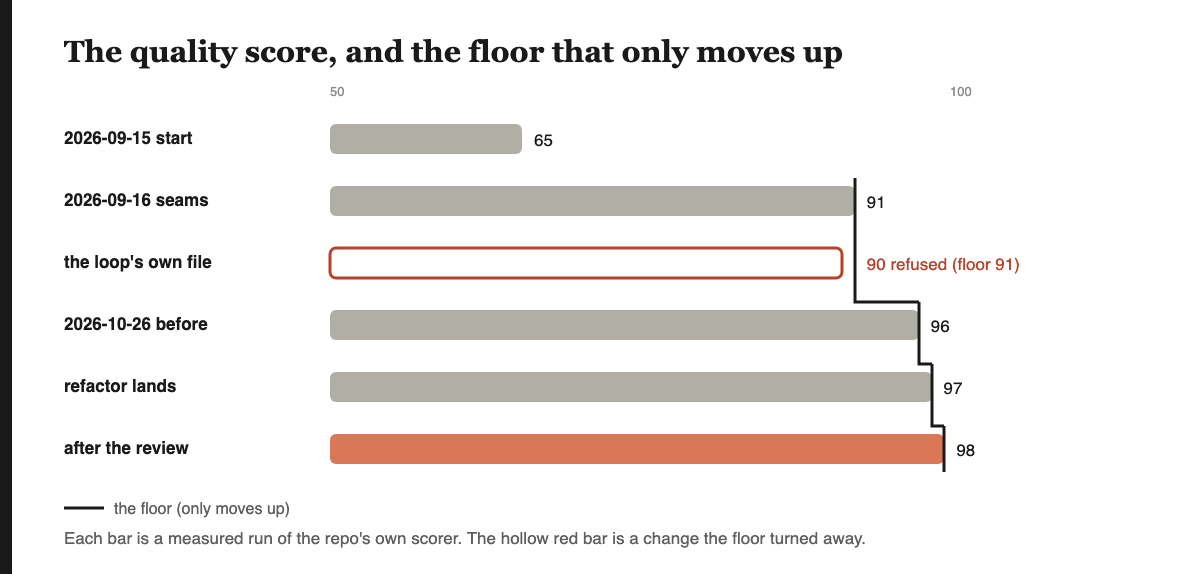
一次 pull request:外部审阅者。 十月重构合并前,另一个审阅者冷读了新代码,发现了测试漏掉的七个真 bug。最精彩的一个:同一个文件下方还藏着旧版函数,悄悄覆盖了上方修复后的版本。为这个 bug 新写的测试第一次就挂了,这才发现了重复定义。我的上一篇文章解释了为什么审阅者必须是别人:“a loop that scores its own work does not get better — it gets more confident.(中译:一个给自己打分的循环不会变得更好——只会更自信。)" (Wu, P. J., Loop Engineering Is a Referee).
周级:观测循环。 每周有一个命令观测所有关键点(闸门、下限、生成文档是否过期、外部是否能访问、最新备份的时间,以及现在还有多少决策等着人来拍板),并只输出一个下一步行动。如果连续三周都是同一个行动,它会提醒你。重复的行动不是待办,而是循环被卡住了。这个循环曾暴露过一个更隐蔽的失败:我用在代码智能体上的自我提升引擎,记录了 111 次运行,却没有一条经验被提升进常驻记忆。它只是在记录,没有产生复利。
月级:触发线。 十月重构上线时就设好了带日期的触发线。如果到 11 月 9 日还没有决策通过新循环,说明决策速度根本不是瓶颈,我会先问团队再决定要不要继续开发。如果十次决策后,人类只同意机器首选不到三分之一,说明目标本身就有问题。这些触发线都是在还没有任何数据时就写下的——这才是关键。等看到结果再来定触发线,那只是事后诸葛亮。
活动 2 · 画出你的五个尺度
选一样你手头的东西:代码库、习惯、团队仪式、家庭预算。画一个五行表:秒、分、一次变更、一周、一个月。每行写下你观测什么、和什么对比、你会怎么做。
圈出每一个空着的“控制”单元格。每一个都是假装成循环的记分板。
大多数人会发现两类空白。慢行的格子没人负责所以空着;快行的没有外部视角,因为作者自己就是审阅者。每类只补一个格子,往往比加第六个指标更有用。
多维度:从一个数到分形
尺度决定你多久看一次;维度决定你看的是什么形状——一个点、一条线、一张表、一张连线图,或者循环本身。只测一种形状的系统,盲区正好就是其他形状的总和。
| 维度 | 观测对象 | 在这个代码库里 | 单独看会遗漏什么 |
|---|---|---|---|
| 0 维:一个点 | 单一数值 | 质量分数 98 | 分数是怎么来的 |
| 1 维:一条线 | 随时间变化的数值 | 每次打分的记录,按时间顺序排列 | 分数为何波动 |
| 2 维:一个平面 | 指标 × 项目的表格 | 得分卡:五项指标,每个失分项都点名 | 各部分之间的关联 |
| 3 维:结构 | 哪些部分可能依赖哪些 | 一个测试:只要核心模块导入了任何附加组件就会失败 | 结构如何演变 |
| 4 维:随时间变化的结构 | 结构在不同版本间的变化 | 这里还没测:还没有对比过不同版本的依赖关系图 | 版本间的缓慢漂移 |
| 分形 | 循环中嵌套的同一个循环 | test → check → review → week → month | 这一层没有具体内容;它本身就是整个循环栈。 |
最后一行名副其实。Benoit Mandelbrot 发现,海岸线的测量长度取决于你用多长的尺子,他那篇论文的副标题正是「Statistical Self-Similarity and Fractional Dimension(中译:统计自相似性与分数维)" (Mandelbrot (1967), How Long Is the Coast of Britain? Statistical Self-Similarity and Fractional Dimension, Science 156(3775), 636-638」。系统的质量也是如此。用一秒的“尺子”(比如单元测试)去量,看起来一切平滑无瑕;但用实机运行或让外部读者来检验,就会冒出短尺子根本看不到的新细节。这些循环本身就是自相似的:每个尺度都在重复同样的三个动作。这正是循环栈能起作用的原因——每一层都能发现更快那层太细、太容易被蒙蔽而漏掉的问题。
每个度量都暗藏陷阱
循环的诚实程度取决于它的传感器,而一旦度量变成目标,它就不再是好传感器了。最常被引用的说法来自 Marilyn Strathern,1997 年:「When a measure becomes a target, it ceases to be a good measure.(中译:一旦度量变成目标,它就不再是好度量。)" (Strathern (1997), 'Improving ratings': audit in the British University system, European Review 5(3), 305-321, as quoted by Wikipedia, Goodhart's law」。Goodhart 1975 年的原话谈的是经济统计:「Any observed statistical regularity will tend to collapse once pressure is placed upon it for control purposes.(中译:一旦某个统计规律被用来控制,它就会趋于失效。)" (Goodhart (1975), Problems of Monetary Management: The U.K. Experience, as quoted by Wikipedia, Goodhart's law」。Strathern 的摘要还补了一句更尖锐的警告:「audit does more than monitor—it has a life of its own that jeopardizes the life it audits.(中译:审计不仅仅是监控——它有自己的生命,会威胁到被审计对象的生命。)" (Strathern (1997), European Review 5(3), 305-321).
这个代码库里的棘轮机制就有这样的软肋,而且它在自己的得分卡上也坦白了。它的“tested”数值是测试函数数除以生产函数数,这并不等于覆盖率。随便写四个无关痛痒的测试也能把分数抬高。把这个漏洞直接写在页面上,是我能想到的最低成本防御:一个虚高的闸门比没有闸门更糟,因为它带来的是假信心。
另一种极端是:有个闸门从没人见过它真正触发。我在 andon cord 那篇文章里说得很直白:「a gate that has never fired is indistinguishable from a gate that cannot fire(中译:一个从未触发过的闸门,和一个根本无法触发的闸门没有区别。)" (Wu, P. J., ANDON: Pull the Cord」。丰田的做法是实物:在生产线上,「the operator can stop the line by pulling the stop cord themselves(中译:操作员可以自己拉停绳让产线停下来。)" (Toyota Motor Corporation, Toyota Production System (global.toyota)」。只有循环第一次真的拦下问题,才开始赢得信任。这个代码库里的每个闸门都有测试,专门喂给它一个预埋的违规,确保它能如预期地失败。
活动 3 · 写一个触发线(tripwire)
针对你在活动 2 画出的系统,严格按照这个格式写一个触发线:「如果 [指标] 在 [日期] 前 [高于/低于] [数值],那么我将 [行动]。」
再写下一条观察,能直接推翻这个触发线本身。
这个格式强制你用上三个动词:指标是观察,数值和日期是提前定下的标准,行动就是控制。第二句话是循环套循环:一个你完全想不到会错的触发线,其实只是信念,不是控制。
活动 4 · 试试能不能绕过底线
打开Destination Playground(演练场)的第 5 节。先提交一个 92 分的变更,再把底线抬高。现在试着提交一个 70 分的。
找找有没有“降低底线”的按钮。继续往下读前,先猜猜为什么没有。
没有“降低底线”的按钮,这是故意设计的。在真实代码库里,确实可以降底线,但那得你手动改文件,还要写一条决策说明理由。这个操作门槛,就是棘轮机制里 feedforward 的一半:提前约定,红色构建只能靠修代码解决,而不是降标准。演练场里唯一真实的是规则,分数都是虚构的。
同一个故事,五种出路
| 你的身份是…… | 这会改变你做的决定 | 本周你要做的一件事 |
|---|---|---|
| 学生 | 你怎么为重要的事学习 | 在已有的反馈(批改作业)之外,加一个 feedforward 规则(自测的日期) |
| 工程师 | 你的代码库缺了哪一环 | 在你的五层表里找到空着的控制格,把它补上 |
| 创始人 | 你怎么知道团队习惯还在坚持 | 在数据出来之前,先为本季度写好三个带日期的触发线 |
| 高管 | 一个仪表盘能不能算作一个循环 | 每看到一张图表,都要追问:它对应的行动是什么?由谁来执行? |
| 投资人 | 公司在演示之后,质量还能否持续保持? | 请对方拿出一个真正触发过的闸门,以及它实际拦下了什么 |
这篇文章里的真、善与美
- 真:分数来自仓库自身的测量,bug 是用实际测试查出来的,主指标的局限也在页面上坦白说明。
- 善:这里的每一个循环,都是为了让队友,或者凌晨两点还在加班的未来的我,不必靠记忆硬撑。闸门其实是体贴那个本该被怪罪“忘了”的人。
- 美:同一个三步循环,在每个尺度、每个维度上反复嵌套。要扩展一个新尺度,无需再发明新东西。
有一个视角是我自己的,我会特别标明。使徒保罗写给腓立比人的信最后有一句关于“观察什么”的劝勉:最后,弟兄们,凡是真实的,凡是可敬的,凡是公义的,凡是纯洁的,凡是可爱的,凡是有美名的,若有什么德行,若有什么称赞,这些事你们都要思念。" (腓立比书 4:8在我的信仰里,这就是人的 feedforward:提前决定你要关注什么,而不是等一天结束再被动接受。上面这些循环,即使没有这个信念也能成立。
那些似是而非的误区
- “多加几个指标就能多控一点。” 只是多了观察、没加控制步骤,本质上只是更大的记分牌。
- “测试能证明它没问题。” 测试只能证明它在假环境下没问题。用户级别的实地运行,是完全不同的传感器。
- “只升不降的底线会让人钻空子。” 的确可能。把分数看不到的地方点出来,再配一个外部审查者,才能让底线保持诚实。
- “OEC 循环就是为了不出错。”大致如此。不过,棘轮机制不仅能防止倒退,每次真正提升后还会主动抬高标准。所以,这套循环既能守住底线,也能把进步变成新常态。
那些我一直在用、但没起名字的原则
重读这个系列的早期文章时,我发现自己其实早就反复用过四条原则,只是一直没给它们命名。每一条,都是跨尺度 OEC 的一环。
- 写成文字的规则会慢慢失效;能真正让事情停下来的规则,才能长久生效。 "a rule in prose is enforced by whoever remembers it(中译:写成文字的规则,靠谁记得就由谁执行)" (Wu, P. J., ANDON: Rules as Data。这就是把控制步骤落到了现实里。
- 一个从未失败过的检查,其实什么都没说明。 "A smoke detector with a dead battery makes exactly the same sound as one that works(中译:电池没电的烟雾报警器,和正常工作的发出的声音一模一样)" (Wu, P. J., Silence Is Not a Status。这就是把观察这一步用在了传感器自身。
- 在你看结果之前,先想清楚:什么情况会让你改变主意。 这就是 feedforward(前馈),它能防止评估被事后诸葛亮带偏。
- 谁写的,就别自己打分。 这就是让外部视角来做评估。
现在轮到你教别人了
你的教回路。和同事一起花十五分钟,把笔递给他,一起做活动 1。然后帮他为自己负责的一件事填一张五层循环表(活动 2),再一起写一个带日期的 tripwire(活动 3)。如果他还没读 part 1,就从那里开始:循环得先有目标,才谈得上地板。
结果:你的同事能用一支笔、不看笔记,讲明白 feedback 和 feedforward,并且有一个带日期的 tripwire 写进了日历。把 tripwire(去掉隐私信息)发在本文评论区。
为什么重要:五问追根
问题:一个代码库自评分 97/100,所有测试全过,结果第一次线上跑几秒就暴露了一个 bug,合并前外部审查又找出七个。
- 为什么测试会漏掉这些问题? 测试用的是比真实环境更宽容的假驱动,还只验证了作者自己设想的那些可能出错的情形。
- 那为什么还能拿到 97 分? 得分只是单一尺度上的一个数字。它衡量的是代码的结构,评分表自己也明确指出测试指标并不等于覆盖率。
- 为什么慢循环能发现快循环看不到的东西? 真实运行和冷读者是两种不同的传感器,尺子也更长。Mandelbrot 的海岸线就是例子:换个尺度就能看到新的细节(Mandelbrot (1967), How Long Is the Coast of Britain? Statistical Self-Similarity and Fractional Dimension, Science 156(3775), 636-638).
- 为什么团队会跳过慢循环? 慢循环既费时,又需要多一个人,而且跳过时不会有任何红灯警告。漏掉一次评审,任何看板上都不会留下痕迹。
- 根本原因: 质量被当成了单一尺度下的属性,而不是每个层级都堆叠 observe-evaluate-control 循环,每层都用不同的传感器补足快循环看不到的盲区。解决办法就是这套堆叠,并且要在数据出来之前就写好 feedforward 的 tripwire。
实操:本周动手跑一遍
- 先读一遍 teach-ahead 的引导句。
- 站着、走路各平衡一次笔(活动 1,3 分钟)。
- 画出你的五层循环表,圈出所有空着的 control 单元格(活动 2,10 分钟)。
- 写一个带日期的 tripwire,再写一句能推翻它的观察(活动 3,5 分钟)。
- 去 Destination Playground 里试试能不能绕过质量底线(活动 4,5 分钟)。
- 教给一位同伴,并把 tripwire 发出来。
反馈:怎么判断你做对了
- 你的五层循环表每一行都有 control 单元格,且至少有一行是外部视角。
- 你手头的 gate 至少有一个在预埋问题上被实际触发过。
- 到了 tripwire 设定的日期,你要么按它说的做了,要么写下了为什么没做。
本方法看不到的:你的标准本身是否合适。循环只负责让系统守住标准,不负责选标准。这是第 1 部分(目标)和第 3 部分(标准如何自证)的主题。
前馈:触发线要现在就定好
- 如果某个指标在没人做任何调整时自己波动,要么删掉这个指标,要么补上控制环节。只会计分的看板只消耗注意力,毫无回报。
- 如果同一个下一步动作连续三周都出现,就要升级处理。这不是忘了,是卡住了。
- 如果你想为了让构建通过而降低底线,先把决策写下来。写不出来,就去修代码。
5S 自评
| S | 主张 | 证据 |
|---|---|---|
| 简明 | 正文难度不高于高三水平;全篇由一个三步循环贯穿。 | Flesch–Kincaid 等级:7.0(区间 ≤ 12),由以下工具重新计算:node scripts/check-numbers-four-ages.mjs --series agentic-collab |
| 扎实 | 控制理论观点来自教材;指标陷阱归功于原作者。 | "Experience indicates that it is often advantageous to combine feedback and feedforward(中译:经验表明,将反馈与前馈结合通常更有优势)" (Åström & Murray) |
| 犀利 | 每个尺度都能发现更快尺度看不到或被蒙蔽的细节。 | 五个尺度 · 多维度 |
| SMART | 本周行动:画一张五层循环表,写下一条带日期的触发线,再教会一位同伴。 | 执行 |
| 意外之喜 | 循环首次运行时,就自己揪出了因自身代码引发的回归问题。 | 棘轮机制 |
| 真 · 善 · 美 | 分数有据、弱点直陈;闸门是体贴的善意;同一个三步循环,贯穿每个尺度。 | 真、善与美 |
参考资料
- Åström, K. J. & Murray, R. M. Feedback Systems: An Introduction for Scientists and Engineers,第二版(电子版)版本 v3.1.5(2020-07-24)). caltech.edu
- Wiener, N. (1948). Cybernetics, or Control and Communication in the Animal and the Machine. Open Library
- Mandelbrot, B. (1967). How Long Is the Coast of Britain? Statistical Self-Similarity and Fractional Dimension. Science 156. Crossref
- Strathern, M. (1997). 'Improving ratings': audit in the British University system. European Review 5. OpenAlex
- Goodhart 定律,含 1975 年 Goodhart 原文及 Strathern 的表述。wikipedia.org
- Toyota. Toyota Production System. global.toyota
- Kobayashi, K. (2024). Interactive learning effects of preparing to teach and teaching. Educational Psychology Review. ERIC EJ1414484
- 腓立比书 4:8,World English Bible。bible-api.com
- Wu, P. J. The App That Audits Itself. agentic-portfolio
- Wu, P. J. Loop Engineering Is a Referee. agentic-portfolio
- Wu, P. J. ANDON: Pull the Cord. agentic-portfolio
- Wu, P. J. ANDON: Rules as Data. agentic-portfolio
- Wu, P. J. Silence Is Not a Status. agentic-portfolio
- Destination Playground(本系列的在线演练场,首次出现时译为“演练场”,下文直接用英文)。agentic-portfolio