AI-NATIVE 시리즈 · DESTINATION, NOT TOOLBOX, 3부작 중 2화 · 원칙 2
OEC 루프, 모든 크기에서: 코드베이스(그리고 팀)는 어떻게 아무도 챙기지 않아도 계속 나아질 수 있을까
1분 요약
이 글은 무엇인가 OEC 루프(관찰, 평가, 제어)에 대해 다루는 에세이이자, 빌더를 위한 플레이그라운드다. 왜 이 순환이 초, 분, 풀 리퀘스트, 주, 월 등 모든 시간 단위에서 반복되어야 하는지 설명한다. 100점 만점에 65점에서 97점까지 점수를 올리고, 스스로 회귀를 거부한 코드베이스에 기반했다. 하지만 테스트만으로는 잡히지 않는 문제를 실제 실행과 외부 리뷰어가 찾아냈고, 그걸 고쳐 98점에 도달했다.
왜 중요한가 대부분의 개선은 누군가가 기억해내야만 유지된다. 미리 정한 기준에 따라 관찰하고 평가하며, (오류 뒤 피드백이든, 오류 전에 미리 대비하는 피드포워드든) 직접 행동하는 루프만이 별도의 알림 없이도 개선을 지킨다. 팀과 제품 역시 코드베이스와 똑같은 방식으로 무너질 수 있으니, 같은 루프 구조가 그대로 적용된다.
읽고 나면 할 수 있는 일 자신이 책임지는 시스템 하나를 고른다. 초, 분, 변경 단위, 일주일, 한 달—이 다섯 가지 시간 단위마다 각각 어떤 루프가 도는지 적는다. 날짜가 명시된 feedforward 트립와이어를 하나 만들어보고, 플레이그라운드에서 품질 기준선을 슬쩍 넘겨보는 시도를 해본다.
Destination, Not Toolbox — 시리즈 줄기
▶ 실제로 돌아가는 모습 보기: 라이브 데모 열기 공개 · 로그인 불필요
- 에이전트형 소프트웨어는 도구가 아니라 선택지를 건넨다 1화
- OEC 루프는 모든 규모에서 반복된다 이번 화
- 진리, 사랑, 아름다움: 하나의 시스템 3화
단 하나의 질문: 시스템이 출시된 뒤에도 아무도 개선을 챙기지 않아도 계속 발전할 수 있는 비결은 무엇인가?
이 글은 시스템의 목적이나 그 중심이 왜 인간의 선택이어야 하는지 설명하지 않는다. 그 이야기는 part 1에 있다. 진리, 사랑, 아름다움이 이 루프 안에서 어떻게 서로를 살리는지는 part 3.
이 에세이의 주제: OEC 루프, 그리고 하나만으로는 결코 충분하지 않은 이유
이 글은 OEC 루프—관찰, 평가, 제어—에 관한 에세이다. 시스템이 출시된 뒤에도 누군가가 일부러 챙기지 않아도 계속 나아질 수 있는 구조에 대해 썼다. 한 달 만에 깔끔한 코드베이스, 좋은 팀 습관, 세심한 계획이 어떻게 흐트러지는지 지켜본 빌더를 위한 글이다. 브라우저와 펜, 그리고 40분 정도의 시간이 필요하다.
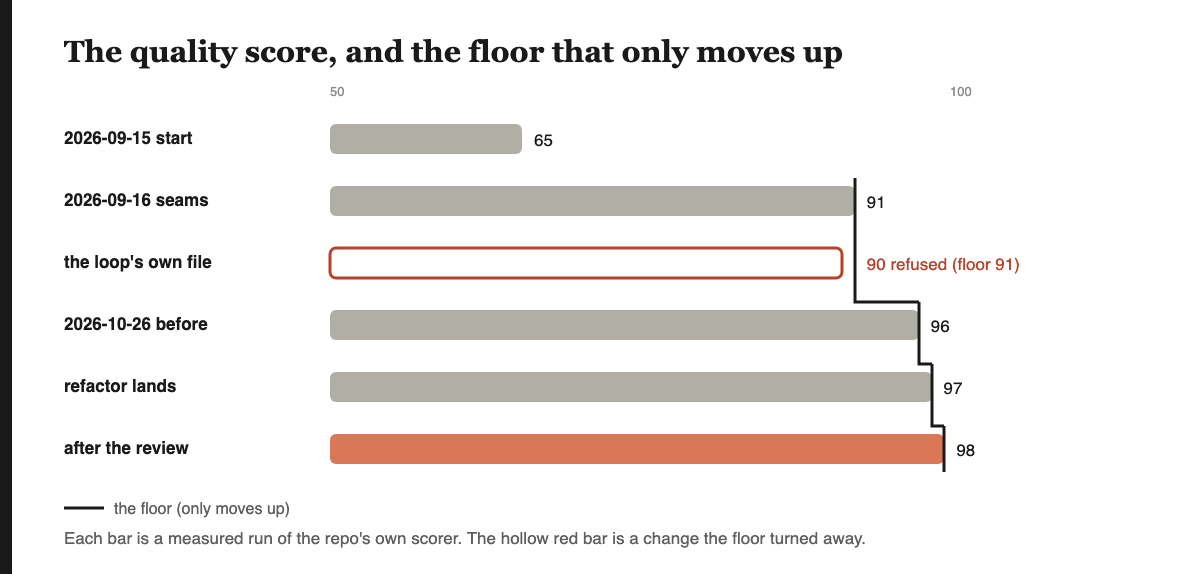
이야기는 part 1에서 다룬 것과 같은 코드베이스에서 나왔다. 소규모 창업팀이 코드로 운영한 자체 사무 시스템이다. 9월, 빈 폴더에서 시작해 스스로 점수를 매기는 시스템으로 진화했다. 첫날 자체 평가로 100점 만점에 65점, 다음 날엔 91점을 기록했다. 10월 말에는 97점까지 올랐고, 그 과정에서 스스로 회귀를 거부했다. 하지만 실제 실행과 외부 리뷰어가 모든 테스트가 놓친 버그 8개를 더 찾아냈고, 그걸 고치니 98점이 됐다. 이 두 과정 모두가 교훈이다.
이 에세이의 바탕이 되는 원칙은 시리즈의 두 번째로, 나는 이것을 cross-scale, cross-dimension OEC라 부른다. 관찰, 평가, 제어—이 세 단계를 초, 분, 일, 주, 월 같은 모든 시간 단위(코드 한 줄, 팀, 예산 등)와, 측정하는 모든 차원(단일 숫자, 시간의 흐름, 표, 구조, 그리고 그 안에 중첩된 루프)에서 동시에 반복한다. 한 단위에서 한 번만 도는 루프는 점수판에 불과하다. 여러 층의 루프가 쌓이면 스스로를 바로잡는 시스템이 된다.
3부 진리, 사랑, 아름다움은 하나의 제어 시스템이다에서는, 이 모든 루프가 어떻게 정직함을 유지하는지 질문하고, 시리즈의 세 가지 원칙을 하나의 시스템 안에서 다시 읽는다.
1부에서 다룬 '요리의 사다리' 역시 이 글의 흐름을 이끈다. 이미 시간의 여러 층위로 이루어진 사다리이기 때문이다. 주방의 각 단계마다 똑같은 세 가지 절차가 반복되지만, 적용되는 시간의 리듬만 다르다.
| 주방 단계 | 관찰 | 비교 기준 | 제어 |
|---|---|---|---|
| 요리사 – 초 단위 | 숟가락으로 맛을 본다 | 레시피 | 즉시 소금을 추가한다 |
| 패스(플레이팅) – 분 단위 | 접시를 눈으로 확인한다 | 매장 표준 | 다시 주방으로 돌려보낸다 |
| 헤드 셰프 – 신메뉴 | 식은 상태로, 외부 시선으로 맛을 본다 | 메뉴가 약속한 것 | 출시 전에 요리를 수정한다 |
| 주간 메뉴 회의 | 무엇이 팔렸고, 무엇이 반품됐는지 확인한다 | 지난주 목표 | 다음 주에 한 가지를 바꾼다 |
| 체인, 분기별 | 각 레스토랑의 수치 | 사전에 정한 한계 | 계획을 바꾼다 |
계속 읽기 전에 마지막에는 동료 한 명과 함께, 그 사람이 책임지는 무언가를 주제로 다섯 단계 루프 표를 만든다. 피드백과 피드포워드의 차이를 펜으로 설명해야 할 사람처럼 읽어야 한다. 39 메타분석에 따르면, '가르칠 준비를 한다'는 기대를 갖고 공부한 뒤 실제로 가르친 경우 g = 0.48 (하위 집단 결과), 반면 그런 기대 없이 가르친 경우에는 측정 가능한 이득이 없었다(g = −0.02) (Kobayashi (2024), Educational Psychology Review (ERIC EJ1414484)).
활동 1: 손바닥 위에 펜 세우기
일어서서 펜이나 연필을 손바닥 위에 곧게 세워 10초간 균형을 잡아본다. 그런 다음, 방을 천천히 걸으면서 다시 시도한다.
계속 읽기 전에 두 가지를 적는다. 내 눈은 무엇을 주시했고, 손은 언제 움직였는가? 그리고 걷기 시작했을 때 무엇이 달라졌는가?
가만히 서 있을 때는 펜 끝을 바라보다가, 펜이 기울기 시작한 뒤에 손을 움직였을 것이다. 이것이 피드백이다: 오류가 발생한 뒤에야 수정이 이뤄진다. 걷기 시작하면, 아마 펜이 기울기도 전에 손을 앞으로 내밀었을 것이다. 곧 움직일 것을 미리 알았기 때문이다. 이것이 피드포워드다: 오류가 나타나기 전에, 미리 세운 계획이나 이미 예측된 교란에 따라 선제적으로 행동하는 것이다. 제어공학자들은 이 둘을 한 문장으로 정리한다. Åström과 Murray는 "Feedback is reactive: there must be an error before corrective actions are taken."(번역: 피드백은 반응적이다. 수정 조치가 취해지려면 반드시 오류가 있어야 한다)라고 썼고, 미리 예측된 교란에 대한 선제적 행동을 이렇게 설명한다: "Feedback is reactive: there must be an error before corrective actions are taken.(번역: 피드백은 반응적이다. 수정 조치가 취해지려면 반드시 오류가 있어야 한다)" 그리고 미리 예측된 교란에 대해 선제적으로 행동하는 것을 이렇게 설명한다: "This way of controlling a system is called feedforward.(번역: 이런 방식의 시스템 제어를 피드포워드라고 부른다)" (Åström & Murray (2020), Feedback Systems: An Introduction for Scientists and Engineers, 2nd ed., v3.1.5, §1.2) 이 중 무엇을 쓸지에 대한 그들의 결론은 이 에세이 전체의 축약판이다: "Experience indicates that it is often advantageous to combine feedback and feedforward(번역: 경험적으로 피드백과 피드포워드를 결합하는 것이 종종 유리하다는 것이 드러난다)" (Åström & Murray (2020), Feedback Systems, 2nd ed., §1.2).
세 가지 동사, 그리고 자주 빠뜨리는 하나
한 문장으로 요약하면, OEC 루프란 어떤 상태를 관찰하고, 미리 정한 기준에 따라 평가한 뒤, 모든 시간 단위에서 다음 행동을 제어하는 것이다.
OEC 루프란OEC 루프에는 세 단계가 있다. 관찰: 신뢰하는 센서로 상태를 측정한다. 평가: 미리 정해둔 기준과 비교한다. 제어: 그 차이에 따라 행동한다. 이 개념은 오래전부터 있었다. Norbert Wiener는 이 원리를 한 분야의 이름으로 삼았다. 바로 1948: 사이버네틱스이며, 부제는 "Cybernetics, or control and communication in the animal and the machine"(번역: 사이버네틱스, 즉 동물과 기계에서의 제어와 소통)" (Wiener (1948), Cybernetics: Or Control and Communication in the Animal and the Machine (Open Library work OL4307531W)).
실제로 가장 자주 빠지는 단계는 바로 이 세 번째다. 나는 이전 에세이에서 이렇게 썼다. 그리고 지금도 내가 가장 자주 목격하는 실패다: "evaluation without a control hook is just a scoreboard"(번역: 제어 고리가 없는 평가는 단순한 점수판일 뿐이다.evaluation without a control hook is just a scoreboard" (Wu, P. J., The App That Audits Itself). 아무도 행동하지 않는 대시보드는 관찰만 있고 제어가 없는 셈이다. 아무도 고치지 않는 문제를 찾아내는 리뷰 역시 평가만 있고 제어가 없는 것이다. 둘 다 겉으로는 규율처럼 보이지만, 실제로는 아무것도 바꾸지 못한다.
제어에는 두 가지 방식이 있고, 둘 다 필요하다. 피드백은 오류가 난 뒤에 바로잡는다. 피드포워드는 오류가 나기 전에 미리 세운 계획에 따라 움직인다. 즉, 미리 적어둔 규칙이나 한계, 혹은 트립와이어에 날짜와 실행할 행동을 명확히 써두는 것이다. 피드백만 있으면 항상 늦고, 피드포워드만 있으면 예상치 못한 상황에 무방비가 된다.
하나의 루프, 다섯 가지 시간 단위
아래는 동일한 루프가 다섯 가지 시간 단위에서 어떻게 작동하는지, 그리고 각각을 가르쳐준 오피스 코드베이스의 실패 사례다.
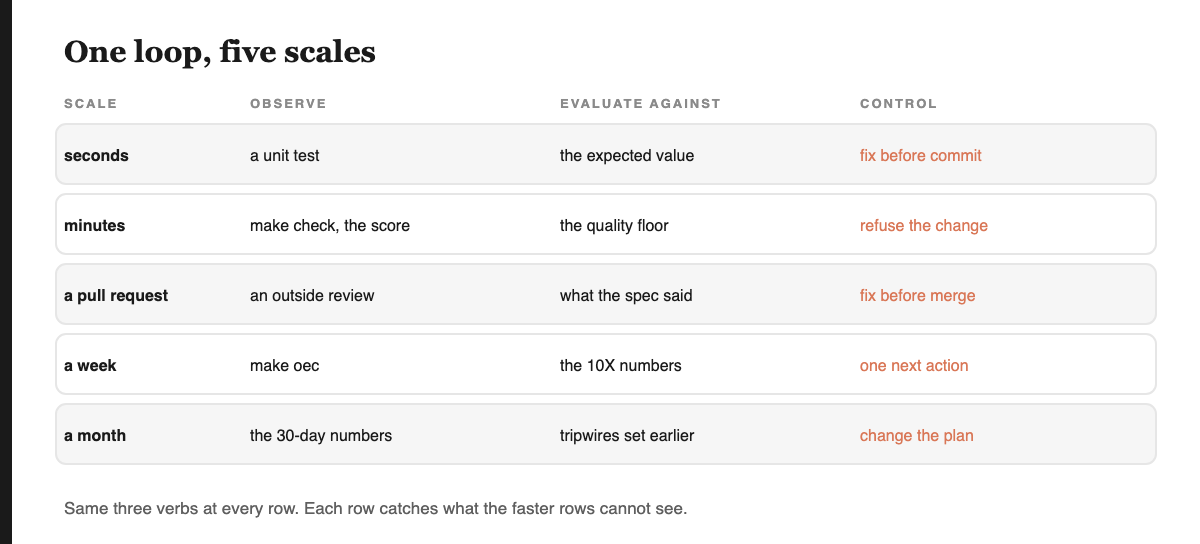
초 단위: 단위 테스트. 각 테스트는 값을 하나 측정해서, 미리 정한 기대값과 비교한 뒤, 기준에 어긋나면 커밋을 막는다. 가장 빠른 루프이지만, 가장 쉽게 속기도 한다. 이 코드베이스의 테스트는 아무 파일이나 받아주는 가짜 파일 드라이브를 썼다. 실제 드라이브는 존재하지 않는 폴더에는 저장을 거부한다. 오프라인 테스트는 전부 통과했지만, 첫 실제 실행에서는 실패했다. 빠른 루프는 자기 가짜가 보여주는 것만 본다.
분 단위: 래칫. 변경이 있을 때마다, 한 번의 명령으로 코드(문서화, 함수 크기, 중첩, 타입, 테스트 등)를 측정해 점수로 만들고, 그 점수를 ratchet과 비교한다. 이 ratchet은 파일에 저장된 기준선으로, 오직 위로만 올라간다. 기준선보다 낮은 변경은 거부된다. 실제로 점수가 오르면 기준선도 올리고, 내릴 때는 반드시 서면 결정을 남겨야 한다. 첫 세션에서 래칫은 자기 반올림 버그, 측정 점수와 달라진 README 배지, 그리고 주간 루프를 구현한 파일 때문에 90점으로 떨어진 상황을 모두 잡아냈다. 루프가 처음 실행됐을 때, 자기 코드가 만든 회귀를 스스로 보고했다.
풀 리퀘스트: 외부 리뷰어. 10월 리빌드가 머지되기 전, 별도의 리뷰어가 새 코드를 아무 정보 없이 처음부터 읽었다. 테스트가 놓친 진짜 버그 7개를 찾아냈다. 가장 인상 깊었던 것은, 함수의 옛 버전이 같은 파일 아래쪽에 여전히 남아 있어서, 위에서 고친 버전을 조용히 덮어쓰고 있었다는 점이다. 그 버그를 잡으려고 새로 쓴 테스트는 첫 실행에서 바로 실패했고, 그 덕분에 중복을 발견했다. 내가 예전 에세이에서 리뷰어는 반드시 다른 사람이어야 한다고 강조한 이유가 바로 이것이다: "a loop that scores its own work does not get better — it gets more confident."(번역: 자기 일을 점수 매기는 루프는 더 나아지지 않는다 — 더 자신감만 붙는다.)a loop that scores its own work does not get better — it gets more confident." (Wu, P. J., Loop Engineering Is a Referee).
일 단위(일주일): 관찰 루프. 일주일에 한 번, 한 명령으로 중요한 모든 항목을 점검한다(게이트, 기준선, 생성된 문서의 만료 여부, 외부에서 오피스 접근 가능성, 최신 백업의 나이, 그리고 이제는 인간 결정을 기다리는 항목 수까지) 그리고 정확히 하나의 다음 행동을 출력한다. 같은 행동이 3주 연속 반복되면, 그 사실을 알려준다. 반복되는 행동은 막힌 루프이지, 단순한 할 일 목록이 아니다. 이 루프는 한 번 조용한 실패도 드러냈다. 내가 코딩 에이전트와 함께 쓰는 자기개선 엔진이 111번 실행됐지만, 항상 켜진 메모리로 승격된 교훈은 0개였다. 기록만 하고, 누적은 없었다.
월 단위: 트립와이어. 10월 리빌드는 날짜가 명시된 트립와이어와 함께 배포됐다. 11월 9일까지 새 루프를 통과한 결정이 없다면, 결정 속도가 병목이 아니었으니 더 만들기 전에 팀에 묻는다. 10번의 결정 중 인간이 기계의 첫 번째 선택에 3분의 1 미만으로 동의한다면, 목표가 잘못 설정된 것이다. 이 기준들은 데이터가 생기기 전에 미리 작성된 것으로, 그게 핵심이다. 결과를 보고 나서 정하는 트립와이어는 합리화에 불과하다.
활동 2 · 다섯 단계 표 그리기
내가 관리하는 무언가(코드베이스, 습관, 팀의 의식, 가계부 등) 하나를 고른다. 다섯 줄짜리 표를 그린다: 초, 분, 변화, 주, 월. 각 줄마다 무엇을 관찰하고, 무엇과 비교하며, 그 결과로 무엇을 하는지 적는다.
비어 있는 모든 "control" 셀에 동그라미를 쳐라. 이 셀들은 루프인 척하는 점수판일 뿐이다.
대부분 두 가지 빈틈이 드러난다. 느린 줄은 아무도 책임지지 않아서 비어 있고, 빠른 줄은 작성자가 스스로 리뷰어라 외부의 시선이 없다. 각 유형에서 한 칸만 채워도, 여섯 번째 지표를 추가하는 것보다 효과가 크다.
차원: 숫자에서 프랙탈로
스케일은 얼마나 자주 들여다보는지, 차원은 무엇을 어떤 형태로 보는지다 — 점, 선, 표, 배선도, 혹은 루프 자체. 한 형태만 측정하는 시스템은 나머지 형태만큼의 맹점을 갖는다.
| 차원 | 관찰 대상 | 이 코드베이스에서 | 이 차원만 볼 때 놓치는 것 |
|---|---|---|---|
| 0차원: 점 | 단일 숫자 | 품질 점수 98 | 그 점수에 이르는 과정 |
| 1차원: 선 | 시간에 따라 변하는 숫자 | 각 실행의 점수, 시간 순서대로 | 왜 변화했는지 |
| 2차원: 평면 | 측정 항목 × 대상의 표 | 점수표: 다섯 지표, 각 위반자 이름까지 | 각 부분이 어떻게 연결되는지 |
| 3차원: 구조 | 어떤 부분이 무엇에 의존하는지 | 코어가 애드온을 임포트하면 실패하는 테스트 | 구조가 어떻게 바뀌는지 |
| 4차원: 시간 속의 구조 | 버전이 바뀔 때 구조가 어떻게 달라지는지 | 아직 여기선 측정하지 않음: 어떤 버전의 의존성 그래프도 이전 버전과 비교하지 않음 | 버전 사이에 천천히 쌓이는 변화 |
| 프랙탈 | 루프 안에 또 반복되는 같은 루프 | 테스트 → 체크 → 리뷰 → 주간 → 월간 | 이 단계에는 별도의 측정이 없다. 바로 이 계층 구조 자체가 그 역할을 한다. |
마지막 행이야말로 '프랙탈'이라는 이름에 걸맞다. Benoit Mandelbrot는 해안선의 길이가 자의 길이에 따라 달라진다는 사실을 보여주었고, 논문 부제에 이렇게 썼다: "Statistical Self-Similarity and Fractional Dimension" (번역: 통계적 자기유사성과 분수 차원)" (Mandelbrot (1967), How Long Is the Coast of Britain? Statistical Self-Similarity and Fractional Dimension, Science 156(3775), 636-638). 시스템의 품질도 이와 비슷하다. 1초짜리 자(유닛 테스트)로 재면 표면이 매끄럽게 보인다. 실제로 실행하거나 외부의 눈으로 보면, 짧은 자로는 보이지 않던 새로운 결함이 드러난다. 루프는 자기유사적이다. 모든 시간 단위마다 똑같은 세 동사가 반복된다. 이 구조 덕분에 계층이 제대로 작동한다. 각 단계는 더 빠른 단계가 너무 미세하거나 속아서 놓친 부분을 잡아낸다.
모든 측정에는 함정이 있다
루프의 정직함은 센서의 정직함에 달려 있다. 그리고 측정이 목표로 바뀌는 순간, 더 이상 좋은 센서가 아니다. 이 점을 가장 널리 알려진 표현으로 정리한 사람이 1997년의 Marilyn Strathern이다: "When a measure becomes a target, it ceases to be a good measure." (번역: 어떤 측정이 목표가 되는 순간, 그것은 더 이상 좋은 측정이 아니다.)" (Strathern (1997), 'Improving ratings': audit in the British University system, European Review 5(3), 305-321, as quoted by Wikipedia, Goodhart's law). Goodhart가 1975년에 경제 통계를 두고 남긴 원문은 이렇다: "Any observed statistical regularity will tend to collapse once pressure is placed upon it for control purposes." (번역: 관찰된 통계적 규칙성은 통제 목적으로 압박이 가해지는 순간 붕괴하는 경향이 있다.)" (Goodhart (1975), Problems of Monetary Management: The U.K. Experience, as quoted by Wikipedia, Goodhart's law). Strathern의 초록은 한층 더 날카롭게 경고한다: "audit does more than monitor—it has a life of its own that jeopardizes the life it audits." (번역: 감사는 단순히 감시하는 데 그치지 않는다—감사 자체가 생명을 얻어, 감시 대상의 생명을 위협한다.)" (Strathern (1997), European Review 5(3), 305-321).
이 코드베이스의 래칫도 바로 그 약점을 갖고 있고, 스코어카드에 그 사실을 적시한다. 여기서 '테스트됨' 숫자는 테스트 함수 개수를 프로덕션 함수 개수로 나눈 값이다. 커버리지는 아니다. 하찮은 테스트 네 개만 추가해도 이 수치는 올라간다. 페이지에 그 약점을 명시하는 것이 내가 아는 가장 저렴한 방어다. 과장된 게이트는 없는 것보다 더 나쁘다. 거짓된 확신을 사기 때문이다.
반대의 실패는, 아무도 작동하는 걸 본 적 없는 게이트다. 내가 안돈 코드에 대해 쓴 글에서 이렇게 말했다: "a gate that has never fired is indistinguishable from a gate that cannot fire" (번역: 한 번도 작동한 적 없는 게이트는 작동할 수 없는 게이트와 구별되지 않는다.)" (Wu, P. J., ANDON: Pull the Cord). Toyota의 방식은 실제 물리적 장치다. 생산 라인에서는 "the operator can stop the line by pulling the stop cord themselves" (번역: 작업자가 직접 정지 코드를 당겨 라인을 멈출 수 있다.)" (Toyota Motor Corporation, Toyota Production System (global.toyota)). 루프가 처음으로 무언가를 멈추는 순간, 비로소 신뢰를 얻는다. 이 코드베이스의 모든 게이트는 의도적으로 위반을 심어주고, 실패를 기대하는 테스트를 갖고 있다.
활동 3 · 트립와이어 하나 써보기
활동 2에서 그린 시스템에 대해, 다음 형식 그대로 트립와이어를 하나 적는다: "[측정값]이 [날짜]까지 [숫자]보다 [높/낮]으면, 나는 [조치]를 취한다."
그리고 그 트립와이어가 잘못됐다는 사실을 알려줄 단 하나의 관찰 항목을 적는다.
이 형식은 세 가지 동작(관찰, 기준, 제어)을 빠짐없이 쓰게 만든다. 측정값이 곧 관찰이고, 숫자와 날짜는 미리 정한 기준이며, 조치는 제어다. 두 번째 문장은 루프 위의 루프다. 절대 틀릴 리 없다고 여기는 트립와이어는 통제가 아니라 신념일 뿐이다.
활동 4 · 기준선을 몰래 넘어서기
섹션 5를 열고 Destination Playground에서 92점으로 변경을 반영한 뒤, 기준선을 올린다. 이제 70점으로 다시 반영을 시도해본다.
기준선을 내리는 버튼이 있는지 찾아본다. 왜 그 버튼이 없는지, 읽기 전에 스스로 예측해본다.
일부러 기준선을 내리는 버튼이 없다. 실제 코드베이스에서는 기준선을 내릴 수 있지만, 그럴 때는 파일을 직접 고치고, 그 이유를 기록으로 남겨야 한다. 이 불편함이 바로 래칫의 피드포워드 역할이다. 미리 정해둔 규칙에 따라, 빌드가 실패하면 기준선을 내리는 대신 코드를 고친다. 플레이그라운드에서 실제인 것은 규칙이고, 점수는 연출된 것이다.
같은 이야기, 다섯 갈래의 출구
| 당신의 역할은… | 이로 인해 달라지는 결정 | 이번 주에 할 한 가지 행동 |
|---|---|---|
| 학생 | 중요한 것을 공부하는 방식 | 피드백(채점된 과제)에, 스스로 시험을 보는 날짜처럼 피드포워드 규칙 하나를 추가한다 |
| 엔지니어 | 내 코드베이스에 비어 있는 루프는 무엇인가 | 다섯 단계 표에서 비어 있는 제어 셀을 찾아 채운다 |
| 창업자 | 팀의 습관이 제대로 유지되고 있는지 어떻게 확인할 것인가 | 이번 분기 숫자가 나오기 전에, 날짜가 적힌 트립와이어를 세 개 쓴다 |
| 임원 | 대시보드가 진짜 루프인지 | 각 차트마다 어떤 행동을 촉발하는지, 그리고 그 행동을 실제로 누가 하는지 반드시 물어본다. |
| 투자자 | 데모가 끝난 뒤에도 그 회사의 품질이 계속 유지될지 | 실제로 발동한 게이트가 있었는지, 그리고 그 게이트가 막아낸 것이 무엇이었는지 보여 달라고 요청한다. |
이 글에 담긴 진실, 사랑, 아름다움
- 진실: 점수는 레포지토리 자체의 측정값이고, 버그는 실제로 테스트를 통해 발견된 진짜 사례이며, 주요 지표의 약점 또한 페이지에 분명히 밝혀 두었다.
- 사랑: 여기서 말하는 모든 루프는 동료나, 새벽 두 시에 일하고 있을 미래의 나 자신이 일일이 기억하지 않아도 되도록 설계했다. 게이트란, 누군가가 잊었다고 비난받지 않게 미리 배려하는 친절이다.
- 아름다움: 세 단계로 이루어진 루프 하나가 모든 시간적·구조적 차원에 반복된다. 새로운 스케일을 추가하려고 억지로 뭔가를 발명할 필요가 없다.
내 관점도 하나 덧붙인다. 사도 바울이 빌립보서 마지막에서 관찰의 대상을 이렇게 정리했다: "끝으로, 형제들아, 무엇이든 참되고, 무엇이든 존귀하며, 무엇이든 옳고, 무엇이든 순결하며, 무엇이든 사랑받을 만하고, 무엇이든 칭찬받을 만한 것이 있으면, 덕이 있거나 칭찬할 만한 것이 있으면, 이런 것들을 생각하라."" (빌립보서 4:8 내 신앙에서는 이것이 한 사람을 위한 피드포워드다. 즉, 하루가 나를 휘두르기 전에 내가 무엇에 주의를 둘지 미리 정하는 것이다. 위에서 설명한 루프들은 이런 믿음이 없어도 충분히 작동한다.
절반만 맞는 흔한 오해들
- "지표가 많으면 통제가 더 잘된다." 통제 단계 없이 관찰만 늘어나면 점수판만 커질 뿐이다.
- "테스트가 통과하면 제대로 동작한다는 뜻이다." 테스트는 그 테스트가 사용하는 가짜 환경에서만 통과한다는 사실만 보여준다. 실제 사용자의 환경에서 라이브로 돌려보는 것은 완전히 다른 센서다.
- "바닥선이 오르기만 하면 사람들은 점수를 조작하게 된다." 그럴 수 있다. 점수가 감지하지 못하는 부분을 명확히 밝히고, 외부 리뷰어와 짝을 이루는 것이 바닥선을 정직하게 지키는 방법이다.
- "OEC 루프는 실패하지 않게 하려는 것이다." 대체로 그렇다. 하지만 래칫은 실제로 개선이 일어날 때마다 기준선을 올린다. 즉, 손실을 막는 루프가 동시에 성장을 고정하는 역할도 한다.
내가 이름 붙이지 않고 써온 원칙들
이 시리즈를 준비하며 예전 에세이들을 다시 읽다 보니, 내가 여러 번 실천했으면서도 이름 붙이지 않았던 네 가지 원칙이 있었다. 각각은 여러 층위에 걸친 OEC의 한 조각이다.
- 글로만 남은 규칙은 쉽게 사라진다. 실제로 무언가를 멈출 수 있는 규칙만이 오래간다. "a rule in prose is enforced by whoever remembers it (번역: 글로만 된 규칙은 기억하는 사람이 있을 때만 지켜진다)" (Wu, P. J., ANDON: Rules as Data)—이것이 바로 통제 단계를 물리적으로 구현한 예다.
- 한 번도 실패한 적 없는 체크는 아무것도 알려주지 않는다. "A smoke detector with a dead battery makes exactly the same sound as one that works (번역: 배터리가 방전된 화재 경보기는 정상 작동하는 것과 똑같은 소리를 낸다)" (Wu, P. J., Silence Is Not a Status)—이것이 바로 관찰 단계를 센서 자체에 적용한 것이다.
- 무엇이 내 생각을 바꿀지, 미리 정해둬라. 이것이 바로 피드포워드이며, 평가가 사후 합리화로 흐르는 것을 막아준다.
- 만든 사람이 직접 평가하지 않는다. 이것이 바로 외부의 시선으로 평가하는 단계다.
이제 직접 가르쳐라
당신의 teach-back. 15분 동안 팀원 한 명과 마주 앉아라. 펜을 건네고, 함께 활동 1을 해보라. 이어서 그가 맡은 무언가에 대해 다섯 단계 표(활동 2)를 같이 채우고, 날짜가 적힌 트립와이어(활동 3)도 함께 써보라. 만약 그가 part 1을(를) 읽지 않았다면, 거기서 시작하라. 루프에는 목적지가 먼저 필요하고, 그 다음에야 기준선이 필요하다.
결과: 당신의 팀원은 펜만으로 피드백과 피드포워드를 설명할 수 있고, 노트 없이도 날짜가 적힌 트립와이어를 자신의 캘린더에 남길 수 있다. 트립와이어(개인 정보는 빼고)를 이 글의 댓글로 남겨라.
왜 중요한가: 다섯 번의 왜
문제: 100점 만점에 97점을 받은 코드베이스가 모든 테스트를 통과했는데도, 첫 라이브 실행에서 몇 초 만에 버그가 드러났고, 머지 전 외부 리뷰어가 7개의 버그를 추가로 찾아냈다.
- 테스트가 왜 그 문제를 잡아내지 못했을까? 테스트는 실제보다 관대한 가짜 드라이브를 통해 코드를 살폈고, 저자가 상상한 문제 상황만을 기준 삼았다.
- 그런데도 어떻게 97점이라는 점수를 받았을까? 점수는 한 가지 척도의 단일 숫자다. 이 숫자는 코드의 형태만을 측정하며, 스스로의 스코어카드에도 테스트 지표가 커버리지가 아님을 밝히고 있다.
- 느린 루프들은 왜 빠른 루프가 놓친 것을 잡아냈을까? 라이브 실행과 외부 독자는 서로 다른 센서이고, 더 긴 자를 쓴다. Mandelbrot의 해안선이 바로 그 그림이다. 새로운 척도에서는 새로운 세부가 드러난다(Mandelbrot (1967), How Long Is the Coast of Britain? Statistical Self-Similarity and Fractional Dimension, Science 156(3775), 636-638).
- 팀들은 왜 느린 루프를 건너뛰는가? 느린 루프는 시간과 두 번째 사람을 필요로 하고, 건너뛰어도 어디에도 경고등이 켜지지 않는다. 리뷰를 생략해도 어떤 대시보드에도 흔적이 남지 않는다.
- 근본 원인: 품질을 하나의 척도에서 측정되는 속성으로만 여겼기 때문이다. 사실 품질은, 각 척도마다 센서가 다른 observe-evaluate-control 루프가 층층이 쌓인 구조여야 한다. 해법은, 데이터를 보기 전에 미리 써두는 feedforward 트립와이어와 함께 이 스택을 쌓는 것이다.
실행: 이번 주에 직접 해보라
- teach-ahead 문장을 읽는다.
- 펜을 세워두고, 그리고 걸으면서 균형을 잡아본다(활동 1, 3분).
- 다섯 단계 표를 그리고, 비어 있는 control 셀을 동그라미 친다(활동 2, 10분).
- 날짜가 있는 트립와이어 하나와, 그 트립와이어가 틀렸음을 보여줄 관찰 항목을 쓴다(활동 3, 5분).
- Destination Playground에서 바닥 점수를 몰래 넘겨본다Destination Playground (활동 4, 5분).
- 이 내용을 한 팀원에게 직접 가르치고, 트립와이어를 게시한다.
피드백: 제대로 했는지 확인하는 법
- 다섯 단계 표의 모든 행에 control 셀이 있고, 최소 한 행에는 외부의 시선이 있다.
- 내가 가진 게이트 중 적어도 하나는 심어둔 문제에서 실제로 작동(실패)한 적이 있다.
- 트립와이어에 적힌 날짜에, 그 지시대로 행동했거나, 왜 하지 않았는지 기록했다.
여기서 확인할 수 없는 것이 하나 있다. 바로 내 기준이 정말로 옳았는지다. 루프는 시스템을 정해진 기준에 맞춰 붙들어 둘 뿐, 그 기준 자체를 고르지는 않는다. 그건 1부(목적지)와 3부(기준의 정직함을 지키는 힘)의 역할이다.
피드포워드: 지금 결정하는 트립와이어
- 지표가 움직였는데 아무도 아무 변화도 주지 않았다면, 그 지표를 지우거나 제어 단계를 추가해야 한다. 점수판은 주의만 잡아먹고 아무것도 돌려주지 않는다.
- 만약 같은 다음 행동이 3주 연속 반복된다면, 그 문제를 한 단계 위로 올려야 한다. 그건 잊힌 게 아니라 막힌 것이다.
- 빌드를 통과시키려고 기준선을 내리고 싶다면, 먼저 그 결정을 글로 남겨라. 만약 그 결정을 쓸 수 없다면, 코드를 고쳐라.
5S 자기평가
| S | 주장 | 근거 |
|---|---|---|
| 단순함 | 이 글의 문장은 고등학교 3학년 수준이나 그 이하로 읽히며, 세 단계로 이루어진 하나의 루프가 전체 에세이를 관통한다. | Flesch–Kincaid 등급: 7.0 (밴드 ≤ 12), 재계산: node scripts/check-numbers-four-ages.mjs --series agentic-collab |
| 견고함 | 컨트롤 이론에 관한 주장은 교과서에서 가져왔고, 측정의 함정은 그 진짜 저자를 드러낸다. | "Experience indicates that it is often advantageous to combine feedback and feedforward (번역: 경험적으로 피드백과 피드포워드를 결합하는 것이 종종 유리하다는 것이 드러난다.)" (Åström & Murray) |
| 예리함 | 각 시간 단위의 계층은 더 빠른 계층이 너무 미세하거나 속아서 놓치는 것을 잡아낸다. | 다섯 단계 · 차원 |
| SMART | 이번 주의 목표: 다섯 단계 표 하나, 날짜가 명시된 트립와이어 하나, 그리고 동료 한 명에게 직접 가르치기. | 실행하기 |
| 예상 밖의 발견 | 이 루프가 처음 돌았을 때, 바로 그 루프의 코드가 만든 회귀를 스스로 찾아냈다. | 래칫 |
| 진실 · 사랑 · 아름다움 | 약점까지 드러낸 측정 점수, 친절함으로 작동하는 게이트, 그리고 모든 규모에 반복되는 단 하나의 루프. | 진실, 사랑, 아름다움 |
참고문헌
- Åström, K. J. & Murray, R. M. Feedback Systems: An Introduction for Scientists and Engineers, 2판 (전자판 버전 v3.1.5 (2020-07-24)). caltech.edu
- Wiener, N. (1948). Cybernetics, or Control and Communication in the Animal and the Machine. Open Library
- Mandelbrot, B. (1967). How Long Is the Coast of Britain? Statistical Self-Similarity and Fractional Dimension. Science 156. Crossref
- Strathern, M. (1997). 'Improving ratings': audit in the British University system. European Review 5. OpenAlex
- Goodhart's law, with Goodhart's 1975 wording and Strathern's phrasing. wikipedia.org
- Toyota. Toyota Production System. global.toyota
- Kobayashi, K. (2024). Interactive learning effects of preparing to teach and teaching. Educational Psychology Review. ERIC EJ1414484
- 마지막으로, 형제들이여, 무엇이든 참된 것, 무엇이든 존귀한 것, 무엇이든 옳은 것, 무엇이든 순결한 것, 무엇이든 사랑스러운 것, 무엇이든 칭찬할 만한 것, 덕이 있거나 칭찬받을 만한 것이 있으면 이런 것들을 생각하라." — 빌립보서 4:8bible-api.com
- Wu, P. J. The App That Audits Itself. agentic-portfolio
- Wu, P. J. Loop Engineering Is a Referee. agentic-portfolio
- Wu, P. J. ANDON: Pull the Cord. agentic-portfolio
- Wu, P. J. ANDON: Rules as Data. agentic-portfolio
- Wu, P. J. Silence Is Not a Status. agentic-portfolio
- Destination Playground(이 시리즈의 실시간 데모). agentic-portfolio