AIネイティブ・シリーズ · エージェント型AIにおける人間のダイナミクス、第2回/全4回
ゆっくりとしか変わらないベストプラクティス:今日、エージェントと働くということ
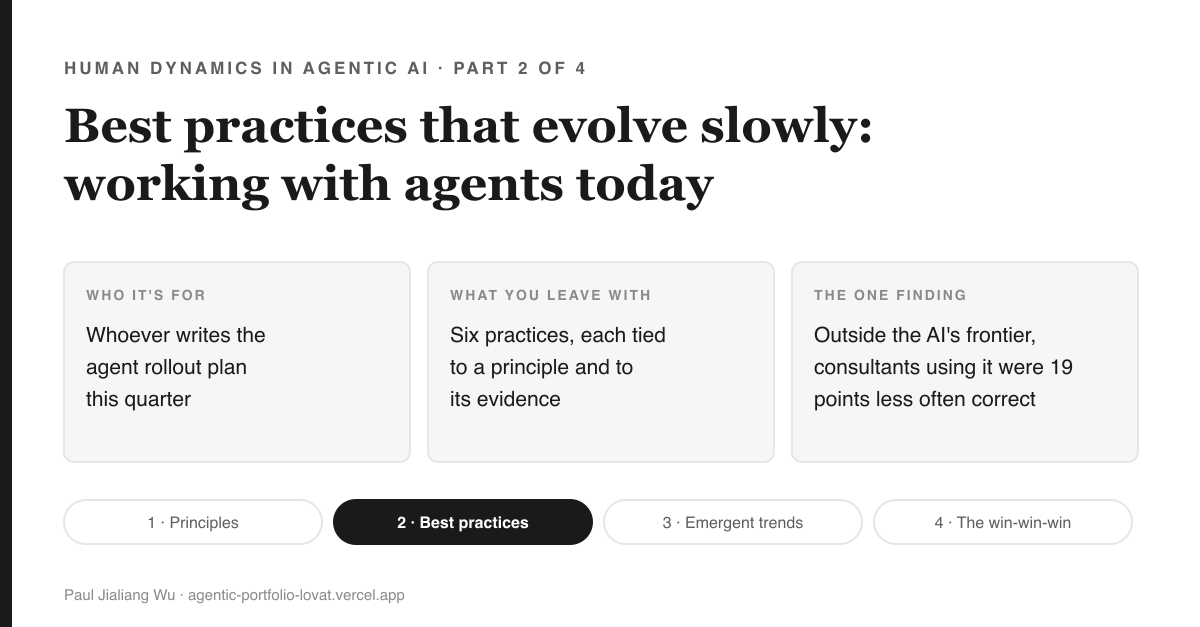
1分でわかる要点
これは何か。シリーズ第2回:AIエージェントと働く人々のための6つの実践。それぞれが、第1回で示した原則とその根拠、Anthropic・OpenAIからNIST、EU AI Act、そしてフィールド実験までに結びついている。
なぜ重要か。あるタスクではコンサルタントの出力品質を40%以上も押し上げた同じAIツールが、そのフロンティアのすぐ外側にあるタスクでは、正答率を19ポイントも下げた。自分がどちら側にいるのかを知ること——それが、ここで覚えておくべき実践だ。
読んだ後にできること。 自分のエージェントが取りうる行動をすべて洗い出し、それぞれ可逆か不可逆かを印づけ、人の目を通さずに実行される不可逆な行動がいくつあるか数えてみよう。その数がゼロでなければ、それが今週直すべきことだ。
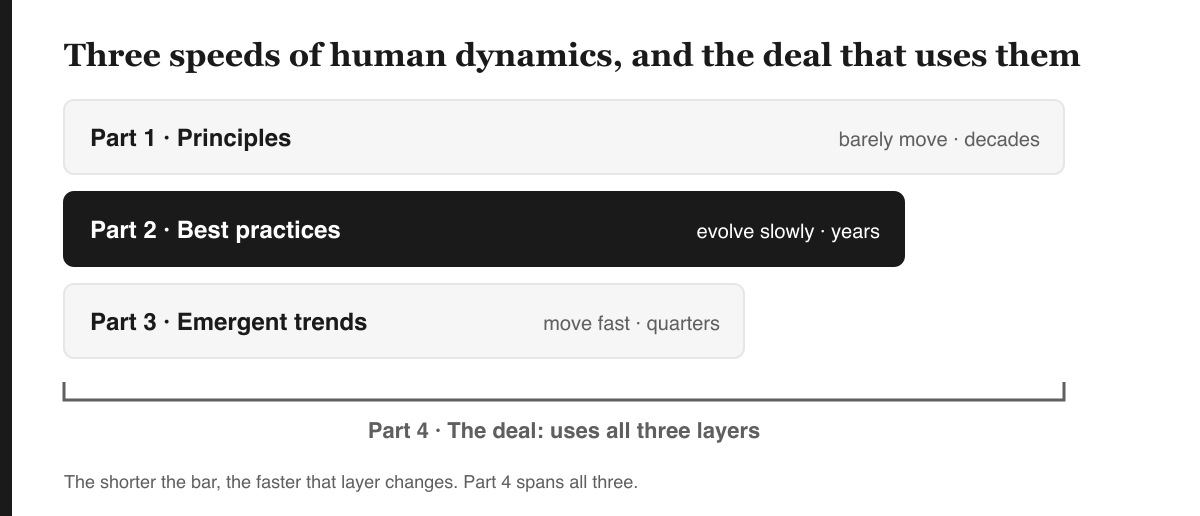
Human Dynamics in Agentic AI — シリーズの背骨
- ほとんど動かない原則 第1話
- ゆっくり進化するベストプラクティス この回
- 速く動く新興トレンド 第3話
- 近日公開 第4話
ラベルの読み方: EVIDENCE は出典あり、 DESIGN は実践の設計方法、 OPEN はまだ検証されていないもの、そして LENS は私自身の見解を指す。
あなたはエージェントを人のそばで働かせようとしている。ラボ、規制当局、そしてフィールド実験から得られた六つの実践が、第1部の原則を今期のルールへと変換する。意外なのは、AIのフロンティアがジャギー(jagged、ギザギザ)だということだ。あるタスクでコンサルタントを40%向上させる同じツールが、次のタスクでは彼らを悪化させてしまう。シンプルに始め、不可逆な行動にはゲートをかけ、自分がフロンティアのどちら側にいるのかを知ることだ。
今回のエピソードの内容:AIエージェントと働く人のためのベストプラクティス
第1部ではほとんど動かない六つの原則を挙げた。この層は動くが、ゆっくりとだ。展開を重ねる中で何年もかけて定着し、おそらくあと数年は持ちこたえるであろう実践である。これは展開計画を書く人のためのものだ——何を、どの順序で行うべきか、そして各ステップの背後にある根拠が実際に何を語っているのか。
まず賭けてみる
2023年のフィールド実験では、トップ戦略ファームのコンサルタント758人が、GPT-4を使う場合と使わない場合とで現実的なタスクに取り組んだ。意図的にAIが得意とする範囲のすぐ外側に設定されたタスクでは、AIを使ったコンサルタントは——
- A. 使わなかった場合とほぼ同程度の正確さだった。
- B. やや正確さが増した。
- C. 正確さが大きく低下した。
実践1:うまくいく最もシンプルなものから始める
EVIDENCE エージェントに関するAnthropicのガイダンスはこう述べる:"we recommend finding the simplest solution possible, and only increasing complexity when needed,"(訳:可能な限り最もシンプルな解決策を見つけ、必要なときだけ複雑さを増やすことを推奨する) なぜなら、"agentic systems often trade latency and cost for better task performance"(訳:エージェント型システムは、より良いタスク性能のためにレイテンシとコストを犠牲にすることが多い) (Anthropic、『Building effective agents』, 2024)。数カ月後に公開されたOpenAIのガイドも、言葉は違えど同じことを述べている:"Our general recommendation is to maximize a single agent's capabilities first"(訳:我々の一般的な推奨は、まず単一のエージェントの能力を最大化することだ) (OpenAI、『A practical guide to building agents』, 2025).
LENS 競合する二社が同じ助言をするとき、それはたいてい両社とも別の道が失敗するのを見てきたからだ。良いツールを備えた単一のエージェントは検証しやすく、これは第1部の原則2がアーキテクチャに落とし込まれた姿だ。
実践2:不可逆的なものにゲートをかける
EVIDENCE 同じOpenAIのガイドは、人が介入すべきタイミングを名指ししている:"Actions that are sensitive, irreversible, or have high stakes should trigger human oversight until confidence in the agent's reliability grows,"(訳:繊細、不可逆、または影響が大きい行為は、エージェントの信頼性への確信が高まるまで、人間の監督を発動させるべきだ)——例えば"canceling user orders, authorizing large refunds, or making payments."(訳:ユーザーの注文を取り消す、高額な返金を承認する、支払いを行う、といった行為だ) Anthropicは、エージェントが次のように"pause for human feedback at checkpoints or when encountering blockers."(訳:チェックポイントで、あるいは障害に遭遇したときに、人間のフィードバックを待つために一時停止する)
DESIGN そこから導かれる規則は単純だ。エージェントが取りうるすべての行動を、可逆なものと不可逆なものに仕分ける。可逆な行動はそのまま走らせる。不可逆な行動の前には、実際に考える時間のある人間を置く。そしてそのゲートは、エージェントが実績によってそれを勝ち取った場合にのみ緩める——熱意によってではなく、証拠によってだ。「今まで問題なかった」とは誰もが口にする台詞だが、取り消せない返金が発生するまでの話に過ぎない。
実践3:できることを明言し、不確かなときは範囲を絞る
EVIDENCE Microsoftの研究チームは、"18 generally applicable design guidelines for human-AI interaction,"(訳:人間とAIのインタラクションに関する、汎用的に適用できる18のデザインガイドライン)を提案し、49人のデザイン実務者によって20のAI製品に対して検証した。1番目の指針は"Make clear what the system can do."(訳:システムにできることを明確にせよ)だ。10番目は"Scope services when in doubt"(訳:不確かなときはサービスの範囲を絞れ) (Amershi et al., CHI 2019).
当たり前に聞こえるかもしれないが、それこそが要点だ。エージェントを「何でも手伝います」として紹介するのは、新入社員を「何でもできる人」として紹介するようなものだ。LENS 私の経験では、失敗したロールアウトはしばしばこれを飛ばしている。エージェントは「何でも手伝えます」として導入され、人々は見当違いのことでそれを試し、信頼は一度も較正されないまま崩壊する。
実践4:過度な依存を防ぐよう、意図して設計する
EVIDENCE 標準化団体や規制当局は今や、この失敗を明確に名指ししている。NISTの任意生成AIプロファイルはこう警告する。"humans may over-rely on GAI systems… This phenomenon is an example of automation bias, or excessive deference to automated systems"(訳:人間は生成AIシステムに過度に依存する可能性がある……この現象は自動化バイアス、すなわち自動化されたシステムへの過剰な追従の一例である) (NIST AI 600-1, 2024)。EU AI Actは、高リスクシステムについて次のように設計することを求めている――"that they can be effectively overseen by natural persons,"(訳:自然人によって効果的に監視されうるように)――そして監視者は"remain aware of the possible tendency of automatically relying or over-relying on the output"(訳:出力を自動的に信頼しすぎる、あるいは過度に依存してしまう傾向がありうることを常に意識する) (EU AI Act, Article 14).
これは、part 1の「誤用」が法律の条文になったものだ。DESIGN 実務に落とすとこうなる。エージェントの確信度と情報源を示し、「承認」と同じくらい「異議あり」を押しやすくし、人間がどれだけの頻度で上書きしているかを計測する。もしその答えが「一度もない」なら、エージェントが完璧であるか、誰も中身を読んでいないかのどちらかだ。賭けるべきは後者だと見ていい。
実践5:フロンティアがどこにあるかを知り、ケンタウロス型かサイボーグ型としてそれを使いこなす
EVIDENCE 先ほどの賭けの話に戻ろう。あの実験では、AIを使ったコンサルタントは"completed 12.2% more tasks on average, and completed tasks 25.1% more quickly,"(訳:平均してタスクを12.2%多くこなし、25.1%速く完了させた)、その結果は"more than 40% higher quality."(訳:品質が40%以上高かった)というものだった。しかし、AIのフロンティアの外側にあるタスクでは、AIを使ったコンサルタントは"were 19 percentage points less likely to produce correct solutions"(訳:正しい解を出す可能性が19ポイント低かった) (Dell'Acqua et al., HBS working paper, 2023)。答えはCケンタウロスかサイボーグかだ。この部から実践を一つだけ覚えておくなら、これにしてほしい――自分がフロンティアのどちら側にいるかを知れ、ということだ。
part 1の「オートパイロット」が、ここでも効いてくる。危険なのは、予期していなかった形で仕事を押し戻されることだ。著者らはその境界をジャギー(jagged、ギザギザ)と呼んだ。AIはあるタスクでは卓越した能力を発揮する一方、見た目はよく似た隣接タスクで、静かに間違える。著者らは、うまくいく働き方を二つ見出した。ケンタウロス型は仕事を分担し、"dividing and delegating"(訳:分割して委任する)、人間とAIの間で役割を分ける。サイボーグ型は"completely integrating their task flow with the AI."(訳:タスクの流れをAIと完全に一体化させる) LENS どちらのやり方もうまくいく。失敗するのは、自分がフロンティアのどちら側にいるかを把握していない場合だ。だからこそ実践3が重要になる。
実践6:初心者こそ最も伸びると心得て、その学び方を守る
EVIDENCE 5,179人のカスタマーサポート担当者を対象とした研究(2023年の論文、2025年にQuarterly Journal of Economics誌に掲載)では、AIによる支援が"issues resolved per hour, by 14% on average,"(訳:1時間あたりの解決件数が平均14%増加し)そう示している。"a 34% improvement for novice and low-skilled workers but with minimal impact on experienced and highly skilled workers"(訳:初心者・低スキルの労働者では34%の改善が見られた一方、経験豊富で高スキルな労働者への影響はごくわずかだった) (Brynjolfsson, Li & Raymond, NBER).
これはこの分野における最良のニュースであり、同時に警告でもある。AIは事実上、熟練者の習慣を初心者へと伝えていたわけだ。しかし第1部の原則1が指摘するように、支援なしで自力で仕事をこなす経験を一度もしない初心者は、次世代のシステムが学習する対象となる「熟練者」には決してなれないかもしれない。 DESIGN だからこの実践は両面を持つ。若手には支援を与えると同時に、答えだけでなく、意図的に支援なしで練習し、説明を受ける機会も与えるべきだ。
実践と原則の対応関係
各実践は、ある原則の実装である。
| Practice | Implements | Evidence | |---|---|---| | Start simple | reliance you can calibrate (principle 2) | Anthropic 2024; OpenAI 2025 | | Gate the irreversible | judgment where it matters (part 1's frame) | OpenAI 2025; Anthropic 2024 | | Say what it can do | calibrated trust from day one (principle 2) | Amershi et al. 2019 | | Design against over-reliance | misuse, prevented (principle 2) | NIST AI 600-1, 2024; EU AI Act Art. 14 | | Know the frontier | the ironies, managed (principle 1) | Dell'Acqua et al. 2023 | | Protect how novices learn | the ironies, prevented (principle 1) | Brynjolfsson, Li & Raymond 2023/2025 |
OPEN 何が抜け落ちているかに注目してほしい。原則3から6(契約、コンウェイ、グッドハート、動機づけ)に対応する実践は、公開されているガイダンスの中では明らかに手薄だ。この空白は、この分野がまだ解けていない問いである。第4部では、そのうち委任契約と動機づけの2つを取り上げる。
こう失敗しうる
- 実践をコンプライアンスのチェックリストにしてしまう。 オーバーライドの発生数を測定せずに「ヒューマンオーバーサイト」の箱にチェックを入れるだけでは、第1部で言う「誤用」が新しい形で繰り返されるだけだ。
- ゲートを固定してしまう。 ゲートが決して緩まなければ、人はそれを迂回する方法を学んでしまう。
- 一つの研究を法則と取り違えること。 コンサルティングとコールセンターの研究はどちらも強力だが、それぞれ一つの現場に過ぎない。自分の現場で再検証せよ。
今週やるべきこと
あなたのエージェントが取りうる行動をすべて列挙する。それぞれを可逆か不可逆かに分類する。人が事前に目を通さずに実行される不可逆な行動がいくつあるか数える。その数がゼロでないなら、それが今週の修正点だ。
次回予告
実践はゆっくりと動く。第3回では、いま急速に動いているものを扱う——ジュニア採用、スキル低下、独自のアイデンティティを持つエージェント、そして2025年の目玉数字のいくつかがすでに陳腐化してしまった理由だ。
出典
- Anthropic (2024). Building effective agents. https://www.anthropic.com/engineering/building-effective-agents
- OpenAI (2025). A practical guide to building agents. https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
- Amershi, S. et al. (2019). Guidelines for human-AI interaction. CHI 2019. https://www.microsoft.com/en-us/research/uploads/prod/2019/01/Guidelines-for-Human-AI-Interaction-camera-ready.pdf
- NIST (2024). AI 600-1: Generative AI Profile. https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf
- NIST (2023). AI Risk Management Framework 1.0. https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.pdf
- European Union (2024). AI Act, Article 14: Human oversight. https://artificialintelligenceact.eu/article/14/
- Dell'Acqua, F. et al. (2023). Navigating the jagged technological frontier. HBS working paper 24-013. https://mitsloan.mit.edu/sites/default/files/2023-10/SSRN-id4573321.pdf
- Brynjolfsson, E., Li, D. & Raymond, L. (2023; QJE 2025). 誌掲載). Generative AI at Work(訳:職場における生成AI) NBER w31161 https://www.nber.org/papers/w31161