SERIE AI-NATIVE · DINÁMICAS HUMANAS EN IA AGÉNTICA, PARTE 2 DE 4
Buenas prácticas que evolucionan lento: trabajar con agentes hoy
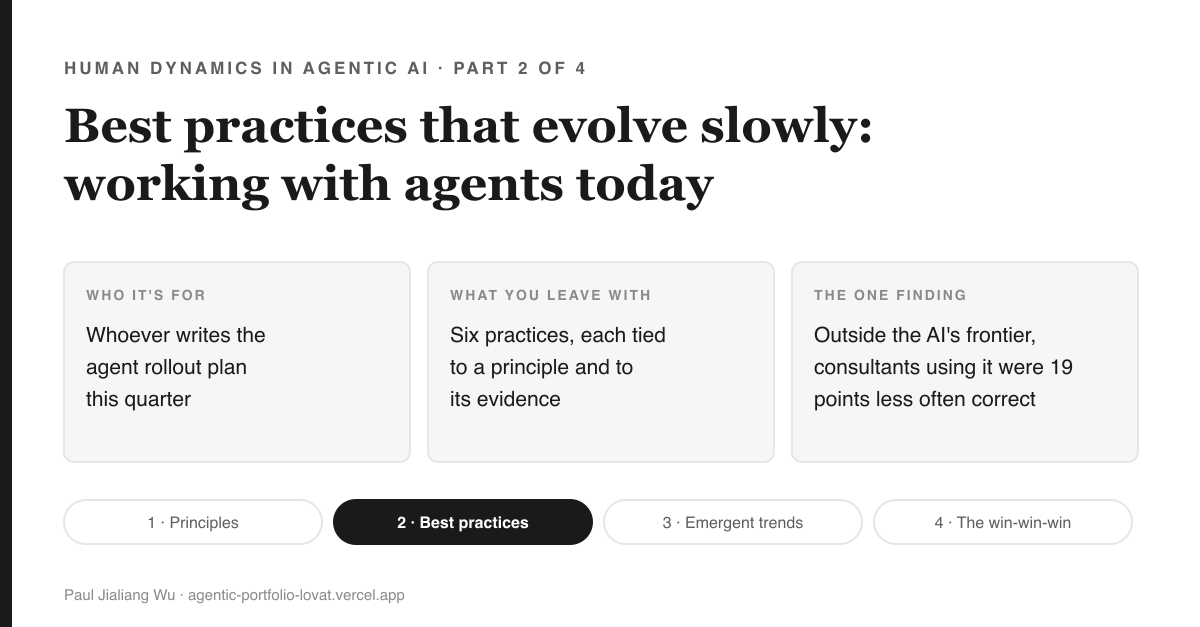
Resumen de 1 minuto
De qué se trata. Parte 2 de la serie: seis prácticas para las personas que trabajan con agentes de IA, cada una ligada a un principio de la parte 1 y a su evidencia, desde Anthropic y OpenAI hasta NIST, la Ley de IA de la UE y experimentos de campo.
Por qué importa. La misma herramienta de IA que elevó la calidad del trabajo de los consultores en más del 40% en una tarea los hizo 19 puntos menos propensos a acertar en una tarea apenas fuera de su frontera. Saber de qué lado estás es la práctica que hay que recordar.
Qué puedes hacer después de leer esto. Haz una lista de cada acción que tu agente puede ejecutar, marca cada una como reversible o irreversible, y cuenta cuántas de las irreversibles se ejecutan sin que una persona las revise antes. Si el conteo no da cero, ese es el arreglo de esta semana.
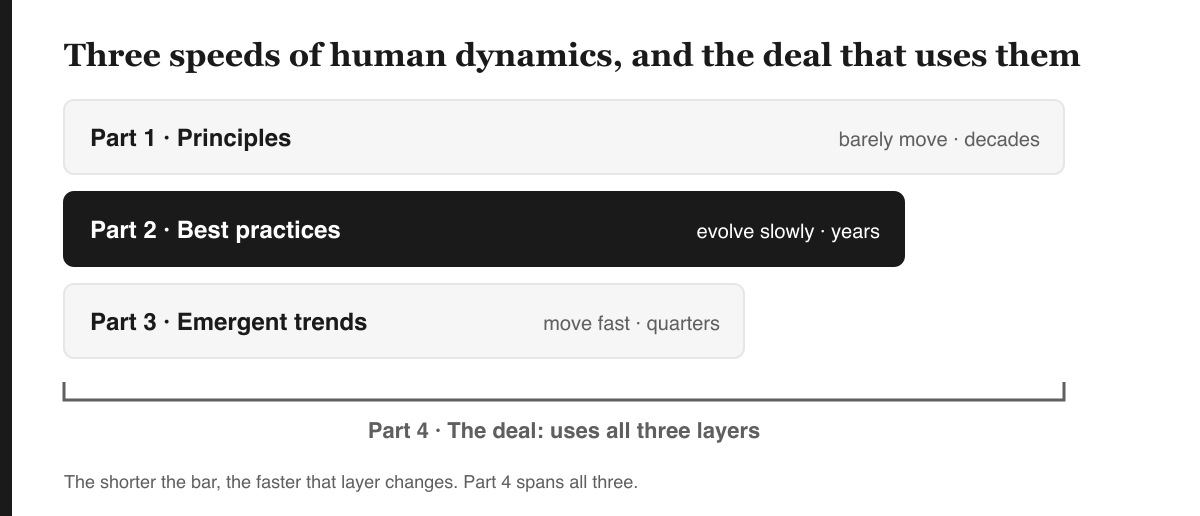
Human Dynamics in Agentic AI — la espina de la serie
- Principios que apenas cambian episodio 1
- Buenas prácticas que evolucionan lento este episodio
- Tendencias emergentes que cambian rápido episodio 3
- próximamente episodio 4
Cómo leer las etiquetas: EVIDENCE tiene una fuente, DESIGN es cómo está diseñada la práctica, OPEN aún no está probado, y LENS es mi propia convicción.
Estás poniendo a los agentes a trabajar junto a las personas. Seis prácticas, con aportes de laboratorios, reguladores y experimentos de campo, convierten los principios de la parte 1 en reglas para este trimestre. La sorpresa: la frontera de la IA es dentada, así que la misma herramienta que hace a los consultores un 40% mejores en una tarea los hace peores en la siguiente. Empieza simple, pon compuertas a lo irreversible, y sabe de qué lado estás.
Qué cubre este episodio: buenas prácticas para las personas que trabajan con agentes de IA
La parte 1 nombró seis principios que apenas se mueven. Esta capa se mueve, pero despacio: prácticas que tomaron años de despliegue para asentarse y que probablemente se mantengan por unos cuantos más. Es para quienes escriben el plan de implementación: qué hacer, en qué orden, y qué dice en realidad la evidencia detrás de cada paso.
Haz primero una apuesta
En un experimento de campo de 2023, 758 consultores de una firma líder en estrategia trabajaron en tareas realistas con o sin GPT-4. En una tarea elegida deliberadamente para quedar justo fuera de lo que la IA podía hacer bien, los consultores que usaban IA estuvieron:
- A. Casi tan precisos como quienes no la usaron.
- B. Un poco más precisos.
- C. Mucho menos precisos.
Práctica 1: empieza por lo más simple que funcione
EVIDENCE La guía de Anthropic sobre agentes: "we recommend finding the simplest solution possible, and only increasing complexity when needed," (Traducción: recomendamos encontrar la solución más simple posible, y aumentar la complejidad solo cuando sea necesario) porque "agentic systems often trade latency and cost for better task performance" (Traducción: los sistemas agénticos a menudo sacrifican latencia y costo a cambio de un mejor desempeño en la tarea) (Anthropic, Building effective agents, 2024). La guía de OpenAI, publicada unos meses después, dice lo mismo con otras palabras: "Our general recommendation is to maximize a single agent's capabilities first" (Traducción: nuestra recomendación general es maximizar primero las capacidades de un solo agente) (OpenAI, A practical guide to building agents, 2025).
LENS Cuando dos competidores dan el mismo consejo, suele ser porque ambos han visto fracasar la alternativa. Un solo agente con buenas herramientas es más fácil de verificar: eso es el Principio 2 de la parte 1 convertido en arquitectura.
Práctica 2: pon compuertas a lo irreversible
EVIDENCE La misma guía de OpenAI nombra cuándo debe intervenir una persona: "Actions that are sensitive, irreversible, or have high stakes should trigger human oversight until confidence in the agent's reliability grows," (Traducción: las acciones sensibles, irreversibles o de alto riesgo deben activar la supervisión humana hasta que crezca la confianza en la fiabilidad del agente) con ejemplos como "canceling user orders, authorizing large refunds, or making payments." (Traducción: cancelar pedidos de usuarios, autorizar grandes reembolsos o hacer pagos) Anthropic describe agentes que "pause for human feedback at checkpoints or when encountering blockers." (Traducción: se detienen a esperar retroalimentación humana en puntos de control o al toparse con obstáculos)
DESIGN La regla que se desprende es simple. Clasifica cada acción que puede realizar un agente como reversible o irreversible. Deja que las reversibles avancen sin supervisión. Pon a una persona, con tiempo para pensar de verdad, frente a las irreversibles. Luego deja que la compuerta se abra solo a medida que el agente se lo gane, con evidencia, no con entusiasmo. "Hasta ahora ha ido bien" es lo que dice todo el mundo, justo hasta el reembolso que no debió salir.
Práctica 3: di qué puede hacer, y acótalo cuando haya dudas
EVIDENCE El equipo de investigación de Microsoft propuso "18 generally applicable design guidelines for human-AI interaction," (Traducción: 18 pautas de diseño de aplicación general para la interacción humano-IA) verificadas por 49 profesionales del diseño frente a 20 productos de IA. La primera es "Make clear what the system can do." (Traducción: deja claro qué puede hacer el sistema) La décima es "Scope services when in doubt" (Traducción: acota los servicios cuando haya dudas) (Amershi et al., CHI 2019).
Suenan obvias, y precisamente ahí está la clave. Presentar un agente como capaz de "ayudar con lo que sea" es como presentar a un nuevo empleado como "bueno para varias cosas". LENS En mi experiencia, los despliegues fallidos suelen saltarse esto: presentan el agente como capaz de "ayudar con lo que sea", la gente lo prueba en lo que no corresponde y la confianza colapsa antes de haber sido siquiera calibrada.
Práctica 4: diseña contra la dependencia excesiva, a propósito
EVIDENCE Los organismos de normalización y los reguladores ya nombran la falla explícitamente. El perfil voluntario de IA generativa del NIST advierte que "humans may over-rely on GAI systems… This phenomenon is an example of automation bias, or excessive deference to automated systems" (Traducción: los humanos pueden depender en exceso de los sistemas de IA generativa… este fenómeno es un ejemplo de sesgo de automatización, o deferencia excesiva hacia los sistemas automatizados) (NIST AI 600-1, 2024). La AI Act de la UE exige que los sistemas de alto riesgo estén diseñados de modo tal "that they can be effectively overseen by natural persons," (Traducción: que puedan ser supervisados eficazmente por personas físicas) y que quienes los supervisan "remain aware of the possible tendency of automatically relying or over-relying on the output" (Traducción: se mantengan conscientes de la posible tendencia a confiar automáticamente o a confiar en exceso en el resultado) (AI Act de la UE, Artículo 14).
Eso es el "mal uso" de la parte 1 convertido en ley. DESIGN En la práctica: mostrar la confianza y las fuentes del agente, hacer que "no estoy de acuerdo" sea tan fácil como "aprobar", y medir con qué frecuencia la gente anula al agente. Si la respuesta es nunca, entonces o bien el agente es perfecto, o bien nadie está leyendo. Apuesta por lo segundo.
Práctica 5: saber dónde está la frontera, y trabajarla como centauro o como cíborg
EVIDENCE Volvamos a la apuesta. En ese experimento, los consultores con IA "completed 12.2% more tasks on average, and completed tasks 25.1% more quickly," (Traducción: completaron en promedio un 12.2% más de tareas, y las completaron un 25.1% más rápido) con resultados de "more than 40% higher quality." (Traducción: una calidad más de un 40% superior) Pero en la tarea fuera de la frontera de la IA, los consultores que la usaban "were 19 percentage points less likely to produce correct solutions" (Traducción: tenían 19 puntos porcentuales menos de probabilidad de producir soluciones correctas) (Dell'Acqua et al., HBS working paper, 2023). La respuesta es C. Si recuerdas una sola práctica de esta parte, que sea esta: saber de qué lado de la frontera estás.
El piloto automático de la parte 1, otra vez: el peligro es la devolución de control que no viste venir. Los autores llamaron a ese límite dentado (jagged): la IA es excelente en algunas tareas y falla calladamente en tareas vecinas que parecen similares. Vieron dos buenas formas de trabajar. Los centauros dividen el trabajo, "dividing and delegating" (Traducción: dividiendo y delegando) entre persona e IA. Los cíborgs "completely integrating their task flow with the AI." (Traducción: integrando por completo su flujo de trabajo con la IA) LENS Las dos funcionan. Lo que falla es no saber de qué lado de la frontera estás, por eso la práctica 3 importa tanto.
Práctica 6: espera que los novatos ganen más, y protege cómo aprenden
EVIDENCE En un estudio con 5179 agentes de atención al cliente (working paper de 2023, publicado en la Quarterly Journal of Economics en 2025), la asistencia de IA aumentó "issues resolved per hour, by 14% on average," (Traducción: los problemas resueltos por hora, en un 14% en promedio) con "a 34% improvement for novice and low-skilled workers but with minimal impact on experienced and highly skilled workers" (Traducción: una mejora del 34% para trabajadores novatos y poco calificados, pero con impacto mínimo en trabajadores experimentados y altamente calificados) (Brynjolfsson, Li & Raymond, NBER).
Esta es la mejor noticia del campo y, al mismo tiempo, una advertencia. De hecho, la IA estaba transmitiendo los hábitos de los expertos a los novatos. Pero el Principio 1 de la parte 1 dice que el novato que nunca hace el trabajo sin ayuda quizá nunca llegue a ser el experto del que aprenderá el siguiente sistema. DESIGN Así que la práctica tiene dos caras: dale a los junior la asistencia, y también dales práctica deliberada sin ayuda, con explicaciones, no solo respuestas.
Cómo se vinculan las prácticas con los principios
Cada práctica es un principio convertido en implementación:
| Práctica | Implementa | Evidencia | |---|---|---| | Empieza simple | confianza que puedes calibrar (principio 2) | Anthropic 2024; OpenAI 2025 | | Pon compuertas a lo irreversible | el criterio donde importa (marco de la parte 1) | OpenAI 2025; Anthropic 2024 | | Di lo que puede hacer | confianza calibrada desde el día uno (principio 2) | Amershi et al. 2019 | | Diseña contra la dependencia excesiva | el mal uso, prevenido (principio 2) | NIST AI 600-1, 2024; EU AI Act Art. 14 | | Conoce la frontera | las ironías, gestionadas (principio 1) | Dell'Acqua et al. 2023 | | Protege cómo aprenden los novatos | las ironías, prevenidas (principio 1) | Brynjolfsson, Li & Raymond 2023/2025 |
OPEN Nota lo que falta: las prácticas para los principios 3 a 6 (contratos, Conway, Goodhart, motivación) son mucho más escasas en las guías publicadas. Esa brecha es una pregunta abierta que el campo todavía no resuelve. La parte 4 retoma dos de ellas: el contrato de delegación y la motivación.
Cómo podría fallar esto
- Las prácticas como lista de verificación de cumplimiento. Marcar "supervisión humana" sin medir cuántas veces se anula es el mal uso de la parte 1 bajo otra forma.
- Congelar la compuerta. Si la compuerta de lo irreversible nunca se afloja, la gente aprende a esquivarla.
- Confundir un estudio con una ley general. Los estudios de consultoría y centros de llamadas son sólidos, pero cada uno es un contexto particular. Vuelve a probarlo en el tuyo.
Tu tarea de esta semana
Haz una lista de cada acción que tu agente puede realizar. Marca cada una como reversible o irreversible. Cuenta cuántas acciones irreversibles se ejecutan sin que una persona las vea antes. Si el conteo no es cero, ahí tienes el pendiente de esta semana.
Siguiente
Las prácticas evolucionan lentamente. La parte 3 trata sobre lo que está cambiando rápido ahora mismo: contratación de personal junior, pérdida de habilidades, agentes con identidades propias, y por qué varias cifras destacadas de 2025 ya quedaron obsoletas.
Fuentes
- Anthropic (2024). Building effective agents. https://www.anthropic.com/engineering/building-effective-agents
- OpenAI (2025). A practical guide to building agents. https://cdn.openai.com/business-guides-and-resources/a-practical-guide-to-building-agents.pdf
- Amershi, S. et al. (2019). Guidelines for human-AI interaction. CHI 2019. https://www.microsoft.com/en-us/research/uploads/prod/2019/01/Guidelines-for-Human-AI-Interaction-camera-ready.pdf
- NIST (2024). AI 600-1: Generative AI Profile. https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.600-1.pdf
- NIST (2023). AI Risk Management Framework 1.0. https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-1.pdf
- European Union (2024). AI Act, artículo 14: supervisión humana. https://artificialintelligenceact.eu/article/14/
- Dell'Acqua, F. et al. (2023). Navigating the jagged technological frontier. HBS working paper 24-013. https://mitsloan.mit.edu/sites/default/files/2023-10/SSRN-id4573321.pdf
- Brynjolfsson, E., Li, D. & Raymond, L. (2023; QJE 2025). Generative AI at Work. NBER w31161. https://www.nber.org/papers/w31161