AI-NATIVE 시리즈 · FUTURE MAKERS STRATEGIC COLLAB, 4부작 중 1부
기존과는 다른 기술 강연: Future Makers Strategic Collab(FM-SC)은 무엇이 다른가
1분 요약
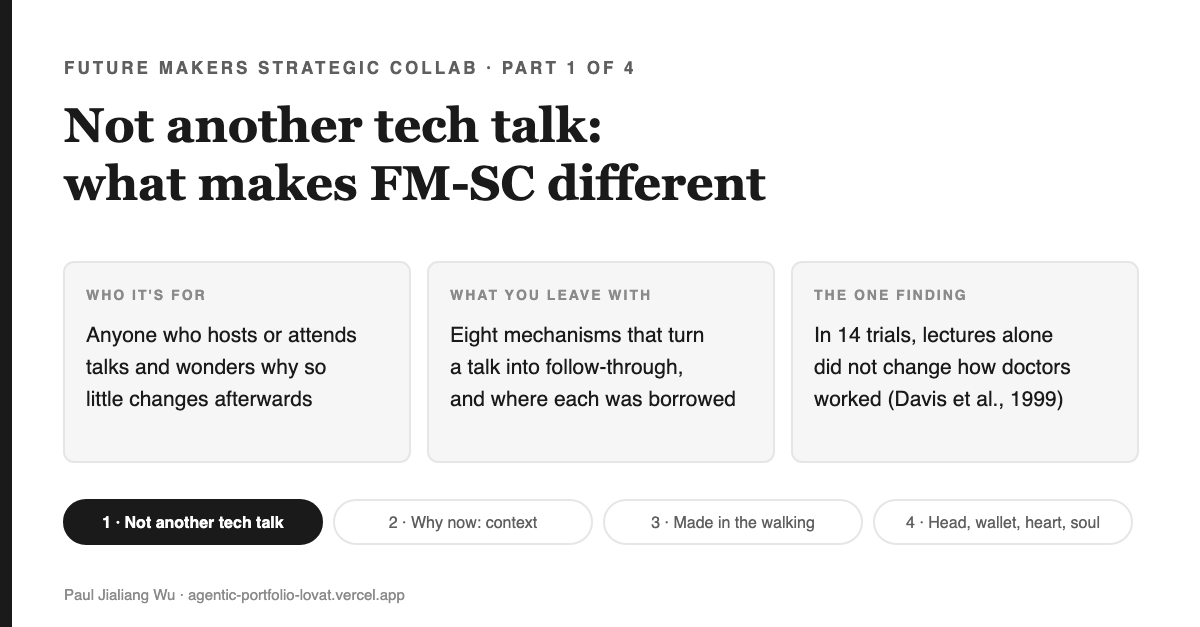
이 글의 내용Future Makers Strategic Collab(FM-SC)에 관한 네 편 중 첫 번째 글이다. 이 시리즈는 최전선 AI 기업들을 초청해, 행사가 끝난 뒤 실제로 변화가 일어나도록 설계된 기술 강연이다. FM-SC를 학계 및 산업계 컨퍼런스와 비교하고, FM-SC만의 여덟 가지 차별점을 정리한다.
핵심 이유의사들을 대상으로 한 14건의 무작위 대조 실험을 검토한 결과, 강의만으로는 실제 업무 방식이 바뀌지 않았고, 상호작용이 있는 경우에만 일부 변화가 있었다는 근거가 있다. 강연을 주최하거나 참석하는 입장이라면, 한 시간의 대부분이 아무런 변화도 남기지 않을 수 있다. 해법은 강연자가 누구냐가 아니라, 강연을 어떻게 운영하느냐에 달려 있다.
읽고 난 뒤 실천법. 다음 강연이나 모임에 이 여덟 가지 원칙을 적용해보라. 마지막에는 '내가 앞으로 무엇을, 언제 다르게 할 것인가'를 한 문장으로 적는다. 만약 답을 못 적겠다면, 이 글이 어떤 원칙이 빠졌는지 짚어준다.
Future Makers Strategic Collab — 시리즈 줄기
▶ 실제로 돌아가는 모습 보기: 라이브 데모 열기 공개 · 로그인 불필요
- FM-SC가 기존 기술 강연과 다른 이유 이번 화
- 왜 지금인가 — AI가 저비용이 되면, 컨텍스트가 누적된다 2화
- 매칭 — 말이 아니라, 함께 걷는 과정에서 만들어진다 3화
- 머리, 지갑, 가슴, 영혼 — 관행마다 두 증인 4화
표시 설명법:EVIDENCE는 근거가 출처에 있다,DESIGN은 FM-SC의 설계 원리,OPEN은 아직 실험 전이며,LENS는 내 신념이다.
이 시리즈의 주제: 실제로 행동 변화를 이끄는 기술 강연 만들기
이 글은 네 편으로 이어지는 Future Makers Strategic Collab (FM-SC) 시리즈의 첫 번째다.Future Makers Strategic Collab (FM-SC), 우리는 Accenture Advanced AI Center에서 최전선 기업들을 초청해 운영하는 기술 강연 시리즈다. 이 시리즈는 강연을 주최하거나 참석하지만, 왜 끝나고 나면 실제로 달라지는 것이 거의 없는지 고민하는 엔지니어, 창업자, 연구자, 리더를 위한 것이다. 1부에서는 FM-SC와 학계 및 산업계의 기존 포맷을 비교하고, 각 포맷이 무엇을 목표로 설계되었는지, 그리고 FM-SC가 어떻게 여덟 가지 방식으로 다르게 접근하는지 짚는다.
먼저 질문을 던져보자
다음 중 어떤 요소가 실제로 전문가 모임 이후 사람들이 일터에서 행동을 바꾸는지를 가장 잘 예측할까?
- A. 유명 연사
- B. 많은 청중
- C. 상호작용: 청중이 단순히 듣는 데 그치지 않고, 연사와 함께 문제를 직접 다룬다
- D. 다시 볼 수 있는 녹화본
하나를 골라보라. 정답은 무작위 대조 실험 리뷰에서 확인할 수 있는데, 곧 설명하겠다.
이 이야기는 이렇게 시작됐다
2022년 9월 Southern Data Science Conference 이후 나는 두 편의 글을 썼다. 하나는 행사에 대한 장난스러운 "비공식 설문"이었는데, 마지막 문장은 지금도 내 신념이다: "all models are wrong, but some are useful, some time." (번역: 모든 모델은 틀렸지만, 어떤 모델은 언젠가 쓸모가 있다.) (Wu, 2022a). 다른 글에서는 컨퍼런스가 한순간의 스냅샷에서 지속적인 상호작용으로 나아가야 한다고 주장했다. 즉, 연사는 실제 문제를 던지고, 학습자는 멘토와 팀을 이루며, 관계는 행사 그 자체보다 더 오래 이어져야 한다는 내용이었다. (Wu, 2022b).
4년 뒤, Accenture Advanced AI Center에서 우리는 그 아이디어를 실제로 구현해보았다. 우리는 이것을 Future Makers Strategic Collab (FM-SC)라 이름 붙였다. 초청 연사는 모두 Future Makers다. 2026년 10월 2일, 첫 연사로 XTrace의 Felix Meng과 Austin Cai가 참여했는데, 이들은 사람과 AI 에이전트를 위한 공유 메모리를 구축하는 팀이다.
대부분의 강연과 컨퍼런스가 지향하는 것
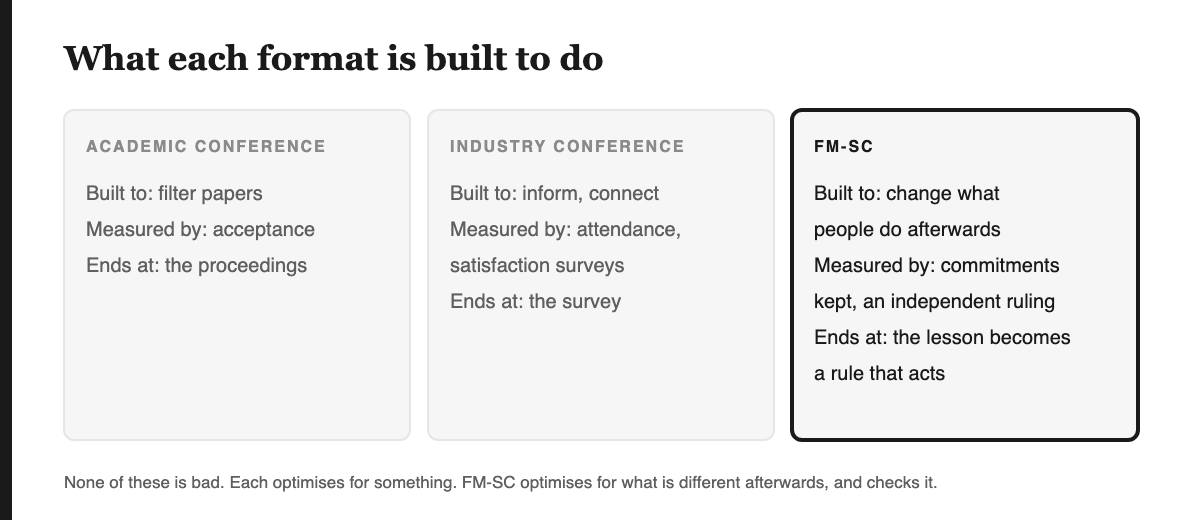
이 부분은 객관적으로 살펴볼 필요가 있다. 모든 포맷은 각자의 목표에 맞게 최적화되어 있고, 대부분은 그 목적에 부합하는 방향.
학술 컨퍼런스는 어떤 논문을 받아들일지 결정하는 데 목적이 있다. EVIDENCE 이 심사 과정은 많은 이들이 생각하는 것보다 훨씬 더 불확실하다. 2021년 NeurIPS에서는 882편의 논문을 두 개의 독립 위원회가 심사했는데, 두 위원회가 23%에서 서로 다른 결정을 내렸다(NeurIPS consistency experiment). 내가 공개된 수치를 계산해보니, 한 위원회가 통과시킨 논문 중 절반 가까이를 다른 위원회는 탈락시켰다. 이는 결코 이상한 일이 아니다. 전문가들이 각자, 시간에 쫓기며, 공통 기준 없이 판단하면 자연스럽게 벌어지는 현상이다.
산업 컨퍼런스는 정보를 전달하고 사람들을 연결하는 데 초점을 둔다. LENS 내 경험상, 이런 행사는 주로 참석자 수와 행사 후 설문조사 결과로 평가된다. 즉, 얼마나 많은 사람이 왔는지, 그리고 만족했는지가 주요 기준이다.
대부분의 강연은 박수가 터지는 순간 끝난다. 박수는 모든 강연이 현장에서, 무료로, 전 청중으로부터 받는 유일한 실시간 지표다. 그리고 이 박수는 마지막 문장이 얼마나 잘 마무리됐는지를 보여준다. EVIDENCE 정답은 다음과 같다. C14건의 무작위 배정 임상시험을 종합한 결과, "didactic sessions do not appear to be effective in changing physician performance"(번역: 강의식 세션은 의사의 실제 업무 변화를 이끌어내는 데 효과적이지 않은 것으로 보인다)는 사실이 밝혀졌고, 소수의 연구에서는 상호작용이 있는 세션이 효과가 있다는 근거도 일부 있었다(Davis et al., JAMA 1999). 물론 이 연구는 의사를 대상으로 했으니, 절대적 법칙이라기보다는 강한 시사점 정도로 받아들이면 된다.
이 모든 것이 컨퍼런스가 잘못됐다는 뜻은 아니다. 애초에 이들은 정보를 제공하거나, 선별하거나, 연결하는 데 초점을 맞췄을 뿐, 사람들의 행동 변화를 목표로 설계된 적이 없다는 의미다.
FM-SC가 다르게 하는 여덟 가지
FM-SC는 한 가지 질문을 중심에 둔다: 이 강연 이후에 실제로 무엇이 달라질 것인가, 그리고 우리는 그것을 어떻게 확인할 수 있을까? 아래의 여덟 가지는, 일반적인 강연에서는 시도하지 않는 것들이다.
- 초대장을 보내기 전에 질문부터 세운다. DESIGN 누구를 부르기 전에, 우리가 진짜로 알고 싶은 것과 그게 틀렸다는 걸 어떻게 확인할지부터 적는다. EVIDENCE 과학계에는 이와 비슷한 Registered Report라는 방식이 있다. 데이터가 생기기 전에 연구 방법부터 심사받는 것이다. 한 비교 연구에 따르면, 일반 심리학 논문의 96%가 긍정적 결과를 보고한 반면 Registered Report는 44%에 그쳤다(Scheel, Schijen & Lakens, 2021). 먼저 검증 기준을 적어두면, 우리가 무엇을 배웠는지 스스로에게 솔직해질 수 있다.
- 좌석은 직급이 아니라 주제 연관성으로 정한다. 초대받은 각자의 일이 발표자가 다루는 주제와 실제로 연결된다.
- 모두가 질문을 준비한다. 각자는 행사 전에 실제 질문이나 고민, 요청을 미리 기록하고, Q&A는 그 목록에서 시작한다.
- 발표 전에 미리 만나고, 현장에서 직접 검증한다. 발표자의 엔지니어와 리더들과 사전 미팅을 하고, 발표자가 미리 볼 수 있도록 공정하게 준비된 짧은 현장 테스트도 진행한다.
- 마지막 10분은 각자의 실행 약속을 정하는 시간이다. 각 약속에는 책임자와 마감일이 지정되고, 모두 앞에서 낭독된다.
- 발표자를 초대한 사람이 아닌 제3자가 결과를 판정한다. 5영업일 이내에 확인, 반박, 또는 계속 보류 중임을 판정한다. DESIGN 발표가 잘 되기를 바란 사람이 실제로 잘 됐는지 판정하는 일은 절대 맡지 않는다.
- 발표자는 실제로 도움이 되는 무언가를 받고, 이어서 세 가지를 더 요청받는다. 먼저 측정된 피드백을 받고, 이후에는 프런티어 연구소, 빌더, 연구자와의 연결을 요청한다. EVIDENCE 모든 액셀러레이터가 스타트업의 성장을 가속한 것은 아니지만, 실제로 효과가 있었던 사례를 보면 핵심 요인은 "broad, intensive, and paced consultation"(번역: 폭넓고, 집중적이며, 속도 조절이 된 자문): 한 번의 데모로 끝내지 않고, 반복적으로 접촉하는 방식이다 (Hallen, Cohen & Bingham, Organization Science 2020).
- 배운 것은 다음 실수를 미리 막는 규칙으로 바꾼다.우리가 얻은 교훈은, 아무도 다시 보지 않는 녹화본이 아니라, 우리 시스템이 다음 단계에 들어가기 전에 직접 점검하는 규칙으로 남긴다.
우리가 정직하게 참고한 것들
이 여덟 가지 중 어느 것도 완전히 새로운 발명은 아니다. 새롭다고 포장할 생각은 없다.
- 먼저 검증 기준을 작성한다: 위에서 언급한 Registered Reports.
- 아이디어는 공개적으로 논의한다: Xerox PARC에서는 Bob Taylor가 '빈백' 룸에서 비공식 모임을 열어, 직원들이 새로운 아이디어를 발표하고 동료들로부터 솔직하고 때로는 가차 없는 피드백을 받았다 (Computer History Museum).
- 소규모 초청 실무 모임: Dagstuhl 세미나는 초청제로, 3일 또는 5일간 진행된다 (Schloss Dagstuhl).
- 주식을 사지 말고 제품을 직접 써본다: BMW Startup Garage의 벤처-클라이언트 모델.EVIDENCE BMW는 280개가 넘는 스타트업과 파일럿을 진행했고, 이 중 38개 이상이 정식 공급업체가 되었다고 한다. 이 두 하한값을 나누면 대략 13.6%가 나온다(내 계산 기준) (BMW Startup Garage).
DESIGNFM-SC가 더한 것은 바로 이 조합이다. 모든 강연마다 하나의 루프를 돌리고, 소프트웨어가 이를 점검해 약속이 조용히 사라지지 않게 한다. 이 루프는 아홉 단계로 이루어진다:등록 질문을, 소집 적합한 인원을, 준비, 참여, 기록 논의된 내용을, 이행 약속 사항을, 판정 우리가 배운 점을, 상호 보답 (먼저 발표자에게 감사를 전하고, 이어서 소개를 요청), 그리고 축적 (배운 교훈을 규칙으로 바꾼다).
직접 경험해보기: FM-SC 웹 앱
DESIGN 이 루프를 점검하는 소프트웨어는 에이전트형 웹 앱이다. 질문을 입력하면 기록을 바탕으로 답을 내놓는다. 누구나 이용할 수 있는 공개 버전이 strategic-collab.vercel.app 에 열려 있고, 로그인도 필요 없다. 첫 화면에는 이런 질문이 뜬다: 무엇이 궁금한가? 이렇게 물어보라 우리는 얼마나 잘하고 있나? 또는 Future Makers는 누구인가? 그리고 모든 답변은 항상 같은 구조로 돌아온다. 하나의 제목, 하나의 수치, 하나의 다음 단계, 그리고 그 답변의 근거가 무엇인지가 명확히 제시된다. 아홉 단계, 규칙이 된 교훈, 각 항목별 접근 권한은 메뉴 뒤 각자의 페이지에서 확인할 수 있다.
클릭하기 전에 알아둘 점이 두 가지 있다. 홈 화면에 있는 토크 기록은 실제 기록이며, 우리가 대외적으로 공개 가능한 수준까지만 보여준다. 메뉴 뒤에 있는 안내 페이지들은 모두 가상의 인물과 사건을 예시로 삼고, 페이지 상단에 그 사실이 명확히 표시되어 있다. 실제 참여자 이름, 메모, 판정 결과 등은 우리 내부 시스템에만 저장되며 온라인에는 절대 공개되지 않는다.
솔직한 결과표
FM-SC는 지금까지 단 한 번의 토크만을 진행했다. 우리 스스로 정한 규칙에 따라, 현재까지의 결과는 다음과 같다.
- 토크 이틀 전에 질문을 작성해 타임스탬프를 남겼다. 이것이 첫 번째 실수다. 1번 원칙은 초대 이전에질문이 정해져야 한다고 명시한다. 그래서 시스템이 첫 토크에서 가장 먼저 배운 규칙은 주최자 자신에 관한 것이었다.
- 토크에서 다뤄진 내용 중 아직 검증된 것은 없다. 무언가 검증이 필요할 때는, 발표자가 그 테스트를 사전에 확인한다.
- EVIDENCE 내 계산에 따르면, 이 토크는 행사 전 3회 이상의 심층 토론과 행사 중·후 15개 이상의 질문을 이끌어냈다.
- 첫 번째 루프는 아직 닫히지 않았다. 우리 규칙상, 행사 전 준비 과정을 기록하지 않았기 때문에 이 루프는 유효하지 않다. 이 실수를 규칙으로 바꿔, 이제 모든 세션 전에 미리 경고가 뜨도록 했다.
이 방식이 실패할 수 있는 경우
- 형식적인 절차로 변질된다. 아홉 단계가 실질적인 도움이 아니라 단순한 서류 절차처럼 느껴진다면, 사람들은 이를 우회하려 들 것이다. 그렇게 되면 준비와 후속 조치가 자연스럽게 줄어든다.
- 판정의 책임자가 없다. 독립적인 판정을 위해서는 시간적 여유가 있는 제3자가 필요하다. 그 역할이 없으면, 루프는 7단계인 판정에서 멈추고 만다.
- 엄격함을 적대감으로 오해한다. 공정한 검증도 때로는 불쾌한 기습처럼 느껴질 수 있다. 그래서 발표자가 사전에 검증 내용을 확인하고, 실패 역시 합격만큼 신속하게 보고하는 것이다.
- OPEN 축적되지 않는다. 만약 열 번째 토크가 첫 번째 토크보다 더 나아지지 않는다면, 이 모든 과정은 그저 불필요한 행정적 부담에 불과하다.
이번 주에 실천할 것
최근에 참석했던 토크를 떠올려 보라. 그 경험 덕분에 실제로 달라진 점 한 가지를 날짜와 함께 적어보라. 만약 떠오르지 않는다면, 여덟 가지 중 어떤 요소가 빠졌는지 스스로 점검해 보라.
그리고 5분만 투자해 FM-SC 웹 앱을 열고 아홉 단계에서 당신이 마지막 토크에서 놓친 단계를 찾아보라.
다음 글 예고
2부에서는 왜 이 문제가 지금 더 중요한지 다룬다. AI 모델은 해마다 더 저렴해지고, 점점 비슷해지고 있다. 모두가 같은 지능을 빌릴 수 있는 시대에, 진짜 경쟁력은 어디에서 나올까?
출처
- Wu, P. J. (2022a). How come this Southern Data Science Conference ranking #1. LinkedIn. https://www.linkedin.com/pulse/how-data-science-conference-becomes-ranking-1-paul-jialiang-wu-phd/
- Wu, P. J. (2022b). Here comes the 12X-Future Southern Data Science Conferences. LinkedIn. https://www.linkedin.com/pulse/here-coms-12x-future-southern-data-science-conference-wu-phd/
- NeurIPS (2021). The NeurIPS 2021 consistency experiment. https://blog.neurips.cc/2021/12/08/the-neurips-2021-consistency-experiment/
- Davis, D. 외. (1999). 공식적 지속 의학 교육의 효과. JAMA, 282(9). https://jamanetwork.com/journals/jama/fullarticle/191423
- Scheel, A. M., Schijen, M. & Lakens, D. (2021). 긍정적 결과의 과잉. Advances in Methods and Practices in Psychological Science. https://forrt.org/curated_resources/an-excess-of-positive-results-comparing/
- Hallen, B. L., Cohen, S. L. & Bingham, C. B. (2020). 액셀러레이터는 실제로 효과가 있는가? 그렇다면, 그 이유는 무엇인가? Organization Science, 31(2). https://doi.org/10.1287/orsc.2019.1304
- Computer History Museum, Xerox PARC. https://www.computerhistory.org/revolution/input-output/14/348
- Schloss Dagstuhl, Dagstuhl Seminars. https://www.dagstuhl.de/en/seminars/dagstuhl-seminars
- BMW Startup Garage. https://bmwstartupgarage.com/