AI 原生系列 · 研究
一个观点,十顶帽子
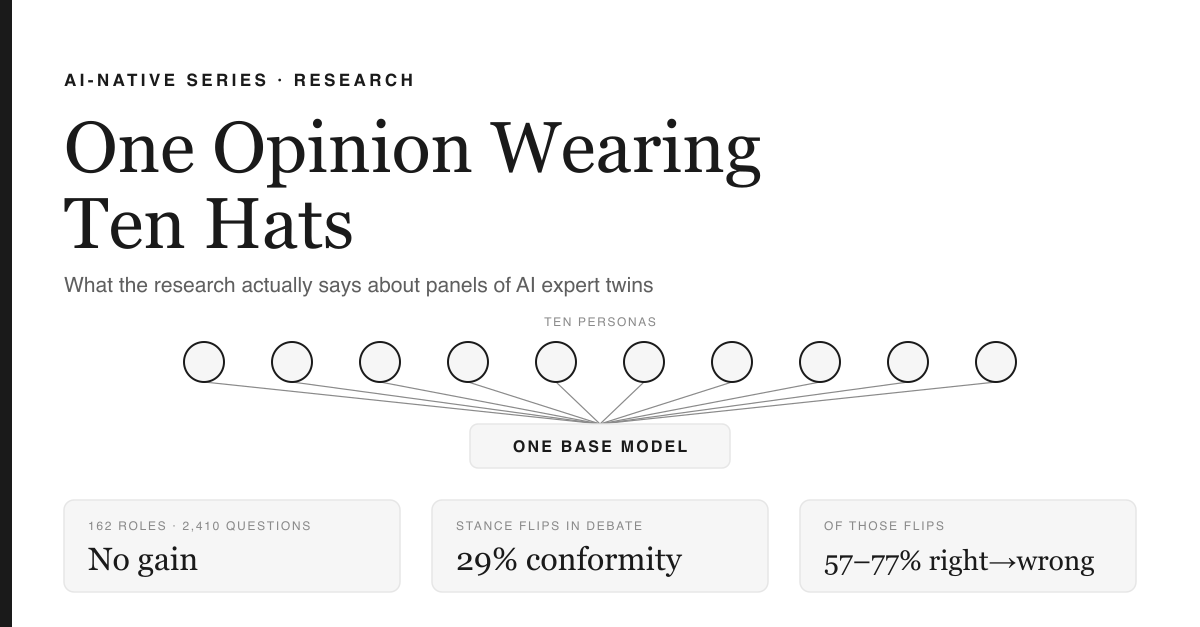
一分钟速览——你能带走什么
找十个 AI「领域专家」来批判你的工作,感觉上是在组建一个评审团。可一旦实测,往往只是同一个模型换了十种字体在自我从众。人设标签并不能提升事实准确率(162 种角色、2410 个问题,相较于不加人设毫无增益)。辩论则是先变差、后才可能变好:智能体有 29% 的概率会改变答案,而这些改变中有 57%–77% 是从答对变成答错。真正能在证据面前站得住、且可以落地搭建的做法很窄:让每个分身都扎根于一份真实语料库而非一个形容词,从不同源的模型家族中挑选它们,在任何人开口之前先封存裁决——以及那个至今没人真正上线的环节:衡量你这个评审团的一致意见,究竟是被说服的结果,还是从众压力的产物。
这是一个幻想,而我曾经深陷其中。
你深陷在一个研究问题里。真正昂贵的不是工作本身,而是那段等待。你需要一个懂这个领域的人看看你的框架,告诉你「这个问题早就有人做死了,原因是……」——可那个人正在开会,或者收件箱里躺着两百封未读邮件,又或者是你的导师,而你三周才能约到 45 分钟。于是你只能盲目地迭代。Andrew Ng 用一个周末做出了一个工具,起因正是如此:他说自己是受一个学生的启发——那学生的论文三年里被拒了六次,每一轮反馈都要等上大约六个月 [1]。三年的人生,大半耗在了等回信上。
所以:如果你不必等待呢?如果你把十位真实的领域专家提炼成十个 AI 分身,让他们独立读你的东西,意见不合时再让他们辩论呢?十位世界级的评审,随叫随到,凌晨两点也行,价钱只要一份三明治。
我去查了这套办法到底行不行。答案是:行——但这个想法里那种直觉上的版本,几乎没有一处能真正站得住;而失败的那些部分,失败得比什么都不做还糟,因为一个失灵的小组照样会递给你一份信心满满的结论。
先说好消息:陪审团赢过法官
支持这个幻想的最强证据来自一篇评测论文,而不是研究智能体的论文。Cohere 的团队问了一个很朴素的问题——用 LLM 给另一个 LLM 的输出打分时,该用一个昂贵的大模型,还是几个小模型?他们的回答,原文如下:
"using a PoLL composed of a larger number of smaller models outperforms a single large judge, exhibits less intra-model bias due to its composition of disjoint model families, and does so while being over seven times less expensive." [2](中译:由更多小模型组成的 PoLL 表现优于单一的大模型评委,由于其构成来自互不重叠的模型家族,模型内部偏差更小,同时成本还便宜七倍以上。)
中间那句从句值得读两遍,因为它才是真正撑住整个论点的部分:由于其构成来自互不重叠的模型家族。这个小组之所以获胜,不是因为它有更多意见,而是因为这些意见来自不同的人、用不同的数据训练出来的机器,所以它们犯的错不会对齐到一块儿去。这不是什么提示词的小技巧,这是一种结构性的属性——你要么有,要么没有。
这个幻想也确实有过真正的战果。在 Virtual Lab 里——作者称之为「一种面向科学研究的人机协作」[3]——一个「首席研究员」智能体主持会议,带着若干专家智能体和一位指定的批评者,这条流水线设计出的纳米抗体后来在实验台上得到了验证,并发表在Nature [4]。Google 的 Co-Scientist 跑的是类似的结构(生成、评审、锦标赛式排名、迭代进化),在 2026 年也登上了Nature,带着经实验验证的假设 [5]。而最早那篇多智能体辩论论文发现,让多个模型实例「在多轮中提出并辩论各自的回答与推理过程」能提升事实准确性、减少幻觉——用作者自己的话说,这是一种「群体心智(society of minds)」的方法 [6]。
所以,AI 智能体组成的小组确实产出过真实的分子、真实的论文。很好。现在,该算账了。
坏消息:戏服不管用
构建十位专家最直觉的做法,就是写十段系统提示词。You are a skeptical roboticist. You are a careful statistician. You are a materials chemist who has seen every version of this fail.(中译:你是一位持怀疑态度的机器人专家。你是一位谨慎的统计学家。你是一位材料化学家,见过这类失败的每一种版本。) 感觉像选角,读起来也像选角。Zheng 及其同事用一个足以终结争论的规模做了测试:162 种角色,涵盖六类人际关系和八个专业领域,在四个模型家族上跑了 2,410 道事实性问题。他们的发现,原文如下:
"we demonstrate that adding personas in system prompts does not improve model performance across a range of questions compared to the control setting where no persona is added." [7](中译:我们证明,与不添加任何人设的对照组相比,在系统提示中添加人设并不能提升模型在一系列问题上的表现。)
而同一篇摘要里,还有一句本该终结这种做法的话:
"while adding a persona may lead to performance gains in certain settings, the effect of each persona can be largely random." [7](中译:虽然在某些情境下添加人设可能带来性能提升,但每种人设的效果在很大程度上是随机的。)
很大程度上是随机的。不是「偏差不大」——是随机。当你写下「你是X领域的世界级专家」时,你召唤出来的并不是专业能力,而是把模型自身的先验概率印在骰子的每一面,然后掷了一把。
另一项研究里藏着一个漂亮的对照实验。Park 及其同事为 1,052 名真实美国人构建了智能体,测量每个智能体预测本人答案的准确度,并以该真人两周后预测自己的准确度作为基准进行归一化。基于两小时访谈构建的智能体达到了该上限的83%;基于结构化问卷的,82%;两者兼用的,86%。而仅基于人口统计信息构建的智能体——这是该研究中最接近「人设标签」的做法,比如「你是一名来自俄亥俄州、受过大学教育的34岁女性」——只拿到了74%[8]。
这个差距——74 对 83——用一组数字就说清了全部论点。一个关于某人的标签,其价值可衡量地低于那个人自己说出的话。分身智能体的根基应该是一份语料,而不是一套戏服。
更糟的消息:辩论可能会吃掉你的正确答案
好吧,你可能会想——即便是平庸的分身智能体,只要争论起来,也总能互相挑出错误吧。就是在这一点上,我不得不改掉了原来的设计。
Smit 及其同事将辩论式策略与普通提示法进行了基准对比,原话如下:
"multi-agent debating systems, in their current form, do not reliably outperform other proposed prompting strategies, such as self-consistency and ensembling using multiple reasoning paths." [9](中译:以目前的形式而言,多智能体辩论系统并不能可靠地胜过其他已有的提示策略,例如自我一致性和多推理路径集成法。)
他们的诊断比这句结论本身更有意思,也是我愿意分享给任何想搭建此类系统的人的内行心得。他们并没有断言辩论本身很糟,而是认为它调校得很糟:MAD(多智能体辩论)协议「未必天生就比其他方法差,但……对不同的超参数设置更为敏感,也更难优化」,而能拯救它的那个关键旋钮是「从众倾向」——调节智能体之间的从众程度「可以显著提升表现,甚至超过我们评估过的所有非辩论式协议」[9]。决定你的这个小组究竟是在帮你、还是在骗你的变量,并不是智能体有多聪明,而是它们有多容易从众.
这就引出了那个彻底重组了我整套设计的数字。Hao 及其同事想弄清楚,辩论中出现的「趋同」到底是什么——是说服,还是从众?在 MMLU-Pro 数据集上,原话如下:
"strict conformity is 29% in the primary setting and remains predominantly harmful across model replications (57-77% correct-to-wrong)." [10](中译:在主要实验设置中,严格意义上的从众比例为29%,且在各模型重复实验中,这种从众绝大多数情况下都是有害的(57%–77%的从众是从正确变为错误)。)
细品这句话。大约十分之三的立场转变属于从众而非说服,而在这些转变中,大多数是把原本答对的智能体说到答错。你的专家组不只是没能抓出你的坏想法,它还有据可查地倾向于把好答案生生辩没了,然后面不改色地把这个共识交给你。
这就是Twelve Angry Men,只不过十二个陪审员都是同一个人,而且这个人从出生起就被训练得容易说服、逆来顺受。Henry Fonda 站起来发表那唯一一票足以救下无辜男孩的异议,环顾四周,看到十一个自己的复制品已经在点头,然后说:“你知道吗,仔细想想,你们说的都很有道理。”
这些在心理学里都不是新鲜事。Deutsch 和 Gerard 早在 1955 年就区分了人类从众的两种原因:信息性影响——你之所以改变看法,是因为有人给了你证据;以及规范性影响——你之所以改变看法,只是因为不想显得格格不入 [11]。他们的结论是:即便剥除了社会压力,人们在群体中依然犯更多错——这是七十年前就贴在所有多智能体系统上的警示标签,如今每一个仍在照单全收。我们用硅基材料重建了一遍 Asch 线段判断实验,结果它的表现和 Asch 线段判断实验一模一样,我们却还感到意外。
心智模型:密封信封
所有值得保留的东西,都能装进一幅十五岁孩子也能照着操作的画面里。
在任何人开口之前,每个人都先把自己的答案写下来,密封进一个信封。然后大家同时拆开所有信封。如果信封里的答案一致,就到此为止——而且这份一致是白得的,未受污染。如果不一致,这时你才有了一场值得进行的争论,而且只针对你们真正分歧的那一点。事后,如果有人改变了主意,你就回头翻开他的信封,问一个问题:你学到了什么你之前不知道的东西?如果他答得出来,那是被说服了。如果答不出来,那就是从众了。
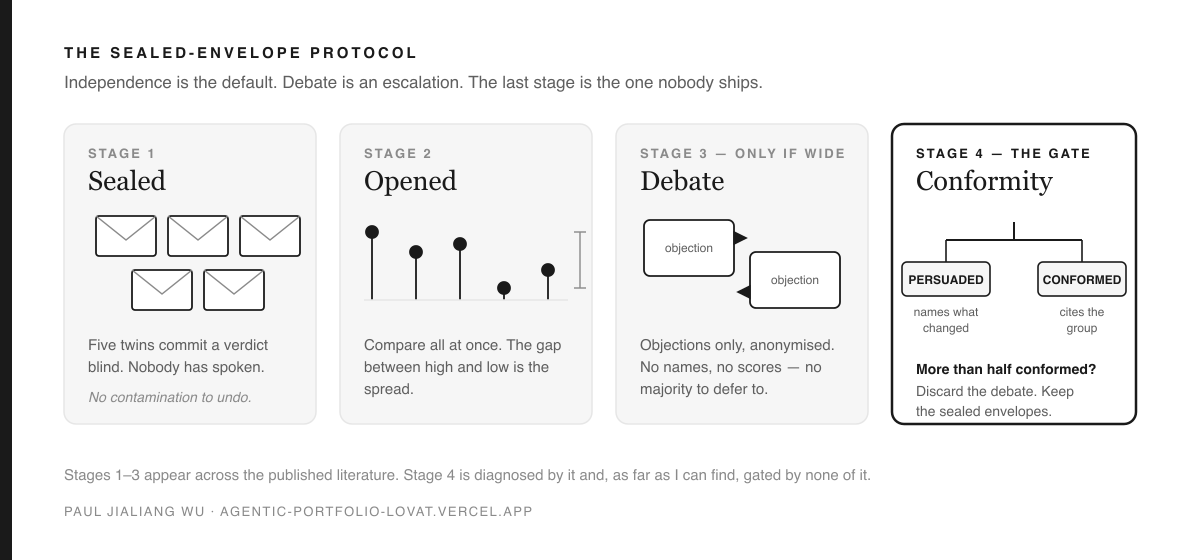
最后这一步,在我的设计里有名字,在我能找到的文献里却没有。上面那些论文把诊断从众现象诊断得漂亮极了。但它们没有一个设卡拦截 上。于是:
从众闸门。 记录每个分身在辩论前的立场。辩论结束后,将每一次立场转变分类为:被说服 ——如果该分身能引用促使它改变的具体新论点;从众 ——如果它只是引用了群体意见、或说不出到底改变了什么。如果超过一半的转变属于从众,就丢弃这次辩论,保留密封裁决。
这只需要在结构化回复里多加一个字段,再做一次除法。据我所知,这是对抗那57%到77%数字最便宜的保险。
四条规则,及其存在的理由
| 规则 | 理由 |
|---|---|
| 要语料库,不要戏服。 任何分身都必须有指名道姓、可核实的来源——论文、演讲、评审意见、代码——并有一个可对照衡量的保真度分数。 | 人设标签的价值约等于随机 [7];基于真实语料的智能体以83比74的成绩击败仅靠人口统计信息构建的智能体 [8]。 |
| 多样性必须来自架构。 两个分身不得共享同一个模型族并且 同一个语料库。在同一个基座模型上换几个形容词,不叫多样性。 | 该小组的优势来自「互不重叠的模型族」,而不是来自更多的意见 [2]。 |
| 先独立判断,辩论只是升级手段。 始终先给出密封裁决;只有在分歧较大时才引入辩论,且需设上限,并将异议匿名化,避免出现可供从众依附的权威信号。 | 辩论并不能可靠地胜过自洽性 [9],而规范性影响需要一个可见的多数派才能发挥作用 [11]。 |
| 分歧才是产出。 同时交付裁决和 以及留存的异议——原文照录、注明出处。允许某个分身弃权——「outside my corpus(超出我的语料范围)」——把它当作一种一等公民的答案。 | 一个总是意见一致的小组,等于什么都没告诉你;而强迫一个超出领域范围的分身表态,正是制造一个自信满满的幻觉的方法。 |
正面做法
- 结构化裁决,而非散文式陈述。 立场、分数、置信度、前三条反对意见,以及一个必填项:什么能改变我的想法。如果你从未记录过立场,事后就无法判定这是一次翻转。
- 根据实测的分歧程度触发辩论,而不是按固定流程走。一致性阈值是一个需要调的超参数,因为它就是那个关键超参数 [9]。
- 给裁判打分。 小组本质上是一个打分函数;打分函数要么拿外部标准校准过,要么就该被标注为「未校准」。绝不能悄悄地选第三条路。
- 给你的分身设定有效期。 十八个月前提炼出的语料,代表的是一位后来已经公开改变过想法的专家。过时是一种需要显示出来的状态,而不是需要隐藏的状态。
反面做法
- 十个提示词,一个模型。 这是最默认的搭建方式,也是被证据击穿的那种。你花了十倍的钱,买到的却是同一种意见的同一种错误模式。
- 从第一轮就开始车轮式讨论。 在你拿到任何一份干净的裁决之前,就已经污染了所有裁决。
- 强行逼出共识。 「小组意见一致」是经理想要的产出,却也是摧毁你召集这个小组本想获取的信息的产出。
- 用你没读过的真实人物的名字给分身命名。 用一个真实的名人姓名去冒充一个泛用模型,等于给一个观点做深度伪造。如果你没法引用语料库,就别用这个名字。
- 让人类彻底出局。 见下文——这一条无解,只有边界。
我无法用工程手段绕过的边界
这就是老实的极限,也是我不会把凌晨两点的幻想原样卖给你的原因。
本文中出现的每一个保真度分数,定义方式都是「与人类的一致程度」。Park 的智能体是拿来对照本人真实答案打分的 [8]。Ng 的审稿工具之所以有意思,恰恰是因为它与人类审稿人的相关性——报告为 0.42 Spearman——大致落在两个人类审稿人彼此之间相关性的水平上,后者报告为 0.41 [1]。世上并不存在一把独立于人类、可以判断「这是不是好研究」的尺子。所以,一个从头到尾都没有人类参与的双胞胎评审团,根本没有任何纠错信号,只会自信满满地滑向其基座模型的先验偏好——而这种滑移读起来会和共识一模一样,因为它本质上就是共识的赝品。
由此得到一个更小、但更真实的结论:双胞胎压缩的是专家检查点之间的等待时间,从数月缩短到数分钟。它们不会移除检查点本身。 对 Ng 的那位学生来说,这依然是三年和一个周末之间的差别。只是这不等于说「你再也不需要专家了」。
所以我没有假装一套设计能包打天下,而是按照「深度」来定制规模。一英里深——单一论断、单一决策:三个双胞胎,密封一轮,完全不辩论,几分钟搞定。十英里——一个你会反复迭代十到十五次的研究问题:五到七个双胞胎,针对有争议的论断展开辩论,在框架设定这一步设一个人类检查点,因为「框架设定错了」这件事代价最高、也最隐蔽。一百英里——一个项目、一篇论文、一场豪赌:七到十个双胞胎,其中包括一名指定的怀疑者和一个来自相邻领域的局外人,只要存在外部权威判据就用上,并且至少设三个人类检查点,强制执行。这不只是一种保险手段——它是唯一能挡在「百英里评审团」和「一场代价高昂的回声」之间的防线。
第一原则
一个评审团比单个专家更有价值,前提仅在于其成员能够各自独立地犯错 ——所以要靠架构和语料库去购买独立性,并且要去衡量你是否真的买到了它。
本文中的一切都是这条原则的推论。人设失败,是因为一件戏服改变不了底层的错误模式。互不重叠的模型家族之所以有效,是因为它们真的做到了这一点。密封信封之所以有效,是因为「污染」说到底不过是事后引入的相关性错误。而从众闸门之所以存在,是因为独立性不是一个只需配置一次就一劳永逸的属性——它是一个在智能体们一开口说话的瞬间就会悄悄泄漏的属性,面对泄漏,唯一负责任的做法就是给它装上仪表去监测。
在动手之前,先说清楚我要如何知道自己错了:如果语料库支撑的双胞胎在留出的评审任务上打不赢光秃秃的人设,那么双胞胎构建就只是一场戏,我该发布那个更便宜的评审团方案。如果这个评审团打不赢一个等成本、用自洽性(self-consistency)的强模型,那就说明 Smit 等人的结论被复现了,我该收手。如果无论用什么匿名化设置,从众率都压不到一半以下,那么辩论在这里就不可用,我只发布密封轮次。以上每一条都是一个可以发表的「零结果」,比起演示一场大合唱,我宁愿发表一个零结果。
溯源——哪些是经过核实的,哪些是我自己的
以上每一条引文,都在发表时逐字核实过原始出处。有两处论断特意没有加引号,因为我没能从原始渠道直接抓取到它们:Agentic Reviewer 的 0.42 对 0.41 相关性,以及「三年被拒六次」这一动机,都是其作者在一篇公开发布文章中所述,本文只是转述,并非引用 [1];Virtual Lab 在 Nature 和 bioRxiv 上的页面,我的抓取工具都收到了 403,所以那项工作是依据其摘要记录及其代码仓库自身的描述引用的 [3][4]。有一处我欠记录一个更正:Park 等人那个被广泛引用的「85%」数字,出自论文的第一版,题为Generative Agent Simulations of 1,000 People;当前版本报告的数字是 83/82/86%,对照的是在 1,052 名参与者中、仅用人口统计信息构建的 74% 基线,本文使用的正是这一版的数字 [8]。密封信封协议、从众闸门、四条规则以及深度阶梯,都是我自己的设计,写在一个私有仓库中,尚未实现——我并未声称有任何实现,整件事情老实的状态是「已规定,未测量」。
参考文献
- Ng, A. (2025). Release post for the Agentic Reviewer (Stanford ML Group), with Y. Jiang. x.com/AndrewYNg/status/1993001922773893273 · 工具:paperreview.ai
- Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P.(2024)。Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models. arxiv.org/abs/2404.18796
- Zou Group。virtual-lab(代码仓库)。github.com/zou-group/virtual-lab
- Swanson, K., 等(2025)。The Virtual Lab of AI agents designs new SARS-CoV-2 nanobodies. Nature。nature.com/articles/s41586-025-09442-9
- Accelerating scientific discovery with Co-Scientist.(2026)。Nature。nature.com/articles/s41586-026-10644-y · deepmind.google/blog/co-scientist…
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I.(2023)。Improving Factuality and Reasoning in Language Models through Multiagent Debate. arxiv.org/abs/2305.14325
- Zheng, M., Pei, J., Logeswaran, L., Lee, M., & Jurgens, D.(2024)。When "A Helpful Assistant" Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models. Findings of EMNLP 2024。arxiv.org/abs/2311.10054 · aclanthology.org/2024.findings-emnlp.888
- Park, J. S., Zou, C. Q., Kamphorst, J., Egan, N., Shaw, A., Hill, B. M., Cai, C., Morris, M. R., Liang, P., Willer, R., & Bernstein, M. S. LLM Agents Grounded in Self-Reports Enable General-Purpose Simulation of Individuals (v1: Generative Agent Simulations of 1,000 People). arxiv.org/abs/2411.10109 · github.com/StanfordHCI/genagents
- Smit, A., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A.(2024)。 Should we be going MAD? A Look at Multi-Agent Debate Strategies for LLMs. ICML 2024. arxiv.org/abs/2311.17371
- Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J.(2026)。 Not All Flips Are Conformity: Decomposing Stance Convergence in Multi-Agent LLM Debate. arxiv.org/abs/2606.00820
- Deutsch, M., & Gerard, H. B.(1955)。 A study of normative and informational social influences upon individual judgment. The Journal of Abnormal and Social Psychology, 51(3), 629–636. semanticscholar.org/paper/…
相关阅读
研究素材包整理于 2026-08-06:共十一个来源,每条引文均在发表时逐字核验;无法直接获取的来源仅作描述,绝不虚构引用。 — Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app