AI-네이티브 시리즈 · 연구
열 개의 모자를 쓴 하나의 의견
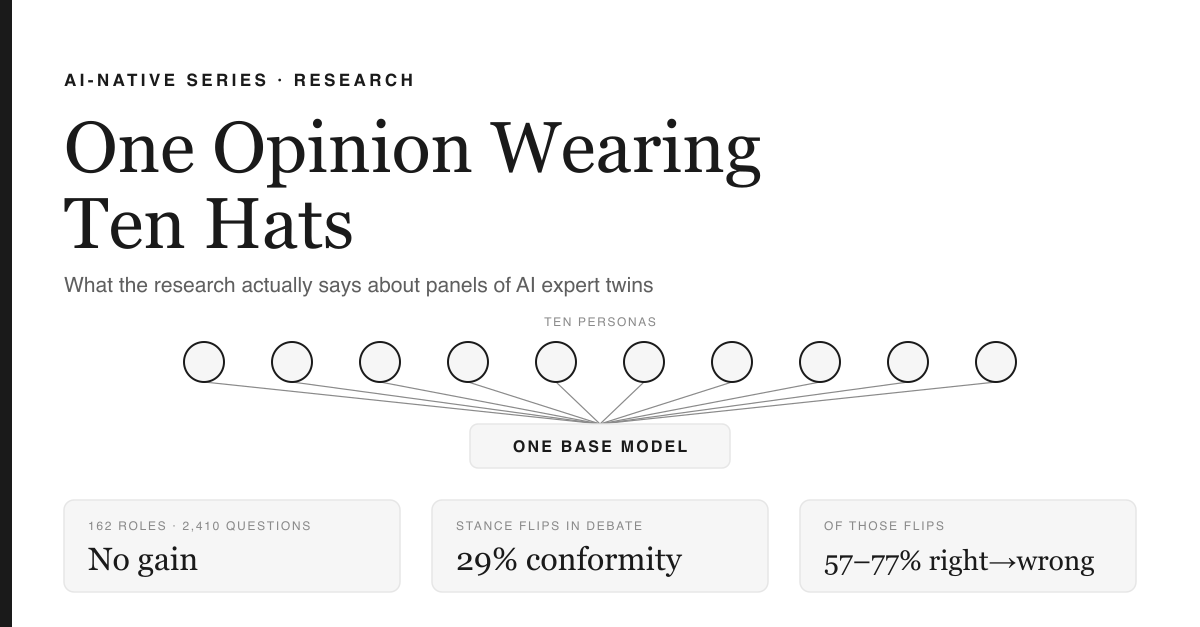
1분 요약 — 이 글에서 얻어갈 것
AI "도메인 전문가" 열 명을 즉석에서 만들어 내 작업물을 비판하게 하는 일은 패널을 꾸리는 것처럼 느껴진다. 하지만 측정해보면 대개 하나의 모델이 열 가지 폰트로 스스로에게 동의하고 있을 뿐이다. 페르소나 라벨은 사실적 정확도를 개선하지 않는다(162개 역할, 2,410개 질문, 페르소나 없음 대비 이득 없음). 토론은 나아지기 전에 먼저 나빠진다: 에이전트는 29%의 확률로 답을 뒤집으며, 그 뒤집힘의 57~77%는 정답에서 오답으로 향한다. 증거와 부딪히고도 살아남는 것은 좁지만 실제로 만들 수 있는 것들이다: 각 트윈을 형용사가 아니라 실제 코퍼스에 근거하게 하고, 서로 겹치지 않는 모델 계열에서 뽑아내고, 누구도 입을 열기 전에 봉인된 평결을 받아두고 — 그리고 아무도 하지 않는 일이지만 — 패널의 합의가 설득에서 나온 것인지 동조 압력에서 나온 것인지를 측정하라.
여기, 내가 품었던 환상이 있다. 그것도 아주 심하게.
당신은 어떤 연구 문제에 깊이 빠져 있다. 비용이 많이 드는 건 작업 자체가 아니라 기다림이다. 그 분야를 아는 누군가가 당신의 문제 설정을 보고 "그 질문은 이미 죽은 질문이고, 이유는 이렇다"라고 말해줘야 한다. 하지만 그 사람은 학회에 가 있다. 혹은 읽지 않은 이메일이 200통 쌓여 있다. 혹은 당신의 지도교수라서, 3주에 45분밖에 시간을 내주지 못한다. 그래서 당신은 눈감고 반복 작업을 한다. Andrew Ng는 정확히 이런 이유로 주말 동안 툴을 하나 만들었다. 그는 어떤 학생의 논문이 3년에 걸쳐 여섯 번 거절당했고, 매번 피드백을 받는 데 대략 6개월씩 기다렸다는 사실에서 영감을 받았다고 밝힌 바 있다 [1]. 인생의 3년이, 대부분 답장을 기다리며 흘러간 셈이다.
그래서 나는 생각했다. 기다리지 않으면 어떨까? 진짜 도메인 전문가 열 명을 AI 트윈 열 개로 압축해서, 각자 독립적으로 내 작업을 읽게 하고, 의견이 갈릴 때는 논쟁하게 만들면 어떨까? 새벽 2시에도 대기 중인, 샌드위치 한 개 값의 세계적 비평가 열 명.
나는 이것이 실제로 작동하는지 찾아 나섰다. 작동은 한다. 다만 이 직관적인 버전에 대해서는 거의 아무것도 살아남지 못하고, 실패하는 부분들은 쓸모없는 것보다 더 나쁜 방식으로 실패한다. 실패한 패널조차 확신에 찬 평결을 내놓기 때문이다.
좋은 소식부터: 배심원단이 판사를 이긴다
이 환상에 유리한 가장 강력한 결과는, 의외로 리서치 에이전트 논문이 아니라 평가 논문에서 나온다. Cohere 팀은 평범한 질문 하나를 던졌다. LLM으로 다른 LLM의 출력을 채점할 때, 크고 비싼 모델 하나를 써야 할까, 아니면 작은 모델 여러 개를 써야 할까? 그들의 답은, 원문 그대로:
"using a PoLL composed of a larger number of smaller models outperforms a single large judge, exhibits less intra-model bias due to its composition of disjoint model families, and does so while being over seven times less expensive." [2] (번역: 더 많은 수의 소형 모델로 구성된 PoLL을 사용하는 것이 하나의 거대 심판 모델보다 성능이 뛰어나며, 서로 겹치지 않는 모델 계열로 구성되어 있어 모델 내부 편향이 적고, 그러면서도 비용은 7배 이상 저렴하다.)
가운데 절을 두 번 읽어보라. 이 논증 전체를 떠받치는 핵심이 바로 거기 있다: 서로 겹치지 않는 모델 계열로 구성되어 있기 때문에. 패널이 이긴 것은 의견이 더 많아서가 아니다. 그 의견들이 서로 다른 사람이 서로 다른 데이터로 만든 기계에서 나왔기에, 오류들이 서로 겹치지 않았기 때문에 이긴 것이다. 이건 프롬프트 트릭이 아니다. 구조적 속성이며, 있거나 없거나 둘 중 하나다.
이 환상에는 진짜 성과도 있다. Virtual Lab에서는 수석연구원(PI) 에이전트가 전문가 에이전트들과 지정된 비평가를 두고 회의를 진행하며 — 저자들 스스로 이를 "과학 연구를 위한 AI-인간 협업"이라 표현한다 [3] — 이렇게 만들어진 파이프라인이 설계한 나노바디들은 실제로 실험대에서 검증되어 Nature에 게재되었다 [4]. Google의 Co-Scientist는 비슷한 구조(생성, 검토, 토너먼트 방식 순위 매김, 진화)로 돌아갔고, 2026년 실험실에서 검증된 가설들과 함께 Nature에 실렸다 [5]. 그리고 원조 멀티에이전트 논쟁 논문은 모델 인스턴스들이 "여러 라운드에 걸쳐 각자의 답변과 추론 과정을 제시하고 논쟁하게" 하는 것이 사실적 타당성을 개선하고 환각을 줄였다는 결과를 냈다. 저자들의 표현으로는 "마음들의 사회(society of minds)" 접근이다 [6].
AI 에이전트 패널들이 실제 분자와 실제 논문을 만들어냈다는 것, 이건 부정할 수 없는 사실이다. 좋다. 이제 청구서를 받을 차례다.
나쁜 소식: 코스튬은 아무 효과가 없다
열 명의 전문가를 만드는 직관적인 방법은 열 개의 시스템 프롬프트를 쓰는 것이다. "당신은 회의적인 로봇공학자다. 당신은 신중한 통계학자다. 당신은 이런 실패 사례를 온갖 버전으로 다 봐온 재료화학자다." 캐스팅처럼 느껴진다. 캐스팅처럼 읽힌다. Zheng과 동료들은 이 논증 자체를 무력화할 만한 규모로 이를 검증했다. 여섯 종류의 대인관계 유형과 여덟 개 전문 분야에 걸친 162개 역할을, 네 개 모델 계열에서 2,410개의 사실 확인 질문으로 실행한 것이다. 그들의 발견은, 원문 그대로:
"we demonstrate that adding personas in system prompts does not improve model performance across a range of questions compared to the control setting where no persona is added." [7] (번역: 시스템 프롬프트에 페르소나를 추가하는 것이, 페르소나를 전혀 추가하지 않은 대조 조건에 비해 다양한 질문 범위에서 모델 성능을 개선하지 않는다는 것을 우리는 입증한다.)
그리고 같은 초록에서, 이 관행에 마침표를 찍어야 할 문장이 하나 더 있다:
"while adding a persona may lead to performance gains in certain settings, the effect of each persona can be largely random." [7] (번역: 페르소나를 추가하는 것이 특정 상황에서는 성능 향상으로 이어질 수 있지만, 각 페르소나의 효과는 대체로 무작위적일 수 있다.)
대체로 무작위적. 작은 게 아니라 — 무작위적이라는 것이다. "당신은 X 분야의 세계적인 전문가입니다"라고 쓸 때, 당신은 전문성을 소환하는 게 아니다. 모델 자체의 사전 편향이 모든 면에 인쇄된 주사위를 굴리고 있는 것이다.
다른 연구에는 이를 위한 아름다운 대조 조건이 숨어 있다. Park와 동료들은 실제 미국인 1,052명의 에이전트를 만들어, 각 에이전트가 본인의 답변을 얼마나 잘 예측하는지를 측정했다. 그 기준으로 삼은 것은, 실제 그 사람이 2주 후 스스로를 얼마나 잘 예측하는가였다. 두 시간짜리 인터뷰로 만든 에이전트는 그 상한선의 83%를 기록했고, 구조화된 설문으로 만든 에이전트는 82%, 둘 다 사용한 경우는 86%였다. 그리고 인구통계 정보만으로 만든 에이전트는 74%를 기록했다 [8]. 이 연구에서 페르소나 라벨에 가장 가까운 것이 바로 이 경우인데, 예컨대 "당신은 오하이오 출신의 34세 대졸 여성입니다" 같은 식이다.
그 격차, 즉 74 대 83이라는 숫자 한 쌍에 이 논증 전체가 담겨 있다. 한 사람에 대한 라벨은, 그 사람의 실제 말보다 측정 가능할 만큼 가치가 낮다. 트윈은 코스튬이 아니라 코퍼스다.
더 나쁜 소식: 토론이 당신의 정답을 잡아먹을 수 있다
그래도, 하고 생각할 수 있다 — 평범한 트윈들이라도 서로 논쟁하다 보면 상대의 오류를 잡아낼지 모른다고. 바로 여기서 나는 설계를 바꿔야 했다.
Smit와 동료들은 토론 전략을 일반적인 프롬프팅과 벤치마크했고, 다음과 같이 그대로 보고했다:
"multi-agent debating systems, in their current form, do not reliably outperform other proposed prompting strategies, such as self-consistency and ensembling using multiple reasoning paths." [9] (번역: 현재 형태의 멀티 에이전트 토론 시스템은, 자기일관성이나 다중 추론 경로를 활용한 앙상블 같은 다른 제안된 프롬프팅 전략들을 신뢰성 있게 능가하지 못한다.)
이들의 진단은 헤드라인보다 훨씬 흥미로운데, 이걸 만들려는 사람이라면 누구에게든 건네고 싶은 내부자의 통찰이다. 이들은 토론이 나쁘다고 결론짓지 않는다. 대신 토론이 튜닝이 잘못됐다고 결론짓는다: MAD 프로토콜은 "다른 접근법들보다 본질적으로 열등한 것은 아닐 수 있지만 ... 서로 다른 하이퍼파라미터 설정에 더 민감하고 최적화하기 어렵다"는 것이며, 이들을 구제하는 구체적인 손잡이는 순응성이다 — 에이전트의 동의 수준을 조정하면 "성능을 크게 향상시킬 수 있고, 우리가 평가한 다른 모든 비토론 프로토콜을 능가할 수도 있다" [9]. 당신의 패널이 당신을 돕는지 속이는지를 결정하는 변수는 에이전트가 얼마나 똑똑한가가 아니다. 그것은 얼마나 쉽게 굴복하는가.
이다.인지 — 숙고인지, 순응인지 — 를 찾아 나섰다. MMLU-Pro에서, 원문 그대로:
"strict conformity is 29% in the primary setting and remains predominantly harmful across model replications (57-77% correct-to-wrong)." [10] (번역: 엄격한 의미의 동조는 주 실험 조건에서 29%를 차지하며, 모델 반복 실험 전반에 걸쳐 대체로 유해한 것으로 나타난다 (57~77%가 정답에서 오답으로 전환).)
그 숫자를 곱씹어보자. 입장이 바뀌는 경우 대략 열 번 중 세 번은 설득이 아니라 동조다. 그리고 그중 대다수는 정답을 갖고 있던 에이전트를 구슬려 오답으로 돌려놓는 경우다. 여러분의 패널은 나쁜 아이디어를 걸러내지 못하는 데서 끝나지 않는다. 좋은 답을 스스로 설득해서 버리는 성향이 문서로 확인된다: 좋은 답을 스스로 설득해서 버리는 성향, 그러고는 태연하게 그 합의를 여러분에게 건넨다.
이것은 바로 Twelve Angry Men이다. 다만 모든 배심원이 같은 사람이고, 그는 태어날 때부터 동조하도록 훈련받았다는 점만 다르다. Henry Fonda가 일어서서 무고한 소년을 구하는 단 하나의 반대 의견을 내놓고는, 방을 둘러보다 이미 고개를 끄덕이고 있는 열한 명의 자기 복제본을 발견하고 이렇게 말한다: "You know what, on reflection, you all raise excellent points." (번역: 있잖아요, 다시 생각해보니 다들 훌륭한 지적을 하셨네요.)
이 모든 것은 심리학에서 새로운 이야기가 아니다. Deutsch와 Gerard는 1955년에 인간이 굴복하는 두 가지 이유를 구분했다: 정보적 영향, 즉 누군가 증거를 제시해서 입장을 바꾸는 경우와 규범적 영향, 즉 남들과 다른 사람이 되고 싶지 않아서 동조하는 경우다 [11]. 사회적 압력을 제거한 상태에서도 사람들이 집단 속에서 더 많은 오류를 범했다는 그들의 결과는, 오늘날 출시되는 모든 멀티 에이전트 시스템에 붙어 있는 70년 된 경고 문구나 마찬가지다. 우리는 Asch의 선분 판단 실험을 실리콘으로 재현했고, 그것이 Asch의 선분 판단 실험과 똑같이 행동한다는 사실에 놀랐다.
멘탈 모델: 봉인된 봉투
간직할 가치가 있는 것은 모두 열다섯 살짜리도 이해할 수 있는 하나의 그림에 담긴다.
누구도 입을 열기 전에, 모두가 자기 답을 적어 봉투에 봉인한다. 그러고 나서 그 봉투를 전부 동시에 연다. 봉투들이 일치하면 끝이다 — 그 일치는 오염되지 않은 채로 공짜로 얻은 것이다. 일치하지 않으면 그제야 벌일 가치가 있는 논쟁이 생기고, 그 논쟁도 오직 실제로 의견이 갈린 지점에 대해서만 이루어진다. 그 후 누군가 마음을 바꾼다면, 그의 봉투로 돌아가 딱 한 가지만 묻는다: 무엇을 새로 알게 되어 마음을 바꾼 것인가? 새로 알게 된 것을 구체적으로 짚어낼 수 있다면 설득된 것이고, 짚어내지 못한다면 동조한 것이다.
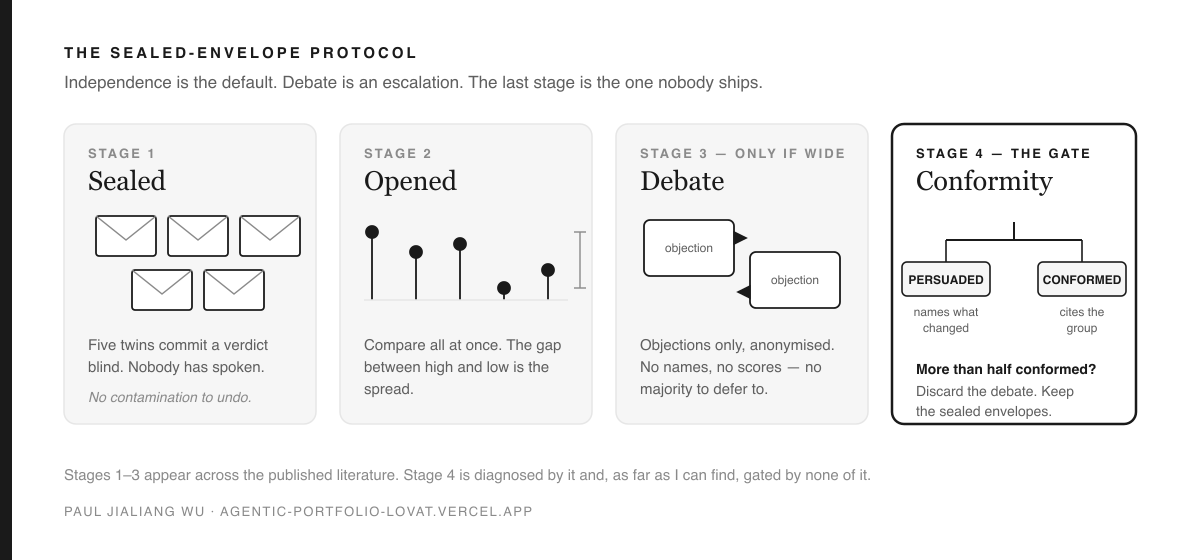
그 마지막 단계는 내 설계에는 이름이 있지만 문헌에는 이름이 없다. 위에서 인용한 논문들은 동조 현상을 훌륭하게 진단한다. 하지만 그중 어느 것도 이를 근거로 동조 게이트를 두지는 않는다 게이트를 두지 않는다. 그래서 나는 이렇게 하기로 했다.
동조 게이트. 각 트윈의 토론 전 입장을 기록해둔다. 토론이 끝난 뒤, 입장이 바뀐 경우를 다음과 같이 분류한다: 설득된 경우 — 트윈이 자신의 입장을 바꾼 구체적인 새 반론을 댈 수 있으면 설득된 것이고, 동조한 경우 — 집단을 이유로 대거나 무엇이 바뀌었는지 말하지 못하면 그것은 동조다. 입장 변화의 절반 이상이 여기 해당하면, 토론 결과는 버리고 밀봉된 평결만 남긴다.
구조화된 응답에 필드 하나, 나눗셈 한 번만 더하면 되는 일이다. 57~77%라는 수치에 맞설 보험치고는, 내가 아는 한 이보다 싼 것이 없다.
네 가지 규칙, 그리고 각각이 존재하는 이유
| 규칙 | 이유 |
|---|---|
| 코스튬이 아니라 코퍼스. 이름이 명시되고 검증 가능한 출처 — 논문, 강연, 리뷰, 코드 — 를 갖추지 못한 트윈은 인정하지 않는다. 무언가를 기준으로 측정된 충실도 점수도 반드시 있어야 한다. | 페르소나 라벨의 가치는 사실상 무작위 수준이다 [7]. 근거를 갖춘 에이전트는 인구통계 기반 에이전트를 83 대 74로 앞선다 [8]. |
| 다양성은 구조적이어야 한다. 두 트윈은 모델 계열과 코퍼스를 동시에 공유해서는 안 된다. 하나의 베이스 모델에 형용사만 다르게 붙인 것은 다양성이 아니다. | 패널의 우위는 서로 겹치지 않는 모델 계열에서 나왔지, 의견이 더 많다는 데서 나온 것이 아니다 [2]. |
| 독립성이 먼저, 토론은 예외적 확대 조치. 밀봉된 평결은 항상 받아두되, 토론은 견해 차이가 클 때만, 상한을 둔 채로만 진행한다. 반론은 익명 처리해 따를 만한 권위의 단서를 남기지 않는다. | 토론은 자기 일관성(self-consistency)을 안정적으로 이기지 못하며 [9], 규범적 영향력이 작동하려면 눈에 보이는 다수가 필요하다 [11]. |
| 불일치야말로 결과물이다. 평결과 그리고 살아남은 반대 의견을 그대로 인용하고 누구의 것인지 밝힌다. 트윈에게는 기권도 1급 답변으로 허용한다 — "내 코퍼스 밖의 문제"라는 답도 괜찮다. | 언제나 동의하는 패널은 아무것도 말해준 게 없는 것과 같다. 자기 영역 밖의 트윈에게 억지로 의견을 내게 하는 것은 자신감 있는 할루시네이션을 제조하는 방법일 뿐이다. |
패턴
- 산문이 아니라 구조화된 판정문. 입장, 점수, 확신도, 상위 세 가지 반론에 더해 반드시 채워야 할 항목이 하나 있다: 무엇이 내 생각을 바꿀 수 있는가. 입장을 미리 기록해두지 않으면 나중에 입장 전환을 분류할 방법이 없다.
- 측정된 편차를 기준으로 토론을 촉발하라, 일정에 따라서가 아니라. 합의 임계값은 직접 튜닝해야 하는 하이퍼파라미터다. 바로 이것이 그 하이퍼파라미터이기 때문이다 [9].
- 심판을 채점하라. 패널은 하나의 스코어링 함수다. 스코어링 함수는 외부의 무언가를 기준으로 캘리브레이션되거나, 아니면 '캘리브레이션되지 않음'이라는 딱지가 붙어야 한다. 조용히 넘어갈 수 있는 세 번째 선택지 같은 건 없다.
- 트윈에는 유효기간을 두라. 열여덟 달 전에 증류한 코퍼스는 그 이후로 공개적으로 생각을 바꿔온 전문가를 대표한다. 낡음은 감춰야 할 대상이 아니라 드러내 보여야 할 사실이다.
안티패턴
- 프롬프트 열 개, 모델 하나. 기본적으로 짜게 되는 구성이자, 증거가 무너뜨리는 바로 그 구성이다. 하나의 의견이 갖는 오류 프로파일에 열 배의 비용을 치르는 셈이다.
- 첫 턴부터 시작하는 라운드로빈 토론. 깨끗한 판정을 단 하나도 얻기 전에 모든 판정을 오염시킨다.
- 합의를 강제하는 것. "패널이 합의했다"는 관리자가 원하는 결과물이자, 애초에 패널을 소집한 목적인 정보를 파괴하는 결과물이다.
- 읽어보지도 않은 실제 인물의 이름을 트윈에 붙이는 것. 일반 모델 위에 유명인의 이름을 얹는 것은 의견을 딥페이크하는 짓이다. 실제 사람 이름을 딴 트윈에 정작 그 사람의 글은 읽어본 적도 없다면 — 이는 의견의 딥페이크다. 코퍼스를 인용할 수 없다면 그 이름을 쓰지 말라.
- 루프를 완전히 닫아버리기. 아래 참조 — 이 항목은 고칠 수 없다. 경계선일 뿐이다.
내가 설계로 우회할 수 없는 경계선
여기 솔직한 한계가 있다. 이것이 내가 새벽 2시의 환상을 통째로 팔지 않는 이유다.
이 글의 모든 충실도 수치는 인간과의 일치도로 정의된다. Park의 에이전트들은 본인 답변과 대조해서 채점된다[8]. Ng의 리뷰어에는 흥미로운 지점이 하나 있다. 인간 리뷰어와의 상관관계가 0.42 스피어만으로 보고되는데, 이 수치는 두 인간 리뷰어끼리의 상관관계인 0.41과 거의 같은 수준이라는 점이다[1]. "이것이 좋은 연구인가"를 판단할 독립적이고 인간과 무관한 기준자는 존재하지 않는다. 따라서 루프 안에 인간이 전혀 없는 트윈 패널은 어떤 오류 신호도 갖지 못한다. 그런 패널은 자신의 베이스 모델이 가진 사전 확률 쪽으로 확신에 차서 표류할 뿐이고, 그 표류는 정확히 합의처럼 보일 것이다. 실제로 합의이기 때문이다.
그로부터 나오는 진짜 주장은 환상보다는 작지만 그만큼 더 진실에 가깝다: 트윈은 전문가 체크포인트 사이의 대기 시간을 몇 달에서 몇 분으로 압축한다. 체크포인트 자체를 없애지는 않는다. Ng의 학생에게는 그것만으로도 3년과 주말의 차이다. 다만 "더 이상 전문가가 필요 없다"는 말과는 같은 문장이 아니다.
그래서 나는 하나의 설계가 모든 상황에 맞는다고 가정하는 대신, 깊이에 따라 규모를 조정하기로 했다. 1마일 깊이 — 단일 주장, 단일 결정: 트윈 세 명, 봉인된 라운드, 토론은 전혀 없이 몇 분 안에 끝낸다. 10마일 — 열 번에서 열다섯 번쯤 반복할 연구 질문: 트윈 다섯에서 일곱, 쟁점이 되는 주장에 대해서만 토론, 프레이밍 단계에서 휴먼 체크포인트 하나 — 프레이밍이 틀렸을 때 대가가 가장 크고 가장 눈에 안 띄는 지점이기 때문이다. 100마일 — 프로그램, 논문, 승부수: 지정된 회의론자와 인접 분야 출신 외부인을 포함해 트윈 일곱에서 열, 존재하는 경우 외부 오라클, 그리고 최소 세 번의 휴먼 체크포인트를 반드시 둔다. 대비책이 아니다. 100마일 패널과 아주 값비싼 메아리 사이를 갈라놓는 유일한 것이다.
제1원칙
패널이 한 명의 전문가보다 더 가치 있는 것은, 오직 구성원들이 서로 독립적으로 틀릴 수 있는 정도까지다 — 그러니 독립성은 아키텍처와 코퍼스로 확보하고, 실제로 확보했는지는 반드시 측정하라.
이 글의 모든 내용은 이 원칙의 파생물이다. 페르소나가 실패하는 이유는 코스튬이 그 밑에 깔린 오류 프로파일을 바꾸지 못하기 때문이다. 서로 겹치지 않는 모델 계열이 효과가 있는 이유는 실제로 오류 프로파일을 바꾸기 때문이다. 봉인된 봉투가 효과가 있는 이유는 오염이란 결국 사후에 도입된 상관된 오류일 뿐이기 때문이다. 그리고 동조 게이트가 존재하는 이유는 이렇다. 독립성은 한 번 설정해두면 유지되는 속성이 아니다. 에이전트들이 말을 섞기 시작하는 순간 조용히 새어나가는 속성이며, 그 새는 곳에 대해 책임 있게 할 수 있는 유일한 일은 계측하는 것이다.
내가 틀렸다는 걸 어떻게 알 수 있을지, 만들기 전에 미리 밝혀둔다: 코퍼스에 근거한 트윈이 홀드아웃 리뷰 과제에서 페르소나만 걸친 모델을 이기지 못한다면, 트윈 구축은 극장일 뿐이니 나는 저렴한 패널을 내놓아야 한다. 패널이 동일 비용의 자기 일관성(self-consistency) 기법을 쓴 강력한 모델 하나를 이기지 못한다면, Smit 등의 결과가 재현된 것이니 나는 멈춰야 한다. 어떤 익명화 설정을 쓰더라도 동조율을 절반 이하로 끌어내릴 수 없다면, 여기서 토론은 쓸 수 없는 것이니 나는 봉인된 라운드만 내놓아야 한다. 이 각각은 발표할 가치가 있는 무효 결과이며, 나는 합창을 시연하기보다 그런 무효 결과 하나를 발표하는 쪽을 택하겠다.
출처 — 검증된 것과 내 것
위의 모든 인용문은 발행 시점에 원문과 대조해 직접 확인되고 검증되었다. 두 가지 주장은 의도적으로 인용 부호 없이 표기했는데, 1차 출처를 직접 확인할 수 없었기 때문이다: Agentic Reviewer의 0.42 대 0.41 상관관계와, 3년에 걸쳐 여섯 번 거절당했다는 동기 부여 일화는 저자 본인이 공개 릴리스 포스트에서 밝힌 것을 여기서는 인용 없이 서술만 했다[1]. Virtual Lab의 Nature 및 bioRxiv 페이지는 내 페처에 403 에러를 반환했으므로, 해당 연구는 초록 기록과 저장소 자체 설명에서 인용했다[3][4]. 기록을 위해 바로잡아둘 것이 하나 있다: Park 등의 논문에서 널리 인용되는 "85%"라는 수치는 논문의 첫 번째 버전인 Generative Agent Simulations of 1,000 People에서 나온 것이다. 현재 버전은 1,052명의 참가자를 대상으로 74%의 인구통계학 정보만 사용한 베이스라인 대비 83/82/86%를 보고하며, 여기서 사용한 수치는 이 최신 버전의 것이다[8]. 봉인된 봉투 프로토콜, 동조 게이트, 네 가지 원칙, 그리고 깊이별 단계는 모두 내 자신의 설계로서, 비공개 저장소에 명세되어 있으며 아직 구현되지 않았다 — 어떤 구현도 주장하지 않으며, 전체의 정직한 상태는 "명세는 되었으나 측정되지 않음"이다.
참고문헌
- Ng, A. (2025). Release post for the Agentic Reviewer (Stanford ML Group), with Y. Jiang. (번역: Ng, A. (2025). Agentic Reviewer 릴리스 포스트 (Stanford ML Group), Y. Jiang과 공동.) x.com/AndrewYNg/status/1993001922773893273 · 도구: paperreview.ai
- Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models. arxiv.org/abs/2404.18796
- Zou Group. virtual-lab (레포지토리). github.com/zou-group/virtual-lab
- Swanson, K., et al. (2025). The Virtual Lab of AI agents designs new SARS-CoV-2 nanobodies. Nature. nature.com/articles/s41586-025-09442-9
- Accelerating scientific discovery with Co-Scientist. (2026). Nature. nature.com/articles/s41586-026-10644-y · deepmind.google/blog/co-scientist…
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving Factuality and Reasoning in Language Models through Multiagent Debate. arxiv.org/abs/2305.14325
- Zheng, M., Pei, J., Logeswaran, L., Lee, M., & Jurgens, D. (2024). When "A Helpful Assistant" Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models. Findings of EMNLP 2024. arxiv.org/abs/2311.10054 · aclanthology.org/2024.findings-emnlp.888
- Park, J. S., Zou, C. Q., Kamphorst, J., Egan, N., Shaw, A., Hill, B. M., Cai, C., Morris, M. R., Liang, P., Willer, R., & Bernstein, M. S. LLM Agents Grounded in Self-Reports Enable General-Purpose Simulation of Individuals (v1: Generative Agent Simulations of 1,000 People). arxiv.org/abs/2411.10109 · github.com/StanfordHCI/genagents
- Smit, A., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Should we be going MAD? A Look at Multi-Agent Debate Strategies for LLMs. ICML 2024. arxiv.org/abs/2311.17371
- Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Not All Flips Are Conformity: Decomposing Stance Convergence in Multi-Agent LLM Debate. arxiv.org/abs/2606.00820
- Deutsch, M., & Gerard, H. B. (1955). A study of normative and informational social influences upon individual judgment. The Journal of Abnormal and Social Psychology, 51(3), 629–636. semanticscholar.org/paper/…
관련 글
리서치 패킷 작성일 2026-08-06: 출처 11개, 모든 인용문은 발행 시점에 원문 대조로 축자 검증됨; 가져올 수 없었던 출처는 인용 없이 서술로만 처리함. — Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app