AI-Nativeシリーズ・研究
十の帽子をかぶった一つの意見
1分でわかる要点——ここから持ち帰れるもの
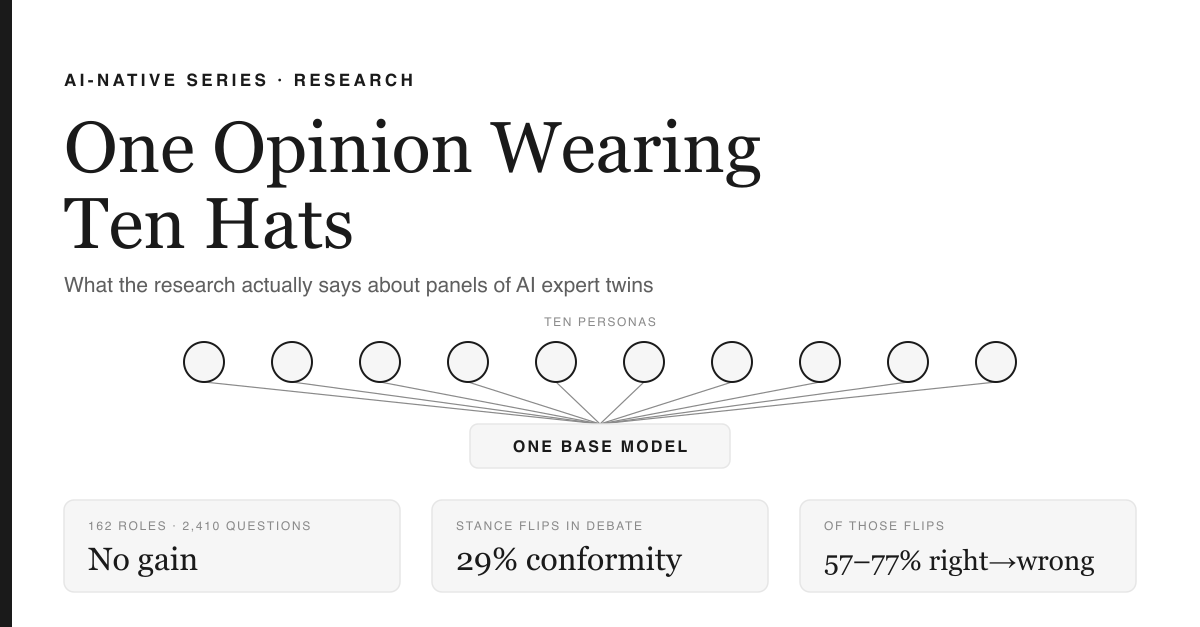
AIの「ドメインエキスパート」を十体立ち上げて自分の仕事を批評させる——それはパネルを組んでいるような気分にさせてくれる。だが実際に測ってみれば、たいていは一つのモデルが十通りのフォントで自分自身に同調しているだけだ。ペルソナのラベルは事実的な正確さを向上させない(162種類の役割、2,410問、ペルソナなしと比べて効果ゼロ)。ディベートは、良くなる前にまず悪くなる。エージェントは29%の確率で回答を覆し、その反転のうち57〜77%は正解から不正解へと転落する。証拠に耐えて生き残るものはわずかだが、作れる。形容詞ではなく実在のコーパスに各分身を根付かせること、切り離されたモデルファミリーから選び出すこと、誰かが発言する前に封をした評決を取ること——そして、まだ誰も実装していない部分だが——パネルの一致が説得によるものか、それとも同調圧力によるものかを見極めることだ。
ここに、その空想がある。私は見事にそれにハマっていた。
あなたは研究上の問題に深く入り込んでいる。高くつくのは作業そのものではない。それは待ち時間だ。その分野に通じた誰かに、自分の問い方を見てもらって「その問いはもう死んでいる、理由はこうだ」と言ってほしい。だがその人物は学会に出ているか、未読メールが200通たまっているか、あるいは指導教員で3週間後にようやく45分だけもらえる、そんなものだ。だから手探りで反復するしかない。Andrew Ngはまさにこれが理由で週末にツールを作り上げた。ある学生に触発されたと彼は語っている。その学生の論文は3年間で6回却下され、1回ごとにフィードバックにおよそ半年待たされたという [1]。人生の3年間が、その大半を郵送待ちに費やされたわけだ。
では、待たなくて済むとしたらどうだろう。10人の実在するドメインエキスパートをそれぞれAIツインに蒸留し、各自にあなたの研究を独立に読ませ、意見が割れたときには互いに議論させたらどうなるか。世界トップクラスの批評家が10人、深夜2時でも呼び出し放題、値段はサンドイッチ一つ分だ。
私はこれが本当に機能するのかを探ってみた。結論から言えば、機能する――ただし、この直感的なバージョンについてはほとんど何も生き残らない。しかも失敗する部分は、無用よりもさらにたちが悪い形で失敗する。なぜなら失敗したパネルでも、自信満々の判定は手渡してくるからだ。
まず良い知らせから:陪審は裁判官に勝る
この空想に有利な最も強力な結果は、リサーチエージェントの論文ではなく、評価手法についての論文から出ている。Cohereのチームは地味な問いを立てた——あるLLMに別のLLMの出力を採点させるとき、高価な大型モデル一つを使うべきか、それとも複数の小型モデルを使うべきか。彼らの答えを、そのまま引用する:
"using a PoLL composed of a larger number of smaller models outperforms a single large judge, exhibits less intra-model bias due to its composition of disjoint model families, and does so while being over seven times less expensive." [2](訳:より多数の小型モデルから成るPoLL(Panel of LLMs、複数LLMによる審査団)を用いる方が、単一の大型審査モデルよりも性能で上回り、互いに素なモデルファミリーで構成されているためモデル内バイアスも小さく、しかもコストは7分の1以下に抑えられる。)
真ん中の節を二度読んでほしい。そこが支えとなる要点だからだ。due to its composition of disjoint model families(訳:互いに素なモデルファミリーで構成されているために)。パネルが勝ったのは、意見の数が多かったからではない。作り手もデータも異なる機械から意見が出てきたからこそ、間違い方が揃わなかったのだ。プロンプトの小技ではない。構造上の性質であり、あるかないかのどちらかしかない。
この空想には、正真正銘のトロフィーケースもある。Virtual Labでは——著者らが「科学研究のためのAIと人間の協働」[3]と呼ぶこの仕組みでは——プリンシパル・インベスティゲーター役のエージェントが専門エージェントと指名された批評役を交えて会議を進行し、そのパイプラインが設計したナノボディは実際にベンチで試験され、Nature誌に掲載された [4]。GoogleのCo-Scientistも同様の構造(生成・査読・トーナメント方式でのランク付け・進化)を実行し、2026年には研究室で検証済みの仮説とともにNature誌に到達した [5]。そして最初のマルチエージェント討論論文では、複数のモデルインスタンスに「複数ラウンドにわたって個々の回答と推論過程を提案し討論させる」ことで事実性が向上し幻覚が減少したことが示されている——著者らの言葉を借りれば「精神の社会(society of minds)」的アプローチだ [6]。
つまりAIエージェントのパネルは、実在の分子と実在の論文を生み出してきた。良い話だ。さて、代償の話に移ろう。
悪い知らせ:コスチュームは何の役にも立たない
10人のエキスパートを作る直感的なやり方は、10通りのシステムプロンプトを書くことだ。You are a skeptical roboticist. You are a careful statistician. You are a materials chemist who has seen every version of this fail.(訳:あなたは懐疑的なロボット工学者だ。あなたは慎重な統計学者だ。あなたはこの手の失敗をあらゆるパターン見てきた材料化学者だ。)キャスティングのように感じられ、キャスティングのように読める。Zhengらは、この議論そのものを封じるほどの規模でこれを検証した。6種類の対人関係と8分野の専門性にまたがる162種のロール、4つのモデルファミリー上で2,410問の事実質問を実施した。彼らの発見を、そのまま引用する:
"we demonstrate that adding personas in system prompts does not improve model performance across a range of questions compared to the control setting where no persona is added." [7](訳:システムプロンプトにペルソナを追加しても、ペルソナを追加しない対照条件と比較して、幅広い質問においてモデルの性能は向上しないことを我々は示す。)
そして、同じ抄録にある、この慣行に終止符を打つべき一文がこれだ。
"while adding a persona may lead to performance gains in certain settings, the effect of each persona can be largely random." [7](訳:ペルソナの追加が特定の設定では性能向上をもたらすことがあるとはいえ、個々のペルソナの効果はおおむねランダムでありうる。)
おおむねランダム。小さいのではなく——ランダムなのだ。「あなたはXの世界的専門家である」と書くとき、あなたは専門性を呼び出しているのではない。モデル自身の事前分布を全ての面に印刷したサイコロを振っているにすぎない。
この点についての美しい対照実験が、別の研究に見つかる。Parkと共同研究者たちは1,052人の実在するアメリカ人のエージェントを構築し、各エージェントが本人の回答をどれだけ予測できるかを測定した。正規化の基準としたのは、その本人自身が2週間後に自分自身をどれだけ予測できるかだ。2時間のインタビューから構築されたエージェントはその上限の83%のスコアを記録し、構造化されたアンケートからは82%、両方からは86%だった。そして、人口統計情報のみから構築されたエージェント——本研究においてペルソナのラベルに最も近いもの、すなわち「あなたはオハイオ州出身の34歳、大卒の女性である」——は74%だった [8]。
この差、すなわち74対83こそが、この二つの数字に凝縮された議論の全てだ。ある人物についてのラベルは、その人物自身の実際の言葉より価値が劣る——それも測定可能なほどはっきりと。ツインとはコーパスであって、コスチュームではない。
さらに悪いニュース:ディベートは正解を食い潰しうる
まあいい、と思うかもしれない——凡庸なツインたちでも、議論させれば互いの誤りを捕まえられるのではないか、と。だが、まさにここで設計を変えざるを得なくなった。
Smitと共同研究者たちは、ディベート戦略を通常のプロンプティングに対してベンチマークし、こう報告している。
"multi-agent debating systems, in their current form, do not reliably outperform other proposed prompting strategies, such as self-consistency and ensembling using multiple reasoning paths." [9](訳:マルチエージェント・ディベートシステムは、現行の形態では、自己整合性や複数の推論経路によるアンサンブルといった他の提案済みプロンプティング戦略を、確実に上回るわけではない。)
彼らの診断は見出しよりもずっと興味深く、これを構築しようとする誰にでも手渡したい内輪の知見だ。彼らは「ディベートは悪い」とは結論づけていない。結論づけているのは、それが調整不足だということだ。マルチエージェント・ディベート(MAD)のプロトコルは「他のアプローチより本質的に劣っているわけではないかもしれないが……異なるハイパーパラメータ設定に対してより敏感であり、最適化が難しい」とされ、それを救う具体的なつまみは協調性だ——エージェントの同意水準を調整することで、「性能を大幅に向上させ、我々が評価した他の非ディベート型プロトコルの全てを上回ることさえある」[9]。あなたのパネルがあなたを助けるか、それとも欺くかを決める変数は、エージェントがどれほど賢いかではない。それはどれほど容易く屈するか.
だ。ここで、私の設計全体を作り直すことになった数字にたどり着く。Haoと共同研究者たちは、ディベートにおける収束が実際には何なのか——熟慮なのか、それとも同調なのか——を検証している。MMLU-Proにおいて、原文のまま引用すると:
"strict conformity is 29% in the primary setting and remains predominantly harmful across model replications (57-77% correct-to-wrong)." [10](訳:厳密な同調は主要な設定において29%を占め、モデルの再現実験全体にわたって、その大部分が有害な結果をもたらし続けている(正解から不正解への転換が57〜77%)。)
そこで少し立ち止まって考えてほしい。スタンスの変化のおよそ10件に3件は、説得ではなく同調によるものだ。しかもそのほとんどは、もともと正解を持っていたエージェントを言いくるめて、間違った答えに変えさせるという形で起きる。あなたのパネルは、悪いアイデアを見抜けないだけではない。実際には自ら議論して正しい答えを手放してしまう傾向が記録として裏付けられており、そのうえでその合意結果を澄まし顔で差し出してくるのだ。
これはまさに十二人の怒れる男だ。ただし陪審員全員が同一人物で、十二の違う帽子をかぶっているにすぎず、しかも生まれたときから同調するよう訓練されている。Henry Fondaが立ち上がり、無実の少年を救う唯一の反対意見を述べる。部屋を見回すと、すでに頷いている自分自身のコピーが十一人並んでいた。そこで彼はこう言う——「よく考えてみれば、皆さんのご意見はどれも実にもっともですね」。
こうしたことは心理学にとって何も目新しくはない。Deutsch と Gerard は1955年、人が屈服する理由を二つに分けている。ひとつは情報的影響——誰かが証拠を示したから考えを更新する場合。もうひとつは規範的影響——浮いた存在になりたくないから考えを更新する場合だ [11]。社会的圧力を取り除いてもなお人はグループの中でより多く誤りを犯した、というのが彼らの得た結果であり、今日出荷されているあらゆるマルチエージェントシステムに貼っておくべき、70年前からの警告ラベルにほかならない。我々はAschの線分判断実験をシリコン上で再現し、それがAschの線分判断実験そのままに振る舞ったことに驚いたのだ。
メンタルモデル:封印された封筒
残す価値のあるものはすべて、十五歳の子どもでも実行できる一枚の絵に収まる。
誰も話し始める前に、全員が自分の答えを書き、封筒に封をする。それから全員分を同時に開封する。もし封筒の中身が一致していれば、それで終わりだ——しかもその一致は、汚染されることなく、ただで手に入ったものである。もし食い違っていれば、そのときこそ議論する価値のある論点が生まれる。しかもその議論は、実際に意見が食い違った部分についてだけ行えばよい。その後、誰かが意見を変えたなら、その人の封筒に戻ってひとつだけ質問する——以前は知らなかった何を学んだのか?それを名指しできれば、その人は説得されたのだ。名指しできなければ、同調させられたにすぎない。
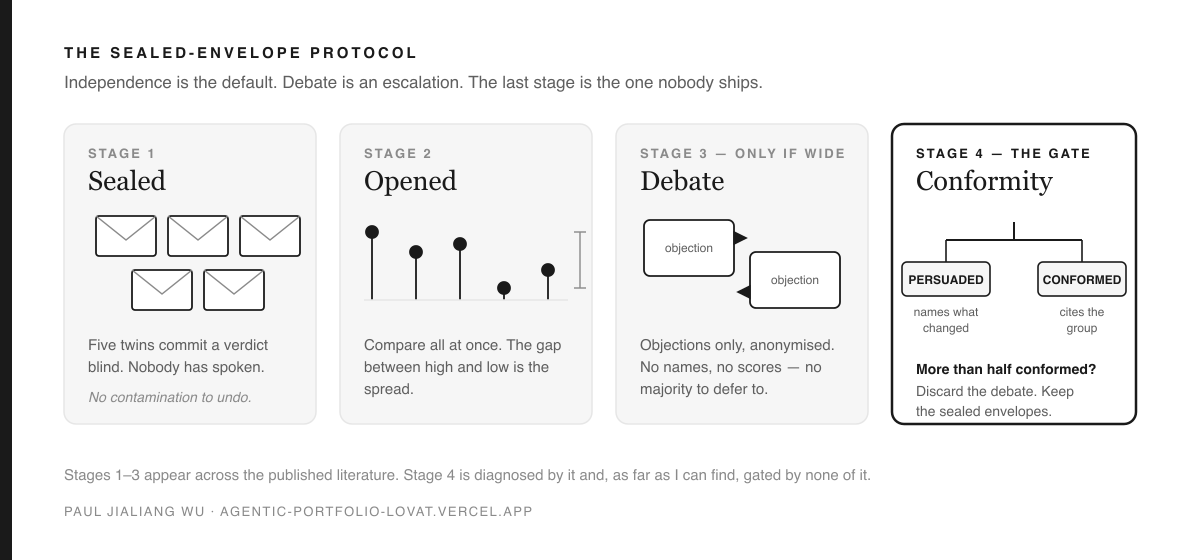
この最後のステップには、私の設計上の呼び名はあるが、私が見つけた文献の中には名前がない。上に挙げた論文群は、同調を診断する点では見事だ。だが、そのどれ一つとして、それをゲートする(歯止めをかける)ことはしていない についてだ。だから、こうする。
同調ゲート。 議論前の各ツインの立場を記録しておく。議論後、方向転換をそれぞれ分類する: 説得された ――ツインが自分を動かした具体的な新しい反論を挙げられる場合、 同調した ――集団を理由に挙げるか、何が変わったのか言えない場合。方向転換の半数以上が同調であれば、議論を破棄し、封印された評決だけを残す。
構造化された回答に一項目、割り算を一回加えるだけで済む。57〜77%というあの数字に対して、私が知る限り最も安上がりな保険だ。
四つのルールと、それぞれが存在する理由
| ルール | 理由 |
|---|---|
| コスチュームではなく、コーパスを。 名前のある、たどれる出典――論文、講演、査読、コード――と、何かに対して測定された忠実度スコアがないツインは認めない。 | ペルソナ・ラベルの価値はほぼランダムであり[7]、地に足のついたエージェントはデモグラフィックだけのエージェントに83対74で勝る[8]。 |
| 多様性はアーキテクチャで担保しなければならない。 二つのツインは、モデルファミリーとコーパスの両方を共有してはならない。一つのベースモデルに違う形容詞を付けただけでは多様性とは言えない。 | パネルの優位性は「disjoint model families(互いに独立したモデルファミリー)」から生まれたのであって、声の数が多いからではない[2]。 |
| 独立性を先に、議論はエスカレーションとして。 封印された評決は常に取る。議論はばらつきが大きいときだけ、上限を設けて行い、権威への追従が起きないよう反論は匿名化する。 | 議論はself-consistency(自己整合性)を確実に上回るわけではなく[9]、規範的影響力が働くには目に見える多数派が必要だ[11]。 |
| 不一致こそが成果物だ。 評決を出荷し、および 生き残った反対意見を、一字一句そのまま、発言者を明記して公開すること。ツインには「自分のコーパスの範囲外です」という一級市民の回答として棄権を許すこと。 | 常に全員一致するパネルは何も教えてくれない。専門外のツインに無理やり意見を言わせることは、自信満々のハルシネーションを製造するやり方そのものだ。 |
パターン
- 散文ではなく、構造化された評決を。 スタンス、スコア、確信度、上位三つの反論、そして必須項目が一つ——何があれば自分の考えが変わるか。立場を記録しておかなければ、あとで翻意を分類することはできない。
- 測定されたばらつきに基づいて討論を発火させる、スケジュール通りにではない。合意の閾値はチューニングすべきハイパーパラメータだ。なぜなら、それこそが肝心の変数だからだ [9]。
- 審判を採点せよ。 パネルとはスコアリング関数である。スコアリング関数は外部の何かに対して較正されるか、さもなくば「未較正」とラベルを貼られるかのどちらかだ。こっそり第三の道を選ぶことは許されない。
- ツインには有効期限を設けよ。 十八か月前に蒸留されたコーパスは、その後公に意見を変えたかもしれない専門家を表している。古びていることは隠すことではなく、示すことだ。
アンチパターン
- 十個のプロンプト、一つのモデル。 これがデフォルトの構築法であり、エビデンスによって葬られる構築法だ。あなたは一つの意見のエラープロファイルに対して十倍の代金を払っている。
- 最初のターンからの総当たり式の議論。 一つもクリーンな評決を得る前に、すべての評決を汚染してしまう。
- 合意を強制すること。 「パネルは合意しました」というのは、マネージャーが欲しがるアウトプットであり、パネルを招集した目的だった情報そのものを破壊するアウトプットだ。
- 読んだこともない実在の人物の名前をツインに付けること。 実在の人物の名前を、その人の論考を読んでもいないのに借りるのは、意見のディープフェイクだ。コーパスを引用できないなら、その名前を使ってはいけない。
- ループを完全に閉じること。 下記参照——これだけは修正の余地がなく、境界線があるだけだ。
工学的に回避できない境界線
ここに正直な限界がある。これこそ、私が「午前2時の幻想」をまるごと売り込まない理由だ。
この記事に登場するあらゆる忠実度の数値は、人間との一致によって定義されている。Parkのエージェントは、本人自身の回答に照らして採点されている[8]。Ngのレビュアーが興味深いのは、人間レビュアーとの相関がSpearmanで0.42と報告され、人間レビュアー同士の相関である0.41とほぼ同水準に位置しているからだ[1]。「これは良い研究か」を測る物差しは、人間を介さずに独立して存在するものではない。だから、ループに人間が一度も入らないツインパネルには誤差信号がまったく存在せず、ベースモデルの事前分布へと自信満々に漂流していく。そしてその漂流は、コンセンサスと見分けがつかない——見分けがつかなくて当然で、実質それはコンセンサスそのものだからだ。
そこから導かれるのは、幻想よりも慎ましいが、その分だけ本当の主張である。すなわち——ツインは専門家によるチェックポイント間の待ち時間を、数か月から数分へと圧縮する。だが、チェックポイントそのものをなくすわけではない。 Ngの学生にとって、それでも三年間と週末一回分の違いがあることに変わりはない。ただし、それは「もう専門家は不要だ」という文とは別物だ。
そこで私は、あらゆる設計に一つの型が万能だと装うのではなく、深さによってサイズを決めることにした。深さ1マイルとは、単一の主張、単一の意思決定を扱う局面を指す。ツインを三体用意し、封印した一巡だけで討論はせず、数分で完了させる。深さ10マイルは、十回から十五回は反復するであろう研究上の問いにあたる。ツインを五体から七体用意し、争点となる主張についてのみ討論を行い、フレーミングの段階で一度だけ人間のチェックポイントを挟む。フレーミングの局面こそ、誤りが最も高くつき、しかも最も見過ごされやすいからだ。深さ100マイルは、プログラムや学位論文、大きな賭けにあたる局面だ。指定された懐疑派と隣接分野からの部外者を含めてツインを七体から十体用意し、存在する限りの外部オラクルを当て、最低でも三回の人間チェックポイントを必須とする。これは念のために付け加える保険ではない。100マイル規模のパネルと、目の玉が飛び出るほど高くつく単なるこだま(エコー)とを分ける、唯一の境目である。
第一原理
パネルが一人の専門家より価値を持つのは、そのメンバーが独立に間違いうる限りにおいてのみだ——だからこそ、アーキテクチャとコーパスによって独立性を買い取り、実際にそれが手に入ったかどうかを測定せよ。
この記事に書かれていることはすべて、この原理から導かれる帰結にすぎない。ペルソナが機能しないのは、衣装を着せてもその下にある誤差プロファイルが変わらないからだ。分離されたモデルファミリーが機能するのは、実際にそうだからだ。封印された封筒が機能するのは、汚染とは事後的に持ち込まれた相関誤差にほかならないからだ。そして同調ゲートが存在するのは、独立性が一度設定すれば済むような性質のものではなく、エージェントが話し始めた瞬間に静かに漏れ出していく性質のものだからだ。漏れに対して責任を持ってできる唯一のことは、それを計測することである。
構築する前に述べておく、私が間違っていると分かる方法。もしコーパスに基づくツインが、held-outのレビュー課題において素のペルソナに勝てなければ、ツインの構築は演劇にすぎず、私は安価なパネルの方を出すべきだ。もしパネルが、同等コストの自己整合性を備えた一つの強力なモデルに勝てなければ、Smitらの結果が再現されたということであり、私はやめるべきだ。もしどのような匿名化設定のもとでも同調を五割未満に抑え込めなければ、ここでは討論は使い物にならず、私は封印された一巡のみを出すべきだ。そのいずれもが、公表に値するnull結果であり、私は合唱を実演するより、そうしたnull結果を一つでも公表したい。
来歴——何が検証済みで、何が私自身のものか
上記の引用はすべて、公開時点でその出典に照らして取得・逐語検証済みである。二つの主張だけは、一次情報源から取得できなかったため、意図的に引用符で括っていない。Agentic Reviewerの0.42対0.41という相関、および三年間で六回の却下という動機は、著者自身が公開のリリース投稿で報告しているものであり、ここでは引用ではなく記述として扱っている[1]。Virtual LabのNatureおよびbioRxivのページは、私のフェッチャーに対して403を返したため、その研究は抄録レコードとそのリポジトリ自身の説明から引用している[3][4]。記録として一つ訂正しておくべき点がある。Parkらの広く引用されている「85%」という数値は、論文の第一版——タイトルはGenerative Agent Simulations of 1,000 People(訳:千人の生成エージェント・シミュレーション)——に由来するものだ。現行版では、1,052人の参加者に対して、人口統計のみを用いたベースライン74%に対し83/82/86%と報告されており、本稿で用いているのはこちらの数値である[8]。封印封筒プロトコル、同調ゲート、四つのルール、そして深さのはしごは、私自身の設計であり、非公開のリポジトリに仕様として記載されているのみで、まだ構築されていない——実装を主張するものではなく、この試み全体の正直な現状は「仕様化済み、未計測」である。
参考文献
- Ng, A. (2025). Release post for the Agentic Reviewer (Stanford ML Group), with Y. Jiang. x.com/AndrewYNg/status/1993001922773893273 · ツール: paperreview.ai
- Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models.(訳:陪審は裁判官に代わる——多様なモデルによるパネルでLLMの生成を評価する) arxiv.org/abs/2404.18796
- Zou Group. virtual-lab(リポジトリ)。 github.com/zou-group/virtual-lab
- Swanson, K., et al. (2025). The Virtual Lab of AI agents designs new SARS-CoV-2 nanobodies.(訳:AIエージェントのバーチャルラボが新型SARS-CoV-2ナノボディを設計する) Nature. nature.com/articles/s41586-025-09442-9
- Accelerating scientific discovery with Co-Scientist.(訳:Co-Scientistによる科学的発見の加速) (2026). Nature. nature.com/articles/s41586-026-10644-y · deepmind.google/blog/co-scientist…
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving Factuality and Reasoning in Language Models through Multiagent Debate.(訳:マルチエージェント討論による言語モデルの事実性と推論の改善) arxiv.org/abs/2305.14325
- Zheng, M., Pei, J., Logeswaran, L., Lee, M., & Jurgens, D. (2024). When "A Helpful Assistant" Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models.(訳:「役に立つアシスタント」が本当は役に立たないとき——システムプロンプト中のペルソナは大規模言語モデルの性能を改善しない) Findings of EMNLP 2024. arxiv.org/abs/2311.10054 · aclanthology.org/2024.findings-emnlp.888
- Park, J. S., Zou, C. Q., Kamphorst, J., Egan, N., Shaw, A., Hill, B. M., Cai, C., Morris, M. R., Liang, P., Willer, R., & Bernstein, M. S. LLM Agents Grounded in Self-Reports Enable General-Purpose Simulation of Individuals (v1: Generative Agent Simulations of 1,000 People). arxiv.org/abs/2411.10109 · github.com/StanfordHCI/genagents
- Smit, A., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Should we be going MAD? A Look at Multi-Agent Debate Strategies for LLMs. ICML 2024. arxiv.org/abs/2311.17371
- Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Not All Flips Are Conformity: Decomposing Stance Convergence in Multi-Agent LLM Debate. arxiv.org/abs/2606.00820
- Deutsch, M., & Gerard, H. B. (1955). A study of normative and informational social influences upon individual judgment. The Journal of Abnormal and Social Psychology, 51(3), 629–636. semanticscholar.org/paper/…
関連記事
リサーチパケット作成日2026-08-06:出典11件、すべての引用は公開時点でフェッチにより逐語検証済み。フェッチ不能な出典は説明にとどめ、引用はしていない。 — Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app