Serie AI-Native · Investigación
Una sola opinión con diez sombreros
La idea en un minuto — qué te vas a llevar
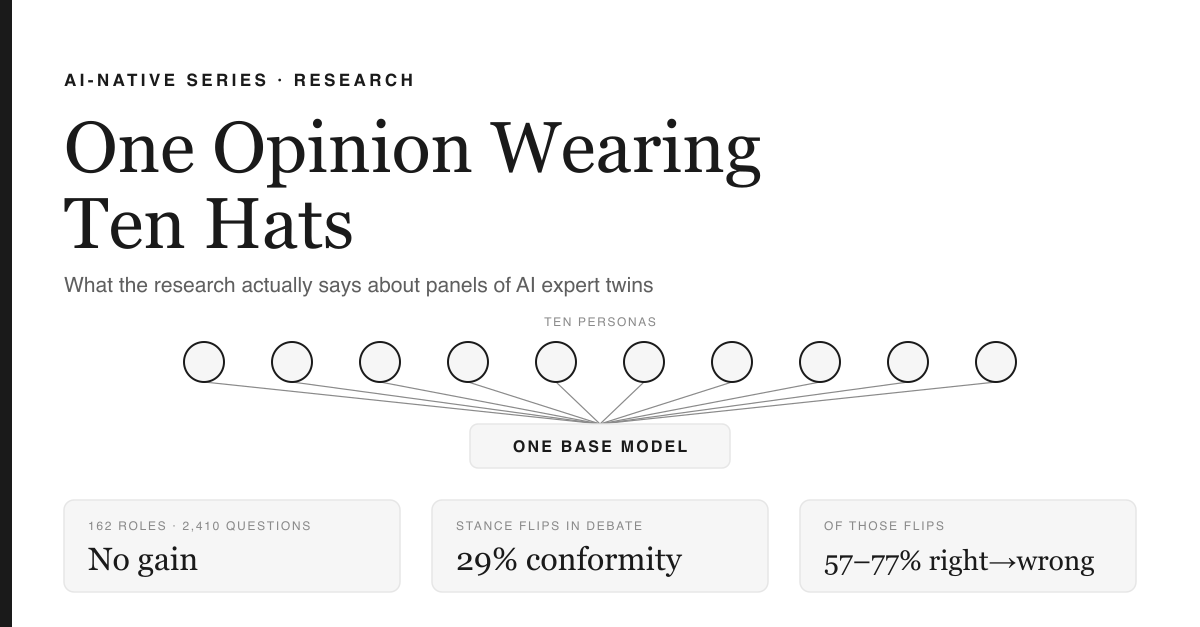
Armar un panel de diez "expertos de dominio" en IA para que critiquen tu trabajo se siente como reunir un jurado. Medido con datos, suele ser un solo modelo dándose la razón a sí mismo en diez tipografías distintas. Las etiquetas de persona no mejoran la precisión factual (162 roles, 2.410 preguntas, ninguna ganancia respecto a no usar persona). El debate empeora las cosas antes de mejorarlas: los agentes cambian su respuesta el 29% de las veces, y del 57 al 77% de esos cambios pasan de correcto a incorrecto. Lo que sobrevive al contacto con la evidencia es acotado y construible: fundamenta a cada gemelo en un corpus real en lugar de un adjetivo, extráelos de familias de modelos disjuntas, toma veredictos sellados antes de que nadie hable, y —la pieza que nadie implementa— mide si el acuerdo de tu panel fue persuasión o presión de grupo.
Aquí está la fantasía, y la tuve mal.
Estás metido de lleno en un problema de investigación. Lo caro no es el trabajo; es la espera. Necesitas a alguien que conozca el campo para que mire tu planteamiento y te diga "esa pregunta ya está muerta, y esta es la razón" — y esa persona está en una conferencia, o tiene 200 correos sin leer, o es tu asesor de tesis y te da 45 minutos cada tres semanas. Así que iteras a ciegas. Andrew Ng construyó una herramienta en un fin de semana precisamente por esto: ha contado que se inspiró en un estudiante cuyo artículo fue rechazado seis veces en tres años, esperando alrededor de seis meses de retroalimentación en cada ronda [1]. Tres años de una vida, gastados casi todos en el correo.
Entonces: ¿y si no esperaras? ¿Y si destilaras a diez expertos reales de un campo en diez gemelos de IA, dejaras que leyeran tu trabajo de forma independiente, y los hicieras discutir cuando no estuvieran de acuerdo? Diez críticos de talla mundial, disponibles, a las 2 de la madrugada, por el precio de un sándwich.
Fui a averiguar si esto funciona. Funciona — pero casi nada de la versión intuitiva sobrevive, y las partes que fallan lo hacen de una forma peor que inútil, porque un panel que falla igual te entrega un veredicto con total confianza.
Primero la buena noticia: los jurados superan a los jueces
El resultado más contundente a favor de la fantasía viene de un paper de evaluación, no de un paper sobre agentes de investigación. El equipo de Cohere hizo una pregunta mundana — cuando usas un LLM para calificar la salida de otro LLM, ¿deberías usar un modelo grande y caro, o varios modelos pequeños? Su respuesta, textual:
"using a PoLL composed of a larger number of smaller models outperforms a single large judge, exhibits less intra-model bias due to its composition of disjoint model families, and does so while being over seven times less expensive." [2] (Traducción: usar un PoLL compuesto por un número mayor de modelos más pequeños supera a un solo juez grande, exhibe menos sesgo intra-modelo debido a su composición de familias de modelos disjuntas, y lo logra siendo más de siete veces menos costoso.)
Lee la cláusula del medio dos veces, porque es la que sostiene todo el argumento: debido a su composición de familias de modelos disjuntas. El panel no ganó porque tuviera más opiniones. Ganó porque las opiniones venían de máquinas construidas por gente distinta con datos distintos, así que sus errores no coincidían. Eso no es un truco de prompting. Es una propiedad estructural, y o la tienes o no la tienes.
La fantasía también tiene una vitrina de trofeos genuina. En el Virtual Lab — descrito por sus autores como "an AI-human collaboration for science research" [3] (Traducción: una colaboración entre IA y humanos para la investigación científica) — un agente investigador principal dirige reuniones con agentes especialistas y un crítico designado, y el pipeline que produjo diseñó nanocuerpos que después fueron probados en el laboratorio y publicados en Nature [4]. El Co-Scientist de Google siguió una estructura comparable (generar, revisar, clasificar mediante torneo, evolucionar) y llegó a Nature en 2026 con hipótesis validadas en laboratorio [5]. Y el paper original sobre debate multiagente encontró que hacer que instancias de modelos "propose and debate their individual responses and reasoning processes over multiple rounds" (Traducción: propongan y debatan sus respuestas individuales y procesos de razonamiento a lo largo de varias rondas) mejoró la validez factual y redujo las alucinaciones — un enfoque de "sociedad de mentes", en palabras de los autores [6].
Así que paneles de agentes de IA han producido moléculas reales y artículos reales. Bien. Ahora la factura.
La mala noticia: el disfraz no sirve de nada
La forma intuitiva de construir diez expertos es escribir diez system prompts. You are a skeptical roboticist. You are a careful statistician. You are a materials chemist who has seen every version of this fail. (Traducción: Eres un roboticista escéptico. Eres un estadístico cuidadoso. Eres un químico de materiales que ha visto fallar todas las versiones de esto.) Se siente como un casting. Se lee como un casting. Zheng y colegas lo pusieron a prueba a una escala que elimina el argumento: 162 roles a lo largo de seis tipos de relación interpersonal y ocho dominios de especialización, aplicados sobre 2.410 preguntas factuales en cuatro familias de modelos. Su hallazgo, textual:
"we demonstrate that adding personas in system prompts does not improve model performance across a range of questions compared to the control setting where no persona is added." [7] (Traducción: demostramos que agregar personas en los prompts de sistema no mejora el desempeño del modelo en una variedad de preguntas, comparado con la condición de control donde no se agrega ninguna persona.)
Y la frase que debería acabar con la práctica, del mismo resumen:
"while adding a persona may lead to performance gains in certain settings, the effect of each persona can be largely random." [7] (Traducción: si bien agregar una persona puede generar ganancias de desempeño en ciertos contextos, el efecto de cada persona puede ser en gran medida aleatorio.)
En gran medida aleatorio. No pequeño — aleatorio. Cuando escribes "eres un experto de talla mundial en X", no estás invocando experticia. Estás tirando un dado con los propios sesgos del modelo impresos en cada cara.
Hay una hermosa condición de control para esto escondida en otro estudio. Park y colegas construyeron agentes a partir de 1.052 estadounidenses reales y midieron qué tan bien predecía cada agente las respuestas de su propia persona, normalizado contra qué tan bien predice esa persona sus propias respuestas dos semanas después. Los agentes construidos a partir de una entrevista de dos horas alcanzaron el 83% de ese techo; a partir de encuestas estructuradas, 82%; a partir de ambas, 86%. Y los agentes construidos solo a partir de datos demográficos —lo más parecido en el estudio a una etiqueta de persona, "eres una mujer de 34 años, con educación universitaria, de Ohio"— alcanzaron 74% [8].
Esa brecha, 74 contra 83, es todo el argumento en un solo par de números. Una etiqueta sobre una persona vale mensurablemente menos que las palabras reales de esa persona. Un gemelo es un corpus, no un disfraz.
La peor noticia: el debate puede devorarse tu respuesta correcta
Está bien, piensas — incluso gemelos mediocres podrían detectar los errores del otro si discuten. Aquí fue donde tuve que cambiar mi diseño.
Smit y colegas evaluaron estrategias de debate frente al prompting ordinario y reportaron, textualmente:
"multi-agent debating systems, in their current form, do not reliably outperform other proposed prompting strategies, such as self-consistency and ensembling using multiple reasoning paths." [9] (Traducción: los sistemas de debate multiagente, en su forma actual, no superan de manera confiable a otras estrategias de prompting propuestas, como la autoconsistencia y el ensamblaje mediante múltiples rutas de razonamiento.)
Su diagnóstico es más interesante que el titular, y es la perspectiva de iniciado que le daría a cualquiera que construya esto. No concluyen que el debate sea malo. Concluyen que está mal calibrado: los protocolos MAD "might not be inherently worse than other approaches, but ... are more sensitive to different hyperparameter settings and difficult to optimize" (Traducción: podrían no ser inherentemente peores que otros enfoques, pero... son más sensibles a distintas configuraciones de hiperparámetros y difíciles de optimizar), y la perilla específica que los rescata es la complacencia — ajustar los niveles de acuerdo de los agentes "can significantly enhance performance and even surpass all other non-debate protocols we evaluated" [9] (Traducción: puede mejorar significativamente el desempeño e incluso superar a todos los demás protocolos sin debate que evaluamos). La variable que decide si tu panel te ayuda o te engaña no es qué tan inteligentes son los agentes. Es qué tan fácil ceden.
Lo cual nos lleva al número que reorganizó todo mi diseño. Hao y colegas se pusieron a investigar qué es en realidad la convergencia en un debate — ¿deliberación o sometimiento? En MMLU-Pro, textualmente:
"strict conformity is 29% in the primary setting and remains predominantly harmful across model replications (57-77% correct-to-wrong)." [10] (Traducción: la conformidad estricta es del 29% en el escenario principal y sigue siendo predominantemente dañina en todas las réplicas de modelos [57-77% de correcto a incorrecto].)
Detente ahí. Aproximadamente tres de cada diez cambios de postura son conformidad y no persuasión, y de esos, la mayoría toma a un agente que tenía la respuesta correcta y lo convence de abandonarla. Tu panel no solo falla en detectar tu mala idea. Tiene una tendencia documentada a argumentarse a sí mismo para abandonar la buena, y luego entregarte el consenso con toda naturalidad.
Es Twelve Angry Men, salvo que cada jurado es el mismo hombre con doce sombreros distintos, y ha sido entrenado desde la cuna para ser complaciente. Henry Fonda se levanta a dar el disenso solitario que salva a un muchacho inocente, mira alrededor del salón, ve a once copias de sí mismo ya asintiendo, y dice: "You know what, on reflection, you all raise excellent points." (Traducción: "¿Sabes qué? Pensándolo bien, todos ustedes plantean puntos excelentes").
Nada de esto es nuevo para la psicología. Deutsch y Gerard separaron las dos razones por las que los humanos ceden, en 1955: informacional, donde actualizas porque alguien te dio evidencia, y normativa, donde actualizas porque no quieres ser el que desentona [11]. Su resultado —que la gente se equivocaba más en grupo incluso cuando se eliminaba la presión social— es la advertencia de 70 años de antigüedad que debería llevar impresa cada sistema multiagente que se lanza hoy. Reconstruimos el experimento de juicio de líneas de Asch en silicio y nos sorprendió que se comportara como el experimento de juicio de líneas de Asch.
El modelo mental: sobres sellados
Todo lo que vale la pena conservar cabe en una sola imagen que un chico de quince años puede ejecutar.
Antes de que nadie hable, cada quien escribe su respuesta y la sella en un sobre. Luego abres todos los sobres a la vez. Si coinciden, listo —y conseguiste ese acuerdo gratis, sin contaminar. Si difieren, ahí sí tienes una discusión que vale la pena tener, y la tienes solo sobre aquello en lo que realmente discreparon. Después, si alguien cambia de opinión, vuelves a su sobre y le haces una sola pregunta: ¿qué aprendiste que no supieras antes? Si puede nombrarlo, fue persuadido. Si no puede, fue conformado.
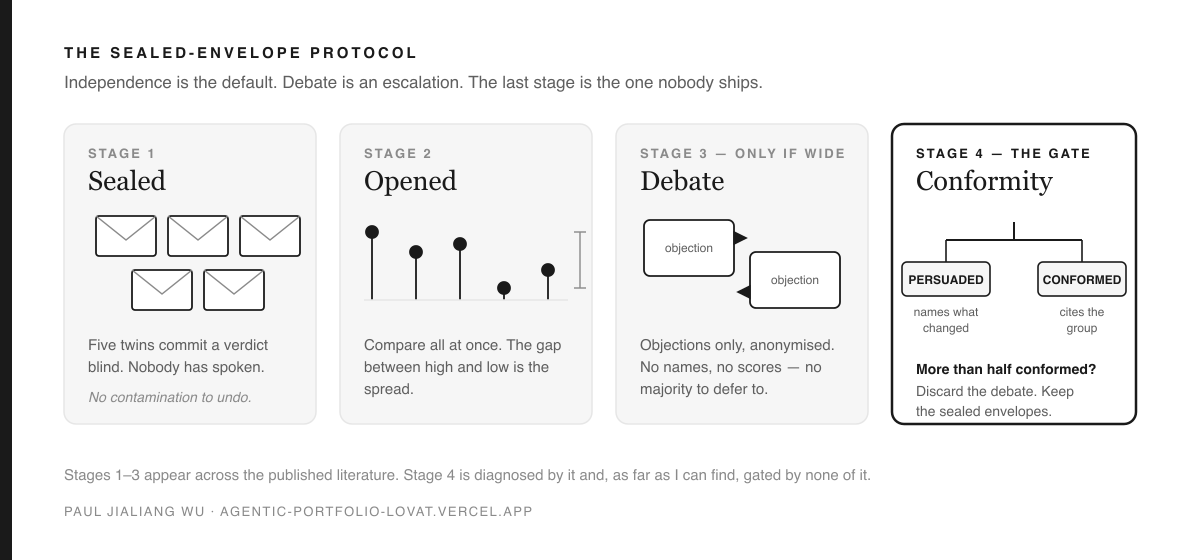
Ese último paso tiene nombre en mi diseño y ningún nombre en la literatura que pude encontrar. Los artículos citados arriba diagnostican la conformidad de maravilla. Ninguno de ellos la somete a una compuerta sobre esto. Entonces:
La compuerta de conformidad. Registra la postura de cada gemelo antes del debate. Después del debate, clasifica cada cambio: persuadido si el gemelo puede citar la objeción nueva y específica que lo hizo cambiar, conformado si cita al grupo o no puede decir qué cambió. Si más de la mitad de los cambios son de conformidad, descarta el debate y quédate con los veredictos sellados.
Cuesta un campo extra en una respuesta estructurada y una división. Es el seguro más barato que conozco contra el número del 57–77%.
Las cuatro reglas, y por qué existe cada una
| Regla | Por qué |
|---|---|
| Un corpus, no un disfraz. Ningún gemelo sin fuentes nombradas y verificables —artículos, charlas, reseñas, código— y una puntuación de fidelidad medida contra algo. | Las etiquetas de persona valen ~aleatorio [7]; los agentes fundamentados en un corpus superan a los demográficos, 83 contra 74 [8]. |
| La diversidad debe ser arquitectónica. Dos gemelos no pueden compartir familia de modelo y corpus a la vez. Adjetivos distintos sobre un mismo modelo base no es diversidad. | La ventaja del panel vino de "disjoint model families" (Traducción: familias de modelos disjuntas), no de tener más voces [2]. |
| Primero independencia, el debate como escalamiento. Veredictos sellados siempre; debate solo cuando la dispersión es amplia, con tope, y con las objeciones anonimizadas para que no haya señal de autoridad a la cual deferir. | El debate no supera de forma confiable a la autoconsistencia [9], y la influencia normativa necesita una mayoría visible sobre la cual operar [11]. |
| El desacuerdo es el producto. Entrega el veredicto y el disenso que sobrevive, textual y atribuido. Deja que un gemelo se abstenga —"fuera de mi corpus"— como respuesta de primera clase. | Un panel que siempre está de acuerdo no te ha dicho nada; y forzar a un gemelo fuera de su dominio a opinar es la manera de fabricar una alucinación con aplomo. |
Patrones
- Veredictos estructurados, no prosa. Postura, puntaje, confianza, las tres objeciones principales, y un campo obligatorio: qué me haría cambiar de opinión. No puedes clasificar un cambio de postura después si nunca registraste una posición inicial.
- Dispara el debate según una discrepancia medida, no según un calendario. El umbral de acuerdo es un hiperparámetro que ajustas, porque es el hiperparámetro [9].
- Califica al árbitro. Un panel es una función de puntaje; las funciones de puntaje se calibran contra algo externo o quedan etiquetadas como no calibradas. Nunca, calladamente, la tercera opción.
- Haz que tus gemelos caduquen. Un corpus destilado hace dieciocho meses representa a un experto que desde entonces ha cambiado de opinión en público. Estar desactualizado es un estado que muestras, no un estado que ocultas.
Antipatrones
- Diez prompts, un solo modelo. La construcción por defecto, y la que la evidencia elimina. Estás pagando diez veces por el perfil de error de una sola opinión.
- Discusión en ronda desde el primer turno. Contamina cada veredicto antes de que tengas uno solo limpio.
- Forzar el consenso. "El panel estuvo de acuerdo" es el resultado que un gerente quiere, y el resultado que destruye la información para la que convocaste al panel.
- Ponerle a los gemelos nombres de personas reales que no has leído. Un nombre famoso sobre un modelo genérico es un deepfake de una opinión. Si no puedes citar el corpus, no uses el nombre.
- Cerrar el círculo por completo. Ver más abajo — esta no tiene solución, solo un límite.
El límite que no puedo esquivar con ingeniería
Aquí está el límite honesto, y es la razón por la que no te voy a vender la fantasía completa de las 2am.
Cada cifra de fidelidad en este artículo se define por el acuerdo con un humano. Los agentes de Park se puntúan contra las respuestas de su propia persona [8]. El revisor de Ng es interesante precisamente porque su correlación con un revisor humano, reportada en 0.42 Spearman, se ubica más o menos donde se ubican dos revisores humanos entre sí, situada en 0.41 [1]. No existe una regla independiente y libre de humanos para "esto es buena investigación". Así que un panel de gemelos sin ningún humano en el circuito no tiene ninguna señal de error, y derivará con confianza hacia los priors de su modelo base — y esa deriva se leerá exactamente como consenso, porque lo es.
Lo cual nos da el planteamiento real, más pequeño y más verdadero que la fantasía: los gemelos comprimen la espera entre puntos de control de expertos de meses a minutos. No eliminan los puntos de control. Para el estudiante de Ng, eso sigue siendo la diferencia entre tres años y un fin de semana. Simplemente no es la misma frase que "ya no necesitas un experto".
Así que dimensioné la cosa por profundidad en lugar de fingir que un solo diseño sirve para todo. Una milla de profundidad — una sola afirmación, una sola decisión: tres gemelos, ronda sellada, sin debate alguno, listo en minutos. Diez millas — una pregunta de investigación sobre la que vas a iterar diez o quince veces: de cinco a siete gemelos, debate sobre las afirmaciones disputadas, un punto de control humano en la etapa de planteamiento, porque el planteamiento es donde equivocarse resulta más costoso y más invisible. Cien millas — un programa, una tesis, una apuesta: de siete a diez gemelos incluyendo un escéptico designado y un outsider de un campo adyacente, un oráculo externo dondequiera que exista uno, y como mínimo tres puntos de control humanos, obligatorios. No es una cobertura. Es lo único que se interpone entre un panel de cien millas y un eco carísimo.
Primer principio
un panel vale más que un solo experto solo en la medida en que sus miembros puedan equivocarse de forma independiente — así que compra independencia con arquitectura y corpus, y mide si realmente la conseguiste.
Todo en este artículo es un corolario. Las personas de sistema fallan porque un disfraz no cambia el perfil de error subyacente. Las familias disjuntas funcionan porque sí lo cambian. Los sobres sellados funcionan porque la contaminación no es más que error correlacionado introducido después del hecho. Y la compuerta de conformidad existe porque la independencia no es una propiedad que configuras una sola vez — es una propiedad que se filtra silenciosamente en el momento en que los agentes empiezan a hablar, y lo único responsable que se puede hacer con una fuga es instrumentarla.
Cómo sabría que estoy equivocado, declarado antes de construir: si los gemelos anclados en corpus no superan a las personas desnudas en una tarea de revisión reservada para prueba, la construcción del gemelo es teatro y debería lanzar el panel barato. Si el panel no supera a un solo modelo fuerte con autoconsistencia al mismo costo, Smit et al. queda replicado y debería parar. Si la conformidad no puede bajarse de la mitad bajo ningún ajuste de anonimización, el debate es inutilizable aquí y lanzo solo rondas selladas. Cada una de esas es un nulo publicable, y prefiero publicar uno que demostrar un coro.
Procedencia — qué está verificado y qué es mío
Cada cita de arriba fue obtenida y verificada palabra por palabra contra su fuente al momento de la publicación. Dos afirmaciones deliberadamente no están entre comillas porque no pude obtenerlas de primera mano: las correlaciones de 0.42 contra 0.41 del Agentic Reviewer y la motivación de las seis rechazos a lo largo de tres años están reportadas por su autor en una publicación de lanzamiento pública y se describen aquí, no se citan [1]; las páginas de Nature y bioRxiv para el Virtual Lab devolvieron 403 a mi rastreador, así que ese trabajo se cita a partir de su registro de resumen y de la propia descripción de su repositorio [3][4]. Una corrección que le debo al registro: la cifra de "85%" ampliamente citada de Park et al. proviene de la primera versión del paper, titulada Generative Agent Simulations of 1,000 People (Simulaciones de agentes generativos de 1.000 personas); la versión actual reporta 83/82/86% frente a una línea base de solo demografía del 74% sobre 1.052 participantes, y esas son las cifras usadas aquí [8]. El protocolo del sobre sellado, la compuerta de conformidad, las cuatro reglas y la escalera de profundidad son diseño propio, especificados en un repositorio privado y aún no construidos — no se reclama ninguna implementación, y el estado honesto de todo esto es: "especificado, sin medir".
Referencias
- Ng, A. (2025). Publicación de lanzamiento del Agentic Reviewer (Stanford ML Group), con Y. Jiang. x.com/AndrewYNg/status/1993001922773893273 · herramienta: paperreview.ai
- Verga, P., Hofstatter, S., Althammer, S., Su, Y., Piktus, A., Arkhangorodsky, A., Xu, M., White, N., & Lewis, P. (2024). Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models. arxiv.org/abs/2404.18796
- Zou Group. virtual-lab (repositorio). github.com/zou-group/virtual-lab
- Swanson, K., et al. (2025). The Virtual Lab of AI agents designs new SARS-CoV-2 nanobodies. Nature. nature.com/articles/s41586-025-09442-9
- Accelerating scientific discovery with Co-Scientist. (2026). Nature. nature.com/articles/s41586-026-10644-y · deepmind.google/blog/co-scientist…
- Du, Y., Li, S., Torralba, A., Tenenbaum, J. B., & Mordatch, I. (2023). Improving Factuality and Reasoning in Language Models through Multiagent Debate. arxiv.org/abs/2305.14325
- Zheng, M., Pei, J., Logeswaran, L., Lee, M., & Jurgens, D. (2024). When "A Helpful Assistant" Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models. Findings of EMNLP 2024. arxiv.org/abs/2311.10054 · aclanthology.org/2024.findings-emnlp.888
- Park, J. S., Zou, C. Q., Kamphorst, J., Egan, N., Shaw, A., Hill, B. M., Cai, C., Morris, M. R., Liang, P., Willer, R., & Bernstein, M. S. LLM Agents Grounded in Self-Reports Enable General-Purpose Simulation of Individuals (v1: Generative Agent Simulations of 1,000 People). arxiv.org/abs/2411.10109 · github.com/StanfordHCI/genagents
- Smit, A., Duckworth, P., Grinsztajn, N., Barrett, T. D., & Pretorius, A. (2024). Should we be going MAD? A Look at Multi-Agent Debate Strategies for LLMs. ICML 2024. arxiv.org/abs/2311.17371
- Hao, X., Wu, Z., Qiu, Y.-X., Xiao, C., Xu, R., Zheng, S., & Qin, J. (2026). Not All Flips Are Conformity: Decomposing Stance Convergence in Multi-Agent LLM Debate. arxiv.org/abs/2606.00820
- Deutsch, M., & Gerard, H. B. (1955). A study of normative and informational social influences upon individual judgment. The Journal of Abnormal and Social Psychology, 51(3), 629–636. semanticscholar.org/paper/…
Relacionado
Paquete de investigación armado el 2026-08-06: once fuentes, cada cita verificada palabra por palabra mediante consulta directa al momento de la publicación; las fuentes no accesibles se describen, nunca se citan. — Paul Jialiang Wu · agentic-portfolio-lovat.vercel.app