AI-NATIVE 시리즈 · 네 연령대의 수, 4부 중 마지막 · 20세
수와 표현: 모든 프로그래머가 처음 마주하는 추상화 (20세)
1분 요약
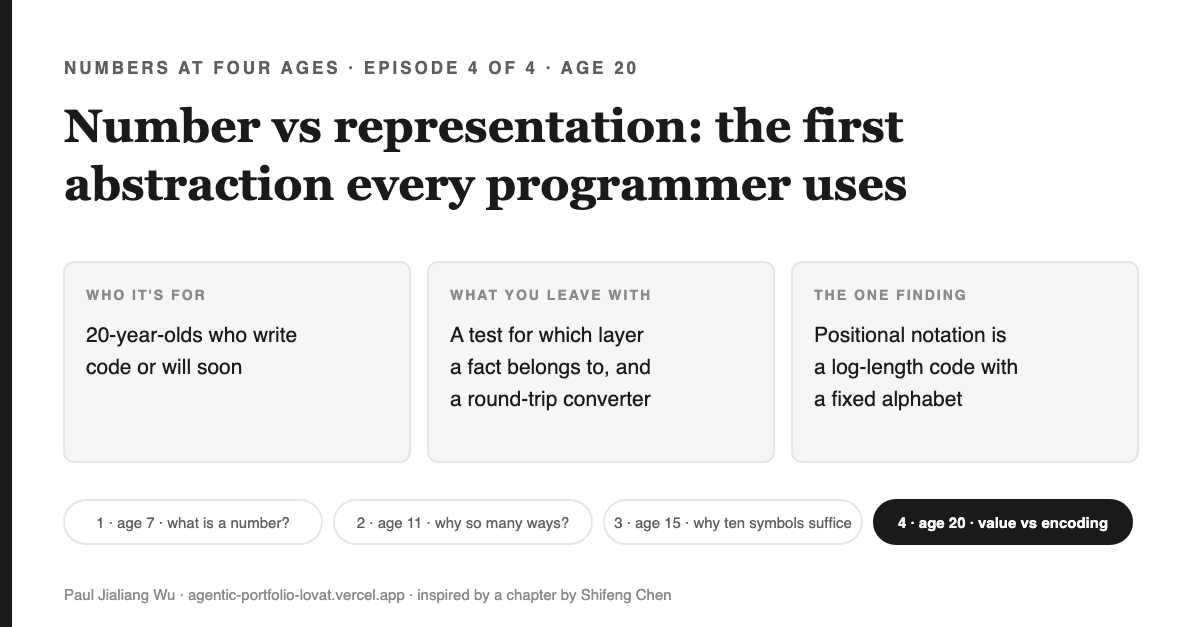
이 글의 성격20대 초반을 위한 엔지니어의 에세이다. 어린 시절 사과와 돌멩이로 만나는 '수는 이름이 아니다'라는 개념이, 추상 데이터 타입, 인코딩, 부동소수점, 유니코드 숫자 등 모든 추상화의 뿌리다.
왜 이 구분이 중요한가 버그는 값과 인코딩 사이의 틈에서 생긴다. 예를 들어, 0.1 + 0.2가 0.3이 되지 않는 현상, 같은 바이트를 누가 읽느냐에 따라 251이 될 수도 −5가 될 수도 있는 경우, 0이 없는 26진법으로 동작하는 스프레드시트 열 등이 모두 그렇다. 어떤 사실이 어느 계층(값, 인코딩, 표현)에 속하는지 구분하는 일은 매일 반복되는 엔지니어의 판단이다.
이 글을 읽고 할 수 있는 일 모든 수를 세 가지 인코딩으로 변환했다가 다시 원래대로 돌려놓는 변환기를 직접 만들어보고, 불변성(property) 테스트를 통과하는지 확인하라. 그리고 표현 방식에 의존하는 버그를 내 코드에서 하나 찾아내고, 자리값 증명을 15세에게 직접 설명해보라.
Numbers at Four Ages — 시리즈 줄기
▶ 실제로 돌아가는 모습 보기: 라이브 데모 열기 공개 · 로그인 불필요
- 7세 · 수란 무엇인가? 1화
- 11세 · 왜 숫자를 쓰는 방법이 이렇게 많을까 2화
- 15세 · 열 개 기호로 모든 수 쓰기 3화
- 20세 · 수와 표현의 구분 이번 화
프로그래머라면 왜 반드시 '수'와 '표현'의 차이를 알아야 하는가?
이번 편에서는 자리값 증명 자체는 다루지 않는다. 그 내용은 에피소드 3(15세)에서 다룬다. 연속적인 양(즉, 세는 것이 아니라 재는 것)은 다음 시즌의 주제다.
이번 편의 주제: 수와 표현의 구분
이 글은 '수와 표현', 즉 값과 그것을 적거나 저장하는 방식의 차이에 대한 엔지니어의 에세이다. 코드를 쓰거나 곧 쓰게 될 20세 전후의 독자를 위해 썼다. 파이썬이 설치된 노트북과 연습을 위한 15분만 있으면 충분하다.
네 편 중 마지막, 시리즈의 고리를 완성하는 글이다.
- 에피소드 1에서는 7세 아이에게 사과 다섯 개와 돌 다섯 개가 본질적으로 같은 수를 가진다는 것, 그리고 '5'라는 것은 그저 이름에 불과하다는 사실을 보여주었다.
- 에피소드 2에서는 11살 아이가 직접 숫자 체계를 만들어 보고, 자리값 표기가 왜 우위를 점하는지 체험하게 했다.
- 에피소드 3에서는 15살 아이에게 어떤 진법이든(0이 있든 없든) 모든 수가 오직 하나의 표기를 갖는다는 증명을 보여주었다.
이번 편에서는 바로 그 어린이의 통찰이 모든 프로그래머가 처음으로 마주치는 추상화임을 보여준다. 이 아이디어들은 장 (이 시리즈의 공저자인 陈诗峰(Shifeng Chen)이 쓴 '수와 그 표현'에 관한 장)을 따라간다. 한 걸음 더 나아가면, 이 생각들은 자신의 코드에 직접 적용해볼 수 있는 테스트로 이어진다.
이 시리즈는 부엌에서 시작해 사다리를 오르듯 한 장면을 따라간다. 그릇 속 달걀, 식당, 패스트푸드 창고를 지나, 이번에는 전국 식품 공급망의 최상단에 도달한다. 42개들이 한 상자가 여러 시스템을 거친다. 바코드는 한 방식으로 이를 인코딩하고, 창고 데이터베이스는 이 값을 이진 정수로 저장하며, CSV 내보내기는 "0042"라는 문자열로 기록하고, 스프레드시트는 AP 열에 저장한다. 수량은 변하지 않지만, 각 시스템은 저마다 다르게 기록한다. 공급망에서 발생하는 버그는 바로 그 틈에서 생긴다.
계속 읽기 전에 마지막에는 15살 아이에게 에피소드 3의 유일성 증명을 직접 설명하게 될 것이다. 직접 설명할 사람이라는 마음가짐으로 읽어라. 39건의 연구에서, '가르칠 것을 염두에 두고 공부한 뒤 실제로 가르치기'는 g = 0.48을 기록했고, 그런 기대 없이 공부한 뒤 가르치기는 g = −0.02 (Kobayashi (2024), Educational Psychology Review (ERIC EJ1414484)).
활동 1 · 한 손으로 31까지 세기(직접 발명해보기)
손가락을 하나씩 펴면 0부터 5까지 셀 수 있다. 아래를 읽지 말고, 한 손만으로 0부터 31까지 모든 수를 각기 다른 손가락 패턴으로 나타내는 방법을 직접 고안해보라. 어떤 수도 패턴이 겹치지 않게 하라.
이제 그 방법으로 19와 31을 손가락으로 표현해보라. 자신이 만든 규칙을 적어보라.
각 손가락이 바로 앞 손가락의 두 배(1, 2, 4, 8, 16)를 뜻한다면, 당신은 이진법을 발명한 것이다. 19는 16+2+1이고, 31은 다섯 손가락 모두를 편다. 같은 손, 같은 손가락 개수로 범위는 여섯 배가 된다. 표기법만 바꿨을 뿐, 수 자체는 전혀 변하지 않았다. 이 에세이의 핵심이 바로 이 한 동작에 응축되어 있다.
"같은 수"의 정의는 짝짓기이며, 표기는 인코딩이다
에피소드 1의 사과 게임은 결코 어린이용 단순화가 아니다. 바로 프레게가 산술의 기초로 삼았던 "같은 수"의 정의다. 수학의 기초에서, 두 집합이 같은 수를 가진다는 것은 그 사이에 일대일 대응(one-to-one correspondence)이 존재할 때이다. 이것이 바로 흄의 원리(Hume's Principle)로, 프레게의 1884년 산술 구성의 뿌리다(Zalta, Stanford Encyclopedia of Philosophy, "Frege's Theorem and Foundations for Arithmetic"). 이 정의 어디에도 숫자 기호는 등장하지 않는다.
A 표현(representation)은 그 값의 인코딩이다. 즉, 어떤 알파벳 위의 유한한 문자열과 읽는 규칙의 쌍이다. 10진법, 이진법, 로마 숫자, 빗금표, 레지스터의 비트 등은 모두 표현이다. 소프트웨어 공학에서도 같은 분리를 한다. 추상 데이터 타입은 값이 어떤 동작을 하는지를 정의하며, 저장 방식과는 분리된다. 이 개념은 1974 (Liskov & Zilles (1974), "Programming with abstract data types", ACM SIGPLAN Notices에서 처음 명확히 제시되었다. 숫자는 추상 데이터 타입의 원형이며, 모든 수 체계는 그 구체적 구현이다.
모든 인코딩에서 변하지 않는 성질을 불변성이라 한다. 인코딩에 따른 사실과 불변성을 구분하는 것이 이 글에서 다루는 핵심 훈련이다. 지금 Number Playground에서 직접 확인할 수 있다. 이 무료 페이지는 어떤 수든 아홉 가지 방식으로 변환해 보여주고, Chen의 분류 게임도 실행한다.
이 시리즈의 핵심은 한 줄로 정리된다. 수는 값이고, 표기는 인코딩이며, 올바른 코드는 오직 값에만 의존해야 한다.
위치 표기법이 선택받은 이유: 고정된 알파벳, 로그 길이의 코드
Chen의 장은 압축의 역사다. 엔지니어라면 이렇게 정확히 말할 수 있다.
- 막대기 표기는 n을 나타내려면 n개의 표시가 필요하다. 길이는 값에 비례해 선형적으로 늘어난다.
- 가법적 체계(로마, 이집트)는 더 짧지만, 수가 커질수록 새로운 기호가 필요하다. 이집트에는 백만을 위한 기호가 하나 있었지만, 그 이상은 없었다. 결국 막다른 골목이다.
- 진법 b의 위치 표기법은 1 + ⌊log_b n⌋개의 숫자만 있으면 된다(Weisstein, MathWorld, "Digit"). 길이는 값에 대해 로그로 증가하고, 알파벳의 크기는 늘어나지 않는다.
Chen의 문장에 따르면, 자리값 표기는 무한한 기호의 필요를 무한한 자리로 바꾼다.
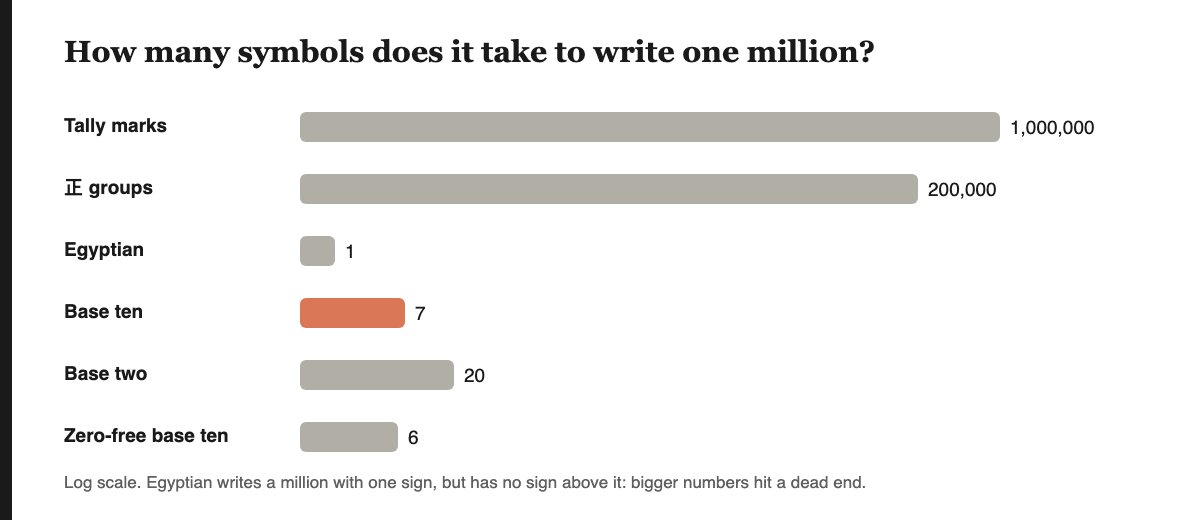
이 방식에는 대가가 있다. 빈 자리까지 모든 자리를 반드시 유지해야 하며, 이를 위해 자리 표시자 0이 필요하다. 하지만 0이 꼭 필수는 아니다.bijective(제로 없는) k진법에서는 숫자가 1부터 k까지 이어진다. 모든 양의 정수는 여전히 정확히 하나의 문자열로 표현되고, 빈 문자열이 0을 뜻한다. 우리는 이 시스템을 매일 쓴다. 스프레드시트의 열 A부터 Z, 그리고 AA, AB…는 모두 bijective 26진법이다. Excel에서는 16,384개의 열을 지원하며, 마지막 열은 XFD이다 (Microsoft, "Excel specifications and limits"): 24 × 26² + 6 × 26 + 4 = 16,384.
활동 2 · 변환기를 직접 작성하고, 반드시 보존되어야 할 속성을 검증하라
아래 예시를 보기 전에, 인코더 3종과 그 디코더를 직접 만들어보라. 0이 포함된 b진법, 0이 없는 10진법(1~9와 10을 나타내는 κ, Chen이 쓴 기호), 그리고 스프레드시트 열 라벨이다. 그리고 각 인코딩이 왕복 변환을 정확히 수행하는지, 특정 표현에만 성립하는 '사실'이 있는지 속성 테스트를 작성하라.
아래는 모든 검증(assertion)을 통과하는 예시 코드다:
DIGITS = "0123456789abcdefghijklmnopqrstuvwxyz"
def to_base(n, b):
    if n == 0:
        return "0"
    out = ""
    while n:
        n, r = divmod(n, b)
        out = DIGITS[r] + out
    return out
def from_base(s, b):
    return int(s, b)
def to_zero_free_ten(n):            # digits 1-9 and κ (ten); no 0
    out = ""
    while n:
        r = n % 10 or 10
        out = "123456789κ"[r - 1] + out
        n = (n - r) // 10
    return out
def from_zero_free_ten(s):
    n = 0
    for ch in s:
        n = n * 10 + "123456789κ".index(ch) + 1
    return n
def column_label(n):                # spreadsheet columns: zero-free base 26
    out = ""
    while n:
        r = n % 26 or 26
        out = chr(64 + r) + out
        n = (n - r) // 26
    return out
def column_number(s):
    n = 0
    for ch in s:
        n = n * 26 + ord(ch) - 64
    return n
assert to_zero_free_ten(3020) == "2κ1κ" and to_zero_free_ten(10**6) == "99999κ"
assert column_label(27) == "AA" and column_label(16384) == "XFD"
for n in range(1, 10_000):          # every encoding round-trips: the value is untouched
    assert from_base(to_base(n, 3), 3) == n
    assert from_zero_free_ten(to_zero_free_ten(n)) == n
    assert column_number(column_label(n)) == n
    assert (n % 3 == 0) == to_base(n, 3).endswith("0")              # true in base 3 ...
assert any((n % 3 == 0) != str(n).endswith("0") for n in range(1, 100))  # ... false in base ten: a fact about notation
마지막 두 검증을 보라. "3으로 나누어떨어지는 수는 마지막 자리가 0이다"라는 명제는 3진법에서는 항상 참이다. 하지만 마지막 줄은 이 명제가 10진법에서는 성립하지 않음을 보여준다(3은 3으로 나누어떨어지지만 끝자리는 3이다). 한 인코딩에서는 참이고 다른 인코딩에서는 거짓인 속성은, 그 수가 아니라 인코딩에 속한다. Chen의 분류 실험(아이들이 문장이 수에 관한 것인지, 표기에 관한 것인지 구분하는 실험)은, 값을 고정한 채 인코딩만 바꿔서 속성을 검증하는 것과 같다. b진법에서는 자릿수 합 규칙이 정확히 b − 1 (Weisstein, MathWorld, "Divisibility Tests"의 약수에 대해 성립한다. 즉, 우리가 익숙한 3과 9의 규칙은 10진법에 대한 사실이지, 3이라는 수 자체에 대한 사실이 아니다.
같은 비트, 다른 수: 코드에서 드러나는 대표적 사례
파이썬 프롬프트에서 직접 재현할 수 있는 세 가지 예시. 각각은 표현(인코딩) 계층의 사실이 값 계층으로 새어 나오는 경우다.
- 1바이트, 2개의 수. 비트 패턴 11111011이 바에 들어가자 바텐더가 묻는다. "251인가, −5인가?" 부호 없는 바이트로 읽으면 251이고, 8비트 2의 보수 정수로 읽으면 −5다. 비트는 완전히 동일하지만, 약속된 인코딩이 수를 결정한다. 두 시스템이 인코딩에 대해 합의하지 않으면 버그가 발생한다.
- 0.1 + 0.2는 0.30000000000000004이다. 이진 부동소수점은 1/10을 정확히 표현할 수 없다. 마치 10진법에서 1/3을 정확히 표현할 수 없는 것과 같다. 3진법에서는 1/3이 단순히 0.1이다. 값 자체는 문제가 없고, 인코딩이 반올림을 일으킨다.
0.1 + 0.2 == 0.3는 인코딩의 문제이므로, 수치 코드는 항상 허용 오차(tolerance)를 두고 비교한다. - 다섯 글자, 하나의 값. 문자 5, ٥, ५, Ⅴ, 五는 모두 유니코드 문자 데이터베이스에서 숫자 값 5를 가진다 (Unicode Character Database (UnicodeData.txt) and Unihan (U+4E94)). 파이썬의
int("٥")와int("५")는 5를 반환한다. 이들은 유니코드에서 10진수 숫자이기 때문이다. 반면int("五")와int("Ⅴ")는 의도적으로 ValueError를 발생시킨다.int숫자(digit)는 읽지만, 숫자 기호(numeral)는 읽지 않는다.unicodedata.numeric("五")는 5.0을 반환한다. 모든 파서는 이 경계를 반드시 어디선가 그어야 한다. 문제는 그 경계를 의식하지 않고 넘기는 데서 발생한다.
공급망에서 흔히 벌어지는 일: 제품 코드 "0042"가 스프레드시트에 입력되면 숫자 42로 바뀌고, 식별자의 일부였던 앞자리 0이 사라진다. 그 결과, 창고에서는 제품 0042(고무 오리)와 42(역시 고무 오리, 공급업체만 다름)를 동일한 것으로 착각해 오리를 두 배로 주문한다. 이 코드는 원래 수량이 아니라, 숫자 문자열로 저장된 식별자였다. 값이 어느 계층(값, 표현, 저장 방식) 중 어디에 속하는지 알았다면 이런 혼동은 막을 수 있었다.
지도와 예측: 숫자에도 몸이 있을까?
이 시리즈는 Paul의 '놀이 엔지니어링' 노트에서 가져온, 검증된 관점을 쓴다. 몸에는 영혼, 뼈, 살, 피부가 있다. 숫자 체계에선 다음과 같다.
- 영혼은 값이다.
- 뼈는 자릿값 구조, 즉 타입의 구조다.
- 살은 숫자 기호에 적용되는 알고리즘(올림, 비교, 파싱 등)이다.
- 피부는 글리프와 바이트다.
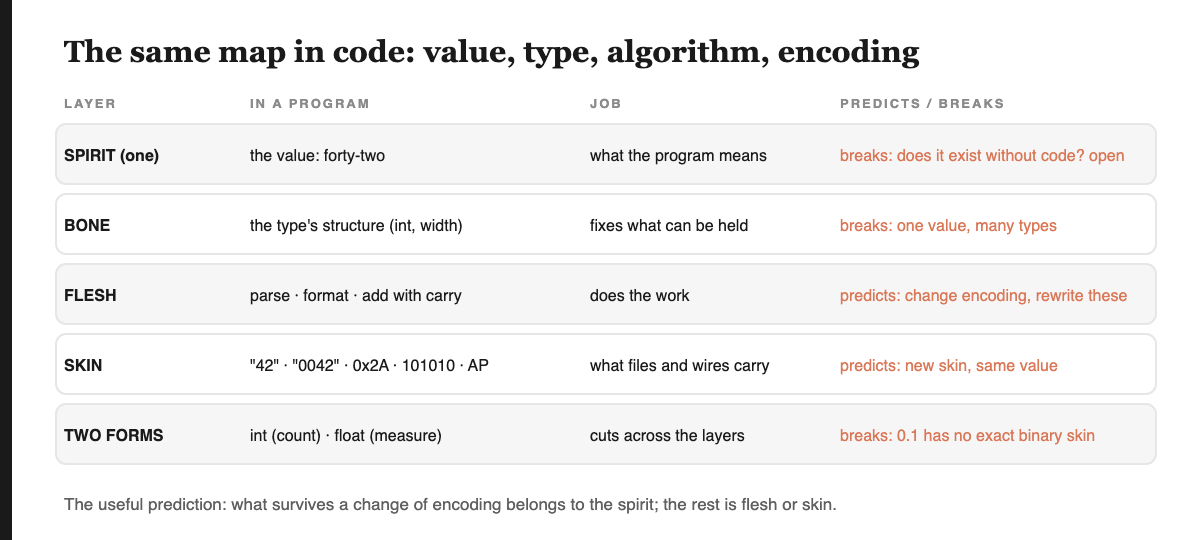
이 관점에서 내릴 수 있는 예측은 이렇다.인코딩을 바꿔도 변하지 않는 것은 값에 속하고, 인코딩을 바꾸면 깨지는 것은 구현 계층에 속한다.덧셈은 영혼에 해당하고, 올림 규칙은 살이다. 'N에 도달하면 하나 올린다'는 규칙만 있고, 밑이 바뀌면 N만 달라진다. 덧셈 자체는 변하지 않는다. 코드로 치면 '값 계층에서 성질을 테스트하고, 인코딩 특유의 사실은 인코딩 인터페이스 뒤에 숨겨라'가 된다.
이 지도에도 한계가 있다.
- 뼈(밑)를 바꿔도 영혼(값)은 유지할 수 있는데, 실제 몸에서는 이런 일이 불가능하다.
- "이산(discrete)과 연속(continuous)은 계층이 아니라 하나의 축이다. 아리스토텔레스는 이렇게 말했다: "양은 이산적이거나 연속적이다."" (아리스토텔레스, 『범주론』 6장, E. M. Edghill 번역 (MIT Internet Classics Archive)). 여기서 다루는 모든 것은 이산적 대상이다. 측정, 그리고 그에 따라 제대로 다루는 부동소수점 연산은 다음 시즌의 주제다.
- 정신(Spirit)이 독립적으로 존재하는지는 결정된 바 없다. 플라톤주의에서는 수가 실제로 존재하며, 추상적이고 어떤 마음에도 의존하지 않는다고 본다 (Linnebo, Stanford Encyclopedia of Philosophy, "Platonism in the Philosophy of Mathematics"). 반대로 명목주의에서는 추상적인 수라는 객체 자체가 존재하지 않는다고 본다 (Bueno, Stanford Encyclopedia of Philosophy, "Nominalism in the Philosophy of Mathematics"). 엔지니어라면 불가지론적 입장을 취할 수 있다. 중요한 것은 인터페이스다. 이것 자체가 하나의 철학적, 실용적 태도다.
왜 하나의 아이디어가 네 연령대 모두에 통하는가
이 시리즈는 Jerome Bruner의 The Process of Education (1960)에서 유래한 주장에 기대고 있다. 어떤 주제든 지적으로 정직한 방식이라면, 어느 발달 단계에서도 가르칠 수 있다는 것이다. 우리는 이 문장을 의도적으로 의역했다. 원문을 직접 확인하지 못했으므로 인용하지 않는다.
"정직함"의 기준은 바로 그 불변성 테스트다. 각 에피소드는 같은 핵심을 반복한다. 여기서 7살이 배운 것은 20살이 되어도 다시 배울 필요가 없다. 짝짓기 게임은 흄의 원리다. "5는 단지 이름일 뿐" 은 값과 인코딩의 분리다. 두 손가락 카운터 는 올림 규칙이다.
이 시리즈의 플레이북은 직접 확인할 수 있는 연구들 위에 세워졌다:
- 작업 기억은 3~5개의 청크를 유지한다 (Cowan (2001), "The magical number 4 in short-term memory", Behavioral and Brain Sciences 24).
- 초보자에게 도움이 되는 지원이 전문가에게는 해가 될 수 있다 (Kalyuga, Ayres, Chandler & Sweller (2003), "The Expertise Reversal Effect", Educational Psychologist 38).
- 가르칠 것을 염두에 두고 공부하는 것이 실제로 학습 효과를 높인다 (Kobayashi (2024), Educational Psychology Review (ERIC EJ1414484)).
내가 제시하는 또 하나의 관점이 있다. 나는 진리, 사랑, 아름다움이 각각 따로 떨어진 이상이 아니라 하나의 실재(Reality)의 세 가지 얼굴이며, 내 신앙에서는 한 인격의 세 가지 모습이라고 본다. 이 시리즈에서는 신앙과 무관하게 누구나 쓸 수 있는 엔지니어링 체크리스트이기도 하다. 한 교훈은 반드시 참(학습자가 직접 검증할 수 있어야 한다), 사랑(특정한 사람을 위해 쓰이고, 그 사람의 실수에서 만나야 한다), 아름다움(누군가에게 보여주고 싶은 한 순간이 있어야 한다)을 모두 갖춰야 한다.
- 사랑이 없는 진리는 아무도 따라올 수 없는 정답일 뿐이다.
- 진리가 없는 사랑은 거짓을 심는 재미있는 놀이에 불과하다.
- 진리와 사랑이 빠진 아름다움은 잘못된 역사를 담은 그럴듯한 인포그래픽일 뿐이다.
반쯤 맞는 흔한 오해들
- "0.1이 잘못 저장된다." 0.1은 명세대로 가장 가까운 이진 분수로 저장된다. 놀라운 것은 인코딩 방식이지, 오류가 아니다. 해결책은 허용 오차로 비교하거나, 소수형(decimal type)을 사용하는 것이다.
- "앞의 0은 중요하지 않다." 수량(값)에는 맞지만, 식별자에는 틀리다. "0042"가 상품 코드라면, 그저 숫자가 들어 있는 문자열일 뿐이다.
- "26진수 열 라벨은 그냥 알파벳이다." 이들은 0이 없는 위치적 수 체계다. 그래서 Z 다음이 BA가 아니라 AA가 오는 것이다.
이제 직접 가르쳐보라
당신의 teach-back. 15세 청소년을 찾아 "증명: 모든 수는 정확히 하나의 표기를 가진다"(episode 3)를 함께 풀어보라.episode 3 풀이 과정을 대신 써주지 말고, 352를 3으로 나눌 때 나머지가 무엇인지, 몫은 어떻게 되는지 물어보라. 그리고 아무도 숫자를 '선택'하지 않았다는 점을 스스로 깨닫게 하라.
결과: 그 15세 학생이 352를 3진법으로 나누는 나머지 과정을 혼자서 써보고(111001), 마지막 자릿수가 왜 정해질 수밖에 없는지 한 문장으로 설명한다. 그들의 나이와 결과를 이 글의 댓글로 남겨보라.
왜 중요한가: 다섯 번의 왜
문제: 데이터 파이프라인에서 상품 코드의 앞자리 0이 사라져 0042와 42가 합쳐지고, 두 상품이 하나로 처리되었다.
- 왜 코드가 합쳐졌는가?로더가 "0042"를 숫자 42로 해석했다. 두 문자열이 동일한 값으로 변환되면서, 식별자끼리 충돌하게 되었다.
- 왜 숫자로 해석되었는가?해당 필드가 실제로 무엇을 의미하는지 따지지 않고, 문자 모양(숫자만으로 이루어짐)만 보고 타입을 추론했기 때문이다.
- 왜 모양만 보고 추론했는가?시스템이 표현(숫자로 이루어진 문자열)을 값 그 자체로 착각했기 때문이다. 바로 Chen의 장에서 아이들에게 절대 혼동하지 말라고 가르치는 그 지점이다.
- 왜 이 오류가 잡히지 않았는가?값은 고정한 채 인코딩만 바꿔보는 테스트가 없었기 때문이다. 만약 값은 그대로 두고 인코딩만 바꾸는 테스트가 있었다면, 변환기의 10진법 대조선에서 3진법에서만 성립하는 '사실'이 10진법에서는 바로 깨지는 것처럼 즉시 오류를 잡았을 것이다.
- 근본 원인:코드가 값 계층이 아니라 표현 계층에 의존했다. 해결책은 이번 에피소드의 원칙이다: 값(수량인지 식별자인지)을 먼저 명확히 결정하고, 인코딩에 관한 사실은 반드시 인터페이스 뒤에 숨긴다 (Liskov & Zilles (1974), "Programming with abstract data types", ACM SIGPLAN Notices), 그리고 인코딩을 바꿔가며 불변성 테스트를 한다.
실행: 이번 주에 직접 실습해볼 것
- teach-ahead 문장을 먼저 읽는다.
- 한 손으로 31까지 세는 방법을 직접 만들어본다(2분).
- 세 가지 변환기와 불변성(property) 테스트를 작성한 뒤, 위의 예시와 비교한다(15분).
- 다음을 연다: 플레이그라운드. 16384와 1000000을 입력해 변환기가 각 행(특히 스프레드시트 열: 16384는 XFD)에 대해 올바르게 동작하는지 확인한다. 그리고 N-or-R 게임도 해본다.
- 자신의 코드에서 어떤 사실이 표현(예: 문자열 vs 숫자, 부동소수점 비교, 숫자만 파싱하는 코드 등)에 의존하는 부분을 하나 찾고, 불변성 테스트를 하나 추가한다.
- 15세 청소년에게 3화의 증명을 직접 가르쳐본다.
피드백: 제대로 실천했는지 확인하는 방법
- 직접 만든 변환기가 위의 모든 assertion을 통과한다.
- 자신의 코드에, 표현 관련 사실이 값 계층으로 새어 나오면 실패하는 새로운 불변성 테스트가 하나 추가되어 있다.
- 11111011이 왜 두 개의 숫자가 되는지, 0.1 + 0.2 ≠ 0.3이 이진 부동소수점에서 왜 발생하는지, Z 다음에 왜 AA가 오는지 각각 한 문장으로 설명할 수 있다.
일주일 뒤에 다시 점검하라. 테스트가 복습보다 효과적이었다: 1주 (Roediger & Karpicke (2006), "Test-Enhanced Learning", Psychological Science 17). 여기서 확인할 수 없는 것은, 이 습관이 마감 직전의 압박 속에서도 유지되는지다. CI에 속성 테스트를 두는 것이 그 역할을 대신한다.
피드포워드: 미리 설치하는 안전장치
- 필드가 모두 숫자라면, 먼저 그것이 수량인지 식별자인지부터 분명히 하라. 로더가 임의로 판단하기 전에, 그 결정을 스키마에 명확히 기록하라.
- 부동소수점 수를
==로 직접 비교하고 있다면, 즉시 멈춰라. 허용 오차를 사용하거나 decimal 타입을 쓰고, 0.1 + 0.2 테스트를 반드시 추가하라. - 파서가 ٥나 五를 만난다면, 의도적으로 선택하라: Python의
int는 ٥와 같은 유니코드 10진수 숫자는 받아들이고, 五나 Ⅴ 같은 숫자 기호는 설계상 거부한다. 어떤 문자를 시스템이 받아들이는지 명확히 문서화하고, 테스트하라.
이 에피소드의 진리, 사랑, 아름다움
- 진리: 모든 주장은 실제로 실행된다. 변환기의 assert가 모두 통과하고, 바이트와 부동소수점 예제는 어떤 Python 프롬프트에서도 재현된다.
- 사랑: 이 에세이는 15세 학생을 직접 가르쳐보게 하고, 흔히 나오는 실수마다 그 이유와 올바른 개념을 짚어준다.
- 아름다움: 다섯 개 사과에서 Excel의 마지막 열까지, 한 가지 아이디어가 모든 연령대에 단 한 번도 수정 없이 통한다. (1화에서 돌과 손을 잡았던 달걀은 이제 전국 트럭에 실린 0042번 상자가 되었다. 셈은 여전히 하나, 이름만 계속 바뀐다.)
5S 자기평가
| S | 주장 | 근거 |
|---|---|---|
| 단순함 | 이 글은 13학년 수준 이하의 독해력을 요구한다. | Flesch–Kincaid 난이도 등급: 8.4 (밴드 ≤ 13), 다음 기준으로 재계산됨: node scripts/check-numbers-four-ages.mjs |
| 견고함 | 모든 정의와 수치는 출처가 명확하며, 코드는 실제로 동작한다. | Excel의 16,384 열 (Microsoft); 흄의 원리 |
| 예리함 | 위치 표기법은 고정된 알파벳으로 로그 길이의 코드를 제공하며, 올바른 코드는 오직 값에만 의존한다. | 로그 길이 · 불변성 테스트 |
| SMART | 이번 주 실천: 변환기 작성 + 내 코드에 불변성 테스트 추가 + 한 번 가르쳐보기. | 실행 · 플레이그라운드 |
| 놀라움 | 당신의 스프레드시트는 처음부터 0 없는 26진법으로 숫자를 세고 있었다. | XFD = 16,384 |
| 진리 · 사랑 · 아름다움 | 검증 가능한 주장, 가르칠 대상, 그리고 모든 연령에 통하는 하나의 아이디어. | 진리, 사랑, 아름다움 |
출처
- 陈诗峰 (Shifeng Chen), 초고 《第一章 数和数的表示形式》(“Numbers and Their Representations”), 2026.원문 장(중국어 PDF) 읽기이 시리즈의 공동 저자.
- Zalta, E. N. "Frege's Theorem and Foundations for Arithmetic."Stanford Encyclopedia of Philosophy. plato.stanford.edu
- Liskov, B. & Zilles, S. (1974). Programming with abstract data types.ACM SIGPLAN Notices. Crossref 10.1145/942572.807045
- Weisstein, E. W. "Digit." MathWorld.mathworld.wolfram.com
- Weisstein, E. W. "Divisibility Tests." MathWorld.mathworld.wolfram.com
- Microsoft. "Excel specifications and limits."support.microsoft.com
- Unicode Character Database, UnicodeData.txt.unicode.org
- Aristotle.Categories6부, E. M. Edghill 번역.classics.mit.edu
- Linnebo, Ø. "Platonism in the Philosophy of Mathematics."Stanford Encyclopedia of Philosophy. plato.stanford.edu
- Bueno, O. "Nominalism in the Philosophy of Mathematics." Stanford Encyclopedia of Philosophy. plato.stanford.edu
- Cowan, N. (2001). The magical number 4 in short-term memory. Behavioral and Brain Sciences 24. doi:10.1017/S0140525X01003922
- Kalyuga, S., Ayres, P., Chandler, P. & Sweller, J. (2003). The expertise reversal effect. Educational Psychologist 38. doi:10.1207/S15326985EP3801_4
- Kobayashi, K. (2024). Interactive learning effects of preparing to teach and teaching. Educational Psychology Review. ERIC EJ1414484
- Roediger, H. L. & Karpicke, J. D. (2006). Test-enhanced learning. Psychological Science 17. doi:10.1111/j.1467-9280.2006.01693.x
- DeLamater, M. (1999), on Bruner's hypothesis. Education Week. edweek.org(2차 출처; 원문은 확인하지 않음)