AI-NATIVEシリーズ · 四つの年齢でたどる数 · 第4話(最終話)· 20歳
数と表現──すべてのプログラマが最初に出会う抽象化(20歳編)
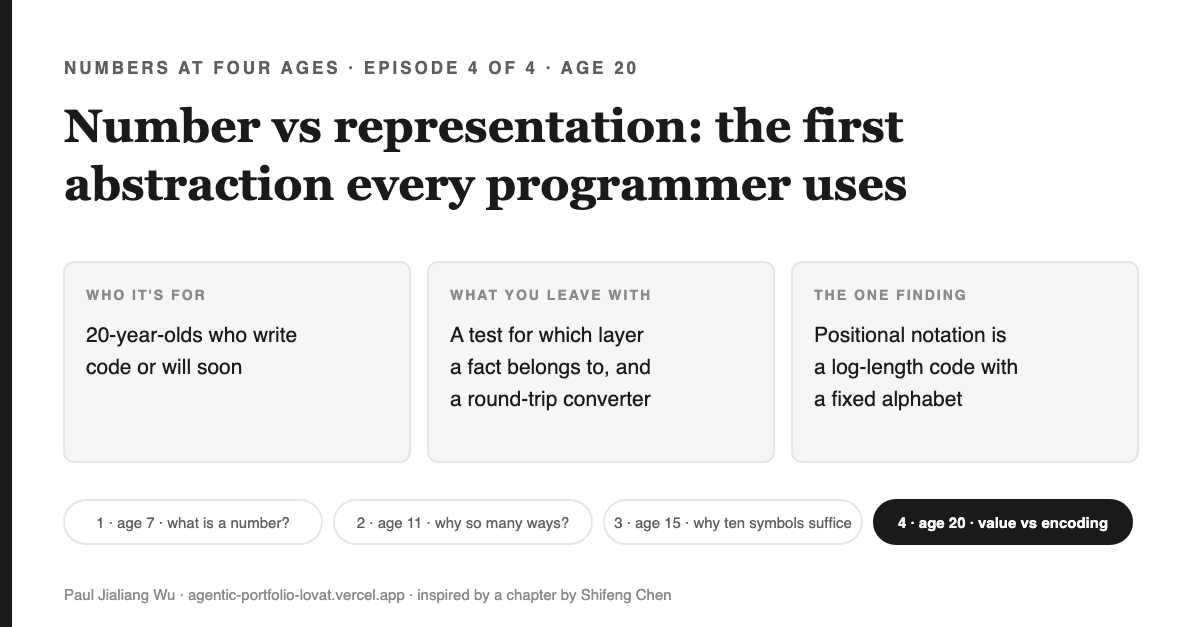
1分でつかむ要点
このエッセイについて 20歳前後のエンジニアに向けたエッセイ。子どもがリンゴや石で出会う「数はその名前ではない」という発想は、抽象データ型・エンコーディング・浮動小数点・Unicode数字の根底にある同じ抽象化だ。
なぜこれが大事なのか バグは「値」と「エンコーディング」の間のすき間に潜む。たとえば、0.1 + 0.2 が 0.3 にならない現象、同じバイト列が読む側によって 251 にも −5 にもなること、スプレッドシートの列がゼロのない26進数で表されていることなどが典型例だ。どの事実がどの層に属するかを見極めるのは、エンジニアの日常的な判断材料である。
このエピソードを読んだ後にできること すべての数を3種類のエンコーディングで往復変換し、不変性テストを通すコンバーターを書こう。自分のコードから表現依存のバグを一つ見つけ、さらに15歳の子に位取りの証明を教えてみてほしい。
Numbers at Four Ages — シリーズの背骨
▶ 動いているところを見る:ライブデモを開く 公開 · ログイン不要
- 7歳編 · 数ってなに? 第1話
- 11歳 · なぜ数字の書き方はこんなに多いのか? 第2話
- 15歳編 · 十個の記号ですべての数 第3話
- 20歳編:数と表現の違い この回
なぜ「数」とその表現の違いを、すべてのプログラマーが知っておくべきなのか?
このエピソード自体では位取りの証明は扱わない。それは第3話(15歳編)で取り上げる。連続量(数えるのではなく測るもの)は次のシーズンのテーマだ。
この回のテーマ:数と表現の違い
「数」と「表現の違い」について、エンジニアの視点から語るエッセイだ。値そのものと、それがどのように書かれたり保存されたりするかの違いに焦点を当てる。対象は、すでにコードを書くか、これから書く予定の20歳前後の読者。Pythonが動くノートPCと、演習に15分あれば十分だ。
全4話の最終回であり、ここでシリーズの円が一つつながる。
- 第1話 では、7歳の子どもに「リンゴ5個と石5個は同じ数を持つ」こと、そして「5」というのは単なる名前にすぎないことを伝えた。
- エピソード2 では、11歳の子どもが自分で数の体系を考案し、位取り記数法がなぜ勝つのかを体験した。
- エピソード3 では、15歳の子どもに、どんな基数でも(ゼロあり・ゼロなし問わず)すべての数がただ一通りの綴りを持つことを証明してみせた。
このエピソードでは、子どもの頃に出会う「数とその表し方の違い」という発想が、実はすべてのプログラマが最初に使う抽象化そのものであることを示す。ここで扱うアイデアは、章(本シリーズ共著者・陈诗峰(Shifeng Chen)による「数とその表現」)に基づいている。さらに一歩進めると、それは自分のコードで実際に動かせるテストになる。
このシリーズは、キッチンの一場面から始まり、卵の入ったボウル、レストラン、ファストフードの倉庫と、段階的にスケールアップしていく。そして最終地点は、全国規模の食品サプライチェーンだ。42カートン入りの箱が十数種類のシステムを通過する。バーコードはある方法でそれをエンコードし、倉庫のデータベースはバイナリ整数として保存し、CSVエクスポートは文字列"0042"を書き、スプレッドシートはAP列に記録する。数量自体は変わらないのに、システムごとに表し方が異なる。このギャップこそが、サプライチェーンのバグの温床となる。
この先を読む前に 最後には、15歳の子どもにエピソード3の一意性証明を説明することになる。つまり、誰かに説明するつもりで読んでほしい。39件の研究をまとめたところ、「教えるつもりで学習した」場合の成績はg = 0.48、一方「教えるつもりなし」で学習した場合はg = −0.02 (Kobayashi (2024), Educational Psychology Review (ERIC EJ1414484)).
アクティビティ1 · 片手で31まで数える(まず自分で考案)
指を1本立てるごとに1と数えるなら、片手で0から5まで数えられる。ここから先は読まずに、0から31までのすべての数に対して一意の指パターンができ、どれも重複しないような数え方を自分で考えてみてほしい。
その方法で19と31を表現し、考案したルールを書き出してみよう。
もし各指が前の指の2倍(1, 2, 4, 8, 16)を意味するなら、あなたは2進法を発明したことになる。19は16+2+1、31は5本すべての指。手も指の本数も同じまま、数えられる範囲は6倍になった。表現を変えただけで、数そのものは変わらない。これがこのエッセイの本質を、たった一つの動作で体現している。
「同じ数」とはペアを作ることで定義され、表現はエンコーディングである
エピソード1のリンゴ遊びは、単なる子ども向けの単純化ではない。「同じ数」の定義そのものであり、Fregeが算術の基礎を築いた根拠だ。数学の基礎論では、2つの集合が「同じ数」を持つのは、一対一対応 が存在する場合に限る。これはヒュームの原理であり、Fregeが1884年に算術を構築した根底にある(Zalta, Stanford Encyclopedia of Philosophy, "Frege's Theorem and Foundations for Arithmetic"(訳:「ザルタ、スタンフォード哲学百科事典『フレーゲの定理と算術の基礎』」))。この定義には数字という言葉は一切出てこない。
A 表現 とは、その値をエンコードしたもの、すなわち何らかのアルファベット上の有限な文字列と、それを読むためのルールの組み合わせだ。十進法、二進法、ローマ数字、棒線、レジスタ内のビット列、これらはすべて表現である。ソフトウェア工学でも同じ分離があり、「抽象データ型」は値が何をするかと、それがどう保存されるかを分けて考える。抽象データ型とは、値が持つ本質的なふるまいのことであり、保存方法とは切り離されている。この考え方は1974 (Liskov & Zilles (1974), "Programming with abstract data types", ACM SIGPLAN Noticesで示された。数は抽象データ型の元祖であり、あらゆる記数法はその具体的な実装の一つだ。
どのエンコーディングでも変わらず成り立つ性質は不変量と呼ばれる。エンコーディング固有の事実と不変量を見分ける力こそ、このエッセイで鍛えるスキルだ。今すぐNumber Playgroundで体験できる。任意の数を9通りに表現し、Chenのソートゲームも遊べる無料ページだ。
シリーズの根幹はこの一文に尽きる。「数は値、表現はエンコーディング、正しいコードは値だけに依存する」。
なぜ位取り記法が勝ったのか――固定されたアルファベットで対数長のコード
Chenの章は圧縮の歴史そのものであり、エンジニアならこう言い切れる。
- 棒をn本並べる方式なら、nを書くのにn本必要で、長さは値に比例して増える。
- 加法的な記数法(ローマ数字やエジプト数字)は多少短くなるが、数が大きくなるたび新しい記号が必要になる。エジプト数字には100万の記号はあったが、それ以上はなかった。そこで行き止まりだ。
- 底bの位取り記法なら、必要な桁数は1 + ⌊log_b n⌋だけで済む(Weisstein, MathWorld, "Digit")。長さは値に対して対数的にしか増えず、使う記号の種類は増えない。
Chenの言葉を借りれば「位取りは、無限の記号を無限の桁に変える」。
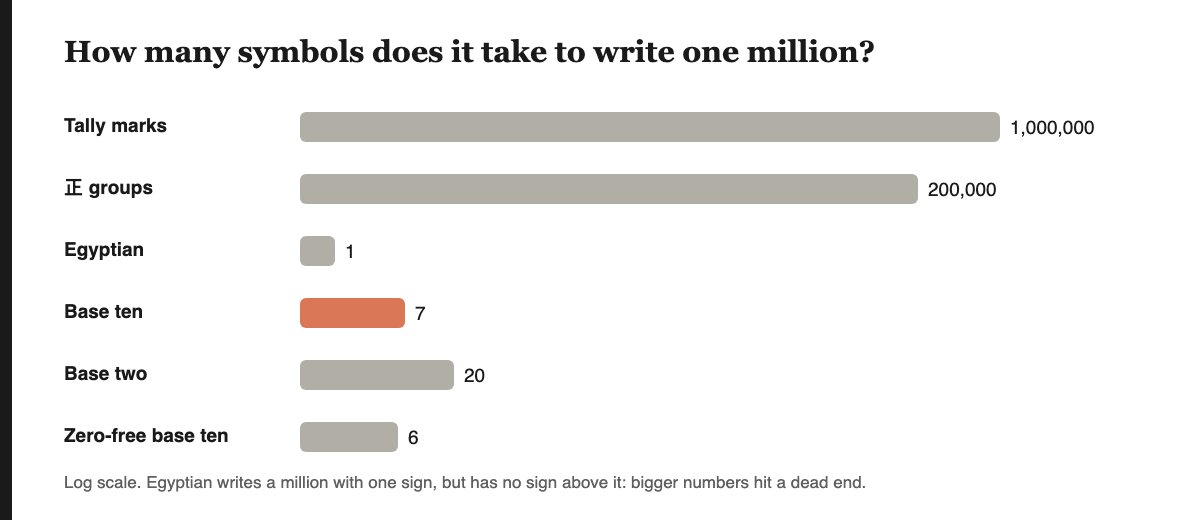
ただし、その便利さには代償もある。空の桁も含めてすべての桁を保持する必要があり、それがプレースホルダーとしてのゼロの役割だ。もっとも、ゼロは厳密には必須ではない。全単射(ゼロなし)基数kでは、桁は1からkまでを使う。すべての正の整数には必ず一意の文字列が対応し、空文字列がゼロとなる。実はこれ、日常的に使っている。スプレッドシートの列AからZ、そしてAA、AB…は全単射な基数26の表記法だ。Excelでは16,384列まで使え、最後の列はXFDとなる(Microsoft, "Excel specifications and limits"(訳:Microsoft, Excelの仕様と制限)): 24 × 26² + 6 × 26 + 4 = 16,384.
アクティビティ2:コンバーターを書き、何が変わってはいけないかをテストせよ
以下のバージョンを読む前に、3種類のエンコーダとそのデコーダを書いてみよう。ゼロを使う基数b、ゼロなしの10進法(1〜9と10用のκ、Chenの記号)、そしてスプレッドシートの列ラベルだ。次にプロパティテストを書こう。すべてのエンコーディングが往復変換できること、そして特定の表現だけで成り立つ「事実」を検出できることを確認する必要がある。
下記のバージョンは、すべてのアサーションを満たす:
DIGITS = "0123456789abcdefghijklmnopqrstuvwxyz"
def to_base(n, b):
    if n == 0:
        return "0"
    out = ""
    while n:
        n, r = divmod(n, b)
        out = DIGITS[r] + out
    return out
def from_base(s, b):
    return int(s, b)
def to_zero_free_ten(n):            # digits 1-9 and κ (ten); no 0
    out = ""
    while n:
        r = n % 10 or 10
        out = "123456789κ"[r - 1] + out
        n = (n - r) // 10
    return out
def from_zero_free_ten(s):
    n = 0
    for ch in s:
        n = n * 10 + "123456789κ".index(ch) + 1
    return n
def column_label(n):                # spreadsheet columns: zero-free base 26
    out = ""
    while n:
        r = n % 26 or 26
        out = chr(64 + r) + out
        n = (n - r) // 26
    return out
def column_number(s):
    n = 0
    for ch in s:
        n = n * 26 + ord(ch) - 64
    return n
assert to_zero_free_ten(3020) == "2κ1κ" and to_zero_free_ten(10**6) == "99999κ"
assert column_label(27) == "AA" and column_label(16384) == "XFD"
for n in range(1, 10_000):          # every encoding round-trips: the value is untouched
    assert from_base(to_base(n, 3), 3) == n
    assert from_zero_free_ten(to_zero_free_ten(n)) == n
    assert column_number(column_label(n)) == n
    assert (n % 3 == 0) == to_base(n, 3).endswith("0")              # true in base 3 ...
assert any((n % 3 == 0) != str(n).endswith("0") for n in range(1, 100)) # ... false in base ten: a fact about notation最後の2つのアサーションに注目してほしい。「3で割り切れるなら末尾の桁は0」は、基数3では常に成り立つが、最後の行では10進法で破綻している(3は3で割り切れるが末尾は3)。あるエンコーディングで成り立ち、別のエンコーディングで成り立たない性質は、数そのものではなく表現に属する。Chenの並べ替え実験(子どもが文が数についてか書き方についてかを判別する)は、値を固定してエンコーディングだけを変えるプロパティテストと同じ発想だ。基数bでは、桁和ショートカットはb − 1 (Weisstein, MathWorld, "Divisibility Tests"(訳:Weisstein, MathWorld,「割り算の判定法」)の約数に対して正確に機能する。つまり、3や9の判定法は10進法固有の事実であり、3進法の事実ではない。
同じビットでも数は違う——コードで現れる落とし穴
Pythonプロンプトで再現できる3つの例。それぞれ、表現の事実が値の層に漏れ込んでいる。
- 1バイト、2つの数。ビットパターン11111011がバーに入ると、バーテンダーが聞く。「251か、それとも−5か?」。符号なしバイトとして読めば251、8ビット2の補数整数として読めば−5。同じビットでも、どのエンコーディングと合意するかで数が決まる。2つのシステムがエンコーディングで食い違うと、バグになる。
- 0.1 + 0.2 は 0.30000000000000004 になる。2進浮動小数点では0.1を正確に表せない。10進法が1/3を正確に表せないのと同じだ。3進法なら1/3は単に0.1。値自体は問題ないが、エンコーディングが丸めてしまう。
0.1 + 0.2 == 0.3これはエンコーディングの問題なので、数値コードは許容誤差で比較する。 - 5つの文字、1つの値。「5」「٥」「५」「Ⅴ」「五」——これらの文字はすべて、Unicode文字データベース上で数値5を持つ(Unicode Character Database (UnicodeData.txt) and Unihan (U+4E94))。Pythonの
int("٥")やint("५")は5を返す。これらはUnicodeの10進数字だからだ。一方、int("五")やint("Ⅴ")は設計通りに ValueError を返す。intは数字(digit)を読み取るが、数字記号(numeral)は扱わない。unicodedata.numeric("五")は 5.0 を返す。どのパーサもどこかでこの境界を引くが、その意図を意識せずに線を引くとバグの温床になる。
サプライチェーンの現場では、製品コード「0042」がスプレッドシートに読み込まれると数値の42に変換され、識別子だった先頭のゼロが消える。結果、どこかの倉庫が製品0042(ラバーダック)と製品42(これもラバーダック、別の仕入先)を同一視し、アヒルを2倍発注してしまう。もともとこのコードは数字列として保存された識別子であり、数量ではなかった。値がどの層に属するかを見極めていれば、こうした事故は防げた。
もう一つの視点:数に「身体」はあるのか?
このシリーズでは、Paul の「プレイ・エンジニアリング」ノートから着想を得たレンズを使う。仮説ではなく、実際に検証されたものだ。身体には spirit(精神)、bone(骨)、flesh(肉)、skin(皮膚)がある。数の体系に当てはめると:
- 「spirit」は値そのもの、
- 「bone」は位取りの枠組みや型の構造、
- 「flesh」は数記号上のアルゴリズム(繰り上がり、比較、パース)、
- 「skin」はグリフやバイト列にあたる。
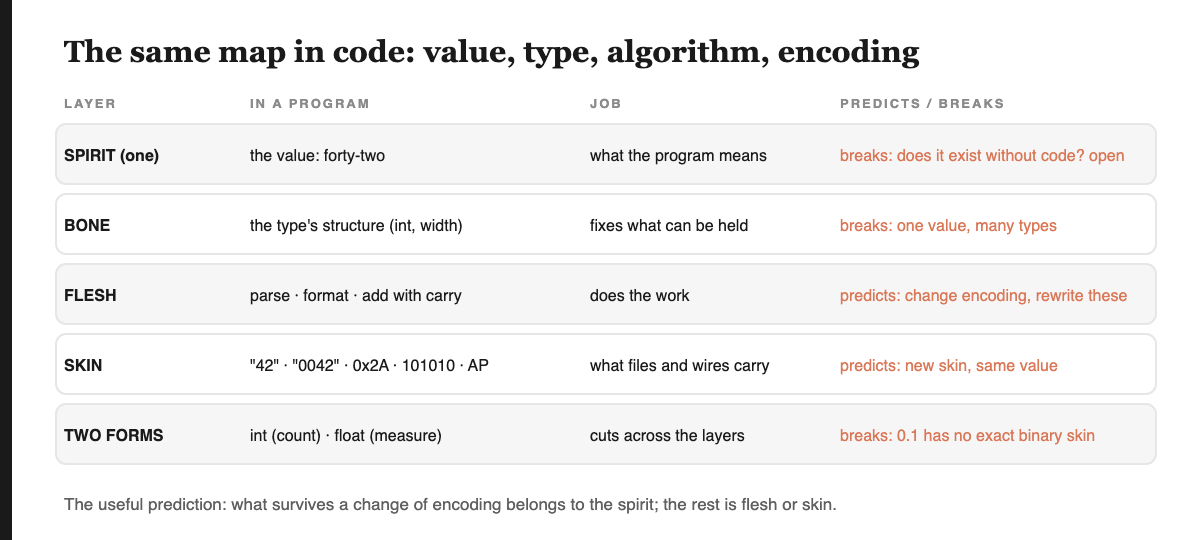
この構造を持つ意味は何か?エンコーディングを変えても変わらず残るものは値に属し、変化してしまうものは実装層に属する。 加算は spirit、繰り上がり規則は flesh だ。「N に達したら1繰り上げる」というN入りのルールなので、基数を変えればNだけが変わり、加算そのものは変わらない。コードでは「値層で性質をテストし、エンコーディング固有の事実はエンコーディングのインターフェースの裏に隠す」という設計になる。
この構造が通用しない場面もある:
- 骨(基数)を入れ替えても spirit(値)は保てるが、現実の身体でそんなことはできない。
- 「離散と連続」は層ではなく軸だ。アリストテレスはこう記している――量とは、離散的であるか連続的であるかのいずれかである。" (Aristotle, Categories, Part 6, tr. E. M. Edghill (MIT Internet Classics Archive))。ここで扱うのはすべて離散量であり、「測る」ことや、正しく扱うfloatは次のシーズンの話になる。
- 「精神」が独立に存在するかどうかは決着がついていない。プラトン主義では、数は実在し、抽象的で、いかなる心にも依存しない(Linnebo, Stanford Encyclopedia of Philosophy, "Platonism in the Philosophy of Mathematics")。一方、唯名論では、抽象的な「数」という対象自体が存在しない(Bueno, Stanford Encyclopedia of Philosophy, "Nominalism in the Philosophy of Mathematics")。エンジニアは不可知論で構わない――大事なのはインターフェースであり、それ自体が一つの哲学的立場(機能主義)だ。
なぜ一つの発想が四つの年齢を貫けるのか
このシリーズは、Jerome BrunerのThe Process of Education(1960年)にしばしば帰せられる「どんな主題も、知的に誠実な形ならどの発達段階でも教えられる」という主張に賭けている。ここではあえて意訳した。原文は未確認なので直接引用はしていない。
「誠実さ」の基準も同じく不変性テストだ。各エピソードは同じ核を持ち、7歳で学んだことは20歳になっても一つも学び直す必要がない。ペアリングゲームはヒュームの原理そのもの。「5はただの名前」が値とエンコーディングの分離。両手カウンターはキャリーの規則そのものだ。
シリーズの設計思想は、検証可能な研究に基づいている:
- ワーキングメモリが保持できるのは3〜5チャンク(Cowan (2001), "The magical number 4 in short-term memory", Behavioral and Brain Sciences 24).
- 初心者を助けるサポートは、熟練者には逆効果になることがある(Kalyuga, Ayres, Chandler & Sweller (2003), "The Expertise Reversal Effect", Educational Psychologist 38).
- 「教えるつもりで学ぶ」ことが、教えること自体の効果を生む(訳:Expecting to teach is what makes teaching pay)Kobayashi (2024), Educational Psychology Review (ERIC EJ1414484)).
もうひとつ、私自身の視点を紹介する。私は「真・愛・美」は三つの別々の理想ではなく、一つの現実の三つの側面であり、私の信仰では一人の人格の現れだと考えている。このシリーズでは、信仰抜きでも通用するエンジニアリングのチェックリストとしても機能する。レッスンには「真」(学ぶ人が自分で確かめられること)、「愛」(特定の相手に向けて書かれ、その人のつまずきに寄り添うこと)、「美」(誰かに見せたくなる瞬間があること)が必要だ。
- 愛のない真実は、誰にも伝わらない正しい証明にすぎない。
- 真実のない愛は、誤ったことを植え付ける楽しい遊びに終わる。
- どちらもない美しさは、歴史を間違えたきれいなインフォグラフィックでしかない。
「半分だけ正しい」典型的な誤解
- 「0.1は間違って保存されている」 これは仕様通り、最も近い2進小数として保存されている。驚くべきなのはエンコーディングであって、エラーではない。対策は許容誤差で比較するか、decimal型を使うことだ。
- 「先頭のゼロは重要ではない」 量としては正しいが、識別子としては誤りだ。商品コード「0042」は、たまたま数字が並んでいるだけの文字列である。
- 「26進の列ラベルは単なるアルファベットだ」 実際にはゼロのない位置記数法の数体系であり、だからこそZの次がAAであってBAではない。
さあ、今度は人に説明してみよう
あなたの番だ。 15歳の子を見つけて、「証明:すべての数にはただ一つの綴りがある」(episode 3)を一緒にやってみよう。手順は書いてあげず、「352を3で割った余りは?」「その後、商はどうなる?」と問いかけ、誰も数字を選んでいないことに気づかせる。
目標: 15歳の子が自力で352の3進法での余りの手順(111001)を書き、なぜ最後の桁が必然なのかを一文で説明できる。その年齢と結果をこの記事のコメント欄に投稿しよう。
なぜ重要か――5回の「なぜ」
問題:データパイプラインが商品コードの先頭ゼロを落とし、0042と42が統合されて2つの商品が1つになった。
- なぜコードが統合されたのか? ローダーが「0042」を数値42として解釈した。その結果、両方の文字列が同じ値に結びつき、識別子が衝突した。
- なぜ数値として解釈されたのか? フィールドの意味ではなく、文字(数字のみ)の見た目から型が推測されたためだ。
- なぜ見た目から推測したのか? システムが「数字の並んだ文字列」という表現を、そのまま値として扱ってしまったからだ。これはまさにChenの章で子どもたちに避けさせている混同そのものだ。
- なぜ見逃されたのか? 値を固定したままエンコーディングだけを変えるテストがなかった。もしそのテストがあれば、コンバーターの十進法との比較行でbase-3の「事実」が十進法で破綻するように、すぐに問題が発覚したはずだ。
- 根本原因 コードが値そのものではなく、表現の層に依存していた。解決策はこのエピソードのルール通り:値(数量か識別子か)をまず決め、表現固有の事実はインターフェースの裏側に隠し(Liskov & Zilles (1974), "Programming with abstract data types", ACM SIGPLAN Notices)、エンコーディングをまたいで不変性をテストすることだ。
実践編:今週やること
- 「教えるつもりで読む」一文を読む。
- 片手で31まで数える(2分)。
- 3種類のコンバーターとプロパティテストを書き、上記のバージョンと見比べる(15分)。
- を開く。プレイグラウンド。16384と1000000を入力し、各行(スプレッドシートの列も含む:16384はXFD)で自作コンバーターと照合し、N-or-Rゲームを試す。
- 自分のコードの中で、事実が表現(文字列と数値、浮動小数点の等価性、数字のみパーサなど)に依存している箇所を一つ見つけ、不変性テストを一つ追加する。
- エピソード3の証明を15歳の子に教える。
フィードバック:できたかどうかの確認
- 自作コンバーターが上記すべてのアサーションを通過する。
- 自分のコードに、表現の事実が値の層に漏れた場合に失敗する新しいプロパティテストが一つ追加されている。
- 11111011がなぜ2つの数になるのか、0.1 + 0.2 ≠ 0.3がなぜバイナリ浮動小数点で起きるのか、なぜZの次がAAなのか、それぞれ一文で説明できる。
1週間後にもう一度自分でチェックしよう。テストは再読よりも効果が高かった(1週間 (Roediger & Karpicke (2006), "Test-Enhanced Learning", Psychological Science 17)。ただし、締切直前のプレッシャー下でも習慣が続くかどうかまでは分からない。CI(継続的インテグレーション)でのプロパティテストだけが、それを自動で見張ってくれる。
実践のための決めごと(今ここで線を引く)
- フィールドがすべて数字なら、それが数量なのか識別子なのかを最初に決める。 ローダーが勝手に推測する前に、その判断をスキーマに明記しておく。
- もしfloat同士を
==で直接比較しているなら、今すぐやめよう。 許容誤差を使うかdecimal型を使い、0.1 + 0.2のテストも加える。 - パーサが٥や五に出会ったときは、 意図して選択すること:Pythonの
intは٥のようなUnicodeの10進数字は受け入れ、五やⅤのような数字記号は仕様上はじく。自分のシステムがどちらを受け入れるかを明文化し、テストする。
このエピソードの「真・愛・美」
- 真: すべての主張は実際に動作する。コンバータのassertは通り、バイトやfloatの例もPythonのプロンプトで再現できる。
- 愛: このエッセイは、あなたに15歳の子に教える役を託し、よくある誤解にはその場で正しく応じている。
- 美: 5個のリンゴからExcelの最終列まで、たった一つのアイデアがどの年齢でも一度も学び直すことなく貫かれる。(エピソード1で石と手をつないだ卵は、今や全国トラックのカートン0042になった。数は変わらず1つ、変わるのはその名前だけだ。)
5Sの自己採点
| S | 主張 | 根拠 |
|---|---|---|
| シンプル | この文章は、高校3年生程度でも読みやすいレベルで書かれている。 | この文章のFlesch–Kincaidグレード:8.4(バンド ≤ 13)、再計算元:node scripts/check-numbers-four-ages.mjs |
| 堅実 | 定義や数値には出典があり、コードも実際に動作する。 | Excelの16,384列(Microsoft); ヒュームの原理 |
| 鋭さ | 位取り記数法は、固定された記号セットで表現長が対数的に伸びる符号化方式であり、正しいコードは値そのものだけに依存する。 | 対数長 · そのプロパティテスト |
| SMART | 今週やること:コンバーター作成、自分のコードに不変性テストを1つ追加、誰かに一度教えてみる。 | 実践 · プレイグラウンド |
| 驚き | あなたのスプレッドシートは、実はずっとゼロのない26進法で数えていた。 | XFD = 16,384 |
| 真・愛・美 | 実行できる主張・教える相手・どの年齢にも通じる一つのアイデア。 | 真・愛・美 |
出典
- 陈诗峰 (Shifeng Chen)、草稿章《第一章 数とその表現形式》("Numbers and Their Representations")、2026年。原著章(PDF・中国語)を読む本シリーズ共著者。
- Zalta, E. N. "Frege's Theorem and Foundations for Arithmetic."Stanford Encyclopedia of Philosophy. plato.stanford.edu
- Liskov, B. & Zilles, S. (1974). Programming with abstract data types.ACM SIGPLAN Notices. Crossref 10.1145/942572.807045
- Weisstein, E. W. "Digit." MathWorld.mathworld.wolfram.com
- Weisstein, E. W. "Divisibility Tests." MathWorld.mathworld.wolfram.com
- Microsoft. "Excel specifications and limits."support.microsoft.com
- Unicode Character Database, UnicodeData.txt.unicode.org
- Aristotle.Categories第6部、E. M. Edghill訳。classics.mit.edu
- Linnebo, Ø. "Platonism in the Philosophy of Mathematics."Stanford Encyclopedia of Philosophy. plato.stanford.edu
- Bueno, O. 「Nominalism in the Philosophy of Mathematics.」Stanford Encyclopedia of Philosophy. plato.stanford.edu
- Cowan, N. (2001). The magical number 4 in short-term memory. Behavioral and Brain Sciences 24. doi:10.1017/S0140525X01003922
- Kalyuga, S., Ayres, P., Chandler, P. & Sweller, J. (2003). The expertise reversal effect. Educational Psychologist 38. doi:10.1207/S15326985EP3801_4
- Kobayashi, K. (2024). Interactive learning effects of preparing to teach and teaching. Educational Psychology Review. ERIC EJ1414484
- Roediger, H. L. & Karpicke, J. D. (2006). Test-enhanced learning. Psychological Science 17. doi:10.1111/j.1467-9280.2006.01693.x
- DeLamater, M. (1999), on Bruner's hypothesis. Education Week. edweek.org(二次資料。一次資料の原文は未確認)