SERIE AI-NATIVE · INGENIERÍA DE AGENTES
Control de apps de escritorio: cuatro puertas, y la app decide cuál puedes usar
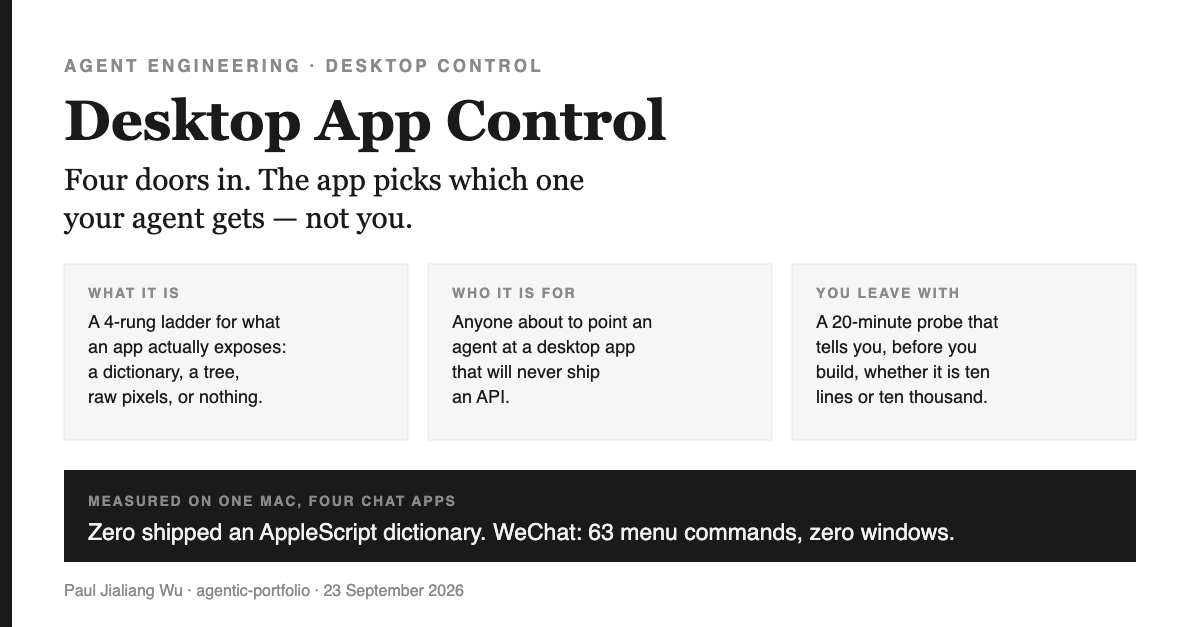
En qué consiste esto. Una forma de responder una pregunta antes de escribir cualquier automatización de escritorio: ¿qué puerta de esta app está realmente abierta? Existen cuatro puertas, la app decide cuál puedes usar, y esa decisión determina si tu automatización sobrevive a la próxima actualización.
Por qué importa. Los equipos construyen agentes asumiendo una puerta, descubren la real meses después y tienen que reescribir. Medirlo toma segundos, y las cuatro apps que la mayoría asume que son controlables por scripts, en la práctica, no lo son.
Qué puedes hacer después. Puedes probar cualquier app en tu Mac, ver en qué nivel está y saber antes de empezar si vas a escribir diez líneas o diez mil — y si lo que construyas podrá ejecutarse mientras usas la máquina.
Qué abarca aquí el control de apps de escritorio, y a quién va dirigido
Esto es para cualquiera que esté por automatizar una aplicación de escritorio: un cliente de chat, una herramienta de diseño, una app interna que nunca tendrá una API. Explico cómo medir lo que expone una app, qué implica cada superficie y las dos conclusiones que solo aprendí tras ejecutar una sonda. No trata sobre APIs en la nube: si la app que te interesa tiene una API real, úsala y deja de leer, porque todo lo que sigue es para el caso en que no la tiene.
Una sola imagen sostiene todo el texto, así que la presento como herramienta, no como adorno.
Una imagen: el restaurante y sus proveedores
En una cocina de restaurante hay que tratar con proveedores, y no todos son igual de accesibles.
El mejor proveedor entrega en tu muelle de carga con un manifiesto impreso.Nunca sales de la cocina. Pides por nombre — "cuarenta kilos de la harina del martes" — y ese nombre sigue significando lo mismo el año siguiente.
El segundo mejor acepta pedidos por teléfono.Describes lo que quieres por nombre y posición: lo de la tercera repisa, el que dice arborio. Es más lento, y a veces reacomodan las repisas, pero sigues usando palabras, no coordenadas.
El tercero ni siquiera tiene teléfono.Vas al mercado, ubicas el puesto a ojo y señalas. Funciona, pero significa que tienes que estar ahí en persona, de día, y si mueven el puesto, te toca buscar otro punto de referencia.
Y el cuarto proveedor simplemente no está abierto.
Cada uno de estos casos corresponde exactamente a algo que una app de macOS expone o no, y el paralelismo es directo:
| Proveedor | Qué expone la app | Cómo se accede a cada elemento | ¿Sobrevive a una actualización? |
|---|---|---|---|
| Muelle de carga + manifiesto | R3 AppleScript dictionary (sdef) | Por nombre, usando el propio vocabulario de la app | Por lo general — es un contrato publicado |
| Pedido por teléfono | R2 Árbol de accesibilidad (AX) | Por rol y título | A menudo — hasta que reestructuran la interfaz |
| Ir al mercado | R1 Pixeles + clics sintéticos | Por coordenada y apariencia | Rara vez — un rediseño implica reescribir todo |
| No disponible | R0 Sin superficie de ventana | — | — |
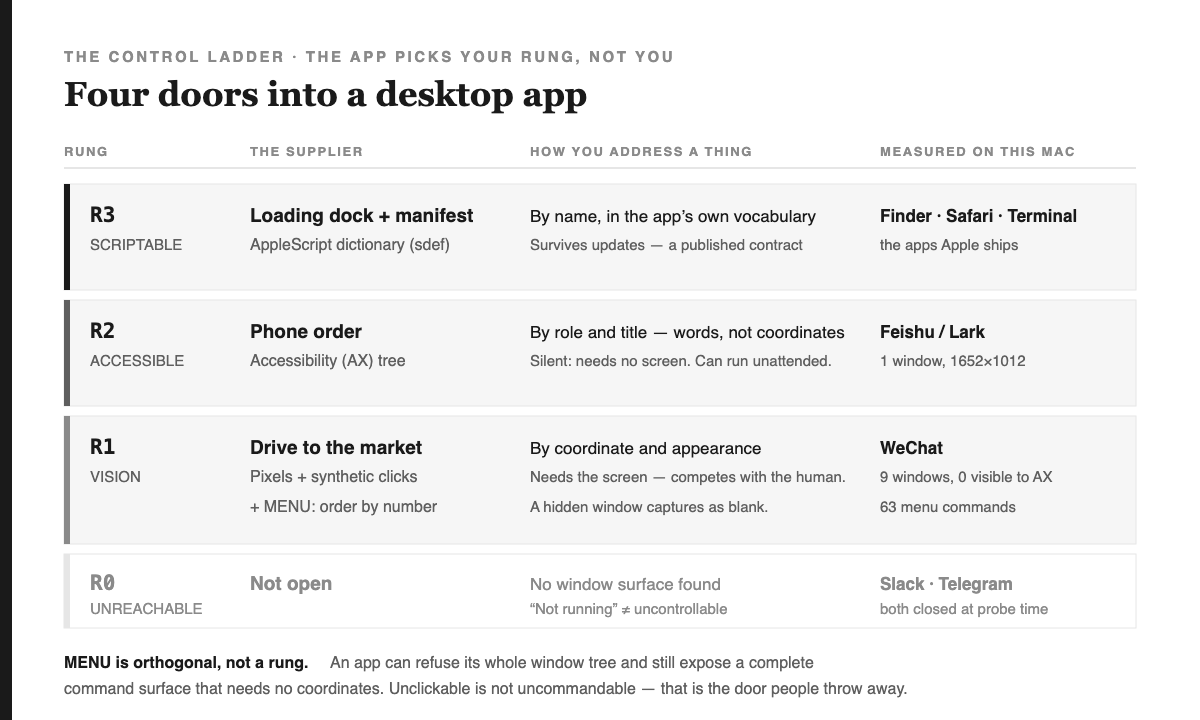
La escalera es lo útil aquí, porque los niveles no son intercambiables y no puedes elegir cuál usar. La app decidió cuál nivel exponer cuando la construyeron, años antes de que tú llegaras. Tu única decisión real es si averiguarlo ahora o después de haber escrito la automatización.
Así que preferí medir, en vez de asumir
Escribí una pequeña sonda — cuatro pruebas independientes por app — y la ejecuté en mi propia máquina. Las pruebas son deliberadamente separadas, porque una app puede responder a una y rechazar otra, y la combinación es lo que importa.
$ appctl survey WeChat Feishu Slack Telegram Finder Safari Terminal

  ⬜ Slack       R0_UNREACHABLE
  ⬜ Telegram    R0_UNREACHABLE
  🟨 WeChat      R1_VISION          +MENU(63)
  🟦 Feishu      R2_ACCESSIBILITY   +MENU(61)
  🟩 Finder      R3_SCRIPTABLE      +MENU(152)
  🟩 Safari      R3_SCRIPTABLE
  🟩 Terminal    R3_SCRIPTABLE      +MENU(132)
El primer resultado es el que merece atención.
Ninguna de las cuatro apps de chat proporciona un diccionario de AppleScript. WeChat, Lark/Feishu,
Slack, Telegram — sdef las cuatro fallan. Finder, Safari y Terminal sí pasan. Las apps donde realmente trabajas están en los niveles bajos; las apps que Apple incluye están en el más alto.
Ese solo hecho invalida el plan más común. Las implementaciones de referencia que la gente suele copiar — incluyendo el harness de Safari en CLI-Anything, que es excelente — empieza con AppleScript, porque Safari sí tiene un diccionario. Si copias ese patrón para una app de chat, no funciona. No es que 'funcione peor'. Simplemente no aplica.
El descubrimiento inesperado: 63 comandos y cero ventanas
WeChat es el caso interesante, y lo es porque responde a dos preguntas de forma contradictoria.
Si le preguntas a la API de accesibilidad cuántas ventanas tiene WeChat, responde cero. Si consultas al window server — la capa inferior, la que realmente compone los píxeles — te informa de nueve, siendo la mayor de 1418×879. Las ventanas existen. WeChat simplemente no las expone a la API de accesibilidad.
Si te detienes ahí, descartas WeChat. Yo estuve a punto. Pero la barra de menús es una superficie aparte,
y la de WeChat está completamente expuesta: 63 comandos repartidos en siete menús, incluyendo
Show Next Unread Chat, Chats, Contacts y
Favorites.
Que no se pueda hacer clic no significa que no se pueda controlar mediante comandos. Una app puede negar todo su árbol de ventanas y aun así darte una superficie de comandos completa que no requiere coordenadas. Tratar un "árbol AX vacío" como "incontrolable" es descartar la única puerta abierta.
En el restaurante: el puesto no tiene teléfono y no te deja entrar al almacén — pero hay un menú impreso clavado al frente, y puedes pedir por número. Es una interfaz peor que el muelle de carga. Es muchísimo mejor que nada, y es estable, porque los comandos de menú tienen nombre, no posición.
El segundo descubrimiento: una ventana oculta no muestra nada al fotografiarla
WeChat está en R1, así que leerlo significa capturar píxeles. Su ventana principal es detectable en 1418×879 mientras la app está cerrada en la bandeja, lo que me hizo ser optimista: capturar la ventana por id, leerla, sin molestar nunca al usuario.
La captura funcionó. Produjo 94 KB completamente en blanco.
Una ventana fuera de pantalla puede ser listada pero no capturada en imagen; no hay píxeles renderizados que entregar. Esto no es un error que puedas evitar. Es una limitación con una consecuencia que afecta incluso la planificación:
El control en el nivel de visión no puede ejecutarse sin que te des cuenta. La app tiene que estar visible en pantalla, lo que significa que el agente compite contigo por el monitor. No es posible construir una automatización que lea WeChat en silencio a las 3 pm mientras trabajas.
Así que la sonda no solo informa el nivel. Informa que R1 nunca está desatendido, y explica por qué. Y aquí llego a lo que, en mi opinión, es la verdadera aportación.
Un nivel se limita, no se proclama
La tentación con un clasificador como este es afirmar una capacidad: "WeChat: controllable." (Traducción: WeChat: controlable). Esa frase vale exactamente lo que vale el eslabón más débil que la sostiene. Ya he escrito antes sobre restringir una garantía a su supuesto más débil, y el error que esa disciplina detecta es este: una garantía se afirma al nivel que alguien esperaba, no al nivel que la evidencia respalda.
Así que la sonda toma prestada esa disciplina. Nunca afirma un nivel — lo deriva a partir de cuatro mediciones, y luego aplica todos los límites que esas mediciones imponen:
🟨 WeChat  R1_VISION
   +MENU — 63 commands, no coordinates needed
   unattended: NO — needs the screen
   ⚠ capped: every window is offscreen: capture returns a blank image, so the
     app must be brought on screen before it can be read
   ⚠ capped: vision control competes with the human for the display — it cannot
     run unattended while the machine is in use
Una app que simplemente está cerrada informa R0 con un límite que indica que la sonda es inconclusa — porque "no está ejecutándose" y "incontrolable" son hechos distintos, y confundirlos habría descartado Slack y Telegram según la evidencia anterior. Los límites se aplican mediante pruebas, no con prosa en un README, que es la única versión de una regla que sobrevive al contacto con una fecha de entrega.
Qué falló cuando lo ejecuté — incluso en la app más sencilla del Mac
Registré los fixtures manualmente a partir de mis primeras sondas exploratorias, escribí el clasificador sobre ellos, pasé diecinueve pruebas en verde y me sentí satisfecho. Luego apunté el backend en ejecución a las mismas apps.
Había dos problemas, y uno fue vergonzoso.
Finder devolvió R1_VISION. Finder — la aplicación más automatizable de la máquina, el objetivo canónico de AppleScript desde 1993. Mi búsqueda de bundle escaneó /Applications, y Finder vive en
/System/Library/CoreServices. No se encontró, así que no se leyó ningún diccionario, y el nivel superior se vino abajo hasta el más bajo. Un clasificador que falla en el caso más sencillo es peor que no tener ninguno, porque confías en él.
Feishu no resolvió ningún bundle. Su proceso se llama Feishu; su bundle de aplicación es Lark.app. Cualquier intento de deducir la ruta a partir del nombre no lleva a nada.
Ambos tienen la misma causa raíz y la misma solución: preguntarle al proceso en ejecución dónde está ubicado, en vez de adivinarlo por su nombre. El proceso lo sabe. Yo estaba deduciendo algo que el sistema simplemente me habría dicho.
Y ambos solo se pudieron detectar porque los fixtures estaban registrados en vez de inventados — un dato falso que yo hubiera inventado habría coincidido con mi suposición equivocada para siempre. Mis números registrados manualmente también estaban equivocados en los detalles: había escrito 19 comandos de menú para WeChat cuando el número real es 63, y 23 ventanas cuando el conteo filtrado es 9. Ahora los fixtures llevan la salida real, pegada desde
--json.
Constrúyelo tú mismo en unos veinte minutos
Todo esto son cuatro pruebas y una función pura. Sin dependencias más allá de la biblioteca estándar y lo que ya trae tu sistema operativo.
- Scripting. Ejecuta
sdef /Applications/Foo.app. Un diccionario significa nivel 3. Ignora laNSAppleScriptEnabledbandera en Info.plist — las apps la ponen de forma inconsistente, así que regístrala pero no tomes decisiones en base a ella. - Accesibilidad. Pídele a System Events
count of windows. Necesita permiso de Accesibilidad; sin él obtienes un error, y ese error debe reportarse literalmente y no traducirse como "cero ventanas" — esas cosas significan lo opuesto. - Barra de menús. Enumera sus ítems y cuenta sus hijos en una sola pasada. Cada llamada por menú tomó unos tres segundos en una app Electron y la prueba completa tardó veintiún segundos.
- Window server. La única manera de ver ventanas que la API de AX no muestra. En macOS 15+
necesitas un pequeño helper en Swift, porque
CGWindowListCreateImagequedó obsoleto y no hay forma de acceder a la lista de ventanas desde la biblioteca estándar.
Luego clasifica: la superficie más alta que respondió es la que cuenta, el menú se registra por separado, y toda precondición no cumplida se convierte en un límite (cap), no en una nota al pie. Mantén el clasificador puro — sin I/O — y la lógica relevante se puede probar sin necesidad de un Mac.
Lo que esto no te dice
Una compuerta que promete más de lo que puede cumplir invita a que la engañen, así que aquí va lo que el nivel realmente no puede ver.
Mide accesibilidad, no usabilidad. Feishu está en R2
con un árbol activo, y su nivel superior es un AXGroup y tres botones — las apps Electron
ocultan su árbol real hasta que un cliente de asistencia lo solicita. Que sea accesible es solo el inicio del
trabajo, no el final.
No dice nada sobre si tienes permiso. Los términos de servicio de una app, la política de tu empleador y las demás personas en la conversación tienen peso que una sonda no puede medir. Automatizar tu propio cliente en tu propia máquina es un uso de accesibilidad común — es lo que hace cualquier lector de pantalla. Automatizar una cuenta a escala es otra pregunta con otra respuesta, y la sonda te dirá sin problema que una puerta está abierta aunque no deberías cruzarla.
Es una instantánea. Los niveles pueden cambiar. Una app puede añadir soporte de accesibilidad en una actualización menor, o quitarlo. La medición es barata precisamente para que puedas volver a ejecutarla en vez de citarla.
Y el límite honesto: el nivel te dice el costo, no el valor. Saber que WeChat solo permite visión y tiene un menú de 63 comandos no te dice si automatizarlo vale la pena. Te dice cuánto costará si decides hacerlo, que suele ser el número que la gente descubre al final.
La parte que se generaliza
El hallazgo específico es sobre apps de chat en macOS y envejecerá. La estructura subyacente no.
Cada vez que vas a automatizar algo que no controlas, hay una escalera de interfaces que podría exponer, no puedes elegir tu nivel, y el movimiento más barato posible es medir en cuál estás antes de construir. La forma de fallo es universal y siempre es la misma: alguien asume el muelle de carga, escribe meses de código para él, y descubre en la integración que el proveedor no tiene teléfono.
Veinte minutos de pruebas, hechos primero, te lo habrían dicho.
Relacionado
appctl en una Mac con macOS 26 y es reproducible sin conexión usando los fixtures registrados con appctl --fake probe <app>. Las apps son mías; las puertas están disponibles para todos.