AI 原生系列 · AI 经济学
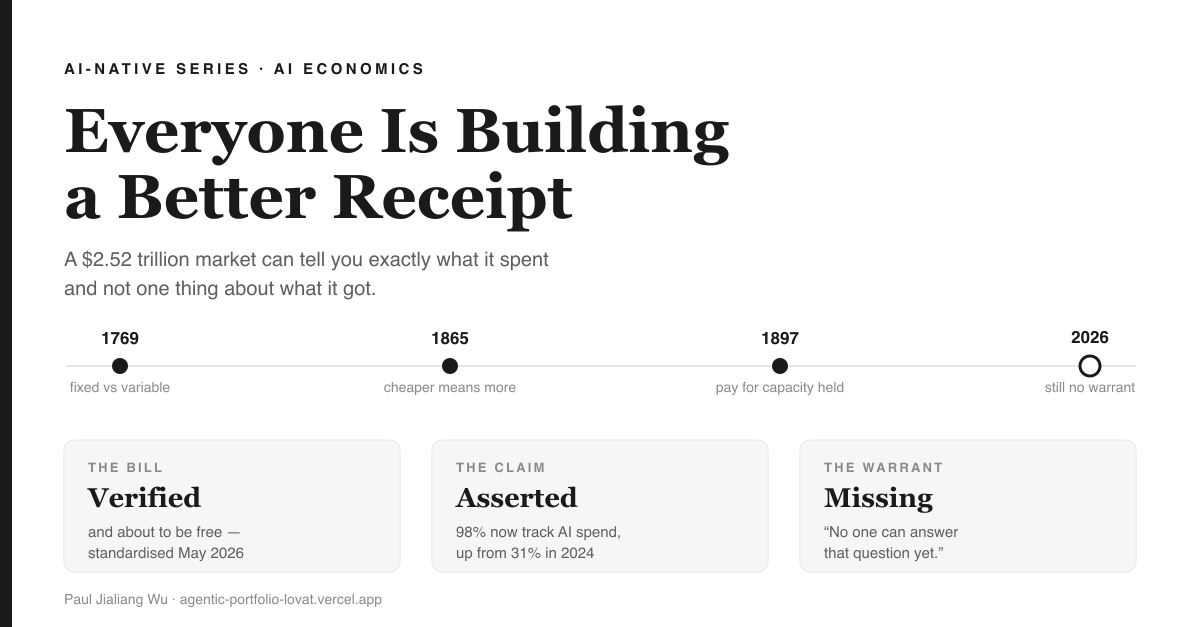
人人都在追求“更好的收据”
1 分钟速览——核心要点
全球 AI 投入正朝着2026 年 2.52 万亿美元迈进,行业年度调查面对这个问题:你的 AI 是否创造了价值?,答案是这样一句话“No one can answer that question yet.”(中译:现在还没有人能回答这个问题。) 现在,几乎所有在这个领域里做产品的人,都在想方设法做出更好的计量工具——而这个计量器,其实在 2026 年 5 月就已经成为行业标准,2026 年 1 月又完成了整合。这种进展只会发生在水管式的基础设施上,而不是护城河。真正能沉淀为生意的,不是那个数字本身,而是 warrant:让财务团队敢于把决策建立在这个数字上的证据。warrant 变成公司的三种路径,按我自己实际会选择的顺序:一个 Gate,只记入那些经过验证、质量确实守住的节省;一个 Warrant 账本,把支出和结果打通,拒绝认证任何无法举证的价值;还有一个 Desk,不再数 token,而是直接按容量采购。以及,为什么第三种有可能让前两种直接变得多余,这个理由我会坦诚说明。
今年我花了不少时间研究那些能告诉你 AI 花了多少钱的工具。它们确实做得很不错——这个领域的工程能力很强,仪表盘流畅,集成只需一行代码。
但它们全都在回答同一个问题,就是 我们花了多少钱。这个问题我早就有答案了,叫发票。
有一件事,彻底改变了我对整个赛道的理解。FinOps Foundation 每年会做业内最大规模的从业者调查。在 2026 年的报告里,谈到 AI 花钱为什么难,有这么一句 [2]:
“Is your AI providing value? No one can answer that question yet.”(中译:你的 AI 到底有没有创造价值?现在还没有人能回答这个问题。)
这不是哪家厂商的宣传语,而是那些本职工作就是要搞清楚这个问题的人,自己公开承认没人知道。而且同一份报告里,98% 的从业者表示他们现在会管理 AI 支出——2025 年是 63%,2024 年只有 31% [1][2].
把这两组数据放在一起看,意思就很明确了。两年时间,行业从三分之一的人在 统计花了多少钱,变成几乎所有人都在统计,但 知道钱到底买来了什么,几乎没有。我们把计量器造得飞快,结果发现难的根本不是计量器本身。
换个角度想:账单、主张和 warrant
每一笔 AI 支出,其实都绕不开三个问题,这三件事你得同时想明白。
账单。 花了多少钱?用掉的 tokens 乘以单价,再加上席位费、GPU 费用。这部分是可测量的。要么来自网关,要么来自发票,这个数字没有争议。
主张。 得到了什么?这是主观申报——而且几乎总是由下年度预算申请人来申报。“我们把推理成本降了 40%。”“这个 agent 帮客服团队每张工单省了 9 分钟。”
warrant。 谁能证明这个主张是真的?有什么证据能让一个本就不愿相信的财务同事也挑不出毛病?这一环是缺位的。不是薄弱,是压根没有。
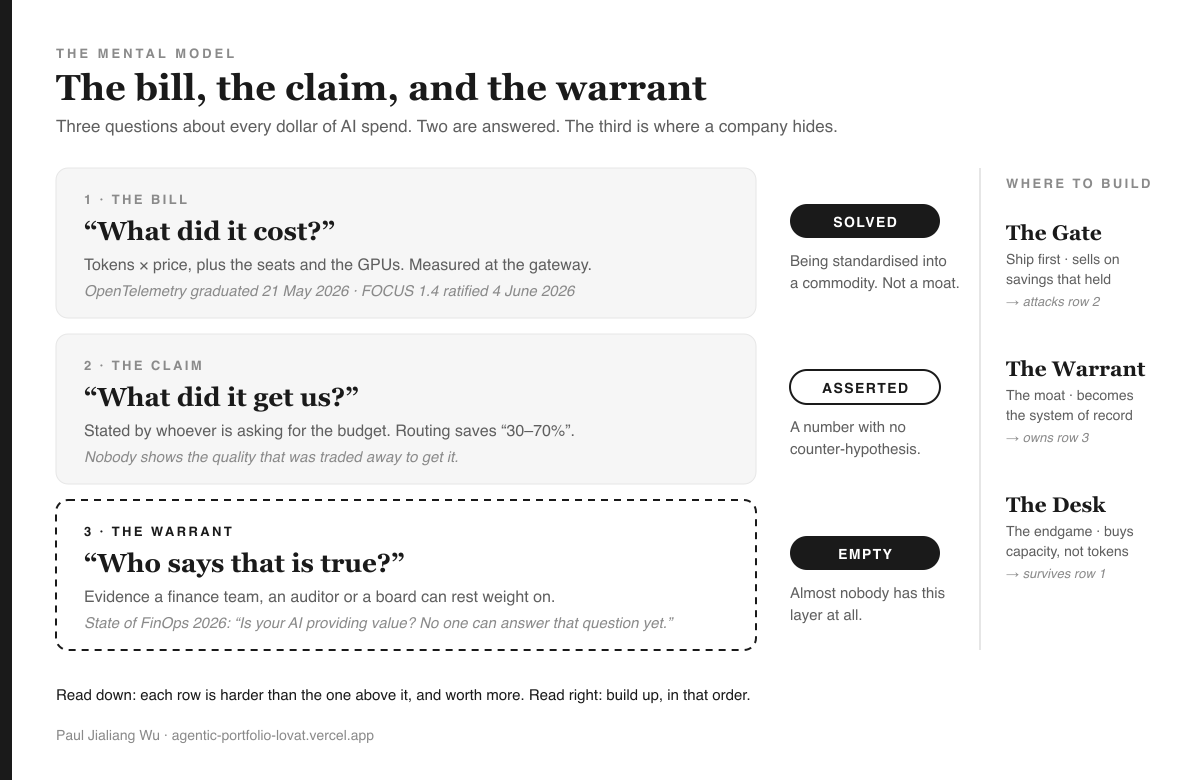
最贴近这个三层结构的独立表述,其实就来自成本可观测性领域本身:他们把市场分成三层——基础设施、推理与应用、业务归因——然后把关键话挑明了 [1]:
“Most organizations today have partial coverage of Layer 1 and Layer 2, but almost none have Layer 3. The tools that exist are strong within their layer but do not cross boundaries.”(中译:如今大多数组织在第一层和第二层有部分覆盖,但几乎没有覆盖第三层。现有工具各自在本层很强,但都无法跨层。)
第三层就是 warrant。这个领域里真正有分量的机会,都是在把这块地基浇出来。
插一句,其实这就是整个问题的核心
你大概见过这个统计:95% 的企业级生成式 AI 试点没有带来可衡量的成效。 这个数字出自 MIT 的 Project NANDA,2025 年 8 月被Fortune报道后成了几乎所有 AI 战略 PPT 的开场白 [10]。
所以我去核查了一下,毕竟写测量相关的文章,最基本的就是要查证。结果,查证过程本身比这个数字还更有意思。
原始报告描绘了一个转化漏斗:大约60%的组织考察过这些工具,20%进入试点,最终有5%真正落地。如果20%试点、5%上线,那么实际做过试点的组织 里,大约有四分之一达标——也就是说,约75%的试点未能通过一个本就设得很高的门槛,而不是95%的试点都失败了[11]。与此同时,样本量在传播中被层层放大:研究实际只对52家机构做了结构化访谈,调研了153位高管,而主流报道却写成150次访谈、350份问卷,后续媒体又不断引用更大的数字[11]。有评论者称其方法论“irresponsible and unfounded”(中译:不负责任且毫无根据)[11]。而发布这项报告的机构,恰好本身就在做一旦行业普遍失败就能受益的智能体基础设施[11]。
我得谨慎表述:大方向几乎肯定没错,而且还有没有利益相关者的人佐证。IBM 的数据是,达到预期 ROI 的 AI 项目占比 25%。S&P Global 则发现,2025 年有 42% 的公司放弃了大部分 AI 项目[10]。这个现象确实存在。
但请注意这层递归。被引用最多的“企业无法衡量 AI 价值”的证据,本身就是一个测得很糟糕的数字——既被媒体错误放大样本量,又由有利益相关方发布。一个连自己测量危机都量不准的行业,不可能靠再加一个仪表盘解决问题。这正是那个结构性悖论。
拉长时间轴:因为这个问题,其实历史上已经被解决过。
我把这个问题放进了四个时间窗口里思考——最近一个月的行业讨论、过去三十个月形成的默认做法、三十年沉淀下来的经验,以及三百年经得起考验的历史。长周期比短周期更有启发,这通常说明你面对的是结构性问题,只是换了新马甲。
1769 年——许可证账单和计量账单,这对组合早有先例
陶瓷匠 Josiah Wedgwood 在 1760 年代一边做精美器物,一边逐渐失去了对成本的把控。在写给合伙人 Thomas Bentley 的信里,他描述了自己账本上的发现[3]:
“Consider that these expences move like clockwork, & are much the same whether the quantity of goods made be large or small”(中译:要知道,这些开支就像钟表一样规律,无论产量多寡几乎都一样)
这句话,其实就是首次区分了固定成本和变动成本,而且这已经是257年前的洞见。Wedgwood 意识到,他的大头开支——模具、租金、燃料、账房、工资——和产量根本没关系。1772 年经济下行,许多同行倒下了,他却能幸存,因为他清楚哪些成本是“钟表”[3]。
放到今天的企业 AI 账本来看:席位授权、平台费、预留算力就是“钟表”,Token 则是变量。几乎所有这类工具都把变量计得清清楚楚,却把“钟表”留给别人用表格算。Wedgwood 要是看到,大概会觉得有趣,然后会把两者打通——这才是全部诀窍。
1865 年——为什么账单越来越高,单价却在下降
William Stanley Jevons 发现,更高效的蒸汽机并没有让英国的煤炭消耗减少,反而让煤炭变得经济可用,原本嫌贵不用的场景也开始烧煤。效率提升带动了需求扩张,远快于单位成本的下降。
这已经成了 AI 经济学里最稳妥的事实。某项能力的 Token 单价每年都在以数量级下降,但总支出还是一路上涨——据说 2025 年企业 AI 支出增长了数倍,而单价却在下跌。结构性原因也被正式总结出来:推理变便宜后,团队会理性地买更多架构——更深的推理、更长的上下文、更智能体化的循环——这些选择让 Token 消耗增长的速度远超价格下降[4]。
这带来了两个后果,而且方向完全相反,这也是为什么这个时间窗口值得关注。
首先:市场的增长几乎是板上钉钉。 只要你的业务建立在企业关心AI支出这件事上,你就会顺风顺水,哪怕没有一个客户变得更浪费。
第二点,没那么让人舒服:优化并不会让账单减少。 它只是改变了账单所买到的内容。如果你卖的是“我们帮你把token成本降了40%”,但客户下个季度因为上线了三个新agent,账单反而涨了90%,你确实兑现了承诺,却失去了续约。这正是我最担心初创者会踩的坑,Jevons在1865年就已经说透了。
1897年——答案其实早就有了:两部制费率
Samuel Insull当时负责芝加哥Edison公司,却始终让电力业务难以盈利。有一次去英国,他发现Brighton的工程师Arthur Wright造了一个能同时测量两件事的电表:你用了多少电,以及你用电的速度。峰值需求——也就是你需要预留的容量——此前没人单独计费。Wright的需求电表让芝加哥Edison可以按每个客户当月的最大用电量计费。到1897年,Insull已经在全市实行“两部制费率”:你预留的容量收一笔固定费用,每度电只收很低的单价[5]。
接下来的部分值得记住。Insull从此有了动力去吸引那些用电高峰错开的客户,比如不同时段——早上是有轨电车,白天是工厂,傍晚是住宅——因为每一个填补负载曲线低谷的客户,都会让其他客户的服务成本降低[5]。负载因子成了最关键的指标。价格下降,消费量激增,这又一次验证了Jevons定律。
把这个思路留在脑海,后文还会用到。这其实就是终局。
以及,为什么你应该把监管者的视角列入必读清单
2025年6月,美国上市公司审计监管机构PCAOB的一位董事,曾在铁路会计官员大会上发表演讲,题为Stop, Look, and Listen: The Legacy of American Railroads and the Dawn of AI。他指出,铁路业“几乎创造了现代会计的所有基本技术”;1827年诞生了第一份书面公司审计报告;1887年的《州际商务法》催生了第一个独立的联邦监管委员会,后来成了包括他自己机构在内的模板[12]。
他最后把话题引向当下:“Whether it is the telegraph, automation, or generative AI, auditors must remain skeptical to still meet their obligations to investors.”(中译:无论是电报、自动化,还是生成式AI,审计人员都必须保持怀疑精神,才能继续履行对投资者的责任。)[12]
所以,从监管者的角度看,历史的顺序是:一项新技术带来无法衡量的规模 → 有人发明了计量单位 → 单位被标准化 → 标准被审计 → 审计被监管。 现在,我们正处在“单位被标准化”和“标准被审计”之间。这是一个非常具体、非常适合创业的时点,也直接指明了下文三个想法中,哪一个才是真正能沉淀下来的。
过去三十个月:计量工具变成了基础设施
这正是短周期窗口的意义所在,因为这里发生了两件大多数创业者还没真正意识到的事。
标准已经落地。2026年5月21日,CNCF宣布OpenTelemetry正式毕业——这是其最高成熟度等级,也标志着默认可观测性标准的争议正式画上句号[7]。与此同时,GenAI语义约定为模型名称、输入输出token数、完成原因、工具调用及结果等定义了标准属性。这些约定已由VS Code Copilot、OpenAI Codex和Claude Code直接输出,也就是说,只要后端支持该协议,这些运行数据都能被读取[7]。这些约定虽仍属实验阶段,但方向已定。
账单的数据规范也随之而来。FinOps Foundation的FOCUS规范——跨厂商统一的成本与用量数据格式——于2026年6月4日正式通过1.4版本,其中新增了Contract Commitment dataset,涵盖支付模式、生命周期状态、折扣率和履约周期等信息[9]。请留意这个细节。标准组织不会无的放矢地加入commitment数据集,除非commitment即将成为资金流向的关键。
紧接着,整个赛道迎来整合。2026年1月16日,ClickHouse宣布收购Langfuse——这是目前部署最广的开源LLM可观测性平台,2025年底已拥有2万多GitHub星标、每月2600万SDK安装量,并被《财富》500强中的63家公司采用——同时还完成了4亿美元D轮融资,使ClickHouse估值达到150亿美元[8]。
把这三件事放在一起,结论就很清楚,也是本文的核心观点:
计量工具不是护城河。当数据规范成为公开标准,追踪数据由智能体自动输出,头部开源采集器又归属于一家市值150亿美元的数据库公司时,“我们能展示你的token花销”就只是你数据仓库的一个功能。这就是水管工程。对ClickHouse来说,做水管是好生意;但如果你是三个人的种子轮团队,这就成了死路。
最近三十天:市场正在争论什么
现在有两种鲜活的观点,我认为它们之间的分歧才是产品设计的真正战场。
主流观点,从今年FinOps X的报道来看,是分母的变化:“The metric to chase is value per token, not cost per token”(中译:真正该追逐的指标是每个token带来的价值,而不是每个token的成本)[13]。成本归因已经从云账单下沉到token级,现在又进一步细化到每次agent运行和会话级别,大家想要的输出指标是每个任务、每个结果、每次交互的成本[13]。同一社区的二手分析显示,实际将单位经济学应用到AI支出的从业者比例不到20%——我在主调查数据中没能确认这个数字,所以这里只作为方向性参考[13]。
非主流观点则更为尖锐,也值得认真对待,因为如果他们对了,这个领域的大部分产品都将失去意义。Yossi Hasson认为,AI定价会像电力和带宽一样,从按量计费转向预留容量,整个“节省token”的做法只是过渡现象[6]:
“Shaving tokens in 2026 is shaving kilobytes off GIFs in 2003. The work is real and the savings may be real. The whole problem is about to disappear anyway.”(中译:2026年还在抠token,就像2003年还在抠GIF的千字节。工作是真实的,节省也许也是真的。但整个问题很快就会消失。)
他对价值真正所在的总结只有一句话:
“Whatever is scarce here, it is not tokens. It is the guarantee.”(中译:这里稀缺的不是token,而是保障。)
他讲的,其实就是Insull那套“两部制费率”,只不过晚了129年才落地。值得注意的是,FOCUS 1.4刚刚上线了commitment数据集,这其实就是标准组织用schema形式和他站在同一阵线。
我认为他的方向没错,只是时机略早——关键在于:他的论点会让以token计量为核心的产品失去市场,却会让warrant类产品更有价值。如果未来的计费单位变成预留容量,那么“我们买的保障是否用上了?带来了什么产出?”就会变成一个更难、但也更有价值的问题,而不是更简单。下面所有的思路,都是为了在他判断正确时依然成立。
三种路径,这个问题如何变成一家公司
我筛选想法时设了四个标准:痛点必须有据可查,而不是凭空想象;产出的成果能积累成护城河,而不是一张截图;哪怕有一家市值150亿美元的数据库公司下季度就发了类似看板,也不会被轻易取代;并且即使 Hasson 关于容量的判断成真,这个点子依然成立。最后只剩下三条。我按自己实际会推进的顺序排列,不是按最终规模大小。
① Gate——节省成本且能确保证据的质量守门人
一句话概括。据称,模型路由和提示压缩可以让成本降低30–70% [15],但宣称这个数字的人从不展示他们为此牺牲了多少质量。Gate 就是这样一个系统:它持续用评测集验证更低成本的配置,只有在质量确实达标时才会推广上线,并会出具一份明确说明的凭证。
具体机制。以真实工作负载为基础,生成多个候选配置:比如更小的模型、更短的 system prompt、缓存断点、减少推理深度。每个候选都用客户自身流量抽取的分级评测集进行测试。只有所有样本都通过质量门槛,才允许上线,并将成本、延迟、缓存表现和评测结果作为签名数据记录在案。如果质量门槛失守,自动回滚。
为什么是现在?因为所需输入条件终于齐备。标准化 trace 意味着你无需为每个客户单独集成,就能还原工作负载的实际表现[7]。而且买家的关注点已经发生根本转变:现在没有高管再问“你能不能帮我们省推理费”,而是问“你怎么证明没有悄悄把产品质量做低”,这其实是证据问题,而非单纯的工程问题。
护城河。不是路由器本身——路由器几天就能写出来。真正的护城河,是你积累下来的评测集和上线历史:一年后,你手里有每个客户真实流量下,哪些 trade-off 成立、哪些失效的完整记录。这套数据集,竞争对手无法购买,并且每次新变更的认证成本都会更低。更重要的是,这也是让客户真正难以替换你的关键。
买方与切入点。平台或 AI 基础设施负责人,卖点是基于可控对比的结果,而不是空口承诺。切入方式可以是一次单一工作负载的审计:这是你当前的成本,这是四种更低成本的配置,这里有两种质量守住了、两种没守住。那两种没通过的,才是你的公信力。
工作量:小到中等。测量 harness 本身不大,难点在于评测集,而且冷启动问题确实存在——有些客户根本无法界定“好”的标准,这类客户实际上帮不上忙,而且比例不低。
什么会让它失效?如果模型提供商直接把这功能作为免费路由特性原生上线,这完全可能;防御方式是跨多家、保持独立,因为卖 token 的那一方天然不适合来证明降级没有损失质量。还有Jevons:永远不要卖“你的账单会降”,而要卖“你的账单能买到更多,而且我能证明没有牺牲质量”。
什么会证伪它?如果企业最终愿意接受厂商自报的节省数字,而不要求独立的质量证据,这门生意就没有成立的基础。可以低成本测试:为十个团队免费做一次审计,看看是否有人关心评测方法。如果一个都没有,及时止损。
② Warrant——拒绝无证背书的账本
一句话梗概。 把 AI 支出自下而上贯通——从调用、会话、工作流到业务结果——精确算出每个结果的真实成本,并且对没有证据支撑的价值主张一律拒绝认证,直接标记为未验证。这就是 Layer-3 的地基[1]。
具体机制。 三次数据关联加一条原则。支出通过现有的关联键与工作流对接,工作流再与实际承载结果的系统打通——比如已解决的工单、已完成的任务、已审核的合同、已结案的案件。结果再与基线数据挂钩,这样每个结果的成本才有可比性。原则就是产品本身:每条主张都必须附上证据和它击败的反假设,未通过的主张要直接以“被拒绝”并注明原因 展示。宣称节省和已验证节省分为两栏,没有证据的主张永远不能转正。
为什么是现在。 因为行业协会已经把需求摆在台面上——“Is your AI providing value? No one can answer that question yet.”(中译:你的 AI 有创造价值吗?现在还没人能回答这个问题。)[2]——而且各种佐证失败的数据已经多到让预算不得不动:IBM 统计四分之一项目达到预期 ROI,S&P Global 发现 2025 年有 42% 的公司放弃了大部分 AI 项目[10]。还有一个有据可查的根本原因,这个产品正面切中:大量 AI 项目是凭没人复查的收益预测批下来的,开工前也没有统一的“成功”定义[10]。一份在花钱之前 就强制定义目标的账本,正是针对这个具体失败点的解法。
护城河,而且是本文最坚实的那一道。 结果端的关联天然高度客户化。它深嵌在银行的工单规则、制造业的关账日、保险公司的理赔状态里。OpenTelemetry 能标准化 trace,但没有任何标准能定义每家公司“已解决”具体指什么。做这一步,每个客户都要投入数周枯燥的数据集成,但一旦建好,它就成了财务部门写进董事会材料的系统记录。没有人会为了省一笔订阅费把系统记录拆掉。这也是 PCAOB 那条历史链所预言最终会变成可审计、甚至强制要求的那一层[12]——谁要签字,谁就离不开它,这类业务的生命线极长。
买方。 CFO 体系,CIO 联合推动。和本领域大多数卖给工程部门的产品不同,这反而是优势:预算池不同,体量更大,竞争也更稀疏。
工作量:中到大。坦率说,本质是数据集成型业务,外面披着分析工具的外壳。谁来做,第一场会就要把这话挑明——怕麻烦的客户本来也不会做成。
什么会让它失败。 首次交付价值太慢——如果第一次数据打通要一个季度,试点还没出结果就胎死腹中。对策:先把 Gate 卖出去,用它争取集成时间。还有一个现实风险是没人真的想要一个被验证的答案,因为未验证的答案对守预算的人反而更有用。这是事实,所以第一个设计合作方必须是财务部门,而不是 AI 团队。
什么会证伪它。 如果连续三家财务组织都更喜欢拍板式估算而不是有证据支撑的区间,那说明市场要的是表演,这个产品就不适合了。
③ The Desk ——买容量,不买 tokens
一句话概括。 随着 AI 定价从按量计费转向预留容量和承诺合约,总得有人决定承诺多少、期限多长、分配给哪些服务商,并且持续管理负载因子。这就是 desk 的职责,正是 Insull 在 1897 年的工作内容 [5]。
具体机制。 针对每个工作负载做需求预测,决定承诺与按需的配比。流量调度优先填补预留容量的低谷,超出部分再用临时价格。内部结算按容量计价,让各团队清楚自己实际持有的容量,而不仅仅是消耗了多少 tokens —— 内部实现“两部制”计费。同时,保留自己的预测校准记录,让 desk 的可信度有据可查,而不是凭主观判断。
为什么是现在? 三个独立信号正在汇聚:2026 年 6 月 FOCUS 1.4 发布了 Contract Commitment 数据集 [9];有见地的非主流观点认为,真正稀缺的不是 tokens,而是“the guarantee”(中译:保障/承诺)[6];再加上一个简单事实:推理已成为企业 AI 预算中的主要支出项之一 [1]。云计算领域的对应做法——预留实例和节省计划优化——已经支撑起多个成熟业务,如今 AI 领域也有标准组织在铺设轨道。
护城河。 预测能力是可以积累的。一个 desk 拥有两年需求历史和带分数的预测记录,在定价承诺时比新入场者更有优势,节省下来的是真实的成本,而不是故事——这让它在三者中最容易落地,也最难被质疑。
工作量:中等。 建模难度可控。关键依赖在于:这个业务需要服务商真正提供多样化的承诺结构,而目前各家差异较大。
什么会让它失效?直说。 如果服务商持续保持简单且宽松的定价,就没有可操作的空间。这三者里 Desk 的波动最大:如果容量假说成立,它空间最大;如果不成立,价值几乎归零。本质上赌的是市场结构,而不是单一痛点。
什么会证伪它? 连续四个季度关注服务商的定价变化。如果到 2027 年中,承诺容量的分级还没有大规模出现,这个假说就站不住脚,坦率承认比自欺欺人强。
顺序才是关键洞见
这不是三家公司,而是一家公司分三幕,顺序和最终体量无关。
先做 Gate ——它体量最小,靠对照实验切入市场,并获得追踪数据的入口。Gate 的证据链就是 Warrant 的种子语料:一旦你在认证变更是否守住质量时,实际上已经在积累每个工作负载所需的价值凭证。Warrant 让 Desk 有据可依,因为你无法对那些无法举证价值的工作负载,负责任地承诺容量。Gate 作为切入口,Warrant 构筑护城河,Desk 决定最终格局。
三者都要做的战略理由在于:它们分别应对不同的不确定性。Gate 如果被服务商原生吸收路由功能就会失效;Desk 如果定价始终保持简单也会失去空间。唯一能穿越这两种极端情形、始终成立的,就是 Warrant——而且正如 1887 年起步、经由审计再到监管的历史链条所揭示的那样:它的价值只会随着时间积累而提升,而不是被消耗 [12]。
创始人与产品的适配,坦诚自评
这一段谈的是我自己,所以我会比融资路演时还要严苛地审视。
这种适配极为具体。 我的项目集不是一堆 AI 应用,而是一组专门“拒绝随意认证”的机器。有独立打分的评测操作系统;有“构建-评测一体”的引擎,成绩单的上限取决于背后证据的强度,所以仅靠文字支撑的主张,分数永远比不过通过 gate 验证的主张。有安全仓库,核心数字坦然写着 0/20,因为还没有任何集成收据。有住房引擎,408 条路径 0 条可部署,每一个阻碍都被明确标注。有 HR 引擎,AI 起草的规则只有在合格人类签字、录入 evidence ledger 后,才能从“claimed”变为有效。有财务系统,资金流必须经过人类闸门,预测还要用 Brier 分数打分。
这十年里,我反复在构建同一个“器官”——一个不允许你提出无法举证的主张的系统。 行业协会自己都明说了,市场最核心的未解难题,就是没人能为 AI 价值举证。这不是我主动选择的方向,而是我观察到的契合。
我手头唯一能直接迁移的资产,就是现有的 ablation harness:提示和模型变体,逐轮测算成本、延迟、缓存表现,背后有 gate,要求每个单元都必须通过能力门槛,且没有遗漏。这就是 ① 的实物,而不是 PPT。分层证据的成绩单,是 ② 的缩影。带校准打分的预测账本,就是 ③ 所需的工具。
但也有明显短板。
广度是风险,而非优势。 七十九个项目可以叫作品集,但独角兽是六年如一日地把一件事做到极致。所有让我善于发现机会的工作习惯——多线程并行、广泛阅读、快速重构——恰恰与深耕一个方向所需的能力背道而驰。换作我是投资人,看到这样的项目清单也会首先质疑,所以我先自问。
圈层壁垒。 我的工程和企业交付经验很深,但 ② 的买家是财务组织,而我在 FinOps 实践圈毫无资历。这个圈子极为紧密,每年有自己的大会、调研,只有真正扛过 pager 的人才有公信力。现实的第一步不是写代码,而是先找到一位 FinOps 或财务转型的实践者做设计合伙人,给出股权,产品一行代码都别写。
利益与合规风险。 任何目前在企业咨询或金融服务业任职的人,若要创业做企业 AI 成本治理,第一步必须与雇主就知识产权和利益冲突问题签署书面协议。这不是脚注,而是第一个 gate。
冷启动难题。 ① 需要一套分级评测集,而最需要成本管控的客户,往往连“好结果”是什么都难以界定。这其实是服务属性藏在产品命题里,也是许多有潜力的评测公司最终转型做咨询的原因。
模式与反模式
正向模式。 卖反假设,不卖单一数字——能经受反驳的发现,比三个仅仅算出来的发现更有分量。要敢于展示被拒绝的案例:一份明确列出哪些主张未获认证的报告,是最快赢得财务部门信任的方式。把“钟表成本”与“计量器”打通,因为 Wedgwood 早就指出,绝大部分资金其实还压在固定成本上。能按容量定价就按容量定价。自己的预测要带分数上账,因为只有自我评分的 desk,才值得信赖。
反面教材。 在一个已经有 CNCF 标准、主流采集器归属于市值 150 亿美元数据库公司的市场里,再去做第四个支出看板,是典型的误区。承诺账单会下降,但自 1865 年 Jevons 就证明这种承诺注定落空。用提示词长度来推断提示冗余,忽略了模型计费还包括系统指令、注入上下文、检索内容和历史。简单筛查“浪费”会带来自信但错误的建议——因为高价模型有时确实物有所值。还有,在讨论测量的话题时,未经核查就引用 95% 这个统计数据——我自己差点也犯了这个错误。
底层机制与第一性原理
机制。 一个成本数字,只有和实际结果建立关联,并经受住明确的反驳后,才具备决策意义。缺少关联,只是算术;缺少挑战,只是自说自话。这个领域真正有价值的,是能实现这种关联和质询的机制。
一句话的第一性原理。 测量本身并不稀缺——有凭据的 测量才是,因为一个无法被证伪的数字,无法为决策提供依据。
这个市场的“收据”已经做得很精细,但“成绩单”还没出现。三百年的会计史都在说明,真正能沉淀为制度的是成绩单,而监管者也已经明确说出了这一步的先后顺序。
相关内容
参考文献
- CloudZero。什么是 AI 成本可观测性?LLM 和 AI 支出追踪指南。 三层框架;Gartner 预测 2026 年全球 AI 支出将达 2.52 万亿美元(同比增长 44%),其中 AI 基础设施 4010 亿美元;AI 支出管理比例 98% / 63% / 31%。cloudzero.com/blog/ai-cost-observability/
- FinOps Foundation。2026 年 FinOps 现状。“Is your AI providing value? No one can answer that question yet.”(中译:你的AI到底创造了价值吗?现在还没有人能回答这个问题。);FinOps for AI 被列为最重要的前瞻性优先事项;AI成本管理成为当前最亟需培养的核心技能。data.finops.org · 另见 Linux Foundation 新闻稿
- Bamboo Innovator(2013)。一位陶艺家如何把会计带进工业时代。Wedgwood致Thomas Bentley的信,原文引用;固定/变动成本的发现,以及他在1772年经济低谷中的幸存。bambooinnovator.com/2013/04/19/…
- Jevons, W. S.(1865)。煤炭问题。描述,并非原文引用。AI推理机制的现代形式化:The Economics of Digital Intelligence Capital: Endogenous Depreciation and the Structural Jevons Paradox,arXiv。arxiv.org/pdf/2601.12339
- Gridium。需求电价的历史。Arthur Wright在布莱顿发明的需求电表;芝加哥Edison公司1897年需求电价;负载因子为平均负载与峰值负载之比。gridium.com/history-of-demand-charges/
- Hasson, Y.Stop Counting Tokens. Nobody Counts Megabytes.两条引文均已与原始来源逐字核对。yossihasson.substack.com/p/stop-counting-tokens-nobody-counts
- Cloud Native Computing Foundation(2026年5月21日)。CNCF宣布OpenTelemetry毕业,正式确立其为事实上的可观测性标准。GenAI 语义规范;由 VS Code Copilot、OpenAI Codex 和 Claude Code 输出。cncf.io/announcements/2026/05/21/… · opentelemetry.io/blog/2026/otel-graduates/
- ClickHouse(2026 年 1 月 16 日)。ClickHouse 完成 4 亿美元 D 轮融资,收购 Langfuse。估值 150 亿美元;Langfuse 的应用数据。clickhouse.com/blog/… · 收购公告 · InfoWorld
- FinOps Foundation。FOCUS 规范。1.4 版于 2026 年 6 月 4 日正式通过,新增 Contract Commitment 数据集。focus.finops.org/focus-specification/· 摘要:amnic.com/blogs/…
- Challapally, A., Pease, C., Raskar, R., & Chari, P.(2025)。The GenAI Divide: State of AI in Business 2025(MIT Project NANDA)。主流报道:Fortune,经 Yahoo Finance。ROI 相关数据(IBM 25%;S&P Global 42% 项目放弃率)整理自 Terminal X,AI ROI in 2026.
- Futuriom。Why We Don't Believe MIT NANDA's Weird AI Study. futuriom.com/articles/news/… · 漏斗结构复原(60%调研、20%试点、5%落地)及样本量膨胀:NewMR,Myth Number 2: MIT Showed That 95% of AI Pilots Fail. patreon.com/NewMR/posts/…
- Botic, G. R.(2025年6月18日)。Stop, Look, and Listen: The Legacy of American Railroads and the Dawn of AI. 美国铁路协会会计官员及内部审计部门演讲。PCAOB。pcaobus.org/news-events/speeches/…
- Abbruscato, A.FinOps X 2026 回顾:AI Tokenomics 解析。 Mavvrik。“The metric to chase is value per token, not cost per token”(中译:衡量的指标应该是每个 token 的价值,而不是每个 token 的成本)。二级社区分析中出现了低于20%的单位经济学应用比例,但在主调查数据中未能确认,因此正文仅作为方向性数据引用。mavvrik.ai/blog/finops-x-2026-ai-token-economics/
- Braintrust。如何追踪 LLM 成本(2026):按用户、按功能、按 agent 运行归因的实用手册。 braintrust.dev/articles/how-to-track-llm-costs-2026
- Zylos Research(2026年4月12日)。AI Agent 成本优化:Token 预算、模型路由与生产 FinOps。 30–70% 路由节省区间的来源。zylos.ai/research/…
研究资料包于2026-08-17整理,覆盖四个时间窗口——30天、30个月、30年、300年。共十五个来源。八条核心论据在起稿前已逐一核查原始出处;一条引用(Wedgwood 的“like clockwork”句)在前两处未能核实,仅在确有原文出处处引用;一项统计(应用单位经济学的从业者比例)在主调查中未能确认,正文中已注明为方向性数据而非直接删去。本文未包含任何雇主或客户的材料。——Paul Jialiang Wu ·agentic-portfolio-lovat.vercel.app