AI-Native 시리즈 · AI 경제학
모두가 더 나은 증빙을 만들고 있다
1분 요약 — 이 글을 읽고 얻어갈 것
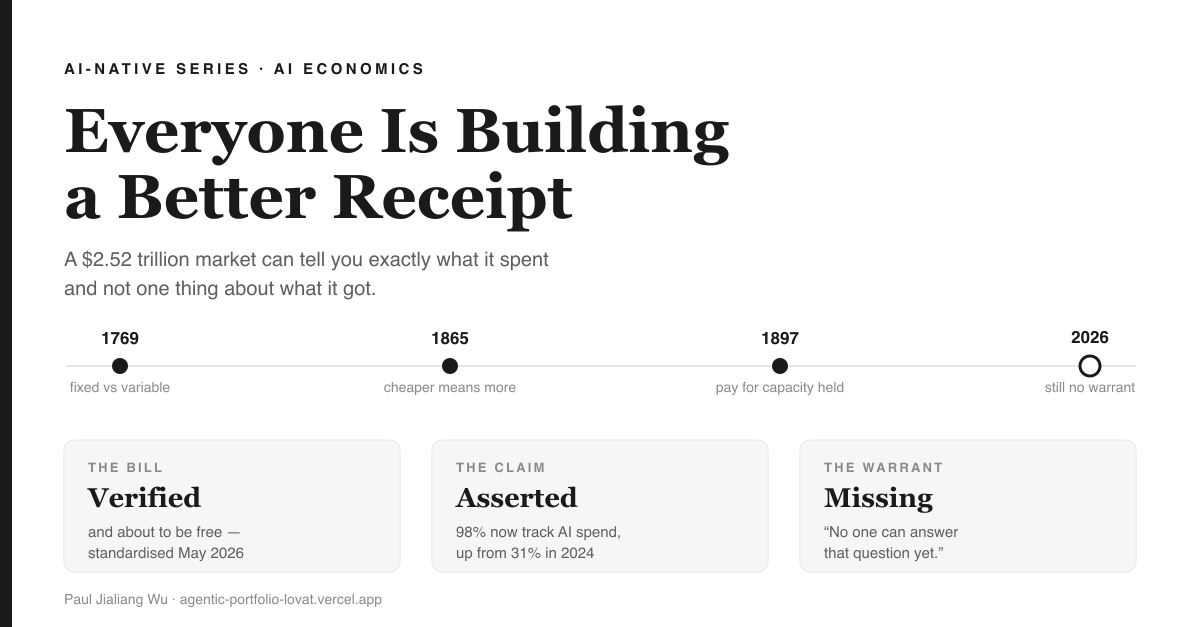
2026년 전 세계 AI 지출은 2조 5,200억 달러에 이를 것으로 전망되며, 업계의 연례 설문조사는 is your AI providing value?라는 질문에 “No one can answer that question yet.”(번역: 아직 그 질문에 누구도 답하지 못한다.)이 분야에서 무언가를 만드는 거의 모든 이들이 더 나은 계량기를 만들고 있다. 그런데 그 계량기는 2026년 5월에 표준이 되었고, 2026년 1월에 통합까지 마쳤다. 이런 일은 방어벽이 아니라 배관에서나 일어나는 일이다. 오래가는 사업의 본질은 숫자가 아니다. 핵심은 바로 워런트다. 즉, 그 숫자에 재무팀이 안심하고 기대어도 된다는 증거다. 이 워런트가 실제로 회사가 되는 세 가지 지점을, 내가 실제로 만들 순서대로 소개한다. 첫째는 Gate로, 품질이 확실히 유지된 절감만을 기록한다. 둘째는 Warrant 원장으로, 지출과 결과를 연결하고 증거 없는 것은 인증하지 않는다. 셋째는 Desk로, 토큰을 세는 대신 용량을 산다. 그리고 마지막, 세 번째 방식이 앞의 둘을 무의미하게 만들 수 있는 솔직한 이유도 있다.
나는 올해 대부분의 시간을 AI 비용을 알려주는 도구들을 살펴보는 데 썼다. 이 도구들은 정말 잘 만들어졌다. 진심으로 — 이 분야의 엔지니어링은 탄탄하고, 대시보드는 빠르며, 통합은 코드 한 줄이면 끝난다.
그런데 이 모든 도구가 결국 답하는 질문은 같다. 바로 우리가 얼마를 썼나이다. 이 질문의 답은 이미 내 손에 있다. 그게 바로 청구서다.
이 범주 전체를 다시 생각하게 만든 계기가 있다. FinOps Foundation이 업계 최대 규모의 연례 실무자 설문조사를 진행한다. 2026년판에서, 'AI 지출이 왜 어려운가'라는 항목 아래 이런 문장이 있다 [2]:
“Is your AI providing value? No one can answer that question yet.”(번역: 당신의 AI가 가치를 제공하고 있습니까? 아직 그 질문에 누구도 답하지 못한다.)
이건 벤더의 홍보문이 아니다. 바로 그 사실을 알아야 할 책임이 있는 사람들이 모인 업계 단체가, 아무도 모른다고 공식적으로 밝힌 것이다. 그리고 같은 보고서에서, 실무자의 98%가 이제 AI 지출을 관리한다고 답했다 — 2025년 63%, 2024년 31%에서 크게 오른 수치다. [1][2].
이 두 사실을 나란히 놓고 보면, 아주 구체적인 이야기가 나온다. 2년 만에 업계는 지출을 측정하는 일에는 거의 모두가 도달했지만, 그 지출로 무엇을 얻었는지 아는 일에는 거의 아무도 도달하지 못했다. 우리는 놀라운 속도로 계량기를 만들었지만, 계량기 자체는 어려운 문제가 아니었다.
내가 쓰는 사고의 틀: 청구서, 주장, 그리고 워런트
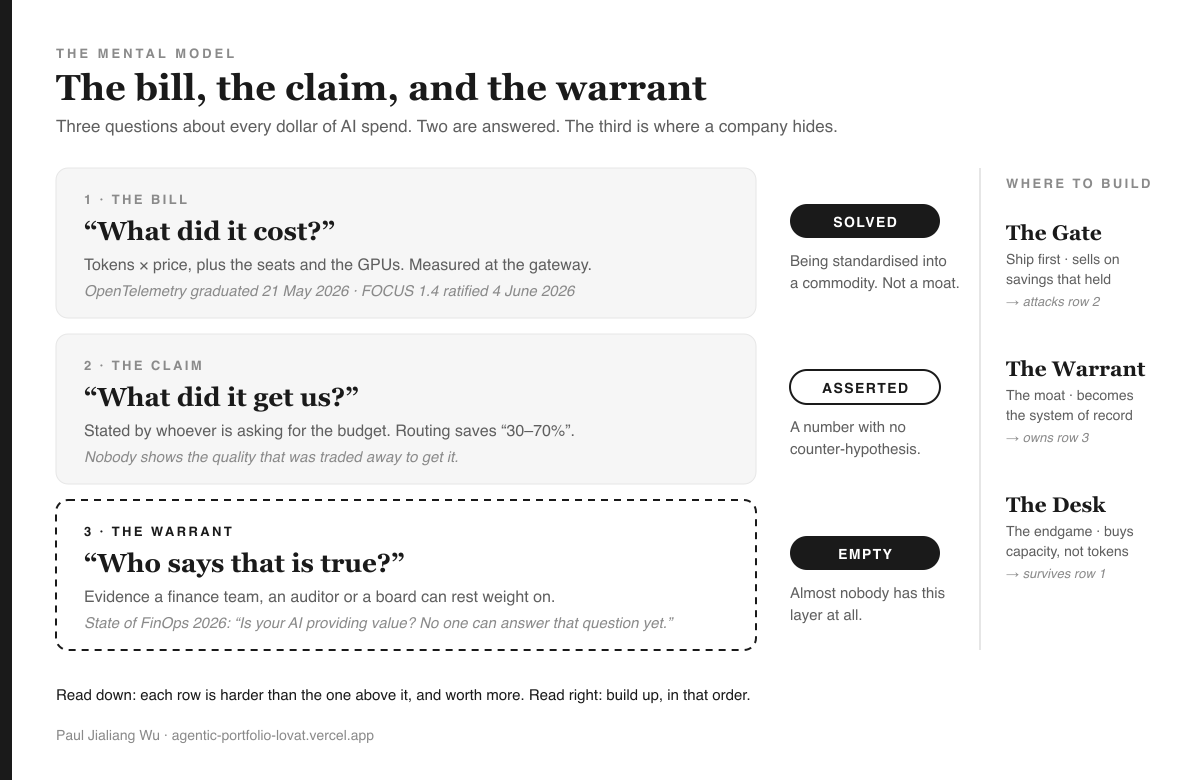
AI에 돈을 쓸 때마다 세 가지 질문이 따라붙는다. 이 세 가지를 동시에 머릿속에 떠올릴 수 있다.
청구서. 얼마가 들었는가? 토큰 수에 단가를 곱하고, 좌석 수와 GPU 비용을 더한다. 이 부분은 측정된다. 게이트웨이나 인보이스에서 바로 뽑아낼 수 있고, 논란의 여지가 없다.
주장. 우리는 무엇을 얻었는가? 이건 주장된다— 그리고 거의 항상, 내년도 예산을 요청하는 사람이 직접 주장한다. "추론 비용을 40% 절감했습니다." "이 에이전트 덕분에 지원팀이 티켓당 9분을 절약합니다."
워런트. 그 주장이 사실임을 누가 증명하는가? 그 주장이 사실이 아니길 바라는 재무 담당자 앞에서도 버틸 수 있는 증거가 있는가? 이 부분은 아예 없다. 얇은 게 아니라, 통째로 빠져 있다.
이 구조를 가장 정확하게 설명하는 독립적 관점은 비용 관측성 분야에서 나온다. 이들은 시장을 세 개의 층—인프라, 추론 및 애플리케이션, 그리고 비즈니스 귀속—으로 나누고, 이어서 이렇게 말한다 [1]:
“Most organizations today have partial coverage of Layer 1 and Layer 2, but almost none have Layer 3. The tools that exist are strong within their layer but do not cross boundaries.”(번역: 오늘날 대부분의 조직은 1층과 2층만 부분적으로 다루고 있으며, 3층을 갖춘 곳은 거의 없다. 기존 도구들은 각 층 안에서는 강력하지만, 경계를 넘지는 못한다.)
3층이 바로 워런트다. 이 분야에서 진짜 기회란, 그 바닥을 붓는 방식이다.
겉보기엔 곁가지 같지만, 사실상 문제의 핵심
이 유명한 통계를 본 적 있을 것이다.엔터프라이즈 생성형 AI 파일럿의 95%가 측정 가능한 임팩트를 내지 못한다. 이 수치는 MIT의 Project NANDA에서 나왔고,Fortune을 통해 2025년 8월에 대중화되었으며, 지금은 전 세계 거의 모든 AI 전략 발표 자료의 첫 슬라이드에 등장한다 [10].
그래서 나는 직접 확인해봤다. 측정에 관한 글을 쓰는 입장에서 최소한 해야 할 일이고, 확인 과정이 숫자 자체보다 더 흥미로웠다.
해당 보고서는 일종의 퍼널 구조를 설명한다. 대략 60%의 조직이 이런 도구를 검토했고, 20%가 파일럿 단계에 진입했으며, 5%만이 실제로 도입에 성공했다. 즉, 20%가 파일럿을 하고 5%가 실제로 도입했다면,실제로 파일럿을 실행한 조직 중 약 4분의 1이기준을 통과한 셈이다 — 즉, 의도적으로 높게 잡은 기준을 75%의 파일럿이 넘지 못한 것이지, 95%가 실패했다는 이야기는 아니다 [11]. 한편, 표본 크기는 전달 과정에서 부풀려졌다. 해당 연구는 52개 조직과 구조화된 인터뷰를 진행했고, 153명의 리더를 설문조사했으나, 주요 언론에서는 150건의 인터뷰와 350건의 설문조사 응답자로 보도했고, 이후 다른 매체들이 이 더 큰 수치를 반복 인용했다 [11]. 한 평론가는 이 방법론을 "irresponsible and unfounded"(번역: '무책임하고 근거 없다')고 평했다 [11]. 그리고 이 결과를 발표한 단체는, 흥미롭게도, 이런 실패 사례가 많을수록 자신들의 에이전트 인프라 사업에 유리한 입장에 있다 [11].
나는 신중하게 말하고 싶다. 방향성 자체는 거의 확실히 맞고, 그런 이해관계가 없는 이들에 의해서도 뒷받침된다. IBM은 기대한 ROI를 달성한 AI 프로젝트의 비율을 25%로 집계했다. S&P Global은 2025년에 기업의 42%가 대부분의 AI 프로젝트를 포기했다고 밝혔다 [10]. 이현상은 실제로 존재한다.
그런데 이 재귀적 상황을 곱씹어볼 만하다.기업들이 AI의 가치를 측정할 수 없다는 가장 널리 인용되는 근거 자체가, 표본 크기를 잘못 집계한 언론에 의해 증폭되고, 결과에 이해관계가 있는 단체가 발표한, 제대로 측정되지 않은 숫자다.자기 측정 위기를 측정하지 못하는 산업은 네 번째 대시보드로는 고쳐지지 않는다. 그게 바로 농담이자, 이 구조를 떠받치는 핵심이다.
긴 시간의 관점 — 이 문제는 이미 여러 번 해결된 적이 있다
나는 이 질문을 네 개의 시계열로 나눠 살폈다. 이번 달에 무슨 이야기가 오가는지, 지난 30개월간 실제로 표준이 된 것은 무엇인지, 30년을 버틴 것은 무엇인지, 300년을 버틴 것은 무엇인지. 긴 시간대가 짧은 시간대보다 더 유용했다. 이는 구조적 문제에 새로운 탈을 씌운 것일 가능성이 높다는 신호다.
1769년 — 라이선스 청구서와 계량 청구서는 새로운 조합이 아니다
도공 Josiah Wedgwood는 1760년대에 아름다운 도자기를 만들면서도 그 비용을 제대로 파악하지 못했다. 그는 동업자 Thomas Bentley에게 보낸 편지에서 자신의 장부에서 발견한 사실을 이렇게 적었다 [3]:
“Consider that these expences move like clockwork, & are much the same whether the quantity of goods made be large or small” (번역: '이 비용들은 시계처럼 움직이며, 생산량이 많든 적든 거의 변하지 않는다')
이 문장은고정비와 변동비의 구분을 발견한 대목이다. 무려 257년 전의 일이다. Wedgwood는 금형, 임대료, 연료, 경리, 임금 등 큰돈이 드는 항목들이 생산량과 무관하게 거의 변하지 않는다는 사실을 알아냈다. 1772년의 불황은 그의 경쟁자 다수를 쓰러뜨렸지만, 그는 살아남았다. 자신만이 어떤 비용이 '시계처럼' 움직이는지 알고 있었기 때문이다 [3].
현대 기업의 AI 자산을 보자. 좌석 라이선스, 플랫폼 요금, 예약 용량이 바로 그 '시계장치'다. 토큰은 변동비다. 이 분야의 거의 모든 도구는 변동비를 정교하게 계측하지만, 고정비는 남의 스프레드시트로 취급한다. Wedgwood라면 이 상황을 우스워했을 것이고, 결국 두 가지를 연결했을 것이다. 그게 바로 핵심이다.
1865년 — 청구서는 늘고 가격은 떨어지는 이유
William Stanley Jevons는 더 효율적인 증기기관이 영국의 석탄 소비를 줄이지 못한다는 사실을 발견했다. 오히려 이전에는 너무 비싸서 시도하지 못했던 용도에까지 석탄 사용이 경제적으로 가능해지면서, 전체 소비가 늘어난 것이다. 효율성 향상이 단위당 비용을 줄이는 속도보다 수요 확대가 더 빨랐다.
이제 이것이 AI 경제학에서 가장 신뢰할 만한 사실이 되었다. 주어진 성능의 토큰 단가가 해마다 거의 한 자릿수씩 떨어졌지만, 전체 지출은 오히려 늘었다 — 실제로 2025년 한 해 동안 기업 AI 지출이 수백 퍼센트 증가한 반면, 단가는 하락했다. 구조적 버전은 이미 공식화됐다. 추론 비용이 저렴해질수록, 팀들은 합리적으로더 많은 아키텍처 — 더 깊은 추론, 더 긴 컨텍스트, 더 많은 에이전트형 루프 — 를 구매하게 되고, 이런 선택들이 토큰 소비를 가격 하락보다 더 빠르게 증가시킨다 [4].
두 가지 결과가 나오는데, 서로 반대 방향을 가리킨다. 그래서 이 창이 중요하다.
첫째, 시장은 성장할 수밖에 없다. 기업들이 AI 지출을 신경 쓰는 한, 그에 기대는 비즈니스는 단 한 명의 고객도 더 낭비하지 않아도 이미 순풍을 탄다.
둘째, 그리고 덜 달가운 진실: 최적화는 청구서를 줄여주지 않는다. 청구서가 무엇을 사는지를 바꿀 뿐이다. "토큰 비용을 40% 절감했습니다"라고 팔았는데, 다음 분기에 고객이 에이전트 세 개를 더 도입해서 청구서가 90% 올랐다면, 당신은 약속한 바를 정확히 이행했고 갱신은 놓쳤다. 이게 바로 이 분야의 초보 창업자가 가장 쉽게 빠질 함정이고, Jevons가 1865년에 이미 예고한 바다.
1897년 — 이미 답은 나와 있었고, 그것은 이부 요금제였다
Samuel Insull은 Chicago Edison을 운영했지만 전기 사업을 수익화하지 못했다. 영국을 방문했을 때, Brighton의 엔지니어 Arthur Wright가 두 가지를 측정하는 계량기를 만들었다는 사실을 알게 된다. 즉, 얼마나 많은 전기를 썼는지, 그리고 얼마나 빠르게 썼는지였다. 피크 수요—즉, 고객이 필요로 해서 미리 확보해둔 용량—는 아무도 요금 청구를 하지 않던 항목이었다. Wright의 수요 계량기는 Chicago Edison이 각 고객의 월별 최대 수요에 따라 요금을 청구할 수 있게 했고, 1897년이 되자 Insull은 도시에 이부 요금제를 도입했다. 즉, 고객이 예약한 용량에 대한 고정 요금과, 실제 사용량에 대한 매우 낮은 단가 요금이 그것이다 [5].
이후의 전개가 바로 기억해둘 만한 대목이다. 이제 Insull은 고객들의 피크가 서로 다른 시간대 — 아침엔 노면전차, 낮엔 공장, 저녁엔 가정 — 에 분포하길 바랄 이유가 생겼다. 부하 곡선의 골짜기를 채우는 고객이 많을수록 다른 모든 고객을 더 싸게 서비스할 수 있었기 때문이다 [5]. 부하율(load factor)이 가장 중요한 수치가 되었고, 가격은 떨어지고 소비는 폭발적으로 늘었다. Jevons의 법칙이 다시 한 번 정확히 맞아떨어진 셈이다.
이 구조를 머릿속에 잠시 담아두라. 이것이 바로 엔드게임이다.
그리고 왜 규제기관의 시각이 중요한지
2025년 6월, PCAOB(미국 상장기업 회계감사 법인을 감독하는 기관)의 이사가 철도 회계 담당자들에게 Stop, Look, and Listen: The Legacy of American Railroads and the Dawn of AI라는 제목으로 연설을 했다. 그의 설명에 따르면, 철도가 "현대 회계의 거의 모든 기본 기법을 창조했다"는 것, 1827년에 최초의 서면 기업 회계감사 보고서가 발행되었다는 것, 그리고 1887년의 Interstate Commerce Act가 최초의 독립 연방 규제위원회를 탄생시켰고, 이는 이후 자신의 기관을 포함한 여러 기관의 모델이 되었다는 것이다 [12].
그가 현재와 연결하며 남긴 결론은 짧다. "Whether it is the telegraph, automation, or generative AI, auditors must remain skeptical to still meet their obligations to investors." [12](번역: 전신이든, 자동화든, 생성형 AI든, 감사인은 투자자에 대한 의무를 다하기 위해 항상 회의적이어야 한다.)
따라서 규제기관의 입에서 나온 역사적 순서는 다음과 같다.새로운 기술이 측정 불가능한 규모를 만든다 → 누군가 단위를 발명한다 → 그 단위가 표준화된다 → 그 표준이 감사를 받는다 → 그 감사가 규제된다. 우리는 지금 "단위가 표준화된다"와 "표준이 감사를 받는다" 사이 어딘가에 있다. 이는 회사를 시작하기에 매우 구체적이고 좋은 위치이며, 아래 세 가지 아이디어 중 어떤 것이 진짜로 지속 가능한지 알려준다.
지난 30개월: 계량기는 이제 인프라가 되었다
바로 이 지점에서 짧은 시간 창이 진가를 발휘한다. 여기서 일하는 대부분의 사람들이 아직 제대로 반영하지 못한 두 가지 변화가 있었기 때문이다.
스키마가 표준이 되었다.2026년 5월 21일, CNCF가 OpenTelemetry의 졸업을 공식 발표했다. 이는 관측성 분야의 사실상 표준 논쟁에 마침표를 찍는 최고 단계였다 [7]. 여기에 GenAI 시맨틱 컨벤션이 모델명, 입력·출력 토큰 수, 종료 사유, 도구 호출 및 결과 등 표준 속성을 정의했다. 이 컨벤션은 이미 VS Code Copilot, OpenAI Codex, Claude Code에서 출력되고 있으므로, 이들의 실행 내역은 해당 프로토콜을 지원하는 어떤 백엔드에서도 읽을 수 있다 [7]. 컨벤션 자체는 아직 실험적이지만, 흐름은 이미 정해졌다.
그리고 과금 스키마도 뒤따랐다.FinOps Foundation의 FOCUS 명세 — 벤더 간 비용 및 사용량 데이터를 위한 통합 포맷 — 가 2026년 6월 4일 버전 1.4로 승인되었다. 이 버전에는 그 외에도 여러 항목과 함께 Contract Commitment dataset이 추가되어 결제 모델, 라이프사이클 상태, 할인율, 이행 주기 등을 다룬다 [9]. 이 디테일을 기억해 두라. 표준화 기구가 커밋먼트 데이터셋을 추가한다는 것은, 앞으로 커밋먼트가 돈이 모이는 지점이 될 것임을 의미한다.
그리고 이 분야는 빠르게 통합되었다.2026년 1월 16일, ClickHouse가 Langfuse를 인수했다고 발표했다. Langfuse는 가장 널리 쓰이는 오픈소스 LLM 관측성 플랫폼으로, 2025년 말 기준 GitHub 스타 2만 개 이상, 월간 SDK 설치 2,600만 건, Fortune 500 중 63곳에서 사용되고 있었다. 동시에 ClickHouse는 4억 달러 규모의 시리즈 D 투자를 유치해 150억 달러의 기업가치를 기록했다 [8].
이 세 가지를 합치면 결론은 명확하다. 이 글의 핵심 명제다:
미터기는 방어벽이 아니다.스키마가 공개 표준이고, 트레이스가 코딩 에이전트 자체에서 출력되며, 선도적인 오픈소스 수집기가 150억 달러짜리 데이터베이스 회사에 속해 있다면, "당신의 토큰 사용량을 보여줄 수 있다"는 것은 데이터 웨어하우스의 부가 기능에 불과하다. 이것은 배관이다. 배관 사업은 ClickHouse 같은 대기업에겐 훌륭하지만, 시드 라운드 받은 세 명의 팀에겐 악몽이다.
최근 30일: 지금 시장에서 벌어지는 논쟁
현재 시장에는 두 가지 입장이 실시간으로 맞서고 있고, 이 긴장감이야말로 진짜 설계가 시작되는 지점이다.
올해 FinOps X 보도에서 주류 입장은 분모의 변화다: "The metric to chase is value per token, not cost per token"(번역: 쫓아야 할 지표는 토큰당 가치이지, 토큰당 비용이 아니다) [13]. 비용 귀속은 클라우드 청구서에서 토큰 단위로, 그리고 이제는 개별 에이전트 실행과 세션 단위로 내려왔다. 사람들이 원하는 산출 지표는 작업당 비용, 결과당 비용, 상호작용당 비용이다 [13]. 같은 커뮤니티의 2차 분석에 따르면 실제로 단위 경제학을 AI 지출에 적용하는 실무자는 20% 미만으로 추정된다 — 이 수치는 1차 설문 데이터에서 확인하지 못했으니, 정확한 수치라기보다는 방향성으로 받아들이길 바란다 [13].
반대 입장은 훨씬 더 날카롭다. 만약 이쪽이 옳다면, 이 분야의 상당 부분이 무의미해진다. Yossi Hasson은 AI 가격 책정이 전기·대역폭처럼 단위별 계량에서 예약 용량으로 옮겨갈 것이며, 토큰 절약이라는 전체 분야는 과도기적 산물에 불과하다고 주장한다 [6]:
“Shaving tokens in 2026 is shaving kilobytes off GIFs in 2003. The work is real and the savings may be real. The whole problem is about to disappear anyway.”(번역: 2026년에 토큰을 아끼는 것은 2003년에 GIF에서 킬로바이트를 줄이던 것과 같다. 그 작업도 실제이고, 절감도 실제일 수 있다. 하지만 이 문제 전체가 곧 사라질 것이다.)
그리고 그가 생각하는 가치의 본질을 한 줄로 요약하면:
“Whatever is scarce here, it is not tokens. It is the guarantee.”(번역: 여기서 희소한 것은 토큰이 아니다. 보장(guarantee)이다.)
그는 Insull의 2부 요금제를 129년 늦게 설명하고 있다. 그리고 FOCUS 1.4가 방금 커밋먼트 데이터셋을 출시했다는 점도 주목할 만하다. 이는 표준화 기구가 스키마 차원에서 그의 주장에 동의했다는 뜻이다.
나는 그의 방향성에는 동의하지만, 시기상조라고 본다. 그리고 여기서 중요한 점이 있다:그의 주장은 토큰 계수 제품을 사장시키고, 워런트(증빙) 제품의 가치를 높인다.만약 단위가 예약 용량으로 바뀐다면, "우리가 산 보장을 실제로 썼는가, 그리고 그것이 무언가를 생산했는가"라는 질문은 더 어렵고 더 가치 있는 문제가 된다. 아래의 모든 아이디어는 그가 옳을 때도 살아남도록 설계했다.
이 세 가지가 바로 회사가 되는 자리
나는 네 가지 조건을 동시에 충족하는 아이디어만을 추렸다. 고통이 상상이 아니라 실제로 문서화되어 있고, 산출물이 스크린샷이 아니라 진짜 해자를 쌓으며, 150억 달러짜리 데이터베이스 회사가 다음 분기에 대시보드를 내놔도 무너지지 않고, Hasson의 용량 논리가 맞아도 여전히 살아남는 것. 세 개가 남았다. 실제로 내가 창업한다면 이 순서로 할 것이다. 크기 순서와는 다르다.
① 게이트 — 품질을 증명하며 절감한 비용
핵심 한 줄 요약. 모델 라우팅과 프롬프트 압축으로 비용을 30~70%까지 줄였다는 수치는 흔하다 [15]. 하지만 그 수치를 내세우는 누구도, 그 과정에서 어떤 품질을 희생했는지 보여주지 않는다. 게이트는 더 저렴한 구성을 평가 스위트로 끊임없이 검증하고 품질이 유지될 때만 승격시키는 — 그리고 그 사실을 영수증으로 남기는 시스템이다.
작동 원리. 실제 워크로드를 가져온다. 후보 구성을 만든다: 더 작은 모델, 더 짧은 시스템 프롬프트, 캐시 브레이크포인트, 추론 단축 등. 각 후보를 고객의 실제 트래픽에서 뽑은 평가 스위트로 돌린다. 측정되지 않은 사례 없이 품질 기준을 통과한 후보만 승격시키고, 비용·지연·캐시 동작·평가 결과를 서명된 산출물로 남긴다. 기준선이 깨지면 자동으로 롤백한다.
왜 지금인가. 이제 입력이 갖춰졌다. 표준화된 트레이스 덕분에 고객별 맞춤 통합 없이도 실제 워크로드가 무엇을 했는지 재구성할 수 있다 [7]. 그리고 구매자의 질문이 바뀌었다. 이제는 '추론 비용을 줄일 수 있나'가 아니라 '조용히 제품을 나쁘게 만들지 않았다는 증거가 있나'를 묻는다. 이건 엔지니어링이 아니라 증거의 문제다.
해자. 라우터 자체는 해자가 아니다 — 라우터는 주말에 만들 수 있다. 진짜 해자는 누적된 평가 스위트와 승격 이력이다. 1년이 지나면, 실제 트래픽에서 어떤 절감이 유지됐고 어떤 것이 깨졌는지 고객별로 기록이 쌓인다. 이 데이터셋은 경쟁사가 살 수 없고, 이후의 변화마다 인증 비용을 낮춘다. 또한 고객이 쉽게 떠날 수 없게 만드는, 좋은 의미의 락인 요소다.
구매자와 진입 전략. 플랫폼 또는 AI 인프라 리더십이 주요 고객이고, 약속이 아니라 통제된 비교로 판다. 한 워크로드 감사를 통해 진입한다: 현재 비용, 더 저렴한 네 가지 구성, 그 중 품질을 유지한 두 가지와 실패한 두 가지를 보여준다. 실패한 둘이 오히려 신뢰의 증거다.
노력: 소~중간. 측정 하네스는 작다. 진짜 어려운 건 평가 스위트다. 그리고 이 부분엔 진짜 콜드 스타트 문제가 있다 — 자신의 워크로드에서 '좋음'이 무엇인지 정의하지 못하는 고객은 도울 수 없고, 그런 고객이 적지 않다.
무엇이 이 사업을 무너뜨리는가. 모델 제공사가 이 기능을 네이티브 무료 라우팅으로 내놓는 경우, 충분히 있을 수 있다. 방어책은 크로스-프로바이더이자 독립적이어야 한다는 점이다. 토큰을 파는 쪽이 다운그레이드를 인증하는 건 적절치 않다. 그리고 Jevons: '청구서가 줄어듭니다'는 절대 팔지 마라. '청구서가 더 많은 것을 사게 되었고, 그 과정에서 품질이 희생되지 않았다는 증거가 여기 있습니다'를 팔아라.
무엇이 이 모델을 반증하는가. 만약 기업들이 독립적인 품질 증거 없이 벤더가 보고한 절감만 받아들인다면, 이 사업은 성립하지 않는다. 저렴하게 실험하라: 열 팀에 무료 감사를 제공하고, 그 중 누가 평가 방법론을 묻는지 보라. 아무도 묻지 않으면, 멈춰라.
② 워런트 — 인증을 거부하는 원장
한 줄 요약. AI 지출을 위로 연결한다 — 콜, 세션, 워크플로, 비즈니스 성과까지 — 그 결과로 결과당 비용을 산출하고, 증거 없는 가치 주장은 아예 공개하지 않는다. 대신 미검증 상태로 명확히 표시한다. 이것이 바로 3계층의 바닥이다 [1].
작동 원리. 세 번의 연결과 한 가지 원칙. 지출은 조직 내 상관 키를 통해 워크플로와 연결된다. 워크플로는 실제 결과가 존재하는 시스템 — 해결된 티켓, 완료된 업무, 검토된 계약, 종결된 케이스 등 — 에서 결과와 연결된다. 결과는 기준선과 연결되어, 결과당 비용이 비교 가능한 값이 된다. 이 원칙 자체가 곧 제품이다: 모든 주장은 그 증거와, 극복해야 했던 반증 가설을 함께 지닌다. 실패한 주장은 거부 사유와 함께 거절로 표시된다. 주장된 절감액과 검증된 절감액은 별도 컬럼에 기록되고, 증거 없이는 어느 한 쪽에서 다른 쪽으로 이동할 수 없다.
왜 지금인가. 이미 업계 단체에서 수요 진술이 공식적으로 발표되었다 — “No one can answer that question yet.”(번역: 아직 그 질문에 답할 수 있는 사람은 없다) [2] — 그리고 그에 부합하는 실패 데이터가 이제는 예산을 움직일 만큼 곤혹스러울 정도로 쌓였다: IBM 집계로 기대한 ROI를 달성한 이니셔티브는 4분의 1, 42%의 기업이 대부분의 프로젝트를 포기했다 [10]. 이 제품이 직접 겨냥하는 근본 원인도 명확히 드러나 있다: 상당수 AI 프로젝트가 한 번도 재검토되지 않은 예상 수익을 근거로 승인되었고, 작업 시작 전 성공의 정의조차 합의되지 않았다 [10]. 정의를 지출 전에 강제하는 원장이 바로 그 실패를 해결하는 해법이다.
이 사업의 해자, 그리고 이 글에서 가장 강력한 해자다. 결과 연결의 반대편은 본질적으로 고객별로 다르다. 은행의 티켓 처리 규칙, 제조사의 마감 달력, 보험사의 클레임 상태 등 각 조직 고유의 규칙에 따라 존재한다. OpenTelemetry가 트레이스를 표준화하긴 하지만, 특정 회사에서 '해결됨'이 무엇을 의미하는지는 어디에도 표준이 없다. 이 연결을 구축하는 일은 고객마다 몇 주씩 지루한 작업이지만, 한 번 구축되면 재무팀이 이사회 보고서에서 인용하는 시스템 오브 레코드가 된다. 구독료 아끼자고 시스템 오브 레코드를 뜯어내는 회사는 없다. 또한 PCAOB의 역사적 순서상 이 레이어가 곧 감사를 받고, 이후에는 의무화될 것으로 예측된다 [12] — 즉, '이거 없으면 서명 못 한다'는 비즈니스가 긴 수명을 갖는다는 뜻이다.
구매자. CFO 조직이 주 구매자이고, CIO가 공동 스폰서다. 이 카테고리의 대부분이 엔지니어링 조직에 파는 것과는 명확히 다르다. 이것이 오히려 장점이다: 예산이 다르고, 더 크고, 경쟁도 덜하다.
노력: 중~대 규모. 솔직히 말해, 이 사업은 분석 도구의 탈을 쓴 데이터 통합 사업이다. 이걸 만드는 사람은 첫 미팅에서 그 사실을 반드시 명확히 밝혀야 한다. 그 말에 움찔하는 고객은 애초에 성공할 수 없는 고객이다.
이 사업이 무너지는 경우. 첫 번째 가치 실현까지 너무 느릴 때 — 첫 연결에 분기(쿼터) 단위 시간이 걸리면, 인사이트가 나오기도 전에 파일럿이 죽는다. 대응책: Gate를 먼저 출시해 통합 시간을 충당한다. 그리고 냉소적으로, 아무도 실제로 검증된 답을 원하지 않을 위험도 있다. 검증되지 않은 답이 예산을 방어하는 사람에게 더 유용하기 때문이다. 이건 현실이다. 그래서 첫 디자인 파트너는 AI팀이 아니라 재무 조직이어야 한다.
이 가설이 반증되는 경우. 만약 세 곳의 재무 조직이 연달아 증거 기반 구간보다 자신감 있는 추정치를 선호한다면, 시장은 진실이 아니라 쇼를 원한다는 뜻이고, 이 제품은 그 시장에 맞지 않는다.
③ 데스크 — 토큰이 아니라 용량을 산다
한 문장으로 요약하는 제안. AI 가격 체계가 사용량 기반에서 예약 용량과 약정 계약 중심으로 이동하면서, 누군가는 얼마를, 어떤 기간에, 어떤 공급자에 걸쳐 약정할지 결정하고, 그 후에는 부하율을 관리해야 한다. 이 역할이 바로 데스크이며, 1897년 Insull이 맡았던 그 직무와 같다 [5].
작동 원리. 워크로드별로 수요를 예측한다. 약정과 온디맨드의 비율을 결정한다. 예약 용량의 공백을 우선적으로 채우고, 남는 트래픽만 스팟 요금으로 넘긴다. 내부 정산 가격은 팀이 소모한 토큰이 아니라 자신이 보유한 용량을 기준으로 책정한다 — 내부적으로는 이중 요금제다. 그리고 자신의 예측에 대한 보정 기록을 남겨, 데스크의 신뢰도가 주장 아닌 실적으로 평가받게 한다.
왜 지금인가. 세 가지 독립적인 신호가 동시에 모였다. 2026년 6월 FOCUS 1.4에서 Contract Commitment 데이터셋이 도입되었고 [9], "the guarantee"(번역: 희소한 것은 토큰이 아니라 보증이다)라는 역발상 논거가 힘을 얻었으며 [6], 추론 비용이 기업 AI 예산에서 가장 큰 항목 중 하나가 되었다는 명백한 사실이 있다 [1]. 클라우드에서 이미 예약 인스턴스와 세이빙스 플랜 최적화가 여러 굵직한 사업을 뒷받침했고, AI에서도 표준화 기구가 이미 기반을 깔고 있다.
방어막. 예측 품질은 시간이 쌓일수록 복리로 성장한다. 2년치 수요 이력과 자체 예측의 점수화된 실적을 가진 데스크는 신규 진입자보다 약정 가격을 더 정교하게 산정한다. 그리고 그 절감 효과는 서사가 아니라 산술로 증명된다 — 세 가지 중 가장 팔기 쉽고, 반박하기는 가장 어렵다.
노력: 중간. 모델링 자체는 충분히 다룰 수 있다. 다만 실제로는 공급자가 다양한 약정 구조를 제공해야 한다는 의존성이 크다. 오늘날 공급자마다 그 차이가 상당하다.
무엇이 이 사업을 무너뜨리는가 — 직설적으로 말하겠다. 공급자들이 가격 구조를 계속 단순하고 후하게 유지한다면, 차익을 낼 여지가 없다. 세 가지 중 변동성이 가장 크다: 용량 논지가 맞으면 가장 크고, 틀리면 거의 무(無)에 가깝다. 고통이 아니라 시장 구조에 거는 베팅이다.
무엇이 이 논지를 반증하는가. 1년(4분기) 동안 공급자 가격 페이지를 지켜본다. 2027년 중반까지 약정 용량 티어가 늘어나지 않는다면, 이 논지는 틀린 것이고, 솔직하게 덱을 접는 것이 옳다.
진짜 통찰은 순서에 있다
이건 세 개의 회사가 아니다. 세 개의 막으로 구성된 하나의 회사이며, 순서는 크기와 다르다.
게이트부터 만든다 — 가장 작고, 통제된 비교로 팔 수 있으며, 트레이스 데이터에 들어갈 자격을 얻는다.게이트의 증거 기록이 워런트의 시드 코퍼스다: 변화가 품질을 유지했음을 인증하기 시작하면, 이미 워크로드별로 가치 원장에 필요한 증거를 쥐고 있게 된다.워런트가 데스크의 신뢰를 만든다, 즉, 가치가 증명되지 않은 워크로드에 용량을 약정하는 것은 책임 있는 행동이 아니다. 게이트는 진입점, 워런트는 방어막, 데스크는 마지막 단계다.
그리고 세 가지를 모두 가져야 하는 전략적 이유: 이들은 서로 다른 조건에서 무너진다. 공급자가 라우팅을 흡수하면 게이트가 사라지고, 가격이 단순하게 유지되면 데스크가 사라진다.Warrant만이 두 조건 모두에서 살아남는다, 그리고 1887년부터 감사, 규제까지 이어지는 역사적 순서가 시간이 흐를수록 더 큰 가치를 갖게 된다고 예고한 바로 그 사업이다 [12].
창업자–제품 적합성, 있는 그대로의 자기 평가
이 부분에서는 내가 직접 주인공이니, 피치덱보다 훨씬 더 엄격하게 따져보겠다.
이 적합성은 드물게 구체적이다. 내 포트폴리오는 AI 앱 모음이 아니다. 내가 만든 것은 인증 없는 주장을 허락하지 않는 기계들이다. 독립적으로 점수를 매기는 평가 운영체제, 증거의 강도에 따라 점수 상한이 결정되는 빌드-앤-그레이드 엔진(텍스트 주장만 있는 결과와 게이트를 통과한 증거가 있는 결과는 같은 점수를 받을 수 없다), 통합 영수증이 없어 헤드라인 숫자가 20개 중 0개인 보안 레포, 408개 중 배포 가능한 경로가 0개이고 모든 장애 요인을 명시하는 하우징 엔진, AI가 초안만 쓴 규칙이 자격 있는 사람이 증거 원장에 서명하기 전까지 "claimed" 상태에 머무는 HR 엔진, 자금이 휴먼 게이트를 거치고 예측이 Brier 점수로 평가되는 금융 시스템 등이다.
이것이 지난 10년간 내가 반복해서 만들어온 동일한 기관이다:증거 없는 주장은 절대 통과시키지 않는 장치. 업계 단체의 말을 빌리자면, 시장의 1번 미해결 과제는 아무도 AI의 가치를 증명할 수 없다는 점이다. 내가 이 문제를 선택한 것이 아니라, 그 사실을 발견한 것이다.
내가 이미 운용 중인 ablation harness가 바로 구체적으로 이전 가능한 자산이다. 프롬프트와 모델 변형을 턴별 비용, 지연, 캐시 동작으로 측정하고, 모든 셀이 미측정 케이스 없이 능력 기준을 통과해야 하는 게이트 뒤에 둔다. 이것이 ①을 슬라이드가 아니라 실제 작동하는 산출물로 구현한 것이다. 증거 등급별 리포트 카드는 ②의 축소판이다. 보정 점수가 있는 예측 원장은 ③이 필요로 하는 도구다.
이제 그 간극들, 결코 작지 않다.
폭이 위험이지, 강점이 아니다. 79개 프로젝트는 포트폴리오다. 유니콘은 6년간 한 가지를 지독하게 파는 것이다. 내가 이 기회를 잘 포착할 수 있었던 모든 작업 방식—여러 평행 루프, 폭넓은 독서, 빠른 재구성—은 이 기회를 실제로 잡는 데 필요한 것과 정반대다. 내 프로젝트 리스트를 가진 창업자에게 투자를 한다면 반드시 이 질문을 먼저 할 것이므로, 나 자신에게도 먼저 묻는다.
문제가 다른 방. 엔지니어링과 엔터프라이즈 딜리버리에는 깊이가 있지만, ②는 재무 조직에 판매하는 제품이고 나는 FinOps 실무자 커뮤니티에서 신뢰가 없다. 그 커뮤니티는 유난히 끈끈하고, 연례 모임이 있으며, 자체 설문을 내고, 호출기를 들어본 사람에게 신뢰를 준다. 현실적인 첫걸음은 제품을 만드는 것이 아니라, FinOps 또는 재무 혁신 실무자가 지분을 가진 디자인 파트너로 합류하는 것이다. 제품 코드 한 줄도 쓰기 전에 말이다.
이해관계 충돌의 표면. 현재 엔터프라이즈 컨설팅이나 금융 서비스에 종사하면서 엔터프라이즈 AI 비용 거버넌스 회사를 창업하려는 사람은, 고용주와 서면으로 IP 및 이해상충 문제를 먼저 정리해야 한다. 각주가 아니라, 첫 번째 게이트다.
콜드 스타트. ①에는 등급화된 평가 스위트가 필요한데, 비용 통제가 가장 절실한 고객일수록 좋은 결과가 무엇인지 설명하지 못하는 경우가 많다. 이것이 바로 서비스 문제가 제품 논지 안에 숨어 있는 경우이며, 많은 유망한 평가 회사들이 조용히 컨설팅 회사로 변한 이유다.
패턴과 안티패턴
패턴. 숫자가 아니라 반대 가설을 팔아라 — 반박 시도에서 살아남은 발견 하나가 단순 계산된 발견 셋보다 값지다. 거절된 사례를 보여라: 인증을 거부한 항목을 명시하는 리포트가 재무 담당자의 신뢰를 얻는 가장 빠른 방법이다. 시계장치(고정비)와 미터(변동비)를 연결하라. Wedgwood의 고정비가 여전히 돈이 머무는 곳이다. 가능하면 용량 기준으로 가격을 매겨라. 그리고 자신의 예측을 점수와 함께 기록에 남겨라. 자기 자신을 평가하는 데스크만이 신뢰할 만하다.
안티패턴. 이미 CNCF 표준 스키마가 자리 잡고, 150억 달러 규모의 데이터베이스 회사가 주도하는 수집기가 있는 시장에서 네 번째 비용 대시보드를 만드는 일. Jevons가 1865년부터 그 약속을 번번이 거짓으로 만들어온 상황에서, '청구서가 줄어듭니다'라고 약속하는 일. 프롬프트 길이만 보고 프롬프트의 장황함을 추정하는 일—실제로 모델이 과금받는 입력에는 시스템 명령, 삽입된 컨텍스트, 검색 페이로드, 히스토리까지 모두 포함된다. 단순히 낭비만 걸러내려다, 비싼 모델이 충분한 가치를 내는 경우까지도 자신 있게 잘못된 추천을 내놓는 일. 그리고 95% 통계를 검증도 없이 측정에 관한 글에 인용하는 일—사실 나도 거의 그렇게 할 뻔했다.
작동 원리와 첫 번째 원칙
작동 원리. 비용 수치는 반드시 결과와 연결되고, 명시적으로 제기된 반론을 견뎌냈을 때에만 의사결정에 쓸 수 있는 등급이 된다. 연결이 없으면 단순 산수에 불과하고, 도전이 없으면 변호에 불과하다. 이 분야에서 진짜 가치 있는 것은 모두 이 연결을 만들고, 도전을 관리하는 장치다.
첫 번째 원칙, 한 문장으로. 측정 그 자체는 희소하지 않다 — 증거가 뒷받침된 측정만이 진짜 희소하다. 실패할 수 없는 숫자는 어떤 결정에도 정보를 줄 수 없다.
이 시장의 영수증은 점점 더 정교해지고 있다. 하지만 성적표는 아직 만들어지지 않았다. 300년 회계 역사가 말해주듯, 제도로 남는 것은 성적표다. 그리고 규제자는 이미 그 순서를 공개적으로 밝혔다.
관련 글
참고문헌
- CloudZero.AI 비용 관측성이란 무엇인가? LLM 및 AI 지출 추적 가이드. 3계층 구조; 2026년 전 세계 AI 지출 2조 5,200억 달러(전년 대비 +44%) 및 AI 인프라 4,010억 달러에 대한 Gartner 전망; AI 지출 관리 98% / 63% / 31% 수치.cloudzero.com/blog/ai-cost-observability/
- FinOps Foundation.State of FinOps 2026. “Is your AI providing value? No one can answer that question yet.”(번역: "당신의 AI가 실제로 가치를 내고 있는가? 그 질문에 아직 누구도 답하지 못한다."); AI를 위한 FinOps가 앞으로 가장 중요한 우선순위로 꼽혔으며, AI 비용 관리는 개발해야 할 핵심 역량 1위로 선정되었다. data.finops.org · 참고 Linux Foundation 공식 보도자료
- Bamboo Innovator (2013). 도예가가 어떻게 회계를 산업시대로 이끌었는가. Wedgwood가 Thomas Bentley에게 보낸 편지(영문 인용); 고정비와 변동비의 구분 발견, 그리고 1772년 불황에서 살아남은 과정. bambooinnovator.com/2013/04/19/…
- Jevons, W. S. (1865). The Coal Question. 인용 없이 서술됨. AI 추론 구조의 현대적 공식화: The Economics of Digital Intelligence Capital: Endogenous Depreciation and the Structural Jevons Paradox, arXiv. arxiv.org/pdf/2601.12339
- Gridium. 수요 요금의 역사. Arthur Wright가 Brighton에서 개발한 수요 미터기, Chicago Edison의 1897년 수요 요금제, 부하율을 평균 대비 최대 수요의 비율로 설명. gridium.com/history-of-demand-charges/
- Hasson, Y. Stop Counting Tokens. Nobody Counts Megabytes. 두 인용문 모두 원문과 일치함을 검증함. yossihasson.substack.com/p/stop-counting-tokens-nobody-counts
- Cloud Native Computing Foundation (2026년 5월 21일). CNCF, OpenTelemetry의 졸업을 공식 발표하며 사실상 관측 표준 지위를 확립.GenAI 시맨틱 컨벤션; VS Code Copilot, OpenAI Codex, Claude Code에서 트레이스가 표준 방식으로 출력됨.cncf.io/announcements/2026/05/21/… · opentelemetry.io/blog/2026/otel-graduates/
- ClickHouse (2026년 1월 16일).ClickHouse, 4억 달러 규모의 시리즈 D 투자 유치 및 Langfuse 인수.150억 달러 기업가치; Langfuse 도입 수치.clickhouse.com/blog/… · 인수 관련 공식 게시글 · InfoWorld
- FinOps Foundation.FOCUS 명세.2026년 6월 4일 버전 1.4 승인; Contract Commitment 데이터셋 포함.focus.finops.org/focus-specification/ · 요약:amnic.com/blogs/…
- Challapally, A., Pease, C., Raskar, R., & Chari, P. (2025).The GenAI Divide: State of AI in Business 2025(MIT Project NANDA). 주요 언론 보도:Fortune, via Yahoo Finance. ROI 수치 보강 (IBM 25%; S&P Global 42% 프로젝트 중단) — 다음에 정리됨:Terminal X,AI ROI in 2026.
- Futuriom.Why We Don't Believe MIT NANDA's Weird AI Study. futuriom.com/articles/news/… · 퍼널 구조 복원(60% 조사, 20% 파일럿, 5% 실제 도입) 및 표본 크기 부풀림 관련: NewMR, Myth Number 2: MIT Showed That 95% of AI Pilots Fail. patreon.com/NewMR/posts/…
- Botic, G. R. (2025년 6월 18일).Stop, Look, and Listen: The Legacy of American Railroads and the Dawn of AI. 미국철도협회 회계 담당자 및 내부감사 부서 대상 연설. PCAOB.pcaobus.org/news-events/speeches/…
- Abbruscato, A.FinOps X 2026 요약: AI 토크노믹스 해설. Mavvrik. "The metric to chase is value per token, not cost per token"(번역: 추구해야 할 지표는 토큰당 비용이 아니라 토큰당 가치이다). 20% 미만의 단위 경제 적용 비율은 2차 커뮤니티 분석에서만 언급되었으며, 1차 설문에서는 확인되지 않아 본문에서는 참고 수치로만 다루었다.mavvrik.ai/blog/finops-x-2026-ai-token-economics/
- Braintrust.LLM 비용 추적 가이드(2026): 사용자별, 기능별, 에이전트 실행별 비용 귀속 플레이북. braintrust.dev/articles/how-to-track-llm-costs-2026
- Zylos Research (2026년 4월 12일).AI 에이전트 비용 최적화: 토큰 예산, 모델 라우팅, 프로덕션 FinOps. 30~70% 라우팅 절감 수치의 출처.zylos.ai/research/…
2026-08-17 기준, 30일·30개월·30년·300년 네 시계열 창을 가로질러 리서치 패킷을 구성함. 총 15개 출처. 초안 작성 전 8개의 핵심 주장은 실제 출처에서 검증 완료. Wedgwood의 "like clockwork" 인용문은 최초 두 출처에서 검증에 실패해, 해당 문장을 실제로 담고 있는 출처만 인용함. 단위 경제 적용 실무자 비율 통계는 1차 설문에서 확인되지 않아 본문에 방향성 지표로만 표기하고 조용히 삭제하지 않음. 본 기사에는 어떤 고용주나 클라이언트의 자료도 포함되어 있지 않다. — Paul Jialiang Wu ·agentic-portfolio-lovat.vercel.app