AIネイティブ・シリーズ · AI経済学
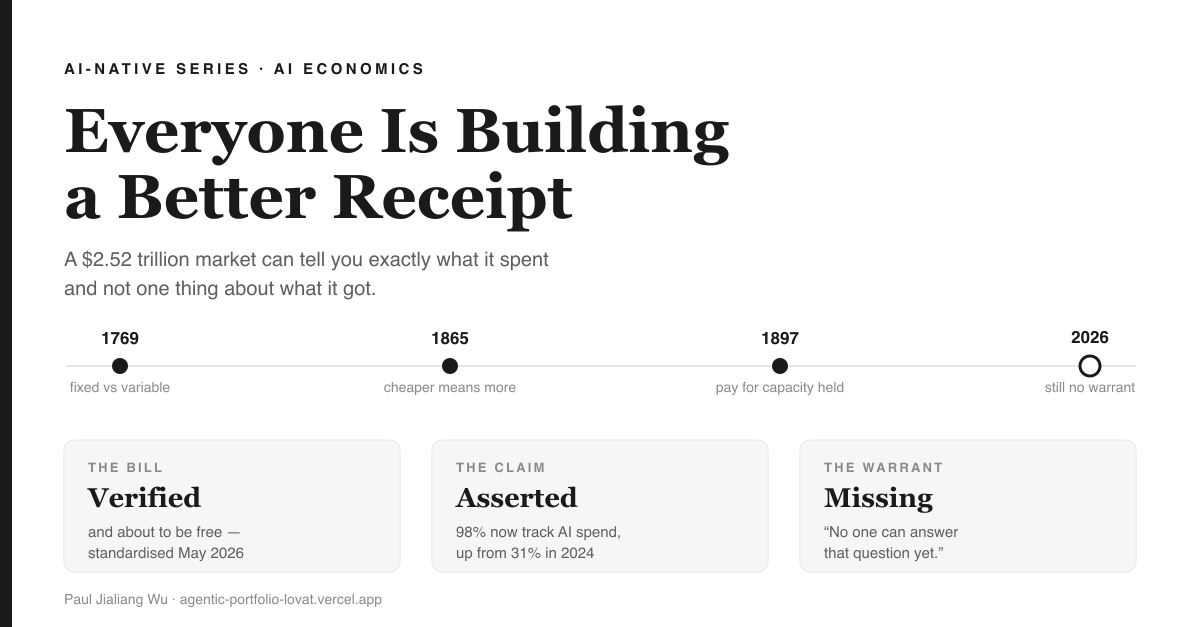
みんな「より良いレシート」を作っている
1分でわかる要点:この記事で得られるもの
世界のAI支出は2026年に2.52兆ドルに達する見通しで、業界最大の年次調査はこの問いにこう答えている:is your AI providing value? その答えは“No one can answer that question yet.”(訳:その問いに答えられる者はいまだにいない。) この領域で手を動かしている人のほとんどが、より良いメーターを作っている。しかし、そのメーターは2026年5月に標準化され、1月には統合された。これは「参入障壁」ではなく、インフラの話だ。数字そのものがビジネスの本質ではない。要となるのはワラント——すなわち、その数字に財務チームが本当に重みを置ける根拠となる証拠だ。このワラントが企業になる形は三つあり、実際に自分がやるならこの順で作る。Gate——品質が確かに維持されたと証明できた節約だけを記録する仕組み、Warrant台帳——支出と成果を結びつけ、証拠のない価値主張には認証を拒むもの、そしてDesk——トークンを数えるのではなく、キャパシティそのものを買う仕組み。さらに、三つ目が最初の二つを時代遅れにするかもしれない理由もある。
今年はAIのコストを可視化するツールを多く見てきた。どれも出来が良い。エンジニアリングは堅実で、ダッシュボードは速く、インテグレーションも一行で済む。
だが、どのツールも結局同じ問いに答えている。それは、「いくら使ったか」——この問いにはすでに答えがある。請求書を見ればいい。
この分野全体の見方が根本から変わった瞬間がある。FinOps Foundationが業界最大の年次実務者調査を実施している。2026年版の「AI支出が難しい理由」という項目に、こうある[2]:
“Is your AI providing value? No one can answer that question yet.”(訳:あなたのAIは価値を生み出しているか?その問いに答えられる者はいまだにいない。)
これはベンダーの宣伝文句ではない。まさに「知ること」が仕事の人々の業界団体が、「誰も知らない」と公表している。そして同じレポートで、「2024年には31%、2025年には63%、そして今や98%の実務者がAI支出を管理している」とされている [1][2].
この二つの事実を並べてみてほしい。業界は2年で「支出の測定」は3分の1からほぼ全員へと一気に進み、支出の測定についてはほぼ全員ができているが、その支出で何を得たかについては、ほとんど誰も答えを持っていない。メーターは驚くほど速く作られたが、実はそこが本当の難所ではなかった。
頭の中で持つべき三つの問い——請求書、主張、そしてワラント
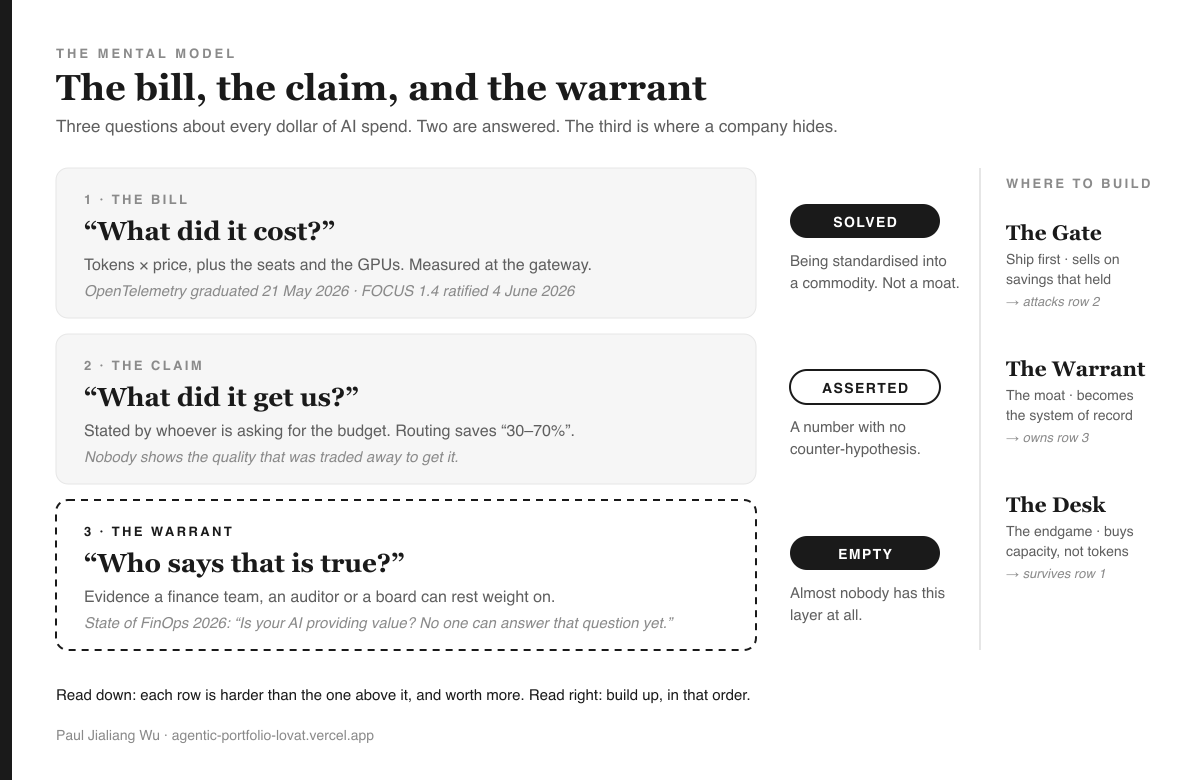
AIに1ドル使うごとに、必ず3つの問いがついて回る。この3つは同時に頭の中で整理できる。
請求書。 いくらかかったのか?トークン数×単価、さらにシート代やGPU代も含む。これは計測済みだ。ゲートウェイや請求書に明記されていて、議論の余地はない。
成果の主張。 その支出で何を得たのか?これは主張される——しかも、ほぼ例外なく来年度の予算を取りに行く人が主張する。「推論コストを40%削減した」「このエージェントでサポートチームの1チケットあたり9分短縮した」など。
証拠(ワラント)。 その主張が本当だと誰が認めるのか?「それは本当じゃない」と思いたい財務部門のビジネスパートナーにも通用する証拠は何か?これは存在しない。薄いのではなく、そもそも無い。
この構造を最も的確に捉えている独立した視点は、コスト可観測性の分野から来ている。市場を「インフラ」「推論・アプリケーション」「ビジネス帰属」の3層で捉え、そしてこう指摘する[1]:
“Most organizations today have partial coverage of Layer 1 and Layer 2, but almost none have Layer 3. The tools that exist are strong within their layer but do not cross boundaries.”(訳:今日のほとんどの組織はレイヤー1とレイヤー2の一部しかカバーできていないが、レイヤー3を持つところはほとんどない。既存のツールは各レイヤー内では強力だが、境界を越えない。)
レイヤー3こそが証拠(ワラント)だ。この分野で本当に価値のある事業機会は、すべてこの床を打つことに集約される。
余談のようでいて、実は問題の核心でもある。
この統計を目にしたことがあるはずだ。エンタープライズの生成AIパイロットの95%は、測定可能なインパクトを出していない。 この数字はMITのProject NANDAが出典で、Fortuneを通じて2025年8月に広まり、今や世界中のAI戦略資料の冒頭スライドになっている[10]。
そこで私は検証してみた。測定を論じる記事として最低限やるべきことだし、実際に調べてみると数字そのものより検証の過程のほうが面白かった。
元のレポートはファネル構造を描いている。およそ60%の組織がこれらのツールを検討し、20%がパイロットに進み、5%が本導入に至った。つまり、実際にパイロットを実施した組織の約4分の1が基準をクリアした計算になる——意図的に高く設定されたハードルを約75%のパイロットが越えられなかったのであって、「95%が失敗した」という話ではない[11]。また、サンプルサイズは伝言ゲームの中で水増しされている。調査自体は52組織への構造化インタビューと153人のリーダーへのアンケートだったが、主流メディアは150件のインタビューと350人のアンケート回答者と報じ、その後他の媒体も大きな数字を繰り返した[11]。ある批評家はこの手法を「無責任かつ根拠がない」と評した[11]。さらに、この調査を発表した団体自体が、失敗が多いという結果が有利に働くエージェントインフラのカテゴリを手がけている[11]。
念のため補足しておくが、全体の方向性はほぼ間違いなく正しいし、その利害がない立場の人々によっても裏付けられている。IBMは、期待されたROIを達成したAIイニシアチブの割合を25%と見積もっている。S&P Globalは、2025年に企業の42%がAIプロジェクトの大半を放棄したと報告している[10]。この現象は現実だ。
だが、この再帰構造を少し味わってほしい。企業がAIの価値を測れないという最も引用される証拠自体が、サンプルサイズを誤ったメディアによって増幅され、利害関係者によって発表された、測定の精度が怪しい数字なのだ。自分たちの「測定危機」すら測定できない業界は、ダッシュボードをもう一つ増やしても直らない。それがジョークであり、しかも構造を支えている。
長い時間軸で見る。なぜなら、この問題は過去にすでに解かれているからだ。
この問いを、今月語られていること、過去30ヶ月でデフォルトになったこと、30年生き残ったもの、300年生き残ったもの——4つの時間窓で検証した。長い時間窓のほうが短いものより役に立った。これは、構造的な問題が新しい衣装をまとって現れているサインであることが多い。
1769年——ライセンス請求書とメーター請求書は新発明ではない
陶工Josiah Wedgwoodは1760年代、美しいものを作りながら、そのコストを見失っていた。パートナーのThomas Bentleyへの手紙で、自分の帳簿で気づいたことをこう記している[3]:
“Consider that these expences move like clockwork, & are much the same whether the quantity of goods made be large or small”(訳:これらの経費は時計仕掛けのように動き、製造量が多くても少なくてもほとんど変わらないことを考えてほしい)
この一文こそが、固定費と変動費の区別という発見であり、それは257年前のことだ。Wedgwoodは、自分の大きな出費——型代、家賃、燃料、簿記係、賃金——が生産量とは全く連動しないことに気づいた。その後1772年の不況で多くの競合が倒れたが、彼だけは生き残った。なぜなら、どのコストが「時計仕掛け」なのかを知っていたのは彼だけだったからだ[3]。
さて、現代のエンタープライズAIの資産を見てみよう。シートライセンス、プラットフォーム料金、リザーブドキャパシティが「時計仕掛け」であり、トークンが変動要素だ。この分野のほぼすべてのツールは変動部分の計測は見事にこなすが、固定部分は他人のスプレッドシート扱いだ。Wedgwoodならそれを面白がり、そして両者を結びつけただろう。それこそが全てのコツなのだから。
1865年——なぜ請求額は下がらずに増えるのか
William Stanley Jevonsは、より効率的な蒸気機関が英国の石炭消費を減らさなかったことに気づいた。むしろ、以前は高すぎて使われなかった用途にも石炭燃焼が経済的になり、消費が増えた。効率化によって需要の拡大が単位コストの低下を上回ったのである。
これは今やAI経済学で最も信頼できる事実となっている。ある能力に対するトークン単価は年ごとに一桁下がっているが、総支出はむしろ増加している——2025年にはエンタープライズAI支出が数百パーセント増加したとされる一方で、単価は下落した。構造的な説明もすでに定式化されている。推論が安くなればなるほど、チームは合理的により多くのアーキテクチャ——より深い推論、より長いコンテキスト、より多くのエージェント型ループ——を導入し、その選択がトークン消費を単価下落よりも速く増やしていく[4]。
2つの帰結があり、それぞれ逆方向を向いている。だからこそ、この時間窓が重要なのだ。
まず最初に言っておく。市場が拡大することは確実だ。エンタープライズがAI支出を重視する限り、この分野のビジネスには、顧客がひとりも無駄遣いを増やさなくても強力な追い風が吹く。
次に、少し厳しい現実を述べる。最適化しても請求額そのものは減らない。請求額が何を買うかが変わるだけだ。「トークンコストを40%削減しました」と売り込んでも、顧客が翌四半期にエージェントを3つ追加して請求書が90%増えれば、約束通りの成果を出してもリニューアルは失う。これこそ、この分野で初めて起業する人が最も陥りやすい罠であり、Jevonsが1865年にすでに指摘している。
1897年――答えはすでに出ていて、それが二部料金制だ。
Samuel InsullはChicago Edisonを経営していたが、電気事業を黒字化できずにいた。イギリスに渡った際、Brightonの技師Arthur Wrightが、電気の「使用量」と「使用速度」の2つを測定できるメーターを作っているのを発見した。ピーク需要――つまり顧客のために確保しておくべき容量――は、それまで誰も課金していなかった。WrightのデマンドメーターによってChicago Edisonは各顧客の月間最大需要に基づいて請求できるようになり、1897年にはInsullが都市に対して、予約容量に対する固定料金と、消費量ごとの非常に低い単価という二部料金制を導入した[5]。
ここからが本質だ。Insullは、ピークが異なる時間帯に現れる顧客――朝の路面電車、日中の工場、夕方の家庭――を集めることで、負荷曲線の谷間を埋める顧客が増えるほど他の顧客のコストも下げられるようになった[5]。ロードファクターが重要な指標となり、価格は下がり消費は爆発的に増えた。これもまた、Jevonsの予言通りである。
この話はあと900語ほど頭の片隅に置いておいてほしい。これが最終局面だ。
そして、なぜ規制当局の視点を読むべきか。
2025年6月、PCAOB(米国公開企業の監査法人を監督する機関)の理事が、鉄道会計担当者向けにStop, Look, and Listen: The Legacy of American Railroads and the Dawn of AIという講演を行った。彼の説明によれば、鉄道は「現代会計の基本技術のほとんどすべてを生み出した」し、最初の書面による企業監査報告書は1827年に発行され、1887年の州間通商法が最初の独立した連邦規制委員会を生み出し、それが自身の機関を含む後の機関のモデルとなったという[12]。
彼の結びの言葉は短い――“Whether it is the telegraph, automation, or generative AI, auditors must remain skeptical to still meet their obligations to investors.”(訳:それが電信であれ、自動化であれ、生成AIであれ、監査人は投資家への責務を果たすために常に懐疑的でなければならない。)[12]
つまり、規制当局の口から語られる歴史の順序はこうだ。新しい技術が測れない規模を生み出す → 誰かが単位を発明する → 単位が標準化される → 標準が監査される → 監査が規制される。今まさに私たちは「単位が標準化される」と「標準が監査される」の間にいる。このタイミングこそ、会社を始めるには極めて具体的かつ好機であり、下記の三つのアイデアのうちどれが持続的かを示している。
直近30か月――メーターはもはや「配管」になった
ここで短期の視点が生きる。なぜなら、この分野で構築している多くの人がまだ十分に織り込んでいない二つの出来事があったからだ。
スキーマは標準となった。 2026年5月21日、CNCFがOpenTelemetryの卒業を発表した。これは最高成熟度への到達であり、デフォルトのオブザーバビリティ標準をめぐる論争に正式な決着がついたことを意味する[7]。同時に、GenAIセマンティック規約がモデル名、入出力トークン数、終了理由、ツール呼び出しやその結果といった標準属性を定めた。これらの規約はすでにVS Code Copilot、OpenAI Codex、Claude Codeで出力されており、つまりこれらの実行履歴はプロトコル対応の任意のバックエンドで読める[7]。規約自体はまだ実験段階だが、進む方向は揺るがない。
続いて、課金スキーマも標準化された。 FinOps FoundationのFOCUS仕様——ベンダー横断でコストと利用データを共通フォーマット化するもの——が2026年6月4日にバージョン1.4として正式に承認され、多くの追加項目の中にContract Commitment dataset(支払いモデル、ライフサイクルステータス、割引率、履行間隔などを含む)が加わった[9]。この点は重要だ。標準化団体がコミットメントデータセットを加えるのは、まさにコミットメントがこれから資金の主戦場になるからである。
そして、この分野は一気に集約された。 2026年1月16日、ClickHouseがLangfuseを買収したと発表した。Langfuseは最も広く使われているオープンソースLLMオブザーバビリティプラットフォームであり、2025年末時点でGitHubスター2万超、月間SDKインストール数2600万、Fortune 500のうち63社で利用されていた。さらに4億ドルのシリーズD調達でClickHouseの評価額は150億ドルに達した[8]。
この三つを並べてみれば、ひとつの結論に行き着く。それが本稿の主張だ。
メーターは参入障壁にならない。 スキーマが公開標準となり、トレースはコーディングエージェント自身が出力し、主要なオープンソースコレクターが150億ドル企業の傘下にある時点で、「あなたのトークン消費を可視化できます」はデータウェアハウスの一機能にすぎない。これは配管と同じだ。配管ビジネスはClickHouseのような巨大企業にはうってつけだが、シードラウンドの3人組には絶望的である。
直近30日:市場が今まさに交わしている論争
現場で今、二つの立場がぶつかっている。その緊張こそが本質的な設計の現場だと私は見ている。
今年のFinOps X報道で主流となったのは「分母のシフト」だ。"The metric to chase is value per token, not cost per token"(訳:「追うべき指標はトークンあたりの価値であり、トークンあたりのコストではない」)[13]。コスト帰属はクラウド請求書からトークン単位、さらに個々のエージェント実行やセッション単位へと細分化され、現場が求めるアウトプット指標は「タスクあたりコスト」「成果あたりコスト」「インタラクションあたりコスト」などに移っている[13]。同じコミュニティの二次分析によれば、実際にAI支出に単位経済学を適用している実務者は20%未満とされる——この数字は一次調査データで裏付けが取れなかったため、あくまで方向性として扱う[13]。
一方、逆張りの立場はより鋭い。もし正しければ、このカテゴリの大半を無効化するため、真剣に向き合う価値がある。Yossi Hassonは、AIの価格体系は電力や帯域と同じく「単位ごとのメーター課金」から「予約キャパシティ」へ移行し、トークン節約という発想自体が過渡的な遺物になると主張している[6]:
“Shaving tokens in 2026 is shaving kilobytes off GIFs in 2003. The work is real and the savings may be real. The whole problem is about to disappear anyway.”(訳:「2026年にトークンを削るのは、2003年にGIFのキロバイトを削るのと同じだ。その作業も節約も本物かもしれないが、問題自体がすぐ消えてしまう。」)
そして、価値の本質を一言で表すならこれだ:
“Whatever is scarce here, it is not tokens. It is the guarantee.”(訳:「ここで本当に希少なのはトークンではない。保証(warrant)だ。」)
彼が語っているのはInsullの二部料金制であり、129年遅れて到着したものだ。そしてFOCUS 1.4がちょうどコミットメントデータセットをリリースしたことにも注目したい。これは標準化団体がスキーマの形で彼の主張に同意したということだ。
私は彼の主張は方向性として正しく、やや時期尚早だと見ている——そしてここが重要な点だ。この議論はトークンカウント系プロダクトを駆逐し、warrant系プロダクトを強くする。 単位が予約キャパシティに移れば、「買った保証を使い切ったか、それは何かを生み出したか」という問いは、より難しく、より価値の高いものになる。以下のアイデアはすべて、彼の主張が正しかった場合にも生き残れるよう設計してある。
これが事業になる三つの地点
同時に四つの条件を満たすアイデアを探した。痛みが実際に記録されていること、成果物がスクリーンショットではなく参入障壁として積み上がること、150億ドル規模のデータベース企業が来四半期にダッシュボードを出しても潰れないこと、そしてHassonのキャパシティ論が正しくても機能すること。このふるいを通ったのは三つだけだ。実際に自分が着手する順に並べているが、それは最終的な規模順ではない。
① Gate ― 品質を証明したコスト削減
要点は一行で済む。 モデルルーティングやプロンプト圧縮によるコスト削減は30~70%と報告されているが[15]、その数字を売りにする誰もが、どんな品質を犠牲にしたかは見せていない。Gateは、より安価な構成を評価スイートで継続的にテストし、品質が維持された場合にのみ昇格させる ― そしてその証明書(レシート)を発行する仕組みだ。
仕組み。 実際のワークロードを使い、候補となる構成(小さいモデル、短いシステムプロンプト、キャッシュのブレークポイント、推論量の削減など)を生成する。各候補を顧客自身のトラフィックから抽出したグレード付きスイートで実行する。未評価ケースがゼロで品質基準をクリアした場合のみ昇格させ、コスト、レイテンシ、キャッシュ挙動、評価結果を署名付き成果物として記録する。基準を割ったら自動でロールバック。
なぜ今か。 必要な入力がようやく揃った。標準化されたトレースがあれば、顧客ごとに専用の統合を作らずともワークロードの実際の挙動を再現できる[7]。そしてバイヤーの関心も変わった。今や「推論コストを下げられるか」と聞く上層部はいない。「こっそり品質を落としていない証拠は?」と問われる。これはエンジニアリングの話ではなく、証拠の話だ。
参入障壁。 ルーター自体は週末で作れる。参入障壁になるのは、蓄積された評価スイートと昇格履歴だ。1年後には、どのトレードオフが本番トラフィックで成立し、どれが破綻したかを顧客ごとに記録したデータセットが手元にある。これは競合が買えない資産であり、以降の変更認証コストも下がる。顧客が「良い意味で」離れられなくなる理由でもある。
顧客と切り口。 プラットフォームやAIインフラのリーダー層向けで、約束ではなくコントロールされた比較で売る。最初は単一ワークロードの監査として着地する。「これが現状コスト、これが4つの安価な構成、そのうち2つは品質維持、2つは維持できなかった」。失敗した2つが信頼性の証明になる。
労力:小〜中。 測定用ハーネスは小規模。難しいのは評価スイートで、これは本物のコールドスタート問題を抱える。「自分のワークロードで『良い』の定義ができない」顧客は助けられず、実際そういう顧客も少なくない。
死因。 モデルプロバイダーがこれをネイティブな無料ルーティング機能として出してくる場合(十分あり得る)。防衛策はクロスプロバイダーかつ独立であること。なぜならトークンを売る側はダウングレードの認証に最適な立場ではないからだ。そしてJevons:「『請求額が下がる』は絶対に売るな。『請求額でより多くを買えるようになった、しかも品質を損なっていない証拠がこれだ』を売れ。」
反証条件。 もし企業が独立した品質証拠なしにベンダー報告の節約を受け入れるなら、このビジネスは成立しない。安く検証するには、10チームに無料監査を提供し、評価手法について誰かが質問するかを見る。誰も聞かなければ撤退。
② Warrant ― 認証を拒む台帳
要点は一行で言える。 AI支出をコール、セッション、ワークフロー、ビジネス成果といった上流へと結びつけ、成果ごとのコストを算出する。そして、証拠のない価値主張は一切公開せず、未検証として明示する。これがLayer 3の基盤だ[1]。
仕組み。 三つの結合と一つの規律。支出は組織内の相関キーでワークフローに結びつける。ワークフローは、成果が記録されるシステム——解決済みチケット、完了タスク、契約レビュー、案件クローズ——で成果と結合される。成果はベースラインと結合され、成果ごとのコストに比較対象ができる。この「規律」こそがプロダクトの本質であり、すべての主張には証拠と、それが打ち破った反証仮説が必ず添えられる。失敗した主張は却下理由とともに「却下」として表示される。主張ベースの削減額と検証済み削減額は別カラムで管理し、証拠がなければ一方から他方へは何も移せない。
なぜ今なのか。 業界団体がすでに「“No one can answer that question yet.”(訳:その問いに答えられる者はいない)」[2]と明言し、失敗事例のデータも予算を動かすほど無視できない水準に達したからだ。IBMの調査ではイニシアチブの4分の1しか期待ROIを達成できず、42%の企業が大半のAIプロジェクトを放棄している[10]。さらに、このプロダクトが狙い撃ちする根本原因も明らかになっている。多くのAIプロジェクトが、誰も再検証しない予測リターンで承認され、開始前に成功の定義すら合意されていなかった[10]。この「定義を支出の前に強制する台帳」こそが、その失敗を正面から断ち切る。
参入障壁——しかも本記事で最も強固なもの。 成果側の結合は、どうやっても顧客ごとに固有になる。銀行のチケット運用ルール、製造業のクローズカレンダー、保険会社の請求状態など、現場の慣習に根ざしている。OpenTelemetryはトレースを標準化するが、「解決済み」が何を意味するかは企業ごとに異なる。この結合を作るには顧客ごとに地味な作業が数週間単位で発生するが、一度構築されれば財務部門が取締役会資料で引用するシステム・オブ・レコードとなる。誰もサブスクリプション費用のためにこの基幹システムを捨てたりしない。ここはPCAOBの歴史的シーケンスが「監査可能となり、やがて必須になる」と予測する層でもある[12]。「これがないとサインできない」状態になるビジネスは、長期的な成長余地が大きい。
買い手。 CFO組織が主導し、CIOが共同スポンサーとなる。多くの類似プロダクトがエンジニアリング部門向けなのに対し、買い手が異なるのが特徴だ。これは予算規模が大きく、競争も少ないという意味で有利である。
労力:中〜大。理由は明快で、これは分析ツールの顔をしたデータ統合ビジネスだからだ。これを作る側は最初の打ち合わせでその点を率直に伝えるべきであり、それで尻込みする顧客はそもそも成功しない。
致命的なリスク。 最初の価値提供までに時間がかかりすぎる場合——最初の結合に四半期もかかれば、インサイトが出る前にパイロットが頓挫する。対策としては、まずGateを先に導入し、その統合期間の資金源にする。また、現実的なリスクとして、誰も本当は検証済みの答えを求めていない可能性もある。なぜなら、未検証の答えの方が予算を守る立場の人間には都合が良いからだ。これが現実であり、最初のデザインパートナーはAIチームではなく財務部門であるべき理由でもある。
反証条件。 もし三連続で財務部門が証拠に基づく幅よりも自信満々な推計値を選ぶなら、市場は演出を求めており、このプロダクトはその需要に合わない。
③ デスク —— キャパシティを買い、トークンは買わない
要点は一行で済む。AIの価格体系が従量課金からリザーブドキャパシティやコミットメント契約へ移る中で、どれだけ・どの期間・どのプロバイダーにコミットするか、そして負荷率をどう運用するかを決める役割が必要になる。それが「デスク」であり、1897年にInsullが担った仕事そのものだ[5]。
仕組み。ワークロードごとに需要を予測し、コミットとオンデマンドの比率を決める。リザーブドキャパシティの谷間を埋めるようにトラフィックをルーティングし、余剰分がスポット価格に流れ出るのを防ぐ。社内チャージバックも、単なる消費トークン数ではなく各チームが保持するキャパシティを可視化する——社内版の二部料金制だ。そして自分の予測のキャリブレーション記録を残し、デスクの信頼性を「主張」ではなく「実測」で示す。
なぜ今なのか。三つの独立したシグナルが重なっている。2026年6月にFOCUS 1.4がContract Commitmentデータセットをリリースした[9]こと、「ここで希少なのはトークンではなくguarantee(保証)だ」という逆張り論[6]、そして推論コストがエンタープライズAI予算の最大項目の一つになったという事実[1]だ。クラウドでもリザーブドインスタンスやセービングスプラン最適化が大きなビジネスになったし、AIでも標準化団体がすでにレールを敷き始めている。
参入障壁。予測精度は複利で積み上がる。2年分の需要履歴と自前の予測スコアを持つデスクは、新規参入者よりもコミットメントを有利に価格設定できる。節約効果も物語ではなく算術で示せる——だから三案の中で最も売りやすく、最も反論しにくい。
労力:中程度。モデリング自体は現実的だ。ただし前提条件は重い——このビジネスが成立するには、プロバイダー側が実際に多様なコミットメント構造を提供している必要があり、現状はベンダーによって大きく異なる。
何が致命傷になるか、率直に書く。もしプロバイダーが価格体系を単純かつ寛大なまま維持し続けたら、アービトラージの余地は消える。三案の中で最も振れ幅が大きい:キャパシティ仮説が当たれば最大、外れればほぼゼロ。これは「痛み」ではなく「市場構造」への賭けだ。
何がこの仮説を否定するか。プロバイダーの価格ページを4四半期観察する。2027年半ばまでにコミットキャパシティ階層が増えていなければ、この仮説は間違いであり、潔く「やめます」と言うのが誠実な対応だ。
順番こそが本質的なインサイト
これは三つの会社ではなく、一つの会社が三幕で展開する物語であり、その順番は規模順ではない。
まずGateを作る——最小規模で、コントロールされた比較で売れ、トレースデータにアクセスする権利を得られる。Gateのエビデンス履歴がWarrantのシードコーパスになる。品質維持を証明するたびに、価値台帳が必要とするワークロード別エビデンスをすでに蓄積していることになる。WarrantがDeskの信頼性を担保する。価値を証明できないワークロードに対してキャパシティをコミットするのは無責任だからだ。Gateは楔、Warrantは堀、Deskはエンドゲーム。
三つすべてを持つ戦略的理由は、それぞれ異なる条件下で死ぬからだ。Gateはプロバイダーがルーティングを吸収したら死ぬ。Deskは価格体系が単純なままなら死ぬ。両方の条件下で生き残るのはWarrantだけだ。そして1887年から監査・規制へと至る歴史の流れが、時間とともに価値が増すのはこれだと示している[12]。
創業者とプロダクトの適合性——率直な自己評価
ここからは自分自身が主題だ。ピッチデックよりも厳しく見ていく。
この適合は異様なほど具体的だ。 私のポートフォリオはAIアプリの寄せ集めではない。「認証できないものは認証しない」機械の集積だ。独立採点を担う評価OS。証拠の強さでスコア上限が決まるビルド&グレードエンジン——文章だけの主張は、ゲートを通過した主張ほどのスコアにはならない。統合レシートがまだ何もないので、正直に「20件中0件」と出すセキュリティリポジトリ。408件中0件のデプロイ可能ルートと、すべてのブロッカーを列挙するハウジングエンジン。AIが起草したルールは、資格ある人間が証拠台帳にサインするまで「claimed」のままのHRエンジン。資金はヒューマンゲートを通し、予測はBrierスコアで評価する金融システム。
こうした仕組みを10年かけて繰り返し作ってきた。証拠なしに主張できない仕掛けそのものだ。 業界団体自身の言葉を借りれば、市場の未解決ナンバーワンの課題は「誰もAIの価値を証明できない」ことだ。私はこの一致を狙ったわけではなく、気づいたのだ。
具体的に移転可能な資産は、私がすでに運用しているアブレーションハーネスだ。プロンプトやモデルのバリアントを、ターンごとのコスト・レイテンシ・キャッシュ挙動で測定し、すべてのセルが未測定ケースゼロで能力基準をクリアしないとゲートを通れない。これは①をスライドではなく実働アーティファクトとして持っているということ。証拠階層付きのレポートカードは②のミニチュア。キャリブレーション付きの予測台帳は③に必要な道具だ。
一方で、ギャップも小さくはない。
幅広さは強みではなくリスクだ。 79件のプロジェクトはポートフォリオだが、ユニコーンは6年間一つのことをやり抜いた結果だ。多並列ループ、広い読書、素早いリフレーミング——この機会を見抜く力の源泉は、実はそれを掴み切る力の正反対にある。自分のプロジェクトリストを持つ創業者に私なら投資するか?まずその問いを自分に投げている。
部屋を間違えている。 エンジニアリングとエンタープライズデリバリーには深みがあるが、②はファイナンス組織向けであり、私はFinOps実務コミュニティに何の立場もない。そのコミュニティは結束が強く、年次集会があり、独自の調査を発表し、実際に現場で運用した人にしか信用を与えない。現実的な最初の一手はプロダクト開発ではなく、FinOpsまたはファイナンス変革の実務家をデザインパートナー(持分付き)に迎えることだ。
コンフリクト・サーフェス。 現在エンタープライズコンサルや金融サービスに勤めている人が、エンタープライズAIコストガバナンスの会社を始める場合、まず雇用主と書面でIPと利益相反の問題を解決しなければならない。脚注ではなく、最初のゲートだ。
コールドスタート。 ①にはグレード付き評価スイートが必要だが、コスト管理が最も必要な顧客ほど「良い出力とは何か」を言語化できないことが多い。これはプロダクト論の皮をかぶったサービス課題であり、有望な評価系スタートアップが静かにコンサル化していった理由でもある。
パターンとアンチパターン
パターン。 数字ではなく反証仮説を売る——殺しにかかった検証を生き残った発見は、単に計算された発見3つ分の価値がある。却下したものを見せる:何を認証しなかったかを明示するレポートは、ファイナンス層の信頼を得る最速の方法だ。時計仕掛け(固定費)とメーター(変動費)を結びつける。Wedgwoodの固定費こそ、今も金が眠る場所だ。可能な限りキャパシティで値付けする。そして自分の予測をスコア付きで記録に残す——自己採点するデスクだけが信頼に値する。
アンチパターン。 CNCF標準のスキーマが定着し、主要なコレクターが時価総額150億ドルのデータベース企業に属している状況で、4つ目の支出ダッシュボードを作ること。Jevonsが1865年以来ずっと「請求額は下がる」という約束を裏切り続けてきたのに、それをうたうこと。プロンプトの長さから冗長さを推測する(実際の課金対象にはシステム命令や注入コンテキスト、検索ペイロード、履歴も含まれる)。「無駄」を素朴にフィルタし、高価なモデルがそのコストに見合う価値を生む場合もあるのに、誤った推奨を自信満々に出すこと。そして、95%という統計を検証せずに「測定」記事で引用すること——実は私も危うくやりかけた。
仕組みと第一原理
仕組み。 コストの数値が意思決定に耐えるものになるのは、それが成果と結びつき、明示的な反証に耐えたときだけだ。結合がなければ単なる算術、反証がなければ単なる主張。価値あるものはすべて、この結合を作り、反証を運用するための仕掛けである。
第一原理を一文で。 測定そのものは希少な価値ではない——保証付きの 測定こそが希少だ。なぜなら、失敗し得ない数値は意思決定の役に立たないからだ。
この市場のレシートはどんどん精緻になってきた。だが、成績表はまだ作られていない。会計の歴史300年が示すのは、成績表こそが制度になるということ。そして規制当局は、その順番をすでに明言している。
関連記事
参考文献
- CloudZero. AIコスト可観測性とは何か?LLMとAI支出の追跡ガイド。 3層フレームワーク、Gartnerによる2026年世界AI支出2.52兆ドル(前年比+44%)とAIインフラ4010億ドルの予測、AI支出管理98% / 63% / 31%の数字。cloudzero.com/blog/ai-cost-observability/
- FinOps Foundation. State of FinOps 2026.“Is your AI providing value? No one can answer that question yet.”(訳:「あなたのAIは価値を生み出しているか?その問いにまだ誰も答えられない。」)/FinOps for AIが今後の最重要テーマ。AIコスト管理が習得すべきスキルセットの筆頭。data.finops.org・関連:Linux Foundation プレスリリース
- Bamboo Innovator(2013年)How a Potter Took Accounting Into the Industrial Age.WedgwoodがThomas Bentleyに宛てた書簡(原文引用あり)。固定費と変動費の発見、および1772年の不況を生き残った経緯。bambooinnovator.com/2013/04/19/…
- Jevons, W. S.(1865年)The Coal Question.原文引用はなく要旨のみ。AI推論の仕組みの現代的定式化:The Economics of Digital Intelligence Capital: Endogenous Depreciation and the Structural Jevons Paradox、arXiv。arxiv.org/pdf/2601.12339
- GridiumA History Of Demand Charges.Arthur Wrightによるブライトンのデマンドメーター、シカゴ・エジソンの1897年デマンド料金、負荷率(平均需要/ピーク需要比)の意義。gridium.com/history-of-demand-charges/
- Hasson, Y.Stop Counting Tokens. Nobody Counts Megabytes.両引用文は出典と照合済みの原文。yossihasson.substack.com/p/stop-counting-tokens-nobody-counts
- Cloud Native Computing Foundation(2026年5月21日)CNCF Announces OpenTelemetry's Graduation, Solidifying Status as the De Facto Observability Standard.GenAIセマンティック規約。VS Code Copilot、OpenAI Codex、Claude Codeが標準トレースを出力。cncf.io/announcements/2026/05/21/… · opentelemetry.io/blog/2026/otel-graduates/
- ClickHouse(2026年1月16日)。ClickHouseが4億ドルのシリーズDを調達し、Langfuseを買収。評価額150億ドル、Langfuseの導入実績。clickhouse.com/blog/… · 買収に関する投稿 · InfoWorld
- FinOps Foundation.FOCUS仕様。バージョン1.4が2026年6月4日に正式承認。Contract Commitmentデータセットを追加。focus.finops.org/focus-specification/・要約:amnic.com/blogs/…
- Challapally, A., Pease, C., Raskar, R., & Chari, P.(2025年)。The GenAI Divide: State of AI in Business 2025(MIT Project NANDA)。主な報道:Fortune(Yahoo Finance経由)。ROI裏付けデータ(IBM 25%、S&P Global 42%放棄)をまとめたものTerminal X、AI ROI in 2026.
- Futuriom.Why We Don't Believe MIT NANDA's Weird AI Study. futuriom.com/articles/news/…・ファネル再構成(調査60%、パイロット20%、実装5%)とサンプルサイズ水増し問題:NewMR、Myth Number 2: MIT Showed That 95% of AI Pilots Fail. patreon.com/NewMR/posts/…
- Botic, G. R.(2025年6月18日)。Stop, Look, and Listen: The Legacy of American Railroads and the Dawn of AI.米国鉄道協会 会計責任者・内部監査部門向け講演。PCAOB。pcaobus.org/news-events/speeches/…
- Abbruscato, A.FinOps X 2026 Recap: AI Tokenomics Explained.Mavvrik。「The metric to chase is value per token, not cost per token」(訳:「追うべき指標はトークンあたりの価値であり、トークンあたりのコストではない」)。ユニットエコノミクス適用率20%未満という数字は二次的なコミュニティ分析に現れるが、主要な調査データでは確認できず、本文では方向性としてのみ扱われている。mavvrik.ai/blog/finops-x-2026-ai-token-economics/
- Braintrust.How to track LLM costs (2026): A playbook for per-user, per-feature, and per-agent-run attribution. braintrust.dev/articles/how-to-track-llm-costs-2026
- Zylos Research(2026年4月12日)。AI Agent Cost Optimization: Token Budgets, Model Routing, and Production FinOps.ルーティングによる30〜70%コスト削減の出典。zylos.ai/research/…
リサーチパケットは2026年8月17日時点で、30日・30カ月・30年・300年の4つの時間軸で編成。出典は15件。主要な8つの主張はドラフト前に出典照合済み。Wedgwoodの「like clockwork」引用は最初の2つの出典で検証に失敗し、原文通りのもののみ引用。ユニットエコノミクス適用率は主要調査で確認できず、本文中で方向性として明記。この記事には雇用主やクライアント由来の素材は一切含まれていない。— Paul Jialiang Wu ·agentic-portfolio-lovat.vercel.app