AI 原生系列 · 课程工程
我把 58 门 Snowflake 课程编译进一个智能体,它第一个不放过的就是我
一分钟速览——你能带走什么
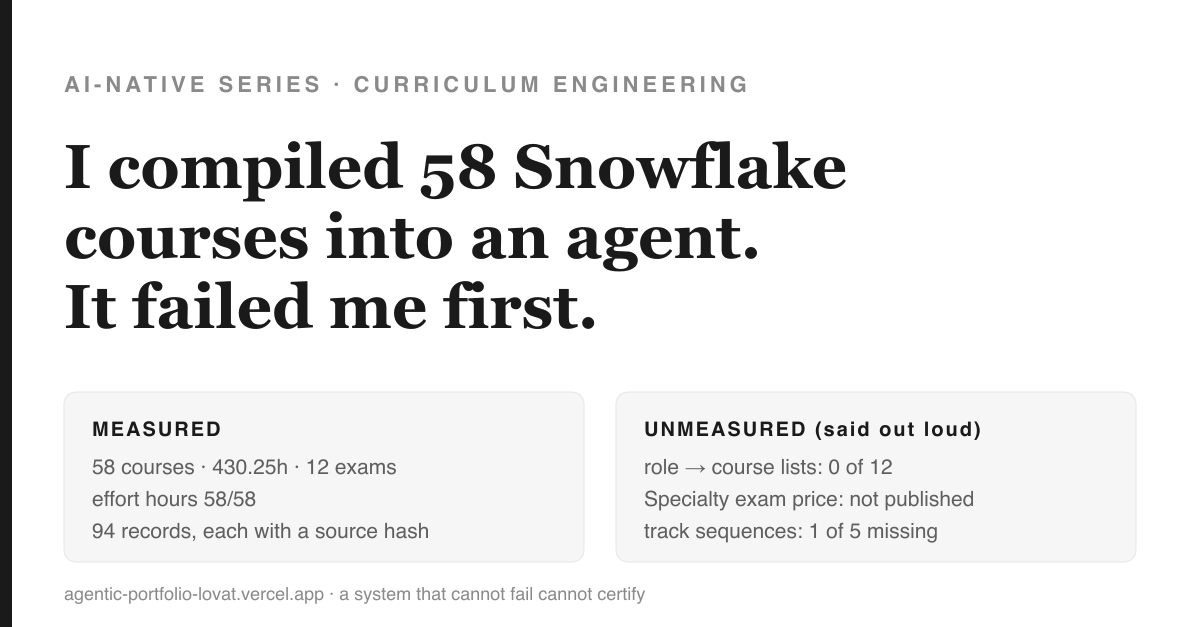
每一款智能体化的 Snowflake 工具都作用于数据仓库,没有一款作用于课程体系——所以没有任何机器能回答“这个人该学什么,学了没有?”这一层,是我搭建出来的。真正有用的部分,不是它索引的那 58 门课程,而是它拒绝知道的那四件事,以及它第一个不放过的,就是我自己。
课程目录是一份菜单,不是一张地图。要把菜单变成地图需要什么——为什么诚实的答案,多半是一份「你不知道什么」的清单。约 9 分钟读完。
Snowflake 告诉你考试的边界在哪里,但几乎没人去读。
在 SnowPro Advanced: MLOps Engineer 认证的页面上,翻过营销话术之后,有一句话描述了谁该来考这场试。最后一句从句,是整个网站上最诚实的一句话:
“Knowledge of general ML engineering concepts and cloud infrastructure is assumed but not tested.”
”(中译:一般机器学习工程概念与云基础设施方面的知识,默认你已具备,但本考试不作测试)—— Snowflake,SnowPro Advanced: MLOps Engineer 考生画像 [1]
这句话值得再读一遍——因为这是一家供应商在主动划出自己这把尺子的量程边界。这场考试测的是 Snowflake 特有的操作。它对底层的工程能力只是假设你已具备,并不检验。这不是缺陷——这是相当难得的认知自律,而恰恰是这份自律,会在任何人拿课程目录去搭建工具的那一刻起消失不见。
我去找这样一个工具。没有。
所有人都在为数据仓库造智能体,没人为课程体系造一个。
Snowflake 自家的工程团队已经交付了一套令人印象深刻的智能体化工具链。Snowflake-Labs/mcp是一个 Model Context Protocol 服务器,暴露了 Cortex AI、对象管理与 SQL 编排能力 [2]。cocoplus——这套工具里星标数最高的一个——它对自己的描述如下:“an Agentic Operating System for Snowflake Coco”(中译:一个面向 Snowflake Coco 的智能体化操作系统),它带来了“structured, multi-agent workflows to data engineering projects”(中译:为数据工程项目带来结构化的多智能体工作流) [3]. coco-skills,为他们的 Cortex Code CLI 提供了精心打磨的 agent skills [4]。文档里还有一个托管的 MCP 端点 [5]。
它们无一例外,操作的都是数据仓库:跑查询、搭管道、发布智能体。没有一个是操作课程体系的:到底哪些课程能让一个人具备做这些事的能力,先后顺序是什么,成本几何,又该如何知道他真的学到了。
这个空缺不是疏忽,而是一整个类别的缺失。而且它举足轻重,因为用人决策恰恰是在课程体系这一层做出的。于是我把这层缺失的东西造了出来——snowflake-os,就在我的 FDE-os 工具包里——我给自己定了一条规矩:它只能声称自己能证明的东西。
心智模型:菜单不是地图
一份目录就是一张菜单。它告诉你有什么、每样东西要花多少钱。这本身很有用,但完全不够,因为菜单没法告诉你地图能告诉你的三件事:
- 一种顺序——什么必须在什么之前;
- 一个终点——哪个子集能带你到达这个职位;
- 一种抵达测试——一种能判断你是否真的到了的方法。
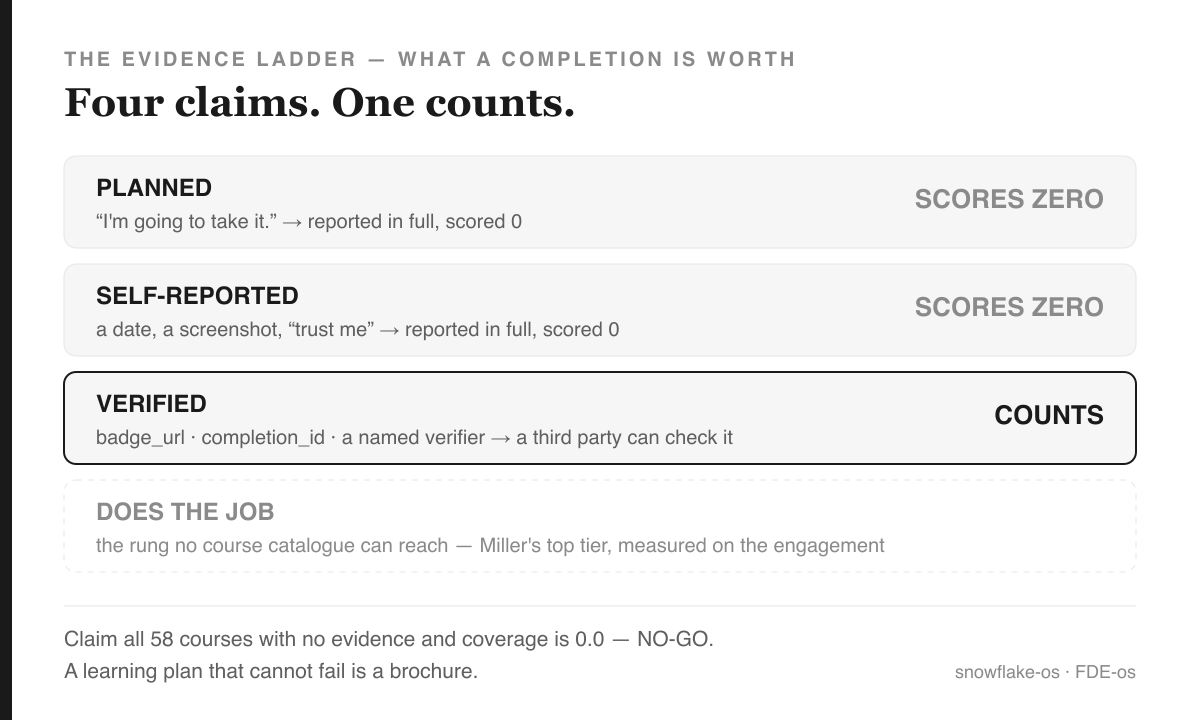
菜单可以随口声称,地图却能被核实。这个区分并不新鲜:1990 年,George Miller 提出了一个评估临床能力的四层框架,从知道到知道怎么做,再到演示怎么做,最后到实际去做——他的论点是,医学评估过度依赖书面知识测试,而对实际表现的观察太少 [6][7]。三十六年后,它依然是医学教育领域的参考模型,对一个想法来说,这算得上是相当过硬的生存测试了。
一门课程的完成,位于这个阶梯的最底层。徽章——由第三方证明你确实做完了评分实验——则往上爬了一级。真正把活干出来,才是最顶层,而世界上没有哪份目录能测量出这一点。诀窍不在于假装并非如此,而在于老老实实说清楚:你现在站在哪一级台阶上。
一句话说清这套机制
先按谁能核实来给每一项完成情况分类,再只从可核实的部分计算已验证覆盖度。 一条完成记录只有携带以下之一才算数:badge_url, a completion_id,或一个具名验证者。日期、截图,或一句「相信我」,会被如实记录,但计零分。
真正重要的测试,是它对说谎者做了什么。我给闸门喂了一份声称all 58 courses的合同,却没有为任何一项附上证据。五大核心能力的已验证覆盖度全部为:0.0。判定:NO-GO。退出码 2。
第一原则:一个不会失败的系统,就无法发放认证。 一份永远说「行」的学习计划,只是带了进度条的宣传册。
目录里实际有什么
数据抓取过程刻意做得很朴素:每秒一次请求,只读,面向公开页面,写入一份已提交的离线快照。每条记录都存有来源 URL、所解析字节的 SHA-256,以及时间戳——94 条记录,全部可溯源。结果如下:
| 已测量 | 数值 |
|---|---|
| 课程 | 58 门——总计 430.25 小时,其中 68.25 小时免费 |
| 不同考试 | 12 个(来自 19 个页面;其余是同一考试的本地化版本) |
| 学习时长 | 58 门中的 58 门已公布 |
| 角色路径 | 12 |
而接下来,才是我更在意的部分。
它拒绝知道的四件事
一个只汇报自己找到了什么的知识库,是一份营销素材。真正有意思的一栏,是它去找过、却没找到的东西:
- 角色 → 课程的映射并不存在。0 / 12。 十二个角色路径页面全部只用文字描述该角色,并链接到the catalogue,而非具体课程。整个知识图谱里最有价值的一条连接——“如果你想成为机器学习工程师,该学这些”——却没有任何地方以机器可读的形式发布。我只好自己补上这一环,并给每一条映射都标注了依据:
title(课程标题里直接点名了这项能力),objective(某个已发布的考试大纲写明了这一点),或者是curated(我自己的判断)。目前22/71 的映射来自人工整理,一旦这个比例超过 40%,构建流程就会失败。凭空捏造映射来“覆盖”某个角色实在太容易了,这道上限把它变成一次失败的构建,而不是一个好看的数字。 - 细分认证的定价未知。 每个考试页面都重复着同一份 FAQ,写着 Core 系列 175 美元、Advanced 系列 375 美元。细分认证的价格哪里都找不到。解析器因此如实记录为未测量——它拒绝去借用同一页面上、近在咫尺的那个看似合理的数字。这种“拒绝”本身,就是测试套件里的一项测试。
- 有一条学习路径没有公布顺序。 五条路径里有四条按顺序列出了课程。SnowPro Core 学习路径却只链接到课程目录和考试报名页面,再无其他。
- 没有人的真实能力是这份目录能测出来的。 课时数是 Snowflake 自己估算的,并不是对你实际耗时的测量。而“能不能干这活儿”——Miller 金字塔的最高一层——只能在真实项目中被检验,课程目录测不出来。这一点,工具在自己的输出里就写明了。
接下来,它判我不合格,一共三次
如果这个工具只是个演示品而不是一道闸门,这部分我大概会直接跳过不写。
1. 完整性检验第一次运行就抓住了我自己整理的漏洞
我为这个知识库写了十项检查——悬空引用、缺失的出处、标着“已测量”却没有实际数值的字段。第一次运行结果就是9 项里过了 8 项,未通过的一项是competency-reachable:我定义了一个Migration & modernisation能力项,却没有任何角色真正需要它。一个孤儿节点。我在它自己的描述里写下了“大多数项目一开始面对的都是别人留下的遗留系统”这样的话,却没有把它接到任何地方。我修的是数据,不是检查规则本身。一个从来没在自己作者身上报过错的验证器,多半什么都没在检查。
第二关:就绪度闸门算错了,而且错得离谱——不是往严了错,是往松了错
我最初的覆盖度公式,给一位准备确实很充分的候选人打出了21%分。问题出在我的模型上,不在他的准备上:Snowflake 用多种交付方式教同一份内容——「Snowflake Platform Training」既有点播课程版,也有讲师授课版——而我把每一对课程的两端都当成了独立的要求来计数。分母被重复项撑大了。引入明确的alternatives(可替代项)分组之后(组内任意一项满足要求即可,按最便宜的那项计费),同一位候选人的分数变成了55%。证据没变,人也没变;出问题的是我的算法。一个分母算错了的评估工具,比没有工具还糟糕,因为它会生成一个看起来很精确的数字。
第三关:我自己仓库里的十一个知识可视化页面,一直在渲染成空白
我新做的课程图谱渲染出来是一片空白——控制台没有报错,什么都没有。原因是:我把嵌在一个<script type="application/json"> 标签里的 JSON 负载做了 HTML 转义。浏览器不会对 script 元素内部的内容做 HTML 实体解码,于是JSON.parse 收到的是字面意义上的" 字符,并在初始化时抛出异常——这让const 一直卡在自己的暂时性死区(temporal dead zone)里,所以哪怕事后去探测这个变量,得到的也只是一个含糊不清的报错信息ReferenceError,而不是一个诚实的报错。
修复只要一行代码。但真正的发现是:同样的一行代码,也存在于knowledgefy.py——我仓库里那个共用的渲染器——里,而且它已经悄无声息地把十一个已经上线的知识可视化页面全部渲染成了空白。它们已经这样悄无声息地坏了好几个星期。
所以事情是这样的:我,一个写文章教人验证自己的说法、还专门做了一个拒绝接受未经验证证据的闸门的人,过去几个星期一直信心满满,把"eleven beautifully rendered white rectangles"(中译:十一个渲染得很精美的白色矩形)发给同事看。每个文件 300KB。每个文件里都装着完整的知识图谱,正确生成、完美转义、彻头彻尾地看不见。这些文件通过了我写的每一项测试,因为我写的每一项测试问的都是「生成了吗?」,没有一项问「人能看见吗?」
我能发现这个问题,纯粹是因为我在真实的浏览器里打开了页面,而不是相信「看起来合法的 HTML 就一定能渲染出来」。真正抓住这个问题的闸门,是一双盯着屏幕看的眼睛——把这句话写进一篇讲自动化验证的文章里,挺让人汗颜的,但这正是它该被写进来的原因。
反面模式: “这个文件生成时没有报错,所以这个产物是好的。”生成成功不等于渲染成功,一次没有任何控制台输出的静默失败,是代价最高的那种失败。
正面模式与反面模式
值得偷师的正面模式:
- 锚定稳定信号,别锚定 CSS 类名。 这个网站是用 Gatsby 构建的,类名是每次部署都会变的内容哈希。解析器只锚定在 URL 路径代码(
OD-ESS-DWW)和可见的标签文字(“Course Number”)上。改样式,照样能解析;改一个标签,它会报告未测量,而不是瞎猜。 - 把联网步骤和验证闸门分开。 只有一条命令会访问网络。其余所有环节都只读取一份已提交的快照,所以 CI 是离线的、确定性的,不会被别人的部署搞坏。
- 指向它,别复刻它。 六个 Snowflake-Labs 仓库都以固定 SHA 的形式登记在案,并附有一份诚实的说明,写明每个仓库不擅长什么。其中两个被隔离处理:
coco-skills完全没有附许可证,而subagent-cortex-code的许可证 GitHub 也识别不出来。没有许可证,默认版权就适用——你可以链接、可以描述,但不能照抄。这一点由检查来强制执行,而不是靠人去记。
反面模式,我自己就踩过:
- 轻信链接的字面文本。 精选的学习路径页面链接的是像
uni-essdww101这样的旧版 slug,它们会 301 重定向到规范化的OD-ESS-DWW。按字面 slug 去匹配,得到的是一个空的课程顺序——这不是报错,而是一个自信满满、看似合理、实则错误的答案。安静的错误好看,喧闹的错误难看;可对交付它的人来说,安静的错误其实更贵。 - 一个分母没人检查过的百分比(参见:21% 对 55%,同一批人、同一份准备,分母一换,结论就翻了个面。)
- 以为文件生成成功,就等于它能用。
它到底能派上什么用场
整套工具离线运行,只依赖标准库,由 43 个测试把关。真正干活的是三条命令:
$ pathfinder.py plan --role forward-deployed-engineer --free-only
PLAN · role:forward-deployed-engineer
  constraints: free_only
  24 courses · 37.75h · 24 free / 0 paid

1. Platform foundations & architecture  [core]  6h
   · OD-LVLUP-101     0.5h  FREE  Level Up: First Concepts  [title]
   ...
   order: Snowflake's published track order
...
HONEST EDGES
  · 5/38 mappings are curated (13%) — snowflake-os judgment, not published by Snowflake
  · --free-only excluded 12 paid course(s): ILT-DE, ILT-GENAI, ILT-NAF, ...
· a plan predicts effort; only readiness.py scores completion(本文里出现了两个不同的「已验证覆盖度」比例,为了把分母说清楚:22 of 71 是整个知识库里的全部映射;5 of 38 则只是这份仅含免费课程的 FDE(面向客户的解决方案工程)计划所涉及的映射。构建闸门是拿第一个数字——也就是全局数字——来限定上限的。)
排序遵循「证据优先」:只要 Snowflake 公布过顺序(Badge 1 → Badge 6),就照那个顺序来;没公布的,退而求其次按「最简单、最短」排,而且学习计划会写明每一步用的是哪条规则。然后readiness.py会根据已验证的证据给出 GO 或 NO-GO 的判定,一条工作流再把这些判定汇总成一份用人结论——一旦拒绝,必定同时附上通往「可以」的最短路径。没有路线图的「不行」,只是一个人的意见。
可以推而广之的部分
这里说的几乎跟 Snowflake 本身没什么关系。每个有认证项目的厂商,都把一份菜单包装成一条路径来卖。每家按这些认证来配置人手的机构,做的都是 Miller 金字塔最底层的事,却把它当成最高层来汇报。可以照搬的做法是:
- 给证据分类。 不是问「他完成了没有」,而是问「谁能核实他完成了」。这两个问题之间的落差,正是每一张虚高的技能矩阵藏身之处。
- 把「未测量」这一栏公开出来。 我这个工具拒绝知道的那四件事,比它索引过的 58 门课更有价值,因为它们精确地告诉你,信心该在哪里止步。
- 给自己的主观判断设上限,让构建在超限时直接失败。 只要上游什么都不公开,人工判断就免不了。但没有标注出处的人工判断,不过是套着 schema 外壳的个人意见。
Snowflake 在认证页面上写了四个老实的英文单词:assumed but not tested(中译:假定你已具备,但不作考核)。大多数搭建在各类认证之上的工具做的却恰恰相反——什么都不测,什么都假定,然后把它包装成一个百分比呈现出来。你至少能做到的,是像你所衡量的那场考试一样坦诚。
参考文献
- Snowflake. SnowPro Advanced: MLOps Engineer ——考生画像。learn.snowflake.com/en/certifications/snowpro-advanced-mlopsengineer/(访问于 2026-08-03)。原文逐字引用。
- Snowflake-Labs. mcp — MCP Server for Snowflake. github.com/Snowflake-Labs/mcp(Apache-2.0;访问于 2026-08-03)。
- Snowflake-Labs. cocoplus. github.com/Snowflake-Labs/cocoplus(MIT;访问于 2026-08-03)。仓库描述通过 GitHub REST API 逐字引用。
- Snowflake-Labs. coco-skills — Agent Skills for Cortex Code. github.com/Snowflake-Labs/coco-skills(截至 2026-08-03 无任何授权文件)。
- Snowflake. Snowflake-managed MCP server. docs.snowflake.com(访问于 2026-08-03)。仅作引用,未独立测试——测试过程中未使用任何 Snowflake 账户。
- Miller, G. E. (1990). The assessment of clinical skills/competence/performance. Academic Medicine, 65(9 Suppl), S63–S67. doi:10.1097/00001888-199009000-00045. pubmed.ncbi.nlm.nih.gov/2400509/。付费墙内容——仅作描述,未直接引用。
- Witheridge, A., Ferns, G., & Scott-Smith, W. (2019). Revisiting Miller's pyramid in medical education: the gap between traditional assessment and diagnostic reasoning. International Journal of Medical Education, 10, 191–192. pmc.ncbi.nlm.nih.gov/articles/PMC7246123/(开放获取;本文用其阐述金字塔四层级及其经久不衰的地位。)
- Snowflake。课程目录 与 Hands-On Essentials track(实战精要学习路径). learn.snowflake.com/en/courses/, /pages/hands-on-essentials-track/(快照拍摄于 2026-08-03;本文中所有课程目录统计数据均来自该快照。)
溯源说明:本文中的每一项数字(58 门课程、430.25 小时、68.25 免费小时、来自 19 个页面的 12 场考试、94 条有据可查的记录、22/71 条经人工整理的映射、43 项测试)均来自 [8] 所述的已提交快照计算得出,绝非估算。两处直接引用([1] 与 [3])已于 2026-08-03 对照其在线原始来源逐字核实。
AI 原生系列的更多文章
以上文章都收录在主页的 Writing(文章)板块。
本文属于 AI 原生系列。这个工具自己那些诚实的边界,都印在它的输出结果里,而不是藏在某个脚注里。发布按钮在你自己手里。