AI-Nativeシリーズ・カリキュラムエンジニアリング
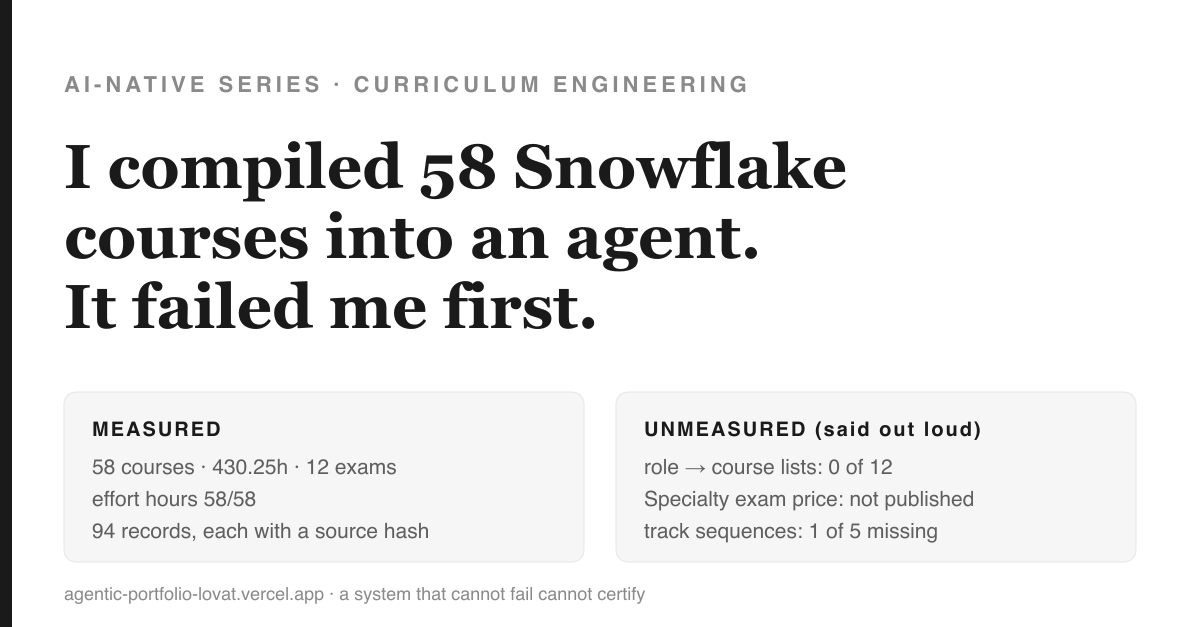
58のSnowflakeコースをエージェントにコンパイルした。まず不合格を突きつけられたのは私自身だった。
1分でわかる要点——持ち帰れるもの
エージェント型のSnowflakeツールはすべてウェアハウスの上では動くが、カリキュラムの上では動かない——だから「この人は何を学ぶべきで、それを実際に学んだのか」という問いに答えられる機械は存在しない。私はそのレイヤーを構築した。役に立ったのは、索引化した58コースそのものではなく、それが知ることを拒否する4つの事柄と、そのエージェントが最初に下した判定が私自身の不合格だったという事実である。
コースカタログはメニューであって、地図ではない。一方を他方に変えるには何が必要か——そして、正直な答えの大半が「分かっていないことのリスト」である理由。所要時間約9分。
Snowflakeは試験がどこで止まるかを教えてくれる。だが、それを読む者はほとんどいない。
SnowPro Advanced: MLOps Engineer認定のページには、マーケティング文言の先に、誰が受験すべきかを説明する一文がある。その最後の節こそ、サイト全体で最も正直な部分だ。
“Knowledge of general ML engineering concepts and cloud infrastructure is assumed but not tested.”
”(訳:一般的なMLエンジニアリングの概念とクラウドインフラの知識は前提とされるが、試験対象ではない)— Snowflake, SnowPro Advanced: MLOps Engineer candidate profile [1]
ここは読み流さないでほしい。ベンダー自身が、自らの測定器の境界線を自主的に引いている一文だからだ。この試験が測るのはSnowflake固有の操作であり、その土台となるエンジニアリング知識は前提としつつも検証はしない。これは欠陥ではなく、むしろ稀に見るほど優れた認識論的な潔癖さだ。そしてそれは、誰かがコースカタログの上にツールを構築した瞬間に、まさに失われてしまう規律でもある。
私はそうしたツールを探した。だが、存在しなかった。
誰もがウェアハウス向けのエージェントを作った。だが、カリキュラム向けに作った者は誰もいなかった。
Snowflake自身のエンジニアリング組織は、印象的なエージェント型ツールチェーンをすでに世に出している。Snowflake-Labs/mcpそのひとつは、Cortex AI、オブジェクト管理、SQLオーケストレーションを公開するModel Context Protocolサーバーだ[2]。cocoplus——このセット中で最もスターを集めているものだが——自らをそのまま“an Agentic Operating System for Snowflake Coco”(訳:Snowflake Cocoのためのエージェント型オペレーティングシステム)と称し、それが“structured, multi-agent workflows to data engineering projects” [3]. coco-skills(訳:構造化されたマルチエージェント・ワークフローをデータエンジニアリングのプロジェクトにもたらす)ものであり、Cortex Code CLI向けに厳選されたエージェントスキルを提供している[4]。ドキュメントにはマネージドMCPエンドポイントも記載されている[5]。
そのどれもがウェアハウスの上で動く。クエリを実行し、パイプラインを構築し、エージェントを出荷する。だが、カリキュラムの上で動くものは一つもない——どのコースを学べば人はそれができるようになるのか、どの順序で、どんなコストで、そしてそこに到達したことをどうやって知るのか。
そのギャップは見落としではなく、ひとつの領域そのものが欠けているのだ。しかも軽視できない。なぜなら、人員配置の判断は現実にカリキュラムを基準にして下されるからだ。だから私は、FDE-osツールキットの中に、その欠けている層を作った——snowflake-os——私のFDE-osツールキットの中に、その欠けている層を作った。そして自分にルールを一つ課した。示せることしか主張してはならない。
メンタルモデル:メニューは地図ではない
カタログはメニューだ。何が存在し、それぞれに何のコストがかかるかを教えてくれる。それは本当に有用だが、まったく不十分でもある。なぜならメニューには、地図が教えてくれる三つのことが分からないからだ。
- 順序——何が何より先に来るべきか。
- 到達点——どの部分集合がこの仕事に到達させてくれるか。
- 到達確認テスト——実際にそこへたどり着いたかどうかを見分ける方法。
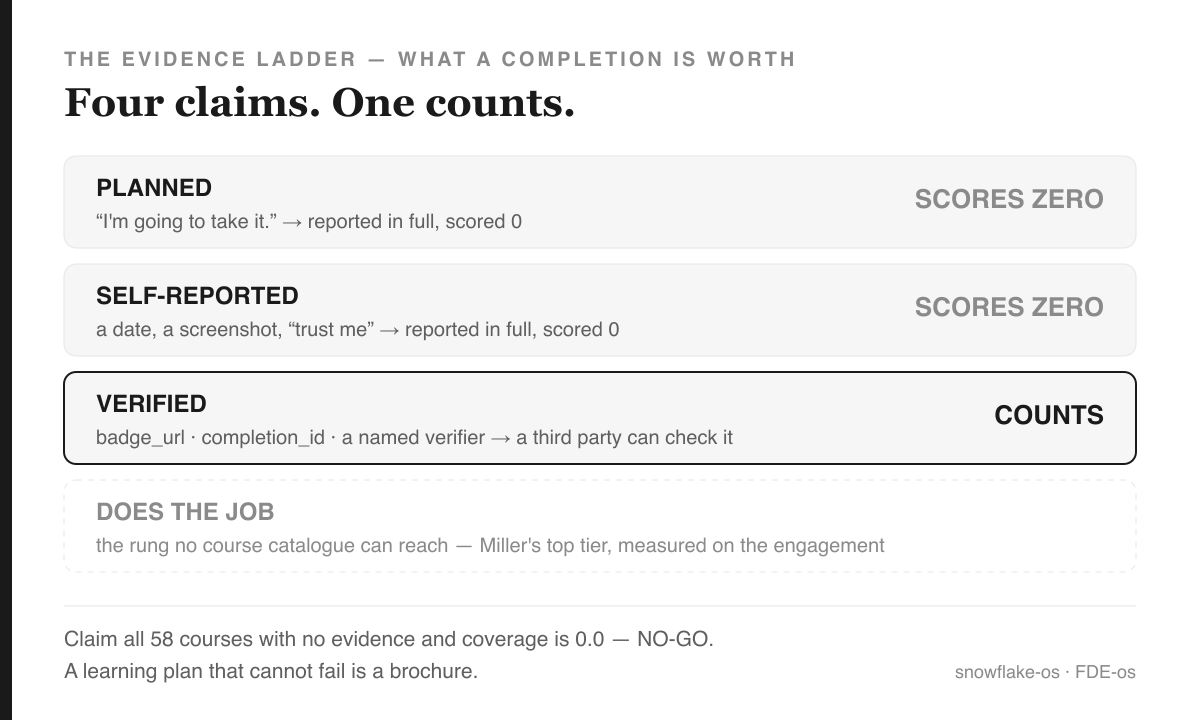
メニューは自称できる。地図は検証できる。実はこの区別、目新しいものではない。1990年、George Millerは臨床能力を評価するための四段階のフレームワークを提唱した。knows(知っている)からknows how(やり方を知っている)、そしてshows how(やって見せられる)を経てdoes(実際にやる)へと段階が上がっていく構造だ——医療の評価は筆記の知識テストに偏りすぎていて、実際に観察されるパフォーマンスへの評価が足りていない、というのが彼の主張だった[6][7]。この枠組みは36年経った今も医学教育の基準モデルであり続けている。アイデアの生存テストとしては、なかなかしぶといと言っていい。
コース修了は、この階段の一番下あたりに位置する。バッジ——第三者が採点済みラボをこなしたことを証明するもの——は、一段上がる。実際に仕事をこなすことが最上段であり、この世のどんなカタログもそれを測ることはできない。ここで肝心なのは、そうでないふりをしないことだ。自分がどの段に立っているかを、はっきりさせることである。
仕組みを一文で言えば
すべての修了実績を、誰が検証できるかで分類し、検証可能なものだけからカバレッジを計算する。 検証にカウントされるのは、次のいずれかが伴う場合だけだ——badge_url, a completion_id、あるいは実名の検証者。日付やスクリーンショット、「信じてくれ」は全文報告されるが、スコアはゼロだ。
本当に重要なテストは、嘘つきに何が起きるかだ。私はゲートに、証拠を一切添付しないままall 58 courses(訳:58コースすべて)を主張する契約を食わせてみた。5つの中核コンピテンシー全体のカバレッジは:0.0。判定はNO-GO、終了コードは2。
第一原則:失敗し得ないシステムは、何も証明できない。常に「イエス」としか言わない学習プランは、進捗バー付きのパンフレットにすぎない。
カタログが実際に含んでいるもの
取り込み処理は、意図的に地味に作ってある。1秒に1リクエストのペースで、公開ページを読み取り専用でアクセスし、コミット済みのオフラインスナップショットへ格納する仕組みだ。各レコードには取得元のURL、パース対象バイト列のSHA-256、タイムスタンプが記録され、来歴(provenance)付きのレコードは94件にのぼる。結果は以下の通り:
| 測定値 | 値 |
|---|---|
| コース | 58——合計430.25時間、うち68.25時間は無料 |
| 個別の試験数 | 12(19ページ中——残りは同一試験のローカライズ版) |
| 所要学習時間 | 公開されている58件中58件 |
| ロールジャーニー | 12 |
そして、ここから先が私にとって本当に気になる部分だ。
あえて知ろうとしない4つのこと
見つけたものだけを報告するナレッジベースは、マーケティング資材にすぎない。興味深いのは、探したのに見つからなかったものの列だ:
- ロール→コースのマッピングは存在しない。12件中0件。 ロールジャーニーのページ12件すべてが、そのロールを文章で説明するだけで、リンク先はカタログであり、個々のコースにはリンクしていないだけだ。このグラフ全体の中で最も価値あるエッジ——「MLエンジニアになりたいなら、これらを受講せよ」——は、機械可読な形式ではどこにも公開されていない。そこで私自身がそれを補い、すべてのマッピングにその根拠をタグ付けした。すなわち、
title(コースタイトルがそのままコンピテンシー名になっている場合)、objective(公開された試験の出題範囲がそう示している場合)、あるいはcurated(私の判断による場合)。現時点では22 of 71 mappings are curated(71件中22件のマッピングがキュレーションによるものだ)。この割合が40%を超えたらビルドゲートが失敗する仕組みにしてある。役割をカバーしたように見せかけてマッピングをでっち上げるのは実に簡単なので、上限を設けることで、見栄えのいい数字ではなくビルド失敗という形で警告が出るようにしている。 - スペシャルティ試験の価格は不明である。どの試験ページも同じFAQを繰り返しており、Coreは175ドル、Advancedシリーズは375ドルと記載している。だがスペシャルティの価格はどこにも載っていない。そのためパーサーはnot measured(計測不能)と記録する——同じページの数センチ横に置いてある、もっともらしい数字を借用することを拒否するのだ。この拒否自体が、テストスイートの中の一項目になっている。
- あるラーニングトラックは順序をまったく公開していない。5つのうち4つはコースを順番に並べて掲載している。だがSnowPro Coreのスタディトラックはカタログと試験登録ページにリンクしているだけで、それ以外は何もない。
- 誰の実際の能力も測れていない。工数(エフォート時間)はSnowflakeの見積もりであって、あなたの実際の所要時間を計測したものではない。そして「実務ができる」——Millerのピラミッドの最上段——は、エンゲージメントの中で測るものであり、カタログの中で測れるものではない。このツール自身がその出力でそう明言している。
そして、このツールは私の仕事を3回にわたって不合格にした
もしこのツールがゲートではなくデモに過ぎなかったなら、この部分は書かずに済んだはずだ。
1. インテグリティ・ゲートは初回実行で私自身のキュレーションのミスを検出した
私はナレッジベースに対して10種類のチェックを書いた——参照切れ、来歴情報の欠落、値の伴わない「計測済み」フラグなど。すると最初の実行結果は8 of 9(9件中8件)で、失敗したのはcompetency-reachableだった。私はMigration & modernisation(移行とモダナイゼーション)というコンピテンシーを定義していたのだが、それを必要とする役割がどこにも存在しなかった。孤立したコンピテンシーだった。その説明文には自分で「ほとんどのエンゲージメントは他人が残したレガシースタックから始まる」と書いておきながら、どこにも紐づけていなかった。直したのはチェックの方ではなく、データの方だ。作者自身に対して一度も発火したことのないバリデーターは、おそらく何もチェックしていないに等しい。
2. レディネスゲートは誤っていた。しかも「甘く見える」方向とは逆に誤っていた
私の最初のカバレッジ計算式は、本当にきちんと準備できていた候補者に対して21%というスコアを出した。バグは私のモデルの側にあり、候補者の準備不足ではなかった。Snowflakeは同じ内容を複数の提供形式で教えており——「Snowflake Platform Training」はオンデマンド版とインストラクター主導版の両方でリリースされている——私はそうしたペアの両側を別々の要件として数えてしまっていた。つまり分母が重複によって水増しされていたのだ。明示的なalternativesグループ(メンバーのどれか一つを満たせば要件クリアとみなし、最も安価なものでコストを算出する)を導入したところ、同じ候補者のスコアは55%に変わった。証拠は同じ、人物も同じ。問題は私の計算の方にあったのだ。分母を間違えた評価ツールは、ツールがないより始末が悪い。もっともらしい数字を出してしまうからだ。
3. 自分のリポジトリにある11個のナレッジビューアが真っ白のまま表示されていた
新しいカタログのグラフが、真っ白なページとしてレンダリングされた——コンソールエラーもなく、何も出ない。原因は、私が<script type="application/json">タグに埋め込んだJSONペイロードをHTMLエスケープしてしまっていたことだった。ブラウザはscript要素内のHTMLエンティティをnotデコードしない。そのためJSON.parseは文字通りの"文字を受け取り、初期化中に例外を投げた——その結果constはtemporal dead zone(訳:初期化前の参照禁止区間)に取り残され、後からその変数を調べても、正直なエラーではなく紛らわしいReferenceErrorが返ってきた。
修正はたった1行だ。判明したのは、同じ行がknowledgefy.py——私のリポジトリの共有レンダラー——にも存在し、すでに公開済みのナレッジビューアを11個静かに真っ白にしていたということだった。何週間も壊れたままになっていたのだ。
つまりこういうことだ。私はあなたの主張を検証することについて記事を書き、未検証の証拠を拒否するゲートを構築した張本人でありながら、何週間もの間、同僚に自信満々にリンクを送り続けていた——eleven beautifully rendered white rectangles(訳:見事にレンダリングされた11枚の真っ白な長方形)を。それぞれ300KB。それぞれに完全なナレッジグラフが、正しく生成され、完璧にエスケープされ、そして完全に見えない状態で入っていた。ファイルは私の持つすべてのテストに合格していた。私のテストはすべて「生成されたか?」しか問わず、「人間に見えるか?」とは誰一人問わなかったからだ。
私がそれに気づけたのは、有効そうに見えるHTMLがちゃんとレンダリングされると信じ込まず、実際のブラウザでページを開いてみたからにすぎない。それを見つけたゲートは、画面を見ている一人の人間だった——自動検証についての記事にこう書くのは謙虚にならざるを得ないが、だからこそここに書く価値がある。
アンチパターン: 「the file generated without error, so the artifact works.」(訳:エラーなく生成されたのだから、その成果物は機能している)。だが生成に成功したこととレンダリングに成功したことは別物で、コンソールに何も出力されない静かな失敗こそ、最も高くつく失敗の種類だ。
パターンとアンチパターン
盗む価値のあるパターン。
- 頼るべきは安定したシグナルであって、CSSクラスではない。 このサイトはGatsbyでビルドされており、クラス名はデプロイのたびに変わるコンテンツハッシュだ。パーサーはURLのパスコード(
OD-ESS-DWW)と、目に見えるラベルのテキスト(「Course Number」)だけを拠り所にしている。スタイルの名前を変えてもパースは通るが、ラベルの名前を変えると、not measured(未計測)と報告するだけで、推測はしない。 - ネットワークにアクセスするステップとゲートは分離する。 インターネットに触れるコマンドはひとつだけ。それ以外はすべてコミット済みのスナップショットを読むだけなので、CIはオフラインかつ決定的で、他人のデプロイに壊されることがない。
- フォークせず、指し示すだけにする。 6つのSnowflake-Labsリポジトリは、固定されたSHAとして登録されており、それぞれの弱点について正直な注記が添えられている。うち2つは隔離扱いだ:
coco-skillsはライセンスファイルが一切なく、subagent-cortex-codeのライセンスはGitHubでも識別不能。ライセンスがない場合、デフォルトの著作権が適用される——リンクして説明することはできるが、コピーはできない。それはチェックによって強制されており、記憶に頼ってはいない。
私が踏み抜いたアンチパターン。
- リンクの見た目のテキストを鵜呑みにすること。 キュレーションされたトラックのページは、
uni-essdww101のような旧式のスラッグにリンクしているだけで、それらは301リダイレクトで正規のOD-ESS-DWWへと転送される。文字通りのスラッグをマッチさせた結果、空のトラック順序が生成された——エラーではなく、ただ自信満々でもっともらしい、間違った答えだ。静かな間違いが声高な間違いより「まし」に見えるのは、それを世に出した張本人にとってだけの話だ。 - 検証されていない分母を持つパーセンテージ(参照:21%対55%)。
- 生成されたファイルが動くと信じ込むこと。「生成できた」だけで安心してしまう罠だ。
実際に何ができるのか
全体はオフラインで、標準ライブラリのみで動き、43個のテストによってゲートされている。実質的な作業は3つのコマンドが担う。
$ pathfinder.py plan --role forward-deployed-engineer --free-only
PLAN · role:forward-deployed-engineer
  constraints: free_only
  24 courses · 37.75h · 24 free / 0 paid

1. Platform foundations & architecture  [core]  6h
   · OD-LVLUP-101     0.5h  FREE  Level Up: First Concepts  [title]
   ...
   order: Snowflake's published track order
...
HONEST EDGES
  · 5/38 mappings are curated (13%) — snowflake-os judgment, not published by Snowflake
  · --free-only excluded 12 paid course(s): ILT-DE, ILT-GENAI, ILT-NAF, ...
· a plan predicts effort; only readiness.py scores completion(この記事には2種類の異なるキュレーション比率が登場するので、分母について明確にしておく:22 of 71 は知識ベース全体におけるマッピングの数であり、5 of 38 は今回の無料コースのみのFDEプランが実際に触れたマッピングの数だ。ビルドゲートは前者、つまりグローバルな数値に対して上限を強制する。)
並び順はエビデンス優先だ。Snowflakeが順序を公開している場合(バッジ1→バッジ6)はその順序が優先される。公開されていない場合は「最も簡単で最も短いものを優先」という規則にフォールバックし、プランは各ステップでどの規則を使ったかを明示する。そしてreadiness.pyは検証済みのエビデンスに基づいてGOかNO-GOかを判定し、ワークフローがそれらを組み合わせて配属判定を出す。ここでは拒否には常に「イエスへの最短ルート」が添えられる。ルートを伴わない「ノー」は単なる意見にすぎない。
汎用化できる部分
ここで書いてきたことは、ほとんどSnowflakeに限った話ではない。認定制度を持つベンダーはどこも、メニューを公開してそれを「パス」と呼んでいる。そうした認定資格を基に配属を決める組織はどこも、Millerのピラミッドの一番下の段を実践していながら、それを一番上の段として報告している。使い回せる原則は次の三つだ。
- エビデンスに型をつけること。 「完了したかどうか」ではなく「誰がそれを確認できるか」を問う。この二つの問いの間にあるギャップこそが、誇張されたスキルマトリクスの生まれる場所だ。
- 測定していない項目を公開すること。 私のツールが「知らない」と断言する4つの事柄は、インデックスした58個のコースよりもよほど有用だ。自信を持てる限界がどこにあるかを正確に示してくれるからである。
- 自分自身の判断には上限を設け、それを超えたらビルドを失敗させること。 上流が何も公開していない以上、キュレーションは避けられない。ラベル付けされていないキュレーションは、スキーマをまとった意見にすぎない。
Snowflakeは認定ページに、こんな正直な一言を書いていた──assumed but not tested(訳:前提とされているが、テストはされない)。認証資格の上に構築されたツールの大半は、その逆をやっている。何もテストせずにすべてを前提とし、それをパーセンテージとして表示する。せめて、自分が測定する試験くらいの正直さは持ちたいものだ。
出典
- Snowflake. SnowPro Advanced: MLOps Engineer — 受験者プロファイル。 learn.snowflake.com/en/certifications/snowpro-advanced-mlopsengineer/(2026-08-03アクセス)。原文をそのまま引用。
- Snowflake-Labs. mcp — MCP Server for Snowflake. github.com/Snowflake-Labs/mcp(Apache-2.0;2026-08-03アクセス)。
- Snowflake-Labs. cocoplus. github.com/Snowflake-Labs/cocoplus(MIT;2026-08-03アクセス)。リポジトリの説明はGitHub REST API経由でそのまま引用。
- Snowflake-Labs. coco-skills — Agent Skills for Cortex Code. github.com/Snowflake-Labs/coco-skills(2026-08-03時点でライセンスファイルなし)。
- Snowflake. Snowflake-managed MCP server. docs.snowflake.com(2026-08-03アクセス)。引用のみで、独自の検証はしていない——テスト対象のSnowflakeアカウントは存在しない。
- Miller, G. E. (1990). The assessment of clinical skills/competence/performance. Academic Medicine, 65(9 Suppl), S63–S67. doi:10.1097/00001888-199009000-00045. pubmed.ncbi.nlm.nih.gov/2400509/。有料壁あり——内容のみ紹介し、引用はしていない。
- Witheridge, A., Ferns, G., & Scott-Smith, W. (2019). Revisiting Miller's pyramid in medical education: the gap between traditional assessment and diagnostic reasoning. International Journal of Medical Education, 10, 191–192. pmc.ncbi.nlm.nih.gov/articles/PMC7246123/(オープンアクセス。ピラミッドの4段階と、それが今なお評価され続けている点について参照した)。
- Snowflake. コースカタログ と Hands-On Essentials トラック. learn.snowflake.com/en/courses/, /pages/hands-on-essentials-track/(2026-08-03時点のスナップショット。本稿のカタログ関連の数値はすべてこのスナップショットに基づく)。
出典に関する注記:本稿中のすべての数値(58コース、430.25時間、無料68.25時間、19ページから抽出した12試験、来歴付きレコード94件、キュレーション済みマッピング22/71、テスト43件)は[8]に記載のコミット済みスナップショットから算出したものであり、推定値ではない。直接引用した2箇所([1]と[3])は、2026-08-03時点でライブソースと逐語的に照合済みである。
AI-Nativeシリーズの他の記事
そのすべては、ホームページのWriting セクションに掲載されている。
AI-Nativeシリーズの一部である。このツール自身が持つ正直な限界は、脚注に埋もれさせるのではなく、出力そのものに刷り込んである。Publishボタンを押す権利は、あなた自身にある。