AI-Native 시리즈 · 커리큘럼 엔지니어링
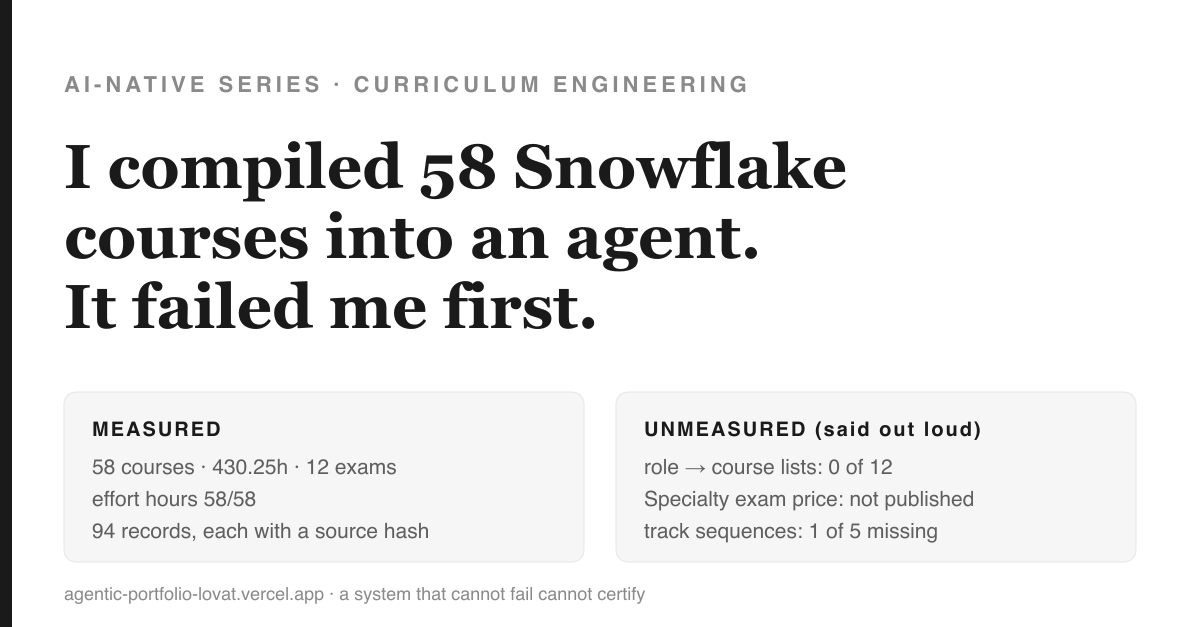
나는 Snowflake 코스 58개를 에이전트로 컴파일했다. 그 에이전트는 먼저 나를 낙제시켰다.
1분 요약 — 이 글에서 얻어갈 것
모든 에이전트형 Snowflake 도구는 웨어하우스 위에서 작동한다. 커리큘럼 위에서 작동하는 것은 하나도 없다 — 그래서 어떤 기계도 "이 사람은 무엇을 배워야 하며, 실제로 배웠는가?"라는 질문에 답할 수 없다. 나는 그 층을 직접 만들었다. 유용했던 부분은 그것이 색인한 58개 코스가 아니라, 그것이 알기를 거부하는 네 가지, 그리고 그 첫 행동이 다름 아닌 내 작업을 낙제시킨 것이었다는 사실이었다.
코스 카탈로그는 메뉴판이지 지도가 아니다. 하나를 다른 하나로 바꾸는 데 무엇이 필요한지 — 그리고 왜 정직한 답이 대체로 '모르는 것들의 목록'인지. ~9분 분량.
Snowflake는 시험이 어디서 멈추는지 알려준다. 거의 아무도 읽지 않을 뿐이다.
SnowPro Advanced: MLOps Engineer 자격증 페이지에는, 마케팅 문구를 지나면, 누가 이 시험을 봐야 하는지 설명하는 문장이 나온다. 그 마지막 절이야말로 이 사이트 전체에서 가장 정직한 대목이다:
“Knowledge of general ML engineering concepts and cloud infrastructure is assumed but not tested.”
” — Snowflake, SnowPro Advanced: MLOps Engineer candidate profile [1] (번역: 일반적인 ML 엔지니어링 개념과 클라우드 인프라에 대한 지식은 전제할 뿐 시험하지 않는다)
다시 읽어보자. 벤더가 스스로 자기 측정 도구의 경계를 자발적으로 그어 보인 문장이기 때문이다. 이 시험은 Snowflake 고유의 작업을 측정한다. 그 밑바탕에 깔린 엔지니어링 역량은 전제할 뿐 검증하지 않는다. 이건 결함이 아니라 대단히 훌륭한 인식론적 위생이며, 누군가 코스 카탈로그 위에 도구를 얹는 순간 정확히 사라지는 바로 그 원칙이다.
나는 그런 도구를 찾아다녔다. 없었다.
모두가 웨어하우스를 위한 에이전트를 만들었다. 커리큘럼을 위한 것은 아무도 만들지 않았다.
Snowflake의 엔지니어링 조직 자체는 인상적인 에이전트형 툴체인을 내놓았다. Snowflake-Labs/mcp은 Cortex AI, 객체 관리, SQL 오케스트레이션을 노출하는 Model Context Protocol 서버다 [2]. cocoplus — 이 중 가장 스타를 많이 받은 것 — 은 스스로를 문자 그대로 이렇게 설명한다. “an Agentic Operating System for Snowflake Coco” (번역: Snowflake Coco를 위한 에이전트형 운영체제) 을 가져온다고 하면서, “structured, multi-agent workflows to data engineering projects” (번역: 데이터 엔지니어링 프로젝트에 구조화된 다중 에이전트 워크플로를) [3]. coco-skills 는 Cortex Code CLI를 위해 엄선된 에이전트 스킬을 제공한다 [4]. 문서에는 관리형 MCP 엔드포인트도 있다 [5].
이들 모두는 웨어하우스 위에서 동작한다: 쿼리를 실행하고, 파이프라인을 만들고, 에이전트를 배포한다. 그 어느 것도 커리큘럼 위에서는 동작하지 않는다: 어떤 코스가 사람을 그 일에 능하게 만드는지, 어떤 순서로, 얼마의 비용으로, 그리고 거기에 도달했는지 어떻게 알 수 있는지 말이다.
그 간극은 실수가 아니라 하나의 범주다. 그리고 이건 무게를 지탱하는 부분이기도 하다. 실제로 인력 배치 결정이 이루어지는 곳이 바로 커리큘럼이기 때문이다. 그래서 나는 빠진 계층을 만들었다 — snowflake-os, 제 FDE-os 툴킷 안에 넣고서, 스스로 규칙을 하나 세웠다: 증명할 수 있는 것만 주장할 것.
멘탈 모델: 메뉴는 지도가 아니다
카탈로그는 메뉴다. 무엇이 존재하는지, 각 항목의 비용이 얼마인지 알려준다. 이는 분명 유용하지만 완전히 불충분하다. 메뉴는 지도가 해줄 수 있는 세 가지를 알려주지 못하기 때문이다:
- 순서 — 무엇이 무엇보다 먼저 와야 하는지;
- 목적지 — 어떤 부분집합이 바로 이 직무로 이어지는지;
- 도착 판정 — 실제로 거기 도달했는지 알아내는 방법.
메뉴는 주장할 수 있고, 지도는 검증할 수 있다. 이 구분은 새로운 것이 아니다: 1990년 George Miller는 임상 역량을 평가하는 4단계 프레임워크를 제안했는데, 안다(knows)에서 시작해 방법을 안다(knows how)와 보여줄 수 있다(shows how)를 거쳐 실제로 한다(does)로 올라간다 — 그의 주장은 의학 평가가 필기시험에 너무 치우쳐 있고 실제 관찰된 수행에는 충분히 의존하지 않는다는 것이었다[6][7]. 36년이 지난 지금도 여전히 의학교육의 기준 모델로 쓰이고 있으니, 아이디어의 생존력을 시험하는 나름 괜찮은 잣대인 셈이다.
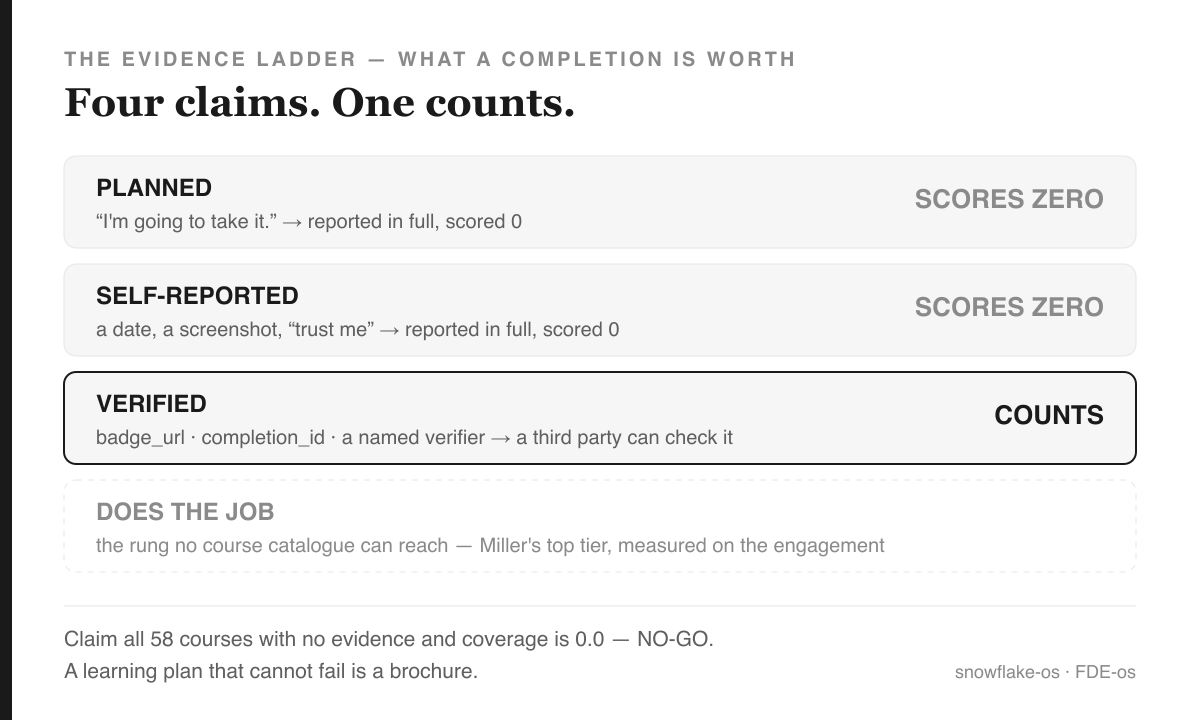
수강 완료는 그 사다리의 맨 아래 칸에 가깝다. 배지 — 제3자가 채점된 실습을 완료했다고 증명해주는 것 — 는 한 칸 위로 올라간다. 실제로 그 일을 해내는 것이 맨 위 칸인데, 이 세상 어떤 카탈로그도 그것을 측정할 수 없다. 요령은 그렇지 않은 척하는 게 아니라, 지금 자신이 어느 칸에 서 있는지를 분명히 밝히는 것이다.
메커니즘을 한 문장으로
모든 수강 완료 기록을 누가 검증할 수 있는지에 따라 분류한 다음, 검증 가능한 것들만으로 커버리지를 계산한다. 완료 기록으로 인정받으려면 badge_url, a completion_id가 있거나, 확인 가능한 검증자가 명시되어 있어야 한다. 날짜나 스크린샷, 혹은 "믿어달라"는 식의 주장은 있는 그대로 보고되긴 하지만 점수는 0점 처리된다.
정말 중요한 시험대는 따로 있다. 바로 거짓말을 하는 사람에게 무슨 일이 일어나느냐다. 나는 이 게이트에 다음과 같은 계약을 입력해 보았다: all 58 courses라고 주장하되, 어느 것에도 근거를 첨부하지 않은 것이다. 다섯 개 핵심 역량 전체에 걸친 커버리지는 0.0였다. 판정: NO-GO. 종료 코드 2.
제1원칙: 실패할 수 없는 시스템은 인증할 자격이 없다. 항상 '예'라고만 답하는 학습 계획은 진행률 표시줄이 달린 브로슈어에 불과하다.
카탈로그가 실제로 담고 있는 것
수집 과정은 의도적으로 지루하게 설계했다. 초당 한 건의 요청만 보내고, 읽기 전용으로, 공개 페이지만을 대상으로 하며, 결과는 커밋된 오프라인 스냅샷에 저장한다. 모든 레코드는 출처 URL과 파싱한 정확한 바이트의 SHA-256, 그리고 타임스탬프를 함께 기록하므로, 94개 레코드 모두 출처가 명확하다. 결과는 다음과 같다:
| 측정값 | 값 |
|---|---|
| 코스 | 58개 — 총 430.25시간, 이 중 68.25시간은 무료 |
| 개별 시험 | 12개 (19개 페이지 중에서; 나머지는 동일 시험의 지역화 버전) |
| 소요 시간 | 58개 중 58개 공개됨 |
| 역할별 여정 | 12 |
그리고 이제부터가 내가 더 신경 쓰는 부분이다.
이 도구가 알기를 거부하는 네 가지
찾은 것만 보고하는 지식 베이스는 마케팅 자산에 불과하다. 흥미로운 항목은 이 도구가 무엇을 찾으려 했고 무엇을 얻지 못했는가이다:
- 역할 → 코스 매핑은 존재하지 않는다. 12개 중 0개. 열두 개의 역할별 여정 페이지 모두 산문 형태로 역할을 설명하며, 링크는 개별 코스가 아니라 카탈로그를 가리킬 뿐, 개별 코스로는 연결되지 않는다. 전체 그래프에서 가장 유용한 연결선 하나 — "ML 엔지니어가 되려면 이 코스들을 들어라" — 는 어디에도 기계가 읽을 수 있는 형태로 공개되어 있지 않다. 그래서 나는 이를 직접 채워 넣었고, 모든 매핑에는 그 근거를 표기해두었다:
title(코스 제목이 해당 역량을 직접 명시하는 경우),objective(공개된 시험 목표가 그렇게 명시하는 경우), 또는curated(내 판단인 경우). 현재 22 of 71 mappings are curated 상태이며, 이 비율이 40%를 넘으면 빌드 게이트가 실패하도록 되어 있다. 매핑을 지어내서 어떤 역할을 "커버"하는 것은 아주 쉬운 일이라서, 이 상한선을 두면 그럴싸해 보이는 숫자가 아니라 빌드 실패로 처리된다. - 전문 분야 시험 가격은 알 수 없다. 모든 시험 페이지는 Core는 $175, Advanced 시리즈는 $375라는 동일한 FAQ 문구를 반복할 뿐, 전문 분야 시험 가격은 어디에도 나오지 않는다. 그래서 파서는 이를 not measured 로 기록한다 — 바로 옆에 있는 그럴듯한 숫자를 빌려다 쓰는 일을 거부하는 것이다. 이 거부 동작 자체가 테스트 스위트에 포함된 검사 항목이다.
- 학습 트랙 하나는 순서를 전혀 공개하지 않는다. 다섯 개 트랙 중 넷은 코스를 순서대로 나열한다. 그런데 SnowPro Core 학습 트랙은 카탈로그와 시험 등록 페이지로 링크만 걸어둘 뿐, 그 외에는 아무것도 없다.
- 누구의 실제 역량인지는 알 수 없다. 학습 시간은 Snowflake가 추정한 값일 뿐, 실제로 걸리는 시간을 측정한 것이 아니다. 그리고 Miller의 최상위 단계인 "실제로 업무를 해내는가"는 카탈로그가 아니라 실무 인게이지먼트에서 측정되는 것이다. 이 도구는 그 사실을 자기 출력물에 명시해둔다.
그리고 내 작업 자체가 세 번 실패했다
이 부분은 도구가 그저 데모였다면 건너뛰었을 대목이다.
1. 무결성 게이트가 첫 실행에서 내 큐레이션을 잡아냈다
지식 베이스에 대해 열 가지 검사를 작성했다. 끊긴 참조, 누락된 출처, 배후 값이 없는 "measured" 플래그 같은 것들이다. 첫 실행 결과는 8 of 9였고, 실패한 항목은 competency-reachable이었다. 나는 Migration & modernisation 역량을 정의해놓고서, 정작 그 역량을 요구하는 역할은 하나도 만들지 않았던 것이다. 어디에도 연결되지 않은 항목이었다. 그 항목의 설명에는 "대부분의 인게이지먼트는 남이 만들어놓은 레거시 스택에서 시작한다"라고 써두었으면서, 실제로는 그 어떤 것에도 이어놓지 않은 셈이었다. 이때 고친 것은 검사가 아니라 데이터였다. 저자 본인에게 단 한 번도 걸린 적 없는 검증기는, 사실 아무것도 검사하지 않고 있는 것이나 마찬가지다.
2. 준비도 게이트가 틀렸다. 그것도 후한 쪽이 아니라 정반대 방향으로 틀렸다
내 첫 번째 커버리지 공식은 실제로 준비가 잘 된 후보자에게 21% 점수를 매겼다. 버그는 내 모델에 있었지, 그 사람의 준비 상태에 있지 않았다. Snowflake는 같은 내용을 여러 전달 방식으로 가르친다 — "Snowflake Platform Training"은 온디맨드와 강사 진행 과정 양쪽으로 나온다 — 그런데 나는 이런 쌍의 양쪽 모두를 별개의 요구사항으로 세고 있었다. 분모가 중복으로 부풀려져 있었던 것이다. 명시적인 alternatives 그룹(구성원 중 누구든 하나만 요구사항을 충족하며, 가장 저렴한 것으로 비용을 계산한다)을 도입하자 같은 후보자가 55% 로 이동했다. 증거도 같고 사람도 같다. 문제는 내 계산이었던 것이다. 분모가 잘못된 평가 도구는 도구가 없는 것보다 더 나쁜데, 구체적으로 보이는 숫자를 만들어내기 때문이다.
3. 내 레포 안의 지식 뷰어 11개가 백지로 렌더링되고 있었다
내 새 카탈로그 그래프는 텅 빈 흰 페이지로 렌더링되었다 — 콘솔 에러도 없고, 아무것도 없었다. 원인은 이랬다: 나는 <script type="application/json"> 태그 안에 삽입된 JSON 페이로드를 HTML로 이스케이프해 버렸던 것이다. 브라우저는 script 요소 안에서 HTML 엔티티를 디코드하지 않으므로, JSON.parse 는 문자 그대로의 " 문자를 받아 초기화 중 예외를 던졌다 — 그 결과 const 는 초기화 이전 접근 금지 구간(temporal dead zone)에 갇혔고, 그래서 나중에 그 변수를 살펴보려 해도 정직한 에러 대신 혼란스러운 ReferenceError 만 나왔다.
고치는 데는 한 줄이면 충분했다. 하지만 발견한 사실은, 같은 줄이 knowledgefy.py — 내 레포의 공유 렌더러 — 에도 존재했고, 이미 배포된 지식 뷰어 11개 를 몇 주째 조용히 백지로 만들고 있었다는 것이다.
그러니까: 나는 여러분의 주장을 검증하라는 글을 쓰는 사람이고, 검증되지 않은 증거는 거부하는 게이트를 만든 사람이며, 그러면서도 몇 주 동안 자신 있게 동료들에게 아름답게 렌더링된 흰색 사각형 11개 를 링크로 보내고 있었던 사람이다. 각 파일은 300KB였다. 각 파일은 완전한 지식 그래프를 담고 있었고, 올바르게 생성되었으며, 완벽하게 이스케이프되었지만, 완전히 보이지 않았다. 이 파일들은 내가 가진 모든 테스트를 통과했는데, 내가 가진 모든 테스트가 "생성이 되었는가?"만 물었을 뿐 "사람이 볼 수 있는가?"는 아무도 묻지 않았기 때문이다.
내가 이걸 발견한 건 오직 실제 브라우저로 페이지를 열어봤기 때문이다 — 그럴듯해 보이는 HTML이 렌더링될 거라고 그냥 믿지 않았기 때문이다. 이걸 잡아낸 게이트는 화면을 들여다본 한 사람이었다. 자동 검증에 관한 글을 쓰면서 이런 대목을 적자니 겸허해지는데, 바로 그래서 이 얘기를 여기 넣은 것이다.
안티패턴: "파일이 오류 없이 생성됐으니 결과물은 작동한다." 생성이 성공했다고 렌더링까지 성공한 건 아니다. 콘솔 출력조차 없는 조용한 실패야말로 가장 값비싼 종류의 실패다.
패턴과 안티패턴
훔칠 만한 패턴들:
- CSS 클래스가 아니라 안정적인 신호에 고정하라. 이 사이트는 Gatsby로 빌드되는데, 클래스 이름은 배포할 때마다 바뀌는 콘텐츠 해시다. 그래서 파서는 오직 URL 경로 코드(
OD-ESS-DWW)와 화면에 보이는 라벨 텍스트("Course Number")에만 근거를 둔다. 스타일링 이름을 바꿔도 파싱은 그대로 되지만, 라벨을 바꾸면 추측하는 대신 미측정이라고 보고한다. - 네트워크를 타는 단계와 게이트를 분리하라. 인터넷에 접속하는 명령은 단 하나뿐이다. 나머지는 전부 커밋된 스냅샷을 읽으므로 CI는 오프라인이고 결정론적이며, 남의 배포 때문에 깨질 일도 없다.
- 포크하지 말고 참조하라. 여섯 개의 Snowflake-Labs 레포는 고정된 SHA로 등록해두었고, 각각 어떤 점이 부실한지 정직하게 적어두었다. 그중 둘은 격리 대상이다:
coco-skills는 라이선스가 아예 없고,subagent-cortex-code는 라이선스를 GitHub이 식별하지 못한다. 라이선스가 없으면 기본 저작권이 적용되므로, 링크하고 설명할 수는 있지만 복사할 수는 없다. 이 규칙은 기억이 아니라 검사가 강제한다.
내가 직접 빠졌던 안티패턴들:
- 링크의 문자열을 곧이곧대로 믿는 것. 큐레이션된 트랙 페이지들은
uni-essdww101같은 예전 주소로 링크를 걸어두는데, 이 주소는 정식 주소인OD-ESS-DWW(으)로 301 리다이렉트된다. 이 주소 문자열을 그대로 매칭한 결과 빈 트랙 시퀀스가 나왔다 — 오류가 발생한 게 아니라, 그럴듯하고 자신만만하되 틀린 답이 나온 것이다. 조용한 오류가 시끄러운 오류보다 나은 점은, 그걸 내보낸 사람의 체면뿐이다. - 분모를 검토하지 않은 백분율 (참고: 21% vs 55%).
- 생성된 파일이 작동한다고 믿는 것 — 생성됐다는 이유만으로.
실제로 이걸로 할 수 있는 일
이 도구는 전부 오프라인으로 작동하고, 표준 라이브러리만 쓰며, 43개 테스트로 게이트를 건다. 실제 작업을 하는 것은 세 개의 명령어다:
$ pathfinder.py plan --role forward-deployed-engineer --free-only
PLAN · role:forward-deployed-engineer
  constraints: free_only
  24 courses · 37.75h · 24 free / 0 paid

1. Platform foundations & architecture  [core]  6h
   · OD-LVLUP-101     0.5h  FREE  Level Up: First Concepts  [title]
   ...
   order: Snowflake's published track order
...
HONEST EDGES
  · 5/38 mappings are curated (13%) — snowflake-os judgment, not published by Snowflake
  · --free-only excluded 12 paid course(s): ILT-DE, ILT-GENAI, ILT-NAF, ...
  · a plan predicts effort; only readiness.py scores completion
(이 글에는 서로 다른 두 개의 큐레이션 비율이 등장하므로 분모를 분명히 해둔다: 22 of 71은 지식 베이스 전체에서의 매핑이고, 5 of 38은 이번에 다룬 무료 전용 FDE 플랜이 건드린 매핑만 가리킨다. 빌드 게이트는 상한선을 앞의 숫자, 즉 전체 기준으로 강제한다.)
순서는 증거 우선이다. Snowflake가 순서(배지 1 → 배지 6)를 공개한 곳에서는 그 순서를 따른다. 공개하지 않은 곳에서는 '쉽고 짧은 것부터'를 기본값으로 쓰며, 플랜은 각 단계마다 어떤 규칙을 썼는지 명시한다. 그런 다음 readiness.py는 검증된 증거를 근거로 GO 또는 NO-GO를 판정하고, 워크플로가 이를 조합해 배치 판정을 내린다. 이때 거부에는 항상 예스로 가는 가장 짧은 경로가 함께 제시된다. 경로 없는 '아니오'는 그냥 의견일 뿐이다.
일반화되는 부분
여기 있는 내용은 거의 다 Snowflake에 국한되지 않는다. 인증 프로그램을 운영하는 벤더는 하나같이 메뉴를 만들어놓고 그것을 경로라 부른다. 그런 인증을 근거로 인력을 배치하는 모든 조직은 Miller의 가장 아래 단계를 수행하면서 그것을 최상위 단계처럼 보고한다. 재사용 가능한 원칙들:
- 증거에 유형을 매겨라. '이수했는가'가 아니라 '누가 그것을 확인할 수 있는가'를 물어야 한다. 이 두 질문 사이의 간극이야말로 부풀려진 역량 매트릭스가 서식하는 자리다.
- 측정하지 못한 항목을 공개하라. 내 도구가 모른다고 인정하는 네 가지가, 그것이 색인한 58개 과정보다 더 유용하다. 자신의 확신이 어디서 멈춰야 하는지를 정확히 알려주기 때문이다.
- 자신의 판단에는 상한선을 두고, 그것을 넘으면 빌드가 실패하게 하라. 상류에서 아무것도 공개하지 않는 한 큐레이션은 피할 수 없다. 표시되지 않은 큐레이션은 스키마를 입은 의견일 뿐이다.
Snowflake는 인증 페이지에 정직한 네 단어를 적어놓았다: assumed but not tested(번역: 전제할 뿐 시험하지는 않는다). 자격증 위에 세워진 대부분의 툴링은 정반대로 움직인다 — 아무것도 시험하지 않고 모든 것을 전제한 뒤, 그것을 퍼센트로 둔갑시킨다. 적어도 자신이 측정 기준으로 삼는 그 시험만큼은 솔직해야 마땅하다.
참고문헌
- Snowflake. SnowPro Advanced: MLOps Engineer — 응시자 프로필. learn.snowflake.com/en/certifications/snowpro-advanced-mlopsengineer/ (2026-08-03 접속). 원문 그대로 인용.
- Snowflake-Labs. mcp — MCP Server for Snowflake. github.com/Snowflake-Labs/mcp (Apache-2.0; 2026-08-03 접속).
- Snowflake-Labs. cocoplus. github.com/Snowflake-Labs/cocoplus (MIT; 2026-08-03 접속). 저장소 설명은 GitHub REST API를 통해 원문 그대로 인용.
- Snowflake-Labs. coco-skills — Agent Skills for Cortex Code. github.com/Snowflake-Labs/coco-skills (2026-08-03 기준 라이선스 파일 없음).
- Snowflake. Snowflake-managed MCP server. docs.snowflake.com (2026-08-03 접속). 인용은 하되 직접 테스트하지는 않음 — 테스트 대상 Snowflake 계정 없음.
- Miller, G. E. (1990). The assessment of clinical skills/competence/performance. Academic Medicine, 65(9 Suppl), S63–S67. doi:10.1097/00001888-199009000-00045. pubmed.ncbi.nlm.nih.gov/2400509/. 유료 열람(paywalled) — 인용 없이 내용만 소개.
- Witheridge, A., Ferns, G., & Scott-Smith, W. (2019). Revisiting Miller's pyramid in medical education: the gap between traditional assessment and diagnostic reasoning. International Journal of Medical Education, 10, 191–192. pmc.ncbi.nlm.nih.gov/articles/PMC7246123/ (오픈 액세스; 피라미드의 4단계와 그 이론이 지금껏 유지되고 있다는 근거로 인용).
- Snowflake. 코스 카탈로그 및 Hands-On Essentials 트랙. learn.snowflake.com/en/courses/, /pages/hands-on-essentials-track/ (2026-08-03 스냅샷 기준; 이 글의 모든 카탈로그 수치는 해당 스냅샷에서 도출한 것이다.)
출처 표기: 이 글에 등장하는 모든 수치(코스 58개, 총 430.25시간, 무료 68.25시간, 19개 페이지에서 추출한 12개 시험, 출처가 기록된 94개 레코드, 큐레이션된 매핑 22/71, 테스트 43개)는 추정치가 아니라 [8]에 설명된 커밋된 스냅샷에서 계산한 값이다. 직접 인용한 두 문장 [1]과 [3]은 2026-08-03 기준 실제 출처와 대조하여 원문 그대로임을 확인했다.
AI-Native 시리즈 더 보기
이 모든 글은 Writing 섹션에 있다.
AI-Native 시리즈의 일부다. 이 도구의 정직한 한계는 각주에 묻혀 있지 않고 출력 결과에 그대로 인쇄된다. Publish 버튼을 누르는 것은 나 자신이다.