Serie AI-Native · Ingeniería de Currículos
Compilé 58 Cursos de Snowflake en un Agente. Me Falló a Mí Primero.
Resumen de 1 minuto — con qué te vas a quedar
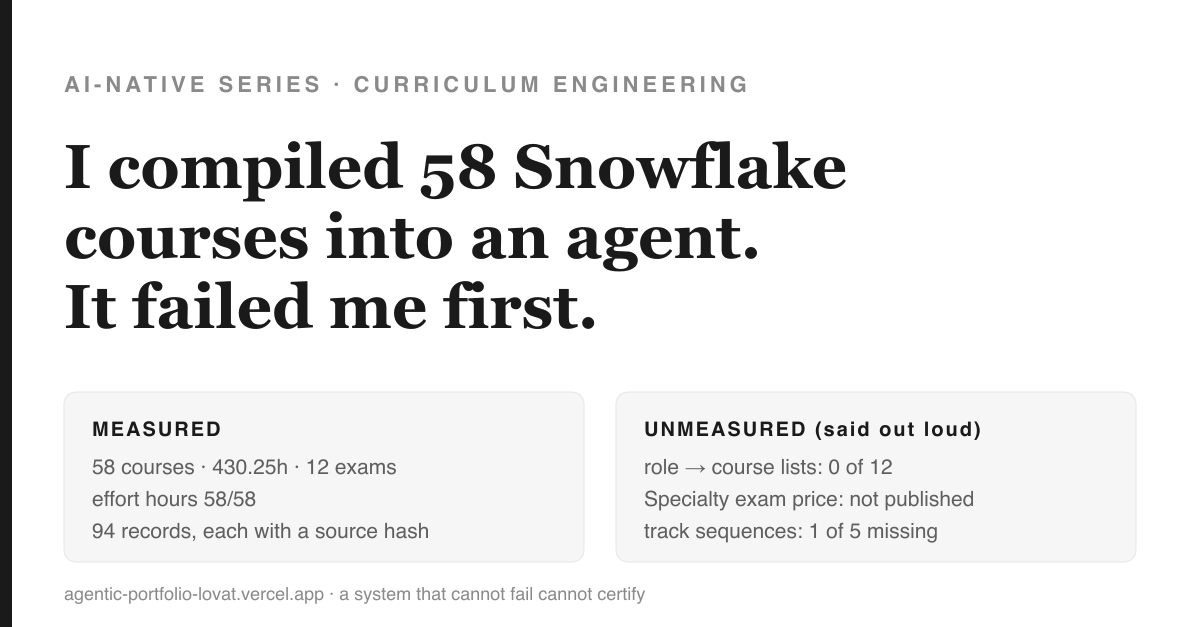
Toda herramienta agéntica de Snowflake opera sobre el warehouse. Ninguna opera sobre el currículo —así que ninguna máquina puede responder "¿qué debería aprender esta persona, y lo aprendió?" Yo construí esa capa. Lo útil no fueron los 58 cursos que indexó, sino las cuatro cosas que se niega a saber, además del hecho de que su primer acto fue fallarme a mí.
Un catálogo de cursos es un menú, no un mapa. Lo que hace falta para convertir uno en el otro —y por qué la respuesta honesta es, sobre todo, una lista de cosas que no sabes. ~9 min.
Snowflake te dice dónde se detiene el examen. Casi nadie lo lee.
En la página de la certificación SnowPro Advanced: MLOps Engineer, pasando la parte de marketing, hay una frase que describe a quién debería presentar el examen. La última cláusula es lo más honesto de todo el sitio:
“Knowledge of general ML engineering concepts and cloud infrastructure is assumed but not tested.”
” — Snowflake, SnowPro Advanced: MLOps Engineer candidate profile [1] (Traducción: «Se asume el conocimiento de conceptos generales de ingeniería de ML e infraestructura en la nube, pero no se evalúa»)
Léelo de nuevo, porque es un proveedor trazando voluntariamente el límite de su propio instrumento. El examen mide operaciones específicas de Snowflake. asume la ingeniería subyacente y no la comprueba. Eso no es un defecto: es una higiene epistémica inusualmente buena, y es exactamente la disciplina que desaparece en cuanto alguien construye una herramienta sobre un catálogo de cursos.
Salí a buscar esa herramienta. No existe.
Todos construyeron agentes para el warehouse. Nadie construyó uno para el currículo.
El propio equipo de ingeniería de Snowflake ha lanzado una cadena de herramientas agénticas impresionante. Snowflake-Labs/mcp es un servidor de Model Context Protocol que expone Cortex AI, gestión de objetos y orquestación SQL [2]. cocoplus — el que más estrellas tiene del conjunto — se describe a sí mismo, textualmente, como “an Agentic Operating System for Snowflake Coco” (Traducción: «un sistema operativo agéntico para Snowflake Coco») que aporta “structured, multi-agent workflows to data engineering projects” (Traducción: «flujos de trabajo estructurados y multiagente a proyectos de ingeniería de datos») [3]. coco-skills ofrece habilidades de agente curadas para su CLI de Cortex Code [4]. Hay un endpoint de MCP administrado en la documentación [5].
Cada una de ellas opera sobre el warehouse: ejecutar la consulta, construir el pipeline, lanzar el agente. Ninguna opera sobre el currículo: cuál de los cursos capacita a una persona para hacer eso, en qué orden, a qué costo, y cómo sabrías que lo logró.
Esa brecha no es un descuido, es una categoría. Y es estructural, porque el currículo es donde de verdad se toman las decisiones de dotación de personal. Así que construí la capa que faltabasnowflake-os, dentro de mi conjunto de herramientas FDE-os — y me impuse una sola regla: solo puede reclamar aquello que puede demostrar.
El modelo mental: un menú no es un mapa
Un catálogo es un menú. Te dice qué existe y cuánto cuesta cada ítem. Eso es genuinamente útil y completamente insuficiente, porque un menú no puede decirte tres cosas que un mapa sí puede:
- un orden — qué tiene que venir antes de qué;
- un destino — qué subconjunto te lleva a este puesto;
- una prueba de llegada — una forma de saber si realmente llegaste.
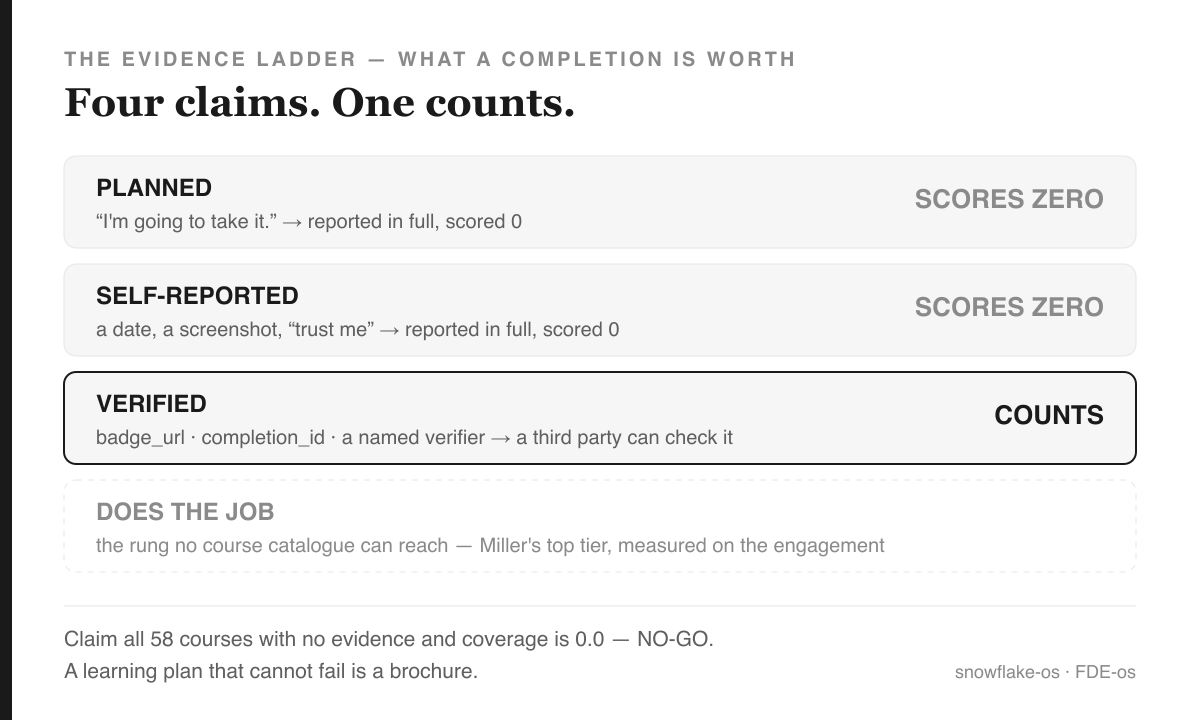
Los menús se pueden alegar. Los mapas se pueden verificar. Esa distinción no es nueva: en 1990 George Miller propuso un marco de cuatro niveles para evaluar la competencia clínica, que asciende desde sabe pasando por sabe cómo y demuestra cómo hasta hace — su argumento era que la evaluación médica se apoyaba demasiado en exámenes de conocimiento escrito y demasiado poco en el desempeño observado [6][7]. Treinta y seis años después, sigue siendo el modelo de referencia en la educación médica, lo cual es una prueba de supervivencia bastante decente para una idea.
Completar un curso está cerca de la base de esa escalera. Una insignia —un tercero que da fe de que hiciste el laboratorio calificado— sube un peldaño. Hacer el trabajo es el peldaño más alto, y ningún catálogo en el mundo puede medirlo. El truco no es fingir lo contrario. Es ser explícito sobre en qué peldaño estás parado.
El mecanismo, en una frase
Clasificar cada finalización según quién puede verificarla, y luego calcular la cobertura solo a partir de las verificables. Una finalización cuenta si lleva un badge_url, a completion_id, o un verificador con nombre. Una fecha, una captura de pantalla o un "confía en mí" se reporta íntegro y se puntúa en cero.
La prueba que importa es qué pasa con un mentiroso. Le di a la compuerta un contrato que afirmaba all 58 courses, sin evidencia adjunta a ninguno de ellos. Cobertura en las cinco competencias clave: 0.0. Veredicto: NO-GO. Código de salida 2.
Primer principio: un sistema que no puede fallar no puede certificar. Un plan de aprendizaje que siempre dice que sí es un folleto con barra de progreso.
Lo que el catálogo realmente contiene
La ingesta es deliberadamente aburrida: una solicitud por segundo, solo lectura, contra páginas públicas, hacia una instantánea offline confirmada. Cada registro guarda la URL de origen, el SHA-256 de los bytes exactos analizados y una marca de tiempo — 94 registros, todos con procedencia. El resultado:
| Medido | Valor |
|---|---|
| Cursos | 58 — 430.25 horas en total, de las cuales 68.25 son gratuitas |
| Exámenes distintos | 12 (de 19 páginas; el resto son localizaciones del mismo examen) |
| Horas de esfuerzo | 58 de 58 publicadas |
| Trayectorias de rol | 12 |
Y ahora la parte que más me importa.
Cuatro cosas que se niega a saber
Una base de conocimiento que solo reporta lo que encontró es un activo de marketing. La columna interesante es lo que buscó y no consiguió:
- El mapeo de rol → curso no existe. 0 de 12. Las doce páginas de trayectoria de rol describen el puesto en prosa y enlazan a el catálogo, no a cursos individuales. La conexión más útil de todo el grafo —«si quieres ser ML engineer, toma estos»— no está publicada en ningún lugar de forma legible por máquina. La aporto yo mismo, y cada mapeo va etiquetado con su base:
title(el título del curso nombra literalmente la competencia),objective(un objetivo de examen publicado lo hace), ocurated(mi criterio). Actualmente 22 de 71 mapeos son curados, y una compuerta de build falla si eso llega a superar el 40%. Es muy fácil «cubrir» un rol inventando mapeos; el techo convierte eso en un build en rojo en vez de en un número que luce bien. - El precio de los exámenes de especialidad no se conoce. Cada página de examen repite el mismo FAQ que cita $175 para Core y $375 para la serie Advanced. Los precios de especialidad no aparecen en ninguna parte. Por eso el parser registra no medido —se niega a tomar prestado el número plausible que está a dos centímetros, en la misma página. Esa negativa es una prueba dentro del conjunto de tests.
- Una ruta de aprendizaje no publica secuencia alguna. Cuatro de cinco listan sus cursos en orden. La ruta de estudio de SnowPro Core enlaza al catálogo y a la página de inscripción al examen, y nada más.
- La competencia real de nadie. Las horas de esfuerzo son estimaciones de Snowflake, no mediciones de tu tiempo real. Y «hace el trabajo» —el peldaño superior de Miller— se mide en un engagement, no en un catálogo. La herramienta lo dice en su propia salida.
Luego falló mi propio trabajo, tres veces
Esta es la parte que me habría saltado si la herramienta fuera una demo en vez de una compuerta.
1. La compuerta de integridad detectó mi curaduría en su primera corrida
Escribí diez chequeos sobre la base de conocimiento —referencias colgantes, procedencia faltante, marcas de «medido» sin ningún valor detrás. La primerísima ejecución arrojó 8 de 9, con una falla en competency-reachable: había definido una competencia de Migration & modernisation que ningún rol requería. Una huérfana. Había escrito las palabras «la mayoría de los engagements empiezan como el legacy stack de otra persona» en su propia descripción y luego no la había conectado a nada. Arreglé los datos, no el chequeo. Un validador que nunca se ha disparado sobre su propio autor probablemente no está verificando nada.
2. La compuerta de preparación estaba mal, y estaba mal en el sentido contrario al halagador
Mi primera fórmula de cobertura calificó a un candidato genuinamente bien preparado con 21%. El error estaba en mi modelo, no en su preparación: Snowflake enseña el mismo contenido en varias modalidades de entrega —"Snowflake Platform Training" se ofrece tanto como curso a demanda como con instructor— y yo estaba contando ambos lados de cada uno de esos pares como requisitos separados. El denominador estaba inflado con duplicados. Al introducir grupos explícitos de alternatives (donde basta con cumplir cualquiera de los miembros del grupo, calculado al más barato), el mismo candidato pasó a 55%. Misma evidencia, misma persona; el problema había sido mi aritmética. Una herramienta de evaluación cuyo denominador está mal es peor que no tener herramienta, porque produce un número que aparenta ser preciso.
3. Once visores de conocimiento en mi propio repositorio llevaban semanas renderizando en blanco
Mi nuevo gráfico del catálogo se renderizaba como una página en blanco vacía —sin error de consola, nada—. La causa: había escapado a HTML el payload JSON incrustado en una etiqueta <script type="application/json">. Un navegador no decodifica entidades HTML dentro de un elemento script, así que JSON.parse recibía literalmente los caracteres " y arrojaba un error durante la inicialización —lo que dejaba a const en su zona muerta temporal, de modo que incluso al examinar la variable después se obtenía un ReferenceError confuso en lugar de uno honesto.
El arreglo es de una línea. El hallazgo fue que esa misma línea existía en knowledgefy.py, el renderizador compartido de mi repositorio, y llevaba semanas dejando en blanco, en silencio, a once visores de conocimiento ya publicados. Llevaban semanas rotos.
Así que: soy la persona que escribe artículos sobre verificar tus afirmaciones, que construyó una compuerta que se niega a aceptar evidencia no verificada, y que había pasado varias semanas enviando a colegas, con total confianza, enlaces a eleven beautifully rendered white rectangles (Traducción: once rectángulos blancos bellamente renderizados). Cada uno de 300KB. Cada uno con el grafo de conocimiento completo, correctamente generado, perfectamente escapado y completamente invisible. Los archivos pasaron todas las pruebas que tenía, porque todas mis pruebas preguntaban "¿se generó?" y ninguna preguntaba "¿puede verlo un humano?"
Solo lo descubrí porque abrí la página en un navegador real en lugar de confiar en que un HTML con apariencia válida se renderiza. La compuerta que lo detectó fue una persona mirando una pantalla —lo cual es humillante de escribir en un artículo sobre verificación automatizada, y precisamente por eso está aquí.
Antipatrón: "el archivo se generó sin errores, así que el artefacto funciona." Que la generación tenga éxito no significa que el renderizado también lo tenga, y un fallo silencioso sin salida en consola es el más costoso de todos.
Patrones y antipatrones
Patrones que vale la pena robar:
- Ancla tus señales en cosas estables, nunca en clases CSS. El sitio es un build de Gatsby cuyos nombres de clase son hashes de contenido que rotan en cada despliegue. El parser se ancla solo en los códigos de ruta de la URL (
OD-ESS-DWW) y en el texto visible de las etiquetas ("Course Number"). Cambia el estilo y el parseo sigue funcionando; cambia una etiqueta, y reporta no medido en lugar de adivinar. - Separa el paso conectado a la red de la compuerta. Un solo comando toca internet. Todo lo demás lee una instantánea ya confirmada, así que el CI es offline, determinista, y nadie puede romperlo con un despliegue ajeno.
- Apunta, no bifurques. Los seis repositorios de Snowflake-Labs están registrados con SHAs fijos y una nota honesta sobre en qué falla cada uno. Dos están en cuarentena:
coco-skillsno publica ninguna licencia, ysubagent-cortex-codeGitHub no logra identificar la de este último. Sin licencia, se aplica el copyright de forma predeterminada: puedes enlazar y describir, no copiar. Eso lo impone una verificación, no la memoria.
Antipatrones en los que caí:
- Confiar en el texto literal de un enlace. Las páginas curadas de la ruta de aprendizaje enlazan slugs heredados como
uni-essdww101que redirigen (301) al canónicoOD-ESS-DWW. Comparar el slug literal produjo una secuencia de ruta vacía — no un error, sino una respuesta confiada, plausible y equivocada. Lo silenciosamente erróneo solo le gana a lo ruidosamente erróneo desde la perspectiva de quien lo publica. - Un porcentaje con un denominador sin examinar (ver: 21% vs 55%).
- Creer que un archivo generado funciona porque se generó.
Qué puedes hacer realmente con esto
Todo el sistema funciona sin conexión, usa solo la biblioteca estándar y está protegido por 43 pruebas. Tres comandos hacen el trabajo real:
$ pathfinder.py plan --role forward-deployed-engineer --free-only
PLAN · role:forward-deployed-engineer
  constraints: free_only
  24 courses · 37.75h · 24 free / 0 paid

1. Platform foundations & architecture  [core]  6h
   · OD-LVLUP-101     0.5h  FREE  Level Up: First Concepts  [title]
   ...
   order: Snowflake's published track order
...
HONEST EDGES
  · 5/38 mappings are curated (13%) — snowflake-os judgment, not published by Snowflake
  · --free-only excluded 12 paid course(s): ILT-DE, ILT-GENAI, ILT-NAF, ...
  · a plan predicts effort; only readiness.py scores completion
(En este artículo aparecen dos porcentajes curados distintos, así que para ser explícito sobre los denominadores: 22 de 71 es el total de mapeos en toda la base de conocimiento; 5 de 38 son solo los mapeos que tocó este plan de FDE en particular, de acceso gratuito. La compuerta de compilación aplica el límite máximo sobre el primer número, el global.)
El orden se basa ante todo en la evidencia: donde Snowflake publicó una secuencia (Insignia 1 → Insignia 6), ese orden prevalece. Donde no publicó ninguna, el mecanismo de respaldo prioriza lo más fácil y más corto, y el plan indica qué regla usó en cada paso. Luego readiness.py emite un veredicto de GO o NO-GO basado en evidencia verificada, y un flujo de trabajo los combina en un veredicto de dotación de personal donde un rechazo siempre incluye el camino más corto hacia el sí. Un "no" que no viene con una ruta es solo una opinión.
La parte que se generaliza
Casi nada de esto tiene que ver específicamente con Snowflake. Todo proveedor con un programa de certificación publica un menú y lo llama un camino. Toda organización que asigna personal según esas certificaciones está operando en el peldaño más bajo de Miller y reportándolo como si fuera el más alto. Las jugadas reutilizables:
- Clasifica tu evidencia. No es "¿lo completó?" sino "¿quién puede verificar que lo hizo?". La brecha entre esas dos preguntas es donde vive toda matriz de habilidades inflada.
- Publica tu columna de lo no medido. Las cuatro cosas que mi herramienta se niega a saber son más útiles que los 58 cursos que indexó, porque te dicen exactamente dónde debe detenerse tu confianza.
- Limita tu propio juicio y deja que una compilación falle por su causa. La curaduría es inevitable cuando la fuente original no publica nada. La curaduría sin etiquetar es solo una opinión disfrazada de esquema.
Snowflake escribió cuatro palabras honestas en una página de certificación: assumed but not tested (Traducción: se asume pero no se evalúa). La mayoría de las herramientas construidas sobre credenciales hacen lo contrario: no evalúan nada y lo asumen todo, y luego lo presentan como un porcentaje. Lo mínimo que puedes hacer es ser tan honesto como el examen contra el que estás midiendo.
Referencias
- Snowflake. SnowPro Advanced: MLOps Engineer — perfil del candidato. learn.snowflake.com/en/certifications/snowpro-advanced-mlopsengineer/ (consultado el 2026-08-03). Citado textualmente.
- Snowflake-Labs. mcp — MCP Server for Snowflake. github.com/Snowflake-Labs/mcp (Apache-2.0; consultado el 2026-08-03).
- Snowflake-Labs. cocoplus. github.com/Snowflake-Labs/cocoplus (MIT; consultado el 2026-08-03). Descripción del repositorio citada textualmente vía la API REST de GitHub.
- Snowflake-Labs. coco-skills — Agent Skills for Cortex Code. github.com/Snowflake-Labs/coco-skills (sin archivo de licencia al 2026-08-03).
- Snowflake. Snowflake-managed MCP server. docs.snowflake.com (consultado el 2026-08-03). Citado, no probado de forma independiente — no se puso a prueba ninguna cuenta de Snowflake.
- Miller, G. E. (1990). The assessment of clinical skills/competence/performance. Academic Medicine, 65(9 Suppl), S63–S67. doi:10.1097/00001888-199009000-00045. pubmed.ncbi.nlm.nih.gov/2400509/. De pago — descrito, no citado.
- Witheridge, A., Ferns, G., & Scott-Smith, W. (2019). Revisiting Miller's pyramid in medical education: the gap between traditional assessment and diagnostic reasoning. International Journal of Medical Education, 10, 191–192. pmc.ncbi.nlm.nih.gov/articles/PMC7246123/ (acceso abierto; usado para los cuatro niveles de la pirámide y su vigencia actual).
- Snowflake. Course catalogue y Hands-On Essentials track. learn.snowflake.com/en/courses/, /pages/hands-on-essentials-track/ (instantánea tomada el 2026-08-03; todos los conteos del catálogo en este artículo provienen de esa instantánea).
Nota de procedencia: cada cifra de este artículo (58 cursos, 430.25 h, 68.25 horas gratuitas, 12 exámenes de 19 páginas, 94 registros con procedencia, 22/71 mapeos curados, 43 pruebas) se calcula a partir de la instantánea comprometida descrita en [8], no es una estimación. Las dos citas textuales, [1] y [3], se verificaron palabra por palabra contra sus fuentes en vivo el 2026-08-03.
Más en la serie AI-Native
Todo esto vive en la sección Writing sección en la página de inicio.
Parte de la serie AI-Native. Los límites honestos de la herramienta están impresos en su propia salida, no escondidos en una nota al pie. Tú tienes el control del botón de Publicar.