AI-NATIVEシリーズ · CS229発・ワールドモデル特集(全1回) · 20歳編
CS229の6行で始めるワールドモデル――オオカミを見抜き、群れを守れ(20歳編)
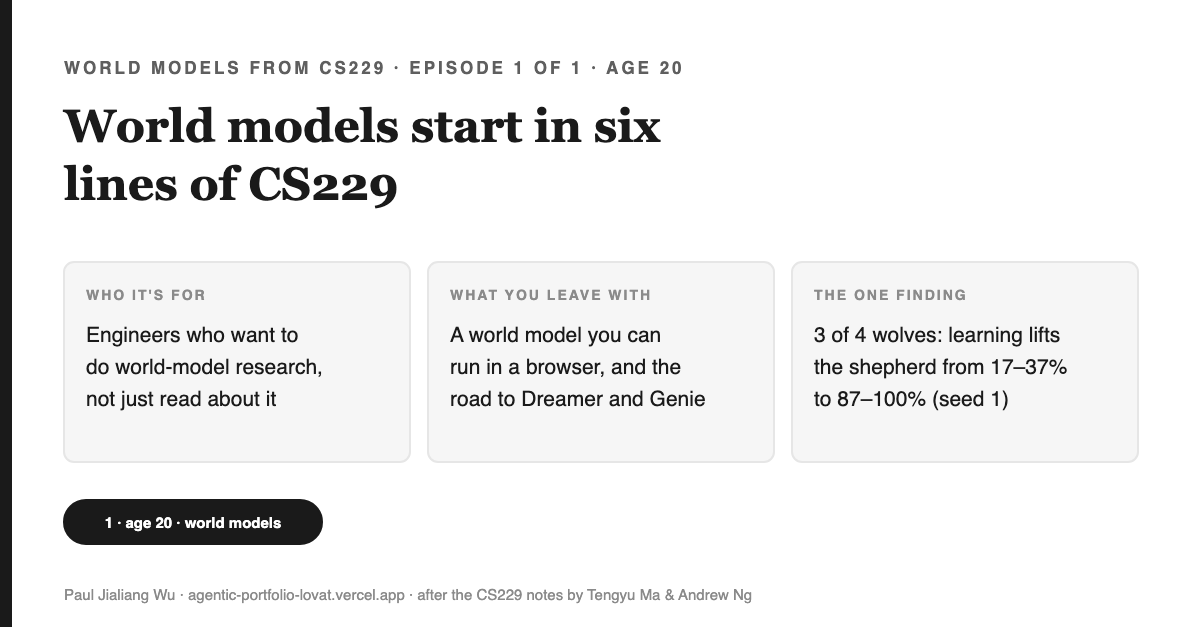
1分でわかる要点
このエッセイについて二十歳前後のエンジニア向けのエッセイとライブデモ。CS229の19.3節には、一晩で読み切れるほど小さなワールドモデルがある。世界の遷移を数えて動きを学び、学んだものをもとに価値反復で計画し、行動し、また繰り返す。デモでは羊飼いがオオカミの習性を見抜く。エッセイでは、このループのどの要素がKalmanフィルタ、Dyna、World Models、Dreamer、MuZero、Genieに受け継がれているかを整理している。
なぜ重要か多くの研究室が、ロボティクスやゲーム、物理AIがワールドモデルで動く未来に賭けているが、たいていの解説は110億パラメータ級の巨大モデルから話が始まる。だが、自分で動かせる6行から始めれば、後発の論文が実際に何を加えたのか、ワールドモデルに関する主張のどこがまだ未解決なのかが見えてくる。
読後にできること羊飼いデモをプレイして「学習しないベースライン」を上回り、狼の習性・割引率・経験量などどれか一つの前提を変えて何がどう崩れたかを確かめる。そのあと、子どもと一緒にファミリードリルをやり、羊飼いが何を学んだかを投稿する。
問いは一つだけだ。自分で作れて動かせて本当に理解できるほど小さなワールドモデルとは何か?それがどうDreamerやMuZero、Genieにつながっていくのか?
この記事はCS229全体を教えるものでも、ニューラルなワールドモデルを訓練するものでもない。19.3節の表を使ったモデルを作り、その先の系譜を地図のように示す。子ども向けのファミリードリルはShepherd's Academy of War, part 5.
このエッセイのテーマ:6行から世界モデルをはじめる
これはワールドモデルについてのエッセイだ。ワールドモデルとは、機械が自分の世界のふるまいを小さく学び取ってコピーし、行動の前に計画するために使うもの。単に読むだけでなく、自分で研究したい20歳前後のエンジニアのために書いた。必要なのはブラウザとPython、そして30分ほどの時間だけ。
多くの研究室が、ロボティクスやゲーム、物理AIはワールドモデルの上で動くと本気で考えている。NVIDIAのCosmosプラットフォームはこの点を端的に述べている。物理AIシステムには「a digital twin of the world, the world model」(訳:世界のデジタルツイン、すなわちワールドモデル)" (NVIDIA (2025), Cosmos World Foundation Model Platform for Physical AI, arXiv 2501.03575)。多くの解説は巨大なほう、つまり110億パラメータのビデオモデルから話を始める。この記事は逆に、Tengyu MaとAndrew NgによるStanford CS229講義ノートの6行という最小単位から出発する(Ma & Ng, CS229 Lecture Notes (Stanford, Spring 2026))。19.3節「MDPのモデル学習」には、その6行で完結するワールドモデルがある:観察し、数え、計画し、行動し、繰り返す。
このエッセイはplaybook-mathで作った。厳選した278枚ほどのノート(約30ページ)から抜き出している。それぞれについて「エンジニアをどれだけ研究に引き寄せるか」「ワールドモデルにどれだけ重要か」「家族で遊べるか」の3点で選んだ。
| CS229の該当セクション(印刷ページ) | 選んだ理由 |
|---|---|
| 19.1–19.3:MDP、価値反復、モデル学習(228–234ページ) | 世界モデルのループ全体が、ほんの数行に凝縮されている。そのままデモで動く。 |
| 19.4.2: モデルやシミュレータの利用(237–241) | データからs(t)とa(t)を使ってs(t+1)を学ぶ:最初の学習型シミュレータ |
| 20.4: LQG、LQR付きカルマンフィルタ(254–257) | 状態が見えないとき、信念にもとづいて行動する |
| 11.5: 変分推論とVAE(162–166) | ニューラル世界モデルの中核となる圧縮エンジン |
| 8.2: ダブルディセント(123–127) | 「測定が理論を覆す」ことを最も鮮やかに描いたエピソード |
このエッセイの実演は、Shepherd's World Model——羊飼いがオオカミの秘密の習性を見抜き、2つの群れを守るための無料ページだ。絵はShepherd's Academy of War(家族で「攻撃の仕組み」を学び、守る力を身につけるためのアカデミー)から来ている。オオカミはあくまで動物であり、人間が敵という話ではない。
ここから先を読む前に。 最後には7〜11歳の子どもと一緒に羊飼いデモを動かし、オオカミの動きを予想してもらうことになる。自分がこのループを子どもに説明する立場だと思って読んでほしい。メタ分析によれば、39 件の研究で「教えるつもりで学習し、その後教える」場合の効果量はg = 0.48(サブグループの結果)で、「教えるつもりなし」で教えた場合は有意な効果は見られなかった(g = −0.02) (Kobayashi(2024)、Educational Psychology Review(ERIC EJ1414484)).
アクティビティ1:まず羊飼いの作戦を自分で考える
紙に8×8のフィールドを描き、各下隅に群れを置き、その間に羊飼いを配置する。オオカミは上段から現れ、羊飼いが1マス動くごとに2マス進む。ただし、その習性は羊飼いには知らされていない。
この先を読む前に、「何も知らない羊飼いがどうやって上達するか」を自分なりに考えてみてほしい。毎晩何を記録すればいいのか?どこに立つべきか、どう決めるべきか?
多くの人がたどり着く答えは同じだ:各地点からオオカミがどこへ行ったかを記録し、その記録が示す方向に立つ。それがまさにCS229の手法である。記録が世界モデルであり、その指し示す場所に立つのが計画だ。Kenneth Craikは1943年、「心はこう動くのでは」と考えた。つまり、生物は「small-scale model」を現実の中に持ち、行動前に選択肢を試せる(訳:Craik(1943)、The Nature of Explanation、Quanta Magazine(2025)による引用))——彼の着想はあくまでアイデアであり、アルゴリズムではなかった。そのアルゴリズムを書き下したのが、CS229の19.3節である。
この6行
CS229の19.3節はマルコフ決定過程(MDP)から始まる。状態、行動、報酬、そして各行動がどこへ導くかを示す遷移確率だ。たいてい、その確率は最初から与えられていない。経験から推定する必要があり、ノートではその推定値を比率(式19.5)で表している。各遷移確率、つまり状態sで行動aを取ったあとs′に移る確率は、それが実際に起きた回数を「#times we took action a in state s" (Ma & Ng, CS229 Lecture Notes, eq. 19.5 (p. 233))で割ったものだ。一度も試していない組み合わせには、一様な推定値を割り当てる。
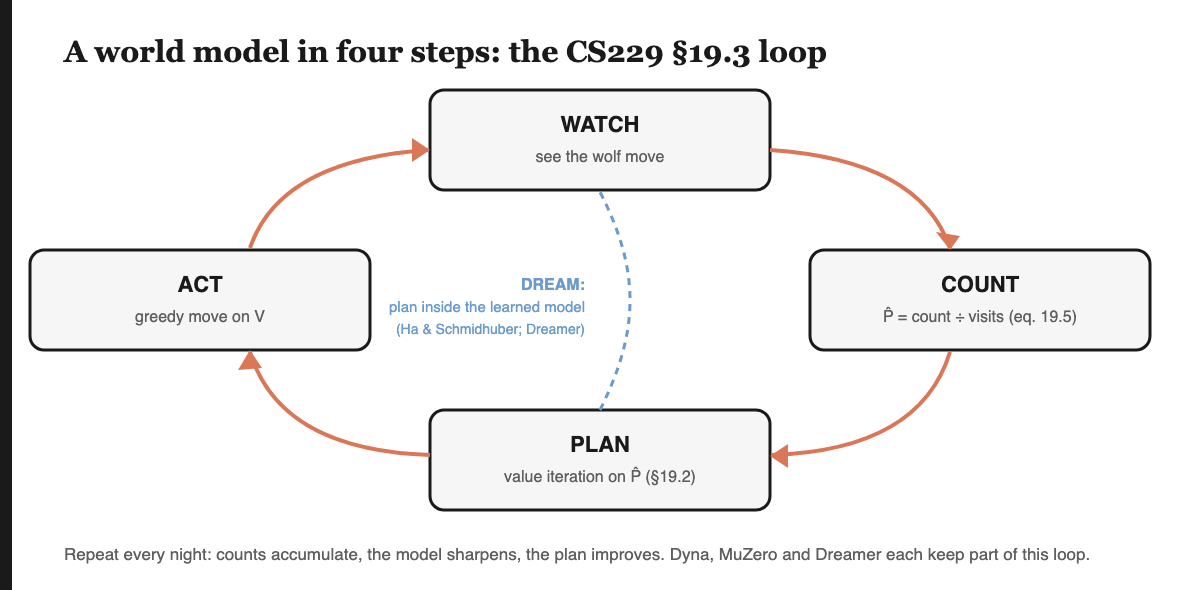
さらにノートは、学習と計画を数行のループとしてまとめている:
- どの方策から始めてもよい。
- 繰り返す:- (a) いくつか試行して実行する; - (b) 遷移回数を更新する; - (c) 推定モデルで価値反復を回す; - (d) 新しい価値に基づいて最善手を選ぶ方策に切り替える。
ステップ(c)が計画の部分なので、ここで明示しておく。状態の価値 V(s)は、その状態から先に期待できる報酬の合計だ。価値反復では、数値が収束するまで同じ更新を繰り返す(§19.2):V(s) ← R(s) + γ・(全行動aについて最大値)Σ(次状態s′について)P̂_sa(s′)・V(s′)。ここでγ(デモでは0.95)は将来の価値を割り引く。方策とは、各状態でどの行動を選ぶかを決めるルールであり、最善手方策は、価値が最大となる行動だけを選ぶ。1日目、何も知らない羊飼いは、オオカミの動きがすべて等確率だと信じているので、すべてのマスを均等に守る。つまり、どこも守れていない。
これが世界モデルの全体像だ。世界モデルとは、世界のふるまいを観察から学び、行動前の計画に使う、小さなコピーである。このモデルには「何が起きたか」の記憶(カウント)があり、その記憶から作られたモデル(比率)があり、そして行動前にモデルを使うプランナー(価値反復)がある。
アクティビティ2 羊飼いがどう学ぶか観察しよう
以下を開く:Shepherd's World Model with seed 1。リバー・スニークを選び、「Learn 30 nights」を2回押して、それぞれのスコアを記録する。その後、エンジニアモードに切り替え、オオカミがいるセルについて、学習済みテーブルと真のテーブルを比較する。
次にワンダラーを選んで同じことを行う。羊飼いがどの習性から最も多く学んだかを書き出し、なぜそうなったかを読む前に推測してみよう。
このデモは、CS229ループを2つの明示的な単純化を加えて実行している。学習されるのはオオカミの動きだけで、報酬や羊飼い自身の動きは与えられている。また、オオカミが一度も訪れたことのないセルには、全64マスではなく、オオカミが合法的に移動できる範囲で均等な推定値を与える。オオカミのすべての一歩をカウントし、羊飼いとオオカミの全組み合わせ(64×64=4,096状態)で価値反復を回し、最善手で動く。オオカミは1ターンで2マス進むので、追いかけても追いつけない。羊飼いはオオカミが向かう先にいなければならず、それを知るにはモデルが必要だ。
シード1で、まったく学習しない羊飼いは「すべての動きが等確率」と仮定して、永遠に同じ計画を繰り返す。ここでは、学習する羊飼いと、60夜のうち最後の30夜でどう違うかを示す。これは2回目のボタン押下、つまり60夜後のスコアから30夜後のスコアを引き、それを30で割った値だ(計算済み。シード1でページを開けば再現できる)。
| オオカミの習性 | 学習しない | 学習する |
|---|---|---|
| 川沿いの忍び寄り(左側面) | 22%が反転 | 100% |
| 尾根走り(右側面) | 17% | 87% |
| 直進ランナー(最寄りの群れ) | 37% | 93% |
| さまよい型(ほぼランダム) | 88% | 93% |
この最後の行こそが、レッスンの中のレッスンだ。さまよい型にはほとんど学ぶべき習性がないので、ワールドモデルが付け加えられるものもほとんどない。学習する羊飼いも、すべてのオオカミの動きが等確率だと仮定して一度も更新しない羊飼いと、ほぼ同じ成績になる(93%対88%)。学習は、オオカミが持っていないパターンを生み出すことはできない。ワールドモデルは、それが写し取る世界の構造がある分だけしか役に立たない。この一文は、研究人生に値する。私の見立てでは、大規模モデルが「ワールドモデルを持つかどうか」をめぐる議論の多くは、実際には「その訓練データがどれだけ構造を強制したか」をめぐる議論だ。これは私見であって、結論ではない。
次の段階へ:6行からワールドファウンデーションモデルへ
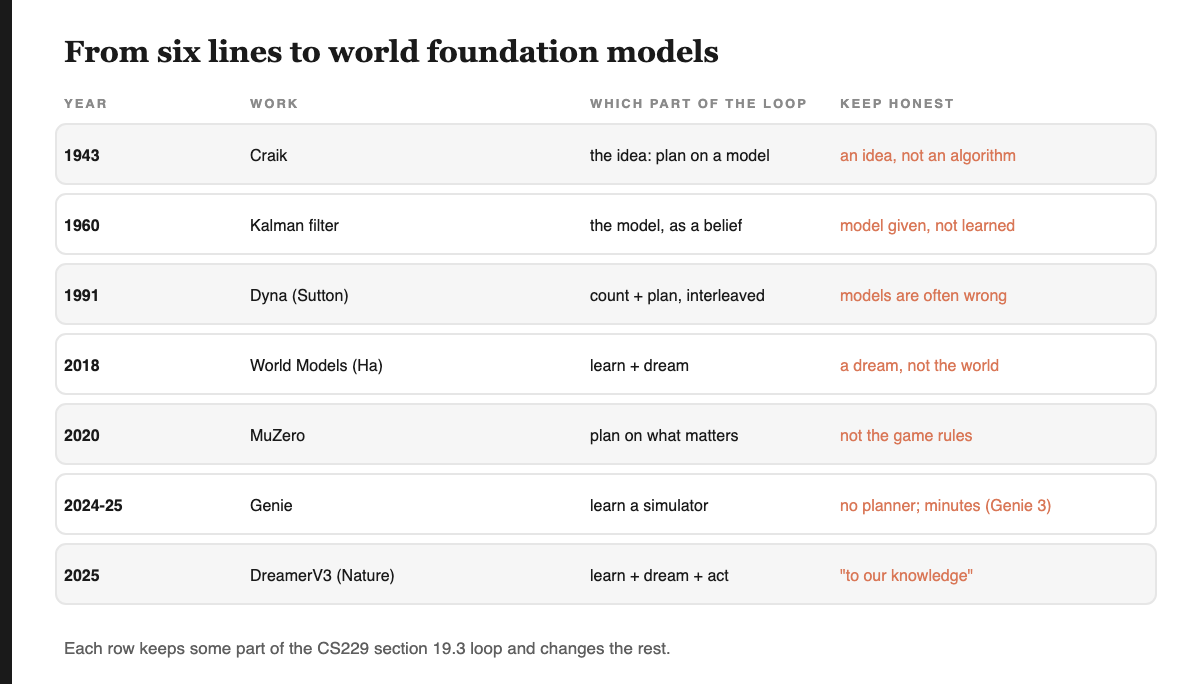
後続の研究は、このループのいくつかの要素を残し、他を変えている。Kalmanのフィルタはモデルが与えられていると仮定し、何も学習しない。Genieはシミュレータを学習するが、計画はしない。MuZeroは計画に必要な部分だけを学習する。どの手法がどの部分を残し、どんな注意点を持つかは表にまとめてある。
位置ではなく「信念」で考える。
- 羊飼いはオオカミを直接見ることができるが、ほとんどのロボットはそうではなく、ノイズだらけの手がかりしか得られない。
- CS229の20.4節(LQG)はこの問題を扱っている。Kalmanフィルタで隠れた状態についての信念を維持し、LQRで制御する。Kalmanの1960 論文はこの深い関係を一文で表現している:「The filtering problem is shown to be the dual of the noise-free regulator problem.(訳:フィルタリング問題は、ノイズのないレギュレータ問題の双対であることが示される。)" (Kalman (1960), A New Approach to Linear Filtering and Prediction Problems, J. Basic Eng. 82).
- 推定と行動は、実は鏡合わせの関係にある。こうした驚きが、人を研究者にする。
学習と計画を交互に織り交ぜる。
- SuttonのDyna(1991)は、このループをアーキテクチャとして実装したもので、これらのノートより何十年も前に提案されている。彼の言葉を借りれば:Planning is incremental and can use the probabilistic and ofttimes incorrect world models generated by learning processes.(訳:計画は漸進的であり、学習過程で生成された確率的かつしばしば誤ったワールドモデルを利用できる。)" (Sutton (1991), Dyna, ACM SIGART Bulletin 2).
- 「Ofttimes incorrect(しばしば間違っている)」――これがこの分野の正直な本質だ。羊飼いの初期のテーブルも例外ではない。
モデルの中で「夢」を見る。
- HaとSchmidhuber(2018)はテーブルをニューラルネットワークに置き換え、こう書いている:「We can even train our agent entirely inside of its own hallucinated dream generated by its world model, and transfer this policy back into the actual environment.(訳:エージェントを、その世界モデルが生み出した幻の夢の中だけで完全に訓練し、その方策を現実の環境に戻すことさえできる。)" (Ha & Schmidhuber (2018), World Models, arXiv 1803.10122).
- デモでやっている価値反復はまさにこれだ。羊飼いは自分で作った狼モデルの中でプランを練る。dreamボタンは、羊飼いが「こう動くだろう」と思い描いた夜の一例を見せているにすぎない。灰色の狼は羊飼いがthinks通りに動く。夢の精度はモデル次第で、羊飼いの初期の夢はたいてい外れる。
計画に必要な部分だけを学ぶ。
- MuZero(2020) "learns an iterable model that produces predictions relevant to planning(訳:計画に必要な予測を生み出す反復可能なモデルを学習する)" (Schrittwieser et al. (2020), MuZero, Nature 588):学ぶのは方策・価値・報酬だけで、世界の全体像そのものではない。
- チェスのルールそのものを学んだわけではなく、勝つために必要なことだけを学んだ。
一つのレシピで多様な領域を横断する。
- DreamerV3はNature誌で2025に発表され、まったく異なるタスクにも同じワールドモデルのレシピを適用した。「to our knowledge」人間のデータやカリキュラムなしでMinecraftでダイヤモンドを集めた初のアルゴリズムとされている(Hafner et al. (2025), Mastering diverse control tasks through world models, Nature 640).
- 繰り返すときは必ず但し書き(hedge)を添えること。
基盤ワールドモデル。
- Google DeepMindのGenieは「11B」個のパラメータを持ち、著者らはこれをファウンデーション・ワールドモデルと呼んでいる(Bruce et al. (2024), Genie, arXiv 2402.15391).
- Genie 3はリアルタイムで「数分間」だけ一貫性を保つ(Google DeepMind (2025), Genie 3 blog)。永続的ではない。
- OpenAIはビデオ生成を「a promising path towards building general purpose simulators of the physical world(訳:物理世界の汎用シミュレータを構築するための有望な道筋)" (OpenAI (2024), Video generation models as world simulators, abstract as given on the MIT CSAIL seminar page)」と位置付けている。これはあくまで研究上の賭けであり、実証されたワールドシミュレータではないし、ビデオモデル自体が何か行動するわけでもない。
CS229のノートには、こうした巨大モデルの中核となる2つのエンジンも載っている:
- 変分オートエンコーダ(11.5節;Kingma and Welling, arXiv 1312.6114, Kingma & Welling (2013), Auto-Encoding Variational Bayes)。これはエージェントが見たものを小さなコードに圧縮する役割だ。
- 拡散モデル(14節;Ho, Jain and Abbeel, arXiv 2006.11239, Ho, Jain & Abbeel (2020), Denoising Diffusion Probabilistic Models)。こちらはビデオワールドシミュレータのフレームを生成する。
これらは次のステップであって、今いる段階ではない。
アクティビティ3 カウント部分を自分で書き、最後まで仕上げよう
7マスの廊下を狼が羊に向かって進む状況で、学習者を書いてみよう。狼の習性は隠しておく。遷移をカウント(式19.5)、学習した確率を出力し、そのモデルを使って羊飼いが狼に追いつかれるまで何手あるか推定する。下のバージョンと比べてみてほしい。
import random
random.seed(1)
N, SHEEP = 7, 6                       # a corridor of 7 cells; the sheep are in the last one
def wolf_step(w):                     # the TRUE habit, hidden from the shepherd
    return min(w + 1, SHEEP) if random.random() > 0.2 else max(w - 1, 0)
counts = [[0] * N for _ in range(N)]  # counts[w][w2]: how often the wolf went from w to w2
visits = [0] * N
def p_hat(w, w2):                     # CS229 eq. 19.5; never seen -> uniform over the wolf's moves
    if visits[w] == 0:
        return 0.5 if abs(w2 - w) == 1 or (w in (0, SHEEP) and w2 == w) else 0.0
    return counts[w][w2] / visits[w]
for night in range(200):              # watch the wolf and count
    w = 0
    while w != SHEEP:
        w2 = wolf_step(w)
        counts[w][w2] += 1
        visits[w] += 1
        w = w2
for w in range(SHEEP):
    print(w, "-> forward", round(p_hat(w, w + 1), 2), " back", round(p_hat(w, max(w - 1, 0)), 2))
E = [0.0] * N                         # plan: how many steps until the wolf reaches the sheep? (the shepherd's deadline)
for _ in range(500):                  # value iteration on expected steps-to-sheep under P-hat
    E = [0.0 if w == SHEEP else 1 + sum(p_hat(w, w2) * E[w2] for w2 in range(N)) for w in range(N)]
print("expected steps for the wolf to reach the sheep from cell 0:", round(E[0], 2))
学習した前進確率は0.77〜0.84(真値は0.8)、最初のマスから期待される手数は9.32(seed 1で計算)。何をしているかをはっきりさせておこう。カウントはCS229の式19.5。最後のループは学習した連鎖を評価するだけで、そこに選択肢はない。羊飼いに行動(その場に留まる、狼に近づく)を与え、毎回最善を選ばせれば、それがバリューイテレーションになる——これが演習であり、デモのエンジンだ。次は、あえて壊してみる:
- 0.2を0.5に変える;
- 200夜ではなく5夜だけ試してみる;
- 狼の習性を夜ごとに変えてみる。
こうした変更は、どれも本物の研究課題の縮図である。ワールドモデルにはどれだけのデータが必要なのか?世界が変化したとき、何が起きるのか?間違ったモデルで計画すると、どんな代償を払うことになるのか?
なぜここから研究が始まるのか
CS229で研究を志す人間にとって、最も心を動かすページは実はワールドモデルそのものではない。8.2節「ダブルディセント」だ。何十年も教科書は「ある点を超えるとモデルが大きくなりすぎて過学習し、テスト誤差が増える」と描いてきた。だが、さらに先まで測ってみると、まったく逆の現象が現れた。Belkinらはこう報告している:「increasing model capacity beyond the point of interpolation results in improved performance(訳:補間点を超えてモデル容量を増やすと、性能が向上する)" (Belkin, Hsu, Ma & Mandal (2019), Reconciling modern machine-learning practice and the classical bias-variance trade-off, PNAS 116 (arXiv 1812.11118)」。Nakkiranらは続く論文のタイトルでこう述べている:Deep Double Descent: Where Bigger Models and More Data Hurt(訳:より大きなモデルとより多くのデータが害になる場所) (Nakkiran et al. (2019), Deep Double Descent, arXiv 1912.02292)。なぜなら、データを増やすことで一時的に性能が悪化することすらあるからだ。
これこそが研究の原点だ。動かして、測って、驚いて、理論を作り直す。羊飼いのデモは今夜でも試せるほど小さい。上で述べたwanderer行は、すでに説明する価値のある驚きだ。
同じ物語、五つの出口
| あなたは…… | これで変わる決断 | 今週やるべき一つの行動 |
|---|---|---|
| 学生 | ワールドモデルが今すぐ自分で始められるテーマかどうか | Pythonでカウント部分を書き、最後まで仕上げ、仮定を一つ変えて何がどう壊れたかを書き出す |
| エンジニア | 自分のシステムに学習済みモデルが必要なのか、もっとデータが必要なのか | 自分のエージェントの世界にモデルで捉えられる構造があるかどうか尋ねる(wandererテスト) |
| 創業者 | ピッチで「world model」と言うとき、それはプランナーなのか、シミュレーターなのか、それともビデオジェネレーターなのか | そのプロダクトがCS229ループのどの工程を実際に動かしているのかを尋ねよ |
| 経営層 | world modelに関する主張に、きちんと測定に基づく裏付けがあるかどうか | 一度も学習しないベースラインと、その差分を確認せよ |
| 投資家 | world model企業の「堀」がモデルそのものなのか、それともデータなのか | 世界が変化したとき、モデルをどのように修正しているかを尋ねよ |
このエッセイにおける真実・愛・美
- 真実: すべての数値は再現できる。デモはシード付き、コードは結果を出力し、有名論文の主張には必ず「to our knowledge」「a few minutes」「a promising path」などの但し書きが付く。
- 愛: このエッセイは、子どもに教える機会と家族ドリルを手渡す。world modelについての「半分正しい」信念には、その正しさをきちんと認めて応える。
- 美: たった6行に全体のアイデアが詰まっている。後のworld modelは、そのうちのいくつかの行を受け継ぎ、テーブルを何十億倍ものネットワークに置き換えていく。
ここで使っているレンズは私自身のものであり、それは明示している。Shepherd's Academy of Warのイメージは、ダビデがサウルに語った報告から取っている。「あなたのしもべは父の羊を飼っていました。そこへライオンや熊が来て群れから子羊を奪うと、私は追いかけてそれを打ち、口から救い出しました……」(サムエル記第一 17:34–35)。捕食者の習性を学び、群れを守る羊飼いは、私の信仰では「宿題をする愛」の象徴である。ただし、上記のチェックリストはこの信念がなくても成立する。
半分だけ正しい誤解
- 「world modelはビデオジェネレーターだ」 一部のworld modelはビデオを生成するが、CS229のものはカウントのテーブルとプランナーである。決定的なのは「学習したモデルで計画すること」であって、映像ではない。
- 「大きいworld modelほど必ず役立つ」 世界に捉えるべき構造がある場合のみだ。wanderer行がその小さな証拠だ:学ばなかった羊飼いでも88%のスコアを出したことを思い出せ。
- 「MuZeroはゲームを学習した」 MuZeroが学んだのは「計画に必要なもの」(方策・価値・報酬)であり、それはより少なく、より賢い。
さあ、教えてみよう
教え返しの時間だ。 7歳から11歳の子どもと一緒に座り、Shepherd's World Modelをキッズモードで開く。子どもに狼の秘密の習性を(あなたに隠したまま)選ばせ、一緒に「Watch one night」を何度か押す。毎晩の前に「狼はどこへ行くと思う?」「羊飼いはどこに立つべき?」と子どもに尋ねる。10夜が終わったら、羊飼いが何を学んだかを聞く。この形式はShepherd's Academy of War, part 5.
成果: 子どもが羊飼いが動く前に狼の次の動きを予想でき、羊飼いが何を学んだかを一文で言える(例:「狼は川沿いにこっそり下りてくる」など)。その子の年齢とその一文をこの記事のコメント欄に投稿してほしい。それはShepherd's Academy of Warのsignal ledgerでshepherd-demo drillとして記録され、SAWの毎週の車内ドリルとは別カウントになる。
なぜ重要か:5つの「なぜ」
課題:エンジニアがワールドモデルに取り組みたいが、主要論文のほとんどが数十億パラメータ規模から話を始めるため、どこから手を付ければいいのかわからない。
- なぜ主要論文は最初から巨大なモデルを扱うのか? 主な成果がスケールで語られるからだ。たとえばGenieの11B パラメータ(Bruce et al. (2024), Genie, arXiv 2402.15391)、Nature掲載のDreamerV3(Hafner et al. (2025), Mastering diverse control tasks through world models, Nature 640).
- なぜ巨大なモデルから始めると理解が妨げられるのか? 規模が大きすぎると、どの部分が本当に仕事をしているのか(モデルか、プランナーか、データか)が見えなくなる。
- なぜか? それぞれの要素が一つのネットワークに絡み合っているからだ。CS229のループでは、それぞれが独立した行になっていて、一つずつ切り替えて確かめることができる(Ma & Ng, CS229 Lecture Notes, eq. 19.5 (p. 233)).
- なぜ部分ごとに切り替えることが大事なのか? それによって何が本当に効いているのかが分かる。学習しないベースラインやwanderer行はまさにそのための実験だし、Dynaも正直にこう釘を刺している:「learned models are 'ofttimes incorrect'」(訳:学習されたモデルはしばしば間違っている)(Sutton (1991), Dyna, ACM SIGART Bulletin 2).
- 根本原因: ワールドモデルはトップダウンで教えられている。その処方箋は、小さくて完結したモデルを自分で作り、ベースラインと比べ、わざと壊してみて、各ステップで何が加わったかを確かめながら系譜を登ることだ。
実践編:今週やること
- まず「教える前提で読む」ポイントを確認せよ。
- 紙に羊飼いの作戦を描いてみよ(アクティビティ1、5分)。
- 「Shepherd's World Model」で4つの狼の習性すべてを試し、自分で表を埋める(10分)。
- Pythonでカウント部分を書き、羊飼いの行動も加えて完成させ、さらに意図的にどこかの前提を壊してみる(15分)。
- 子どもと家族ドリルを実践し、その結果を投稿せよ。
フィードバック:できたかどうかの目安
- CS229の19.3節ループを4つのステップで暗唱できる。
- wandererの行がほとんど改善しない理由を説明できる。
- コードの仮定を1つ変えて、何が壊れたか・なぜかを説明できる。
シミュレーション型学習は高等教育で強い実証がある:g = 0.85 件の145 研究で(Chernikova et al. (2020), Simulation-based learning in higher education, Review of Educational Research 90)。これはシミュレーションを使う大学生向けの話であり、子どもや自作の場合には当てはまらない。だから家族ドリルは「約束」ではなく「テスト」として扱うべきだ。幼児が自分の世界の因果地図を作るという研究もある:「2~4歳児は新しい因果地図を構築する" (Gopnik et al. (2004), A theory of causal learning in children, Psychological Review 111)。このドリルは、狼の動きを予測する場面でそれが現れるかを問う。
フィードフォワード:今決めておくトリップワイヤー
- 学習済みモデルがベースラインとの差でseed間ノイズを超えないなら、まだ何も学んでいない。 結果を主張する前に必ず複数のseedで試し、「一度も学習しない羊飼い」がすでに勝っていないかを常に確認せよ。
- 何かをworld modelと呼ぶなら、どの行を実際に動かしているか明示せよ。カウント、計画、夢想、動画生成はそれぞれ別の主張である。
- 有名な研究成果が引用されていても、元論文の留保(ヘッジ)が省かれていた場合は必ず元通りに補うこと(例:「to our knowledge」「a few minutes」など)
5S自己評価
| S | 主張 | 根拠 |
|---|---|---|
| シンプル | 本文はFlesch–Kincaidグレード13以下の読みやすさで書かれている。 | 本文のFlesch–Kincaidグレード:7.3(バンド ≤ 13)、再計算元:node scripts/check-numbers-four-ages.mjs --series world-models-cs229 |
| 堅実 | 引用された主張はすべて出典付きでヘッジも明記。デモの数値はseed 1で必ず再現できる。 | DreamerV3「to our knowledge" (Nature); シード付きデモ |
| 鋭さ | 世界モデルは、その世界にどれだけ構造があるかによってしか役に立たない。6行にその全ループが詰まっている。 | wanderer行 · 6行 |
| SMART | 今週:4つの習性、1つ壊した仮定、1つ家族ドリル。 | 実行 |
| 驚き | ほぼランダムな狼こそ、羊飼いが最も学びにくい相手であり、それ自体が教訓である。 | アクティビティ2 |
| 真実・愛・美しさ | シードで再現できる真実、子どもに教える体験、そして拡張性を持つ6行。 | 真実、愛、美しさ |
参考文献
- Ma, T. & Ng, A. CS229 Lecture Notes(スタンフォード大学 2026年春、セクション19.3, pp.232–234; 20.4; 11.5; 14; 8.2)cs229.stanford.edu
- Craik, K. (1943). The Nature of Explanation(Quanta Magazine(2025)で引用)quantamagazine.org
- Kalman, R. E. (1960). A New Approach to Linear Filtering and Prediction Problems. J. Basic Eng. 82. Crossref
- Sutton, R. S. (1991). Dyna. ACM SIGART Bulletin 2. OpenAlex
- Ha, D. & Schmidhuber, J. (2018). World Models. arXiv:1803.10122
- Schrittwieser, J. et al. (2020). MuZero. Nature 588. nature.com
- Hafner, D. ほか (2025). Mastering diverse control tasks through world models. Nature 640. nature.com
- Bruce, J. ほか (2024). Genie: Generative Interactive Environments. arXiv:2402.15391
- Google DeepMind (2025). Genie 3. deepmind.google
- NVIDIA (2025). Cosmos World Foundation Model Platform for Physical AI. arXiv:2501.03575
- OpenAI (2024). Video generation models as world simulators (abstract via MIT CSAIL). csail.mit.edu
- Kingma, D. P. & Welling, M. (2013). Auto-Encoding Variational Bayes. arXiv:1312.6114
- Ho, J., Jain, A. & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. arXiv:2006.11239
- Belkin, M., Hsu, D., Ma, S. & Mandal, S. (2019). Reconciling modern machine-learning practice and the classical bias–variance trade-off. arXiv:1812.11118
- Nakkiran, P. ほか (2019). Deep Double Descent. arXiv:1912.02292
- Chernikova, O. ほか (2020). Simulation-based learning in higher education. Review of Educational Research 90. doi:10.3102/0034654320933544
- Gopnik, A. ほか (2004). A theory of causal learning in children. Psychological Review 111. PubMed
- Kobayashi, K. (2024). Interactive learning effects of preparing to teach and teaching. Educational Psychology Review. ERIC EJ1414484
- サムエル記上 17:34–36bible-api.com