AI-NATIVE 시리즈 · CS229에서 출발하는 월드 모델, 1화(완결) · 20세
CS229 여섯 줄에서 시작하는 월드 모델: 늑대를 배우고, 양떼를 지키는 법 (20세를 위한 버전)
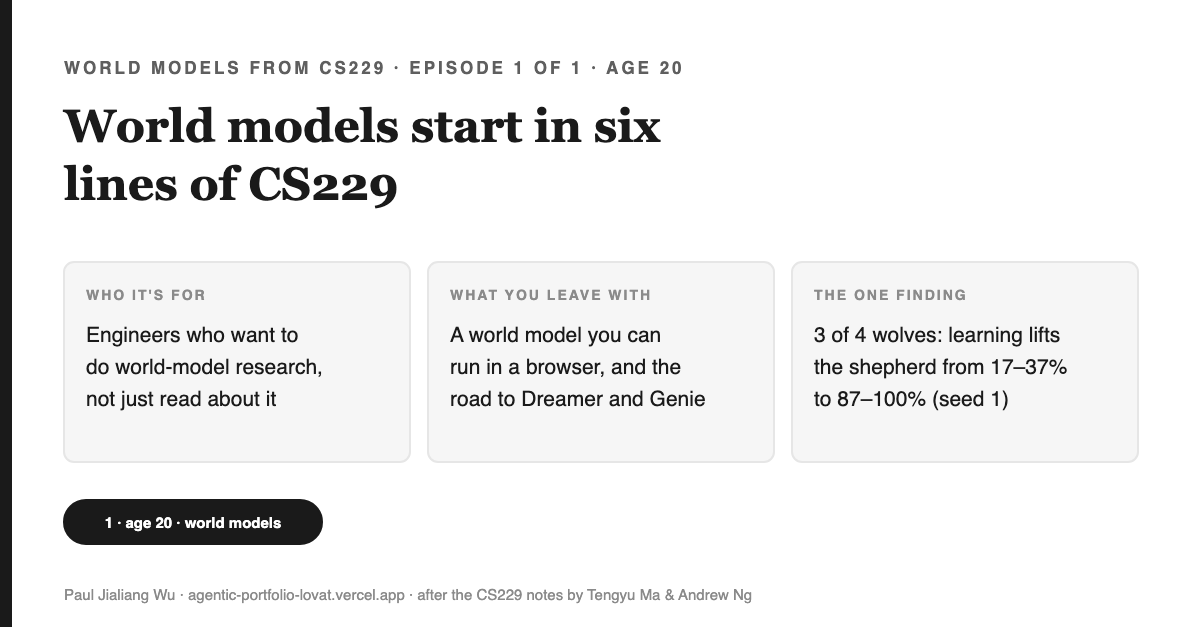
1분 요약
이 글의 정체성스무 살 무렵의 엔지니어를 위한 에세이이자 실시간 데모다. CS229 19.3절에는 한 번에 읽을 수 있을 만큼 작은 완전한 세계 모델이 들어 있다. 세상의 변화를 관찰해 기록하고, 그 기록으로 가치 반복(value iteration)으로 계획을 세우고, 행동하며, 다시 반복한다. 데모에서는 양치기가 늑대의 습관을 익히고, 글에서는 이 동일한 루프의 어떤 부분이 Kalman 필터링, Dyna, World Models, Dreamer, MuZero, Genie에 남아 있는지 지도로 짚는다.
왜 중요한가많은 연구실이 로보틱스, 게임, 물리적 AI가 world model 위에서 작동할 것이라 베팅한다. 대부분의 설명은 11-billion-parameter짜리 대형 모델에서 출발한다. 하지만 직접 실행 가능한 여섯 줄에서 시작하면, 이후 논문들이 실제로 무엇을 더했는지, 그리고 월드 모델에 관한 주장 중 아직 열려 있는 것이 무엇인지 명확히 볼 수 있다.
이 글을 읽고 나서 할 수 있는 것양치기 데모를 실행하여 학습하지 않는 기준선보다 더 나은 성과를 내라. 그리고 늑대의 습관, 할인율, 경험량 등 한 가지 가정을 바꿔서 무엇이 달라졌는지 기록하라. 마지막으로 아이와 함께 가족 연습을 진행하고, 양치기가 무엇을 배웠는지 정리해 올려라.
World Models from CS229 — 시리즈 줄기
▶ 실제로 돌아가는 모습 보기: 라이브 데모 열기 공개 · 로그인 불필요
- 월드 모델의 출발점은 CS229 §19.3이다 이번 화
핵심 질문은 이것이다. 직접 만들고 실행하며 이해할 수 있을 만큼 작은 월드 모델이란 무엇이며, 그것이 어떻게 Dreamer, MuZero, Genie로 이어지는가?
이 글은 CS229 전체 강의를 가르치거나 신경망 기반 월드 모델을 훈련하지 않는다. 19.3절의 표 기반 모델을 구현하고, 그 위로 이어지는 계보를 짚는다. 아이들에게 건네는 가족 연습은 Shepherd's Academy of War, part 5.
이 글의 주제: 여섯 줄에서 시작하는 월드 모델
이 글은 월드 모델에 관한 글이다. 월드 모델이란, 기계가 세계의 동작 방식을 관찰해 작게 배운 복사본을 만들어, 행동 전에 계획에 활용하는 것이다. 월드 모델 연구를 단순히 읽는 데 그치지 않고 직접 해보고 싶은 스무 살 즈음의 엔지니어를 위해 썼다. 브라우저와 Python, 그리고 약 30분이면 충분하다.
여러 연구실이 로보틱스, 게임, 물리적 AI가 월드 모델 위에서 작동할 것이라 베팅하고 있다. NVIDIA의 Cosmos 플랫폼은 이렇게 단언한다. 물리적 AI 시스템에는 "세계의 디지털 트윈, 즉 월드 모델" (NVIDIA (2025), Cosmos World Foundation Model Platform for Physical AI, arXiv 2501.03575"이 필요하다. 대부분의 설명은 11-billion-parameter 비디오 모델처럼 거대한 쪽에서 시작한다. 이 글은 Stanford CS229 강의노트(저자 Tengyu Ma, Andrew Ng)의 여섯 줄에서 출발한다 (Ma & Ng, CS229 Lecture Notes (Stanford, Spring 2026)). 19.3절 "MDP의 모델 학습"에는 여섯 줄로 완결된 월드 모델이 담겨 있다. 관찰하고, 세고, 계획하고, 행동하고, 다시 반복한다.
이 글은 playbook-math로 만들었다. 약 30쪽 분량의 노트에서 엄선한 일부를 뽑았다.278각 쪽은 세 가지 기준으로 평가했다. 엔지니어를 연구로 이끄는 힘, 월드 모델에서의 중요성, 그리고 가족이 함께 실습할 수 있는지다.
| CS229 절 (인쇄 쪽수) | 선정 이유 |
|---|---|
| 19.1–19.3: MDP, 가치 반복, 모델 학습 (228–234) | 몇 줄로 구현되는 월드 모델 전체 루프—이 데모가 바로 그것을 실행한다. |
| 19.4.2: 모델 또는 시뮬레이터 활용 (237–241) | 데이터로부터 s(t), a(t)에서 s(t+1)을 학습한다: 최초의 학습 기반 시뮬레이터. |
| 20.4: LQG, LQR이 결합된 Kalman 필터 (254–257) | 상태를 직접 볼 수 없을 때, 신념에 기반해 행동하기. |
| 11.5: 변분 추론과 VAE (162–166) | 신경망 기반 월드 모델 내부의 압축 엔진. |
| 8.2: double descent (123–127) | 측정이 이론을 뒤집는 과정을 가장 명확하게 보여주는 노트의 사례. |
이 글의 실험적 기반은 바로 Shepherd's World Model이다. 목자가 늑대의 비밀 습관을 배워 두 무리를 지키는 무료 체험 페이지다. 이 그림은 Shepherd's Academy of War에서 가져왔다. 이 가족 아카데미에서는 아이들이 공격의 원리를 배워 스스로를 보호하는 법을 익힌다. 늑대는 동물일 뿐, 그 누구도 적으로 삼지 않는다.
이제 다음을 읽기 전에 생각해 볼 것이 있다. 7세에서 11세 사이의 아이와 함께 Shepherd 데모를 실행하고, 늑대의 다음 행동을 예측하게 하는 것으로 이 글의 실습이 끝난다. 이 루프를 쉽게 설명해야 할 사람이라는 마음으로 읽어야 한다. 메타분석 결과, 39 개의 연구에서 '가르칠 준비를 하며 공부한 뒤 실제로 가르칠 때' 효과 크기는 g = 0.48 (하위 집단 결과)였으나, 그런 기대 없이 가르칠 때는 유의미한 효과가 없었다(g = −0.02) (Kobayashi (2024), Educational Psychology Review (ERIC EJ1414484)).
활동 1 · 먼저 목자의 방법을 직접 고안해 보라
종이에 8×8 필드를 그린다. 각 하단 모서리에 양 떼를 하나씩 두고, 그 사이에 목자를 배치한다. 늑대는 맨 윗줄에서 등장하며, 목자가 한 칸 움직일 때마다 두 칸을 이동한다. 늑대의 습관은 목자에게 미리 알려주지 않는다.
이제 읽기 전에, 아무것도 모르는 목자가 어떻게 하면 점점 더 잘할 수 있을지 직접 적어보라. 매일 밤 무엇을 기록해야 할까? 어디에 서야 할지 어떻게 결정해야 할까?
대부분 비슷한 방법을 떠올린다. 늑대가 각 위치에서 어디로 갔는지 표로 집계하고, 그 표가 가장 많이 가리키는 방향에 선다. 이것이 바로 CS229에서 제시한 방식이다. 집계표가 곧 월드 모델이고, 그 표가 지시하는 곳에 서는 것이 곧 계획이다. Kenneth Craik는 1943년에 마음이 이런 식으로 작동한다고 추측했다. 즉, 유기체가 "small-scale model"—현실의 축소판 모델—을 머릿속에 지니고 있으면, 행동하기 전에 여러 대안을 미리 시도해볼 수 있다는 것이다 (Craik (1943), The Nature of Explanation, quoted by Quanta Magazine (2025))였다. 그의 생각은 아이디어였을 뿐, 알고리즘은 아니었다. CS229 19.3절은 그 아이디어를 실제 알고리즘으로 적어두었다.
여섯 줄
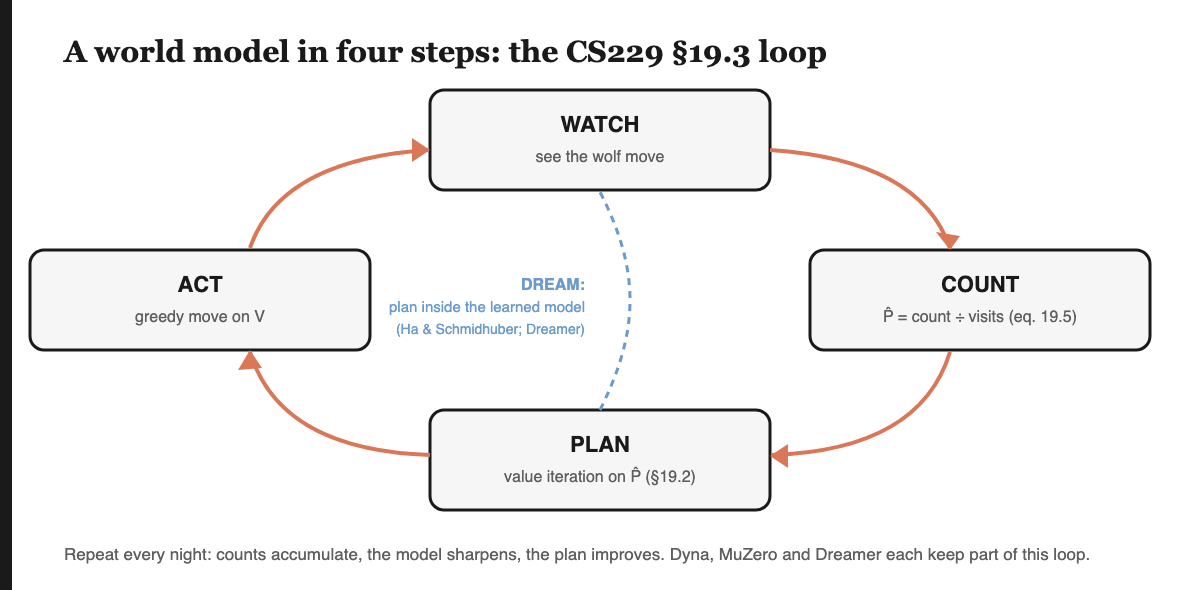
CS229 19.3절은 마코프 결정 과정(MDP)에서 출발한다. 상태, 행동, 보상, 그리고 각 행동이 어디로 이어질지 알려주는 전이 확률이 등장한다. 이 확률들은 보통 주어지지 않는다. 경험을 통해 직접 추정해야 하며, 강의노트는 그 추정치를 비율(식 19.5)로 제시한다. 각 전이 확률, 즉 상태 s에서 행동 a를 했을 때 s′에 도달할 확률은, 그 일이 실제로 일어난 횟수를 "상태 s에서 행동 a를 취한 횟수" (Ma & Ng, CS229 Lecture Notes, eq. 19.5 (p. 233))로 나눈 값이다. 한 번도 시도하지 않은 쌍에는 균등한 추정치를 할당한다.
그리고 강의노트는 학습과 계획을 몇 줄로 이루어진 루프 하나로 묶는다.
- 정책(policy)은 무엇이든 임의로 하나 정해서 시작한다.
- 이후 반복한다: - (a) 정책을 몇 번 시행한다; - (b) 전이 카운트를 업데이트한다; - (c) 추정된 모델로 가치 반복(value iteration)을 수행한다; - (d) 새로운 가치에 대해 greedy policy로 전환한다.
여기서 (c)가 계획 단계이므로, 그 부분을 분명히 짚고 넘어간다. 가치 V(s)는 어떤 상태에서 앞으로 기대할 수 있는 보상의 총합이다. 가치 반복은 숫자가 더 이상 변하지 않을 때까지 한 번의 업데이트를 반복한다(§19.2): V(s) ← R(s) + γ · 가능한 모든 행동 a에 대해, 다음 상태 s′에 대한 Σ P̂_sa(s′) · V(s′)의 최대값. 여기서 γ(데모에서는 0.95)는 미래 보상을 할인한다. 정책이란 각 상태에서 어떤 행동을 할지 정하는 규칙이고, greedy 정책은 단순히 가장 가치가 높은 행동만을 선택한다. 첫날 밤, 아무것도 모르는 양치기는 늑대의 모든 움직임이 똑같이 일어날 것이라 믿으므로, 모든 칸을 똑같이 지키게 되고, 결국 아무 곳도 제대로 지키지 못한다.
이것이 바로 월드 모델의 전체 구조다. 월드 모델이란, 세상이 어떻게 움직이는지 관찰해서 배운 작은 복사본을 만들어, 행동 전에 계획에 활용하는 것이다. 여기서는 일어난 일(카운트)을 기억하고, 그 기억에서 모델(비율)을 만들며, 행동 전에 그 모델을 활용해 계획(가치 반복)을 세운다.
활동 2 · 양치기가 배우는 과정을 관찰하기
다음을 연다: Shepherd's World Model with seed 1. 'river sneak'을 선택하고 "Learn 30 nights"를 두 번 눌러, 각 버튼 클릭 후 점수를 기록한다. 그 다음 엔지니어 모드로 전환해, 늑대가 있는 칸에 대해 학습된 테이블과 실제 테이블을 비교한다.
이제 'wanderer'를 선택해 같은 과정을 반복한다. 양치기가 어떤 습관에서 가장 많이 배웠는지 적고, 왜 그런지 읽기 전에 추측해본다.
이 데모는 CS229 루프를 두 가지 명시적 단순화와 함께 실행한다. 오직 늑대의 움직임만 학습한다. 보상과 양치기의 움직임은 주어진다. 늑대가 한 번도 방문하지 않은 칸에는 64칸 전체가 아니라, 늑대가 실제로 이동할 수 있는 합법적 움직임에 균등 분포로 추정치를 준다. 늑대가 움직이는 모든 스텝을 카운트하고, 양치기와 늑대의 모든 위치쌍(64 × 64 = 4,096 상태)에 대해 가치 반복을 실행하며, greedy하게 움직인다. 늑대는 한 턴에 두 칸 이동하므로, 쫓아가서는 잡을 수 없다. 양치기는 늑대가 향하는 곳에 미리 있어야 하며, 그 위치는 오직 모델만이 알려줄 수 있다.
시드 1에서, 전혀 배우지 않는 목자는 '모든 움직임이 똑같이 일어날 확률'이라는 가정 아래 영원히 같은 방식으로 계획한다. 아래는 60일 중 마지막 30일 동안, 학습하는 목자와의 성과 비교다. 즉, 두 번째 버튼을 눌렀을 때: 60일 후 점수에서 30일 후 점수를 빼고 30으로 나눈 값이다. (계산 결과임; 시드 1로 페이지를 열면 그대로 재현된다.)
| 늑대의 습관 | 학습하지 않음 | 학습함 |
|---|---|---|
| 강가 잠입자(좌측 측면) | 22%가 방향을 틀었음 | 100% |
| 능선 주자(우측 측면) | 17% | 87% |
| 직선 주자(가장 가까운 무리) | 37% | 93% |
| 방랑자(거의 무작위) | 88% | 93% |
마지막 행이 바로 교훈 속의 교훈이다. 방랑자는 배울 만한 습관이 거의 없으니, 월드 모델이 추가할 것도 거의 없다. 이런 늑대 앞에서는, 학습하는 목자도 '모든 늑대 움직임이 똑같이 일어날 확률'이라고 가정하고 절대 업데이트하지 않는 목자와 거의 비슷한 성적을 낸다(93% 대 88%). 학습은 늑대가 갖고 있지 않은 패턴을 더해줄 수 없다. 월드 모델은 자신이 모델링하는 세계의 구조만큼만 쓸모 있다. 이 한 문장만으로도 연구 인생을 걸 만하다. 내 생각에, 대형 모델이 "world model"을 갖고 있느냐를 둘러싼 논쟁의 상당 부분은, 실제로는 훈련 데이터가 모델에 얼마나 많은 구조를 강제로 학습시켰는가에 관한 논쟁이다. 이는 내 의견이지, 연구 결과는 아니다.
여섯 줄에서 world foundation model로 올라가는 길
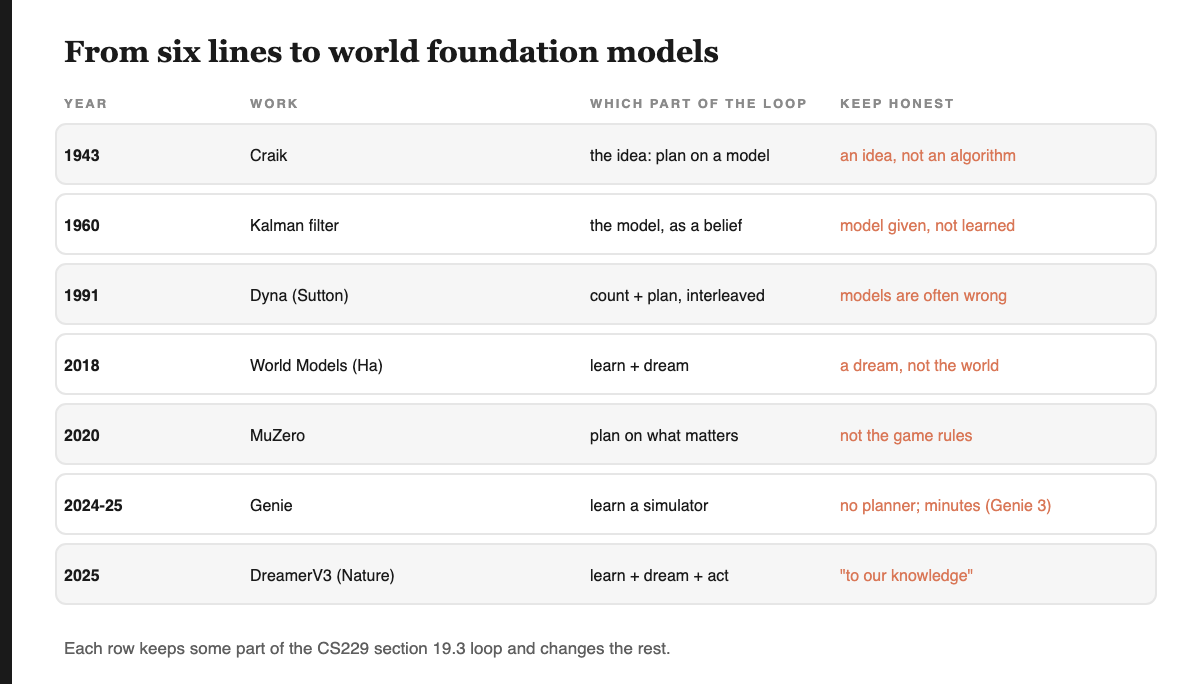
이후의 연구들은 이 루프의 몇몇 줄을 유지하고, 나머지는 바꾼다. Kalman의 필터는 모델이 주어진 것으로 가정하고 아무것도 배우지 않는다. Genie는 시뮬레이터를 학습하지만 계획을 세우지 않는다. MuZero는 계획에 필요한 부분만 학습한다. 표에는 각 방법이 어떤 부분을 유지하고, 어떤 한계를 여전히 안고 있는지 정리되어 있다.
위치 대신 신념.
- 목자는 늑대를 직접 본다. 하지만 대부분의 로봇은 그렇지 못하다. 그들은 잡음 섞인 단서만 본다.
- CS229 20.4절(LQG)은 이 문제를 다룬다. Kalman 필터로 숨겨진 상태에 대한 신념을 유지하고, LQR로 제어한다. Kalman의1960 논문은 이 깊은 연결을 한 문장으로 표현한다: "The filtering problem is shown to be the dual of the noise-free regulator problem."(번역: 필터링 문제는 잡음 없는 조절기 문제의 쌍대임이 드러난다.)" (Kalman (1960), A New Approach to Linear Filtering and Prediction Problems, J. Basic Eng. 82).
- 추정과 행동이 서로 거울상임이 밝혀진다. 이런 놀라움이 바로 사람을 연구자로 만든다.
학습과 계획을 교차하며 반복한다.
- Sutton의 Dyna(1991)는 이 루프를 아키텍처로 만든 것으로, 이 노트보다 수십 년 앞선다. 그의 말로는: "Planning is incremental and can use the probabilistic and ofttimes incorrect world models generated by learning processes."(번역: 계획은 점진적으로 이루어지며, 학습 과정에서 생성된 확률적이고 종종 부정확한 world model을 활용할 수 있다.)" (Sutton (1991), Dyna, ACM SIGART Bulletin 2).
- "Ofttimes incorrect"는 이 분야의 정직한 본질이다. 양치기의 초기 표도 마찬가지로 틀렸다.
모델 내부에서 꿈꾸기.
- Ha와 Schmidhuber(2018)는 표(table)를 신경망으로 대체하며 이렇게 썼다: "We can even train our agent entirely inside of its own hallucinated dream generated by its world model, and transfer this policy back into the actual environment." (번역: 우리는 에이전트를 그 자체의 월드 모델이 만들어낸 환상 속 꿈 안에서 완전히 훈련시키고, 이 정책을 실제 환경에 다시 적용할 수도 있다.)" (Ha & Schmidhuber (2018), World Models, arXiv 1803.10122).
- 데모에서 학습된 표에 대한 가치 반복은 바로 이 방식이다. 양치기는 늑대에 대한 자기만의 모델 안에서 계획을 세운다. dream 버튼은 그런 상상 속 밤 중 하나를 보여준다. 이때 회색 늑대는 양치기가 예상하는 대로 움직인다. 꿈의 질은 모델의 질에 달려 있다. 양치기의 초기 꿈은 틀릴 수밖에 없다.
계획에 필요한 부분만 학습하기.
- MuZero(2020) "계획에 필요한 예측만을 만들어내는 반복 가능한 모델을 학습한다" (Schrittwieser et al. (2020), MuZero, Nature 588): 정책, 가치, 보상만을 다루며, 세계 전체의 모습을 그리지는 않는다.
- 체스의 규칙 전체를 배운 것이 아니다. 이기기 위해 필요한 것만 배웠다.
여러 분야에 통하는 하나의 레시피.
- DreamerV3는 Nature에 2025에 발표되었고, 매우 다양한 과제에 하나의 월드 모델 레시피를 적용했다. 이 알고리즘은 "to our knowledge"라는 단서를 달고, 인간 데이터나 커리큘럼 없이 마인크래프트에서 다이아몬드를 처음부터 모은 최초의 알고리즘으로 소개되었다(Hafner et al. (2025), Mastering diverse control tasks through world models, Nature 640).
- 인용문의 단서는 반복해서 남겨야 한다.
파운데이션 월드 모델.
- Google DeepMind의 Genie는 "11B"개의 파라미터를 갖고 있으며, 저자들은 이를 'foundation world model'로 규정한다(Bruce et al. (2024), Genie, arXiv 2402.15391).
- Genie 3는 실제 시간에서 "a few minutes" 동안만 일관성을 유지한다(Google DeepMind (2025), Genie 3 blog), 영구적이지 않다.
- OpenAI는 비디오 생성을 "a promising path towards building general purpose simulators of the physical world"(번역: 물리적 세계의 범용 시뮬레이터를 구축하는 유망한 길)" (OpenAI (2024), Video generation models as world simulators, abstract as given on the MIT CSAIL seminar page)로 제시했다. 이것은 아직 검증된 월드 시뮬레이터가 아니라 연구적 베팅이며, 비디오 모델은 스스로 행동을 취하지 않는다.
CS229 강의노트에는 이런 대형 모델의 내부 엔진 두 가지도 담겨 있다.
- variational autoencoder(11.5절; Kingma and Welling, arXiv 1312.6114, Kingma & Welling (2013), Auto-Encoding Variational Bayes), 에이전트가 관찰한 정보를 작은 코드로 압축한다;
- diffusion models(14절; Ho, Jain and Abbeel, arXiv 2006.11239, Ho, Jain & Abbeel (2020), Denoising Diffusion Probabilistic Models), 비디오 월드 시뮬레이터의 프레임을 생성한다.
이들은 다음 단계의 디딤돌일 뿐, 지금 다루는 계단은 아니다.
활동 3 · 카운팅 절차를 스스로 작성하고, 끝까지 완성하라
늑대가 양을 향해 걷는 7칸 복도에서, 늑대의 습관을 숨긴 채 학습자를 만들어보라. 전이(transition)를 카운트(eq. 19.5)하고, 학습된 확률을 출력한 뒤, 그 모델로 목자가 늑대에게 도달하기까지 남은 단계를 추정하라. 아래 예시와 비교하라.
import random
random.seed(1)
N, SHEEP = 7, 6                       # a corridor of 7 cells; the sheep are in the last one
def wolf_step(w):                     # the TRUE habit, hidden from the shepherd
    return min(w + 1, SHEEP) if random.random() > 0.2 else max(w - 1, 0)
counts = [[0] * N for _ in range(N)]  # counts[w][w2]: how often the wolf went from w to w2
visits = [0] * N
def p_hat(w, w2):                     # CS229 eq. 19.5; never seen -> uniform over the wolf's moves
    if visits[w] == 0:
        return 0.5 if abs(w2 - w) == 1 or (w in (0, SHEEP) and w2 == w) else 0.0
    return counts[w][w2] / visits[w]
for night in range(200):              # watch the wolf and count
    w = 0
    while w != SHEEP:
        w2 = wolf_step(w)
        counts[w][w2] += 1
        visits[w] += 1
        w = w2
for w in range(SHEEP):
    print(w, "-> forward", round(p_hat(w, w + 1), 2), " back", round(p_hat(w, max(w - 1, 0)), 2))
E = [0.0] * N                         # plan: how many steps until the wolf reaches the sheep? (the shepherd's deadline)
for _ in range(500):                  # value iteration on expected steps-to-sheep under P-hat
    E = [0.0 if w == SHEEP else 1 + sum(p_hat(w, w2) * E[w2] for w2 in range(N)) for w in range(N)]
print("expected steps for the wolf to reach the sheep from cell 0:", round(E[0], 2))
실제 값 0.8에 대해 학습된 전방 확률은 0.77~0.84 사이로 출력되며, 첫 칸에서 기대되는 단계 수는 9.32이다(시드 1 기준). 이 절차가 무엇인지 명확히 하라. 카운팅은 CS229의 eq. 19.5에 해당한다. 마지막 루프는 학습된 체인을 평가하는데, 이때는 선택지가 없다. 목자에게 행동(머무르기, 늑대 쪽으로 한 칸 이동)을 주고, 매 라운드마다 최적의 선택을 하게 하면, 이것이 바로 가치 반복(value iteration)이다. 이것이 바로 연습 문제이자, 데모의 엔진이다. 이제 일부러 망가뜨려보라:
- 0.2를 0.5로 바꿔보라;
- 200번이 아니라 5번만 밤을 주어라;
- 늑대의 습관이 밤마다 달라지도록 만들어라.
이런 변화 하나하나가 축소판 연구 질문이다. 월드 모델에는 데이터가 얼마나 필요할까? 세상이 변하면 무슨 일이 일어날까? 잘못된 모델로 계획하면 어떤 대가를 치르게 될까?
왜 바로 여기서 연구가 시작되는가
세계 모델에 관심 있는 예비 연구자에게 CS229에서 가장 영감을 주는 부분은 사실 월드 모델이 아니라 8.2절, 더블 디센트(double descent)다. 수십 년간 교과서의 그림은 이렇게 말했다. 일정 지점을 넘어서면 모델이 커질수록 과적합이 일어나고 테스트 에러가 증가한다. 그런데 실제로 측정해보니, 그 지점을 더 지나면 오히려 정반대 현상이 나타났다. Belkin과 동료들은 이렇게 보고했다. "increasing model capacity beyond the point of interpolation results in improved performance" (번역: 보간(interpolation) 지점을 넘어서 모델 용량을 더 키우면 성능이 오히려 향상된다)" (Belkin, Hsu, Ma & Mandal (2019), Reconciling modern machine-learning practice and the classical bias-variance trade-off, PNAS 116 (arXiv 1812.11118)). Nakkiran과 동료들은 후속 논문 제목을 이렇게 붙였다.Deep Double Descent: Where Bigger Models and More Data Hurt (Nakkiran et al. (2019), Deep Double Descent, arXiv 1912.02292), 데이터가 더 많아지면 오히려 한동안 성능이 나빠질 수도 있다는 뜻이다.
이것이 연구의 본질적 움직임이다. 직접 실험하고, 측정하고, 놀라고, 이론을 다시 세운다. 양치기 데모는 오늘 밤에도 충분히 해볼 수 있을 만큼 작다. 위의 wanderer(방랑자) 행은 이미 설명할 가치가 있는 놀라움이다.
같은 이야기, 다섯 갈래의 출구
| 당신은 … | 이것이 바꾸는 결정 | 이번 주에 할 수 있는 한 가지 행동 |
|---|---|---|
| 학생 | 월드 모델이 지금 시작할 수 있는 주제인지 아닌지 | 파이썬으로 카운팅 절반을 직접 짜서 완성하고, 가정 하나를 바꿔서 무엇이 망가졌는지 적는다. |
| 엔지니어 | 당신의 시스템에 학습된 모델이 필요한지, 아니면 더 많은 데이터가 필요한지 | 에이전트의 세계에 모델이 포착할 수 있는 구조가 있는지(방랑자 테스트) 직접 물어본다. |
| 창업가 | 피치에서 "world model"이 플래너인지, 시뮬레이터인지, 비디오 생성기인지 구체적으로 무엇을 뜻하는지 | 제품이 실제로 CS229 루프의 어떤 줄을 실행하는지 물어라 |
| 임원 | 월드 모델 관련 주장이 실제 측정 결과에 근거하는지 | 학습하지 않는 기준선과 그 차이를 요구하라 |
| 투자자 | 월드 모델 회사의 해자가 모델 자체인지, 데이터인지 | 세상이 변할 때 모델을 어떻게 보정하는지 물어라 |
이 글의 진실, 사랑, 아름다움
- 진실: 모든 수치는 재현된다. 데모는 시드가 고정되어 있고, 코드는 결과를 출력하며, 유명 논문에 대한 모든 주장은 각자의 단서를 달고 있다("to our knowledge", "a few minutes", "a promising path").
- 사랑: 이 글은 독자에게 아이를 가르치고 가족 연습을 해볼 기회를 건넨다. 월드 모델에 대한 반쯤 맞는 믿음에는 그들이 맞춘 부분으로 답한다.
- 아름다움: 여섯 줄에 전체 아이디어가 담겨 있다. 이후의 월드 모델들은 이 중 한두 줄을 남기고, 테이블을 수십억 배 큰 네트워크로 바꾼다.
여기서 한 가지 관점은 내 것이다. 나는 그것이 내 것임을 밝힌다. Shepherd's Academy of War는 다윗이 사울에게 한 보고에서 그 그림을 가져왔다: "당신의 종이 아버지의 양을 지키고 있었는데, 사자나 곰이 와서 양 떼에서 새끼 양을 물어가면, 내가 쫓아가서 그것을 치고, 그 입에서 빼앗아 내었습니다…"(사무엘상 17:34–35). 포식자의 습관을 배워 양 떼를 지키는 목자는, 내 신앙에서, 숙제를 하는 사랑의 한 모습이다. 위의 체크리스트는 그 믿음이 없어도 유효하다.
절반은 맞는 오해들
- "월드 모델은 비디오 생성기다." 일부 월드 모델은 비디오를 생성하지만, CS229의 월드 모델은 카운트 테이블과 플래너다. 본질은 학습된 모델로 계획을 세우는 것이지, 그림이 아니다.
- "월드 모델이 클수록 항상 더 좋다." 세상에 포착할 구조가 있을 때만 그렇다. wanderer 행이 그 작은 증거다: 배우지 않은 목자가 여전히 88%를 기록했다는 사실을 기억하라.
- "MuZero가 게임을 배웠다." MuZero는 계획에 필요한 것(정책, 가치, 보상)만 배웠다. 더 적게, 더 똑똑하게 배운 셈이다.
이제 가르쳐라
이제, 당신이 직접 설명할 차례다. 7세에서 11세 사이의 아이와 마주 앉아 Shepherd's World Model을 어린이 모드로 연다. 아이가 늑대의 비밀 습관을 당신에게 말하지 않고 스스로 고르게 한다. 함께 "Watch one night" 버튼을 여러 번 눌러본다. 밤이 시작되기 전마다 아이에게 늑대가 어디로 갈지, 목자가 어디에 서야 할지 물어본다. 열 번의 밤이 지나면, 목자가 무엇을 배웠는지 아이에게 묻는다. 이 형식이 바로 Shepherd's Academy of War, part 5.
실험 결과: 아이는 목자가 움직이기 전에 늑대의 다음 행동을 예측하고, 목자가 무엇을 배웠는지 한 문장으로 설명할 수 있다(예: "늑대가 강을 따라 몰래 내려온다"). 아이의 나이와 그 한 문장을 이 글의 댓글로 남긴다. 이 결과는 Shepherd's Academy of War의 signal ledger에 shepherd-demo drill로 기록되며, SAW의 주간 자동차 이동 드릴과는 별도로 집계된다.
왜 중요한가: 다섯 번의 '왜'
문제: 한 엔지니어가 world model 연구를 시작하고 싶지만, 대부분의 대표 논문이 수십억 개의 파라미터에서 출발하기 때문에 어디서부터 접근해야 할지 막막하다.
- 왜 대표 논문들은 처음부터 거대한 규모로 시작하는가? 대표적인 결과들은 대규모에서 나온다. 예를 들어, Genie의 11B 파라미터(Bruce et al. (2024), Genie, arXiv 2402.15391), 그리고 Nature에 실린 DreamerV3(Hafner et al. (2025), Mastering diverse control tasks through world models, Nature 640).
- 왜 거대한 규모로 시작하면 이해가 어려워지는가? 그 크기에서는 실제로 어떤 부분이 핵심 역할을 하는지—모델, 플래너, 데이터 중 무엇이 기여하는지—구분할 수 없다.
- 왜 그런가? 그 이유는 모든 구성 요소가 하나의 네트워크에 얽혀 있기 때문이다. CS229 루프에서는 각각이 독립된 줄로 분리되어 있어, 언제든 한 줄씩 꺼보며 실험할 수 있다(Ma & Ng, CS229 Lecture Notes, eq. 19.5 (p. 233)).
- 왜 한 줄씩 꺼보는 것이 중요한가? 바로 그 방식이 핵심 요소를 밝혀내는 길이기 때문이다. 학습하지 않는 기준선과 wanderer 행이 그런 실험의 예이며, Dyna는 그 정직한 한계를 이렇게 말한다: 학습된 모델은 "ofttimes incorrect"(번역: 종종 틀릴 수 있다) (Sutton (1991), Dyna, ACM SIGART Bulletin 2).
- 근본 원인: world model은 대개 위에서 아래로 주입식으로 가르쳐진다. 해결책은 작고 완전한 모델을 직접 만들어 기준선과 비교하고, 일부러 망가뜨려 본 뒤, 각 단계가 무엇을 더했는지 확인하며 계보를 따라 올라가는 것이다.
실행: 이번 주에 직접 실습해보기
- 미리 가르칠 내용을 한 줄로 정리해보라.
- 종이에 양치기의 전략을 직접 그려보라(활동 1, 5분).
- Shepherd's World Model에서 네 가지 늑대 습관을 모두 실험하고, 본인만의 표를 완성하라(10분).
- 파이썬으로 전이 카운팅 부분을 작성하고, 양치기 행동까지 구현한 뒤, 의도적으로 한 가지 가정을 깨뜨려보라(15분).
- 아이와 함께 가족 연습을 실행하고, 그 결과를 기록해 올려라.
피드백: 제대로 작동했는지 확인하는 기준
- CS229 19.3절의 루프를 네 단계로 암기해 설명할 수 있다.
- wanderer 행이 거의 개선되지 않는 이유를 논리적으로 설명할 수 있다.
- 코드의 가정을 하나 바꿔보고, 무엇이 어떻게 달라졌는지 근거와 함께 말할 수 있다.
시뮬레이션 기반 학습은 고등교육에서 강한 근거를 가진다: g = 0.85 / 145건의 연구에서 (Chernikova et al. (2020), Simulation-based learning in higher education, Review of Educational Research 90). 이는 시뮬레이션을 활용하는 대학생을 대상으로 한 결과이며, 어린이나 직접 모델을 만드는 경우에는 해당하지 않는다. 따라서 가족 연습은 약속이 아니라 실험으로 삼아야 한다. 연구에 따르면 어린 아이들은 자신만의 인과 지도를 구성한다: "2~4세 아동은 새로운 인과 지도를 만든다" (Gopnik et al. (2004), A theory of causal learning in children, Psychological Review 111". 이 연습은 아이가 늑대를 예측할 때 그런 인과 구조가 실제로 드러나는지 확인하는 것이다.
피드포워드: 지금 설정하는 트립와이어
- 학습된 모델이 기준선보다 시드 간 잡음보다 적게 앞선다면, 아직 아무것도 배운 것이 아니다. 결과를 주장하기 전에는 반드시 여러 시드로 실험하고, 학습하지 않는 양치기가 이미 이기고 있지 않은지 항상 점검하라.
- 어떤 시스템을 월드 모델이라 부른다면, 그 모델이 루프의 어느 줄을 실행하는지 명확히 밝혀야 한다. 카운팅, 플래닝, 드리밍, 비디오 생성은 서로 다른 주장임을 구분하라.
- 유명한 연구 결과를 인용할 때 원문의 단서(hedge)가 빠져 있다면, 반드시 그 단서를 복원해야 한다. ("to our knowledge", "a few minutes").
5S 자기 평가표
| S | 주장 | 근거 |
|---|---|---|
| 단순함 | 이 글의 문체는 13학년(대학 1학년) 수준 이하로 읽힌다. | Flesch–Kincaid 문체 등급: 7.3 (밴드 ≤ 13), 재계산 기준 node scripts/check-numbers-four-ages.mjs --series world-models-cs229 |
| 견고함 | 인용된 모든 주장은 출처와 단서를 포함해 확인했으며, 모든 데모 수치는 seed 1로 재현된다. | DreamerV3 "to our knowledge" (Nature); 시드 고정 데모 |
| 예리함 | 월드 모델의 쓸모는 모델이 포착한 세계의 구조에 달려 있다. 여섯 줄에 전체 루프가 담긴다. | 방랑자 행 · 여섯 줄 |
| SMART | 이번 주: 네 가지 습관, 하나의 깨진 가정, 하나의 가족 연습. | 실행 |
| 놀라움 | 거의 무작위로 움직이는 늑대에게서 목자가 가장 적게 배운다. 바로 그 점이 핵심 교훈이다. | 실습 2 |
| 진실 · 사랑 · 아름다움 | 시드로 검증되는 진실, 함께 가르칠 아이, 그리고 끝없이 확장되는 여섯 줄의 구조. | 진실, 사랑, 아름다움 |
참고문헌
- Ma, T. & Ng, A. CS229 Lecture Notes, Stanford, 2026년 봄 (섹션 19.3, 232–234쪽; 20.4; 11.5; 14; 8.2). cs229.stanford.edu
- Craik, K. (1943). The Nature of Explanation, Quanta Magazine (2025) 인용. quantamagazine.org
- Kalman, R. E. (1960). A New Approach to Linear Filtering and Prediction Problems. J. Basic Eng. 82. Crossref
- Sutton, R. S. (1991). Dyna. ACM SIGART Bulletin 2. OpenAlex
- Ha, D. & Schmidhuber, J. (2018). World Models. arXiv:1803.10122
- Schrittwieser, J. et al. (2020). MuZero. Nature 588. nature.com
- Hafner, D. et al. (2025). Mastering diverse control tasks through world models. Nature 640. nature.com
- Bruce, J. et al. (2024). Genie: Generative Interactive Environments. arXiv:2402.15391
- Google DeepMind (2025). Genie 3. deepmind.google
- NVIDIA (2025). Cosmos World Foundation Model Platform for Physical AI. arXiv:2501.03575
- OpenAI (2024). Video generation models as world simulators (abstract via MIT CSAIL). csail.mit.edu
- Kingma, D. P. & Welling, M. (2013). Auto-Encoding Variational Bayes. arXiv:1312.6114
- Ho, J., Jain, A. & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. arXiv:2006.11239
- Belkin, M., Hsu, D., Ma, S. & Mandal, S. (2019). Reconciling modern machine-learning practice and the classical bias–variance trade-off. arXiv:1812.11118
- Nakkiran, P. et al. (2019). Deep Double Descent. arXiv:1912.02292
- Chernikova, O. et al. (2020). Simulation-based learning in higher education. Review of Educational Research 90. doi:10.3102/0034654320933544
- Gopnik, A. et al. (2004). A theory of causal learning in children. Psychological Review 111. PubMed
- Kobayashi, K. (2024). Interactive learning effects of preparing to teach and teaching. Educational Psychology Review. ERIC EJ1414484
- 사무엘상 17:34–36bible-api.com