AI-NATIVE 系列 · CS229 世界模型 · 第 1/1 集 · 20 岁
世界模型六行起步:学狼护羊,二十岁正好
一分钟速览
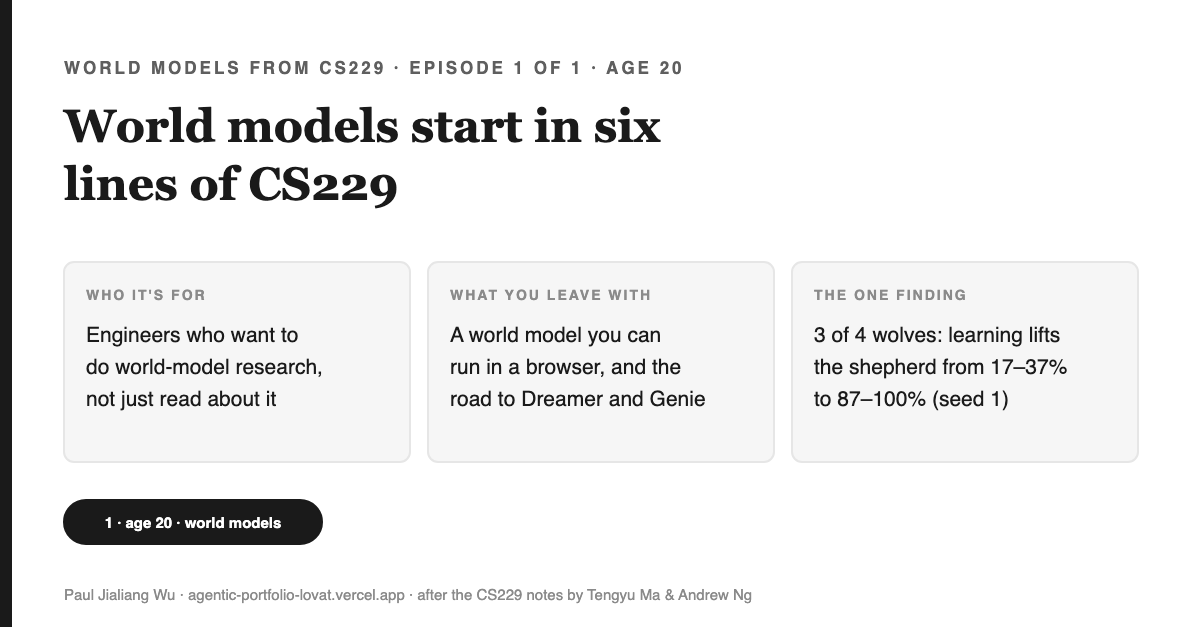
这是什么 一篇写给二十岁上下工程师的文章和一个在线演示。CS229 第 19.3 节里有一个六行世界模型,精巧到能一口气读完:数转移,学世界怎么动;用价值迭代做计划;行动,然后循环。演示是牧羊人摸清狼的习性;文章则梳理了后续 Kalman 滤波、Dyna、World Models、Dreamer、MuZero 和 Genie,这些工作各自保留了循环里的哪些环节。
为什么重要 许多实验室都在押注:机器人、游戏和物理 AI 都会跑在世界模型上,而大多数解释都是从 110 亿参数那头讲起。你能亲手跑的六行起步,让你看清后面每一篇论文到底加了什么,哪些关于世界模型的说法还悬而未决。
读完你能做什么试玩牧羊人演示,击败永不学习的基线,改动一个假设(比如狼的习惯、折扣因子或经验量),看看哪里出问题,再和孩子一起做家庭演练,把牧羊人学到的经验发出来。
核心问题:什么样的世界模型足够小,能让你亲手搭建、运行、理解?它又如何一路通向 Dreamer、MuZero 和 Genie?
这篇文章不会教你完整的 CS229 课程,也不会训练神经网络世界模型;只带你搭建第 19.3 节的表格型模型,并梳理后续进阶路线。文中交给孩子的家庭演练,出自Shepherd's Academy of War,第 5 部分.
本文讲什么:世界模型,从六行起步
这是一篇关于世界模型的文章:机器对世界行为的微型、可学习副本,用来在行动前做计划。写给二十岁上下、想亲自做世界模型研究的工程师,而不是只想看看热闹。你只需要一个浏览器、Python,还有半小时(咖啡可选)。
许多实验室都在下注,未来机器人、游戏和物理 AI 都会跑在世界模型上。NVIDIA 的 Cosmos 平台直接点明:物理 AI 系统需要「a digital twin of the world, the world model」(中译:世界的数字孪生,也就是世界模型)" (NVIDIA (2025), Cosmos World Foundation Model Platform for Physical AI, arXiv 2501.03575)。大多数讲解都从超大规模、百亿参数的视频模型讲起。这篇文章反其道而行,从 Stanford CS229 讲义(Tengyu Ma 和 Andrew Ng)里的六行模型切入(Ma & Ng, CS229 Lecture Notes (Stanford, Spring 2026))。在第 19.3 节“为 MDP 学习模型”里,这六行就包含了一个完整的世界模型:观察、计数、规划、行动,循环往复。
这篇文章用playbook-math 搭建,内容选自一套精挑细选的大约 30 页讲义。每一页都按三个标准筛选:能不能把工程师拉进研究、对世界模型有多重要、适不适合全家一起玩。278
| CS229 节(印刷页码) | 入选理由 |
|---|---|
| 19.1–19.3:MDP、价值迭代、模型学习(228–234) | 几行代码就能串起整个世界模型循环,演示页面就是它的实际落地。 |
| 19.4.2:如何用模型或模拟器(237–241) | 用数据把 s(t) 和 a(t) 学出 s(t+1):最早的学习型模拟器 |
| 20.4:LQG,卡尔曼滤波器配 LQR(254–257) | 看不见真实状态时,如何基于信念行动 |
| 11.5:变分推断与 VAE(162–166) | 神经世界模型的压缩核心 |
| 8.2:双降现象(123–127) | 笔记里最精彩的“测量颠覆理论”案例 |
整个演示的底座是Shepherd's World Model,一个免费在线页面,牧羊人通过摸清狼的秘密习性来守护两群羊。这幅插画来自 Shepherd's Academy of War——一个家庭式“小学院”,孩子们在这里学会攻击是怎么发生的,从而懂得如何保护。这里的狼只是动物,没有任何人是敌人。
请先停一下,别急着往下读。 你最后会和 7 到 11 岁的孩子一起跑一遍牧羊人演示,让他们来猜狼的下一步。请用“我要把这个循环讲明白给别人听”的心态来阅读。某项元分析显示,39项研究中,带着“要教别人”预期去学,教学后的得分提升 g = 0.48(某子组结果);而没有这种预期时,教学并没有带来可测量的提升(g = −0.02) (Kobayashi(2024),Educational Psychology Review(ERIC EJ1414484)).
活动 1 · 先自己想一遍牧羊人的策略
在纸上画一个 8×8 的场地。每个底角放一群羊,中间站牧羊人。一只狼从顶行出现,每当牧羊人走一步,狼就走两步,而且狼的习惯牧羊人一无所知。
继续往下读前,先写写看:如果你是个什么都不知道的牧羊人,怎么才能变得厉害?每晚该记下什么?怎么选站位?
大多数人都会想到类似的办法:记下狼每次从每个格子走向哪里,然后根据统计结果去堵狼最可能出现的地方。这其实就是 CS229 的套路。统计表就是世界模型,跟着它指向的地方站,就是计划。Kenneth Craik 在 1943 年就猜过,心智可能就是这样工作的:有机体如果带着一个“small-scale model”的现实缩影,就能在行动前先试试各种可能性(Craik(1943),The Nature of Explanation,转引自 Quanta Magazine(2025))。他当年只是提出了个想法,还没给出算法。CS229 第 19.3 节把这个算法真正写成了代码。
六行小循环,世界模型的起点
CS229 第 19.3 节从马尔可夫决策过程(MDP)讲起:状态、动作、奖励,以及每个动作通常会把你带到哪里的转移概率。现实里这些概率没人直接告诉你,只能靠经验去估算。讲义用一个比值(公式 19.5)来教你怎么估:每个转移概率,也就是在状态 s 下采取动作 a 后落到 s′ 的概率,就是这种情况出现的次数,除以「#times we took action a in state s" (Ma & Ng, CS229 Lecture Notes, eq. 19.5 (p. 233)」。没见过的组合就平均分配概率。
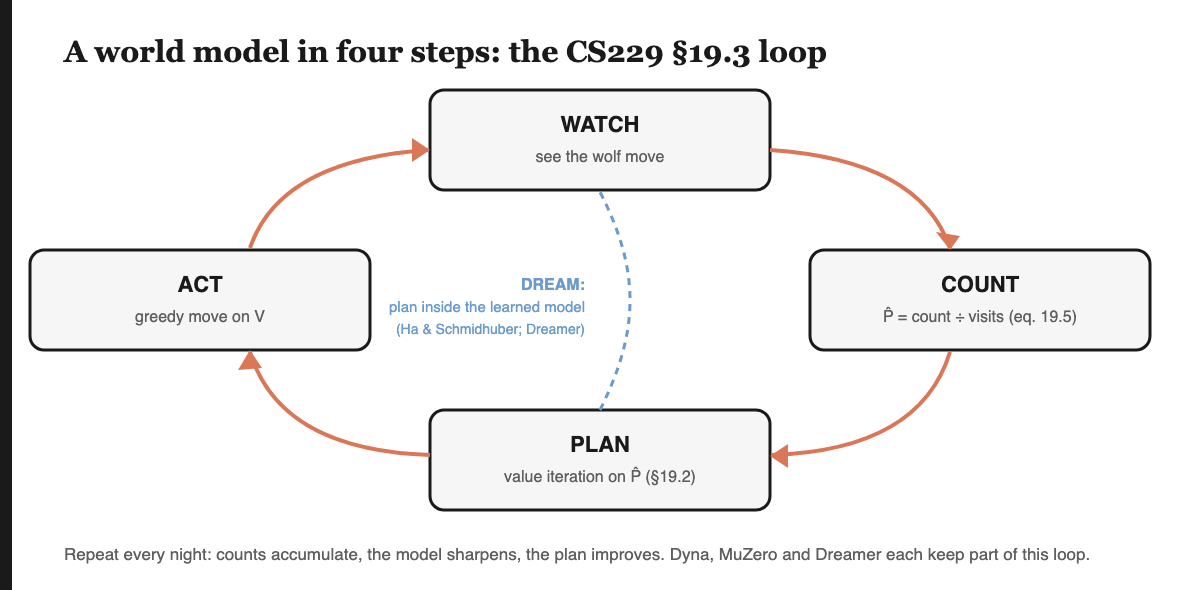
接着,讲义把学习和规划合成了一个几行的小循环:
- 随便选一个策略起步。
- 循环进行:- (a) 跑几轮试试看;- (b) 更新转移计数;- (c) 用刚学到的模型做一次价值迭代;- (d) 换成新价值下的贪婪策略。
第 (c) 步就是规划环节,直接写出来是这样。这里的价值 V(s) 表示从当前状态还能期望拿到多少奖励。价值迭代就是不断用一个公式更新,直到数值稳定(§19.2):V(s) ← R(s) + γ · max over actions a of Σ over next states s′ of P̂_sa(s′) · V(s′)。这里 γ(演示用 0.95)是未来奖励的折扣因子。策略,就是规定每个状态下选哪个动作的规则,而贪婪策略就是每次都选当前价值最高的动作。第一晚,什么都不知道的牧羊人会觉得狼每一步都是等概率,于是每个格子都守,结果等于哪儿都没守。
这就是整个 world model 的精髓。world model 就是你根据见过的世界,学出来的一个小副本,用来提前做规划。这个模型有记忆(计数),有用记忆算出来的模型(比值),还有在行动前用模型做规划的部分(价值迭代)。
活动 2 · 看牧羊人怎么学本事
打开Shepherd's World Model with seed 1。选 river sneak,点两次“Learn 30 nights”,每次记下得分。切到工程师模式,把学到的表和狼实际所在格子的真表对比一下。
再选 wanderer,重复上面操作。写下牧羊人从哪个习惯学得最多,先猜猜为什么,再继续往下看。
这个演示用两处明确的简化来跑 CS229 的循环。只学狼的动作:奖励和牧羊人自己的动作是给定的。狼没走过的格子,只在它能走的那些动作里平均分配概率(不是 64 格全猜,毕竟狼不能瞬移)。它把每一步狼的动作都记下来,对每个牧羊人和狼的位置组合(64 × 64 = 4096 个状态)做价值迭代,然后贪婪地行动。狼每回合走两格,所以追它没戏。牧羊人只能提前卡位,而这只有模型才能告诉他。
用 seed 1 时,从不学习的牧羊人会一直用“每一步等概率”的策略来守夜。下面是它和会学习的牧羊人在 60 晚中的最后 30 晚的表现对比。也就是第二次点击后的分数:用 60 晚后的得分减去 30 晚后的得分,再除以 30。(数据可复现:用 seed 1 打开页面即可。)
| 狼的习惯 | 不学习 | 会学习 |
|---|---|---|
| 河道潜行(左翼) | 22% 被拦截 | 100% |
| 山脊疾行(右翼) | 17% | 87% |
| 直线冲锋(最近羊群) | 37% | 93% |
| 游荡者(几乎随机) | 88% | 93% |
最后一行才是真正的“隐藏彩蛋”。游荡者几乎没有什么规律可学,所以世界模型也帮不上太多忙。对付它时,会学习的牧羊人和假装“每一步等概率、永不更新”的牧羊人表现几乎一样(93% 对 88%)。你没法学出狼本来没有的模式。世界模型的价值,取决于它所建模的世界到底有多少结构。这句话,值得用一整个研究生涯去体会。在我看来,关于大模型是否“有世界模型”的争论,本质其实是在争论训练数据到底让模型捕捉了多少结构。这只是我的看法,不是结论。
进阶之路:从六行循环到世界基础模型
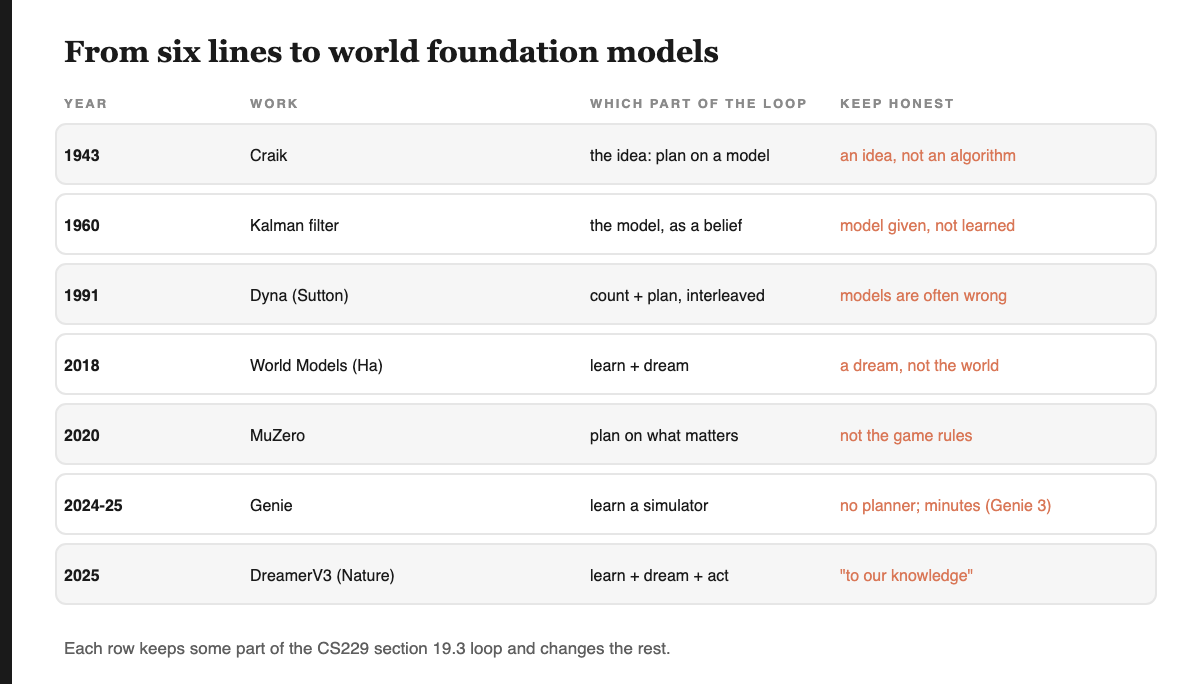
后来的工作,有的保留了这个循环的部分步骤,有的则做了调整。Kalman 滤波假定模型已知,完全不学习;Genie 学了一个模拟器,但不做规划;MuZero 只学了规划真正需要的部分。下表说明了每个方法保留了哪一环,以及各自的遗留问题。
用信念代替位置。
- 牧羊人能直接看到狼,但大多数机器人看不到,只能捕捉到带噪声的线索。
- CS229 第 20.4 节(LQG)就是为此设计的:用 Kalman 滤波器维护对隐藏状态的信念,再用 LQR 控制。Kalman 的1960 论文用一句话点明了深层联系:“The filtering problem is shown to be the dual of the noise-free regulator problem.(中译:滤波问题实际上是无噪声调节器问题的对偶。)" (Kalman (1960), A New Approach to Linear Filtering and Prediction Problems, J. Basic Eng. 82).
- 估计和行动,最后竟然成了镜像。这种意外,正是让人爱上科研的那种惊喜。
交替进行:先学再规划。
- Sutton 的 Dyna(1991)把这个循环做成了架构,比这些讲义早了几十年。他说得很坦率:“Planning is incremental and can use the probabilistic and ofttimes incorrect world models generated by learning processes.(中译:规划是渐进的,可以利用由学习过程生成的概率性、且常常不准确的世界模型。)" (Sutton (1991), Dyna, ACM SIGART Bulletin 2).
- “Ofttimes incorrect” 是这个领域最诚实的注脚。牧羊人最初的统计表也一样会出错。
在模型里“做梦”。
- Ha 和 Schmidhuber(2018)用神经网络取代了表格,并写道:“We can even train our agent entirely inside of its own hallucinated dream generated by its world model, and transfer this policy back into the actual environment.(中译:我们甚至可以让智能体完全在自己世界模型生成的‘梦境’里训练,然后把学到的策略迁回真实环境。)" (Ha & Schmidhuber (2018), World Models, arXiv 1803.10122).
- 在演示里,对学到的表格做价值迭代,其实就是这回事:牧羊人在自己想象出来的狼的模型里训练自己的计划。Dream 按钮展示的,就是这样一个“想象之夜”——灰狼会按照牧羊人以为它会走的方式移动。梦的质量只取决于模型本身:牧羊人早期的梦注定靠不住。
只学规划真正需要的那一部分。
- MuZero(2020) "learns an iterable model that produces predictions relevant to planning(中译:学到一个可迭代的模型,只生成和规划相关的预测)" (Schrittwieser et al. (2020), MuZero, Nature 588):只学策略、价值和奖励,而不是世界的全部细节。
- 它没学会国际象棋的规则,只学了赢棋所需的那部分。
一套配方,横跨多个领域。
- DreamerV3 发表在 Nature(2025),用同一套 world-model 配方横扫了各种完全不同的任务。它被描述为首个“to our knowledge(中译:据我们所知)”能在没有人类数据和课程的前提下,从零开始在 Minecraft 里收集钻石的算法(Hafner et al. (2025), Mastering diverse control tasks through world models, Nature 640).
- 引用时要保留原文的 hedge(保留模糊语气)。
基础世界模型。
- Google DeepMind 的 Genie 拥有「11B」个参数,作者称其为基础世界模型(foundation world model)(Bruce 等(2024),Genie,arXiv 2402.15391).
- Genie 3 在真实时间里最多能保持一致「a few minutes(中译:几分钟)」(Google DeepMind(2025),Genie 3 博客),但还远谈不上“永远”。
- OpenAI 则把视频生成称为「a promising path towards building general purpose simulators of the physical world(中译:构建通用物理世界模拟器的一条有前景的路径)" (OpenAI(2024),Video generation models as world simulators,MIT CSAIL 研讨会摘要)。这其实是个研究方向的下注,还不是现成的世界模拟器,而且视频模型本身并不参与行动。
CS229 讲义还收录了这些大模型内部的两大核心引擎:
- 变分自编码器(第 11.5 节;Kingma 和 Welling,arXiv 1312.6114, Kingma & Welling(2013),Auto-Encoding Variational Bayes),能把智能体看到的内容压缩成极简的编码;
- 扩散模型(第 14 节;Ho、Jain 和 Abbeel,arXiv 2006.11239, Ho、Jain & Abbeel(2020),Denoising Diffusion Probabilistic Models),用来生成视频世界模拟器的每一帧画面。
它们是下一个台阶,不是本节的主角。
活动 3 · 亲手写出计数半环,再补全它
写一个 7 格走廊的学习器,让一只狼按你设定但没告诉它的习惯朝羊靠近。统计转移(公式 19.5),打印学到的概率,再用学到的模型估算牧羊人还有多少步能赶在狼到达前拦住它。和下方的版本对比。
import random
random.seed(1)
N, SHEEP = 7, 6                       # a corridor of 7 cells; the sheep are in the last one
def wolf_step(w):                     # the TRUE habit, hidden from the shepherd
    return min(w + 1, SHEEP) if random.random() > 0.2 else max(w - 1, 0)
counts = [[0] * N for _ in range(N)]  # counts[w][w2]: how often the wolf went from w to w2
visits = [0] * N
def p_hat(w, w2):                     # CS229 eq. 19.5; never seen -> uniform over the wolf's moves
    if visits[w] == 0:
        return 0.5 if abs(w2 - w) == 1 or (w in (0, SHEEP) and w2 == w) else 0.0
    return counts[w][w2] / visits[w]
for night in range(200):              # watch the wolf and count
    w = 0
    while w != SHEEP:
        w2 = wolf_step(w)
        counts[w][w2] += 1
        visits[w] += 1
        w = w2
for w in range(SHEEP):
    print(w, "-> forward", round(p_hat(w, w + 1), 2), " back", round(p_hat(w, max(w - 1, 0)), 2))
E = [0.0] * N                         # plan: how many steps until the wolf reaches the sheep? (the shepherd's deadline)
for _ in range(500):                  # value iteration on expected steps-to-sheep under P-hat
    E = [0.0 if w == SHEEP else 1 + sum(p_hat(w, w2) * E[w2] for w2 in range(N)) for w in range(N)]
print("expected steps for the wolf to reach the sheep from cell 0:", round(E[0], 2))
它打印出的前进概率在 0.77 到 0.84 之间,真实值是 0.8,从第一格出发期望步数是 9.32(用 seed 1 计算)。要搞清楚这是什么:计数部分就是 CS229 的公式 19.5,最后的循环是在评估学到的链条,也就是没有选择的规划步骤。给牧羊人加上动作(原地、向狼靠近),每轮选最优动作,这就成了价值迭代:这是你的练习,也是演示的引擎。然后故意把它搞坏:
- 把 0.2 改成 0.5;
- 把 200 晚改成 5 晚;
- 让狼的习惯每晚都变一变。
每一个小改动,都是现实世界里的微型研究题:世界模型到底需要多少数据?世界如果悄悄变了,会发生什么?拿错的模型去做规划,代价有多大?
为什么研究从这里起步
CS229 里最能点燃准研究者热情的几页,其实和 world model 本身无关。它们是 8.2 节,讲 double descent(双重下降)。几十年来,教材都说模型大到一定程度就会过拟合,测试误差会上升。但后来,实际测量却发现,在更大规模下,结果反而逆转。Belkin 等人报告:"increasing model capacity beyond the point of interpolation results in improved performance(中译:把模型容量做到插值点以上,性能反而提升)" (Belkin, Hsu, Ma & Mandal (2019), Reconciling modern machine-learning practice and the classical bias-variance trade-off, PNAS 116 (arXiv 1812.11118)。Nakkiran 等人的后续论文,标题直接点名:Deep Double Descent: Where Bigger Models and More Data Hurt(中译:更大模型和更多数据反而变糟的地方) (Nakkiran et al. (2019), Deep Double Descent, arXiv 1912.02292,因为有时候,数据越多、模型越大,效果还真会先变差。
这就是最纯粹的研究流程:把东西跑起来,测一测,被结果惊到,然后重写理论。牧羊人演示小到今晚就能亲自试一遍。上面 wanderer 那一行,已经是值得细细琢磨的意外。
同一个故事,五种出路
| 你的身份是…… | 这会影响你的决策 | 本周可以做的一步 |
|---|---|---|
| 学生 | world model 是不是你现在就能上手的方向 | 用 Python 跑一遍计数那半段,补全它,然后改一个假设,写下哪里坏了 |
| 工程师 | 你的系统到底需要学模型,还是只要更多数据 | 问问你的 agent 世界里有没有模型能捕捉的结构(wanderer 测试) |
| 创始人 | 在融资或产品介绍里,“world model”究竟指的是规划器、模拟器,还是视频生成器 | 问清楚产品实际跑的是 CS229 循环的哪一步 |
| 管理者 | 判断 world-model 相关的说法背后有没有真实测量数据 | 要求对方给出“从不学习的基线”及其差距 |
| 投资人 | 判断一家 world-model 公司的护城河到底是模型本身,还是数据 | 问清楚当世界发生变化时,模型是如何被修正的 |
这篇文章里的真、善、美
- 真: 每个数字都能复现。演示有种子,代码会打印结果,每个名作的结论都带自己的限定词(“to our knowledge”“a few minutes”“a promising path”)。
- 善: 这篇文章把一个孩子和一场家庭演练交到你手上。它用事实回应了关于 world model 的半对半错的看法,肯定他们对的那部分。
- 美: 六行代码就装下了整个思想。后来的 world model 只是在保留其中一行或多行的基础上,把表换成了大上十亿倍的网络。
有一层视角是我自己的,我会标明。Shepherd's Academy of War 的画面取自大卫向扫罗的汇报:「你的仆人替父亲放羊,有狮子或熊来,从羊群中叼走一只羊羔,我就追上去,击打它,把羊羔从它口中救出来……」(撒母耳记上 17:34–35)。在我看来,一个为了保护羊群而去研究捕食者习性的牧羊人,是“有备而来的爱”的写照。上面的清单即使没有这个信仰也成立。
那些半对半错的误区
- “world model 就是视频生成器。” 有些 world model 确实能生成视频,但 CS229 里的只是一个计数表加一个规划器。它的本质是用学到的模型做规划,而不是画面。
- “world model 越大越好。” 只有当世界本身有结构可学时才成立。wanderer 那一行就是小小的反例:记得那个从不学习的牧羊人,分数也有 88%。
- “MuZero 学会了整个游戏。” 它只学了规划所需的部分(策略、价值、奖励),更少、更聪明。
现在轮到你教了
你的教回作业。 和 7 到 11 岁的孩子一起坐下来,打开 Shepherd's World Model 的儿童模式。让孩子悄悄选一个狼的秘密习惯,不告诉你,然后一起多点几次“观看一夜”。每晚开始前,问问孩子:狼会去哪?牧羊人该站哪?十夜之后,再问孩子:牧羊人到底学会了什么?这就是 Shepherd's Academy of War,第 5 部分的演练流程.
结果: 孩子能在牧羊人行动前预测狼的下一步,并能用一句话总结牧羊人学到了什么(比如“狼总是沿着河偷偷溜下来”)。把孩子的年龄和这句话发在本文评论区。这个结果会被 Shepherd's Academy of War 的信号台账记为一次 shepherd-demo 演练,和 SAW 的每周车上演练分开统计。
为什么重要:五问追根
问题:一个工程师想做 world model,却不知道从哪下手,因为大多数顶刊论文一上来就是几十亿参数起步。
- 为什么顶刊论文都从大模型开局? 顶级成果都是大规模的:Genie 的11B 个参数(Bruce et al. (2024), Genie, arXiv 2402.15391),还有 Nature 上的 DreamerV3(Hafner et al. (2025), Mastering diverse control tasks through world models, Nature 640).
- 为什么一上来就做大模型反而让人难以理解? 因为规模一大,你根本分不清到底是模型、规划器还是数据在起作用。
- 为什么会这样? 因为这些部分全都搅在同一个网络里。而在 CS229 的循环里,它们是一行一行分明的,你可以随时关掉某一行(Ma & Ng, CS229 Lecture Notes, eq. 19.5 (p. 233)).
- 为什么要能单独关掉? 这正是你找出关键所在的方法。永不学习的基线和 wanderer 那一行就是这种实验的典型,Dyna 也老实交代了:学到的模型“ofttimes incorrect”(中译:经常是错的)(Sutton (1991), Dyna, ACM SIGART Bulletin 2).
- 根本原因: world model 的教学总是自上而下。破解之道,是先亲手搭一个小而完整的模型,和基线比一比,再故意搞坏它,然后沿着谱系往上爬,清楚每一步到底加了什么。
实操:本周就跑一遍
- 先把“要教会别人,自己得先学会”那句话过一遍。
- 在纸上画出牧羊人的策略草图(活动 1,5 分钟)。
- 打开 Shepherd's World Model,体验四种狼的习性,并自己填一份表格(10 分钟)。
- 用 Python 实现计数部分,补全牧羊人的决策动作,然后故意改坏一次(15 分钟)。
- 和孩子一起做家庭演练,把结果发出来。
反馈:怎么判断你真的掌握了
- 你能脱稿说出 CS229 第 19.3 节的四步循环。
- 你能解释为什么 wanderer 那一行几乎没提升。
- 你动过代码里的一个假设,并能说清哪里坏了、为什么坏。
仿真式学习在高等教育中有扎实证据:g = 0.85,覆盖 145 项研究(Chernikova 等(2020),《高等教育中的仿真学习》,Review of Educational Research 90)。这针对的是用仿真的大学生,不是儿童,也不是自己造仿真,所以家庭演练要当作测试,而不是承诺。研究表明幼儿会构建因果地图:「2 到 4 岁的儿童会构建新的因果地图" (Gopnik 等(2004),《儿童因果学习理论》,Psychological Review 111)。这个演练就是看他们预测狼时会不会表现出来。
前馈提醒:现在就定下的“绊线”
- 如果你的学习模型比基线只高出不同随机种子的噪声,那其实还没学到东西。 在你声称有结果前,多跑几个种子,并且永远要检查“从不学习的牧羊人”是不是已经赢了。
- 你说某个东西是 world model 时,要说清它跑的是哪一行。 计数、规划、做梦、生成视频,这些是完全不同的 claim。
- 如果引用了某个著名结果却省略了它的限定语,请把限定语补回来(“to our knowledge”,“a few minutes”)。
5S 自评表
| S | 主张 | 证据 |
|---|---|---|
| 简明 | 正文整体难度不高于 13 年级。 | Flesch–Kincaid 可读性年级:7.3(≤13 分段),由…重新计算node scripts/check-numbers-four-ages.mjs --series world-models-cs229 |
| 扎实 | 每条被引用的主张都来自有出处、带限定语的来源;每个演示数字都能用 seed 1 复现。 | DreamerV3“to our knowledge" (Nature); 有种子可复现的演示 |
| 犀利 | 世界模型只有在世界本身有结构可学时才有用;六行就能跑完整个循环。 | wanderer 行 · 这六行 |
| SMART | 本周:四种习性,一次假设破坏,一次家庭演练。 | 实操 |
| 惊喜 | 最接近随机的狼,才是牧羊人最学不到的对象——这正是本节的要点。 | 活动 2 |
| 真理 · 爱 · 美 | 有种子的真理、要教的孩子、六行模型撑起亿级世界。 | 真理、爱与美 |
参考资料
- Ma, T. & Ng, A. CS229 讲义,斯坦福,2026 春季学期(第 19.3 节,第 232–234 页;20.4;11.5;14;8.2)。cs229.stanford.edu
- Craik, K. (1943). 《解释的本质》,引自 Quanta Magazine (2025)。quantamagazine.org
- Kalman, R. E. (1960). A New Approach to Linear Filtering and Prediction Problems. J. Basic Eng. 82. Crossref
- Sutton, R. S. (1991). Dyna. ACM SIGART Bulletin 2. OpenAlex
- Ha, D. & Schmidhuber, J. (2018). World Models. arXiv:1803.10122
- Schrittwieser, J. 等 (2020). MuZero. Nature 588. nature.com
- Hafner, D. 等(2025)。通过世界模型掌握多样控制任务。Nature 640. nature.com
- Bruce, J. 等(2024)。Genie:生成式交互环境。arXiv:2402.15391
- Google DeepMind(2025)。Genie 3。deepmind.google
- NVIDIA(2025)。Cosmos World Foundation Model Platform for Physical AI。arXiv:2501.03575
- OpenAI(2024)。视频生成模型作为世界模拟器(摘要见 MIT CSAIL)。csail.mit.edu
- Kingma, D. P. & Welling, M.(2013)。自动编码变分贝叶斯。arXiv:1312.6114
- Ho, J., Jain, A. & Abbeel, P.(2020)。去噪扩散概率模型。arXiv:2006.11239
- Belkin, M., Hsu, D., Ma, S. & Mandal, S.(2019)。调和现代机器学习实践与经典偏差-方差权衡。arXiv:1812.11118
- Nakkiran, P. 等(2019)。深度双降。arXiv:1912.02292
- Chernikova, O. 等(2020)。高等教育中的模拟式学习。Review of Educational Research 90. doi:10.3102/0034654320933544
- Gopnik, A. 等(2004)。儿童因果学习理论。Psychological Review 111. PubMed
- Kobayashi, K. (2024). Interactive learning effects of preparing to teach and teaching. Educational Psychology Review. ERIC EJ1414484
- 撒母耳记上 17:34–36bible-api.com