SERIE AI-NATIVE · MODELOS DEL MUNDO DESDE CS229, EPISODIO 1 DE 1 · A LOS 20
Modelos del mundo en seis líneas de CS229: Aprende del lobo, protege el rebaño (a los 20)
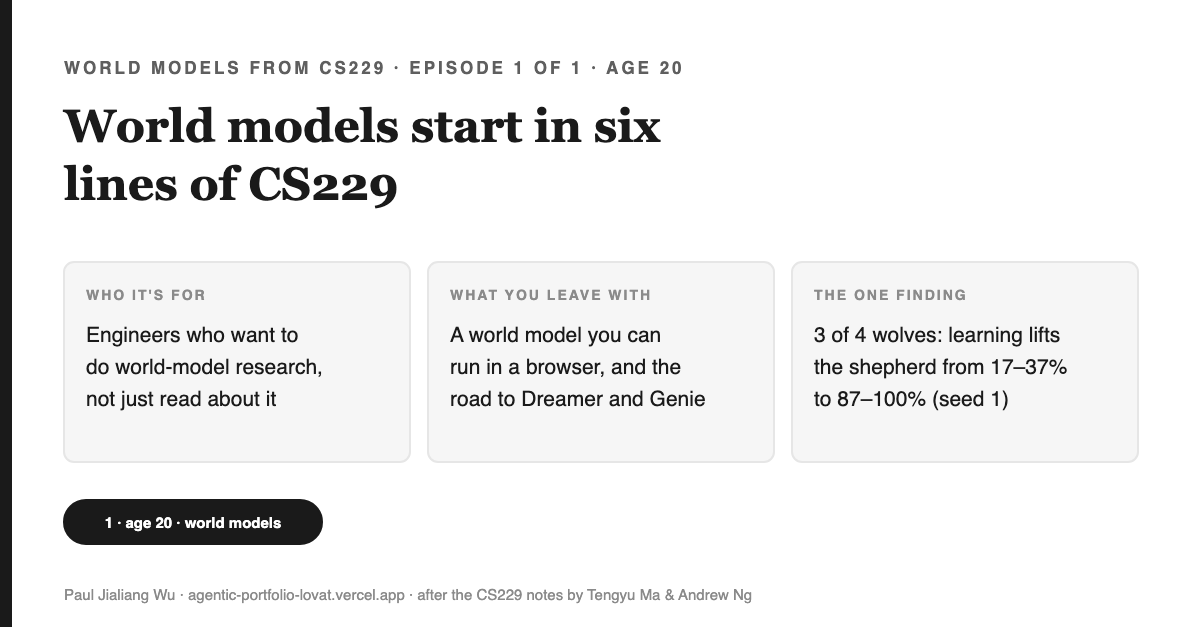
Resumen rápido
De qué trata. Un ensayo y una demo interactiva para ingenieros jóvenes. La sección 19.3 de CS229 contiene un modelo del mundo completo, lo bastante compacto para leerse de una vez: cuenta transiciones para aprender cómo se mueve el mundo, planea con iteración de valores sobre lo aprendido, actúa y repite. La demo es un pastor que aprende los hábitos de un lobo; el ensayo traza qué partes de ese mismo ciclo retoman después Kalman filtering, Dyna, World Models, Dreamer, MuZero y Genie.
Por qué importa. Muchos laboratorios apuestan a que la robótica, los juegos y la IA física funcionarán con modelos del mundo, y la mayoría de las explicaciones empiezan en el extremo de los 11 mil millones de parámetros. Empezar con seis líneas que puedes ejecutar te permite ver qué añadió realmente cada paper posterior, y qué afirmaciones sobre modelos del mundo siguen abiertas.
Qué puedes hacer después de leer. Prueba el demo del pastor y supera al baseline que nunca aprende; cambia una suposición (el hábito del lobo, el descuento, la cantidad de experiencia) y cuenta qué dejó de funcionar, luego haz el ejercicio familiar con un niño y comparte lo que aprendió el pastor.
World Models from CS229 — la espina de la serie
▶ Véalo en marcha: abra la demo en vivo pública · sin registro
- Los world models arrancan en CS229 §19.3 este episodio
La pregunta central: ¿Qué es un world model lo bastante compacto para construir, ejecutar y entender, y cómo lleva de ahí a Dreamer, MuZero y Genie?
Este texto NO enseña todo el curso de CS229 ni entrena un world model neuronal; construye el modelo tabular de la sección 19.3 y traza el camino hacia arriba. El ejercicio familiar que propone para niños forma parte de Shepherd's Academy of War, parte 5.
De qué va este ensayo: world models, empezando desde seis líneas
Este es un ensayo sobre world models: una versión pequeña y aprendida de cómo se comporta el mundo, que una máquina usa para planear antes de actuar. Está dirigido a ingenieros jóvenes que quieren investigar en world models, no solo leer sobre ellos. Solo necesitas un navegador, Python y media hora.
Muchos laboratorios apuestan a que la robótica, los juegos y la IA física funcionarán sobre world models. La plataforma Cosmos de NVIDIA lo plantea de forma directa: un sistema de IA física necesita "a digital twin of the world, the world model" (Traducción: un gemelo digital del mundo, el world model)" (NVIDIA (2025), Cosmos World Foundation Model Platform for Physical AI, arXiv 2501.03575). La mayoría de las explicaciones empiezan por lo grande, con modelos de video de 11 mil millones de parámetros. Esta empieza por lo pequeño, con seis líneas en las notas de clase de CS229 de Stanford por Tengyu Ma y Andrew Ng (Ma & Ng, CS229 Lecture Notes (Stanford, Spring 2026)). En la sección 19.3, "Learning a model for an MDP", esas seis líneas contienen un world model completo: observa, cuenta, planea, actúa, repite.
El ensayo se armó con playbook-math, a partir de una selección manual de un 278paquete de notas de unas 30 páginas. Cada una se evaluó según tres criterios: cuánto impulsa a un ingeniero hacia la investigación, cuánto aporta a los world models y si es apta para jugar en familia.
| Sección de CS229 (páginas impresas) | Por qué fue seleccionada |
|---|---|
| 19.1–19.3: MDPs, iteración de valores, aprendizaje de un modelo (228–234) | Todo el ciclo de un modelo del mundo resumido en unas pocas líneas; la demo lo pone en acción. |
| 19.4.2: uso de un modelo o simulador (237–241) | Aprender s(t+1) a partir de s(t) y a(t) usando datos: el primer simulador aprendido. |
| 20.4: LQG, el filtro de Kalman con LQR (254–257) | Actuar según una creencia cuando el estado no es observable. |
| 11.5: inferencia variacional y el VAE (162–166) | El motor de compresión dentro de los modelos de mundo neuronales. |
| 8.2: doble descenso (123–127) | La historia más clara en las notas sobre cómo una medición puede derribar una teoría. |
La base práctica de todo esto es el Shepherd's World Model, una página gratuita donde un pastor aprende los hábitos secretos de un lobo para proteger dos rebaños. La imagen viene de Shepherd's Academy of War, una escuela familiar donde los niños exploran cómo funciona un ataque para poder defenderse. El lobo es solo un animal: ninguna persona es el enemigo.
Antes de continuar. Al final, vas a ejecutar la demo del pastor con un niño de 7 a 11 años y le pedirás que prediga al lobo. Lee pensando que luego tendrás que explicar el ciclo de forma sencilla. En un meta-análisis de 39 estudios, enseñar después de estudiar con esa expectativa obtuvo g = 0.48 (resultado en un subgrupo), mientras que enseñar sin esa expectativa no mostró ningún beneficio medible (g = −0.02) (Kobayashi (2024), Educational Psychology Review (ERIC EJ1414484)).
Actividad 1 · Primero, inventa el método del pastor
Dibuja un campo de 8 por 8 en papel. Coloca un rebaño en cada esquina inferior y al pastor entre ambos. Un lobo entra desde la fila superior y se mueve dos casillas por cada una que avanza el pastor, siguiendo un hábito que el pastor desconoce.
Antes de seguir, escribe cómo debería mejorar un pastor que no sabe nada. ¿Qué debería registrar cada noche? ¿Cómo decidir dónde colocarse?
Casi todos llegan a la misma idea: anotar desde cada casilla a dónde fue el lobo, y posicionarse donde esas cuentas sugieren que irá. Eso es justo el método de CS229. Esas cuentas forman el modelo del mundo. Pararse donde apunta ese modelo es el plan. Kenneth Craik intuyó en 1943 que las mentes funcionan así: un organismo que lleva un "small-scale model" de la realidad puede probar alternativas antes de actuar (Craik (1943), The Nature of Explanation, quoted by Quanta Magazine (2025)). Aquello era solo una idea, no un algoritmo. La sección 19.3 de CS229 sí escribe el algoritmo.
Las seis líneas
La sección 19.3 de CS229 parte de un proceso de decisión de Markov (MDP): estados, acciones, recompensas y probabilidades de transición que indican a dónde suele llevar cada acción. Normalmente, esas probabilidades no vienen dadas: tienes que estimarlas a partir de la experiencia, y las notas proponen hacerlo como un cociente (ec. 19.5). Cada probabilidad de transición —la posibilidad de llegar a s′ tras tomar la acción a en el estado s— es el número de veces que eso ocurrió, dividido entre el "#times we took action a in state s" (Ma & Ng, CS229 Lecture Notes, eq. 19.5 (p. 233)). Si nunca se ha probado un par, se asume una probabilidad uniforme.
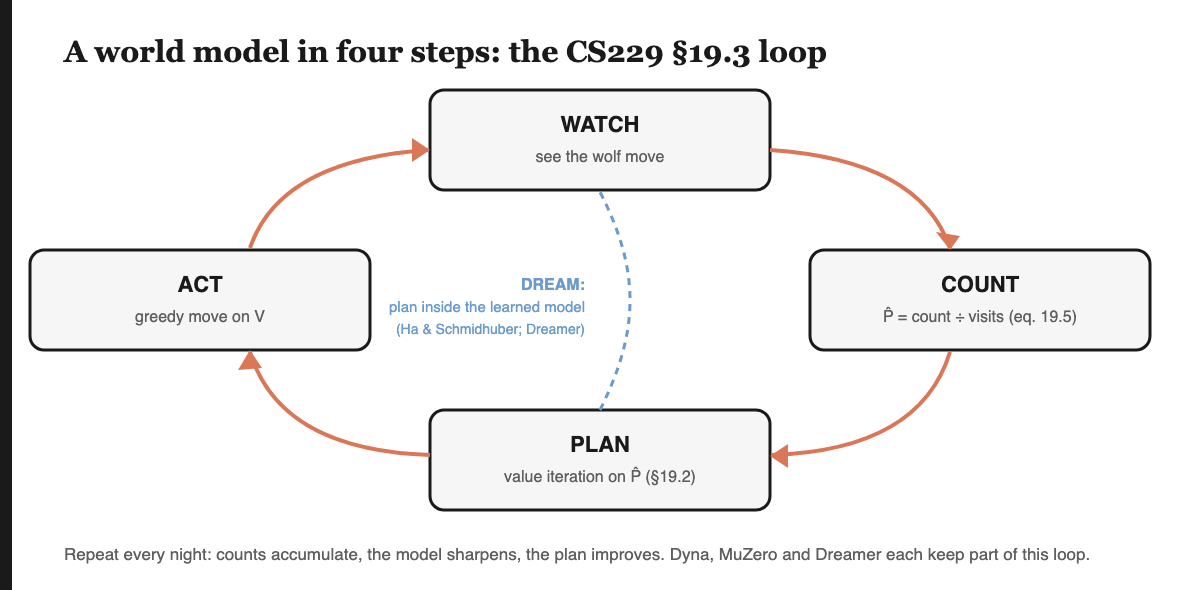
Después, las notas unen el aprendizaje y la planificación en un ciclo de pocas líneas:
- Empieza con cualquier política.
- Repite: - (a) ejecútala durante algunos episodios; - (b) actualiza los conteos de transiciones; - (c) ejecuta iteración de valores sobre el modelo estimado; - (d) cambia a la política codiciosa según los nuevos valores.
El paso (c) es la parte de planificación, así que aquí va directo. El valor V(s) de un estado es la recompensa que puedes esperar desde ahí en adelante. La iteración de valores repite una actualización hasta que los números dejan de cambiar (§19.2): V(s) ← R(s) + γ · máximo sobre acciones a de Σ sobre siguientes estados s′ de P̂_sa(s′) · V(s′). Aquí γ (0.95 en el demo) descuenta el futuro. Una política es una regla para decidir qué acción tomar en cada estado, y la política codiciosa simplemente elige la acción con el mayor valor. En la primera noche, el pastor que no sabe nada supone que todos los movimientos del lobo son igual de probables, así que protege todas las casillas por igual, lo que equivale a no proteger ninguna.
Eso es el modelo del mundo completo. Un world model es una copia pequeña y aprendida de cómo se comporta el mundo, construida a partir de lo que observaste y usada para planear antes de actuar. Este tiene memoria de lo que ocurrió (los conteos), un modelo construido con esa memoria (los cocientes), y un planificador que usa el modelo antes de actuar (iteración de valores).
Actividad 2 · Mira cómo aprende el pastor
Abre el Shepherd's World Model con semilla 1. Elige el river sneak y pulsa "Learn 30 nights" dos veces, anotando la puntuación tras cada vez. Luego cambia a modo ingeniero y compara la tabla aprendida con la verdadera para la celda donde está el lobo.
Ahora elige el wanderer y haz lo mismo. Escribe de cuál hábito aprendió más el pastor, y trata de adivinar por qué antes de seguir leyendo.
El demo ejecuta el ciclo de CS229 con dos simplificaciones explícitas. Solo se aprenden los movimientos del lobo: las recompensas y los movimientos del pastor ya están dados. Y una celda que el lobo nunca ha visitado recibe una suposición uniforme sobre los movimientos legales del lobo, no sobre las 64 casillas, porque un lobo no puede teletransportarse. Cuenta cada paso del lobo que observa, ejecuta iteración de valores sobre cada par de posiciones de pastor y lobo (64 × 64 = 4,096 estados), y se mueve de forma codiciosa. El lobo se mueve dos casillas por turno, así que perseguirlo no funciona. El pastor tiene que anticipar a dónde irá el lobo, y solo un modelo puede decírselo.
Con la semilla 1, el pastor que nunca aprende sigue planeando eternamente como si “cada movimiento fuera igual de probable”. Así se compara con el pastor que sí aprende, durante los últimos 30 de 60 turnos nocturnos. Ese es el segundo clic: la puntuación después de 60 noches menos la de 30, dividido entre 30. (Calculado; abre la página con la semilla 1 para comprobarlo.)
| Hábito del lobo | No aprende nunca | Aprende |
|---|---|---|
| Sigiloso del río (flanco izquierdo) | 22% se dio la vuelta | 100% |
| Corredor de la cresta (flanco derecho) | 17% | 87% |
| Corredor recto (hacia el rebaño más cercano) | 37% | 93% |
| Errante (casi aleatorio) | 88% | 93% |
La última fila es la lección dentro de la lección. Un errante casi no tiene hábito que aprender, así que el world model tiene poco que aportar. Frente a él, un pastor que aprende lo hace casi igual de bien que uno que asume que todos los movimientos del lobo son igual de probables y nunca actualiza (93% frente a 88%). Aprender no puede inventar un patrón que el lobo no tiene. Un world model solo es tan útil como la estructura que haya en el mundo que modela. Esa frase vale una carrera de investigación. En mi opinión, gran parte de la discusión sobre si los modelos grandes “tienen world models” en realidad es una discusión sobre cuánta estructura los datos de entrenamiento les obligaron a capturar. Eso es una opinión, no un hallazgo.
El camino: de seis líneas a world foundation models
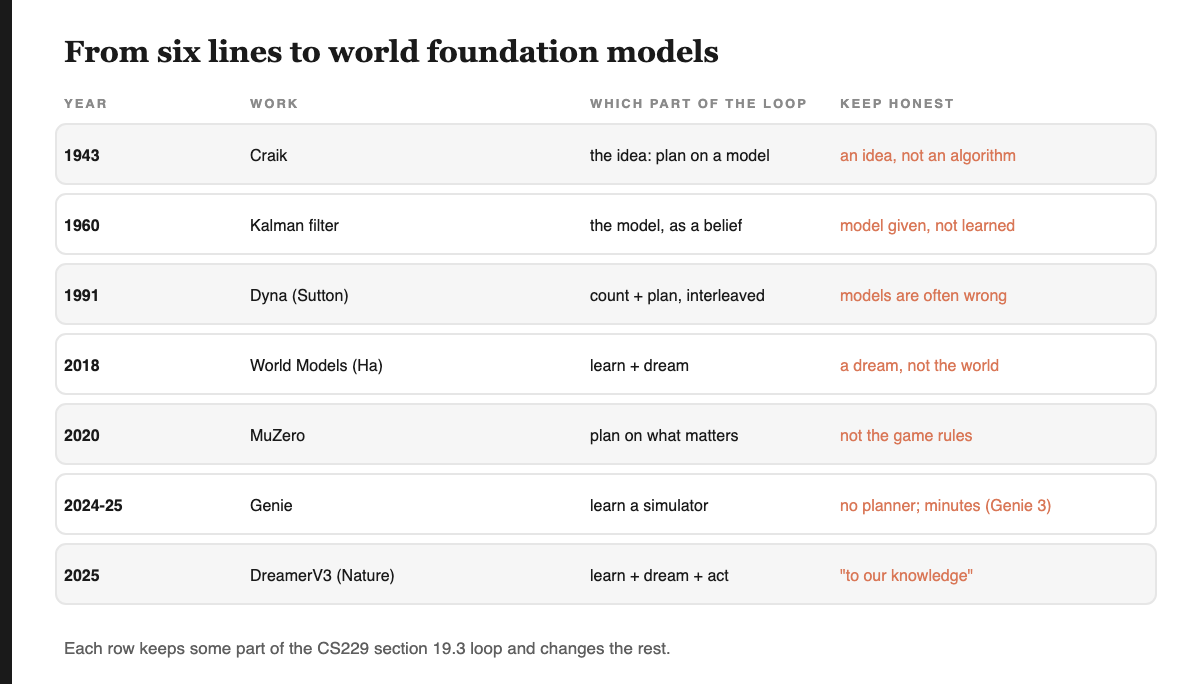
Los trabajos posteriores conservan algunas líneas de este ciclo y cambian otras. El filtro de Kalman asume que el modelo ya está dado y no aprende nada. Genie aprende un simulador pero no planifica. MuZero solo aprende las partes que la planificación necesita. La tabla indica qué parte conserva cada uno y la advertencia que aún arrastra.
Creencia en vez de posición.
- El pastor ve al lobo. La mayoría de los robots no; solo reciben pistas ruidosas.
- La sección 20.4 de CS229 (LQG) resuelve esto: mantiene una creencia sobre el estado oculto con un filtro de Kalman, y luego controla con LQR. El artículo de Kalman 1960 lo resume en una sola frase: “The filtering problem is shown to be the dual of the noise-free regulator problem.” (Traducción: El problema de filtrado resulta ser el dual del problema del regulador sin ruido)." (Kalman (1960), A New Approach to Linear Filtering and Prediction Problems, J. Basic Eng. 82).
- Estimar y actuar resultan ser imágenes en espejo. Ese es el tipo de sorpresa que hace que alguien quiera dedicarse a la investigación.
Aprender y planificar, entrelazados.
- Dyna de Sutton (1991) es este ciclo convertido en arquitectura, décadas antes de estas notas. En sus palabras: “Planning is incremental and can use the probabilistic and ofttimes incorrect world models generated by learning processes.” (Traducción: La planificación es incremental y puede usar los world models probabilísticos y a menudo incorrectos generados por procesos de aprendizaje)." (Sutton (1991), Dyna, ACM SIGART Bulletin 2).
- "Ofttimes incorrect" es la verdad incómoda del campo. Las primeras tablas del pastor también están equivocadas.
Soñar dentro del modelo.
- Ha y Schmidhuber (2018) cambiaron la tabla por redes neuronales y escribieron: "We can even train our agent entirely inside of its own hallucinated dream generated by its world model, and transfer this policy back into the actual environment. (Traducción: Incluso podemos entrenar a nuestro agente completamente dentro de su propio sueño alucinado generado por su world model, y transferir esa política de vuelta al entorno real)." (Ha & Schmidhuber (2018), World Models, arXiv 1803.10122).
- En la demo, la iteración de valores sobre la tabla aprendida es justo eso: el pastor entrena su plan dentro de su propio modelo del lobo. El botón de soñar simplemente muestra una de esas noches imaginadas, donde el lobo gris se mueve como el pastor imagina que se mueve. Un sueño solo es tan bueno como el modelo: los primeros sueños del pastor están equivocados.
Aprende solo lo que la planificación necesita.
- MuZero (2020) "aprende un modelo iterable que produce predicciones relevantes para la planificación" (Schrittwieser et al. (2020), MuZero, Nature 588): política, valor y recompensa, no una imagen completa del mundo.
- No aprendió las reglas del ajedrez. Aprendió lo que necesitaba para ganar.
Una receta para muchos dominios.
- DreamerV3, publicado en Nature en 2025, usó una sola receta de world model en tareas muy distintas. Se describió como el primer algoritmo, "to our knowledge", en recolectar diamantes en Minecraft desde cero, sin datos humanos ni currículos (Hafner et al. (2025), Mastering diverse control tasks through world models, Nature 640).
- No olvides la salvedad cuando la repitas.
World models fundacionales.
- Genie de Google DeepMind tiene "11B" parámetros y sus autores lo describen como un foundation world model (Bruce et al. (2024), Genie, arXiv 2402.15391).
- Genie 3 se mantiene coherente durante "a few minutes" (Traducción: unos pocos minutos)" en tiempo real (Google DeepMind (2025), Genie 3 blog), pero no indefinidamente.
- OpenAI presentó la generación de video como "a promising path towards building general purpose simulators of the physical world" (Traducción: un camino prometedor hacia la construcción de simuladores de propósito general del mundo físico)" (OpenAI (2024), Video generation models as world simulators, abstract as given on the MIT CSAIL seminar page). Eso es una apuesta de investigación, no un simulador del mundo ya demostrado, y el modelo de video no toma decisiones ni acciones.
Las notas de CS229 también incluyen los dos motores que están dentro de estos modelos grandes:
- el autoencoder variacional (sección 11.5; Kingma y Welling, arXiv 1312.6114, Kingma & Welling (2013), Auto-Encoding Variational Bayes), que comprime lo que percibe el agente en un código compacto;
- modelos de difusión (sección 14; Ho, Jain y Abbeel, arXiv 2006.11239, Ho, Jain & Abbeel (2020), Denoising Diffusion Probabilistic Models), que generan los fotogramas de los simuladores de video del mundo.
Son los siguientes escalones, no el de aquí.
Actividad 3 · Escribe tú mismo la parte de conteo y luego complétala
Programa un aprendiz para un corredor de 7 casillas donde un lobo avanza hacia las ovejas con un hábito que le ocultas. Cuenta las transiciones (ec. 19.5), imprime las probabilidades aprendidas y luego usa el modelo aprendido para estimar cuántos pasos le quedan al pastor antes de que llegue el lobo. Compáralo con la versión de abajo.
import random
random.seed(1)
N, SHEEP = 7, 6                       # a corridor of 7 cells; the sheep are in the last one
def wolf_step(w):                     # the TRUE habit, hidden from the shepherd
    return min(w + 1, SHEEP) if random.random() > 0.2 else max(w - 1, 0)
counts = [[0] * N for _ in range(N)]  # counts[w][w2]: how often the wolf went from w to w2
visits = [0] * N
def p_hat(w, w2):                     # CS229 eq. 19.5; never seen -> uniform over the wolf's moves
    if visits[w] == 0:
        return 0.5 if abs(w2 - w) == 1 or (w in (0, SHEEP) and w2 == w) else 0.0
    return counts[w][w2] / visits[w]
for night in range(200):              # watch the wolf and count
    w = 0
    while w != SHEEP:
        w2 = wolf_step(w)
        counts[w][w2] += 1
        visits[w] += 1
        w = w2
for w in range(SHEEP):
    print(w, "-> forward", round(p_hat(w, w + 1), 2), " back", round(p_hat(w, max(w - 1, 0)), 2))
E = [0.0] * N                         # plan: how many steps until the wolf reaches the sheep? (the shepherd's deadline)
for _ in range(500):                  # value iteration on expected steps-to-sheep under P-hat
    E = [0.0 if w == SHEEP else 1 + sum(p_hat(w, w2) * E[w2] for w2 in range(N)) for w in range(N)]
print("expected steps for the wolf to reach the sheep from cell 0:", round(E[0], 2))
Imprime probabilidades aprendidas hacia adelante entre 0.77 y 0.84 para un valor real de 0.8, y un promedio esperado de 9.32 pasos desde la primera casilla (calculado con semilla 1). Sé claro sobre lo que hace: el conteo es la ec. 19.5 de CS229. El último ciclo evalúa la cadena aprendida, que es la fase de planificación sin opciones. Si le das al pastor acciones (quedarse, avanzar hacia el lobo) y eliges la mejor en cada ronda, eso se convierte en iteración de valores: ese es tu ejercicio, y es el motor de la demo. Luego rómpelo a propósito:
- cambia el 0.2 por 0.5;
- pruébalo con solo 5 noches en vez de 200;
- haz que el hábito del lobo cambie según la noche.
Cada cambio es una pregunta de investigación en miniatura. ¿Cuántos datos necesita realmente un world model? ¿Qué ocurre cuando el mundo cambia bajo tus pies? ¿Cuánto cuesta planear con un modelo equivocado?
Por eso aquí arranca la investigación
Las páginas más inspiradoras de CS229 para quien quiere lanzarse a investigar ni siquiera hablan de world models. Son la sección 8.2, sobre double descent. Durante décadas, el libro de texto decía que, pasado cierto punto, los modelos más grandes sobreajustan y el error de prueba sube. Luego las mediciones mostraron lo contrario, más allá de otro punto. Belkin y colegas reportaron que "increasing model capacity beyond the point of interpolation results in improved performance" (Traducción: aumentar la capacidad del modelo más allá del punto de interpolación mejora el desempeño)" (Belkin, Hsu, Ma & Mandal (2019), Reconciling modern machine-learning practice and the classical bias-variance trade-off, PNAS 116 (arXiv 1812.11118)). Nakkiran y colegas titularon su seguimiento Deep Double Descent: Where Bigger Models and More Data Hurt" (Traducción: Donde los modelos más grandes y más datos empeoran el resultado) (Nakkiran et al. (2019), Deep Double Descent, arXiv 1912.02292), porque más datos incluso pueden empeorar las cosas por un tiempo.
Ese es el movimiento de investigación en su versión más pura: ejecuta el experimento, mide, déjate sorprender, reconstruye la teoría. El demo del pastor es tan compacto que puedes hacerlo esta misma noche. La fila del wanderer de arriba ya es una sorpresa digna de explicación.
Misma historia, cinco caminos de salida
| Tú eres… | La decisión que esto cambia | Una acción para esta semana |
|---|---|---|
| Estudiante | Si los world models son un tema que puedes empezar a explorar ya | Corre la parte de conteo en Python, termínala, luego cambia una suposición y apunta qué se rompió |
| Ingeniero | Si tu sistema necesita un modelo aprendido o simplemente más datos | Pregunta si el mundo de tu agente tiene estructura que un modelo podría capturar (la prueba del wanderer) |
| Fundador | Si en un pitch "world model" significa un planificador, un simulador o un generador de video | Pregunta qué parte del ciclo de CS229 ejecuta realmente el producto |
| Ejecutivo | Si una afirmación sobre world models tiene detrás una medición concreta | Pide la línea base que nunca aprende, y la diferencia con respecto a ella |
| Inversionista | Si la ventaja competitiva de una empresa de world models está en el modelo o en los datos | Pregunta cómo se corrige el modelo cuando el mundo cambia |
Verdad, amor y belleza en este ensayo
- Verdad: cada número se puede reproducir. El demo está sembrado, el código imprime sus resultados, y cada afirmación sobre un paper famoso lleva su propio matiz ("to our knowledge", "a few minutes", "a promising path").
- Amor: el ensayo te pone a enseñar a un niño y a hacer un ejercicio familiar. Responde a las creencias a medias sobre world models reconociendo lo que sí acertaron.
- Belleza: seis líneas contienen toda la idea. Los world models posteriores conservan una o más de esas líneas y cambian la tabla por una red miles de millones de veces más grande.
Una perspectiva es la mía, y la marco como tal. Shepherd's Academy of War toma su imagen del informe de David a Saúl: "Your servant was keeping his father’s sheep; and when a lion or a bear came, and took a lamb out of the flock, I went out after him, and struck him, and rescued it out of his mouth…" (1 Samuel 17:34–35, WEB). Un pastor que aprende los hábitos del depredador para proteger al rebaño es, en mi fe, una imagen del amor que hace la tarea. La lista de comprobación anterior se sostiene incluso sin esa creencia.
Errores que son medio ciertos
- "Un world model es un generador de video." Algunos world models generan video, pero el de CS229 es una tabla de conteos y un planificador. Lo que lo define es planificar con un modelo aprendido, no con imágenes.
- "Los world models más grandes siempre ayudan." Solo si el mundo tiene estructura que capturar. La fila del wanderer es la prueba en pequeño: recuerda al pastor que nunca aprendió y aun así obtuvo 88%.
- "MuZero aprendió el juego." Aprendió lo que la planificación necesitaba (política, valor, recompensa), que es menos, y más inteligente.
Ahora enséñalo
Tu turno de enseñar. Siéntate con un niño de 7 a 11 años y abre Shepherd's World Model en modo para niños. Deja que el niño elija el hábito secreto del lobo sin decírtelo, y luego presionen juntos "Ver una noche" varias veces. Antes de cada noche, pregúntale a dónde cree que irá el lobo y dónde debería colocarse el pastor. Después de diez noches, pregúntale qué ha aprendido el pastor. Este es el formato del ejercicio de Shepherd's Academy of War, parte 5.
Resultado: el niño predice el próximo movimiento del lobo antes de que el pastor actúe, y puede decir en una frase lo que aprendió el pastor (por ejemplo: "el lobo baja por el río"). Publica la edad del niño y esa frase como comentario en este artículo. Se cuenta en el ledger de señales de Shepherd's Academy of War como un ejercicio de demostración del pastor, separado del ejercicio semanal en auto de SAW.
Por qué importa: los cinco porqués
El problema: un ingeniero quiere trabajar en world models y no sabe por dónde empezar, porque la mayoría de los papers destacados parten de miles de millones de parámetros.
- ¿Por qué los papers destacados empiezan tan grandes? Los resultados principales se logran a gran escala: los parámetros de Genie 11B (Bruce et al. (2024), Genie, arXiv 2402.15391), y DreamerV3 en Nature (Hafner et al. (2025), Mastering diverse control tasks through world models, Nature 640).
- ¿Por qué empezar en grande dificulta entender? A esa escala no puedes distinguir qué parte hace el trabajo: el modelo, el planificador o los datos.
- ¿Por qué? Porque las partes están entrelazadas en una sola red. En el ciclo de CS229 son líneas separadas que puedes desactivar una por una (Ma & Ng, CS229 Lecture Notes, eq. 19.5 (p. 233)).
- ¿Por qué importa poder desactivar partes? Así es como descubres qué es lo que realmente importa. La línea base que nunca aprende y la fila del wanderer son justo ese tipo de experimento, y Dyna señala la advertencia honesta: los modelos aprendidos son "ofttimes incorrect" (Traducción: a menudo incorrectos) (Sutton (1991), Dyna, ACM SIGART Bulletin 2).
- Causa raíz: los world models se enseñan de arriba hacia abajo. La solución es construir uno pequeño y completo, medirlo contra una línea base, romperlo a propósito y luego subir por la genealogía sabiendo qué añadió cada paso.
Ponte manos a la obra: ejecútalo esta semana
- Lee la consigna de preparación para enseñar.
- Haz un esquema en papel del método del pastor (Actividad 1, 5 minutos).
- Abre el Shepherd's World Model con los cuatro hábitos y completa tu propia versión de la tabla (10 minutos).
- Ejecuta la parte de conteo en Python, agrégale las acciones del pastor y luego modifícala a propósito para que falle (15 minutos).
- Realiza la dinámica familiar con un niño y comparte el resultado.
Cómo saber si funcionó
- Puedes recitar de memoria el ciclo de la sección 19.3 de CS229 en cuatro pasos.
- Puedes explicar por qué la fila del wanderer apenas mejora.
- Cambiando una suposición en el código, puedes decir qué falló y por qué.
El aprendizaje basado en simulaciones tiene evidencia sólida en educación superior: g = 0.85 en 145 estudios (Chernikova et al. (2020), Simulation-based learning in higher education, Review of Educational Research 90). Eso aplica a estudiantes que usan simulaciones, no a niños, y no a construir una, así que toma la dinámica familiar como una prueba, no como una promesa. Los estudios sugieren que los niños pequeños construyen mapas causales de su entorno: "2- to 4-year-old children construct new causal maps" (Traducción: Niños de 2 a 4 años construyen nuevos mapas causales)" (Gopnik et al. (2004), A theory of causal learning in children, Psychological Review 111). El ejercicio pregunta si eso se refleja cuando intentan predecir al lobo.
Feedforward: trampas y alertas, decididas desde ahora
- Si tu modelo aprendido supera la línea base por menos que el ruido entre semillas, todavía no has aprendido nada. Prueba con más semillas antes de afirmar un resultado, y revisa siempre si el pastor que nunca aprende ya gana.
- Si llamas a algo world model, di explícitamente qué línea ejecuta. Contar, planear, soñar o generar video son afirmaciones distintas.
- Si citas un resultado famoso sin su matiz, vuelve a ponerle el matiz ("to our knowledge", "a few minutes").
Autoevaluación 5S
| S | Afirmación | Evidencia |
|---|---|---|
| Simple | El texto se entiende con un nivel equivalente a grado 13 o más fácil. | Nivel Flesch–Kincaid del texto: 7.3 (banda ≤ 13), recalculado por node scripts/check-numbers-four-ages.mjs --series world-models-cs229 |
| Sólido | Cada afirmación citada viene de una fuente comprobada y con su matiz; cada número de la demo se reproduce con semilla 1. | DreamerV3 "to our knowledge" (Nature); demo con semilla |
| Agudo | Un world model solo es tan útil como la estructura que haya en el mundo que modela; seis líneas encierran todo el ciclo. | la fila del wanderer · las seis líneas |
| SMART | Esta semana: cuatro hábitos, una suposición rota, un ejercicio familiar. | Operar |
| Sorpresa | El lobo casi aleatorio es justo del que menos aprende el pastor, y ahí está la lección. | Actividad 2 |
| Verdad · Amor · Belleza | Verdad con semilla, un niño a quien enseñar y seis líneas que escalan. | Verdad, amor y belleza |
Fuentes
- Ma, T. & Ng, A. CS229 Lecture Notes, Stanford, primavera de 2026 (sección 19.3, pp. 232–234; 20.4; 11.5; 14; 8.2). cs229.stanford.edu
- Craik, K. (1943). The Nature of Explanation, citado en Quanta Magazine (2025). quantamagazine.org
- Kalman, R. E. (1960). A New Approach to Linear Filtering and Prediction Problems. J. Basic Eng. 82. Crossref
- Sutton, R. S. (1991). Dyna. ACM SIGART Bulletin 2. OpenAlex
- Ha, D. & Schmidhuber, J. (2018). World Models. arXiv:1803.10122
- Schrittwieser, J. et al. (2020). MuZero. Nature 588. nature.com
- Hafner, D. et al. (2025). Mastering diverse control tasks through world models. Nature 640. nature.com
- Bruce, J. et al. (2024). Genie: Generative Interactive Environments. arXiv:2402.15391
- Google DeepMind (2025). Genie 3. deepmind.google
- NVIDIA (2025). Cosmos World Foundation Model Platform for Physical AI. arXiv:2501.03575
- OpenAI (2024). Video generation models as world simulators (abstract via MIT CSAIL). csail.mit.edu
- Kingma, D. P. & Welling, M. (2013). Auto-Encoding Variational Bayes. arXiv:1312.6114
- Ho, J., Jain, A. & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. arXiv:2006.11239
- Belkin, M., Hsu, D., Ma, S. & Mandal, S. (2019). Reconciling modern machine-learning practice and the classical bias–variance trade-off. arXiv:1812.11118
- Nakkiran, P. et al. (2019). Deep Double Descent. arXiv:1912.02292
- Chernikova, O. et al. (2020). Simulation-based learning in higher education. Review of Educational Research 90. doi:10.3102/0034654320933544
- Gopnik, A. et al. (2004). A theory of causal learning in children. Psychological Review 111. PubMed
- Kobayashi, K. (2024). Interactive learning effects of preparing to teach and teaching. Educational Psychology Review. ERIC EJ1414484
- 1 Samuel 17:34–36, World English Bible. bible-api.com