AI 原生系列 · Agent 工程
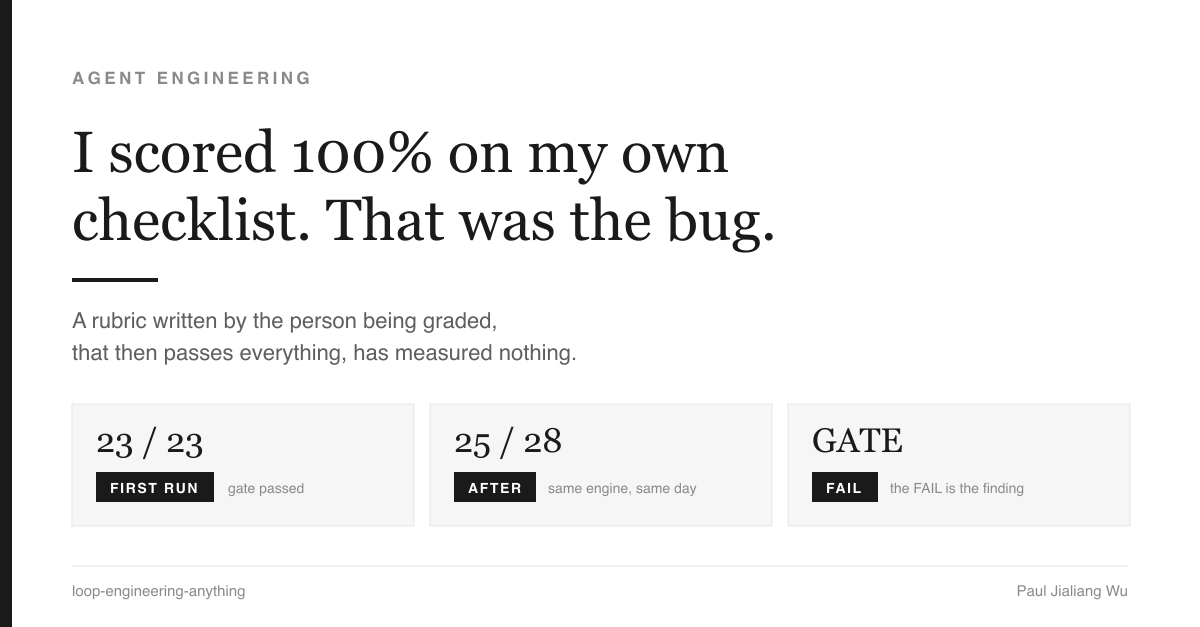
我给自己的检查清单打了 100 分,问题就出在这满分上
一场讲座列出了一个正经的 AI 智能体循环(agent loop)必须具备的十六件事。我把这份清单变成一份机器可核查的评分标准,拿去对照自己的引擎,结果全部通过。满分不是证据,它不过是一张收据,记着你挑了哪些问题来问。
一分钟读完
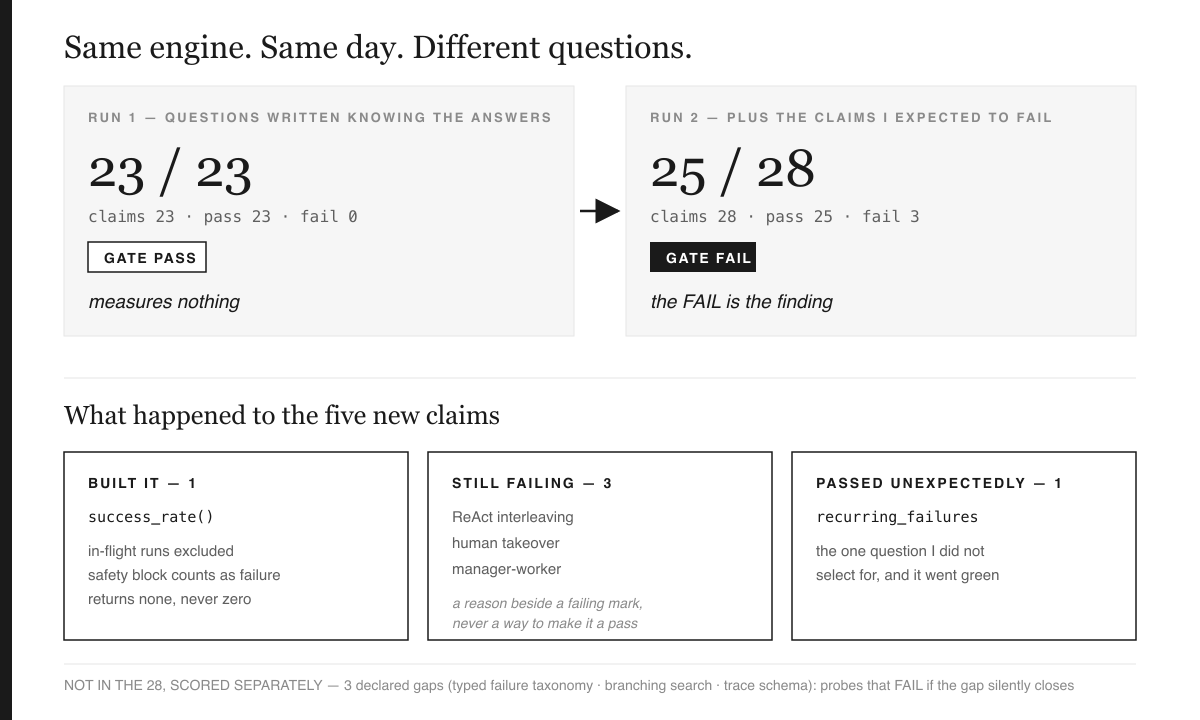
有人给我发来一份讲得不错的讲座总结,讲的是如何搭建可靠的 AI agent——十六个章节,讲的都是一个成熟系统「必须」做到的事。它没有拿真实软件去验证任何一条,于是我把它编码成一份检查清单,让我的引擎可以被自动打分。第一次跑分:23 分满分 23 分。可我是看着答案写的题目。于是我回到讲座原文,找出那些我不动声色跳过的论断——那些我预期会不及格的——诚实的分数变成了 25 分(满分 28),闸门变红。有一处不及格顺手就补上了;三处仍然是红色;另外还有三个缺口被单独列了出来,如今终于被摆到明面上。
这场讲座
一位读者转发了一份网络研讨会总结,标题是 Agent Loop Engineering。这份总结确实写得好。它从提示工程讲到上下文工程,再讲到循环工程,并指出真正有趣的问题已经变了:不再是“我该对模型说什么”,而是“系统如何行动、观察、判断,并再次尝试”。
它的十六个章节读起来像一份规格说明书。一个循环需要一个目标、模型之外的状态、一个策略、一个有边界的行动空间、观察和评估。它需要明确的退出条件。它需要在重试之前先对错误分类。它需要在高风险时刻有人类介入。它需要统计 token 数、时间、迭代次数以及成功率。
这份讲座对自己的定位也异常坦诚——[1]:
"Agent Loop Engineering目前更适合作为一种工程实践和设计思想来理解,而不是一个已经高度标准化、具有唯一严格定义的技术标准。"
Agent Loop Engineering is better understood, for now, as an engineering practice and a design philosophy rather than a highly standardised technical standard with a single strict definition.
我很欣赏这句话,但它同时也是漏洞所在。十六个章节列出了一个系统该有什么,却没有一行证据能证明哪个具体系统真的做到了。所谓分类法,说到底就是一堆抽掉了验证环节的主张。
我手上正好有一个自称正是这种东西的引擎——一个能生成、判断、重构并收敛的循环。于是显而易见的做法是:别再读清单了,直接跑一遍。
把一篇文章变成一道闸门
我自己的方法论可以浓缩成一句话:a rubric is a closed loop in disguise — the rubric is the score.(中译:评分标准本质上是一个隐藏的闭环——评分标准本身就是分数。)由此引出三条规则,也是整套设计的全部内容。
主张变成数据,而不是代码。十六个章节中有十三个能提炼出可检验的主张——框架部分、编码智能体演示部分和结尾部分都没产出任何可检验内容——这些主张被写进一个 YAML 文件,一条对应一个主张。检查器只读取这个文件,别的什么都不读,因此公开的分数永远不会偏离它声称在评分的那些主张。
证据靠观察得出,绝不能靠断言。每一条主张都配有一个探针:要么是必须存在于真实文件、真实行号处的一个符号,要么是一项真正被执行过的测试——而不仅仅是躺在硬盘上。输出会记录它查看了哪里、发现了什么。
"I could not look" is not "it works."(中译:“我没能查看”不等于“它是有效的”。)如果某个探针跑不起来,这一项就被标记为无法测量:既不计入百分比,也会阻断整体通过。这正是大多数清单悄悄违反的规则——如果放任不管,一个跑不起来的检查项,和一个通过了的检查项,其实没什么两样。
- id: L16-safety-terminal
  claim: "A safety failure is terminal and unbypassable, whatever the score."
  probe: {type: grep, pattern: "BLOCKED_SAFETY", paths: ["src/loopeng/loop/convergence.py"]}

# ... two entries omitted; each real item also carries the lecture section it came from

- id: L19-hitl-unbypassable
  claim: "An unattended run cannot pre-confirm its own result."
probe: {type: pytest, node: "tests/test_run_contract.py::test_contract_can_never_disable_the_human_gate"}我跑了一遍——满分通过。[4]。二十三条声明,全部通过,闸门显示绿灯。
该起疑的那一刻
满分带来的好心情,只撑了大约四秒钟。
然后我反应过来:这些问题是我自己写的。而且是我在花了一个小时钻研代码库之后才写的。我从没写过一个自己预期会翻车的问题。我搭出来的不是一套评估体系,而是一面打磨得很精致、外加测试覆盖率的镜子。
这种现象在测量学文献里是有名字的。Donald Campbell 1979年那篇关于计划性社会变革的研究[2]认为,一个量化指标被用来做决策的程度越高,它就越容易承受压力,从而扭曲它本该监测的那个过程。(这个论点广为流传的那句「金句」版本到处都是;原文在付费墙后面,所以我这里是在转述他的论点,而非替他造句。)Steven Kerr 那篇《On the folly of rewarding A, while hoping for B》 [3]则说出了这件事在操作层面的另一半:系统可靠地产出的,是你实际打分的那个东西,而不是你原本想要的那个东西。
这两项研究通常都是用来解释「别人」如何操纵指标的。但更尖锐的版本其实离我们更近:当评分标准的作者同时也是被评系统的主人时,根本不需要作弊。没有人在弄虚作假,真正的筛选发生得更早、也更「舒服」——就在你决定哪些问题值得写下来的那一刻。
回头找那些我跳过的问题
于是我重读了那篇讲座,这次只找我没有编码进去的声明,并且用一个故意不友好的标准来挑:只要我预期它会失败,就把它收进来。
结果找回来五条——四条是我预料会失败的,还有一条不是。
ReAct 式交替推理(第5节):推理与行动以细粒度交替进行。我的循环没有做到这一点。人类接管(第12节):讲座指出,人可以直接接管正在运行中的任务,而不只是对结果进行审批。我的系统做不到。管理者—工作者层级结构(第11节):由一个管理者智能体拆解任务,分给多个工作者执行。我的系统里没有这种东西。任务成功率(第 14 节):讲座要求同时统计 tokens、时间、迭代次数,以及成功率。我每次运行只记录了前三项,第四项根本不存在。
第五项,是我原本会赌自己失败的一项:这个引擎能否发现跨运行反复出现的失败,从而不再重复同一个错误?能做到——靠的是一个模块recurring_failures,几个月前就已经上线了。这一项通过了。二十三条主张变成了二十八条,我还意外收获了一条没被我选中却存在的好消息。
分数从 23/23 变成了 25/28——主张一加进去就是 24/28,等我把下一节里最容易补的那个漏洞补上后变成 25——闸门变红了。这个失败,是这次练习里我第一个真正相信的产出。
我修好的那一项,以及决定一个数字是否诚实的两行代码
四个不合格项里,有一个既便宜又确实有用:跨运行的成功率。引擎记录了每次运行完成后的结果,却从来没拿去做过除法。
写代码只花了十分钟,真正花时间的是决定“什么才算数”——因为成功率这种指标,最容易被美化。
仍在运行中的任务,要从分母里剔除。 把它算作失败,是在惩罚你手头还有进行中的工作;把它算作成功,则是一句延迟兑现的谎言。所以它被单独报告,不计入分母。
被安全闸门中止的运行,算作失败。 这一条让人不舒服,却也最重要。安全阻断意味着这项工作没有交付。如果成功率悄悄放过这些情况,这个指标奖励的正好就是安全闸门存在的目的所要阻止的结果——那我等于造出了一个数字:引擎因为「太危险」被叫停时,它反而会上升。
而当没有任何运行完成时,它返回的是「无」,而不是零。零读出来是「我们试过,但失败了」;无读出来是「我们还没有测量」。这是两句不同的话,仪表盘绝不该把它们混为一谈。
审计文件里那行结论式标题,是生成出来的,不是我手打的——docs/rubrics/AUDIT.md:
**Conformance: 25/28 (89%)** verifiable claims implemented · 3 declared gaps · 0 unmeasured · gate **FAIL**这份评分表一共包含三十一项:二十八条可验证主张,得分 25/28;外加三个单独计分、绝不并入该分数的已声明缺口。
有理由的不合格,依然是不合格
另外三项仍然是红色,说实话我一度很想给它们重新分类。其中两项其实是刻意的取舍,不是疏忽。
ReAct 让执行模型自己判断下一步该怎么做。我这个引擎的立身之本是:搭建的人绝不评分——如果整体照搬 ReAct,就会打破我最信赖的这条属性。管理者—工作者式协作同样是一种选择:我用的是带环检测的显式依赖图,能在任何东西运行之前……任何东西运行之前就能被检查,不必等一个经理在运行时临场发挥。
两者都说得通,但都算不上通过。所以这份评分表现在带有一个rationale字段,专门记录红叉旁边的理由;同时刻意不设任何机制,把一条理由变成绿灯。一份作者可以把失败解释过去的清单,等于什么都没评——这恰恰是我那天早上已经犯过一次的错误。
第三项,人类接管,没什么巧妙说辞可以开脱:这是个真实的缺口。我的闸门只在任务结束时批准,没有任何通道能介入一个已经在运行中的循环。值得做,但还没做。
缺口一旦补上,就该判它不及格
还有一类,是我认为最值得你偷师、用在自己清单上的部分。
讲座暗示、而我的引擎确实没有的三样东西——类型化的失败分类法、分支搜索、片段级别的追踪 schema——被写进了评分表,列为已声明的缺口。它们的探针断言的是「不存在」:只要缺口真实存在,就算通过;而一旦缺口悄悄被补上,探针就会失败。
这听起来反直觉,直到你亲眼见过一条写在文档里的局限性,是怎么悄悄变成假话的。有人在一个旁支分支里加了追踪功能,README 里「我们没有追踪」那行却照样挂了一年;读者照着一个早已不存在的限制去做规划。把缺口清单变成可执行的,就是让这份文档不可能在无人察觉时悄悄腐坏——总会有什么东西变红,提醒你一声。
该做的,不该做的
该做的:先写下你预期会失败的问题;把断言当作数据,只让一个程序去读取它们;让证据落在具体的文件和行号上,或者落在一次真正跑过的测试上;把跑不起来的检查项当作阻断项,绝不当作通过项;让理由安静地待在红叉旁边,别把它变绿;让你声明的缺口可执行,一旦不再成立就报错。
不该做的:为自己拥有的系统写评分表,却不放进一个你真正害怕的问题;把一份分类法当审计来读;把还在进行中的工作计入成功率;搞一项安全闸门一触发反而变好看的指标;把「未测量」报告成零;搞一份只能靠人记得去更新的缺口清单。而贯穿以上所有问题的根本毛病是:把一个绿勾当证据,却不追问它到底能看见什么。
这套机制,一句话说清
这套机制的核心是撰写阶段的取舍(selection at authoring time):一套测试体系的上限,不取决于跑起来多严格,而取决于作者愿意写下哪些问题——这个取舍,发生在任何代码运行之前,发生在私下里,没有一个红叉能让它现形。
第一条原则:一份不能让作者自己失手的清单,不是评估,是一面镜子——所以唯一值得信任的分数,只能来自一份你在看到答案之前就已写死、事后无权再挑拣的清单。
本文未曾主张的事
- 89% 不是一个质量分数。 它只是与某一场网络研讨会的分类体系相符,而这套体系既不详尽也不具权威性——讲座本身就是这么说的。
- 这份评分表依然是我自己写的。 加入我预期会不及格的问题,能让它变得更好,但不能让它变得独立。若由别人来写,或是从原文机械推导而成,会更有说服力——但我没有这么做。
- 有三项仍是红色、未解决,其中一项(人类接管)除了被点名之外,目前还没有任何解决计划。
- 一台引擎,一个作者。 这次审计针对的是我自己的代码仓库;你的失败模式会不一样。
结语:数字配得上被引用吗
每一个认真做事的团队,都即将写出这么一份东西。AI 智能体这个领域正在以惊人的速度产出各种清单——成熟度模型、就绪度框架、十六节的分类体系——而这些清单,几乎全都会由打造被评分对象的那群人来打分。
你会得到一个漂亮的数字,但你配得上的部分,少之又少。
最便宜的修复办法,一个下午就够:在跑你的清单之前,先写下你最不希望有人问出口的那三个问题,把它们加进去。如果结果依然是绿色的,你就学到了一点真东西;如果它变红了——就像我自己的引擎在同一天早上发生的那样——那么这个数字才第一次真正值得被引用。
参考文献
- 《AI开发进入新时代:Agent Loop Engineering — 讲座总结》,DataApplab / AI聘(info@aipin.io),网络研讨会摘要,收到于 2026-08-20。逐字引自原始邮件;下方的英文译文出自我手,并标注为译文,而非作者本人的原话。
- Donald T. Campbell,Assessing the Impact of Planned Social Change,《Evaluation and Program Planning》,2(1),1979,第 67–90 页。 这里只做转述,不直接引用: 原文在付费墙后,而且大家常挂在嘴边的那句「名言」经过太多层转手,我没读过原文,不敢给它加引号。
- Steven Kerr, 《On the Folly of Rewarding A, While Hoping for B》。原载于 Academy of Management Journal,18(4),1975;我核实过的版本是收录于 《The Academy of Management Executive》 的重刊本,1995 年 2 月,9(1),第 7 页。标题与出版信息均对照该 PDF 核实过;我引用的是重刊版本,因为那是我实际读过的那份。
- 评分表、检查脚本以及完整的审计输出:docs/rubrics/agent-loop-engineering.yml,
scripts/audit_loop_rubric.py,以及docs/rubrics/AUDIT.md位于 github.com/wjlgatech/loop-engineering-anything。第二轮的每一个数字——25/28、三项已声明缺口、零项未测量、gate FAIL——都可以通过运行该脚本复现。第一轮同样能复现,对照的是那份归档版评分表:--rubric docs/rubrics/archive/agent-loop-engineering.v1.yml会返回 23/23,gate PASS。那份归档是事后补建的重建版本,不是找回的原始文件,文件头里也写明了这一点。
写于 2026-08-21。23/23 那一轮和 25/28 这一轮,其实是同一天、同一个引擎跑出来的结果;变的只是评分表本身。这里得做一个更正,否则这篇文章自己都过不了自己定的标准:我最初写这篇文章时,那份 23 项的评分表其实从未被提交过版本库。全世界能找到的 23/23 的唯一痕迹,是我自己写下的文字——一条 commit message、一行 YAML 注释。一位独立审阅者发现了这一点,而他说得对:在一篇论证「可观测和被断言之间的差异就是一切」的文章里,我自己的头条数字,却恰恰只是被断言、而非可观测的。现在它已经作为一个明确标注的重建版本提交,并可一条命令重跑复现 [4].