Serie AI-Native · Ingeniería de Agentes
Obtuve 100% en Mi Propia Rúbrica. Ese Era el Problema.
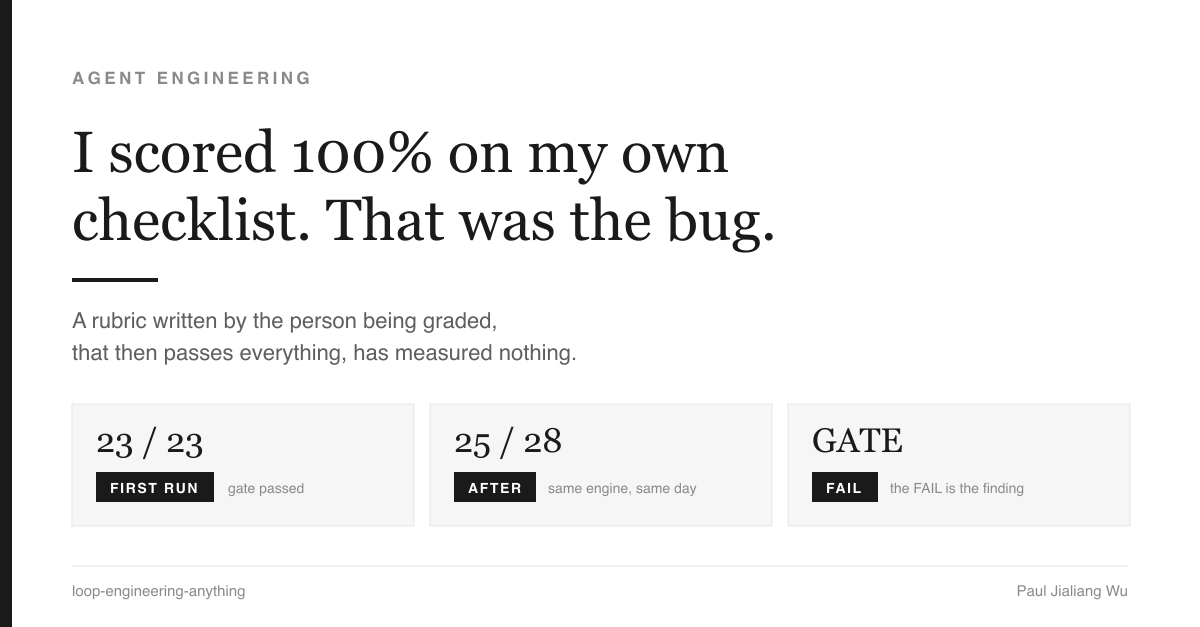
Una conferencia enumeró dieciséis cosas que debe tener un loop de agentes de IA serio. Convertí la lista en una rúbrica verificable por máquina, la apunté hacia mi propio motor, y aprobó todo. Un puntaje perfecto no es evidencia. Es un comprobante de las preguntas que elegiste hacer.
Un minuto
Alguien me envió un buen resumen de una conferencia sobre cómo construir agentes de IA confiables: dieciséis secciones de lo que un sistema maduro debe hacer. No verifica nada de eso contra software real, así que lo codifiqué como una rúbrica contra la cual mi motor pudiera calificarse automáticamente. Primera corrida: 23 de 23. Había escrito las preguntas mientras miraba las respuestas. Así que volví a la conferencia por las afirmaciones que había omitido calladamente —las que esperaba que reprobaran— y el puntaje honesto se convirtió en 25 de 28, con la compuerta en rojo. Un fallo merecía cerrarse de inmediato; tres se quedaron en rojo, y tres brechas adicionales se declaran por separado y ahora lo dicen abiertamente.
La conferencia
Un lector reenvió el resumen de un webinar titulado Agent Loop Engineering. Es genuinamente bueno. Recorre desde la ingeniería de prompts hasta la ingeniería de contexto y la ingeniería de loops, y argumenta que el problema interesante se ha desplazado: ya no es "qué le digo al modelo", sino "cómo actúa, observa, juzga e intenta de nuevo el sistema".
Sus dieciséis secciones se leen como una especificación. Un agent loop necesita un objetivo, un estado fuera del modelo, una política, un espacio acotado de acciones, observación y evaluación. Necesita salidas explícitas. Necesita clasificar los errores antes de reintentarlos. Necesita un humano en los momentos de alto riesgo. Necesita contar tokens, tiempo, iteraciones y tasa de éxito.
La conferencia también es inusualmente honesta sobre su propio estatus: [1]:
"Agent Loop Engineering目前更适合作为一种工程实践和设计思想来理解,而不是一个已经高度标准化、具有唯一严格定义的技术标准。"
Agent Loop Engineering is better understood, for now, as an engineering practice and a design philosophy rather than a highly standardised technical standard with a single strict definition. (Traducción: Por ahora, Agent Loop Engineering se entiende mejor como una práctica de ingeniería y una filosofía de diseño que como un estándar técnico altamente estandarizado con una única definición estricta.)
Aprecié esa frase, y ahí también está el vacío. Dieciséis secciones de lo que un sistema debe tener, y ni una sola línea de evidencia de que algún sistema en particular lo tenga. Una taxonomía es un conjunto de afirmaciones a las que se les quitó la verificación.
Tengo un motor que afirma ser exactamente eso: un agent loop que genera, juzga, refactoriza y converge. Así que el movimiento obvio era dejar de leer la rúbrica y ejecutarla.
Convertir un ensayo en una compuerta
Mi propio manual para esto cabe en una línea: una rúbrica es un agent loop cerrado disfrazado — la rúbrica es el puntaje. De ahí se derivan tres reglas, y son todo el diseño.
Las afirmaciones se vuelven datos, no código. Trece de las dieciséis secciones producen afirmaciones verificables (el planteamiento, el recorrido del agente de código y el cierre no producen ninguna) y esas se convierten en un archivo YAML, una entrada por afirmación. El verificador lee ese archivo y nada más, así que el puntaje publicado nunca puede alejarse de las afirmaciones que dice estar evaluando.
La evidencia se observa, nunca se declara. Cada afirmación lleva una sonda: un símbolo que debe existir en un archivo y una línea reales, o una prueba que efectivamente se ejecuta, no que simplemente esté presente en el disco. La salida registra dónde buscó y qué encontró.
"No pude comprobarlo" no es lo mismo que "funciona". Si una sonda no puede ejecutarse, el ítem queda sin medir: se excluye del porcentaje y bloquea. Esta es la regla que la mayoría de las rúbricas rompe calladamente, porque una sonda que no se puede ejecutar es indistinguible de una que pasa, si se lo permites.
- id: L16-safety-terminal
  claim: "A safety failure is terminal and unbypassable, whatever the score."
  probe: {type: grep, pattern: "BLOCKED_SAFETY", paths: ["src/loopeng/loop/convergence.py"]}

# ... two entries omitted; each real item also carries the lecture section it came from

- id: L19-hitl-unbypassable
  claim: "An unattended run cannot pre-confirm its own result."
  probe: {type: pytest, node: "tests/test_run_contract.py::test_contract_can_never_disable_the_human_gate"}
La ejecuté [4]. Veintitrés afirmaciones, veintitrés aprobadas, compuerta en verde.
El momento de sospechar de mí mismo
Un puntaje perfecto se sintió bien durante unos cuatro segundos.
Luego: yo escribí estas preguntas. Las escribí después de pasar una hora dentro del código. En ningún momento escribí una pregunta que yo creyera que volvería en rojo. Lo que había construido no era una evaluación; era un espejo bien construido, con cobertura de pruebas.
Esto tiene nombre en la literatura sobre medición. El estudio de 1979 de Donald Campbell sobre el cambio social planificado [2] sostiene que cuanto más se usa un indicador cuantitativo para tomar decisiones, mayor es la presión que recibe para distorsionar el mismo proceso que debía vigilar. (La famosa versión de una sola frase de ese argumento circula por todas partes; el original está tras un muro de pago, así que estoy describiendo su argumento en vez de ponerle palabras en la boca.) El texto de Steven Kerr, On the folly of rewarding A, while hoping for B [3] plantea la otra mitad, la operativa: los sistemas producen de manera confiable aquello que de verdad mides, no aquello que querías decir.
Ambos suelen invocarse para explicar cómo otras personas manipulan una métrica. La versión más aguda golpea más cerca: te toca a ti. Cuando el autor de la rúbrica es también el dueño del sistema, no hace falta hacer trampa. No hay engaño de por medio. La selección ocurre antes y con más comodidad, en el momento en que decides qué preguntas vale la pena escribir.
Volver por las preguntas que me salté
Así que releí la charla buscando solo las afirmaciones que no había codificado, y las elegí con un criterio deliberadamente hostil: incluirla si esperaba que fallara.
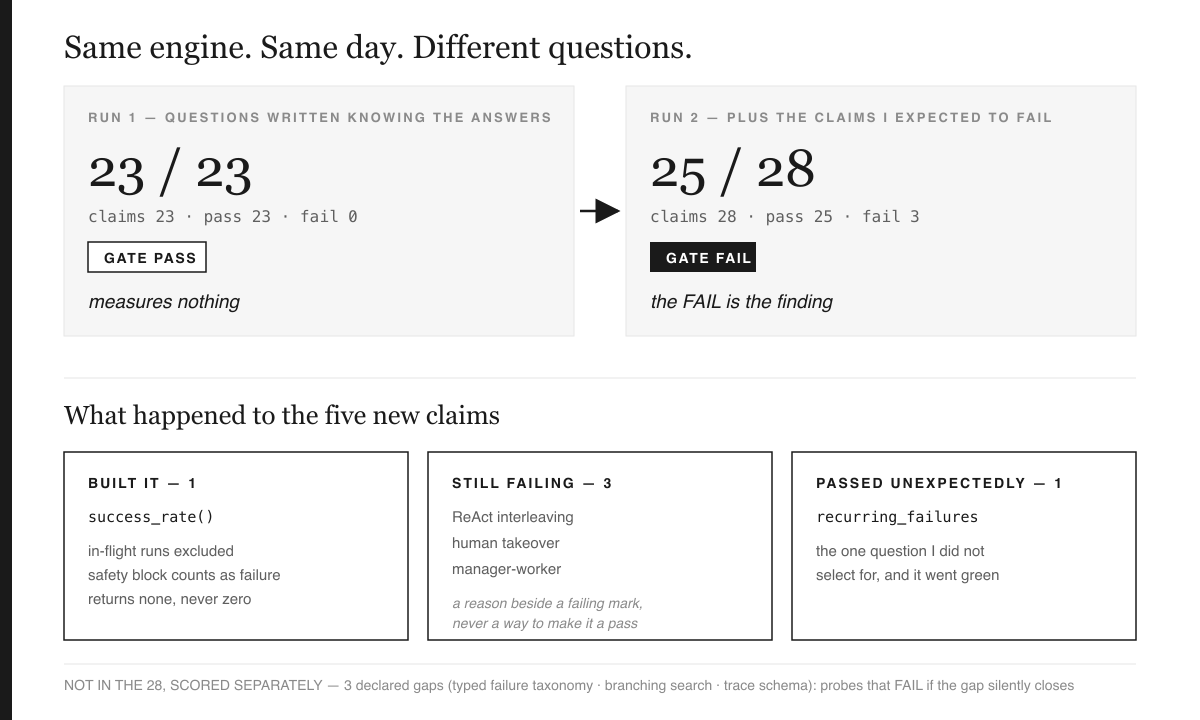
Volvieron cinco: las cuatro que esperaba que fallaran, y una que no.
Intercalado al estilo ReAct (sección 5): razonar y actuar alternándose con granularidad fina. Mi agent loop no hace esto. Toma de control humana (sección 12): la charla dice que una persona puede tomar el control de una tarea en marcha, no solo aprobar el resultado. El mío no puede. Jerarquía manager-worker (sección 11): un agente gestor que descompone el trabajo para agentes trabajadores. El mío no tiene nada de eso. Tasa de éxito de tareas (sección 14): la charla pide tokens, tiempo, iteraciones y tasa de éxito. Tenía las tres primeras por corrida, y la cuarta no existía en ningún lado.
La quinta era aquella en la que yo mismo habría apostado en contra: ¿el motor identifica fallas que se repiten entre corridas, de modo que deja de cometer el mismo error dos veces? Sí lo hace — recurring_failures, lanzado meses antes. Cumplió. Veintitrés afirmaciones se convirtieron en veintiocho, y obtuve exactamente una buena noticia que no había buscado.
El puntaje pasó de 23/23 a 25/28 —24/28 en el instante en que se incorporaron las afirmaciones, 25 una vez que cerré el fallo más barato en la siguiente sección— y la compuerta se puso en rojo. Ese fallo es el primer resultado de este ejercicio que realmente me creo.
La que arreglé, y las dos líneas que deciden si un número es honesto
De los cuatro fallos, uno fue barato y genuinamente útil: una tasa de éxito entre corridas. El motor registraba el resultado de cada corrida terminada; nada se dividía nunca.
Escribirlo tomó diez minutos. Decidir qué cuenta tomó más tiempo, porque una métrica de éxito es lo más fácil de adular en un sistema.
Una corrida todavía en curso queda excluida del denominador. Contarla como fracaso te castiga por tener trabajo en progreso; contarla como éxito es una mentira con retardo. Se reporta por separado y se deja fuera.
Una corrida detenida por la compuerta de seguridad cuenta como fracaso. Esta es incómoda y es la importante. Un bloqueo de seguridad significa que el trabajo no se envió. Si la tasa perdonara eso en silencio, la métrica premiaría exactamente el resultado que la compuerta de seguridad existe para producir —y yo habría construido un número que sube cuando mi motor se detiene por ser peligroso.
Y cuando nada ha terminado, no devuelve cero sino nada en absoluto. Cero se lee como "lo intentamos y fallamos". Nada se lee como "no hemos medido". Son oraciones distintas y un tablero nunca debería confundirlas.
La línea principal del archivo de auditoría, generada en vez de escrita a mano — docs/rubrics/AUDIT.md:
**Conformance: 25/28 (89%)** verifiable claims implemented · 3 declared gaps · 0 unmeasured · gate **FAIL**La rúbrica contiene treinta y un ítems en total: veintiocho afirmaciones verificables, con puntaje 25/28, más tres brechas declaradas que se puntúan por separado y nunca se incorporan a esa fracción.
Los fallos con razones siguen siendo fallos
Los otros tres se mantuvieron en rojo, y hubo una tentación real de reclasificarlos. Dos de ellos son, honestamente, divergencias deliberadas y no descuidos.
ReAct pone al modelo que actúa a cargo de juzgar su propio siguiente paso. La regla estructural de mi motor es que lo que construye nunca califica —así que adoptar ReAct por completo rompería la propiedad en la que más confío. La coordinación manager-worker es igualmente una elección: yo uso un grafo de dependencias explícito con rechazo de ciclos, que puede inspeccionarse antes de que nada se ejecute, en lugar de un manager improvisando en tiempo de ejecución.
Ambas posturas son defendibles. Ninguna aprueba. Así que la rúbrica ahora incluye un campo rationale que registra el razonamiento junto a la marca roja, y deliberadamente no hay ningún mecanismo para convertir una justificación en un verde. Una rúbrica en la que el autor puede justificar sus fallos es una rúbrica que no mide nada — precisamente el error que ya había cometido una vez esa misma mañana.
El tercer punto, la toma de control humana, no admite ningún encuadre ingenioso. Es una brecha real. Mi compuerta es de aprobación al final de la corrida; no hay ningún canal hacia un agent loop que ya está en marcha. Valía la pena construirlo. No está construido.
Brechas que fallan cuando se cierran
Hay una categoría más, y es la pieza que me robaría para cualquier rúbrica que tengas.
Tres cosas que la charla da por sentadas y que mi motor genuinamente no tiene —una taxonomía de fallos tipada, búsqueda por ramificación y un esquema de trazas a nivel de span— quedan escritas en la rúbrica como brechas declaradas. Sus sondas constatan la ausencia. Pasan mientras la brecha sea real, y fallan en el momento en que la brecha se cierra en silencio.
Suena al revés hasta que has visto cómo una limitación documentada se vuelve falsa sin que nadie se dé cuenta. Alguien agrega trazabilidad en una rama secundaria; la línea "no tenemos trazabilidad" del README se queda ahí un año; un lector planifica en función de una restricción que ya dejó de existir. Hacer que la lista de brechas sea ejecutable significa que el documento no puede pudrirse sin que algo se ponga en rojo.
Patrones y antipatrones
Patrones. Escribe primero las preguntas que esperas que fallen. Mantén las afirmaciones como datos y deja que un único programa las lea. Haz que la evidencia sea un archivo y una línea, o una prueba que realmente se haya ejecutado. Trata una sonda que no se puede correr como bloqueante, nunca como aprobada. Deja que una justificación conviva con una marca roja sin convertirla en verde. Haz que tus brechas declaradas sean ejecutables para que fallen en cuanto dejen de ser ciertas.
Antipatrones. Redactar una rúbrica para un sistema propio sin incluir ni una sola pregunta que temas. Leer una taxonomía como si fuera una auditoría. Contar trabajo en curso dentro de una tasa de éxito. Una métrica que mejora cuando se activa tu compuerta de seguridad. Reportar cero cuando en realidad es "no medido". Una lista de brechas que solo un humano recuerda actualizar. Y el patrón amplio detrás de todos ellos: tratar una marca verde como evidencia sin preguntarte qué fue realmente capaz de ver.
El mecanismo, en una frase
El mecanismo es la selección en el momento de redactar: el techo de una rúbrica no lo determina el rigor con que se ejecuta, sino qué preguntas su autor estuvo dispuesto a poner por escrito, y esa elección ocurre antes de que corra una sola línea de código, en privado, sin ninguna marca roja que la haga visible.
El primer principio: a checklist that cannot fail its author is not an assessment, it is a mirror (Traducción: una rúbrica que no puede reprobar a su autor no es una evaluación, es un espejo) — así que el único puntaje confiable es el que produce una lista que no pudiste curar después de ver las respuestas.
Lo que este artículo no afirma
- 89% no es una puntuación de calidad. Es conformidad con la taxonomía de un solo webinar, que no es ni exhaustiva ni autoritativa — la propia charla lo reconoce.
- La rúbrica sigue siendo mía. Agregar preguntas que esperaba que fallaran la mejora; no la vuelve independiente. Una rúbrica escrita por otra persona, o derivada mecánicamente del texto fuente, sería más sólida, y no he hecho eso.
- Tres ítems en rojo siguen sin resolver, y uno de ellos (la toma de control humana) no tiene plan más allá de haber sido nombrado.
- Un motor, un autor. La auditoría corre contra mi propio repositorio; tus modos de falla serán distintos.
La conclusión
Todo equipo serio está a punto de escribir una de estas. El campo de los agentes de IA está produciendo listas de verificación a un ritmo notable —modelos de madurez, marcos de preparación, taxonomías de dieciséis secciones— y casi todas serán calificadas por las mismas personas que construyeron lo que se está calificando.
Vas a obtener un buen número. Vas a merecer muy poco de él.
La solución más barata posible toma una tarde: antes de correr tu lista de verificación, anota las tres preguntas que esperas que nadie haga. Inclúyelas. Si el resultado sigue en verde, aprendiste algo real. Si se pone en rojo —como me pasó a mí, esa misma mañana, con mi propio motor—, entonces por primera vez el número vale la pena citarlo.
Referencias
- AI开发进入新时代:Agent Loop Engineering — 讲座总结, DataApplab / AI聘 (info@aipin.io), resumen de webinar recibido el 2026-08-20. Citado textualmente del correo original; la versión en inglés que aparece debajo es mía y está etiquetada como traducción, no como palabras del autor.
- Donald T. Campbell, Assessing the Impact of Planned Social Change, Evaluation and Program Planning, 2(1), 1979, pp. 67–90. Descrito, no citado: el original está detrás de un muro de pago, y la única frase que todo el mundo le atribuye se reproduce de segunda mano de forma tan generalizada que no la pondría entre comillas sin haber leído el artículo.
- Steven Kerr, On the folly of rewarding A, while hoping for B. Publicado originalmente en Academy of Management Journal, 18(4), 1975; el ejemplar que verifiqué es la reimpresión en The Academy of Management Executive, febrero de 1995, 9(1), p. 7. Título y datos de publicación cotejados con ese PDF; cito la reimpresión porque es la versión que realmente leí.
- La rúbrica, el verificador y la salida completa de la auditoría: docs/rubrics/agent-loop-engineering.yml,
scripts/audit_loop_rubric.py, ydocs/rubrics/AUDIT.mden github.com/wjlgatech/loop-engineering-anything. Cada número de la segunda corrida —25/28, tres brechas declaradas, cero sin medir, compuerta FAIL— es reproducible ejecutando ese script. La primera corrida también es reproducible, contra la rúbrica archivada:--rubric docs/rubrics/archive/agent-loop-engineering.v1.ymldevuelve 23/23, compuerta PASS. Ese archivo es una reconstrucción confeccionada a posteriori, no un original recuperado, y así lo indica en su propio encabezado.
Escrito el 2026-08-21. La corrida de 23/23 y la de 25/28 son el mismo motor el mismo día; solo cambió la rúbrica. Una corrección, porque este artículo no sobreviviría a su propio estándar si no la hiciera: cuando escribí esto por primera vez, la rúbrica de 23 ítems nunca se había registrado en el control de versiones. El único rastro de ese 23/23 en cualquier parte era prosa que yo mismo había escrito —un mensaje de commit, un comentario en YAML—. Un revisor independiente lo detectó, y tenía razón: mi cifra principal era una afirmación, no algo observable, en un texto que argumenta que esa diferencia lo es todo. Ahora está registrada como una reconstrucción etiquetada y se puede volver a ejecutar con un solo comando [4].