AI-Native Series · Agent Engineering
自作チェックリストで満点を取った。それがバグだった。
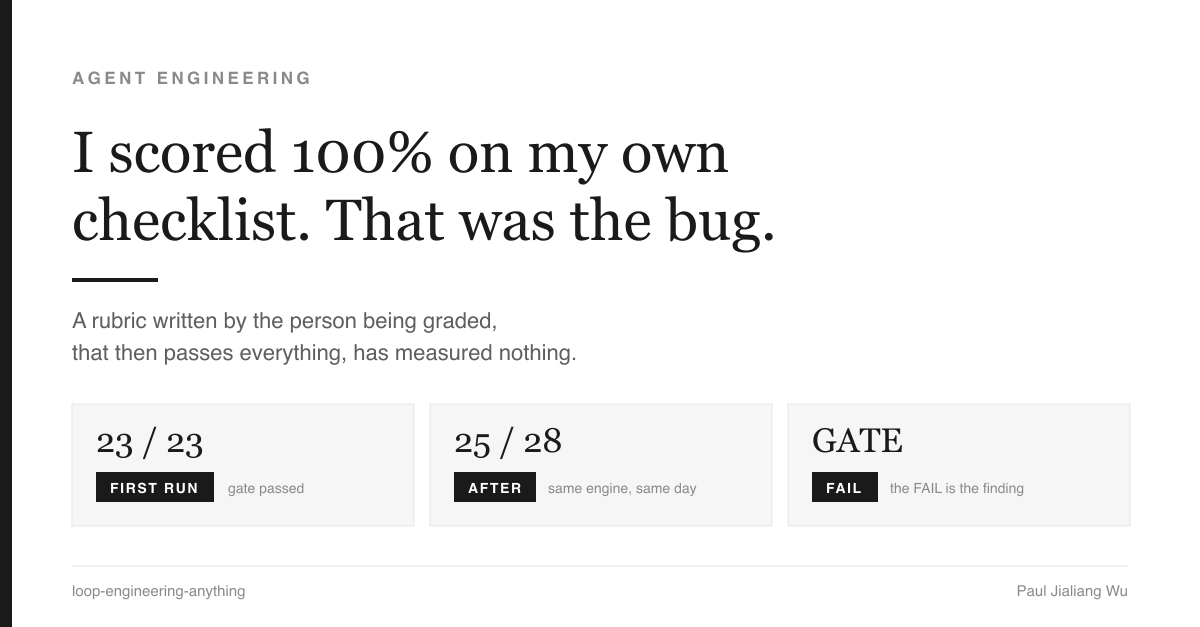
ある講義が、本格的なAIエージェントループが備えるべき16項目を挙げていた。私はそのリストを機械的に検証可能なルーブリックに変え、自分のエンジンに当ててみたところ、すべてに合格した。満点は証拠ではない。それは自分が選んで尋ねた問いに対する領収書にすぎない。
1分で読める
誰かが信頼できるAIエージェントの作り方について、よくまとまった講義の要約を送ってきた。成熟したシステムが満たすべき16のセクションだ。それは実際のソフトウェアに対して何ひとつ検証していなかったので、私はそれを自分のエンジンに対して自動採点できるチェックリストとしてエンコードした。最初の実行結果は23項目中23項目合格。つまり私は、答えを見ながら問いを書いていたのだ。そこで講義に戻り、こっそり見送っていた主張、失敗すると見込んでいたものを洗い出すと、正直なスコアは25/28となり、ゲートは赤になった。ひとつの不合格はその場で解消する価値があった。三つは赤のまま残り、さらに三つのギャップは別枠で宣言され、いまや堂々とそう明言されている。
講義について
ある読者が転送してくれたウェビナー要約のタイトルはAgent Loop Engineeringというものだった。実に良い内容だ。プロンプトエンジニアリングからコンテキストエンジニアリング、そしてループエンジニアリングへと話を進め、興味深い問題はすでに移り変わったと論じている。「モデルに何を言わせるか」ではなく、「システムはどう行動し、観察し、判断し、そして再挑戦するか」へと。
この講義の16のセクションは仕様書のように読める。ループにはゴール、モデル外部の状態、ポリシー、境界づけられた行動空間、観測、評価が必要だ。明示的な終了条件が必要だ。リトライする前にエラーを分類する必要がある。リスクの高い局面には人間が必要だ。トークン数、時間、イテレーション数、そして成功率をカウントする必要がある。
この講義はまた、自らの位置づけについて珍しく正直だ。[1]:
"Agent Loop Engineering目前更适合作为一种工程实践和设计思想来理解,而不是一个已经高度标准化、具有唯一严格定义的技术标准。"
Agent Loop Engineering is better understood, for now, as an engineering practice and a design philosophy rather than a highly standardised technical standard with a single strict definition.(訳:Agent Loop Engineeringは今のところ、唯一の厳密な定義を持つ高度に標準化された技術規格としてよりも、エンジニアリングの実践であり、設計思想として理解するほうがふさわしい。)
私はこの一文を評価しているし、同時にそこに穴があるとも思う。システムが備えるべきものを列挙した16のセクションがある一方で、特定のシステムがそれを実際に備えているという証拠は一行もない。タクソノミーとは、検証を取り除いた主張の集合にすぎない。
私にはまさにこれだと自称するエンジンがある。生成し、判定し、リファクタリングし、収束するループだ。であれば、やるべきことは明白だ。チェックリストを読むのをやめて、実際に走らせてみればいい。
エッセイをゲートに変える
この種の作業における私自身のプレイブックは一行に集約される。a rubric is a closed loop in disguise — the rubric is the score.(訳:ルーブリックとは正体を隠したクローズドループであり、ルーブリック自体がスコアなのだ。)そこから3つのルールが導かれ、それが設計のすべてだ。
主張はコードではなくデータになる。16のセクションのうち13が検証可能な主張を生み出す(導入部、コーディングエージェントのウォークスルー、結びの部分は何も生み出さない)。それらはYAMLファイルへと変換され、主張一つにつき一エントリとなる。チェッカーはそのファイルだけを読み、他は何も読まない。だからこそ、公表されるスコアが、それが評価していると謳う主張から乖離することは決してない。
証拠は観測されるものであり、主張されるものではない。それぞれの主張にはプローブが付随する。実際のファイルと行に存在しなければならないシンボル、あるいは実際に実行されるテストであり、ディスク上に存在するだけでは足りない。出力には、どこを見て、何を見つけたかが記録される。
"I could not look" is not "it works."(訳:「確認できなかった」は「動いている」ではない。)プローブが実行できない場合、その項目は未計測として扱われる。パーセンテージからは除外され、かつブロッキング(ゲートを止める)扱いになる。これはほとんどのチェックリストがひそかに破っているルールだ。実行不能なチェックを放置すれば、それは合格したチェックと見分けがつかなくなってしまうからだ。
- id: L16-safety-terminal
  claim: "A safety failure is terminal and unbypassable, whatever the score."
  probe: {type: grep, pattern: "BLOCKED_SAFETY", paths: ["src/loopeng/loop/convergence.py"]}

# ... two entries omitted; each real item also carries the lecture section it came from

- id: L19-hitl-unbypassable
  claim: "An unattended run cannot pre-confirm its own result."
probe: {type: pytest, node: "tests/test_run_contract.py::test_contract_can_never_disable_the_human_gate"}実際に走らせてみた[4]。23個の主張、23回のパス、ゲートは緑。
自分自身を疑うべき瞬間
満点の気分の良さは、4秒ほどしか続かなかった。
そこで気づいた。私はこれらの質問を書いた。しかも書いたのは、コードベースの中で1時間過ごした後だった。赤くなると思う質問を、私は一つも書かなかった。私が作り上げていたのは評価ではなく、テストカバレッジ付きのよくできた鏡だった。
これには測定論の文献でちゃんと名前がついている。Donald Campbellの1979年の計画的社会変化に関する研究[2]は、定量指標が意思決定に使われれば使われるほど、監視対象であったはずのプロセスそのものを歪める圧力にさらされる、と論じている(この議論のよく知られた要約版はあちこちに出回っているが、原典は有料の壁の向こうにあるため、ここでは彼の言葉をそのまま引用するのではなく、彼の議論を私なりに説明している)。Steven KerrのOn the folly of rewarding A, while hoping for B [3]は、この議論の実践面を突いている。すなわち、システムは意図したものではなく、実際に採点される対象を確実に生み出す、というものだ。
どちらも通常は、他人が指標をごまかす様を説明するために持ち出される。だがより鋭いバージョンは、もっと身近な話だ。ルーブリックの作者がシステムの所有者でもある場合、ごまかしなど必要ない。誰もズルなどしない。選別はもっと早く、もっと気楽に――どの質問を書き留める価値があるかを決める、その瞬間に起きているのだ。
見送っていた質問に立ち返る
そこで私は、自分がまだコード化していなかった主張だけを探して講義を読み返した。しかも選ぶ基準はわざと意地悪にした。失敗すると予想されるものを含めることにしたのだ。
戻ってきたのは五つ――失敗すると予想していた四つと、予想していなかった一つだ。
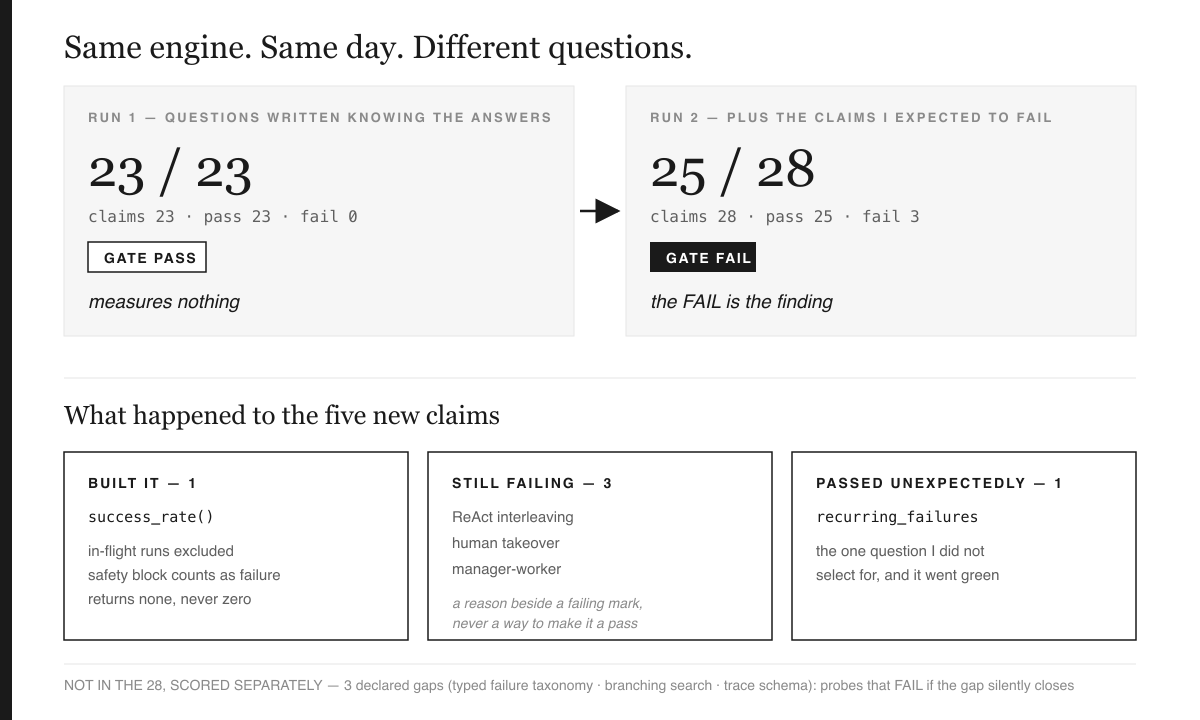
ReAct方式のインターリーブ(第5節):推論と行動が細かい粒度で交互に行われること。私のループはこれをやっていない。ヒューマン・テイクオーバー(第12節):講義では、人間が実行結果を承認するだけでなく、実行中のタスクを引き継ぐこともできるとされている。私のエンジンにはそれができない。マネージャー・ワーカー階層(第11節):マネージャーエージェントがワーカーのために作業を分解する仕組み。私のエンジンにはそんなものはない。タスク成功率 (講義はトークン数、時間、反復回数、そして 成功率を求めている。私は最初の三つは実行ごとに記録していたが、四つ目はどこにも存在しなかった。
五つ目は、自分自身に賭けるなら負けると思っていた項目だった。エンジンは実行を跨いで繰り返し発生する失敗を表面化させ、同じミスを繰り返さないようにしているか? それはできていた——recurring_failures、数ヶ月前にすでに実装済みの機能だ。これは合格した。二十三の主張が二十八になり、私が選んでいなかった良いニュースがちょうど一つ手に入った。
スコアは23/23から25/28へと動いた。主張を組み込んだ瞬間に24/28になり、次のセクションで最も安く片付く見落としを一つ解消して25になった。そしてゲートは赤に変わった。この失敗こそ、今回の作業で私が初めて本当に信じられる成果物だ。
私が直した一件と、数字が正直かどうかを決める二行
四つの見落としのうち一つは、安上がりで、しかも実際に役立つものだった——実行を跨いだ成功率だ。エンジンは完了したすべての実行結果を記録していたが、それを割り算したことは一度もなかった。
書くこと自体は十分もかからなかった。何を「成功」と数えるかを決めるほうが時間がかかった。成功率という指標は、システムの中でもっとも化粧しやすいものだからだ。
実行中でまだ進行中のものは分母から除外する。 それを失敗として数えれば、進行中の仕事を抱えていることが罰せられる。成功として数えれば、それは先送りにした嘘にすぎない。だからそれは別枠で報告し、除外する。
安全ゲートによって停止させられた実行は失敗として数える。 これは居心地が悪く、そして重要な一件だ。安全ブロックとは、その仕事が出荷されなかったということを意味する。もしこの割合がそれをこっそり見逃せば、その指標は安全ゲートがまさに生み出そうとしている結果——つまり停止——を都合よく評価してしまうことになる。そうなれば、私は自分のエンジンが危険だとして止められたときに上昇する数字を作ったことになる。
そして何も完了していないときは、ゼロではなく「何も返さない」。ゼロは「試みて失敗した」と読める。何もないことは「まだ測定していない」と読める。この二つはまったく異なる文であり、ダッシュボードはそれらを決して混同してはならない。
監査ファイルの見出し行は、手で打ったものではなく生成されたものだ——docs/rubrics/AUDIT.md:
**Conformance: 25/28 (89%)** verifiable claims implemented · 3 declared gaps · 0 unmeasured · gate **FAIL**このルーブリックは全部で三十一項目を持つ。二十八件の検証可能な主張がスコア25/28で採点され、加えて三件の宣言済みギャップが別建てで採点され、その分数には決して組み込まれない。
理由のある見落としも、なお見落としである
残りの三つは赤のままだった。そして正直に言えば、それらを別分類に格下げしたいという誘惑は本物だった。そのうち二つは、見落としというより意図的な逸脱だ。
ReActは、次の一手を判断する役割を行動するモデル自身に委ねる。私のエンジンを支える柱となる規則は、「作るものは決して採点しない」というものだ——だからReActをそのまま採用すれば、私が最も信頼しているその性質そのものを壊してしまう。マネージャー・ワーカー型の協調も同様に一つの選択であり、私は明示的な依存グラフとサイクル拒否を用いている。これは何かが実行される前に 検査できるものであり、実行時に即興で判断するマネージャーとは違う。
両方とも擁護はできる。だが、それでも合格ではない。そこでルーブリックには今、rationaleというフィールドを設け、その理由を赤マークの横に記録することにした。理由づけを緑に変える仕組みは、意図的に用意していない。失敗を説明で片づけられるチェックリストは、何も測っていないチェックリストと同じだ。それはまさに、その朝すでに一度犯した過ちそのものである。
3つ目、human takeover(人間による引き継ぎ)については、うまい言い訳のしようがない。これは本物のギャップだ。私のゲートは実行終了後の承認であり、進行中のループに割り込むチャネルは存在しない。作る価値はある。だが、まだ作っていない。
閉じた瞬間に落ちるギャップ
もうひとつ分類があり、これはあなたが自分のチェックリストにそのまま拝借してもいいくらいの部分だ。
講義が示唆していて、なおかつ私のエンジンに本当に欠けているもの——型付けされた失敗の分類体系、分岐探索、スパン単位のトレーススキーマの3つ——は、ルーブリックの中に宣言済みギャップとして書き込んである。それらのプローブは「不在」を主張する。ギャップが本当に存在する間はパスし、そのギャップが密かに解消された瞬間に失敗する。
これは、ドキュメント化された制約がいつの間にか事実でなくなっていくのを目の当たりにするまでは、逆さまに聞こえるだろう。誰かがサイドブランチでトレーシングを追加する。README の「トレーシングはありません」という一行はそのまま1年間残り続ける。読者はすでに存在しない制約を前提に計画を立ててしまう。ギャップリストを実行可能にするということは、何かが赤くならない限りドキュメントが形骸化しないということだ。
パターンとアンチパターン
パターン。 まず、自分が失敗すると見込む問いを書き出せ。主張はデータとして保持し、それを読むプログラムはただ1本だけにせよ。証拠はファイルと行番号、あるいは実際に実行されたテストとして残せ。実行不能なチェックは常にブロッキングとして扱い、決してパスとして扱うな。理由づけは赤マークの横に置いていいが、それで緑には変えるな。宣言済みギャップは実行可能にし、それが真でなくなった瞬間に壊れるようにせよ。
アンチパターン。 自分が恐れる問いをひとつも含めずに、自分が所有するシステムのためのルーブリックを書くこと。分類体系を監査であるかのように読むこと。進行中の作業を成功率にカウントすること。安全ゲートが作動すると数値が改善する指標。「未測定」をゼロとして報告すること。人間が更新を覚えていないと維持されないギャップリスト。そして、そのすべての背後にある広範な誤り——グリーンチェックを、それが何を見ることができたのかを問わずに証拠として扱うこと。
そのメカニズムを、一文で
そのメカニズムとは、作成時点での選別である。テストスイートの上限を決めるのは、それがどれほど厳密に実行されるかではなく、その作者がどの問いを書き留める気になったかだ。そしてその選択は、いかなるコードが実行される前にも、非公開の場で行われ、それを可視化する赤マークは存在しない。
第一原理:作者を失敗させられないチェックリストは、評価ではなく鏡である——だからこそ、信頼に足るスコアとは、答えを見たあとで自分が選別する余地のなかったリストによって生み出されたものだけなのだ。
この記事が主張しないこと
- 89%は品質スコアではない。 あるウェビナーのタクソノミーへの適合度に過ぎず、そのタクソノミー自体、網羅的でも権威あるものでもない。講義自身がそう認めている。
- ルーブリックは依然として私自身のものだ。 失敗すると見込んでいた問いを追加したところで改善はするが、それによって独立性が得られるわけではない。他人が書いたルーブリック、あるいは原文から機械的に導出されたルーブリックであればもっと強固だろうが、私はそれをやっていない。
- 赤信号の項目が3つ、未解決のまま残っている。そのうちの一つ(ヒューマンによる引き継ぎ)は、名指しされている以外には計画すらない。
- 1つのエンジン、1人の著者。 この監査は私自身のリポジトリに対して実行されたものであり、あなたの失敗パターンは異なるだろう。
結論
本気のチームなら、どこもこの種のものを書こうとしている。AIエージェント分野はチェックリストを驚くべき速さで量産しつつある。成熟度モデル、readinessフレームワーク、16セクションのタクソノミー。そして、そのほとんど全てが、採点対象のものを作った当人によって採点されることになるだろう。
良い数字は手に入るだろう。だが、その数字にふさわしいだけの中身は、ほとんどないはずだ。
最も安上がりな対策は、午後のひとときで済む。チェックリストを実行する前に、誰にも聞かれたくない問いを3つ書き出しておくことだ。それを組み込め。結果がそれでも緑のままなら、何か本物を学んだことになる。もし赤に変わったら、私自身のエンジンで、その同じ朝に起きたように、そのときはじめて、その数字は引用に値するものになる。
参考文献
- AI开发进入新时代:Agent Loop Engineering — 讲座总结、DataApplab / AI聘(info@aipin.io)、2026年8月20日受信のウェビナー要約。原文メールから逐語引用しており、その下の英訳は私自身によるものであって、著者本人の言葉ではないと明記している。
- Donald T. Campbell, Assessing the Impact of Planned Social Change、Evaluation and Program Planning, 2(1), 1979, pp. 67–90. 引用ではなく要約: 原論文はペイウォールの向こうにあり、誰もがこの論文の主張として引き伝えている一文はあまりに孫引きが多いため、実際に論文を読まないまま引用符で括る気にはなれない。
- Steven Kerrの"On the folly of rewarding A, while hoping for B"(原載:Academy of Management Journal, 18(4), 1975年)The Academy of Management Executive誌、1995年2月号、9(1), p. 7に再録されたものを実際には確認した。タイトルと書誌情報はこのPDFと突き合わせて確認済みだ。再録版を引用しているのは、それが私が実際に読んだ版だからである。
- ルーブリック、チェッカー、そして監査結果の全出力は次の場所にある——docs/rubrics/agent-loop-engineering.yml,
scripts/audit_loop_rubric.py、およびdocs/rubrics/AUDIT.md(github.com/wjlgatech/loop-engineering-anything)。2回目の実行におけるすべての数値——25/28、declared gaps(宣言済みギャップ)3件、unmeasured(未計測)ゼロ、gate FAIL——は、そのスクリプトを実行すれば再現できる。1回目の実行も同様に再現可能であり、アーカイブ化されたルーブリックに対して--rubric docs/rubrics/archive/agent-loop-engineering.v1.yml実行すれば23/23、gate PASSが返る。そのアーカイブは事後に作成された再構成版であって、復元された原本ではない。そのことはヘッダー自体にも明記してある。
2026年8月21日執筆。23/23の実行と25/28の実行は、同じエンジンを同じ日に動かした結果であり、変わったのはルーブリックだけだ。ここで一つ訂正しておく。そうしなければこの記事自体が、自ら掲げる基準に耐えられなくなってしまう。この記事を最初に書いた時点で、23項目のルーブリックは一度もコミットされていなかった。23/23というスコアの唯一の痕跡は、私自身が書いた文章、つまりコミットメッセージやYAMLのコメントにすぎなかった。ある独立したレビュアーがこれを見つけ、指摘は正しかった。私の見出し数値は観測可能なものではなく、主張されただけのものだった。それも、「観測可能かどうかの違いこそがすべてだ」と論じる記事の中でだ。今ではそれはラベル付きの再構成版としてコミットされており、コマンド一つで再実行できる。[4].