AI-네이티브 시리즈 · 에이전트 엔지니어링
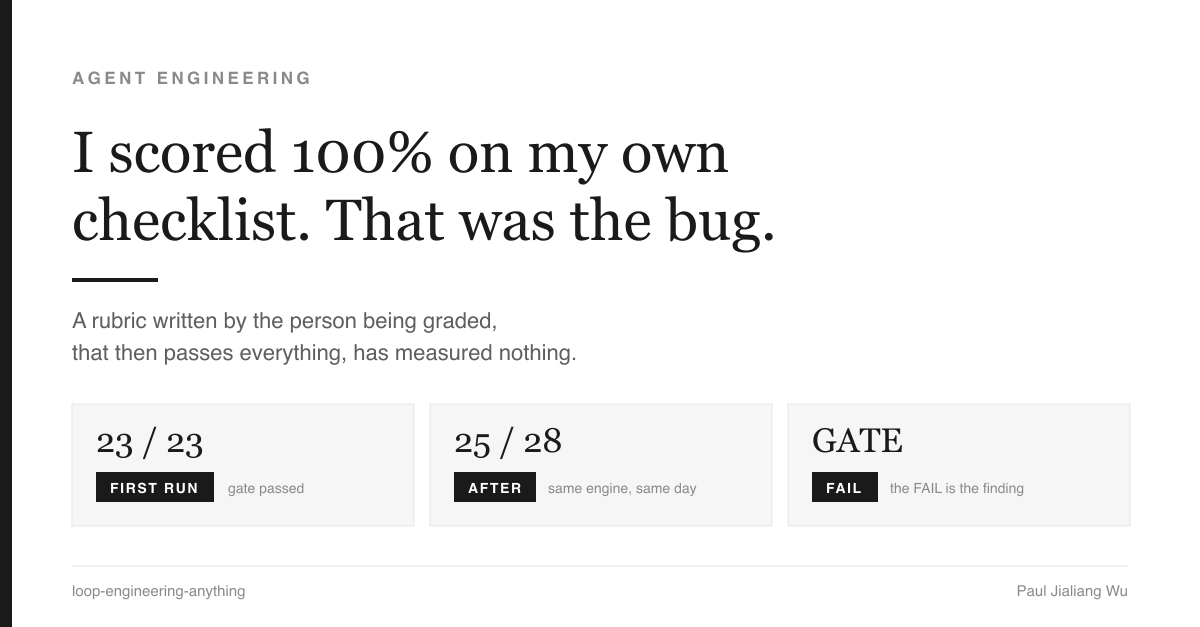
내 체크리스트에서 나는 100점을 받았다. 그게 바로 버그였다.
어느 강연에서 진지한 AI 에이전트 루프가 갖춰야 할 열여섯 가지를 나열했다. 나는 그 목록을 기계로 검증 가능한 루브릭으로 바꿔 내 엔진에 들이댔고, 모든 항목을 통과했다. 만점은 증거가 아니다. 그것은 스스로 묻기로 선택한 질문들에 대한 영수증일 뿐이다.
1분
누군가 신뢰할 수 있는 AI 에이전트를 만드는 법에 관한 훌륭한 강연 요약본을 보내왔다 — 성숙한 시스템이 해야 할 일을 담은 열여섯 개 섹션이었다. 그 내용은 실제 소프트웨어에 대해 아무것도 검증하지 않기에, 나는 그것을 내 엔진이 자동으로 채점받을 수 있는 체크리스트로 코드화했다. 첫 실행 결과: 23점 만점에 23점. 나는 답을 보면서 질문을 쓴 셈이었다. 그래서 나는 강연으로 다시 돌아가, 조용히 건너뛰었던 주장들 — 실패할 것이라 예상했던 것들 — 을 찾아냈고, 정직한 점수는 25/28이 되었으며 게이트는 빨간불이 켜졌다. 하나의 실패는 그 자리에서 바로 고칠 만한 가치가 있었고, 세 개는 계속 빨간불로 남았으며, 추가로 세 개의 격차는 별도로 명시되어 이제는 대놓고 그렇다고 밝히고 있다.
그 강연
한 독자가 다음과 같은 제목의 웨비나 요약본을 전달해주었다 Agent Loop Engineering. 정말로 훌륭한 내용이다. 프롬프트 엔지니어링에서 컨텍스트 엔지니어링, 그리고 루프 엔지니어링으로 나아가면서, 흥미로운 문제가 이동했다고 주장한다: '모델에게 무엇을 말할 것인가'가 아니라 '시스템이 어떻게 행동하고, 관찰하고, 판단하고, 다시 시도하는가'로.
이 강의의 열여섯 개 섹션은 마치 명세서처럼 읽힌다. 루프에는 목표, 모델 바깥에 존재하는 상태, 정책, 제한된 행동 공간, 관찰, 평가가 필요하다. 명시적인 종료 조건이 필요하다. 재시도하기 전에 오류를 분류해야 한다. 고위험 순간에는 사람이 개입해야 한다. 토큰 수, 시간, 반복 횟수그리고 성공률을 세어야 한다.
이 강의는 또한 자기 자신의 위상에 대해 유별나게 정직하다 [1]:
"Agent Loop Engineering目前更适合作为一种工程实践和设计思想来理解,而不是一个已经高度标准化、具有唯一严格定义的技术标准。"
Agent Loop Engineering is better understood, for now, as an engineering practice and a design philosophy rather than a highly standardised technical standard with a single strict definition. (번역: Agent Loop Engineering은 지금으로서는 이미 고도로 표준화되어 단 하나의 엄밀한 정의를 갖춘 기술 표준이라기보다, 하나의 엔지니어링 실천이자 설계 철학으로 이해하는 편이 낫다.)
나는 그 문장이 마음에 들었는데, 동시에 그 문장이 바로 구멍이기도 하다. 시스템이 반드시 갖춰야 할 것을 열거한 열여섯 개 섹션이 있지만, 어떤 특정 시스템이 실제로 그것을 갖추고 있다는 증거는 단 한 줄도 없다. 분류 체계란 검증이 제거된 주장들의 집합일 뿐이다.
바로 그런 일을 해낸다고 주장하는 엔진을 나는 하나 갖고 있다 — 생성하고, 판단하고, 리팩터링하고, 수렴하는 루프다. 그러니 할 일은 명백하다. 체크리스트 읽기를 멈추고, 실제로 돌려보는 것.
에세이를 게이트로 바꾸기
이 작업에 대한 나만의 원칙은 한 줄로 요약된다: 루브릭은 위장한 폐쇄 루프다 — 루브릭이 곧 점수다. 여기서 세 가지 규칙이 따라 나오며, 이것이 설계의 전부다.
주장은 코드가 아니라 데이터가 된다. 열여섯 개 섹션 중 열세 개가 검증 가능한 주장을 만들어낸다 — 도입부, 코딩 에이전트 시연, 결론부는 아무것도 만들어내지 않는다 — 그리고 그것들은 YAML 파일로, 주장 하나당 항목 하나씩 옮겨진다. 체커는 오직 그 파일만 읽으므로, 공표된 점수는 그것이 채점한다고 말하는 주장들로부터 결코 벗어날 수 없다.
증거는 관찰되는 것이지, 결코 주장되는 것이 아니다. 각 주장에는 프로브가 딸려 있다: 실제 파일과 줄에 존재해야 하는 심볼이거나, 실제로 실행되는 테스트다 — 디스크에 그냥 존재하기만 하는 것으로는 안 된다. 출력 결과는 어디를 살펴봤고 무엇을 발견했는지를 기록한다.
"확인할 수 없었다"는 "작동한다"가 아니다. 프로브가 실행될 수 없다면, 그 항목은 미측정 상태다: 백분율에서 제외되고 동시에 게이트를 막는다. 이것이 바로 대부분의 체크리스트가 조용히 어기는 규칙인데, 실행 불가능한 검사는 그냥 내버려두면 통과한 검사와 구별이 되지 않기 때문이다.
- id: L16-safety-terminal
  claim: "A safety failure is terminal and unbypassable, whatever the score."
  probe: {type: grep, pattern: "BLOCKED_SAFETY", paths: ["src/loopeng/loop/convergence.py"]}

# ... two entries omitted; each real item also carries the lecture section it came from

- id: L19-hitl-unbypassable
  claim: "An unattended run cannot pre-confirm its own result."
  probe: {type: pytest, node: "tests/test_run_contract.py::test_contract_can_never_disable_the_human_gate"}
나는 그것을 돌려보았다 [4]. 주장 스물세 개, 통과 스물세 개, 게이트는 초록불이었다.
스스로를 의심해야 할 순간
완벽한 점수는 딱 4초 동안 기분이 좋았다.
그러고 나서 깨달았다: 나는 이 질문들을 직접 작성했다. 그것도 이후 코드베이스 안에서 한 시간을 보낸 뒤에 작성한 것이었다. 빨간불로 돌아올 것 같은 질문은 단 하나도 쓰지 않았다. 내가 만든 것은 평가가 아니었다. 테스트 커버리지를 갖춘, 잘 만들어진 거울이었을 뿐이다.
이 현상에는 측정 이론 문헌에서 이미 이름이 붙어 있다. Donald Campbell이 1979년 계획된 사회 변화에 관해 수행한 연구는[2] 정량적 지표가 의사결정에 사용될수록, 그 지표는 자신이 감시하려 했던 바로 그 과정을 왜곡하라는 압력을 더 많이 받게 된다고 주장한다. (이 주장을 한 문장으로 요약한 유명한 버전이 여기저기 돌아다니지만, 원문은 유료 열람이라 나는 그의 주장을 서술할 뿐 그의 입에 말을 넣지는 않겠다.) Steven Kerr의 On the folly of rewarding A, while hoping for B [3]는 이 논리의 실무적인 절반을 짚어준다: 시스템은 당신이 의도한 것이 아니라, 실제로 점수를 매기는 대상을 꾸준히 만들어낸다.
이 두 논의는 보통 다른 사람이 지표를 조작하는 상황을 설명할 때 인용된다. 하지만 더 날카로운 버전은 훨씬 더 가까이에 있다. 루브릭을 작성한 사람이 그 시스템의 소유자이기도 할 때는, 조작이 아예 필요가 없다. 아무도 부정행위를 하지 않는다. 선택은 그보다 훨씬 전에, 훨씬 더 편안하게, 즉 어떤 질문을 적어둘 가치가 있는지를 결정하는 그 순간에 이미 일어난다.
건너뛰었던 질문들로 되돌아가기
그래서 나는 강의를 다시 읽으면서, 내가 인코딩하지 않은 주장들만을 찾았다. 그리고 일부러 가혹한 기준으로 그것들을 골랐다: 실패할 것 같으면 포함시킨다.
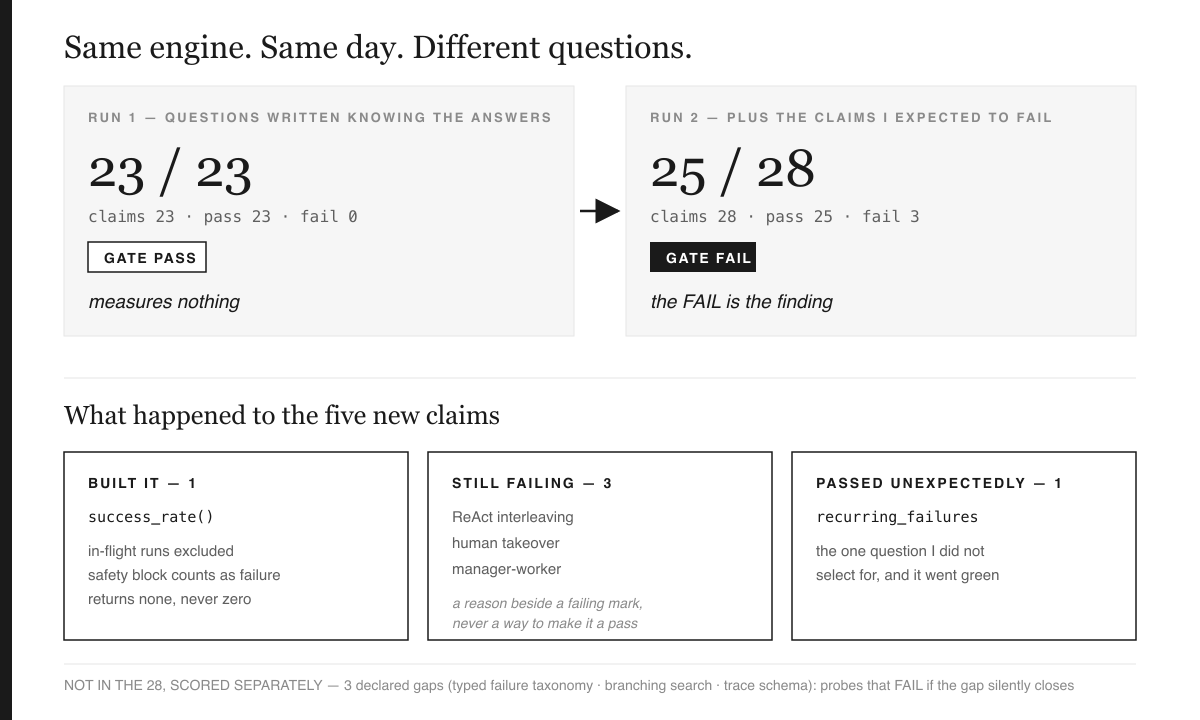
다섯 개가 돌아왔다 — 내가 실패를 예상했던 네 개, 그리고 예상하지 못했던 하나.
ReAct 방식의 교차 실행 (5절): 추론과 행동이 세밀한 단위로 번갈아 일어나는 방식이다. 내 루프는 이렇게 하지 않는다. 휴먼 테이크오버 (12절): 강의에 따르면 사람이 실행 중인 작업을 직접 넘겨받을 수 있어야 하며, 결과를 승인하는 것만으로는 부족하다. 내 시스템은 그렇게 할 수 없다. 매니저-워커 계층 구조 (11절): 매니저 에이전트가 작업을 분해해 워커들에게 나눠주는 구조다. 내 시스템에는 그런 것이 없다. 작업 성공률 (14번 절): 강의는 토큰, 시간, 반복 횟수 그리고 성공률을 요구한다. 실행당 앞의 세 가지는 갖추고 있었지만, 네 번째는 어디에도 존재하지 않았다.
다섯 번째는 스스로에게 불리한 쪽에 걸었을 법한 항목이었다. 엔진이 여러 실행에 걸쳐 반복적으로 나타나는 실패를 표면화해서 같은 실수를 되풀이하지 않도록 하는가? 그렇다 — recurring_failures 몇 달 전에 이미 배포된 기능이었다. 통과. 스물세 개의 항목이 스물여덟 개가 되었고, 내가 고르지 않았는데도 좋은 소식을 하나 얻은 셈이다.
점수는 23/23에서 25/28로 움직였다 — 항목들을 반영하자마자 24/28이 되었고, 다음 절에서 가장 손쉬운 미달 항목을 해결하자 25가 되었다 — 그리고 게이트는 빨간불로 바뀌었다. 그 실패야말로 이 작업이 내놓은 결과물 중 내가 실제로 믿는 첫 번째 것이다.
내가 고친 것 하나, 그리고 어떤 숫자가 정직한지 가르는 두 줄
네 가지 미달 항목 중 하나는 손쉬우면서도 진짜로 유용했다: 여러 실행에 걸친 성공률. 엔진은 완료된 모든 실행의 결과를 기록해두고 있었지만, 그것을 나눗셈해본 적은 한 번도 없었다.
코드를 작성하는 데는 십 분이 걸렸다. 무엇을 셈에 넣을지 정하는 데는 더 오래 걸렸는데, 성공률 지표만큼 시스템을 손쉽게 과장하기 좋은 것도 없기 때문이다.
아직 진행 중인 실행은 분모에서 제외한다. 그것을 실패로 세면 진행 중인 작업이 있다는 이유로 벌을 주는 셈이고, 성공으로 세면 시차를 둔 거짓말일 뿐이다. 그래서 별도로 보고하고 셈에서 뺀다.
안전 게이트에 의해 중단된 실행은 실패로 센다. 이 항목은 불편하지만 중요한 것이다. 안전 차단이 걸렸다는 것은 그 작업이 세상에 나가지 못했다는 뜻이다. 만약 이 비율이 그런 경우를 슬쩍 눈감아준다면, 그 지표는 안전 게이트가 애초에 막으려던 바로 그 결과를 보상하게 될 것이다 — 그러면 나는 내 엔진이 위험해서 멈춰 세워질 때 오히려 올라가는 숫자를 만든 셈이 된다.
그리고 아무것도 완료되지 않았을 때는 0이 아니라 아예 아무 값도 반환하지 않는다. 0은 "시도했지만 실패했다"로 읽힌다. 아무 값 없음은 "아직 측정하지 않았다"로 읽힌다. 이 둘은 서로 다른 문장이며, 대시보드가 이 둘을 혼동해서는 절대 안 된다.
타이핑한 것이 아니라 자동 생성된 감사 파일의 헤드라인 줄은 다음과 같다.docs/rubrics/AUDIT.md:
**Conformance: 25/28 (89%)** verifiable claims implemented · 3 declared gaps · 0 unmeasured · gate **FAIL**루브릭은 전체 서른한 개 항목으로 이루어져 있다: 검증 가능한 주장 스물여덟 개는 25/28로 채점되었고, 여기에 선언된 격차 세 개가 별도로 채점되어 그 분수에는 결코 합산되지 않는다.
이유가 있어도 미달은 미달이다
나머지 세 항목은 계속 빨간불로 남았고, 이를 다른 범주로 재분류하고 싶은 진짜 유혹이 있었다. 그중 둘은 솔직히 말해 실수가 아니라 의도적인 방향 전환이다.
ReAct는 행동하는 모델 자신에게 다음 단계를 판단할 권한을 준다. 내 엔진을 떠받치는 규칙은 만드는 존재가 절대 채점하지 않는다는 것이다. ReAct를 통째로 들여오면 내가 가장 신뢰하는 그 속성이 무너진다. 매니저-워커 조정 방식 역시 하나의 선택이다: 나는 순환을 거부하는 명시적 의존성 그래프를 사용하는데, 이는 아무것도 실행되기 전에 미리 점검할 수 있다는 점에서, 런타임에 즉흥적으로 판단하는 매니저 방식과는 다르다.
둘 다 방어 가능하다. 하지만 둘 다 통과는 아니다. 그래서 이제 루브릭은 rationale 필드를 두어 빨간 표시 옆에 그 근거를 기록한다. 다만 근거를 초록 표시로 바꿔주는 메커니즘은 의도적으로 존재하지 않는다. 저자가 실패를 변명할 수 있는 체크리스트는 아무것도 채점하지 않는 체크리스트나 마찬가지고, 이는 바로 그날 아침 내가 이미 한 번 저질렀던 실수 그 자체다.
세 번째 항목인 휴먼 테이크오버는 그럴듯한 포장이 없다. 이건 진짜 공백이다. 내 게이트는 실행 종료 시점의 승인일 뿐, 이미 진행 중인 루프에 개입할 통로는 없다. 만들 가치는 있지만, 아직 만들지 않았다.
닫히는 순간 실패하는 공백들
범주가 하나 더 있는데, 이는 어느 체크리스트에든 훔쳐가고 싶을 대목이다.
강의가 암시하지만 내 엔진에는 실제로 없는 세 가지 — 타입이 지정된 실패 분류 체계, 분기 탐색, 스팬 수준의 트레이스 스키마 — 는 루브릭에 선언된 공백 으로 기록되어 있다. 이 항목들의 검증 로직은 '부재'를 단언한다. 공백이 실재하는 동안은 통과하지만, 그 공백이 소리 없이 메워지는 순간 실패 로 바뀐다.
이는 문서화된 한계가 조용히 거짓이 되어버리는 것을 지켜보기 전까지는 거꾸로 된 이야기처럼 들린다. 누군가 사이드 브랜치에 트레이싱을 추가하고, README의 '우리는 트레이싱이 없다'는 문구는 그대로 1년을 남아 있으며, 독자는 이미 사라진 제약을 전제로 계획을 세운다. 공백 목록을 실행 가능하게 만든다는 것은, 무언가가 빨갛게 변하지 않고서는 문서가 부패할 수 없다는 뜻이다.
패턴과 안티패턴
패턴. 실패할 것으로 예상되는 질문을 가장 먼저 쓰라. 주장들을 데이터로 남기고 오직 하나의 프로그램만이 그것을 읽게 하라. 증거는 파일과 줄 번호로, 혹은 실제로 실행된 테스트로 만들라. 실행 불가능한 검사는 통과가 아니라 항상 차단으로 취급하라. 근거가 빨간 표시 옆에 놓이더라도 그것을 초록으로 바꾸지 말라. 선언된 공백들을 실행 가능하게 만들어, 더 이상 사실이 아니게 되는 순간 깨지도록 하라.
안티패턴. 자신이 두려워하는 질문 하나 없이 자신이 소유한 시스템을 위한 루브릭을 작성하는 것. 분류 체계를 감사인 양 읽는 것. 진행 중인 작업을 성공률에 포함시켜 계산하는 것. 안전 게이트가 작동할 때 오히려 개선되는 지표. 미측정을 0으로 보고하는 것. 사람이 기억해야만 업데이트되는 공백 목록. 그리고 이 모든 것의 배후에 있는 가장 근본적인 문제: 초록 체크가 무엇을 볼 수 있었는지 묻지도 않은 채 그것을 증거로 취급하는 것.
메커니즘, 한 문장으로
그 메커니즘은 작성 시점의 선택이다. 테스트 스위트의 한계는 그것이 얼마나 엄격하게 실행되는가가 아니라, 저자가 기꺼이 적어두려 했던 질문이 무엇인가에 의해 정해진다. 그리고 그 선택은 어떤 코드가 실행되기도 전에, 은밀하게, 그것을 드러낼 빨간 표시 하나 없이 이루어진다.
첫 번째 원칙: 저자를 실패시킬 수 없는 체크리스트는 평가가 아니라 거울이다 — 그러므로 믿을 수 있는 유일한 점수는, 답을 본 뒤에는 손댈 수 없었던 목록에서 나온 점수뿐이다.
이 글이 주장하지 않는 것
- 89%는 품질 점수가 아니다. 이는 특정 웨비나 하나의 분류 체계에 대한 부합 여부일 뿐이며, 그 분류 체계 자체가 망라적이지도 권위 있지도 않다 — 강연 스스로도 그렇게 말하고 있다.
- 이 루브릭은 여전히 내 것이다. 내가 실패할 거라 예상한 질문들을 추가하면 루브릭은 나아지지만, 그렇다고 독립적인 것이 되지는 않는다. 다른 누군가가 작성했거나 원문에서 기계적으로 도출한 루브릭이었다면 더 견고했을 텐데, 나는 그렇게 하지 않았다.
- 빨간불 항목 세 개는 아직 미달 상태이고, 그중 하나(휴먼 테이크오버)는 이름만 붙여졌을 뿐 아직 계획조차 없다.
- 엔진 하나, 저자 한 명. 이 감사는 내 저장소를 대상으로 실행된 것이므로, 여러분의 실패 양상은 다를 것이다.
결론
진지한 팀이라면 조만간 이런 걸 하나씩 작성하게 될 것이다. AI 에이전트 분야는 놀라운 속도로 체크리스트를 쏟아내고 있다 — 성숙도 모델, 준비도 프레임워크, 열여섯 개 항목짜리 분류 체계 등등 — 그리고 그 대부분은 채점 대상이 되는 시스템을 만든 바로 그 사람들이 채점하게 될 것이다.
좋은 점수는 받을 것이다. 하지만 그 점수를 누릴 자격은 거의 없을 것이다.
가장 값싼 해결책은 시간도 얼마 들지 않는다 — 오후 한나절이면 충분하다. 체크리스트를 돌리기 전에, 아무도 묻지 않기를 바라는 질문 세 개를 적어 목록에 포함시켜라. 그러고도 결과가 여전히 초록불이라면, 뭔가 진짜를 배운 것이다. 반대로 빨간불이 뜬다면 — 그날 아침 내 엔진에서 그랬던 것처럼 — 그제야 비로소 그 숫자는 인용할 가치가 생긴다.
참고 문헌
- AI开发进入新时代:Agent Loop Engineering — 讲座总结, DataApplab / AI聘 (info@aipin.io), 2026년 8월 20일 수신한 웨비나 요약. 원문 이메일에서 그대로 인용했으며, 그 아래의 영어 번역문은 내가 작성한 것으로, 저자의 말이 아니라 번역임을 명시해 둔다.
- Donald T. Campbell, Assessing the Impact of Planned Social Change, Evaluation and Program Planning, 2(1), 1979, pp. 67–90. 인용이 아니라 요약함: 원문은 유료 장벽 뒤에 있다. 다들 이 논문에서 인용하는 그 유명한 한 문장은 하도 여기저기서 재인용되다 보니, 직접 읽어보지 않고서는 따옴표를 붙일 수가 없다.
- Steven Kerr, On the folly of rewarding A, while hoping for B. 원래는 Academy of Management Journal, 18(4), 1975에 실렸으며, 내가 확인한 사본은 The Academy of Management Executive 1995년 2월호, 9(1), p. 7에 실린 재수록판이다. 제목과 서지 정보는 그 PDF를 기준으로 확인했다. 재수록판을 인용하는 이유는 그것이 내가 실제로 읽은 판본이기 때문이다.
- 루브릭, 체커, 그리고 전체 감사 출력 결과: docs/rubrics/agent-loop-engineering.yml,
scripts/audit_loop_rubric.py, 그리고docs/rubrics/AUDIT.mdgithub.com/wjlgatech/loop-engineering-anything에 있다. 두 번째 실행의 모든 숫자 — 25/28, 선언된 격차 세 건, 측정 불가 항목 0건, 게이트 FAIL — 는 해당 스크립트를 실행하면 그대로 재현된다. 첫 번째 실행 역시 재현 가능한데, 아카이브된 루브릭을 기준으로--rubric docs/rubrics/archive/agent-loop-engineering.v1.yml23/23, 게이트 PASS를 반환한다. 이 아카이브는 사후에 커밋된 재구성물이지, 복구된 원본이 아니며, 그 사실은 헤더에 그대로 명시되어 있다.
2026-08-21 작성. 23/23 실행과 25/28 실행은 같은 날, 같은 엔진에서 나온 결과이며 바뀐 것은 루브릭뿐이다. 정정 사항 하나를 밝힌다. 이걸 밝히지 않으면 이 글 자체가 스스로 내세우는 기준을 통과하지 못할 것이기 때문이다. 이 글을 처음 썼을 때, 23개 항목짜리 루브릭은 한 번도 커밋된 적이 없었다. 어디에도 23/23이라는 결과의 흔적은 없었고, 있는 거라곤 내가 써놓은 산문 — 커밋 메시지, YAML 주석 — 뿐이었다. 어느 독립 검토자가 이를 발견했고, 그의 지적이 옳았다. 나의 헤드라인 숫자는 관찰 가능한 것이 아니라 그저 주장된 것이었다. 바로 그 차이야말로 전부라고 주장하는 글에서 말이다. 이제는 라벨이 붙은 재구성물로 커밋되어 있으며, 명령어 한 줄로 재실행할 수 있다 [4].